山大软工实践hive(4)-join算子

三、 Hive 逻辑算子及其生成(下) 3.3算子DAG的生成    在第一章1.4节我们提到Hive首先将抽象语法树AST转换成查询块(QueryBlock),然后在将QueryBlock转化成算子DAG。 3.3.1QueryBlock生成 1) QB数据结构 QueryBlock数据结构定义在QB类中,QB的主要成员变量如下: HashMap aliasToTabs; HashMap aliasToSubq; HashM 阅读详情

2021SC@SDUSC

山大软工实践hive(4)-join算子

杂碎

  1. hive支持等值join,但不支持非等值join,也就是涉及<>的比较在join后进行
  2. JoinOperator为基础,其他join为在此之上的优化

common join

把每个表的读取排序分发给一组mapper(由RS算子实现),再输出给join算子进行join操作。小表优先放入内存以提高效率(内存满时大表就会部分地放在磁盘,使用时才从磁盘读取,让小表在内存减少反复读取磁盘的开销)

在Mapper阶段读取表的数据转换为键值对,经过shuffle让有相应key的输出到相应Reducer
在JoinOperator process方法中

		  // The input is sorted by alias, so if we are already in the last join
          // operand,
          // we can emit some results now.
          // Note this has to be done before adding the current row to the
          // storage,
          // to preserve the correctness for outer joins.
          checkAndGenObject();

直到最右边的表被读完(join操作中最后的表),才进行join操作,否则把读取的内容放入内存

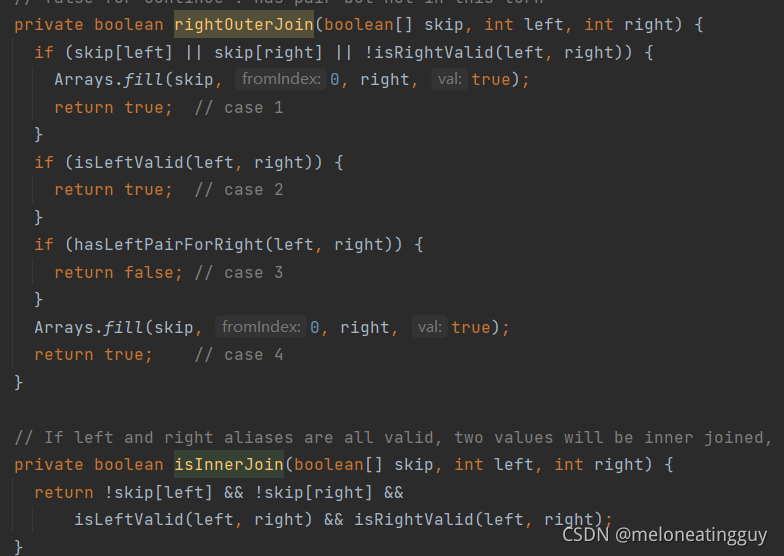
这个checkAndGenObject()由CommonJoinOperator,JoinOperator继承了这个类
而在CommonJoinOperator中,实现了各种连接(内外连接等),如下图部分
请添加图片描述

Map join

用小表(包含数据少的表)的join key为键创建hash表,把hash表广播到所有map节点上,map节点获取大表数据,根据hash表进行join操作
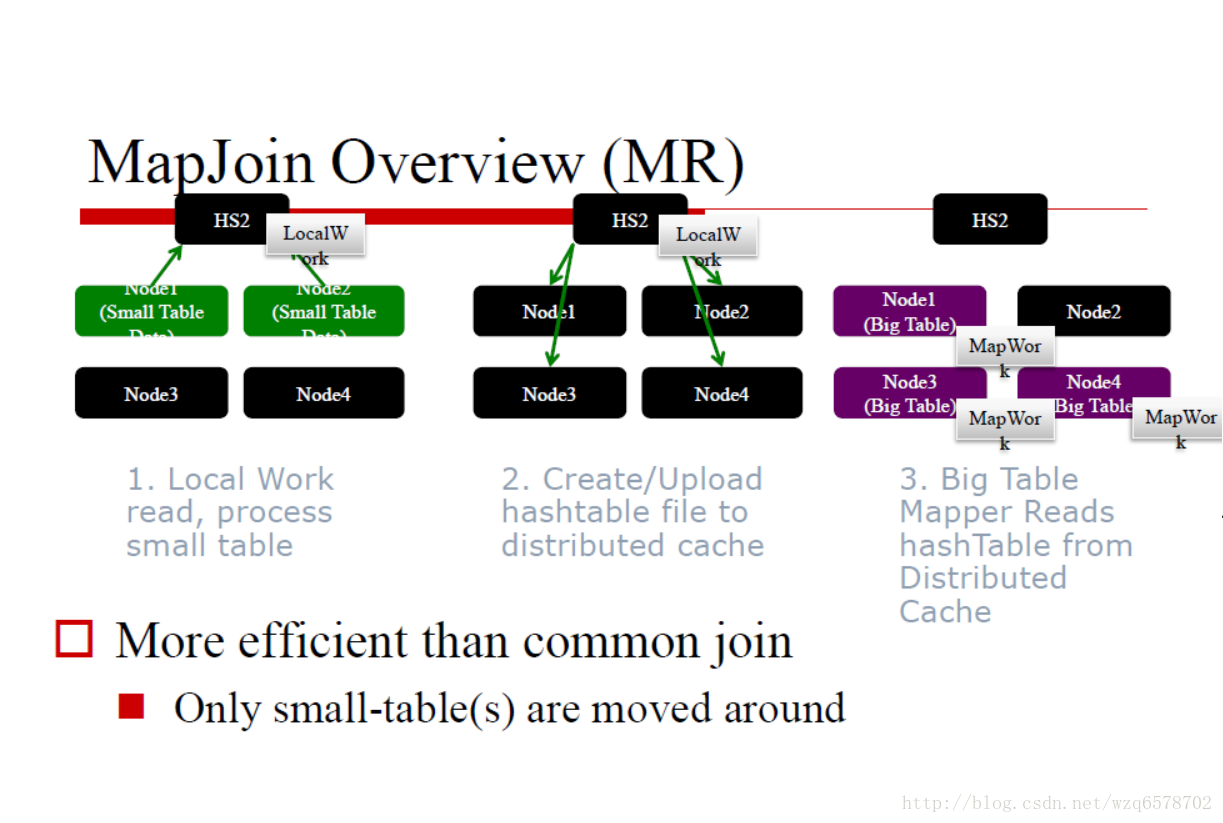
猜测:基于hash表只创建小表的hash表。如果不创建hash表,就会进行排序->join的操作(大小表都要排序,不然不能归并连接),造成排序上的开销,也相当于省略了RS节点。不过如果表原本就是按照join key排的序,如key为主键,则可进行普通join
比如下图,以CityId 进行join
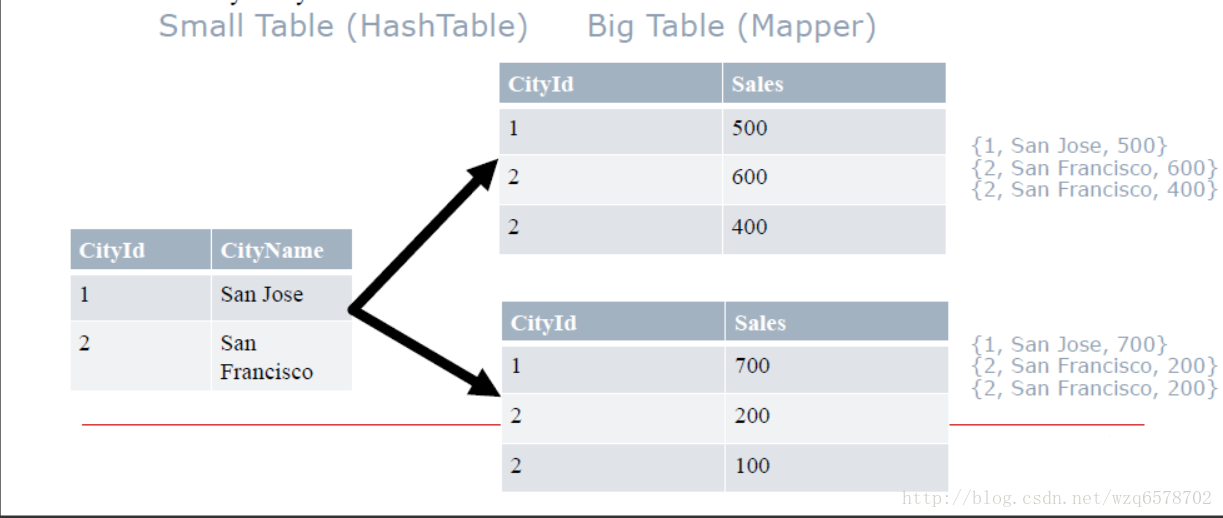
该方法适用于小表足够小的情况
猜测:小表过大会使每个map节点单次处理时间变长,虽然总时间可能会少。这是因为一般会把每个表分成许多map节点读取,让每个不同表的节点之间进行join,虽然次数多,但每个节点小,总而言之,把nm换成了(a个n/a)(b个m/b)
所有小表要能够完全读入内存,可手动要求进行map join,或按照默认(规定小表大小最大值)

BucketMapJoin

首先是Bucket表,在创建时声明如CLUSTERED BY (cityId) INTO 2 BUCKETS,就会把表按cityId分到两个桶储存(每个桶存一部分,比如id为奇数偶数)
在此基础上MapJoin,就会为每个桶创建一个hash表,其他操作类似

SMB join

比如一个表是CLUSTERED BY (cityId) SORTED BY (cityId) INTO 2 BUCKETS,既分桶又排序,并且join时按照该属性join,那就可以直接common join(直接省去排序分段的操作,即不用RS算子,不过桶太大应该还是会切割桶吧?),避免了广播hash表的开销

源代码注释声明,归并排序map join

/**
 * Sorted Merge Map Join Operator.
 */
public class SMBMapJoinOperator extends AbstractMapJoinOperator<SMBJoinDesc> implements
    Serializable {

Skew Join

有的键会出现特别多次,这可能导致reduce阶段数据倾斜
于是把join过程分为处理非倾斜键的Common join与处理倾斜键的map join
可以在创建表时指定某属性倾斜 — create table … skewed by (key) on (key_value);然后在逻辑优化时unoin两种join
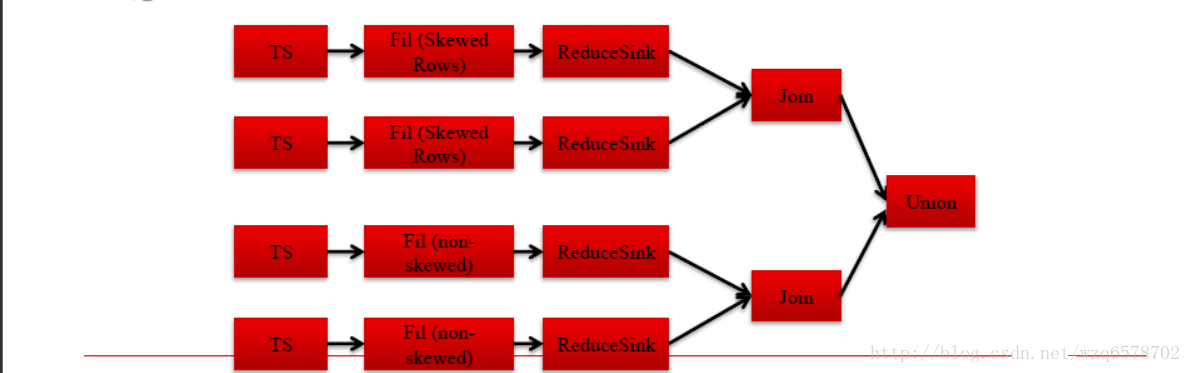
关于union算子,它不做什么事

/**
 * Union Operator Just forwards. Doesn't do anything itself.
 **/
public class UnionOperator extends Operator<UnionDesc> implements Serializable {

下一步

可以开始看逻辑优化部分,也可以看DAG是怎么构造的(输入怎么来的),理论上如果凑不出13篇,再看输入是怎么来的是不错的选择

参考

魔鬼_的博客
Map join和Common join详解

XPe开发初体验(一)XPe概述 XP Embedded是微软Windows Embedded产品线中非常重要的一环,不过比起大名鼎鼎的Windows Embedded CE,XPe显得过于低调了。在接下来的一段时间里,我希望能够用六篇的篇幅来描述一下XPe的整个开发过程。这个系列文章主要是针对有Windows编程经验,但是没有嵌入式开发经验的开发者,提供一些概念和开发过程的初步介绍。XP Embedded是一个基于Windo 阅读详情

相关推荐

二进制、八进制、十六进制、十进制转换详解

二进制是计算机的语言,正如我们使用汉语表达与交流信息一样,任何信息在计算机中都以二进制的形式存储和计算。了解二进制与十进制等进制之间的转换方法,有助于我们了解计算机内部的数字计算过程,可以帮助我们在一定程度上理解信息在计算机中的编码和解码过程。本文先简单介绍位置化数字系统的概念,然后详细讲解二进制、八进制、十六进制、十进制之间的转换方法与原理。

2301_81674797的博客 2097

hive中jion,union的大坑

在执行sql union和jion操作的时候总在报错 错误如下 做了各种操作搞了一整天,最终在mapred-site.xml加了配置 并在执行sql之前执行 SET hive.auto.convert.join=false; set hive.exec.mode.local.auto=false; set MapReduce.queue = QUEUE_root; 问题解决 ...

cstg4w的博客 260

USB的24脚和12脚TYPEC引脚定义

USB 是一种接口,用于将设备连接到计算机上。通过该连接,计算机可以向设备发送数据或检索来自设备的数据。USB 为开发者提供了一个标准接口,适用于多种不同类型的应用。借助于系统的设计过程,USB 设备易于连接和使用。本应用笔记会使该过程变得更加简单。以下是本应用笔记中会使用的概念:USB 历史USB 架构USB 物理接口USB 速度USB 电源USB 端点USB 通信协议USB 描述符USB 类设备USB 枚举与配置过程。

易板 1万+

使用Hive进行join查询的时报错

1.在使用hive时进行单表查询没问题,但是使用join查询报错,错误信息如下:   2.分析日志,估计是reduce task为0的原因,于是就测试了下(测试的时候,设置reduce task的数量为0),果然报一样的错误,错误信息如下:   解决办法:删除hive使用的mysql数据库,重新配置,设置hive的reduce task的默认个数为1,而不是-1,然后就好了。 在...

iteye_7017的博客 1374

测试工程师玩转DeepSeek之Prompt

掌握这些提示词技巧,测试工程师可提升与DeepSeek的协作效率至少3倍。建议结合具体项目上下文进行二次优化,并建立团队内部的提示词知识共享库。✅ “为电商支付接口生成包含幂等性验证的测试用例,覆盖网络中断重试场景”❌ “帮我写测试用例”

weixin_44872675的博客 2262

告别MATLAB!用Python的PYPOWER搞定电力系统潮流计算(附Case30完整代码)

本文介绍了如何从MATLAB迁移到Python,使用PYPOWER工具包进行电力系统潮流计算。通过详细的环境准备、数据接口兼容性实践、潮流计算实现及最优潮流计算进阶,帮助工程师和学生无缝过渡到Python生态。文章还展示了结果处理与可视化技巧,并附有Case30完整代码示例。

weixin_30411819的博客 300

hive join操作踩坑记-报错信息FAILED: Execution Error, return code 2 from org.apache.hadoop.hive.ql.exec.mr...

#Hive join操作踩坑记 事件经过 使用hive join操作时,肉眼可见同样的操作用时越来越长,同样的操作用时从一百多秒直接飙升到三四百秒,并且有时运行时汇报出错误信息 FAILED: Execution Error, return code 2 from org.apache.hadoop.hive.ql.exec.mr.MapRedTask (state=08S01,code=2)。通过jobhistoryserver的记录显示一些reduce task运行失败了,报错信息为There are

weixin_44528131的博客 3186

别再让步进电机‘发烧’了!用FOC闭环驱动实现精准力矩控制(基于P0斩波恒流版)

本文详细介绍了如何利用FOC闭环驱动技术(基于P0斩波恒流版)解决步进电机过热和力矩控制不精准的问题。通过对比传统开环控制的缺陷,展示了FOC在降低温度、提升精度和能效方面的显著优势,并提供了硬件配置、软件实现及性能优化的完整方案。

weixin_30872157的博客 567

Hive 编程专题九 : SQL Join 的那点坑

环境: Hive: 2.7.7 Oracle SQL Developer Cloudera JDBC Driver 案例 - 1 : 非全等 Join 失效 select a.*, b.* from default.employee a inner join default.employee b on a.salary &lt; b.salary 异常: SQL 错误: [Cloudera...

wujiandao的专栏 4414

手把手教你学基于 Linux 的 NPU 固件开发-第 10 讲:可靠性设计(RAS)——让系统坚如磐石错误检测、纠正与上报机制(ECC、Parity)

组件推荐保护机制备注HBM/DDRScrubbing必须开启,定期巡检片上 SRAMECC(权重/激活值),Parity(指令)权衡面积与可靠性计算单元ABFT或DMR(关键路径)防止计算逻辑错误片上网络CRC重传保证数据传输完整性系统软件AER 上报CE 监控自动恢复闭环管理,杜绝 SDC运维策略预测性维护Checkpoint变被动为主动核心心法(信任硬件,但必须验证。在纳米尺度下,错误是必然发生的物理现象。

MHD0815的博客 92

【WRF-Urban数据集】中国60个城市的1 km分辨率城市冠层参数(UCPs)

中国60个城市的1 km分辨率城市冠层参数(UCPs)

WW、forever的博客 1068

hive企业级调优策略之Join优化

Hive拥有多种join算法,包括Common Join,Map Join,Bucket Map Join,Sort Merge Buckt Map Join等

Appreciate(欣赏) 2387

Amesim应用篇-电芯等效电路模型标定

为了使计算模型更加准确,在有电芯实验测试数据的情况下,依据现有的实验数据对Amesim中的电池等效电路模型进行标定。标定的目的是为了获得更加符合项目实际情况的电芯等效电路模型,标定完的电芯可以用于搭建PACK模型,也可以用于其他虚拟实验。本文以充电标定为例,进行介绍。放电标定与充电一致。

2201_75375391的博客 1213

山大软工实践hive(3)-算子做了什么

2021SC@SDUSC 标题 目标 上一篇初步知道算子是什么,这一篇需要深入了解。 各算子 TS 扫描表以获取数据,但实际是Hadoop完成的表数据读取,该算子的作用是把从底层获取的数据传输给子节点处理 SEL 用于投影操作,对应select语句 FIL 用于投影,对应sql 的where语句 RS mapReduce中间有个shuffle过程,实现map结果到reduce任务的映射采集,而RS算子实现了类似shuffle的功能,包括了数据采集(运用hash算法把数据分配给不同的reduce任务),排序方

meloneatingguy的博客 203

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

山大软工实践hive(5)-逻辑优化(1)

2021SC@SDUSC 逻辑优化 逻辑优化,顾名思义,就是通过调整语句的执行顺序,或者优化语句,减少时间、内存上的开销。许多思路与普通数据库的查询优化一样。根据这一阶段输入输出都是DAG,可以认为是用过调整DAG的结构达到目的。 几种方式 参考他人博客有以下几种方式 谓词下推 让选择运算优先执行,比如 select 1 from a join b on a.id=b.id where a.id=5 and b.id>10,会优先执行a.id=5与b.id>10,然后再进行join操作,因为jo

meloneatingguy的博客 881

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

【数据库内核】物理算子之Join算子实现

摘要:本文主要讲述数据库中表与表之间的关联Join算子的设计。主要内容如下: 概述 数据库为什么需要Join Nested Loop Join算法 Merge Sort Join算法 Hash Join算法 三类算法对比情况说明 结论

Night_ZW的博客 2053

Hive优化之Join(三)

Hive优化之Join

weixin_44318460的博客 2788

hive JoinOperator

(1)startGroup:清空各个表的RowContainer (2)processOp:根据tag,把row add到表对应的RowContainer中。 (3)endGroup:RowContainer中的数据进行join并输出。 RowContainer添加数据时:内存中的数据条数是否达到了blockSize(默认是25000)个,如果有,则写入一个临时文件,如果没有放入内存的数...

bupt041137的专栏 505

【OpenGauss源码学习 —— 执行算子(hash join 算子)】

hash join 算子的核心思想是通过哈希表将两个表的数据进行分组和关联,以加速连接操作。函数之间的调用关系确保了哈希表的正确构建、匹配和处理。这个算法对于大规模数据连接操作能够提供高效的性能。

qq_43899283的博客 1554

Apache Flink 漫谈系列 - JOIN 算子

聊什么 在《Apache Flink 漫谈系列 - SQL概览》中我们介绍了JOIN算子的语义和基本的使用方式,介绍过程中大家发现Apache Flink在语法语义上是遵循ANSI-SQL标准的,那么再深思一下传统数据库为啥需要有JOIN算子呢?在实现原理上面Apache Flink内部实现和传统数据库有什么区别呢?本篇将详尽的为大家介绍传统数据库为什么需要JOIN算子,以及JOIN算子在Apache Flink中的底层实现原理和在实际使用中的优化! 什么是JOIN 在《Apache Flink 漫谈

wangchewen的博客 392

hive sql join算子的理解

join的本质就是 根据 左表left,右表right的key字段,进行关联,得到一个结果 底层怎么做的呢? 就是对 左表和右表 的数据 根据key,partition到一个reduce中 然后左右表的相同key的数据,在一个reduce中,需要进行笛卡儿积 所以,如果存在某个key数据倾斜比较严重,那么这个join是会出问题的 这时候需要调整sql了,先增加一个额外的维度进行一次...

tcsbupt的专栏 336

【大数据之Hive】二十二、HQL语法优化之Join优化

Map Join算法可以通过两个只有map阶段的Job完成一个join操作。适用于大表join小表。第一个Job会读取小表数据,将其制作为hash table,并上传至Hadoop分布式缓存(本质上是上传至HDFS)。第二个Job会先从分布式缓存中读取小表数据,并缓存在Map Task的内存中,然后扫描大表数据,在map端即可完成关联操作。Bucket Map Join是对Map Join算法的改进,其打破了Map Join只适用于大表join小表的限制,可用于大表join大表的场景。

阿宁的博客 857

Spark:Join算子

Join是tranformation算子,且有shuffle, 调取join得是对偶元组 如果单独调一个的话我们可以 val rdd1: RDD[Int] = sc.parallelize(List(1,3,4),2) val rdd2: RDD[Int] = sc.parallelize(List(1,4,2),2) val rdd3: RDD[(Int, Null)] = rdd1.map((_, null)) val rdd4: RDD[(Int, Null)] = rdd2.map((_.

weixin_48109576的博客 1610

Map join和Common join详解

利用hive进行join连接操作,相较于MR有两种执行方案,一种为common join,另一种为map join ,map join是相对于common join的一种优化,省去shullfe和reduce的过程,大大的降低的作业运行的时间。 一.先决条件 emp表 hive> select * from emp; OK 369 SMITH CLERK 7902 19

weixin_39216383的博客 1万+

hive org.apache.hadoop.hive.ql.exec.CommonMergeJoinOperator.joinOneGroup 报错

今天hive任务报错,查看tez后台failed 报错原因是 然后关闭优化器再次尝试 set hive.cbo.enable=false; 运行成功。

qq_40771567的博客 995

hive 算子和用户自定义函数 UDF UDAF UDTF

Table of Contents Built-in Operators 关系运算符 算术运算符 逻辑运算符 字符串操作符 复杂类型构造函数 复杂类型上的运算符 Built-in Functions Built-in Aggregate Functions (UDAF) Built-in Table-Generating Functions (UDTF) 使用样例 Bui...

主要写大数据集群一线运维和学习工作经验 902

Spark编程之基本的RDD算子之join,rightOuterJoin, leftOuterJoin

Spark编程之基本的RDD算子之join,rightOuterJoin, leftOuterJoin 1) join def join[W](other: RDD[(K, W)]): RDD[(K, (V, W))] def join[W](other: RDD[(K, W)], numPartitions: Int): RDD[(K, (V, W))] def join[W](other: RD

stevekangpei的博客 3132
上一篇: 山大软工实践hive(3)-算子做了什么
下一篇: 山大软工实践hive(5)-逻辑优化(1)
meloneatingguy
博客等级 码龄7年 1粉丝 15原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值