


三节点 Kafka(4.0版本)集群部署
一.Kafka
1.1 Kafka简介
Kafka 是一个分布式的基于发布/订阅模式的消息队列(Message Queue),主要应用于大数据实时处理领域。
Kafka是一个分布式消息队列。Kafka对消息保存时根据Topic进行归类,发送消息者称为Producer,消息接受者称为Consumer,此外kafka集群有多个kafka实例组成,每个实例(server)称为broker。
1.2 Kafka 基本概念
topic:主题,消息归类的基本单元
partitions:消息分区,通过偏移量 offset 来指定消息的位置,是实现消息的分布式管理的核心机制
replicas:分区副本,每个分区可以有多个副本,一个 leader(读写) 多个 follower(拷贝)
broker 集群:Kafka 由一个或多个 Broker 组成集群,每一个Broker 就是一个 Kafka 实例
ZooKeeper:协调多个 broker,存储元数据
1.3 Kafka架构
一个Kafka 系统架构,会包括 Producer、broker、Cosumer 、 ZooKeeper(集群)等角色
Producer:生产者负责将客户端生产的消息发送到 Kafka 中,可以支持消息的异步发送和批量发送;
broker: Kafka 的核心组件,也是 Kafka 实例,负责消息存储;主题和分区的管理;(生产者和消费者可以连接到集群中的任何一个 Broker 来进行消息的生产和消费)
Consumer:消费者,主动拉取某一个 broker 的消息进行消费
ZooKeeper:协调 Kafka 中的各个 broker 以及存储元数据
Consumer Group:消费者组,多个消费者组成一个组,来消费一个 Topic 中的消息。

1.4 Kafka KRaft 模式
从 Kafka 2.8 开始引入了 KRaft模式,旨在最终取代 ZooKeeper,将元数据管理功能集成到 Kafka Broker 内部,进一步简化部署和运维,对比ZooKeeper优势:
- 简化集群部署和管理 – 不在需要zookeeper,简化了Kafka集群的部署和管理⼯作,资源占⽤更⼩
- 提⾼可扩展性和弹性 – 单个集群中的分区数量可以扩展到数百万个。集群重启和故障恢复时间更短
- 更⾼效的元数据传播 – 基于⽇志、事件驱动的元数据传播提⾼了 Kafka 许多核⼼功能的性能
⽬前KRaft只适⽤于新建集群,将现有的集群从zookeeper模式迁移到KRaft模式,需要等3.5版 本,Kafka 4.0 (2025 年 3⽉发布)将完全删除zookeeper模式,仅⽀持 KRaft 模式。 kafka 4.0文档
所以截止目前 2025 年,除了一些新项目外,Kafka 在大部分项目中用的依旧是 ZooKeeper来作为 Kafka 的协调中心和元数据仓库
参考⽂档:
https://kafka.apache.org/downloads#3.3.1
https://kafka.apache.org/documentation/#kraft
https://developer.confluent.io/learn-kafka/architecture/control-plane/
https://www.confluent.io/blog/why-replace-zookeeper-with-kafka-raft-the-log-of-all-logs/
1.5消息队列模式
(1)点对点
点对点模式是一种一对一的消息传递模型,消费者主动从队列拉取数据,消息一旦消费即从队列中清除。消息生产者将消息发送到队列中,消费者从队列中获取并消费,消息消费后队列中不再保留该消息。同一消息只能被一个消费者处理,队列支持多个消费者竞争获取消息,但每条消息仅被处理一次。
(2)发布订阅模式
发布/订阅模式也称观察者模式,是一种一对多的消息传递模型。消息生产者将消息发布到主题topic,所有订阅该主题的消费者都会接收并消费该消息,消息不会因为被消费而删除。该模式定义了对象间的一对多依赖关系,当一个对象的状态改变时,所有依赖它的对象都会收到通知并自动更新。
发布订阅模式:一条消息被发布到主题后,所有对该主题感兴趣的不同的消费者组都能收到这份消息,并独立进行处理。(即一条消息会被多个消费者消费,前提是这些消费者不能在同一个组)
点对点模式:就是 1 对 1,一条消息只需要被一个消费者消费。所有想要消费这个消息的消费者,都必须指定同一个 group.id,也就是让这些消费者在同一个消费者组。那么只要在一个消费者组,就只会有一个消费者会消费这条消息
综上:只需要将订阅消息的消费者,通过设置 group.id 指定消费者组就能实现,如果这些消费者在一个组里就是点对点,如果不在一个组就是发布订阅模式

二.Kafka部署
2.1 jdk安装
下载安装包:
wget https://download.oracle.com/java/21/latest/jdk-21_linux-x64_bin.tar.gz
解压安装包:
将下载的 .tar.gz 文件解压到指定目录,例如 /usr/local/java:
sudo mkdir -p /usr/local/java

sudo tar -zxvf jdk-21_linux-x64_bin.tar.gz -C /usr/local/java
创建符号链接
为 JDK 创建一个符号链接,方便后续升级时切换版本:
sudo ln -s /usr/local/java/jdk-21.0.8 /usr/local/java/jdk21
编辑全局环境变量文件:
使用 vim 或其他文本编辑器编辑 /etc/profile 文件:
sudo vi /etc/profile
在文件末尾添加以下内容:
export JAVA_HOME=/usr/local/java/jdk-21.0.8

export PATH=$JAVA_HOME/bin:$PATH
使环境变量生效:
source /etc/profile
验证版本:
java -version

2.2 部署三节点Kafka4.0
#关闭服务器的防火墙

systemctl stop firewalld

#关闭服务器防火墙的开机自启

systemctl disable firewalld
下载并解压 Kafka(所有节点):
wget https://downloads.apache.org/kafka/4.0.0/kafka_2.13-4.0.0.tgz

tar -xzf kafka_2.13-4.0.0.tgz

cd kafka_2.13-4.0.0
复制默认配置文件(所有节点):
cp config/server.properties config/server1.properties

cp config/server.properties config/server2.properties

cp config/server.properties config/server3.properties
在节点1 (10.8.15.153) 上执行的命令:
# 生成集群ID

CLUSTER_ID=$(./bin/kafka-storage.sh random-uuid)

echo "生成的集群ID: $CLUSTER_ID"

节点 1(IP:10.8.15.153)
编辑 config/server1.properties:
node.id=1
controller.quorum.bootstrap.servers=10.8.15.153:9093,10.8.15.156:9093,10.8.15.157:9093
CLUSTER_ID="JR9rp11nR9mzvBB-UhnCmw"
process.roles=broker,controller
listeners=PLAINTEXT://10.8.15.153:9092,CONTROLLER://10.8.15.153:9093
controller.quorum.voters=1@10.8.15.153:9093,2@10.8.15.156:9093,3@10.8.15.157:9093
log.dirs=/tmp/kafka-logs-1
advertised.listeners=PLAINTEXT://10.8.15.153:9092,CONTROLLER://10.8.15.153:9093
节点 2(IP:10.8.15.156)
编辑 config/server2.properties:
node.id=2
controller.quorum.bootstrap.servers=10.8.15.153:9093,10.8.15.156:9093,10.8.15.157:9093
CLUSTER_ID="JR9rp11nR9mzvBB-UhnCmw"
process.roles=broker,controller
listeners=PLAINTEXT://10.8.15.156:9092,CONTROLLER://10.8.15.156:9093
controller.quorum.voters=1@10.8.15.153:9093,2@10.8.15.156:9093,3@10.8.15.157:9093
log.dirs=/tmp/kafka-logs-2
advertised.listeners=PLAINTEXT://10.8.15.156:9092,CONTROLLER://10.8.15.156:9093
节点 3(IP:10.8.15.157)
编辑 config/server3.properties:
node.id=3
controller.quorum.bootstrap.servers=10.8.15.153:9093,10.8.15.156:9093,10.8.15.157:9093
CLUSTER_ID="JR9rp11nR9mzvBB-UhnCmw"
process.roles=broker,controller
listeners=PLAINTEXT://10.8.15.157:9092,CONTROLLER://10.8.15.157:9093
controller.quorum.voters=1@10.8.15.153:9093,2@10.8.15.156:9093,3@10.8.15.157:9093
log.dirs=/tmp/kafka-logs-3
advertised.listeners=PLAINTEXT://10.8.15.157:9092,CONTROLLER://10.8.15.157:9093
在主节点生成 UUID:
./bin/kafka-storage.sh random-uuid

UUID 执行格式化命令
./bin/kafka-storage.sh format -t 1KyYLShXTXSqPG9_B5YFkw -c /home/bigdata/kafka_2.13-4.0.0/config/server1.properties

./bin/kafka-storage.sh format -t 1KyYLShXTXSqPG9_B5YFkw -c /home/bigdata/kafka_2.13-4.0.0/config/server2.properties

./bin/kafka-storage.sh format -t 1KyYLShXTXSqPG9_B5YFkw -c /home/bigdata/kafka_2.13-4.0.0/config/server3.properties

分别启动三节点的Kafka:
./bin/kafka-server-start.sh -daemon /home/bigdata/kafka_2.13-4.0.0/config/server1.properties

./bin/kafka-server-start.sh -daemon /home/bigdata/kafka_2.13-4.0.0/config/server2.properties

./bin/kafka-server-start.sh -daemon /home/bigdata/kafka_2.13-4.0.0/config/server3.properties
jps查看:
节点1(10.8.15.153):

节点2(10.8.15.156):

节点3(10.8.15.157):

检查Kafka集群的元数据仲裁(quorum)状态:
./bin/kafka-metadata-quorum.sh --bootstrap-server 10.8.15.153:9092 describe --status

验证集群状态:
./bin/kafka-topics.sh --bootstrap-server 10.8.15.153:9092 --list
2.3 解决集群ID不一致
如果遇见如下错误

关闭所有服务:
# 停止所有节点
bin/kafka-server-stop.sh
节点1 (主节点:10.8.15.153) 上执行的命令:
# 在 153 节点上,确保删除的是正确的路径!!!
rm -rf /tmp/kafka-logs-1/*

# 生成集群ID
CLUSTER_ID=$(./bin/kafka-storage.sh random-uuid)
echo "生成的集群ID: $CLUSTER_ID"

节点2 (10.8.15.156) 上执行的命令:
# 设置环境变量:集群ID(从节点1获取)
export CLUSTER_ID="m7l0Tut3TgWGTv-TTcg3sg"

# 清理日志目录(!!!确保使用正确的路径!!!)
rm -rf /tmp/kafka-logs-2/*

# 创建日志目录(如果不存在)
mkdir -p /tmp/kafka-logs-2

# 格式化存储目录(使用节点2的配置文件)
./bin/kafka-storage.sh format \
    -t "$CLUSTER_ID" \
    -c ./config/server2.properties \
    --ignore-formatted  # 忽略已格式化的目录

# 验证生成的meta.properties文件
echo "验证节点2的meta.properties:"
cat /tmp/kafka-logs-2/meta.properties

# 启动节点2(前台启动以便查看日志)
./bin/kafka-server-start.sh ./home/bigdata/kafka_2.13-4.0.0/config/server2.properties

节点3 (10.8.15.157) 上执行的命令:
# 设置环境变量:集群ID(与节点1、2相同)
export CLUSTER_ID="m7l0Tut3TgWGTv-TTcg3sg"

# 清理日志目录(!!!确保使用正确的路径!!!)
rm -rf /tmp/kafka-logs-3/*

# 创建日志目录(如果不存在)
mkdir -p /tmp/kafka-logs-3

# 格式化存储目录(使用节点3的配置文件)
./bin/kafka-storage.sh format \
    -t "$CLUSTER_ID" \
    -c ./config/server3.properties \
    --ignore-formatted  # 忽略已格式化的目录

重启三节点的kafka:
检查Kafka集群的元数据仲裁(quorum)状态:
./bin/kafka-metadata-quorum.sh --bootstrap-server 10.8.15.153:9092 describe --status

验证集群状态:
./bin/kafka-topics.sh --bootstrap-server 10.8.15.153:9092 --list
2.4 测试
2.4.1 终端直接测试:
创建测试主题:
./bin/kafka-topics.sh --create \
  --bootstrap-server 10.8.15.153:9092 \
  --replication-factor 3 \
  --partitions 1 \
  --topic test-topic

发送测试消息:
./bin/kafka-console-producer.sh --bootstrap-server 10.8.15.153:9092 --topic test-topic

消费测试消息:
./bin/kafka-console-consumer.sh --bootstrap-server 10.8.15.153:9092 --topic test-topic --from-beginning
2.4.2编写python脚本测试
安装库:
pip install kafka-python
2.4.2.1 生产者脚本(producer.py):
from kafka import KafkaProducer
import json

# 初始化生产者
producer = KafkaProducer(
    bootstrap_servers=['10.8.15.153:9092'],  # Kafka集群地址
    value_serializer=lambda v: json.dumps(v).encode('utf-8')  # 将消息序列化为JSON格式
)

# 发送消息
message = {'key': 'value', 'timestamp': '2025-07-11'}
producer.send('test-topic', value=message)
producer.flush()  # 确保消息发送完成
producer.close()

producer.close()

print("消息发送成功!")
2.4.2.2 消费者脚本(consumer.py):
from kafka import KafkaConsumer
import json

# 初始化消费者
consumer = KafkaConsumer(
    'test-topic',
    bootstrap_servers=['10.8.15.153:9092'],  # Kafka集群地址
    auto_offset_reset='earliest',  # 从最早的消息开始消费
    enable_auto_commit=True,  # 自动提交偏移量
    group_id='test-group',  # 消费者组ID
    value_deserializer=lambda m: json.loads(m.decode('utf-8'))  # 将JSON格式消息反序列化
)

# 消费消息
print("开始消费消息...")
for message in consumer:
    print(f"收到消息: {message.value}")

consumer.close()
2.4.2.3 Kafka 综合测试
from kafka import KafkaProducer, KafkaConsumer, KafkaAdminClient
from kafka.admin import NewTopic
from kafka.errors import KafkaError, TopicAlreadyExistsError
import json
import time
import random
import threading

# 配置信息
BOOTSTRAP_SERVERS = ['10.8.15.153:9092', '10.8.15.156:9092', '10.8.15.157:9092']
TEST_TOPIC = 'performance_test'
TEST_GROUP = 'test_consumer_group'


def create_test_topic():
    """创建测试主题(如果不存在)"""
    admin = KafkaAdminClient(bootstrap_servers=BOOTSTRAP_SERVERS)

    try:
        topic = NewTopic(
            name=TEST_TOPIC,
            num_partitions=6,
            replication_factor=3,
            topic_configs={'retention.ms': '172800000'}  # 保留2天
        )
        admin.create_topics([topic])
        print(f"主题 {TEST_TOPIC} 创建成功")
    except TopicAlreadyExistsError:
        print(f"主题 {TEST_TOPIC} 已存在")
    finally:
        admin.close()


def producer_performance_test():
    """生产者性能测试"""
    producer = KafkaProducer(
        bootstrap_servers=BOOTSTRAP_SERVERS,
        value_serializer=lambda v: json.dumps(v).encode('utf-8'),
        acks='all',
        compression_type='gzip',
        retries=5
    )

    start_time = time.time()
    msg_count = 0

    for i in range(1000):
        payload = {
            "id": i,
            "timestamp": time.time(),
            "metric": random.uniform(0, 100),
            "source": f"server-{random.randint(1, 10)}",
            "is_alert": random.random() > 0.9
        }

        future = producer.send(
            TEST_TOPIC,
            value=payload,
            key=str(i % 10).encode()  # 按key分区
        )

        # 异步处理发送结果
        future.add_callback(
            lambda metadata: print(f"发送成功: 分区={metadata.partition} 偏移量={metadata.offset}")
        ).add_errback(
            lambda exc: print(f"发送失败: {exc}")
        )

        msg_count += 1

        # 每100条刷新一次
        if i % 100 == 0:
            producer.flush()

    producer.flush()
    elapsed = time.time() - start_time
    print(f"\n生产者测试完成: 发送 {msg_count} 条消息, 耗时 {elapsed:.2f} 秒, "
          f"吞吐量 {msg_count / elapsed:.2f} msg/s")


def consumer_group_test():
    """消费者组测试"""

    def start_consumer(consumer_id):
        consumer = KafkaConsumer(
            TEST_TOPIC,
            bootstrap_servers=BOOTSTRAP_SERVERS,
            group_id=TEST_GROUP,
            auto_offset_reset='earliest',
            enable_auto_commit=False,
            value_deserializer=lambda x: json.loads(x.decode('utf-8')),
            consumer_timeout_ms=10000
        )

        print(f"消费者 {consumer_id} 启动...")
        try:
            for message in consumer:
                print(f"消费者 {consumer_id} [分区 {message.partition}]: "
                      f"偏移量={message.offset} 值={message.value}")
                # 模拟处理时间
                time.sleep(random.uniform(0.01, 0.1))
                consumer.commit()
        finally:
            consumer.close()
            print(f"消费者 {consumer_id} 关闭")

    # 启动3个消费者线程
    threads = []
    for i in range(3):
        t = threading.Thread(target=start_consumer, args=(i,))
        t.start()
        threads.append(t)
        time.sleep(1)  # 错开启动时间

    for t in threads:
        t.join()


def transaction_test():
    """事务消息测试(精确一次语义)"""
    try:
        producer = KafkaProducer(
            bootstrap_servers=BOOTSTRAP_SERVERS,
            value_serializer=lambda v: json.dumps(v).encode('utf-8'),
            transactional_id='test_transaction',
            # 添加安全协议配置(如果集群需要)
            # security_protocol='SASL_PLAINTEXT',
            # sasl_mechanism='PLAIN',
            # sasl_plain_username='admin',
            # sasl_plain_password='admin-secret',
            # 增加超时时间
            request_timeout_ms=15000,
            retries=5
        )

        # 初始化事务 - 关键步骤!
        producer.init_transactions()
        print("事务初始化成功")

        try:
            print("开始事务...")
            producer.begin_transaction()

            # 发送业务消息
            for i in range(5):
                msg = {"tx_id": i, "data": f"transaction_{i}"}
                producer.send(TEST_TOPIC, value=msg)
                print(f"事务消息发送: {msg}")

            # 提交事务
            print("提交事务...")
            producer.commit_transaction()
            print("事务提交成功")

        except KafkaError as e:
            print(f"事务操作失败: {e}")
            # 尝试中止事务
            try:
                producer.abort_transaction()
                print("事务已中止")
            except Exception as abort_err:
                print(f"中止事务失败: {abort_err}")
        finally:
            producer.close()

    except Exception as init_err:
        print(f"事务初始化失败: {init_err}")


def get_topic_metadata():
    """获取主题元数据"""
    admin = KafkaAdminClient(bootstrap_servers=BOOTSTRAP_SERVERS)

    # 获取所有主题
    topics = admin.list_topics()
    print("\n集群主题列表:")
    for topic in topics:
        print(f" - {topic}")

    # 获取特定主题详情
    if TEST_TOPIC in topics:
        partitions = admin.describe_topics([TEST_TOPIC])
        print(f"\n主题 {TEST_TOPIC} 详情:")
        for p in partitions[0]['partitions']:
            print(f"分区 {p['partition']}: 领导者={p['leader']} 副本={p['replicas']} ISR={p['isr']}")

    admin.close()


def monitor_consumer_group():
    """监控消费者组"""
    admin = KafkaAdminClient(bootstrap_servers=BOOTSTRAP_SERVERS)

    # 获取消费者组列表
    groups = admin.list_consumer_groups()
    print("\n消费者组列表:")
    for group in groups:
        print(f" - {group[0]} ({group[1]})")

    # 获取特定消费者组详情
    if any(TEST_GROUP in g for g in groups):
        group_details = admin.describe_consumer_groups([TEST_GROUP])
        print(f"\n消费者组 {TEST_GROUP} 详情:")
        for member in group_details[0].members:
            print(f"成员 {member.member_id}:")
            print(f"  客户端ID: {member.client_id}")
            print(f"  主机: {member.client_host}")
            print(f"  分配分区: {member.assignment}")

    admin.close()


if __name__ == "__main__":
    print("=" * 50)
    print("开始 Kafka 综合测试")
    print("=" * 50)

    create_test_topic()

    print("\n[阶段1] 生产者性能测试")
    producer_performance_test()

    print("\n[阶段2] 消费者组测试")
    consumer_group_test()

    print("\n[阶段3] 事务消息测试")
    transaction_test()

    print("\n[阶段4] 元数据检查")
    get_topic_metadata()

    print("\n[阶段5] 消费者组监控")
    monitor_consumer_group()

    print("\n测试完成!")
脚本介绍
(1)脚本名称
kafka_full_test.py
(2) 运行环境
- 执行路径: D:\pycharm\PyCharm 2024.2.4\pythonProject1\kafka\kafka_full_test.py
- 解释器:Python 3.8(位于 D:\pycharm\PyCharm 2024.2.4\python3.8.venv\Scripts\python.exe )
- 测试对象:Kafka 集群(主题 performance_test )
(3)核心功能
该脚本用于对 Kafka 集群的核心功能与性能进行全面测试,涵盖 5 个关键阶段:
- 生产者性能测试:验证消息发送效率与分区分发能力;
- 消费者组测试:验证多消费者协同消费、分区分配与消息解析能力;
- 事务消息测试:验证事务消息的初始化、发送与提交功能;
- 元数据检查:验证集群主题、分区及副本配置的正确性;
- 消费者组监控:查看集群中活跃的消费者组信息。
(4)测试结果总结
- 阶段 1:生产者性能测试
-
测试内容:向主题 performance_test 发送消息,验证生产者吞吐量与分区分发逻辑。
-
关键结果:
- 共发送 1000 条消息,耗时 0.22 秒,吞吐量达4569.43 msg/s;(第一次测试为耗时 2.06 秒,吞吐量达485.81 msg/s)

- 消息均匀分发至 6 个分区(分区 0-5),各分区偏移量连续递增(例如分区 3 偏移量从 302 增至 601,分区 5 从 200 增至 399),说明分区负载均衡正常。
- 共发送 1000 条消息,耗时 0.22 秒,吞吐量达4569.43 msg/s;(第一次测试为耗时 2.06 秒,吞吐量达485.81 msg/s)
- 阶段 2:消费者组测试
-
测试内容:启动 3 个消费者组成消费组,验证分区分配、消息消费完整性与内容解析能力。
-
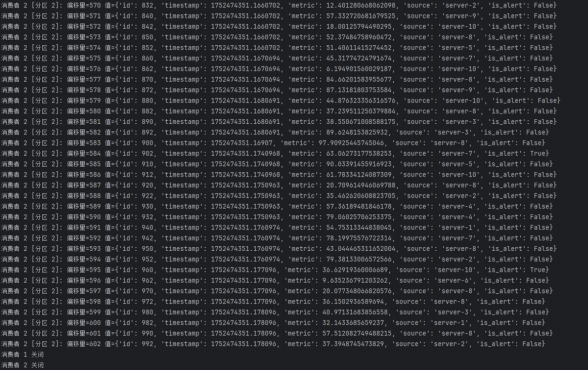
关键结果:
-
消费者分区分配:消费者 0 负责分区 5、4;消费者 1 负责分区 3、2;消费者 2 负责分区 0、1,分配逻辑合理;
-
消息消费完整:所有发送的消息均被正确消费,包含事务消息(如 {‘tx_data’: ‘transaction_0’} )和业务消息(含 id 、 timestamp 、 metric 、 source 、 is_alert 等字段);
-
事务消息:如
{‘tx_data’: ‘transaction_0’}
- tx_data :事务数据字段,存储事务相关的标识信息(如事务 ID)。
-
业务消息:如
{‘id’: 1, ‘timestamp’: 1752463717.3170567, ‘metric’: 75.68237032259279, ‘source’: ‘server-10’, ‘is_alert’: False}
- id :消息唯一标识,用于区分不同消息。
- timestamp :消息生成的时间戳(Unix 时间戳,精确到毫秒),记录消息产生的时间。
- metric :指标值,通常为数值型数据(如服务器性能指标)。
- source :消息来源,如 “server-10” 表示消息来自编号为 10 的服务器。
- is_alert :告警标识(布尔值), True 表示该消息触发告警, False 表示正常消息。
-
-
消费状态正常:消费者均成功启动并关闭,无消息丢失或重复消费。
-
- 阶段 3:事务消息测试
-
测试内容:验证 Kafka 事务消息的初始化、发送与提交机制。
-
关键结果:

- 事务初始化成功,发送 5 条事务消息( tx_id 0-4,数据为 transaction_0 至 transaction_4 );
- tx_id :事务唯一标识,用于关联同一事务中的多条消息。
- data :事务具体数据内容。
- 事务提交成功,无异常报错,说明事务功能正常。
- 阶段 4:元数据检查
-
测试内容:验证 Kafka 集群主题、分区及副本配置的正确性。
-
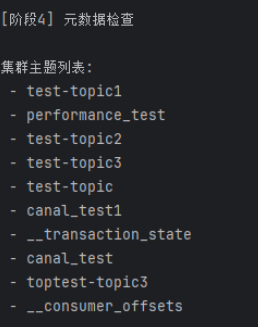
关键结果:
-
集群主题列表:包含 test-topic1 、 performance_test 、 __consumer_offsets 等 10 个主题,符合预期;
-
主题
performance_test
详情:
- 共 6 个分区(0-5);
- 每个分区均配置 3 个副本,领导者(Leader)分布在不同节点,ISR(同步副本)包含所有副本(如分区 5:领导者 = 1,副本 =[1,2,3],ISR=[1,2,3]),集群副本同步正常。
-
- 阶段 5:消费者组监控
-
测试内容:查看集群中活跃的消费者组信息。
-
关键结果:
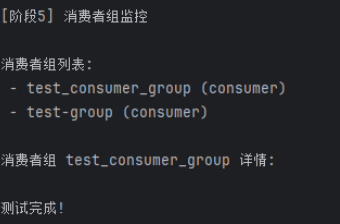
- 消费者组列表:包含 test_consumer_group 和 test-group ,均为 consumer 类型,与测试配置一致。
 409


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


