


AI网文写作实验笔记(三):三轮1541篇样本测完,约束到底能管住AI的笔吗?
文章目录
这篇文章会回答三个问题:
- 在提示词里堆约束,3条、12条、50条,AI味到底能降多少?哪类约束在干活?
- 50条约束丢下去,模型真的在遵守50条,还是只挑了容易的做做样子?
- 100篇无约束基线揭示了模型怎样的默认写作模式?
一、 承接上一篇
承接AI网文写作实验笔记(二):跑多少次,才敢说提示词是真的有用?。
Part 2 我们测清了两件事:AI输出的随机波动有多大(最好和最差差3.4倍),以及给AI喂多少上文最合适(300字摘要+上一章,事实错误率最低)。
有了这个基线,Part 3 我们进入提示词工程最核心的战场:约束条件。
平时写文时,我们总喜欢在提示词里堆满要求–“不准用突然”“不准写瞳孔骤缩”“对话必须单独成段”“每段不超过3行”……这些约束加得越多,到底会让AI写得越好,还是越死板?3条和50条,效果差在哪?禁词、技法、格式,哪类才是真正在干活的?
为了搞清楚这些问题,我跑了三轮实验:
| 轮次 | 样本数 | 约束池 | 测什么 | 核心发现 |
|---|---|---|---|---|
| 第一轮 | 300篇 | 77条 | 约束数量梯度(3/12/50条) | 12条性价比最高,50条事实错误率翻倍 |
| 第二轮 | 320篇 | 95条 | 三类约束消融(禁词/技法/格式) | 禁词是摆设,技法是引擎,格式效果存疑 |
| 第三轮 | 821篇+100基线 | 45条 | 遵从率断点(1~45条) | 遵从率90%是假象,5条技法就崩 |
三轮合计1541篇。
⚠️ 前置说明: 本文所有实验均在 温度0.7、deepseek-v4-flash模型、同一个场景、单次生成任务下进行。不同模型、不同温度、不同任务的结论可能不同,请勿盲目外推。
二、 第一轮:约束越多,AI味越低?
第一轮实验很简单:把约束数量做成梯度,看AI味怎么变。
先跑了5组pilot(A/B/C/D/E对应3/6/12/25/50条,各12篇),确认趋势后挑3个代表点做full run:3条(A)、12条(C)、50条(E),各100篇,共300篇。编号沿用pilot标签,所以没有B和D。每次抽到的约束内容固定不变,确保只有一个变量。
| 组 | 约束条数 | AI腔/千字 | 禁用词/千字 | 事实错误率 |
|---|---|---|---|---|
| A | 3条 | 12.73 | 0.57 | 26% |
| C | 12条 | 9.41 | 0.31 | 37% |
| E | 50条 | 9.85 | 0.22 | 56% |
指标说明: AI腔/千字 = 用自动检测脚本扫描每篇文本,统计命中的AI套话数量(如"眼中闪过一丝"“嘴角勾起一抹”“心中暗道”"仿佛X般"等共14类、上百个模式),除以总字数乘以1000。12.73意味着平均每千字匹配到12.73个AI套话。禁用词/千字同理,统计的是约束池中明确禁止的词汇出现次数。两个指标越低越好。
事实错误率: 由LLM自动检测,对照设定文件逐篇扫描。角色身份、地点、能力、关键设定信息与原文不一致算错误;风格漂移、措辞偏好不算。
约束越多,AI腔确实越低:从3条的12.73降到12条的9.41,降幅26%。但50条只比12条多了0.44,基本到顶了。
禁用词/千字同步递减:0.57→0.31→0.22。约束越多,单个禁用词被使用的概率越低。这说明模型确实在努力遵守禁令,只是遵守禁令不等于改善风格。
但事实错误率同步上升:从3条的26%涨到50条的56%,翻了一倍多。约束越多,模型注意力被占用,设定就越容易写错。
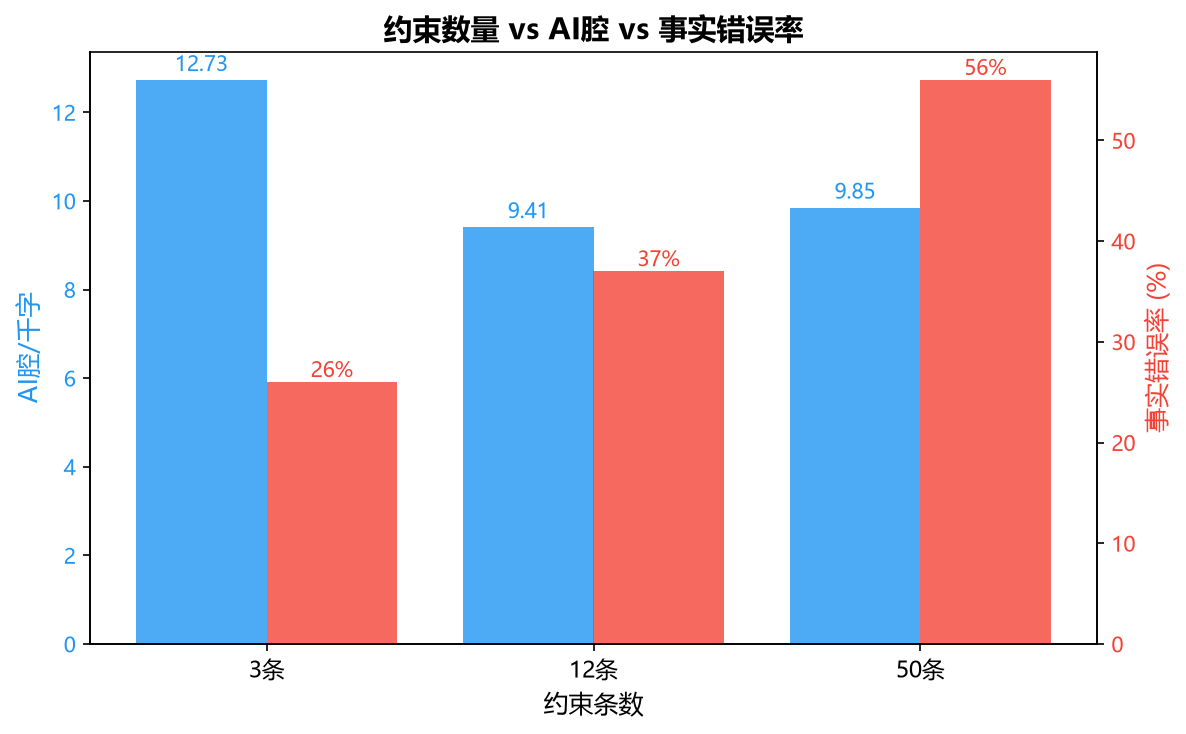
💡 实操提示: 12条左右是性价比最高的区间,AI腔降了26%但事实错误率只涨了11个百分点。加到50条,AI腔没进一步改善,事实错误率却暴涨。注意这个结论基于R1的77条混合约束池,不是"任意12条约束"都有效–下一轮会拆解哪类约束在起作用。
第一轮回答了"加多少条"的问题,但没回答"加什么类型"的问题。50条约束里混了禁词、技法、格式三类,到底是哪类在起作用?
三、 第二轮:哪类约束在干活?
第二轮做消融实验:每次去掉一类约束,看效果变差多少。8组×2场景×20篇=320篇,约束池95条(负向40+正向35+工程20),分三类:
| 类型 | 条数 | 说明 | 示例 |
|---|---|---|---|
| 负向(禁词) | 40 | “不准用什么” | 不准用"突然"开头、不准写"瞳孔骤缩" |
| 正向(技法) | 35 | “必须怎么做” | 必须用主角视角写、必须用动作描写替代"他说" |
| 工程(格式) | 20 | “硬指标” | 不准用感叹号、段落不超3行 |
约束池的JSON结构示例:
{
  "negative": [
    {"id": "neg_01", "rule": "不准用'突然'开头", "type": "forbidden_word"},
    {"id": "neg_02", "rule": "不准写'瞳孔骤缩'", "type": "forbidden_phrase"}
  ],
  "positive": [
    {"id": "pos_01", "rule": "必须用主角视角写", "type": "perspective"},
    {"id": "pos_02", "rule": "必须用动作描写替代'他说'", "type": "technique"}
  ],
  "engineering": [
    {"id": "eng_01", "rule": "不准用感叹号", "type": "punctuation"},
    {"id": "eng_02", "rule": "段落不超3行", "type": "format"}
  ]
}
评估方法是人工打分(0-100分,越低越好),由我本人逐篇评分。不是双盲实验,也没有第二评分人交叉校准,所以分数有主观偏差。但消融实验比的是组间相对差异,只要评分标准一致,方向性结论可靠。
消融结果:
| 消融组 | 去掉的是 | 均分 | vs 全约束 | 结论 |
|---|---|---|---|---|
| 全约束 | - | 51.5 | 基线 | - |
| 去禁词 | 40条禁词 | 51.9 | +0.4 | 几乎无影响 |
| 去技法 | 35条技法 | 61.5 | +10.0 | 影响最大 |
| 去格式 | 20条格式 | 50.3 | -1.2 | 效果存疑 |
三个发现:
1. 禁词是摆设。 在本实验的模型和场景下,去掉40条禁词,AI味几乎不变(仅上升0.4分)。“不准用突然”“不准写瞳孔骤缩”–这些禁词清单的主要作用是合规审计,对降低AI味没有帮助。模型被明确告知"不要用某个词"时,避免单个词是它最擅长的事,禁了之后违反率直接归零,但风格没改善。
2. 技法是核心引擎。 在本实验的模型和场景下,去掉35条技法约束,AI味暴增10分,是唯一有实质影响的类别。“必须用主角视角写”“必须用动作描写替代对话提示语”–这些"必须怎么做"的指令,才是真正在干活的。
3. 格式未发现正面作用。 在本实验的模型和场景下,去掉20条格式约束,AI味反而降低1.2分(效应量小,单人评分,待验证)。“不准用感叹号”“段落不超3行”–模型为了遵守格式,可能被迫写出更机械的句子。
💡 实操提示: 以后写提示词,把精力放在"必须怎么做"(技法约束)上,别花时间在"不准用什么"(禁词清单)上。禁词管底线,不管质量。
四、 第三轮:模型能遵守多少条约束?
前两轮测的是"约束对AI味的影响",第三轮换一个角度:模型实际遵守了多少条约束? 50条约束丢下去,模型是真的在努力遵守50条,还是只挑了几条容易的做做样子?
为什么换了一个约束池?
R2的95条池子里混了大量送分题(模型天然遵守的约束)和不可能题(模型根本做不到的约束),用这个池子测遵从率,数字会失真。R3重新设计了45条约束池(每类15条),并用100篇无约束基线逐条验证每条约束的难度,确保每条都有检测意义。
实验设计
7组×多梯度×15篇=821篇,外加100篇无约束基线。7组分别是:禁词单组、技法单组、格式单组、禁词+技法、禁词+格式、技法+格式、全混合。单组约束数上限15条,双类混合上限30条,全混合上限45条。
结果 1:遵从率看起来不错–但这是假象
遵从率(未违反约束数÷总约束数)是标准指标。以全混合组为例:
| 约束数 | 1条 | 3条 | 5条 | 8条 | 10条 | 15条 | 20条 | 30条 | 45条 |
|---|---|---|---|---|---|---|---|---|---|
| 遵从率 | 93% | 100% | 93% | 90% | 98% | 99% | 85% | 89% | 90% |
看起来不错:全混合组加到45条还有90%。
但1条遵从率93%、3条反而100%,这个反直觉的现象需要解释。 g1抽到的1条约束是"禁嘴角",15篇里有1篇违反(93%);g3抽到的3条约束全是送分题(不引入新配角、禁"只见/忽见"、首200字含基本信息),0篇违反(100%)。约束内容不同,难度不同,条数少时抽样波动很大。这不是数据造假,是单条约束的难度差异没有被条数稀释。
更根本的问题是:90%遵从率是被无效约束稀释出来的。 45条约束里,模型天然就遵守一大半–比如"不准用恐怖如斯",模型根本不用这个词。这些送分题把分母撑大,制造了"90%遵从率"的假象。
结果 2:全遵守率揭示真相,约束难度双峰分布
换一个更诚实的指标:全遵守率,也就是"15篇里有几篇完全没有违反任何约束"。同时,对45条约束在100篇基线上逐条验证难度,找出遵从率假象的根源。
全遵守率(0违反样本占比):
| 组 | 1条 | 3条 | 5条 | 8条 | 10条 | 15条 | 20条 | 30条 | 45条 |
|---|---|---|---|---|---|---|---|---|---|
| 禁词 | 100% | 87% | 87% | 80% | 80% | 53% | |||
| 技法 | 100% | 93% | 20% | 0% | 0% | 0% | |||
| 格式 | 100% | 87% | 60% | 93% | 73% | 47% | |||
| 全混合 | 93% | 100% | 73% | 27% | 80% | 86% | 0% | 0% | 0% |
单类组(禁词/技法/格式)最多15条约束,所以20条以上没有数据。混合组(禁词+技法等)数据篇幅所限不展开,趋势与全混合组一致。表中全混合组1条93%->3条100%的反直觉现象见结果1的解释。
技法组8条约束时全遵守率0%–15篇里没有1篇能同时满足8条技法约束。技法组5条时全遵守率就只剩20%–15篇里只有3篇做到了。全混合组45条约束时遵从率90%,但全遵守率0%,平均每篇违反4.6条。
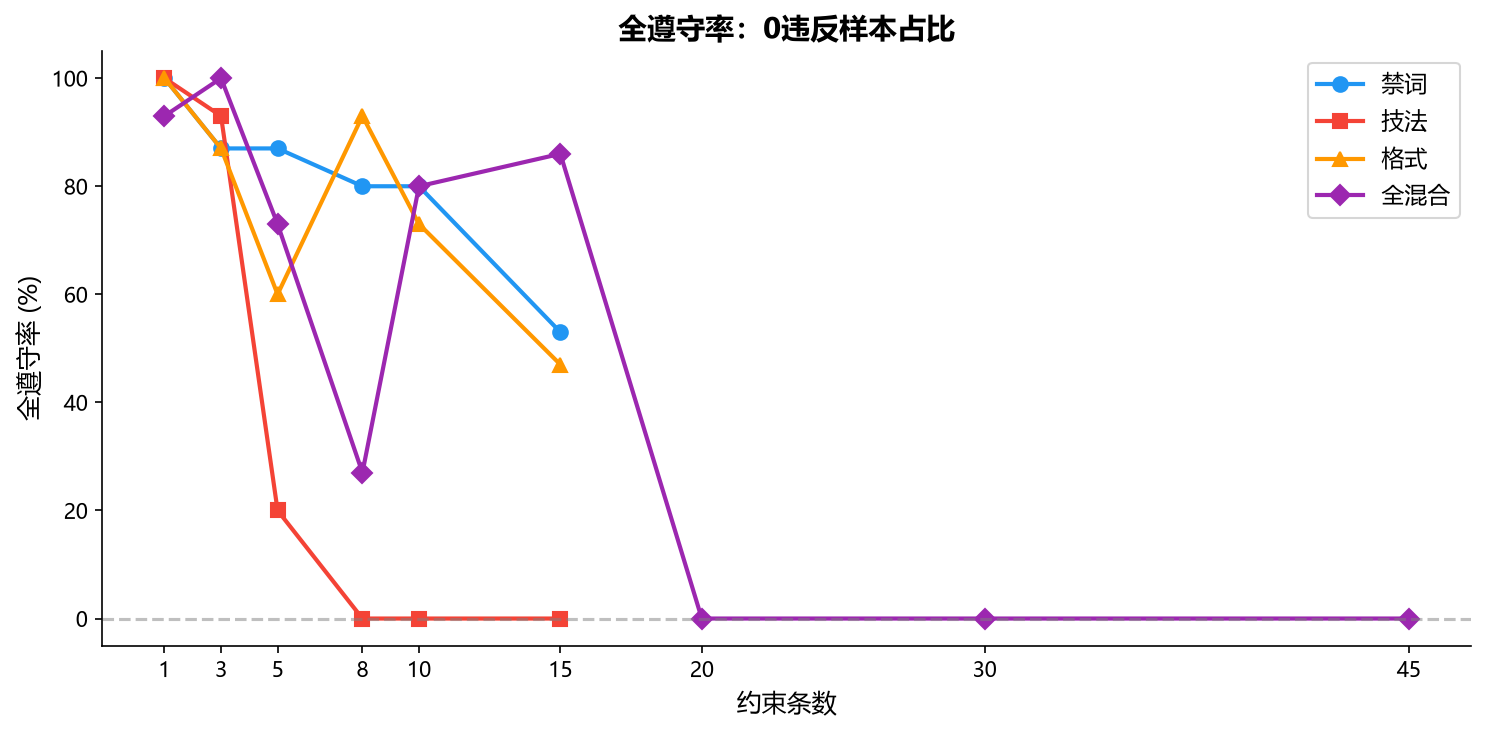
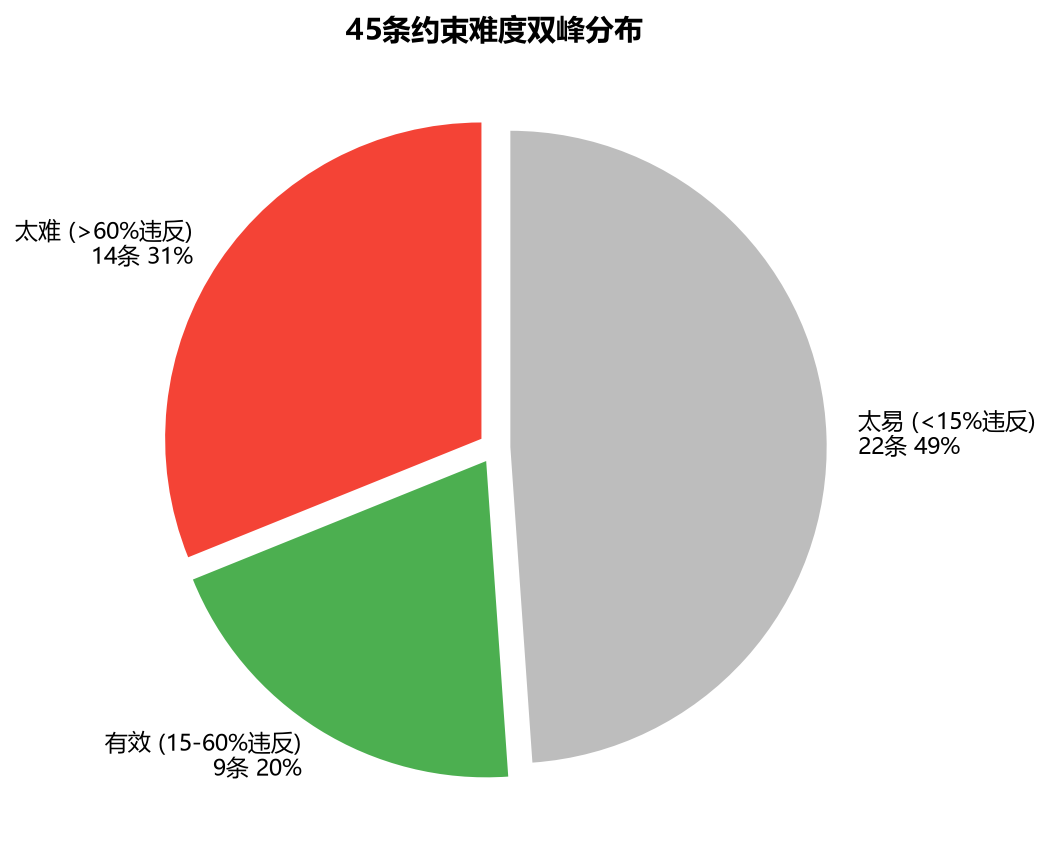
为什么遵从率和全遵守率差距这么大? 查45条约束在100篇基线上的违反率,发现严重的双峰分布:
| 难度 | 约束数 | 占比 | 违反率区间 | 说明 |
|---|---|---|---|---|
| 太难 | 14条 | 31% | >60% | 当前提示词下做不到 |
| 有效 | 9条 | 20% | 15-60% | 有检测意义 |
| 太易 | 22条 | 49% | <15% | 模型天然满足,约束等于摆设 |
近一半约束是送分题,真正有检测意义的只有9条。45条约束的"90%遵从率"里,22条送分题贡献了大半–模型不是在遵守45条约束,是在遵守22条不需要遵守的约束加上9条有效约束中的大部分。
太难约束的检测逻辑伪代码:
def check_difficulty(constraint, baseline_texts):
    """在100篇无约束基线上检测每条约束的违反率"""
    violations = 0
    for text in baseline_texts:
        if violates(text, constraint):
            violations += 1
    rate = violations / len(baseline_texts)
    if rate > 0.6:
        return "太难"    # 模型根本做不到
    elif rate < 0.15:
        return "太易"    # 模型天然满足
    else:
        return "有效"    # 有检测意义
太难的14条是模型的能力边界,典型代表:
| 约束 | 基线违反率 | 为什么做不到 |
|---|---|---|
| 开篇首句为动作 | 100% | 模型默认环境描写开篇 |
| 对话占比≥15% | 97% | 模型默认极少写对话 |
| 仿佛/像是/如同 | 92% | 模型靠比喻填充描写 |
| 至少1段超过4句 | 87% | 模型默认每段2.4句 |
| 此刻/瞬间/骤然 | 86% | 模型靠时间标签推进节奏 |
| X微微Y句式 | 82% | 模型核心动作描写模板 |
| 至少1处情绪词 | 81% | 模型不写情绪 |
| X缓缓Y句式 | 77% | 模型核心动作描写模板 |
| 至少1处心理描写 | 64% | 模型用微动作替代心理 |
这些不是"约束太难",是在当前零示例提示词下模型做不到。不管加多少条、在什么场景下,违反率都恒定在60-100%。
太易的22条是送分题。禁"嘴角"(基线2%)、禁"大喝一声"(0%)……模型天然就遵守,加上去只是撑大遵从率分母。
💡 实操提示: 如果你的约束清单里有很多"不准用XX词"类型的条目,可以检查一下:不加约束时模型会用这些词吗?如果不用,那这些约束就是摆设,删掉不影响效果,留着只会让你误以为"遵从率很高"。
五、 模型到底在写什么?
三轮实验测的都是"约束加进去之后怎样",但还有一个更基础的问题:不加约束时,模型默认在写什么?
用第三轮的100篇无约束基线做词频统计。不用921篇混合数据,因为821篇带约束样本被明确禁止使用"微微"“仿佛”"此刻"等词,混进去统计会系统性拉低这些词的真实频率。
边界说明: 没有人类对照组。这些数字反映的是模型在仙侠考核场景下的默认写作模式,不能直接等同于"人类不会这么写"。
高频词:去掉场景固定词后的AI腔清单
场景强制词(人名、地名、物品名等100%出现的词)不算AI腔,过滤后:
| 词 | 出现率 | 平均次/篇 | 类型 |
|---|---|---|---|
| 目光 | 94.0% | 2.16 | 身体部位 |
| 微微 | 82.0% | 1.36 | 程度副词 |
| 缓缓 | 77.0% | 1.10 | 程度副词 |
| 落在 | 77.0% | 1.01 | 动词 |
| 呼吸 | 75.0% | 0.99 | 身体部位 |
| 此刻 | 74.0% | 1.06 | 时间标签 |
| 传来 | 73.0% | 0.86 | 动词 |
| 像是 | 73.0% | 1.30 | 比喻 |
| 仿佛 | 68.0% | 0.94 | 比喻 |
| 指尖 | 67.0% | 0.89 | 身体部位 |
| 瞬间 | 47.0% | 0.56 | 时间标签 |
| 似乎 | 39.0% | 0.53 | 模糊限定 |
| 轻轻 | 36.0% | 0.42 | 程度副词 |
| 凌厉 | 32.0% | 0.32 | 夸张形容 |
| 一丝 | 30.0% | 0.33 | 量词 |
| 如同 | 25.0% | 0.33 | 比喻 |
| 忽然 | 24.0% | 0.29 | 时间标签 |
| 随即 | 19.0% | 0.23 | 时间标签 |
| 突然 | 13.0% | 0.14 | 时间标签 |
| 骤然 | 12.0% | 0.13 | 时间标签 |
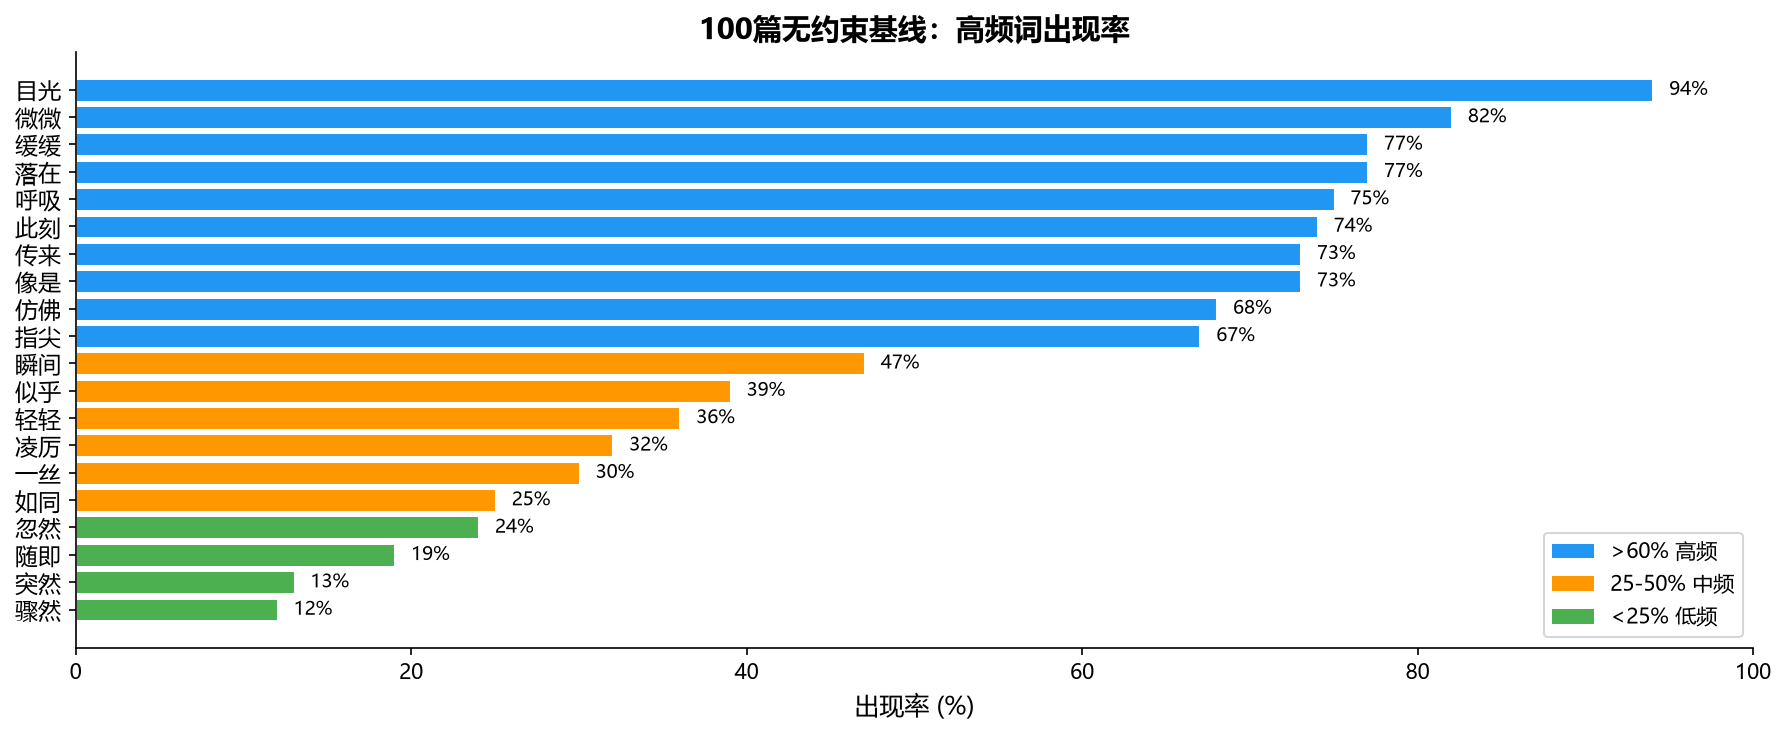
三个特征:
身体部位+程度副词+动词的固定模板。 目光(94%)+呼吸(75%)+指尖(67%)三个身体部位词覆盖几乎所有样本,它们几乎总是搭配微微(82%)+缓缓(77%)出现:“目光微微一凝”“呼吸缓缓平稳”“指尖轻轻发颤”。模型用这套模板替代了心理描写和情绪表达–不写"他很紧张",写"指尖微微发颤";不写"她感到恐惧",写"呼吸微微急促"。"X微微Y"这个句式在82%的样本中出现,模型不知道除了"主语+微微+动词"之外还能怎么写一个人正在做一个轻微的动作。
时间标签密集。 此刻(74%)+瞬间(47%)+忽然(24%)+随即(19%)+突然(13%)+骤然(12%),模型靠时间标签推进节奏,而不是靠事件推进。每段开头塞一个时间词,读起来像在翻日历。
比喻泛滥。 仿佛(68%)+像是(73%)+如同合计覆盖92%的样本。模型靠比喻填充描写,禁了"仿佛"就换"像是",禁了"像是"就换"如同"–三个词本质是同一个功能。
结构性缺陷:短段、无对话、无情绪
| 维度 | 数据 | 说明 |
|---|---|---|
| 平均每段句数 | 2.4句 | 55%的段落不超过2句 |
| 超过4句的段落 | 1.8% | 87%的样本一段长段都没有 |
| 无对话的样本 | 31.0% | 超过1/4完全没有对话 |
| 对话占比<5% | 52.0% | 超过一半对话极少 |
| 对话占比≥15% | 3% | 几乎没有对话充足的样本 |
| 无情绪词 | 81% | 模型不写"紧张/恐惧/愤怒"等情绪 |
| 无心理描写 | 64% | 模型不写"他想/心中/觉得"等心理 |
模型默认的写作模式:短段+微动作+无对话+无情绪+无心理。用身体部位微动作替代情绪和心理,用时间标签替代事件推进,用碎片化段落替代有起伏的叙事节奏。
六、 总结:禁词和格式的死结,技法的天花板
三轮实验、1541篇样本测下来,结论可以用一句话概括:
禁词和格式约束走入了死结:禁了没用的词改不了风格,有用的事(对话、长段、情绪)禁词又管不到。
第二轮已经证明技法约束是唯一有效的类别–去掉35条技法,AI味暴增10分。但技法约束要求模型做的事(写对话、写情绪、写长段),模型又做不到–违反率60-100%。技法有效,但遵从率太低。
具体拆开来看:
1. 核心AI套话:禁了模型就写不出来。
"微微"在82%的样本中出现,"缓缓"在77%中出现,"仿佛/像是/如同"合计覆盖92%。这些不是偶尔用一下的修辞,而是模型动作描写和比喻的核心模板。直接禁掉这些词,违反率归零–但模型不是换了一种写法,而是写不出来了。禁词导致的是输出退化,不是风格改善。
2. 次要套话:禁不禁影响不大。
"轻轻"在36%的样本中出现,"凌厉"在32%中出现。这些词出现率不高,禁了之后对整体风格影响很小。模型可以轻松避开,也可以继续使用,对读者体验没有可感知的差异。
3. 技法约束:方向对了,能力不够。
模型有三个结构性缺陷:不写长段(87%的样本一段长段都没有)、不写对话(97%的样本对话占比不到15%)、不写情绪和心理(81%无情绪词、64%无心理描写)。技法约束要求模型做这三件事,方向是对的–R2证明技法是唯一能降AI味的类别。但违反率60-100%说明模型做不到。
模型不是"不愿意"写对话和情绪,是在当前零示例提示词下做不好。 它的训练数据教会了它用身体部位微动作替代心理描写,用时间标签替代事件推进,用碎片化段落替代叙事节奏。技法约束可以推它一步,但遵从率太低,实际效果有限。
这是在当前零示例提示词方式下的能力边界,不是改约束措辞能解决的问题。不排除通过更细致的提示词设计(给示例、拆解约束步骤、让模型自检)提升遵从率。
七、 下一篇预告
约束实验里有一个数字一直没拆清楚:50条约束下,56%的样本写错了设定。但这个错误率是从加了约束的样本里测出来的。不加约束时模型自己写,事实错误率是多少?能防住吗?
下一篇测幻觉防控。四组对照:一组什么都不防,直接生成——这就是基线,回答"模型本来会犯多少错"。一组生成后让模型自检。一组把核心设定放提示词最前面再自检。最后一组是控制组:在提示词开头放一段和设定长度相同的废话,再让模型自检。
控制组是关键。没有它,你永远分不清是规则前置的效果,还是单纯提示词变长了就有用。
 1209


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


