


 本文系统讲解AI Agent的三大核心模块(规划、执行、反馈),并分三个版本展开:极简版(Python+Ollama,50行代码实现自动写脚本)、进阶版(LangChain集成多工具调用与反馈修正)、工业级版(长期记忆、多Agent协作、沙箱隔离与函数调用优化)。同时指出程序员开发Agent的三大典型误区,强调聚焦Agent逻辑而非自研大模型、控制工具复杂度、防范幻觉风险。
作为老程序员,咱开发Agent不用从零造轮子,核心是“搭骨架+填大脑+连手脚” —— 骨架是任务调度逻辑,大脑是大模型,手脚是工具调用能力。下面分3个版本讲,从新手能跑的极简版,到能落地的进阶版,全是干货!
一、核心原理:Agent的3大必备模块
不管啥Agent,本质都绕不开这3件事,缺一个就玩不转:
- **规划模块:**把用户的模糊需求拆成具体步骤(比如“写一篇AI绘画教程”拆成“选题→查资料→写大纲→填内容→排版”),大模型的思维链(CoT)就能搞定。
- **执行模块:**调用外部工具干活(比如用Python爬资料、调Stable Diffusion API生成配图、用Markdown渲染排版),核心是工具函数的封装和参数传递。
- **反馈模块:**检查执行结果对不对、好不好,不行就返工(比如发现教程里的参数写错了,让模型重新查资料修正),可以用大模型自检,也能加人工规则。
二、版本1:新手友好·极简版Agent(半天就能跑)
**目标:**做一个能“自动写Python小脚本”的Agent,不用复杂框架,纯原生代码+开源大模型。
**技术栈:**Python + Ollama(本地跑大模型,不用API key) + 简单函数封装
步骤1:环境准备
-
装Ollama:官网下载,一行命令跑起Llama 3。
-
装依赖:
pip install requests ollama
步骤2:写核心代码(不到50行)
import ollama

# 1. 规划函数:让大模型拆任务

def plan_task(user需求):

    prompt = f"""你是一个Python助手,帮我把需求拆成具体的代码编写步骤。

    需求:{user需求}

    要求:步骤要清晰,每步只做一件事,比如“1. 导入需要的库;2. 定义函数XXX”

    """

    response = ollama.chat(model='llama3', messages=[{'role': 'user', 'content': prompt}])

    return response['message']['content']

# 2. 执行函数:让大模型生成代码,本地运行(简单版,只跑无风险代码)

def execute_code(code):

    try:

        exec(code, globals())

        return "代码执行成功!"

    except Exception as e:

        return f"代码报错:{str(e)},请修正!"

# 3. 主循环:规划→执行→反馈

def simple_agent(user需求):

    print("=== 1. 任务规划 ===")

    steps = plan_task(user需求)

    print(steps)

    print("\\n=== 2. 生成并执行代码 ===")

    code_prompt = f"""根据下面的步骤,生成完整的Python代码:

    步骤:{steps}

    要求:代码简洁,加注释,能直接运行

    """

    code = ollama.chat(model='llama3', messages=[{'role': 'user', 'content': code_prompt}])['message']['content']

    print("生成的代码:\\n", code)

    result = execute_code(code.replace("```python", "").replace("```", ""))

    print("执行结果:", result)

# 测试一下!

if __name__ == "__main__":

    simple_agent("写一个函数,计算1到100的和,然后打印结果")
步骤3:运行测试
直接跑脚本,你会看到Agent先输出步骤,再生成代码,最后执行出结果 —— 一个极简Agent就成了!
**缺点:**只能跑简单代码,没有复杂工具调用,也不会自动修正错误。
三、版本2:进阶版·能调用工具的Agent(落地级)
**目标:**做一个能“爬取网页+数据分析+生成报告”的多工具Agent。
**核心升级:**引入工具注册表、标准化函数调用、结果反馈机制。
**技术栈:**Python + LangChain(简化工具调用) + 大模型(GPT-4/文心一言/Ollama) + 浏览器/Excel工具
核心步骤
- **封装工具函数:**把常用功能写成标准化函数,比如爬网页、算数据、画图表:
from langchain.tools import tool

@tool

def crawl_webpage(url: str) -> str:

    """爬取指定URL的网页文本内容,用于获取外部数据"""

    import requests

    from bs4 import BeautifulSoup

    response = requests.get(url)

    soup = BeautifulSoup(response.text, 'html.parser')

    return soup.get_text()[:1000]  # 只取前1000字,避免太长

@tool

def analyze_data(data: list) -> str:

    """分析数字列表,返回平均值、最大值、最小值"""

    avg = sum(data)/len(data)

    max_val = max(data)

    min_val = min(data)

    return f"平均值:{avg},最大值:{max_val},最小值:{min_val}"
- **用LangChain搭Agent骨架:**LangChain已经帮我们封装了“规划-执行-反馈”的逻辑,直接调包:
from langchain.agents import create_openai_tools_agent, AgentExecutor

from langchain_core.prompts import ChatPromptTemplate

from langchain_openai import ChatOpenAI

from langchain import hub

# 初始化大模型(本地用Ollama的话,换LangChain的Ollama封装就行)

llm = ChatOpenAI(model="gpt-3.5-turbo")

# 加载工具

tools = [crawl_webpage, analyze_data]

# 用LangChain Hub的现成Prompt模板,省得自己写

prompt = hub.pull("hwchase17/openai-tools-agent")

# 创建Agent和执行器

agent = create_openai_tools_agent(llm, tools, prompt)

agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)

# 测试:爬取某网站数据并分析

result = agent_executor.invoke({"input": "爬取https://xxx.com的房价数据,提取数字列表并分析"})

print(result["output"])
- **加反馈修正机制:**如果执行失败(比如爬取失败),让Agent自动重试:
在AgentExecutor里加参数:agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True, handle_parsing_errors="重新尝试")
关键亮点
• **工具调用标准化:**用@tool装饰器,大模型能自动识别函数名和参数。

• **支持多工具组合:**比如爬数据→分析→生成报告,一键完成。

• **可扩展性强:**想加新工具(比如调Stable Diffusion画图),直接封装函数就行。
四、版本3:大佬版·自主进化的Agent(工业级)
如果想做更牛的Agent(比如像Manus那样能动态调整任务、多Agent协作),需要加这些高级特性:
-
**长期记忆模块:**用向量数据库(比如Pinecone、Chroma)存储Agent的历史任务和经验,下次遇到类似需求不用重新规划。
-
**多Agent协作:**让多个小Agent分工(比如一个负责爬数据,一个负责分析,一个负责写报告),用消息队列(比如RabbitMQ)通信。
-
**沙箱环境:**执行代码或调用外部工具时,用Docker隔离,避免风险(比如防止Agent执行恶意代码)。
-
**性能优化:**用大模型的函数调用API(比如GPT-4的Function Call)代替Prompt解析,准确率更高;加缓存机制,重复任务不用重新跑。
五、避坑指南:老程序员踩过的3个坑
-
**别自己写大模型:**除非你有上亿级算力,否则直接用开源模型或API,把精力放在Agent的逻辑上。
-
**工具调用别太复杂:**新手先从2-3个工具开始,工具越多,大模型越容易搞混参数。
-
**防住大模型幻觉:**执行关键任务(比如数据分析)时,一定要加人工校验或规则校验,别完全信AI的结果。
AI大模型从0到精通全套学习大礼包
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
只要你是真心想学AI大模型,我这份资料就可以无偿共享给你学习。大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!
如果你也想通过学大模型技术去帮助就业和转行,可以扫描下方链接👇👇
大模型重磅福利:入门进阶全套104G学习资源包免费分享!
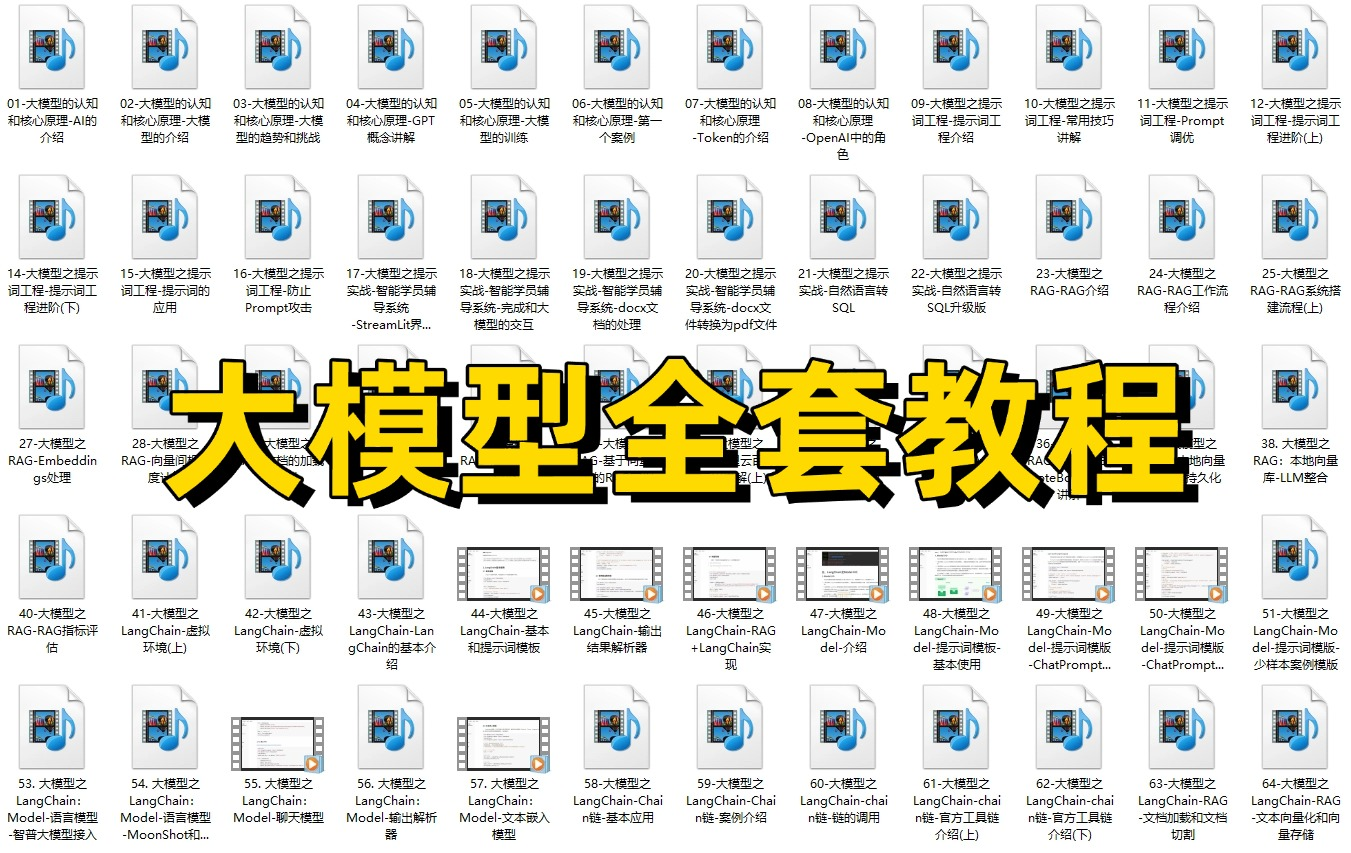
01.从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
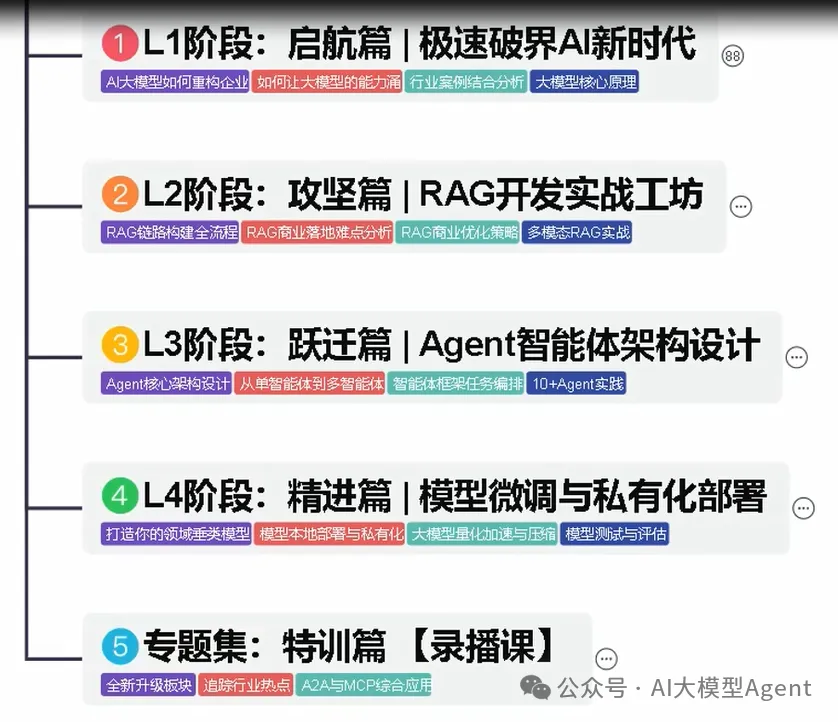
02.AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
03.学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
04.大模型面试题目详解
05.这些资料真的有用吗?
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
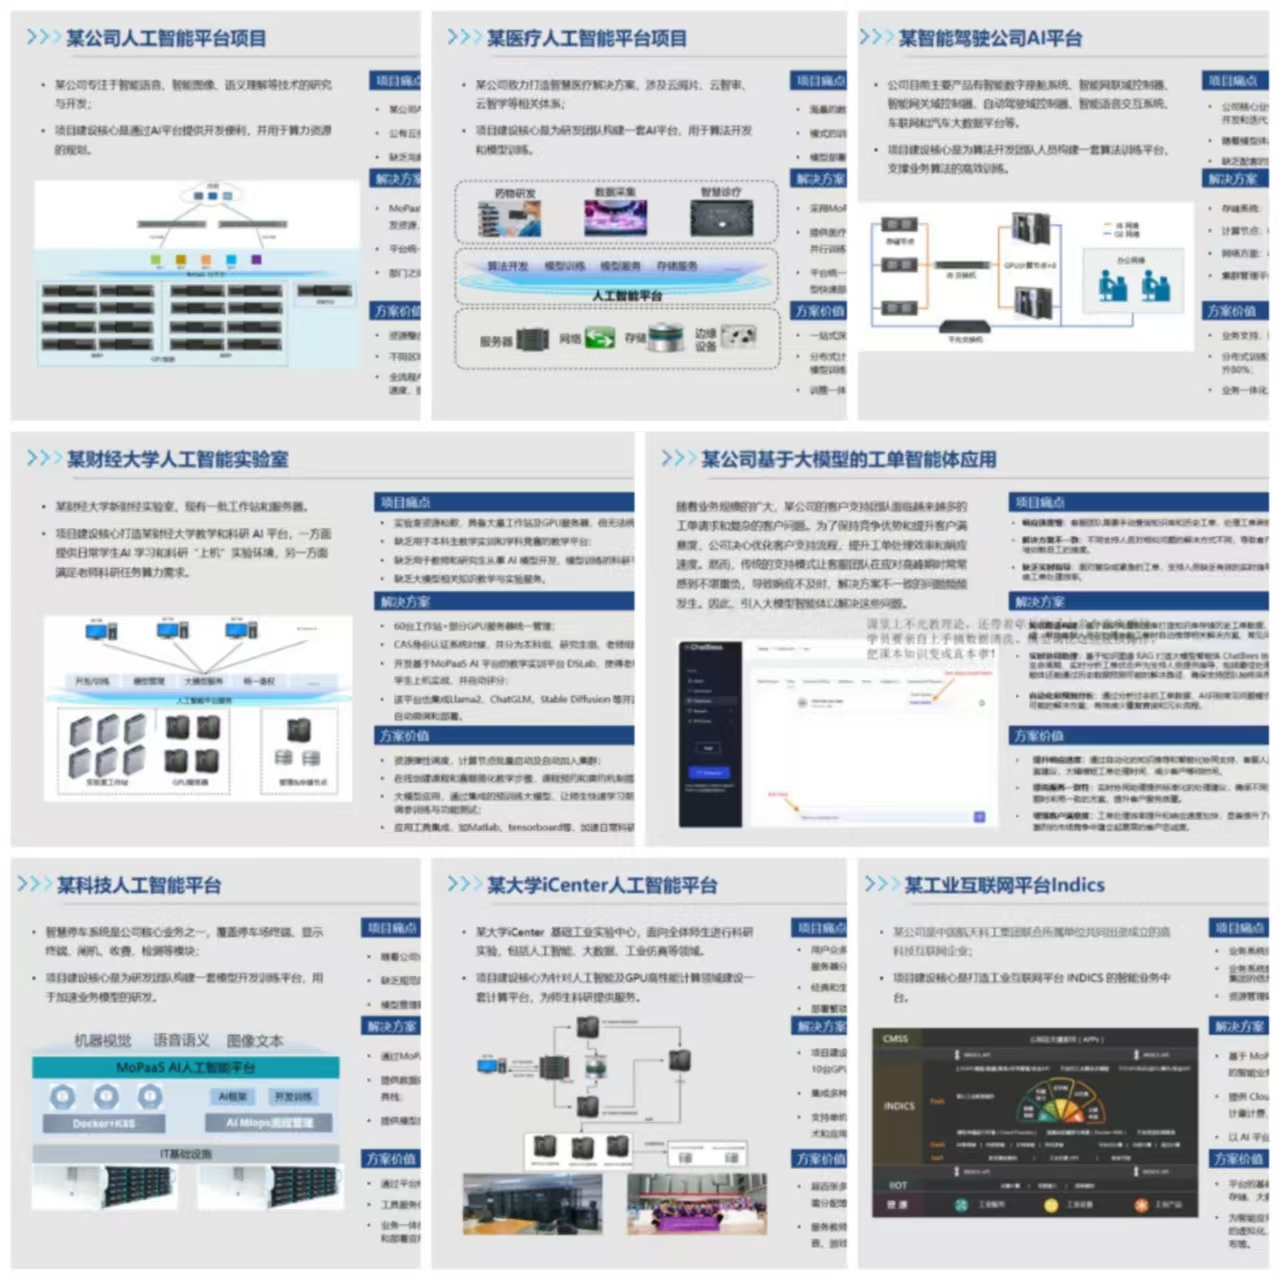
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓


 扫一扫


 448

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


