


在大模型落地企业知识库的场景中,检索增强生成(RAG) 早已成为事实标准。但行业里有一个公认的痛点:80%的RAG效果问题,根源都出在语义分块这一步。
固定长度分块会硬生生拆分完整语义,导致检索不到关键信息;基于生成式大模型的智能分块,又面临推理慢、成本高、超长文本性能暴跌的问题。而金山办公追光AI实验室的最新研究,彻底打破了这一困局。
在《Toward General Semantic Chunking: A Discriminative Framework for Ultra-Long Documents》论文中,团队提出了一套面向超长文档的判别式语义分块框架:基于Qwen3-0.6B轻量化模型,原生支持13k+ token单轮输入,在权威基准WIKI-727K上以0.5503的F1值刷新SOTA,推理速度比主流生成式分块模型快两个数量级,同时通过数学上严格等价的向量融合方案,完美解决了超长语义块的检索适配问题。
一、行业困局:语义分块,卡在效果与效率的两难里
语义分块(主题分割)的核心目标,是把长文本拆分成若干个语义连续、主题一致的独立块,是RAG检索、文档摘要、长文本理解的核心前置步骤。但现有方案,始终无法兼顾效果、效率与长文本适配能力。
传统方案的三大流派,各有致命短板:
-
- 无监督规则方法:以TextTiling为代表,靠词汇相似度、LDA主题模型判断边界,严重依赖人工调参,对复杂文体和专业文档鲁棒性极差,分块效果极不稳定。
-
- 传统监督式判别模型:基于BERT等预训练模型做序列标注,受限于Transformer自注意力的二次复杂度,只能处理短文本,面对超长文档只能强制截断,导致窗口边界信息丢失,边界预测准确率大幅下降。
-
- 生成式大模型分块:以Jina开源的Qwen2系列分块模型为代表,通过prompt引导大模型生成分块边界,虽然语义理解能力强,但存在三大硬伤:逐token生成导致推理成本高、速度慢,无法支撑大规模文档处理;输入超过数千token后,性能显著下降;输出结果对prompt高度敏感,工业落地稳定性极差。
论文中也明确指出,即便经过精心的prompt设计,生成式模型在长文档主题分割任务上,效果依然不如在大规模标注数据上微调的判别式模型。
二、破局核心:层级化判别式框架,攻克超长文档分块难题
团队提出的方案,彻底跳出了“生成式分块”的固有思路,构建了一套“编码-聚合-融合-判别”的层级化判别式架构,同时解决了长文本建模、边界精准识别、工程落地适配三大核心问题。
模型的整体架构如下图所示,分为5个核心阶段:文本块输入、token级语义编码、块级语义聚合、跨块上下文建模、边界判别预测。

图1:本文提出的判别式语义分块模型整体架构
1. 句子级细粒度建模,精准捕捉语义切换
团队首先将输入文档拆分为句子级的基础文本块,把主题分割转化为“相邻句子间是否存在主题边界”的二分类问题。
这种设计有两个核心优势:句子是最小的语义完整单元,相比段落级拆分提供了更细的候选边界粒度,能覆盖绝大多数真实主题切换点;同时与WIKI-727K基准的句子级标注完美对齐,让模型能稳定学习到主题切换的底层规律。
2. 跨块上下文融合,兼顾局部细节与全局语义
模型先用Qwen3-0.6B作为骨干网络,对全文本做token级编码,再通过注意力池化聚合得到每个句子的块级语义表示。
关键创新在于,团队在骨干网络之上新增了一个轻量Transformer编码器,专门建模跨句子的上下文依赖关系。这让模型在判断边界时,既能捕捉相邻句子的局部语义变化,也能参考全文的篇章结构,彻底解决了传统滑动窗口模型“只见局部、不见全局”的问题。
最终,模型通过一个MLP分类头,直接输出相邻句子间的主题边界概率,无需复杂的解码过程,推理效率实现了质的飞跃。
3. 重叠滑动窗口+概率融合,支持无限长文档
虽然Qwen3-0.6B原生支持13k token的长上下文,但面对现实中动辄数万token的超长文档,团队设计了重叠滑动窗口策略:
- • 对超过长度上限的文档,按固定长度拆分窗口,相邻窗口保留10%的重叠区域,避免边界位置因上下文不足导致预测失准;
- • 重叠区域的边界概率,取多个窗口预测结果的平均值作为最终值,非重叠区域直接保留原预测结果。
这套策略无需额外参数和复杂后处理,就能完美适配任意长度的文档,同时保证了边界预测的稳定性。
4. 启发式后处理,平衡语义与工程可用性
模型输出的是连续的边界概率,而工业落地中,还需要避免“过长块无法嵌入”和“过碎块破坏语义”的问题。团队设计了三阶段无参数启发式策略,整体流程如下图所示:

图2:启发式分块策略的三阶段处理流程
-
- 按预设阈值做初始分块,生成高置信度的粗粒度语义块;
-
- 对超过长度上限的超长块,递归选取块内边界概率最高的位置二次拆分,直到所有块满足长度约束;
-
- 对低于长度下限的超短块,对比左右边界的语义连续性,自动合并到语义更连贯的一侧,避免分块过度碎片化。
5. 标量校正向量融合,零损失解决超长块检索难题
分块后偶尔出现的超长块,会超出常规嵌入模型的上下文窗口,截断又会导致语义丢失。针对这个行业痛点,团队提出了向量融合与标量校正(VFSC) 方法,通过数学推导证明:仅用一个融合向量+一个标量因子,就能严格还原超长块所有子段的平均余弦相似度。
这套方法将超长块的存储复杂度从O(N)降至O(1),检索计算量也从O(N)降至O(1),完全没有语义损失,能和现有RAG检索系统无缝衔接,彻底解决了超长块的嵌入与检索适配问题。
三、硬核实验:效果与效率双重碾压生成式方案
团队在主题分割领域最权威的WIKI-727K基准上完成了全面测试,该数据集包含72.7万篇维基百科文档,覆盖开放域全品类主题,是行业公认的语义分块测试标准。
对比基线为Jina开源的3款基于Qwen2-0.5B的生成式分块模型,核心指标对比如下:
| 模型 | 精确率 | 召回率 | F1-Score |
|---|---|---|---|
| simple-qwen-0.5 | 0.5346 | 0.4496 | 0.4702 |
| topic-qwen-0.5 | 0.5405 | 0.5388 | 0.5185 |
| summary-qwen-0.5 | 0.5668 | 0.5159 | 0.5152 |
| Qwen3-0.6B + custom neck | 0.4628 | 0.7312 | 0.5503 |
表1:WIKI-727K测试集上的核心指标对比
从结果可以看到,本文方案实现了全面的性能超越:
-
- 整体效果刷新SOTA:F1值达到0.5503,比表现最好的生成式模型绝对提升3.18个百分点,相对提升超6%;
-
- 召回率实现质的飞跃:召回率高达0.7312,远超生成式模型的最高值0.5388,意味着能精准捕捉到绝大多数真实的主题边界,从根源上避免了RAG检索中“语义拆分错误”的核心问题;
-
- 推理效率提升两个数量级:模型处理13k token的文本仅需数百毫秒,而生成式模型需要逐token解码,推理速度慢了近100倍,在大规模文档处理场景中,成本和效率差距天差地别。
四、写在最后
这篇论文的价值,不仅在于刷新了语义分块的SOTA指标,更在于为RAG工业落地提供了一套低成本、高可用、全场景适配的语义分块解决方案。
在行业普遍执着于“用更大的生成式模型做分块”时,金山办公团队回归判别式建模的本质,用0.6B的轻量化模型,同时攻克了超长文档建模、分块效果、推理效率三大核心痛点,让大规模、低成本的超长文档语义分块成为可能。
对于RAG产业而言,这套方案彻底打破了“智能分块必须依赖生成式大模型”的固有认知,真正解决了企业级海量文档处理的落地瓶颈,为长文本理解与检索系统的规模化落地,铺平了道路。
AI行业迎来前所未有的爆发式增长:从DeepSeek百万年薪招聘AI研究员,到百度、阿里、腾讯等大厂疯狂布局AI Agent,再到国家政策大力扶持数字经济和AI人才培养,所有信号都在告诉我们:AI的黄金十年,真的来了!
在行业火爆之下,AI人才争夺战也日趋白热化,其就业前景一片蓝海!
我给大家准备了一份全套的《AI大模型零基础入门+进阶学习资源包》,包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。😝有需要的小伙伴,可以VX扫描下方二维码免费领取🆓
人才缺口巨大
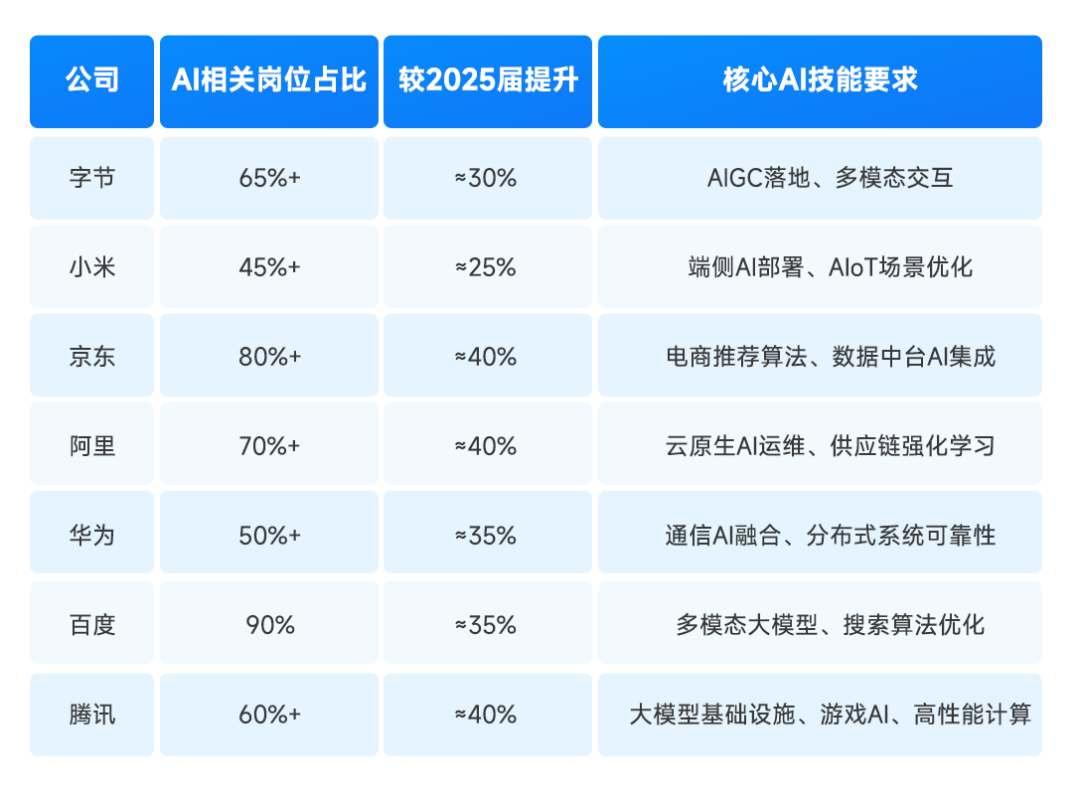
人力资源社会保障部有关报告显示,据测算,当前,****我国人工智能人才缺口超过500万,****供求比例达1∶10。脉脉最新数据也显示:AI新发岗位量较去年初暴增29倍,超1000家AI企业释放7.2万+岗位……
单拿今年的秋招来说,各互联网大厂释放出来的招聘信息中,我们就能感受到AI浪潮,比如百度90%的技术岗都与AI相关!
就业薪资超高
在旺盛的市场需求下,AI岗位不仅招聘量大,薪资待遇更是“一骑绝尘”。企业为抢AI核心人才,薪资给的非常慷慨,过去一年,懂AI的人才普遍涨薪40%+!
脉脉高聘发布的《2025年度人才迁徙报告》显示,在2025年1月-10月的高薪岗位Top20排行中,AI相关岗位占了绝大多数,并且平均薪资月薪都超过6w!
在去年的秋招中,小红书给算法相关岗位的薪资为50k起,字节开出228万元的超高年薪,据《2025年秋季校园招聘白皮书》,AI算法类平均年薪达36.9万,遥遥领先其他行业!
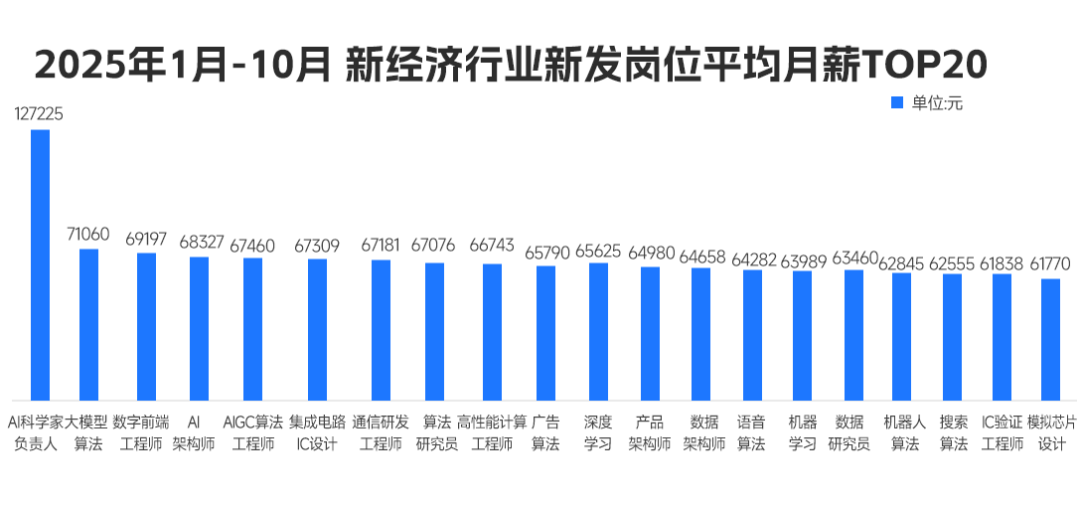
总结来说,当前人工智能岗位需求多,薪资高,前景好。在职场里,选对赛道就能赢在起跑线。抓住AI风口,轻松实现高薪就业!
但现实却是,仍有很多同学不知道如何抓住AI机遇,会遇到很多就业难题,比如:
❌ 技术过时:只会CRUD的开发者,在AI浪潮中沦为“职场裸奔者”;
❌ 薪资停滞:初级岗位内卷到白菜价,传统开发3年经验薪资涨幅不足15%;
❌ 转型无门:想学AI却找不到系统路径,83%自学党中途放弃。
他们的就业难题解决问题的关键在于:不仅要选对赛道,更要跟对老师!
我给大家准备了一份全套的《AI大模型零基础入门+进阶学习资源包》,包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。😝有需要的小伙伴,可以VX扫描下方二维码免费领取🆓
 281


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


