程序员必读收藏:DeepSeek-R1大模型深度解析——强化学习让AI学会自我反思,开源赋能小模型

Deepseek-强化学习算法(通俗易懂版) 首先先贴一张Deepseek核心技术的梳理图:上图详细了讲述了Deepseek主要在哪些阶段用了强化学习方法(GRPO) 阅读详情

DeepSeek-R1通过强化学习让模型学会"打草稿"和自我反思,涌现出强大推理能力,性能比肩OpenAI的o1模型。其创新技术包括GRPO降低训练成本和蒸馏技术让小模型获得大模型的推理能力。这一开源突破将推动全球AI应用落地,使低成本智能成为可能。


  1. 前言:AI 进化的新里程碑

在过去几年,像 ChatGPT 这样的 AI 主要是通过“阅读”海量文字来学习模仿人类说话。它们很擅长回答知识性问题,但在处理复杂的数学题、编程或逻辑推理时,往往会一本正经地胡说八道。

DeepSeek(深度求索)近日对初次发布于2025年1月22日的论文更新:

《DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning》

(https://arxiv.org/abs/2501.12948)

增大篇幅,详细展示了一种新的范式:通过强化学习,让模型学会像人类一样“打草稿”和“反思”,从而涌现出强大的推理能力。 这不仅在性能上比肩了 OpenAI 的顶尖模型 o1,而且完全开源,通过“蒸馏”技术让小模型也能变聪明。


  1. 核心突破:两大模型与“顿悟时刻”

论文主要介绍了两个模型:DeepSeek-R1-Zero(原型机)和 DeepSeek-R1(完全体)。

2.1 DeepSeek-R1-Zero:纯粹的自我进化

研究人员做了一个大胆的实验:不给 AI 看人类是怎么做题的,只给它题目和最终答案检查器(比如数学题答案对不对,代码能不能跑通),然后用纯强化学习(Reinforcement Learning, RL) 训练它 。

  • 原理: 就像训练小狗,做对了给奖励,做错了没奖励。AI 为了拿高分,开始尝试各种解题路径。
  • 结果: 模型自然而然地学会了“思维链”(Chain-of-Thought, CoT)。它开始生成很长的思考过程,学会了把大问题拆成小问题。
  • 顿悟时刻(Aha Moment): 最令人震惊的是,在训练过程中,模型突然学会了自我反思。研究人员发现,模型在输出中开始出现“Wait…(等等…)”这样的词,然后推翻自己之前的结论,重新尝试 。这是 AI 自主学会“检查作业”的标志。

缺点: 虽然 R1-Zero 推理很强,但它像个不修边幅的天才,说话中英文夹杂,排版混乱,且不听指挥,只管做题 。

2.2 DeepSeek-R1:天才的“社会化”改造

为了让模型既聪明又好用,研究人员开发了 DeepSeek-R1。他们在 R1-Zero 的基础上引入了“冷启动”数据和多阶段训练 。

  • 冷启动(Cold Start): 先给模型看少量人类写的高质量思考过程,告诉它:“不但要算对,还要写得条理清晰。”
  • 多阶段训练: 结合了强化学习(练脑子)和监督微调(学规矩),不仅保留了推理能力,还修复了语言混乱的问题,并增加了处理通用任务(如写作、问答)的能力。

  1. 关键技术创新

3.1 组相对策略优化 (GRPO):更省钱的训练法

传统的强化学习(如 PPO)需要一个额外的“评委模型”来时刻给 AI 打分,这非常消耗计算资源(显存)。DeepSeek 提出了一种叫 GRPO 的方法 。简单来说,它不是让评委盯着每一个动作,而是让 AI 对同一个问题生成一组答案(比如 64 个),然后让这组答案互相比较。考得好的加分,考得差的减分。这大大降低了训练成本,让大规模训练成为可能。

3.2 蒸馏(Distillation):把智慧传给小模型

这是论文对开源社区最大的贡献之一。DeepSeek-R1 是一个拥有 6710 亿参数的巨型模型(MoE架构)。研究人员把 R1 生成的大量解题步骤作为教材,拿去训练更小的模型(如 Qwen-7B, Llama-8B)。结果发现,小模型通过学习大模型的“思考过程”,推理能力突飞猛进,甚至超过了那些没有经过这种训练的大得多模型 。 这意味着,普通用户用家里的电脑显卡,也能跑出具备极强推理能力的 AI。


  1. 性能表现:比肩顶流

根据论文数据,DeepSeek-R1 的表现非常亮眼:

  • 数学与代码: 在 AIME(美国数学邀请赛)和 Codeforces(编程竞赛)等测试中,R1 的表现与 OpenAI 的 o1-1217 版本不相上下 。
  • 通用能力: 在百科知识、写作等任务上,也表现优异。
  • 局限性:

论文坦诚地指出,目前模型在处理某些需要具体格式输出或软件工程任务上还有提升空间,且在遇到非常简单的常识问题时,有时会“想太多”(过度思考) 。


  1. 总结

DeepSeek-R1 的论文告诉我们:

  1. AI 不需要人类教它每一步怎么思考,只要给足激励和算力,它能通过强化学习自主涌现出推理和反思能力。
  2. 推理能力是可以“传授”的,巨型模型的思考过程可以极大地提升小模型的智商。
  3. 开源的力量:DeepSeek 将模型权重和技术细节全部公开,这将极大推动全球 AI 应用的落地,让更低成本的智能成为可能 。

【附:v2与v1对比】

根据对DeepSeek-R1论文v2版本(当前86页版本)与v1版本(初始约20多页版本)的对比分析,v2版本的核心修订在于从“技术报告”向“完整学术论文”的质变。

对于研究者而言,v2版本补充了大量复现实验所需的“暗知识”(隐性经验)、负面结果(失败尝试)以及底层机理的定性分析。以下是详细解读:

1. 增加了极具价值的“失败路径”分析(Negative Results)

v1版本主要展示了成功的路径(GRPO + RL),而v2版本在附录中专门增加了 Appendix G.2 Unsuccessful Attempts。这对研究者的科研极具参考价值,避免了重复造轮子。

  • Process Reward Model (PRM) 的局限性:论文明确指出,虽然PRM在理论上优于Outcome Reward(结果奖励),但在大规模训练中极易导致Reward Hacking(奖励劫持),且标注成本过高,难以定义通用的细粒度推理步骤。
  • Monte Carlo Tree Search (MCTS) 的不可行性:论文解释了为何没有采用AlphaGo式的MCTS。与围棋不同,语言生成的搜索空间是指数级的,且训练一个细粒度的Value Model(价值模型)极难,容易陷入局部最优,导致训练迭代失败。
  • 解读:这告诉我们,在LLM推理中,简单的“结果验证”配合大规模强化学习,可能比复杂的“过程搜索”更具Scale-up的潜力。

2. 补全了实验复现的关键细节(Reproducibility)

v2版本大幅扩充了 Appendix B. Training Details,提供了可以直接用于复现的超参数和基础设施细节,这是v1版本中较为简略的。

  • 具体超参数:详细列出了RL阶段的学习率(如DeepSeek-R1-Zero为2e-6)、KL系数(0.001)、Batch Size(512)、采样温度(Temperature)以及不同阶段的Checkpoint设置。
  • Prompt 模板:公开了用于冷启动数据生成的Prompt(如 Listing 1)、代码测试用例生成的Prompt(Listing 2)以及作为Judge的Prompt(Listing 4)。
  • 解读:对于想复现DeepSeek-R1方法的研究者,这些不再是“黑盒”,而是可以直接写进实验配置文件的具体数值。

3. 深入了“涌现行为”的机理分析(Qualitative Analysis)

v2版本在 Appendix C 中对模型的训练动力学进行了更细致的分析,特别是关于“Aha Moment”(顿悟时刻)的捕捉。

  • 顿悟时刻的量化:论文展示了随着RL训练步数增加,模型输出中“Wait”、“Re-evaluate”等反思性词汇的频率呈指数级上升的曲线图(Figure 9)。
  • 语言混合(Language Mixing)的解释:分析了为何初期模型会出现中英夹杂现象(源于预训练语料的分布),并解释了为何在后期引入CoT一致性奖励后能解决此问题。
  • 解读:这部分内容将“RL能提高推理能力”这一结论,细化为“RL通过激励模型在Test-time分配更多计算量(Token)来进行自我修正”,为解释性研究提供了依据。

4. 扩展了蒸馏(Distillation)的实验广度

v2版本在 Appendix F 中补充了从1.5B到70B全系列模型的蒸馏实验结果。

  • 关键结论:证明了强大的推理能力可以从R1“蒸馏”给小模型(如Llama-8B, Qwen-1.5B),且蒸馏的效果优于直接在小模型上进行RL训练。
  • 解读:这为算力受限的实验室指明了方向——与其尝试在小模型上从头训练RL,不如利用大模型的推理轨迹进行SFT(监督微调),这是性价比更高的路径。

5. 完善了安全性与伦理评估(Safety & Ethics)

v2版本增加了 Appendix D.3,长达数页的安全性评估报告。

  • 内容:涵盖了Jailbreak(越狱)攻击测试、偏见评估以及多语言安全性分析。虽然R1在无害性(Harmlessness)上可能因RL追求解题而略有牺牲,但论文详细展示了如何通过后续的Risk Control System(风控系统)来弥补。
  • 解读:这使得论文更加严谨,符合顶级会议对于Responsible AI(负责任的人工智能)的发表要求。

AI大模型从0到精通全套学习大礼包

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

只要你是真心想学AI大模型,我这份资料就可以无偿共享给你学习。大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!

如果你也想通过学大模型技术去帮助就业和转行,可以扫描下方链接👇👇
大模型重磅福利:入门进阶全套104G学习资源包免费分享!
在这里插入图片描述

01.从入门到精通的全套视频教程

包含提示词工程、RAG、Agent等技术点
在这里插入图片描述
​

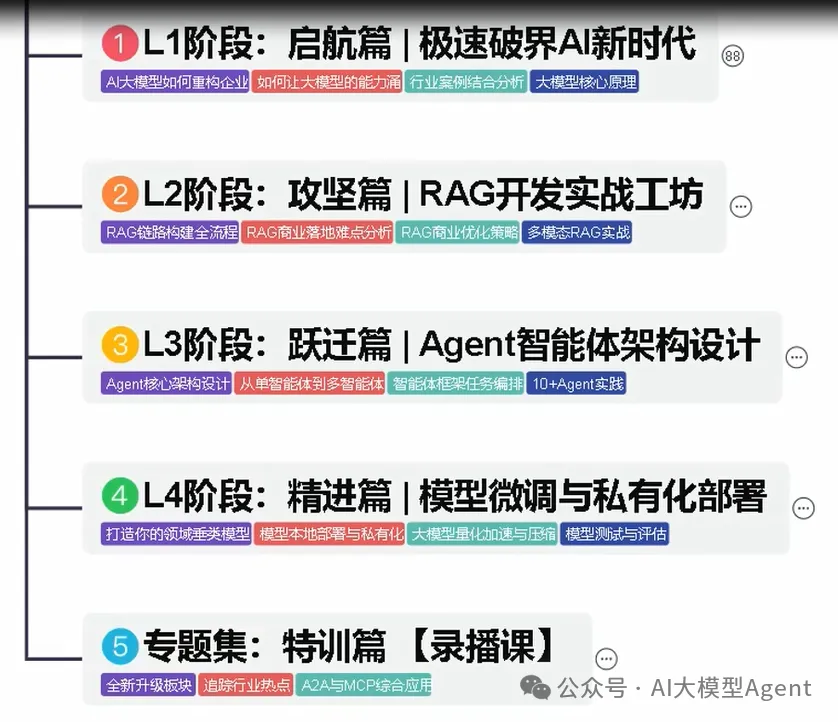
02.AI大模型学习路线图(还有视频解说)

全过程AI大模型学习路线

在这里插入图片描述
​在这里插入图片描述

03.学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
在这里插入图片描述
在这里插入图片描述

04.大模型面试题目详解

在这里插入图片描述

在这里插入图片描述

05.这些资料真的有用吗?

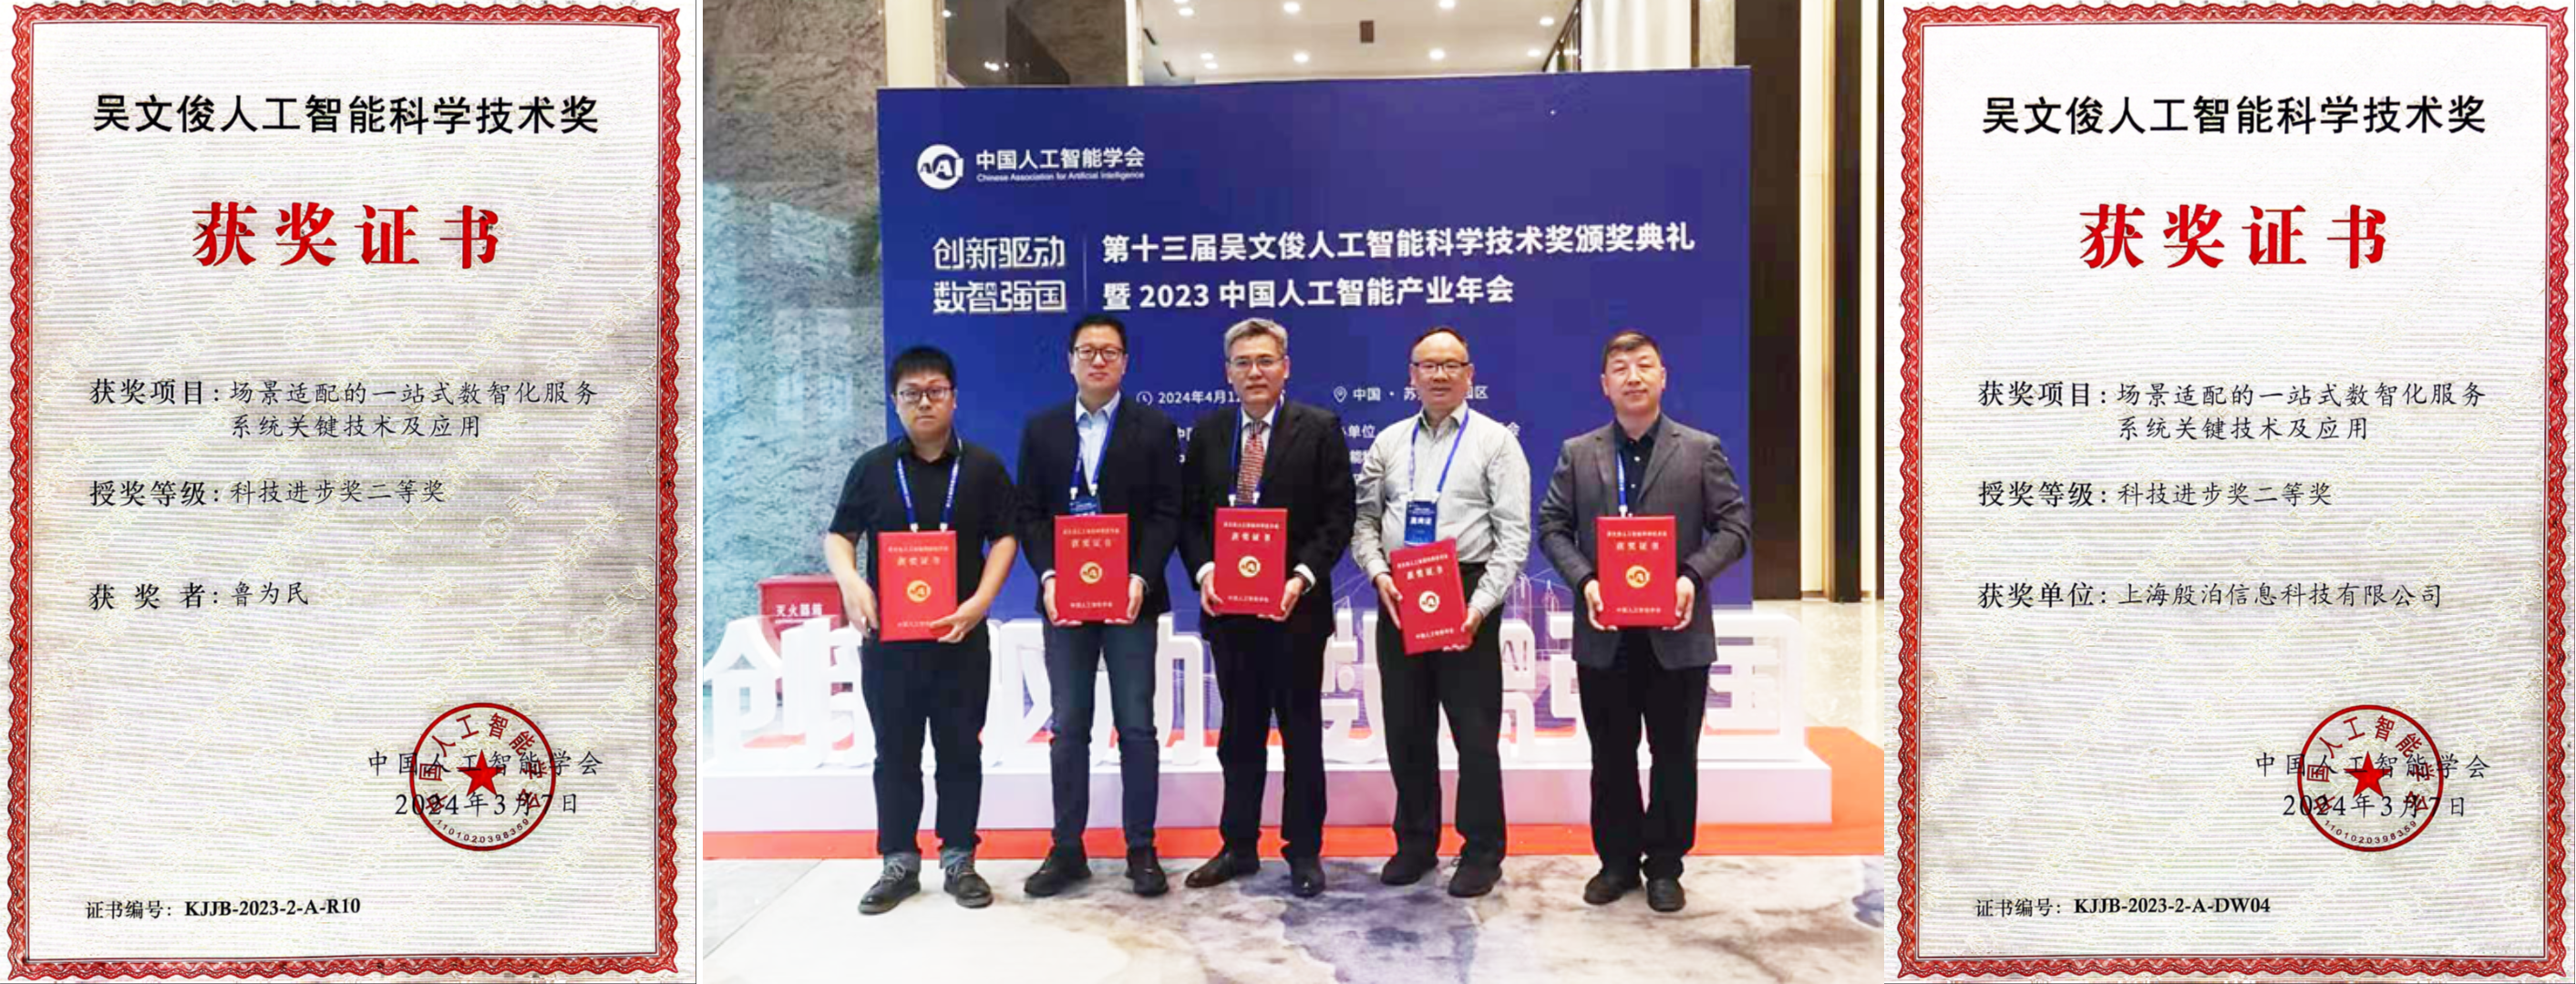
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。

所有的视频由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
在这里插入图片描述
在这里插入图片描述

智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念‌,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势‌,构建起"前沿课程+智能实训+精准就业"的高效培养体系。

课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

在这里插入图片描述
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!

应届毕业生‌:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能 ‌突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
在这里插入图片描述

(2025,DeepSeek-R1-Zero,DeepSeek-R1,两阶段强化学习,两阶段监督微调,蒸馏,冷启动数据)通过强化学习激励 LLM 的推理能力 DeepSeek-R1-Zero通过大规模强化学习训练,未经过监督微调,展现了卓越的推理能力。然而,它也面临一些挑战,例如可读性差和语言混杂。DeepSeek-R1 结合了多阶段训练和强化学习前的冷启动数据来解决这些问题并进一步提升推理性能 阅读详情

相关推荐

Deepseek-R1:纯强化学习实现接近OpenAI o1水平(论文解读)

最近,post-training已成为大模型训练的一个重要组成部分。它可以提高推理任务的准确性,并适应用户的偏好,同时相对于预训练,它只需要相对最少的计算资源。在推理能力方面,OpenAI的o 1系列模型是第一个通过增加思维链推理过程的长度来引入推理时间缩放的模型。这种方法在数学、编码和科学推理等各种推理任务中取得了显著的改进。然而,有效的测试时间缩放的挑战仍然是一个开放的问题。一些先前的工作已经探索了各种方法,包括基于过程的奖励模型、强化学习,以及诸如蒙特卡罗树搜索和波束搜索。

sherlockMa的博客 8629

DeepSeek-R1:通过强化学习激励大语言模型中的推理能力

我们推出了第一代推理模型——DeepSeek-R1-Zero 和 DeepSeek-R1。DeepSeek-R1-Zero 是通过大规模强化学习(RL)训练而成,没有经过监督微调(SFT)作为初步步骤,却展现出卓越的推理能力。通过 RL,DeepSeek-R1-Zero 自然地涌现出许多强大而有趣的推理行为。然而,它也面临着可读性差、语言混合等挑战。为了解决这些问题并进一步提高推理性能,我们引入了 DeepSeek-R1,它在 RL 之前加入了多阶段训练和冷启动数据。

AI前沿技术的分享! 3768

一文读懂DeepSeek强化学习技术,开启AI新视野

在当今人工智能(AI)蓬勃发展的时代,DeepSeek 无疑是一颗耀眼的新星。自其诞生以来,便在 AI 领域迅速崭露头角,以其卓越的性能和创新的技术,吸引了全球众多研究者和开发者的目光。DeepSeek 的出现,不仅为 AI 技术的发展注入了新的活力,也为解决各种复杂问题提供了强大的工具,在自然语言处理、计算机视觉等诸多领域都展现出了巨大的潜力和应用价值。而强化学习作为机器学习领域的一个重要分支,在人工智能的发展历程中占据着举足轻重的地位。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 1269

一文搞懂DeepSeek - 强化学习和蒸馏,收藏一篇就够了!!

DeepSeek-R1在Introduction部分提到,R1通过结合冷启动数据、多阶段训练管道和纯强化学习,显著提升了大型语言模型的推理能力,实现了与OpenAI的o1系列模型相当的性能,并通过蒸馏技术将推理能力传递给更小的模型。

2401_85327249的博客 2680

双向全桥隔离DC-DC变换器(DAB)的调制优化与挑战解析

本文深入解析了双向全桥隔离DC-DC变换器(DAB)的核心调制技术及其面临的挑战。文章从基础的相移调制(SPS)入手,逐步探讨了扩展相移(EPS)、双重相移(DPS)等进阶策略,并重点分析了电流优化与零电压开通(ZVS)等硬核优化技巧。针对DAB在实际应用中存在的建模困难、多模块并联及数字实现等挑战,提供了实用的应对策略与设计思路,旨在帮助工程师在性能、复杂度与成本之间找到最佳平衡。

weixin_29271053的博客 572

腾讯云运维工程师认证TCA--真题(最新2022.11)

解析:云原生应用的12要素,1.基准代码:一份基准代码,多份部署;解析:腾讯云主账号具备对其名下资源(包括存储桶)的最大权限,您虽然可以在存储桶策略中限制几乎所有操作,但主账号始终具备 PUT Bucket Policy 操作的权限,主账号调用该操作不检查存储桶策略。解析:瀑布模型将软件生命周期划分为制定计划、需求分析、软件设计、程序编写、软件测试和运行维护等六个基本活动,并且规定了它们自上而下、相互衔接的固定次序,如同瀑布流水,逐级下落。解答:云原生五大关键技术:微服务、容器化、DevOps、持续交付。

e1210101的博客 9915

浅谈DeepSeek系列技术路线

架构设计:DeepSeek系列采用了多种先进的架构设计。例如,DeepSeek-V3采用了Multi-head Latent Attention (MLA)和DeepSeekMoE架构。MLA通过低秩压缩技术减少了推理时的Key-Value缓存,显著提升了推理效率;DeepSeekMoE则通过细粒度的专家分配和共享专家机制,实现了经济高效的训练。训练方法:DeepSeek采用多种先进的训练技术和方法,包括分布式训练(数据并行、模型并行、流水线并行)、混合精度训练、强化学习与多词元预测、持续学习与微调等。

weixin_58022259的博客 8364

第七天 Labview进阶(7.2 与汇川PLC通信)

运行环境: Labview 2020 Autoshop v4.10.1.1 该文档中包括Labview程序和汇川PLC程序,可以完美实现Labview与汇川PLC的通信。具体的使用教程可以参考本人的相关文章,讲解详尽,请尽情享用!

weixin_38637405的博客 3527

详解DeepSeek-R1核心强化学习算法:GRPO

在目前大语言模型中进行微调的流程中,一般在监督微调(Supervised Fine-Tuning, SFT)阶段之后,进一步通过强化学习对模型进行优化可以显著提升其性能。而Group Relative Policy Optimization (GRPO),就是使用在该阶段,替换传统的PPO算法。Proximal Policy Optimization (PPO) 是一种广泛使用的强化学习算法,尤其适用于对 LLMs 进行微调。

m0_59164520的博客 5082

蓝牙学习笔记之HCI协议(一)

目录 协议浅述 HCI简介 HCI协议数据格式 HCI Command Packet HCI ACL Data Packet HCI Synchronous(SCO) Data Packet HCI Event Packet HCI命令和事件介绍 Inquiry command Write Local Name Command Read BD_ADDR Command H...

在云巅的博客 2万+

【AI大模型】角色设定:给模型定身份的高效使用方法

摘要: AI大模型角色设定(RolePrompting)是提示词工程的核心优化技巧,通过赋予模型特定职业、领域和风格约束,显著提升输出专业度与适配性。文章系统拆解了角色设定的原理、万能公式(领域+身份+技能+风格+场景)、三级分层写法(基础/进阶/专家),并提供10类高频场景的模板。通过无角色与有角色输出的对比实验(Python代码量化验证),证明角色设定可使模型综合得分提升35%以上,尤其优化场景适配度与风格统一性。该技巧作为高阶提示词(如CoT、Few-Shot)的前置模块,能以零成本实现AI输出的专业

unber的博客 43

DeepSeek R1模型解读与使用

下面有个图表,这里可以重点关注DeepSeek-R1-Distill-Qwen-32B这个模型,这也是他们官方标注的,基座采用了Qwen32B的模型,在数学,代码,复杂问题的测试集中跟o1-mini一个水准,远高于GPT4o,Claude3.5-Sonnet,DeepSeek-V3。相比国内的推理模型,价格不算便宜,但性能目前确实最好的,通义千问QWQ预览版输入价格3.5元/百万tokens,输出7元/百万tokens,智谱GLM-ZERO预览版,输入输出10元/百万tokens。这是官方的性能评测图。

2401_85549225的博客 1万+

CXSMILES细则-用于在 SMILES 字符串后存储分子的特殊特征

Chemaxon 扩展 SMILES/SMARTS 用于在 SMILES 字符串后存储分子的特殊特征。任何信息都可以存储在 SMILES 字符串后,只要它们由空格或制表符字符分隔,因为 SMILES 解析器会忽略这些信息,或者将它们作为注释使用。扩展特征以以下格式存储:Chemaxon 的扩展 SMILES/SMARTS 不包含非 ASCII 字符,它们通常以字符代码 n 的形式被转义为 &#n;。在 S-group 中,ASCII 字符“,”、“;”、“|”、“{”、“}”也以这种方式转义。此外,符号“$

ASKCOS博客 401

多图详解 DeepSeek-R1 !看完这篇就够了

DeepSeek-R1 是AI发展过程中的里程碑式工作。在这篇文章中,我们将一起了解DeepSeek-R1是如何构建出来的。和目前大多数大语言模型类似,DeepSeek-R1 也是通过一次生成一个 token(词元)的方式来工作。但它在数学和推理问题上的表现尤为突出,这是因为它能够花更多的“思考时间”,通过生成“thinking tokens”的方式来解释自己的推理过程。DeepSeek-R1 的训练方法遵循了大语言模型的一般训练流程。

weixin_59191169的博客 2484

拼多多Android面试题及参考答案

Android 系统采用分层架构设计,从底层到上层依次为Linux 内核层硬件抽象层(HAL)系统运行时库层应用框架层应用层,共五层。位置:Linux 内核层与系统运行时库层之间,是“硬件与系统的隔离层”。核心作用:屏蔽硬件差异,为上层提供统一的硬件访问接口,解决 Android 开源与硬件厂商闭源的矛盾,具体功能如下:硬件能力抽象:将硬件的具体实现(如不同厂商的摄像头芯片、音频芯片)封装为标准化接口(如Camera HALAudio HAL。

大模型大数据攻城狮的专栏 1284

【软件系统架构】系列五:TCP/IP 协议栈

TCP/IP协议栈是现代网络通信的核心框架,采用分层架构设计,包含应用层、传输层、网络层和网络接口层四层结构。应用层提供HTTP、FTP等用户服务接口;传输层通过TCP/UDP实现端到端通信;网络层负责IP寻址和路由选择;网络接口层处理物理数据传输。数据在传输过程中经历层层封装,从应用层报文最终转换为物理层的比特流。该协议栈通过三次握手建立连接、数据传输、四次挥手断开连接的流程,确保可靠通信。作为互联网的基础,TCP/IP协议栈具有跨平台、标准化和可扩展的特点,广泛应用于各类网络设备和嵌入式系统中。

moton2017的博客 2164

一文搞懂DeepSeek - 开源模型R1

DeepSeek系列模型包括R1(数学、代码及推理领域开源大模型,回答全面详实)、V3(自研MoE模型,性能顶尖且性价比极高)、VL(视觉与语言理解开源多模态模型)、V2(创新架构,推理成本低廉)、R1-Zero(强化学习预模型,独特优势)、以及蒸馏版Qwen和Llama小模型(从R1数据蒸馏,表现优异)。DeepSeek-R1的技术创新在于开发了GRPO算法以优化策略网络,避免了高计算开销,同时设计了多层次奖励机制和“思考-回答”双阶段训练模板,确保模型推理的高效性、可读性和过程可追踪性。

2201_75499313的博客 2912

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

【DeepSeek-R1背后的技术】系列三:强化学习(Reinforcement Learning, RL)

强化学习(Reinforcement Learning, RL)是一种智能体在与环境互动过程中,通过试错和奖励机制学习如何达成目标的算法。在这个过程中,智能体会不断探索环境,采取行动,并根据环境反馈的奖励或惩罚调整自己的行为策略,最终学习到最优策略。因此,反复实验(trial and error)和延迟奖励(delayed reward)是强化学习最重要的两个特征。

https://github.com/Donvink,专注于计算机视觉、目标检测、目标跟踪等方向 4088

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

DeepSeek 全面指南!入门 DeepSeek 必看!(建议收藏)

深度求索智能助手(DeepSeek-R1)简介: 深度求索智能助手是由深度求索(DeepSeek)公司开发的人工智能助手,专注于通过自然语言交互提供精准、高效的信息服务与解决方案。基于先进的深度学习技术和多领域知识库,能够处理复杂问题、生成创意内容,并适配多样化场景需求。特点:多语言与多领域支持:覆盖科技、教育、文化、生活等领域,支持中英文等多语言交互。实时信息整合:可联网搜索最新信息,结合知识库提供动态更新的答案(需联网模式下使用)。

2401_85343303的博客 1703

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

一文深入了解DeepSeek-R1:模型架构

DeepSeek-R1 (DeepSeek-V3) 总共包含 671B 个参数,其中每个标记激活 37B 个。在这里插入图片描述。

yanqianglifei的专栏 1万+

一文教你:DeepSeek是什么?DeepSeek-R1是什么?如何使用DeepSeek-R1?

DeepSeek-R1火的飞起,在中日美三个Appstore榜上登顶。还直接干崩英伟达,盘前先死13个点,连带着台积电一起。几乎一夜之间,所有人都在关注DeepSeek。DeepSeek,是一家在2023年7月17日成立的公司所开发的大模型名称。2024年1月5日,他们正式发布DeepSeek LLM,这是深度求索第一个发布的AI大模型。

m0_56255097的博客 5734

手把手带你搞懂Deepseek-V3 低成本知识库,收藏这一篇就够了!!

1 可以通过 api 添加各种模型 2 上传文档就能本地新建知识库 3 各种 AI 工具直接打开 4 知识库配合 deepseek 3 ,加上 COT 提示词 效果不错 5 还能画图 6 有简单 Artifacts 功能,直接渲染代码 7 可以多个模型一起回答问题,就是样式是直接铺下来的。

2401_85325397的博客 1万+

强化学习与 DeepSeek:实现智能体训练的最佳实践

自定义环境类# 解析动作生成答案# 初始化智能体value_model=None # GRPO无需独立CriticDeepSeek通过开源策略和算法-硬件协同优化,使得单卡GPU即可运行百亿参数模型。是否需要专业RL知识?是 → 使用DeepSeek-RL高级API否 → 直接调用预训练智能体库期待看到更多开发者创造突破性的智能体应用!

一碗黄焖鸡三碗米饭的博客 946

一文搞懂DeepSeek - 强化学习和蒸馏

(1)训练后:在基础模型上进行大规模强化学习。通过在基础模型上直接应用大规模强化学习,成功开发出具备自我验证和长思维链等推理能力的DeepSeek-R1。(2)蒸馏:小模型同样强大。同时证明了大模型的推理模式可被有效蒸馏到小模型中,实现性能显著提升。

2401_85373691的博客 1354

Deepseek的核心是强化学习?哪什么是强化学习?通俗解释与专业解读

强化学习是一种序列决策框架,其目标是让智能体(Agent)通过与环境(Environment)的交互,学习一种策略(Policy),使得长期累积奖励(Reward)最大化。与监督学习(如行为克隆)不同,RL不依赖预先标注的“正确动作”,而是通过试错和反馈动态优化策略。

simoncool23的博客 1551

DeepSeek-R1推理训练全解析:低成本强化学习实战指南

大语言模型的推理能力并非仅依赖参数规模与海量标注数据,而是一种可通过行为建模、奖励驱动和策略优化精准塑造的可迁移能力。基于强化学习(RL)的推理训练范式,正逐步替代传统监督微调(SFT),其核心在于用可计算的准确性奖励与结构化格式奖励,引导模型生成符合逻辑链条的中间思考过程。DeepSeek-R1通过纯RL路径、GRPO算法及多阶段对齐设计,在7B-32B中等规模模型上实现媲美GPT-o1的推理表现,训练成本降低至同类方案的1/5–1/3。该方法尤其适用于数学推理、代码生成与科学问答等需强逻辑链的任务,为预

weixin_33023873的博客 574
上一篇: 2026大模型学习指南:从Java到AI+,程序员职业升级的必经之路!_大模型应用开发实战
下一篇: 【干货收藏】从亿级到万级:STRUCTURE让多模态对齐不再需要海量数据
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值