


本文通过分析Open Deep Research项目源码,详解LangGraph框架中多Agent系统的State设计思路。文章介绍了主图、监督者子图和研究者子图的State结构设计,讲解了基于需求分析、数据流转关系和Agent职责划分的字段设计方法,以及Reducer函数选择和默认值设置策略,为构建高效多Agent系统提供了实用参考。
本期我们继续研究Open Deep Research这个项目的源代码。上一期我们学习了多Agent架构的设计与实现,相信大家看的不是很过瘾,因为没有讲太多数据、信息流的实现。今天我们逐步进入深水区,先来聊聊Open Deep Research的各个Graph的State设计思路。
在LangGraph中,State(状态) 是连接各个节点的核心纽带,它承载着整个工作流的数据流转。如何根据任务需求设计合适的State结构,如何选择State的类型和更新策略,这些都是构建高效多Agent系统的关键。
项目文件结构
在进入正片之前,我们先来看一下Open Deep Research的项目文件结构,其核心代码位于src/open_deep_research/目录下,其中
- •
state.py:State定义文件,包含所有Graph State类的定义; - •
deep_researcher.py:主Graph实现文件,定义了整个研究流程的Graph结构和节点函数; - •
configuration.py:配置管理文件,定义了系统的配置选项和模型设置; - •
prompts.py:提示词文件,包含各个Agent使用的系统提示词; - •
utils.py:工具函数文件,包含辅助函数和工具定义。
本次学习主要关注state.py文件,它定义了系统中所有State类的结构,包括主图State(AgentState)、监督者子图State(SupervisorState)、研究者子图State(ResearcherState)等。
但为了让大家更好地理解,我不会直接展示源代码,而是从State设计的角度出发,带着大家一步步探索这些State是如何从需求分析到最终实现的。同时需要明确的是,本期核心是state 的设计思路,数据流转方面的细节将在后续专题写。
第一步:任务需求分析 - 理解需要管理哪些数据
为什么需要先分析任务需求?
State的设计必须基于实际的数据需求,而不是凭空想象。如果不先理解任务需求就设计State,可能会遗漏关键字段导致后续无法实现某些功能,也可能设计出冗余字段增加系统复杂度,还可能因为不理解数据流转关系而选择错误的Reducer函数(在该追加时用了覆盖,或相反),甚至因为不理解Agent之间的数据依赖关系而导致状态隔离不当,造成状态污染或数据丢失。
如何进行任务需求分析
任务需求分析是一个系统性的梳理过程:
- • 首先需要梳理系统的核心业务流程,识别每个阶段的具体任务和产生的数据;
- • 然后,基于流程分析列出每个阶段需要管理的数据类型及其用途;
- • 最后,分析这些数据在Agent之间的传递和共享的方式,确定哪些数据需要共享、哪些需要保持隔离。
需要强调的是,从实践来看,事前的分析并不能保证State字段设计的完备性,但它至少能大幅降低我们出错的概率。事实上,很多State字段也是在搭建Graph的过程中,随着对系统理解的深入而补充完善出来的。因此,需求分析是一个持续迭代的过程,而不是一次性的工作。
我们以Open Deep Research为例,它是一个深度研究系统,其核心流程我们在上一期中已经进行了比较详细的分析:
- • 用户输入阶段:接收用户提出的研究请求;
- • 澄清阶段:分析用户需求并询问澄清问题;
- • 研究简报生成阶段:将用户消息转换为结构化研究简报;
- • 研究执行阶段:由监督者规划研究策略并委派多个研究者并行执行研究任务;
- • 研究压缩阶段:每个研究者将收集的信息压缩整理;
- • 报告生成阶段:整合所有研究结果生成最终报告。
基于这个流程,我们可以归纳出可能需要管理的数据包括:
- • 用户消息:用户输入的研究请求和澄清回答,包括AI的部分回复;
- • 研究简报:结构化的研究问题描述;
- • 监督者消息:监督者的规划、委派和评估消息;
- • 研究者消息:每个研究者的搜索、思考和总结消息;
- • 研究笔记:收集到的研究资料和发现;
- • 最终报告:生成的完整研究报告。
需求分析与State设计之间的联系
任务需求分析完成后,我们应该至少获得了三个关键信息:
- • 需要管理的数据清单:包括用户消息、研究简报、监督者消息等;
- • 数据流转关系:哪些数据需要在Agent之间传递和共享,哪些需要保持隔离;
- • Agent职责划分:不同层级的Agent负责不同的任务,需要管理不同范围的数据。
这些结果直接影响State的设计:
首先,数据清单决定了State字段的设计,每个需要管理的数据都对应一个或多个State字段,例如用户消息对应messages字段,研究简报对应research_brief字段,监督者消息对应supervisor_messages字段;
其次,数据流转关系决定了Reducer函数的选择,需要累积的数据(如研究者消息需要保持完整的对话历史)使用追加策略(operator.add),需要重置的数据(如监督者消息在初始化时需要重置)使用覆盖策略(override_reducer),单值字段(如研究简报、最终报告)直接覆盖;
最后,Agent职责划分决定了字段在各Graph State中的分布,主图需要协调整个流程,因此主图State(AgentState)包含所有阶段的数据字段,而监督者子图专注于研究任务的规划与委派,其State(SupervisorState)只包含与监督者职责相关的字段,研究者子图专注于单个研究任务的执行,其State(ResearcherState)只包含与研究者职责相关的字段。
需要注意的是,有些字段是公用的,需要在多个Graph State中都定义,以便在Graph之间传递和共享数据。这些公用字段确保了数据可以在不同层级的Graph之间正确传递和聚合。
Open Deep Research的State字段
在具体进入字段分析之前,我列了个表格给大家一个整体的个感觉:

下面,我们来看看Open Deep Research是如何将这些需求转化为具体的State字段的。
第二步:将需求转化为具体的State字段
基于第一步的业务需求分析,由于不同层级的Agent有不同的职责,需要管理不同范围的数据,因此需要为每个层级的Agent设计独立的State,实现状态的隔离和职责的分离。同时,根据数据流转关系分析,有些数据需要在多个Graph State之间传递和共享,这些字段需要在多个State中都定义,以确保数据可以在不同层级的Graph之间正确传递和聚合。
注意,这部分相对有点复杂,强烈建议结合上一期关于架构的内容看(LangGraph实战研究 — Open Deep Research源代码学习:多Agent系统架构的设计思路与实现方法),效果更佳。
输入State:AgentInputState
介绍主图State之前,先来看一个特殊的State:AgentInputState。这个State虽然简单,但它在整个系统的设计中起到了关键作用:
class AgentInputState(MessagesState): """InputState is only 'messages'."""
AgentInputState继承自MessagesState,只包含messages字段。它的作用不是作为图的内部状态,而是作为图的输入接口定义。
这里涉及到LangGraph的一个知识点:StateGraph除了第一个位置参数(也就是我们熟悉的主State)外,还有一个input参数用于指定图的输入接口,可以用来限制调用者提供的数据
我们来看下主图的初始化构建代码:
deep_researcher_builder = StateGraph( AgentState, input=AgentInputState, config_schema=Configuration)
可以看到,在主图构建时, 第一个位置参数是AgentState,定义了图的内部完整状态。input=AgentInputState指定了图的输入接口,调用者只需要提供messages字段。
当用户调用图时,只需要传入符合AgentInputState格式的数据(即messages字段):
# 用户只需要传入 messages,符合 AgentInputState 的定义result = deep_researcher.invoke({ "messages": [HumanMessage(content="帮我研究一下LangGraph和LangChain的区别")]})
然后,LangGraph根据AgentState的定义,将输入数据转换为完整的内部状态。对于AgentState中未提供的字段,LangGraph会自动初始化为默认值(如空列表[]、None等):
{ "messages": [HumanMessage(content="帮我研究一下LangGraph和LangChain的区别")], "supervisor_messages": [], "research_brief": None, "raw_notes": [], "notes": [], "final_report": "" }
最后,图的内部节点(如clarify_with_user、write_research_brief等)接收到的都是完整的AgentState,可以访问所有字段。随着图的执行,各个字段会被逐步填充。
这种输入接口抽象与状态管理分离的设计,既保证了调用接口的简洁性(用户只需要提供必要的messages字段),又保证了内部状态的完整性(图的节点可以使用完整的AgentState进行复杂的状态管理)。同时,LangGraph会在运行时自动验证输入数据是否符合AgentInputState的定义,未提供的字段会自动初始化为合理的默认值,避免了空值错误,提高了系统的健壮性和易用性。
接下来我们看主图State。
主图State:AgentState
主图需要协调整个研究流程,因此需要管理所有阶段的数据,下面我们对主图的AgentState中定义的字段进行注意分析:
class AgentState(MessagesState): """Main agent state containing messages and research data.""" supervisor_messages: Annotated[list[MessageLikeRepresentation], override_reducer] research_brief: Optional[str] raw_notes: Annotated[list[str], override_reducer] = [] notes: Annotated[list[str], override_reducer] = [] final_report: str
1. messages(通过继承)
第一行可以看到AgentState(MessagesState),意味着Agentstate也继承了MessagesState,自动获得了messages字段。
如前所述,Agentstate的messages其实首先来自于AgentInputState,对应需求分析中的"用户消息"数据需求。在"用户输入阶段"和"澄清阶段"需要存储用户的研究请求和澄清回答。但同时,Agentstate的messages还包括了AI的部分回复。
例如,用户可能输入"帮我研究一下LangGraph和LangChain的区别"(HumanMessage),系统可能会回复"我需要一些澄清:您希望重点关注技术架构差异,还是使用场景对比?“(AIMessage),用户再回答"重点关注技术架构差异”(HumanMessage)。所有这些消息都会存储在messages字段中,形成完整的对话历史。
另外,在"报告生成阶段",final_report_generation节点也会读取messages字段来了解用户的语言偏好,确保生成的报告使用与用户输入相同的语言。
2. supervisor_messages
对应需求分析中的"监督者消息"数据需求。这个字段存储监督者在"研究执行阶段"产生的消息历史,包括AIMessage(监督者的规划决策,如调用think_tool、ConductResearch、ResearchComplete等)和ToolMessage(工具执行结果,如think_tool返回的反思内容、ConductResearch返回的研究者压缩后的研究结果)。
主图需要在AgentState中定义这个字段,主要有以下几个原因:
-
- 初始化并传递给监督者子图:主图在
write_research_brief节点中需要通过Command的update参数初始化监督者的上下文(设置系统提示词和研究简报,细节又只能后面再讲了,不然写不完…),为监督者子图提供干净的起始状态。这个初始化操作需要更新主图State中的supervisor_messages字段。
- 初始化并传递给监督者子图:主图在
-
- 数据传递和同步:主图通过
research_supervisor节点调用监督者子图时,需要将supervisor_messages传递给子图,让子图在执行过程中能够读取和更新这个字段。更重要的是,监督者子图对supervisor_messages的更新需要同步反映到主图的AgentState中,这样才能保证主图能够跟踪整个研究过程的状态。
- 数据传递和同步:主图通过
-
- 状态管理和功能扩展:主图需要存储和管理这个字段以便进行状态管理、调试监控或未来的功能扩展(例如,如果需要根据监督者的活动来调整报告生成策略)。
因此,虽然supervisor_messages主要在监督者子图中被使用和更新,但它必须在主图State中定义,这样才能在主图和监督者子图之间正确传递和同步数据。
3. research_brief
对应需求分析中的"研究简报"数据需求。在"研究简报生成阶段"(write_research_brief节点),系统会分析用户消息,使用结构化输出(ResearchQuestion)生成一个聚焦的研究问题描述。
这个研究简报将指导整个研究过程:监督者子图需要根据它来分解研究任务(如将研究分解为"LangGraph的核心特性"、“LangChain的核心特性”、"两者的对比分析"等子任务),主图在"报告生成阶段"也需要使用它来生成最终报告。
因此这个字段在主图State中定义,并通过Command的update参数传递给监督者子图,确保监督者能够理解研究目标并据此规划研究策略。
4. raw_notes 和 notes
对应需求分析中的"研究笔记"数据需求,但两者存储的内容和处理方式不同。
- • raw_notes:存储原始的研究数据:在研究者的
compress_research节点中,raw_notes包含研究者所有工具调用结果和AI消息的原始内容(如搜索结果、网页内容、API返回数据等),这些原始数据会被传递给监督者,监督者再聚合多个研究者的raw_notes传递给主图。 - • notes:存储处理后的研究笔记:在监督者的
supervisor_tools节点中,通过get_notes_from_tool_calls()函数从supervisor_messages中提取所有ToolMessage的内容(主要是研究者返回的压缩后的研究结果),这些notes是经过研究者压缩整理的结构化研究结果,比raw_notes更简洁和聚焦。在"报告生成阶段",final_report_generation节点使用notes(而不是raw_notes)作为研究发现的输入,因为notes已经包含了所有关键信息且格式更规范。
这两个字段在主图State中定义,用于收集和聚合所有研究者的成果,同时也需要在监督者和研究者子图中定义,以便在数据流转过程中传递和聚合。
5. final_report
对应需求分析中的"最终报告"数据需求。在"报告生成阶段"(final_report_generation节点),系统会整合所有研究结果生成完整的报告。
具体来说,final_report_generation节点会读取notes字段(包含所有研究者压缩后的研究结果)、research_brief字段(研究简报)和messages字段(用户消息历史),然后使用配置的报告生成模型生成一个结构化的、包含引用来源的完整研究报告。
这个字段只在主图State中定义,因为报告生成是主图的最终任务,子图不需要访问或管理最终报告。
监督者子图State:SupervisorState
监督者子图专注于研究任务的规划与委派,需要管理研究迭代和任务分配,其State字段设计基于Agent职责划分和数据流转需求:
class SupervisorState(TypedDict): """State for the supervisor that manages research tasks.""" supervisor_messages: Annotated[list[MessageLikeRepresentation], override_reducer] research_brief: str notes: Annotated[list[str], override_reducer] = [] research_iterations: int = 0 raw_notes: Annotated[list[str], override_reducer] = []
可以看到,其中大部分字段已经在主图里有介绍,对于这部分就一笔带过。
1. supervisor_messages
监督者在规划研究策略、委派研究任务、评估研究进展时需要记录消息历史,这些消息用于监督者进行下一步决策。这个字段与主图State中的supervisor_messages是同一个字段。
2. research_brief
监督者需要根据研究简报来分解研究任务,因此需要访问这个字段。这个字段与主图State中的research_brief是同一个字段。
3. research_iterations
这是一个控制字段,不是直接来自需求分析的数据需求,而是为了满足"研究执行阶段"需要控制监督者循环次数的需求。
监督者可能会多次迭代规划和研究委派(在supervisor和supervisor_tools节点之间循环),需要防止无限循环。在supervisor节点中,每次调用后会将research_iterations加1;在supervisor_tools节点中,会检查research_iterations是否超过配置的最大迭代次数(max_researcher_iterations),如果超过则结束研究阶段。例如,如果max_researcher_iterations设置为5,当research_iterations达到6时,监督者会停止循环并返回研究结果。这个字段只在监督者子图State中定义,因为它是监督者内部的控制逻辑,不需要在主图中管理。
4. notes 和****raw_notes
监督者需要收集研究者返回的研究结果,这两个字段与主图State中的对应字段是同一个字段,确保数据可以在监督者子图和主图之间正确传递和聚合。
研究者子图State:ResearcherState
研究者子图专注于"研究执行阶段"中单个研究任务的执行和"研究压缩阶段"的信息整理,需要管理工具调用和研究结果。
class ResearcherState(TypedDict): """State for individual researchers conducting research.""" researcher_messages: Annotated[list[MessageLikeRepresentation], operator.add] tool_call_iterations: int = 0 research_topic: str compressed_research: str raw_notes: Annotated[list[str], override_reducer] = []
1. researcher_messages
对应需求分析中的"研究者消息"数据需求。研究者在执行研究任务时会产生多种类型的消息:AIMessage(包含研究者调用工具的决策,如调用tavily_search搜索信息、调用think_tool进行思考、调用ResearchComplete表示完成研究)和ToolMessage(工具执行结果,如搜索结果、网页内容、API返回数据等)。
这些消息需要被记录,以便后续的压缩和总结。例如,研究者可能会先调用think_tool思考研究策略,然后调用tavily_search搜索相关信息,再调用think_tool分析搜索结果,最后调用ResearchComplete表示完成。所有这些消息都会累积在researcher_messages中,在compress_research节点中,研究者会读取完整的researcher_messages历史来进行压缩和总结。
这个字段只在研究者子图State中定义,因为研究者的消息历史是研究者内部的工作记录,不需要在主图或监督者子图中管理。
2. tool_call_iterations
这是一个控制字段,不是直接来自需求分析的数据需求,而是为了满足"研究执行阶段"需要控制研究者工具调用循环次数的需求。研究者可能会多次调用工具进行搜索和研究(在researcher和researcher_tools节点之间循环),需要防止无限循环。在researcher节点中,每次调用后会将tool_call_iterations加1;在researcher_tools节点中,会检查tool_call_iterations是否超过配置的最大工具调用次数(max_react_tool_calls),如果超过则结束研究并进入压缩阶段。
例如,如果max_react_tool_calls设置为10,当tool_call_iterations达到11时,研究者会停止工具调用循环并进入compress_research节点。这个字段只在研究者子图State中定义,因为它是研究者内部的控制逻辑。
3. research_topic
对应需求分析中"研究执行阶段"的数据流转需求。监督者委派研究任务时,通过调用ConductResearch工具将具体的研究主题传递给研究者。
例如,如果监督者将研究任务分解为"研究LangGraph的核心特性和架构",它会调用ConductResearch(research_topic="研究LangGraph的核心特性和架构,包括其设计理念、主要组件、使用场景等"),这个research_topic参数会作为HumanMessage的内容传递给研究者,同时也会存储在research_topic字段中。研究者需要根据这个主题进行专门的研究,在researcher节点中,研究者会读取research_topic来理解自己的研究任务,然后调用相应的工具(如搜索工具)来收集相关信息。
这个字段只在研究者子图State中定义,因为它是监督者传递给研究者的任务参数,每个研究者都有自己独立的研究主题。
4. compressed_research
对应需求分析中"研究压缩阶段"的数据需求。在"研究压缩阶段"(compress_research节点),研究者需要将收集的信息压缩整理成结构化的研究结果。具体来说,compress_research节点会读取完整的researcher_messages历史(包含所有搜索请求、工具调用结果、AI思考等),然后使用配置的压缩模型(compression_model)对这些消息进行压缩和整理,生成一个清晰、全面的研究摘要。
例如,如果研究者研究的是"LangGraph的核心特性",compressed_research可能包含"LangGraph是一个用于构建有状态、多参与者应用的框架,主要特性包括状态管理、循环控制、条件分支等,适用于需要复杂工作流的场景"这样的结构化总结。这个结果需要返回给监督者,监督者会将多个研究者的compressed_research聚合后用于后续的规划决策。
这个字段在研究者子图State中定义,用于存储压缩后的研究结果,同时也出现在ResearcherOutputState中,用于返回给监督者。
5. raw_notes
在compress_research节点中,raw_notes是通过提取researcher_messages中所有ToolMessage和AIMessage的内容生成的,包含了研究者收集的所有原始信息(如搜索结果、网页内容、API返回数据、AI的思考过程等)。
这些原始数据会被传递给监督者,监督者再聚合多个研究者的raw_notes传递给主图,主图可以保留这些原始数据以备后续需要。这个字段与主图State和监督者State中的raw_notes是同一个字段。
好了,我们终于把Open Deep Research的各个重要state字段定义过了一边。下面我们再来继续看一下state设计中的其他细节。
第三步:设计Reducer函数 - 控制状态更新策略
在LangGraph中,State字段的更新不是简单的赋值,而是通过Reducer函数来控制如何合并新旧值。Open Deep Research根据数据流转关系的分析,为不同的字段选择了合适的Reducer函数。
override_reducer:灵活的覆盖与追加策略
override_reducer是Open Deep Research中一个自定义的Reducer函数,它实现了一种灵活的更新策略:既支持完全覆盖,也支持追加操作。让我们先看看它的实现。
def override_reducer(current_value, new_value): """Reducer function that allows overriding values in state.""" if isinstance(new_value, dict) and new_value.get("type") == "override": return new_value.get("value", new_value) else: return operator.add(current_value, new_value)
这个函数的工作原理是:首先检查new_value是否是一个包含"type": "override"键的字典。如果是,则完全覆盖当前值;否则,使用operator.add将新值追加到列表中。这种设计使得同一个字段既可以支持覆盖操作(用于初始化或重置),也可以支持追加操作(用于累积数据)。
supervisor_messages字段就使用了override_reducer。在"研究简报生成阶段"完成后,主图需要初始化监督者子图,开始"研究执行阶段"。此时,监督者需要从一个干净的状态开始工作,而不是在旧的消息历史基础上追加。因为每次研究任务都是独立的,如果使用简单的追加策略,可能会导致不同研究任务的消息历史混在一起,影响监督者的决策。
在write_research_brief节点中,主图通过Command来初始化时,使用了覆盖策略去处理supervisor_messages:
return Command( goto="research_supervisor", update={ "research_brief": response.research_brief, "supervisor_messages": { "type": "override", "value": [ SystemMessage(content=supervisor_system_prompt),HumanMessage(content=response.research_brief) ] } } )
这里通过{"type": "override", "value": [...]}的特殊格式来触发覆盖操作,重置supervisor_messages,确保监督者从干净的状态开始工作。
而在监督者子图的执行过程中,当监督者生成新的规划决策或工具执行结果时,这些消息会以普通列表的形式追加到supervisor_messages中,因为此时不需要覆盖,而是需要累积消息历史。
operator.add:纯粹的追加策略
与override_reducer的灵活策略不同,researcher_messages字段使用了operator.add作为Reducer函数,这是一种纯粹的追加策略。
研究者在"研究执行阶段"会多次调用工具进行搜索和研究,每次操作都会产生新的消息。这些消息包括研究者的思考过程(AIMessage)、工具调用请求、工具执行结果(ToolMessage)等。根据数据流转关系分析,这些消息需要累积保存,而不是覆盖,因为后续的"研究压缩阶段"需要访问完整的对话历史来进行压缩和总结。
例如,研究者可能会先调用think_tool思考研究策略,然后调用tavily_search搜索相关信息,再调用think_tool分析搜索结果,最后调用ResearchComplete表示完成。所有这些消息都需要被完整地记录下来,形成一个完整的对话历史。如果使用覆盖策略,每次更新都会丢失之前的消息,导致compress_research节点无法获取完整的研究过程信息,无法生成准确的研究摘要。
因此,researcher_messages使用operator.add追加策略,确保每次工具调用都会添加新的消息到列表中,保持完整的对话历史。这样,当研究者进入compress_research节点时,可以读取完整的researcher_messages历史,了解整个研究过程,从而生成更准确、更全面的研究摘要。
默认行为:直接赋值覆盖
对于没有指定Reducer函数的字段,LangGraph会使用默认行为:直接使用新值覆盖旧值。在Open Deep Research中,大部分非列表类型的字段(如research_brief、final_report、research_iterations、tool_call_iterations、research_topic、compressed_research等)都没有指定Reducer函数,因此使用默认的覆盖行为。
这些字段通常是单值字段,不需要累积历史,每次更新都应该用新值替换旧值。例如,research_brief在研究简报生成阶段被设置后,在整个研究过程中保持不变,直到下一次研究任务;final_report在报告生成阶段被设置后,就是最终的输出结果,不需要追加或累积。
需要注意的是,列表类型的字段如果不指定Reducer函数,也会使用默认的覆盖行为,但这通常不是我们想要的。因为列表字段通常需要追加操作来累积数据,所以Open Deep Research中所有的列表字段都明确指定了Reducer函数(operator.add或override_reducer),而不是依赖默认行为。
第四步:State字段的默认值设计
在State定义中,有些字段有默认值,有些没有。这个设计不是随意的,而是基于字段的使用场景和初始化需求来决定的。
列表字段的默认值设计
在Open Deep Research中,列表类型的字段通常都有默认值,例如raw_notes和notes字段:
raw_notes: Annotated[list[str], override_reducer] = [] notes: Annotated[list[str], override_reducer] = []
为什么列表字段需要默认值呢?这要从Reducer函数的工作机制说起。当我们使用operator.add或override_reducer等Reducer函数时,这些函数会对当前值和新值进行合并操作。如果字段在初始化时没有默认值,LangGraph可能会将其视为None或未定义状态。此时,如果节点尝试使用Reducer函数更新这个字段(例如使用operator.add追加新元素),就会因为无法对None执行列表操作而报错。
提供默认空列表[]可以确保字段在初始化时就有一个有效的列表对象,后续的Reducer函数可以正常对其进行追加或覆盖操作。这样,即使某个节点是第一次更新这个字段,也不会因为字段未初始化而出错。
非列表字段的默认值设计
对于非列表类型的字段,Open Deep Research采用了不同的策略。以AgentState中的几个字符串字段为例:
class AgentState(MessagesState): """Main agent state containing messages and research data.""" supervisor_messages: Annotated[list[MessageLikeRepresentation], override_reducer] research_brief: Optional[str] raw_notes: Annotated[list[str], override_reducer] = [] notes: Annotated[list[str], override_reducer] = [] final_report: str
research_brief字段被定义为Optional[str],没有默认值,允许为None。这是因为在研究流程的早期阶段(用户输入和澄清阶段),研究简报还没有生成,此时research_brief应该是None,表示"还未生成研究简报"。如果给它一个默认值(如空字符串""),就无法区分"还未生成"和"已生成但为空"这两种状态。使用Optional[str]类型配合None值,可以清晰地表达字段的状态,让代码逻辑更加明确。
又如final_report字段被定义为str类型,也没有默认值。虽然这个字段在初始化时可能为空,但它是必需的字段,表示最终报告的内容。在报告生成之前,这个字段可能不存在于State中,或者需要通过其他方式处理。如果给它一个默认空字符串,可能会在报告生成逻辑中造成混淆,因为无法区分"还未生成报告"和"报告内容为空"这两种情况。
这种设计体现了类型系统的作用:通过类型定义(如Optional[str])和是否提供默认值,我们可以清晰地表达字段的语义和状态,让代码更加健壮和易于理解。
总结
Open Deep Research的State设计采用了分层隔离与共享字段结合的策略:
- • 主图State管理整个流程的数据,监督者和研究者子图State只管理各自职责范围内的数据,同时通过共享字段(如
supervisor_messages、research_brief、notes等)实现数据在不同层级Graph之间的传递和聚合。 - • 通过InputState分离输入接口和内部状态,简化了调用者的使用复杂度;
- • 通过Reducer函数(
override_reducer、operator.add)灵活控制状态更新方式,支持覆盖和追加两种策略; - • 通过合理的默认值设计,确保字段初始化的正确性。
这种State设计为构建复杂的多Agent系统提供了优秀的参考范例,既保证了数据的正确流转,又实现了良好的模块化和可维护性。
AI大模型从0到精通全套学习大礼包
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
只要你是真心想学AI大模型,我这份资料就可以无偿共享给你学习。大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!
如果你也想通过学大模型技术去帮助就业和转行,可以扫描下方链接👇👇
大模型重磅福利:入门进阶全套104G学习资源包免费分享!
01.从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
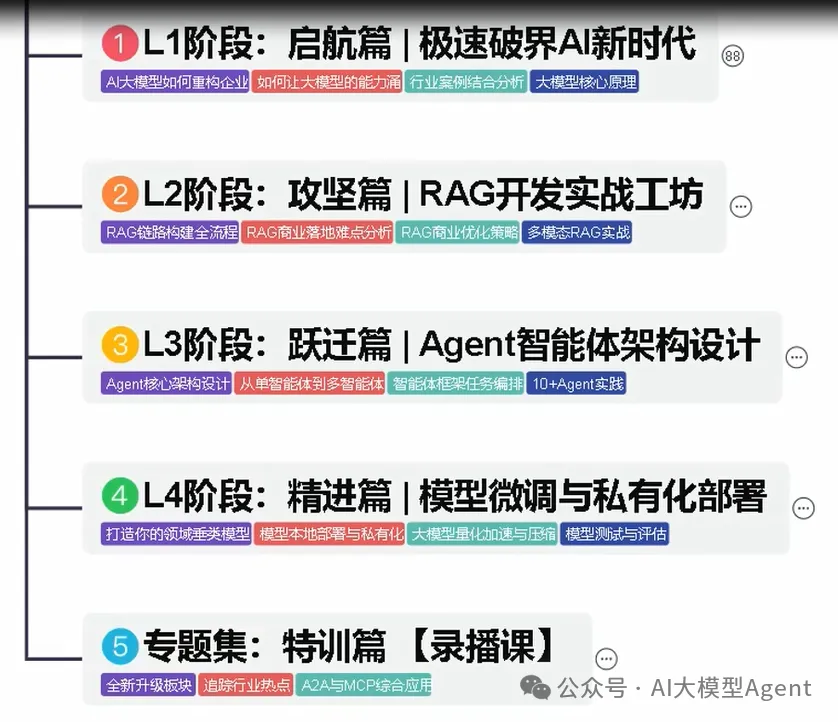
02.AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
03.学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
04.大模型面试题目详解
05.这些资料真的有用吗?
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
 2155


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


