大模型面试经验汇总:22家大厂面试实录+高频考点解析

大模型常见面试题及解答 大模型面试常见问题与解答 阅读详情

本文详细记录了作者2023年参加的22家科技公司大模型岗位面试经验,包括面试流程、问题及感悟。文章总结了高频考点:多头注意力机制、框架并行方式、主流模型细节、大模型训练技巧、数据预处理和模型评估等。作者指出大模型领域竞争激烈,岗位对技术和工程能力均有要求,并提供了面试题资料作为求职者的备考参考。


前言

2023年三月前后,大模型突然国内火了起来,笔者就面了一些公司,有大厂有初创。最近挺多朋友聊大模型相关的内容,对面试也感兴趣,想这里综合写一下,也希望能和各位同行交流下。因为有一段时间了(最早面的半年了),所以大部分细节记不清了,列表顺序大概齐按面试时间排的。

后边会大体总结下面试的经验感悟,以及我认为要注重的内容,一家之言仅供参考。

1. 智元机器人(Agibot)(拒)

稚晖君那个。当时面的很早,他们好像还在一边组建团队一边搞东西,一面就是稚晖君本人,问了一些简历的经历,然后问了transformer相关的比较常见的问题比如MHA,复杂度,BERT/GPT这种。然后后边就没有收到回复,应该是挂了。这家是我开始面试的第一家,所以印象还比较深刻。和大佬交流感觉也挺顺畅,很看好他家的以及具身智能这个方向。给稚晖君大佬点赞!

2. 面壁科技/面壁智能(offer)

记得一共两面,技术上问了大模型训练,transformer相关的内容和过往经历,第二面好像就聊offer了如果没有记错。团队很年轻,大部分清华背景。当时感觉是不是有点太年轻了虽然清华背景这样子。印象里他们有说funding还是很足的。PS:包是挺大的。

3. 光年之外 (简历拒)

三月份猎头帮忙推荐的,简历拒。

4. 北京智源人工智能研究院 (消失)

一共3-4面,面试官是不同team的人,有evaluation,训练等团队。面试时总体感觉他们想招偏evaluation这边的人。面到后面记得有一次面试官鸽了约好的面试,然后后面说从新安排时间,但是猎头或者HR就没有再给后续消息了,应该是默拒了。

5. 360(简历拒)

当时猎头说要高P,P8+

6. Minimax (口头offer):

这家面试轮次挺多,具体记不清但是起码4+轮。

前几轮都是考leetcode为主,问了很少很浅的大模型的内容,记得是其中一面是让手写MHA。最后一轮和主管聊完之后被分配到了框架组的offer,和猎头问了一下算法组是不是考虑,回答是不,就没再继续接触。

PS:他家的包还是挺大的(总包说肯定到得了X+),在几家初创里都算大的,但是面试时公司的前景,业务技术方向感觉面试官没有沟通很多。主管面也是20分钟就匆匆结束了,没有交流很多信息。

7. 昆仑万维 (offer)

面试好像问了之前训练大模型的内容,比如模型参数大小,训练一些细节之类的,印象里没有leetcode。面试官记得很乐呵的一个人。当时拿到的包裹相对低一些,比其他公司。不过后边接触到猎头都说他家给的还是很可以的,所以不确定是不是自己记错了或者交流有误。

8. 云从科技 (拒)

两轮面试被拒掉了,印象很深的是第二轮面试超级长,设定1个小时面试聊了2个多小时。面试官问了很多之前的经验,大模型训练的细节之类的,模型端,框架端,之前做的研究都聊到了。感觉聊的是挺开心的,不过后边就被拒了。

9. 阿里夸克(offer)

4论面试,2轮带leetcode,然后浅浅问了相关经验,第三轮主要问了大模型的内容,比较标准的问题(transformer,训练,分布式,如何处理训练一些问题比如loss spike啥的)。第四轮是cross面,推荐组的一个大佬,感觉是象征性面试,因为之前做过搜广推问了相关问题,问了probability和脑筋急转弯,最后问一些OS的问题我不会。

几天后收到offer,和HR接触时感觉不太礼貌,交流有些摩擦。

10. 衔远(offer)

3面左右,问的也比较中规中矩。最后一面是和周伯文老师聊。他家最后给了框架的岗位,但是我相对想做模型相关。包裹挺大的。

11. 潞晨科技(Colossal-AI)(拒)

他家是做框架为主的,一面问了很多框架内容,各种模型切分方式,问的比较深,好像也问了flash-attention的内容,感觉答得还凑合。

后来我表达了想做算法端,他们算法那边确实也在招人不过hc不多,二面是算法组的人面的,问的应用端比较多,感觉可能不做基座?然后面挂了。他家在圈子里感觉框架端名声挺大的,记得公司内部之前有人发他家新闻来着。

12. 蚂蚁(offer)

徐鹏老师团队。一面记不清了,二面是徐鹏老师本人。聊了之前很多经历,大模型,搜广推,本科实习时的前后端。印象深一点是徐鹏老师表达了团队人希望模型研究和工程都要做,research和engineering不分很细,这个和我的观点很像。接下来一轮HR面就发offer了,第一年算上签字 ** 这样子。

13. 腾讯(简历拒)

猎头说要phd。

14. 小红书(简历拒)

猎头说要phd。

15. 商汤(没消息了,被拒)

一共两面,一面记得是leetcode+写MHA,感觉面得不错。二面好像答得不太好,具体问的啥忘掉了。。。后来没消息了,被拒。

16. 百川智能(拒)

猎头推的,安排了面试,第一面过了之后,后面二面我记错了时间,晚了很久(在外边开车)。然后被HR拒掉了,不过理由说的是要3年以上经验的,不知道是不是给我点面子。

17. 百度文心(offer)

这边面了好多轮。一面是数据组的人,问了很多关于大模型数据处理的内容,感觉答得一般,表达了想去模型组,然后面试官应该是和HR交流了,第二组开始就是模型组的人来面试。有没有leetcode不记得了,面试内容也比较中规中矩,transformer,大模型训练这种内容。后边和leader还有HR聊得也比较通畅。和初创不一样他家组分得挺细的,模型,框架,数据啥的都是分开的。(包裹底薪* 万多,几个月忘了)

18. 科大讯飞(拒)

HR先聊的,觉得我不可能来合肥就拒了。

19. IDEA研究院(拒)

这家确实啥也不记得了,记得的就是一面就被拒了,很尴尬。

20. 好未来(offer)

他家感觉团队整体背景在众多公司中相对一般,一面问了一个简单的leetcode没答上来很尴尬,模型轮可能比较好最后还是给offer了。问题也比较中规中矩,包裹没聊。做的项目是数学相关的GPT模型,个人也不是很了解这个方向。

21. 零一万物(拒)

一面是之前阿里的推荐系统那边的大佬,问了leetcode和一些推荐系统的问题,感觉答得还可以。二面也是个大佬有搜广推,NLP相关很多经验,考了个需要动点脑子的leetcode,没答上来,挂了。没有走到很靠后,好奇他家后边面试会不会有大模型的大佬来面。

22. 月之暗面(moonshot)(拒)

这家感觉面试问的广度和深度是国内厂面的里边最相关也最专业的。一面是个大佬,之前Kaiming大神一些高引论文的共同作者。一开始问了包括一些基础的大模型训练的内容,transformer架构。然后开始问一些框架端的内容,分布式训练的切割和device之间交流,后面follow-up的问题问了不同device之间communication怎么做,底层communication算法有啥,我答案里有ring-reduce,然后再深入问了reduce底层如何实现,我就不会了。问了会不会用cuda写东西,我说了解很浅。最后给了比较难的leetcode,题目不记得了,没写出来,挂。看了下他家主页,感觉创始人和员工都很牛。这家虽然只有一面感觉在国内应该是背景很top的一家了。很可惜没有机会多聊一些。

23. 阿里达摩院(新达摩)(offer)

一面考了leetcode,浅问了大模型技术。第二面是团队大老板,海归,之前在北美连续创业成功,汇报行癫。聊了很多高层的对于大模型技术上的愿景和理解,大模型未来市场方向之类的,我其实听不特别懂,不过学到了很多。他家是纯研究方向,算力听意思挺nb的。主要做大语言模型和多模态大模型这两方面的。最后说我一面leetcode不太行,补了一面coding,然后收到了offer。

24. 边塞科技 (拒)

这家专门做RLHF,微调的。清华背景,创始人有openai的经验。聊了两面感觉在RLHF上积累特别多,学到了很多东西。楼主RL是个票友级别就无了。

总结

这段时间面试了很多家,也学到了超级多东西。楼主这边背景是做基座预训练算法端为主的,对框架端和RL的内容有一定了解(面试能凑合),对于后端的知识比如ML compiler,kernel,cuda相关的了解就比较浅了(问到觉大概率挂)。硬件几乎不太懂。感觉一圈聊下来几点感悟:

  1. 大模型这方向真的卷,面试时好多新模型,新paper疯狂出,东西出的比我读的快。
  2. Research岗位对工程也有要求,工程端也需要了解模型。
  3. 感觉比较硬核的岗位,尤其初创公司都是对好几个点都有要求的(应用,模型,框架,底层后端,硬件)。
  4. 楼主目前是:模型 > 框架 > 底层 > 其他。下一步想不放下模型的前提下,发展底层这边的能力(kernel等)
  5. 目前市场还看不太清,楼主对市场之前不太关注,也不感兴趣,技术宅。
  6. RLHF很有前景的方向,强化学习如果经历够的话也要深挖一下。
  7. 大模型包总体给的相对高一些(同P)。
  8. 目前大多数公司还是集中在语言模型,偏研究的方向会有多模态的预训练这意思。

考点

一些比较高频的东西(针对基座算法/框架岗位为主,大体按重要性排序):

  1. 多头注意力,频率太高了。coding轮,概念轮都考。复习的点包括:时间/空间复杂度,优化(kv-cache,MQA,GQA),手写多头代码。各种Norm,这个频率也不低,不过比较标准的内容,没有啥特意要说的,有的考手写,有的考概念和理解(为什么管用)。
  2. 框架相关内容,各种并行方式,优缺点。DeepSpeed,Megatron可以看看源代码,Flash-Attention等内容。这个点也经常考代码题。
  3. BERT,GPT等比较主流大模型,一些细节,比如位置编码,训练loss,激活,架构些许不同这种。自回归重点。
  4. 大模型训练,这个可能主要是工作经验相关,经常问比如训练loss炸掉了,如何解决,一些技巧之类的。面试时有些面试官会问一些很细节的东西,感觉是在确认确实上手跑过基座训练不是吹水。
  5. 数据预处理,BPE,tokenization,mask相关概念和对模型/训练影响,数据配比(有paper)。
  6. evaluation,如何评估大模型,安全性,有效性,公开数据,个别考过手写eval框架(多选,生成)。
  7. 根据投的岗位,多模态和RLHF内容可以适当看看。这俩感觉paper挺重要的,也大多研究岗位。楼主也少面了一些自动驾驶,RL啥的,不过结果不咋地。

PS:有些非基座相关的或者实在没啥印象的就没写。

​最后

我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。

我整理出这套 AI 大模型突围资料包:

  • ✅AI大模型学习路线图
  • ✅Agent行业报告
  • ✅100集大模型视频教程
  • ✅大模型书籍PDF
  • ✅DeepSeek教程
  • ✅AI产品经理入门资料

完整的大模型学习和面试资料已经上传带到优快云的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
​​
在这里插入图片描述

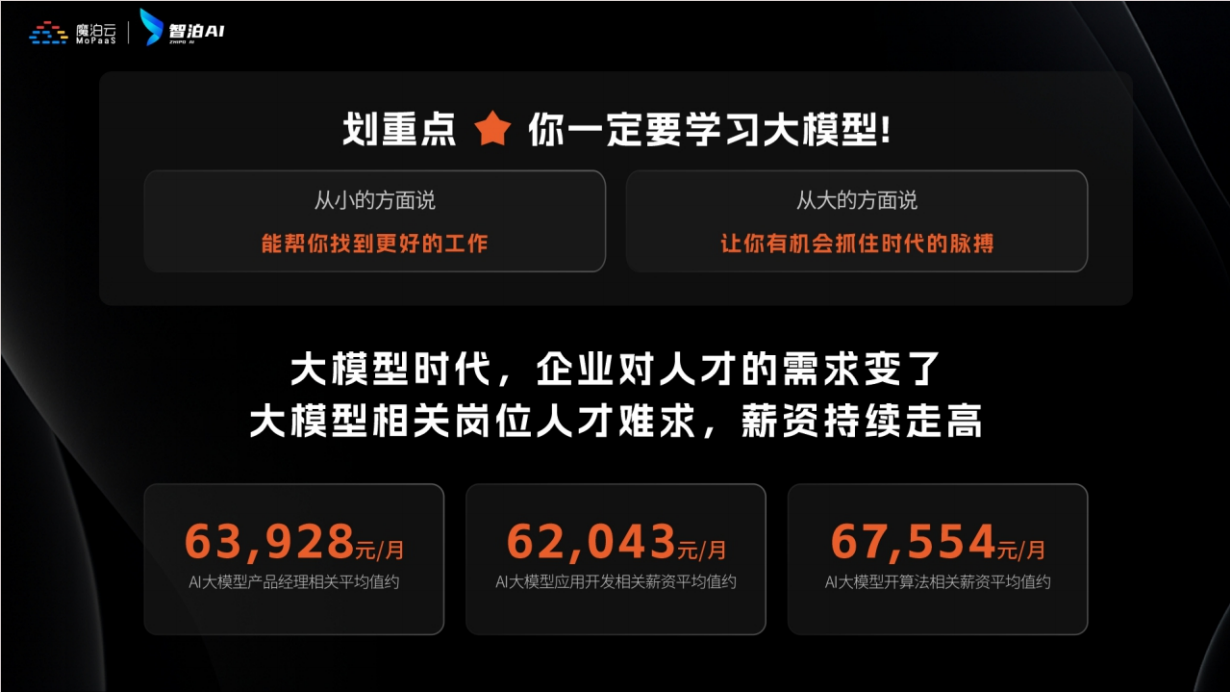
为什么说现在普通人就业/升职加薪的首选是AI大模型?

人工智能技术的爆发式增长,正以不可逆转之势重塑就业市场版图。从DeepSeek等国产大模型引发的科技圈热议,到全国两会关于AI产业发展的政策聚焦,再到招聘会上排起的长队,AI的热度已从技术领域渗透到就业市场的每一个角落。
img
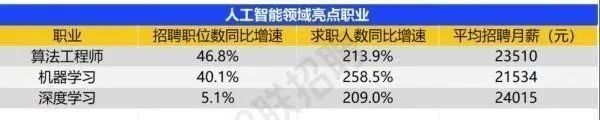
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。

AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
在这里插入图片描述

​​
在这里插入图片描述

资料包有什么?

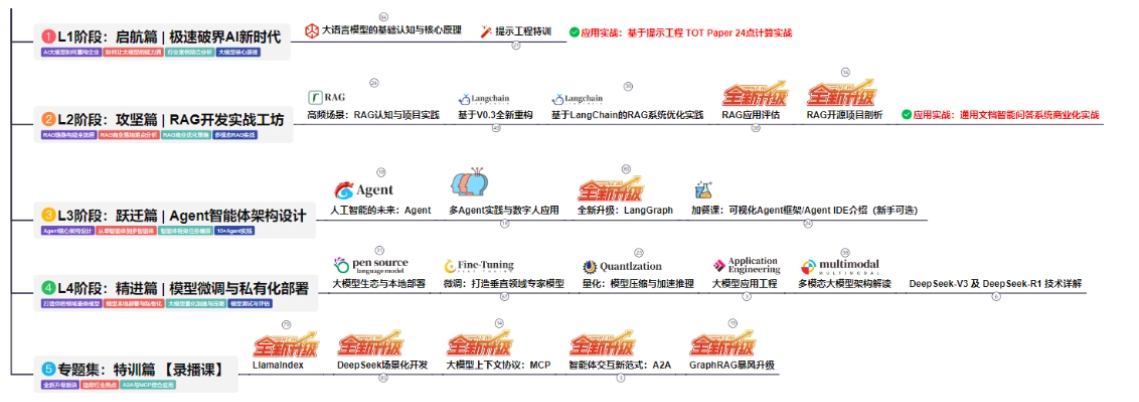
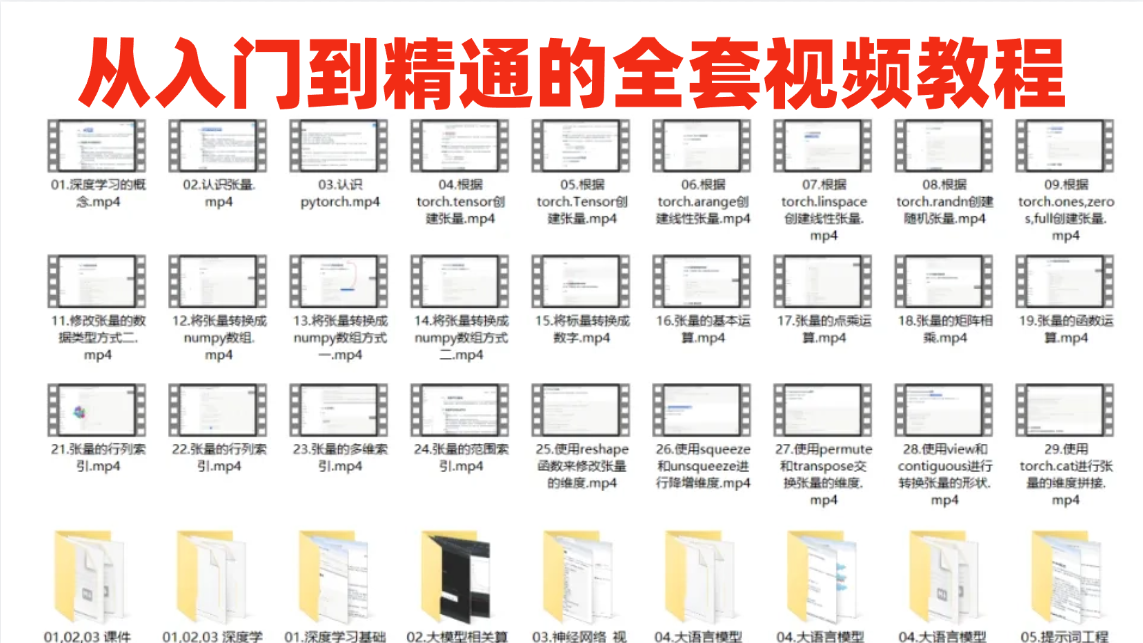
①从入门到精通的全套视频教程⑤⑥

包含提示词工程、RAG、Agent等技术点
在这里插入图片描述

② AI大模型学习路线图(还有视频解说)

全过程AI大模型学习路线

在这里插入图片描述

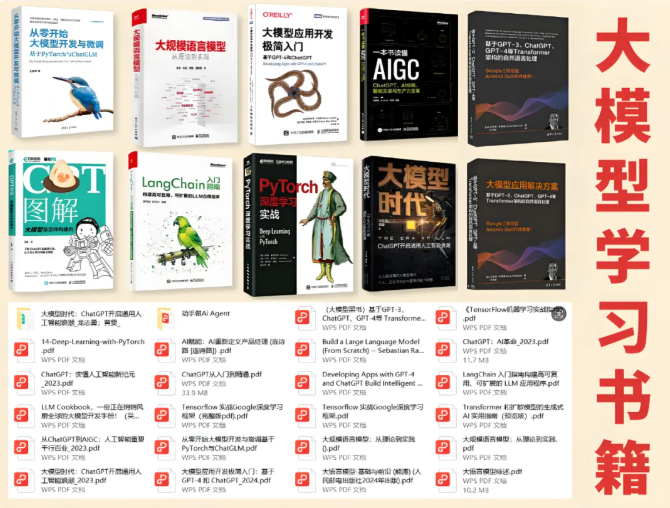
③学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
在这里插入图片描述

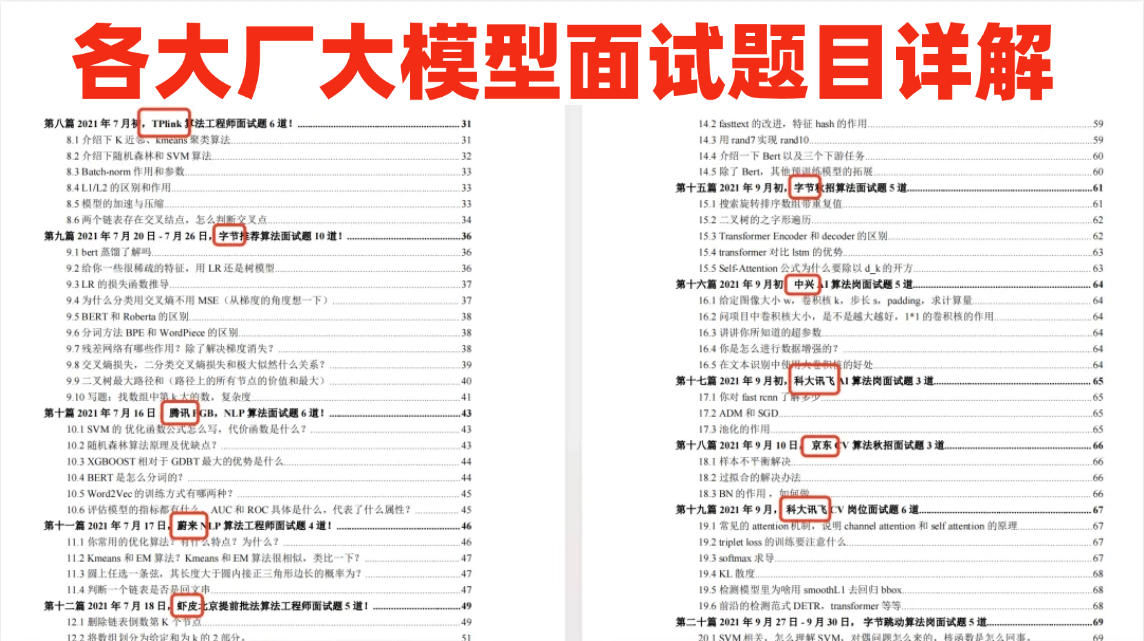
④各大厂大模型面试题目详解

在这里插入图片描述

⑤ 这些资料真的有用吗?

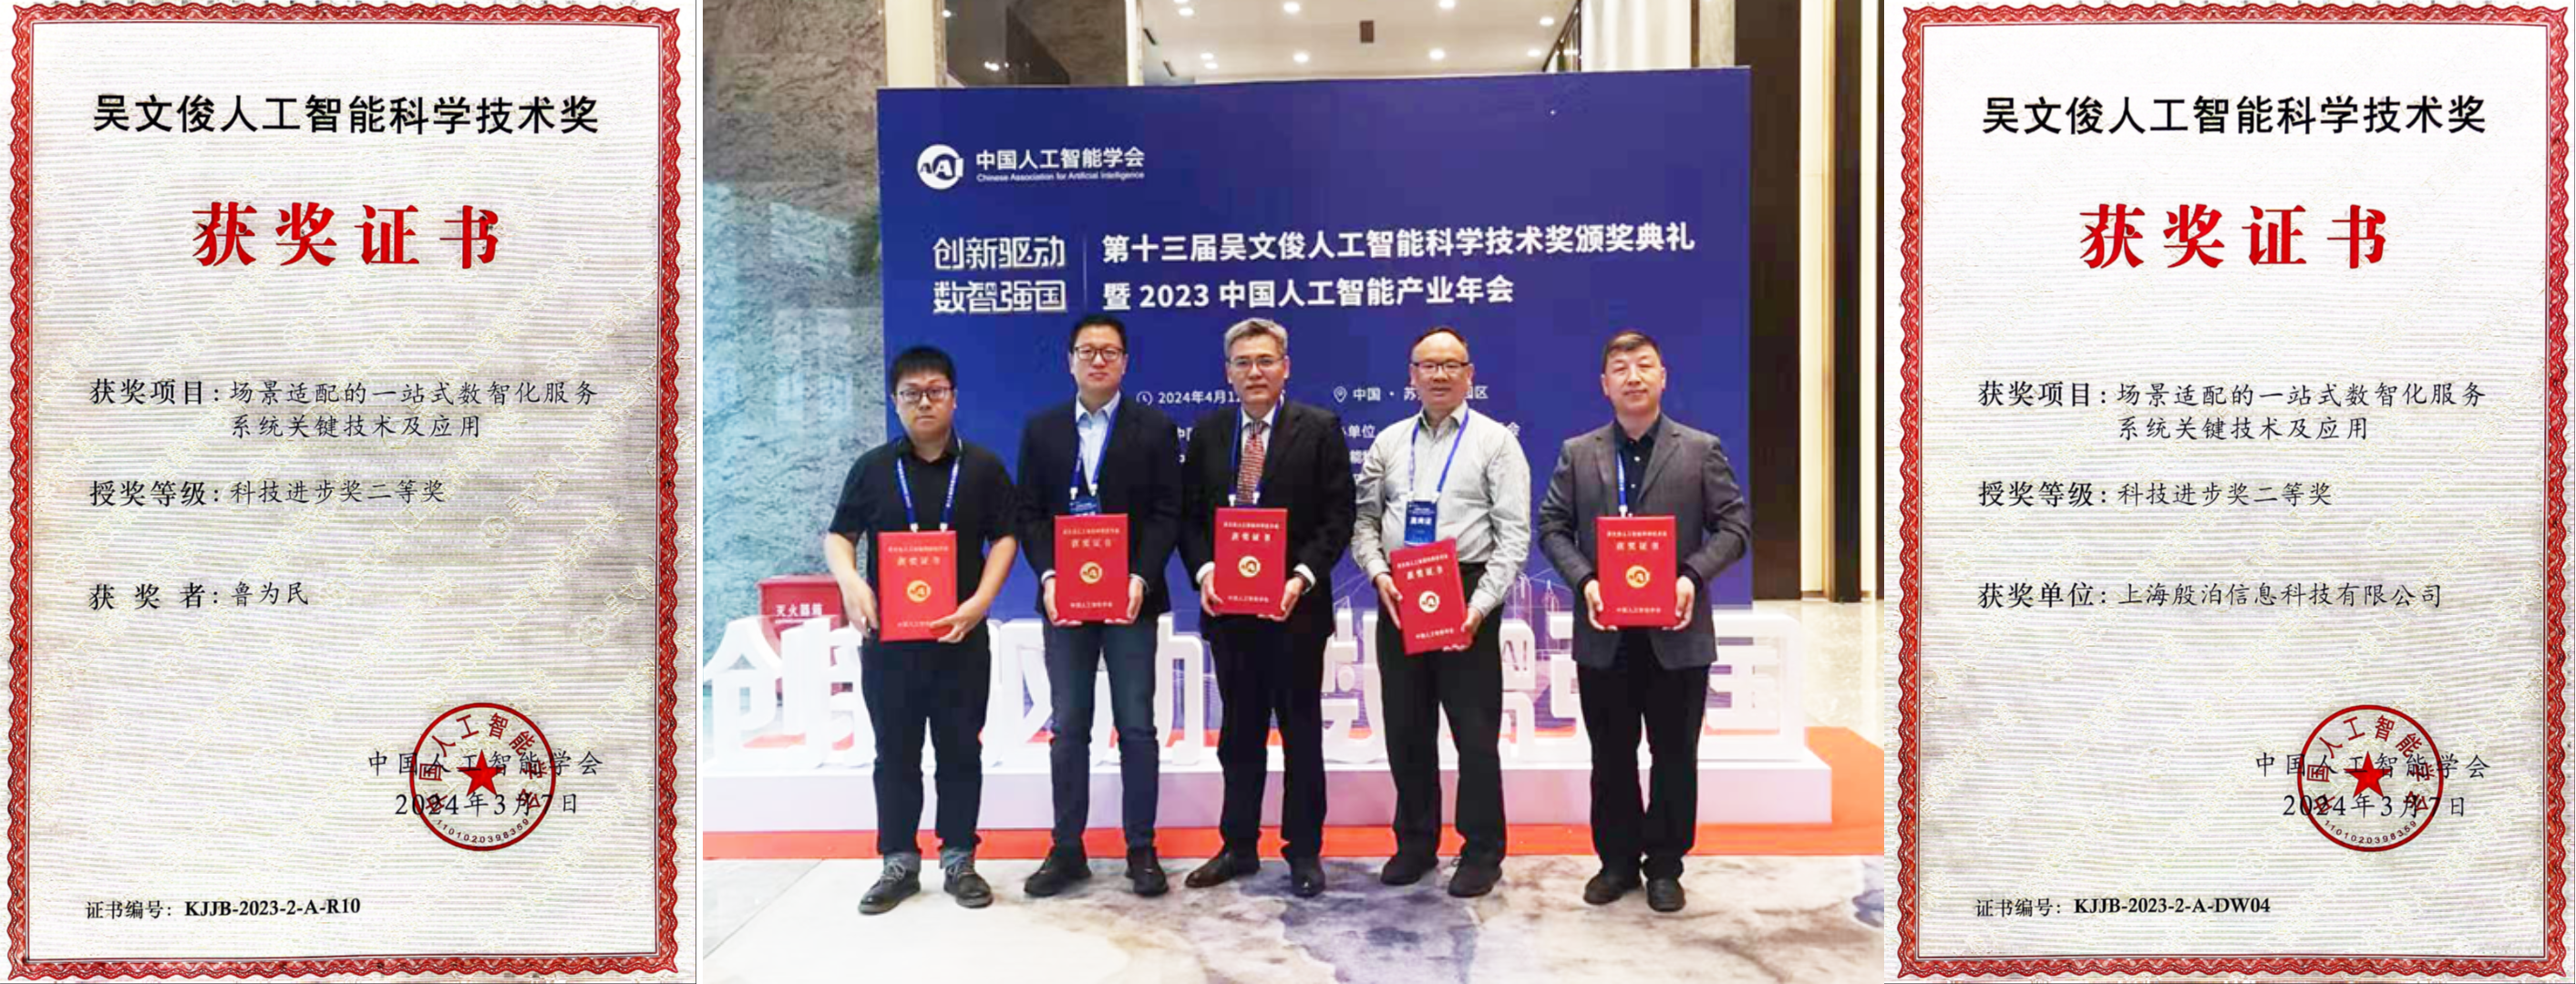
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。

所有的视频教程由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
在这里插入图片描述
在这里插入图片描述

智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念‌,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势‌,构建起"前沿课程+智能实训+精准就业"的高效培养体系。

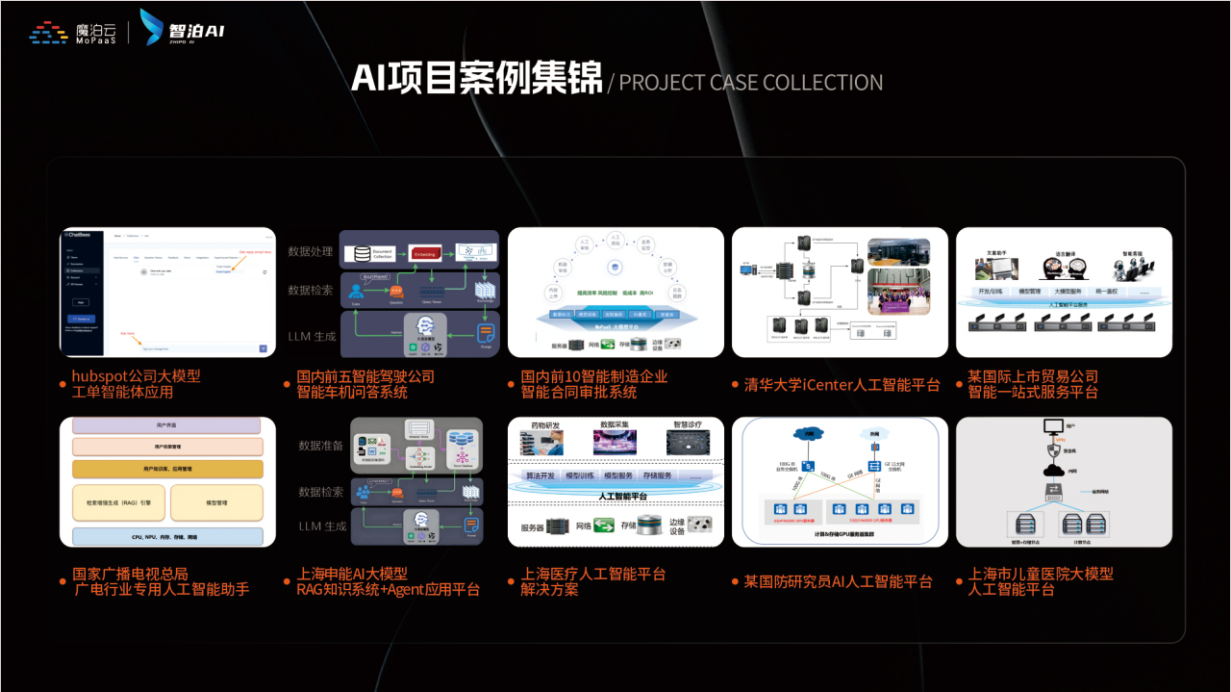
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

​​​​在这里插入图片描述
在这里插入图片描述

如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!

应届毕业生‌:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能 ‌突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

👉获取方式:

😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓**
在这里插入图片描述

​

从立项到上线三个月:面试鸭在线刷题工具的产品与技术复盘 在线刷题是程序员面试准备中的高频场景,力扣等平台虽提供海量题目,但缺乏针对面试的系统化路径。面试刷题工具的核心价值在于将算法练习、八股文背诵和场景题训练整合为一条清晰的学习曲线,并通过记忆曲线与错题回流机制提升复习效率。在工程实践上,需要兼顾题库质量、冷启动推荐和性能优化。以面试鸭为例,复盘其从产品定位、题库体系设计、核心功能实现到冷启动运营的完整过程,并整理上线踩坑经验,为工具型产品开发者和面试准备者提供参考。 阅读详情

相关推荐

大模型面试高频问题整理

最近大模型相关的招聘非常多,大模型相关的面试也初步完善,小编整理了一些大模型面试常见问题,供大家参考。希望在找相关机会的同学能有好的收获。70% 985高校及海外硕博,30% 互联网精英及自主创业者,持续学习者的专属圈。layer normalization和batch normalization的区别?encoder的attention和decoder的attention的区别?为什么现在的大模型大多是decoder-only的架构?attention的复杂度?attention的优化?

具身机器人和通用AI 2522

超详细!大模型面经指南(附答案)

LLM(Large Language Model,大型语言模型)是指基于大规模数据和参数量的语言模型。Transformer架构:大模型LLM常使用Transformer架构,它是一种基于自注意力机制的序列模型。Transformer架构由多个编码器层和解码器层组成,每个层都包含多头自注意力机制和前馈神经网络。这种架构可以捕捉长距离的依赖关系和语言结构,适用于处理大规模语言数据。自注意力机制(Self-Attention):自注意力机制是Transformer架构的核心组件之一。

2401_84208172的博客 3634

大模型算法面试 - 基础篇

基础知识1.transformer 八股文a.Self-Attention的表达式b.为什么上面那个公式要对QK进行scalingscaling后进行softmax操作可以使得输入的数据的分布变得更好,你可以想象下softmax的公式,数值会进入敏感区间,防止梯度消失,让模型能够更容易训练。c.self-attention一定要这样表达吗?不一定,只要可以建模相关性就可以。当然,最好是能够高速计算(矩阵乘法),并且表达能力强(query可以主动去关注到其他的key并在value上进行强化,并且忽略不相关的其

具身机器人和通用AI 2316

大模型开发者面试核心能力与高频考点解析

Transformer架构作为现代大模型的基础,通过自注意力机制实现长距离依赖建模,其核心在于QKV矩阵运算与位置编码设计。在工程实践中,PyTorch和Hugging Face生态成为主流开发工具,而模型量化与LoRA微调技术能显著降低计算资源消耗。面对企业级应用场景,开发者需平衡模型性能与部署效率,例如通过vLLM实现低延迟推理,或运用Flash Attention优化显存占用。当前大模型岗位面试重点考察候选人的三维能力:数学推导功底、框架实操经验及业务解决方案设计能力,其中显存优化技巧和Prompt工

weixin_30719711的博客 395

YOLOv8 轴承缺陷检测 使用YOLOv8进行训练、评估和可视化预测结果 包含1440张图片的轴承缺陷检测数据集 YOLO格式或XML格式

本文介绍了一个基于YOLOv8的轴承缺陷检测项目。数据集包含1440张图片,标注了4类缺陷(凹槽、凹陷、卡伤、划痕),按8:1:1比例划分为训练集(1152张)、验证集(144张)和测试集(144张)。标注文件支持YOLO格式和XML格式,可直接用于模型训练。项目实现了数据准备、模型训练、评估及可视化预测结果的全流程,使用YOLOv8n预训练模型进行50个epoch的训练,并提供了数据格式转换(XML转YOLO)的代码示例。最终模型可自动检测轴承表面缺陷,并保存预测结果。

OICQQ67658008的博客 1445

别再乱删文件了!修复Print Spooler服务自动停止的3个关键检查点(附Win10/Win11实测)

本文深入解析Windows系统中Print Spooler服务自动停止的常见原因及修复方法。从第三方驱动冲突、权限与服务依赖关系到打印队列积压,提供3个关键检查点的详细排查步骤,帮助用户彻底解决打印服务异常问题,适用于Win10/Win11系统。

weixin_31569671的博客 679

DeepResearch:基于LangGraph的可审计科研智能体工作流

科研智能体(Research Agent)是面向复杂科学问题的自主推理与执行系统,其核心在于将隐性科研思维转化为可配置、可回溯、可验证的动作链。不同于传统RAG或LLM问答,它依托Agentic AI架构实现Reason-Act-Observe闭环,强调状态管理、条件编排与伦理守门。技术价值体现在提升研究可重复性、加速技术路线验证、支撑基金申报中的AI决策审计。典型应用场景包括材料机理推演、生物实验设计、计算化学流程自动化等。本文聚焦DeepResearch实践,深入LangGraph工作流构建与Super

weixin_30340819的博客 502

君正T31x metartc集成测试

metartc为国内杨大侠部分开源的一款用于嵌入式领域webrtc库,它与谷歌官方webrtc相比,编译到君正平台的可执行文件仅有5M即可实现webrtc的通信。1. 目前实现的是基于开源版v5.0-b0版本做的简单修改,官方的好几个版本都多少缺点东西,我这里给整理了一下。目前是局域网连接的webrtc,后续尝试走stun和turn试一下NAT穿越的效果。

fsmpeg的博客 3159

超全总结!大模型算法面试指南(含答案)

LLM(Large Language Model,大型语言模型)是指基于大规模数据和参数量的语言模型。具体的架构可以有多种选择,以下是一种常见的大模型LLM的架构介绍:Transformer架构:大模型LLM常使用Transformer架构,它是一种基于自注意力机制的序列模型。Transformer架构由多个编码器层和解码器层组成,每个层都包含多头自注意力机制和前馈神经网络。这种架构可以捕捉长距离的依赖关系和语言结构,适用于处理大规模语言数据。

机器学习社区 6138

WorkBench3.2 + VxWorks6.8安装教程

按照FTP连接主机和目标机,将整个VxWorks6.8的安装分为两个部分,一是在主机(win10系统,可以使用虚拟机或者实体机,推荐使用虚拟机)上安装workbench3.2,进行bootrom与VxWroks映像文件的生成,二是在虚拟机上安装VxWorks系统 19.10.10 首先很高兴文章能帮到大家,但由于本人已不做该方向良久,私信和评论的很多问题现在已经无法解答,如果大家有什么问题欢迎...

Alive的博客 3万+

基于STM32与HRTIM的四开关Buck-Boost双向DC-DC电源设计实战(附源码、仿真与设计解析)

本文详细介绍了基于STM32F334的HRTIM高分辨率定时器实现四开关Buck-Boost双向DC-DC电源的设计实战。通过精准的PWM控制、双环PID算法和智能模式切换逻辑,解决了电压震荡与效率优化等关键问题,并提供了完整的源码、PSIM仿真及参数计算,为高性能电源设计提供了实用参考。

7z8x2c4v6b9的博客 299

大模型经典面试题,(非常详细)收藏这一篇就够了!大模型面试题+答案!

LangChain是一个用于构建和运行大型语言模型应用的开源框架。它提供了一套工具和组件,帮助开发者将大型语言模型(如 GPT-3)与其他工具和API结合,以完成更复杂的任务。1、LangChain包含哪些核心概念?Components:可重用的模块,例如API调用、数据库查询等。Chains:将多个Components链接在一起以完成特定任务的流程。Prompt Templates: 用于指导语言模型生成输出的文本模板。Output Parsers:解析语言模型输出的工具。

Everly_的博客 3542

C# chart以鼠标所在位置为中心进行缩放

以前都用labview做一些软件,但给出去总是会遇到版本,安装包过大等一些问题,于是想自学C#,记录一下使用过程中遇到的一些问题和解决措施,便于日后回顾。 在这个项目中需要绘制折线图,由于数据比较大,需要对图表进行缩放操作,以鼠标为中心对图表进行缩放,在网上查找了一些资料没找到我想要的,于是自己想了一个解决方案,可以基本实现,但略显繁琐,由于刚开始学习C#,对一些操作不太了解,若以后遇...

fei的博客 6363

聊一聊国内大模型公司,大模型面试心得、经验、感受(附答案)

这段时间面试了很多家,也学到了超级多东西。楼主这边背景是做基座预训练算法端为主的,对框架端和RL的内容有一定了解(面试能凑合),对于后端的知识比如ML compiler,kernel,cuda相关的了解就比较浅了(问到觉大概率挂)。硬件几乎不太懂。感觉一圈聊下来几点感悟:大模型这方向真的卷,面试时好多新模型,新paper疯狂出,东西出的比我读的快。Research岗位对工程也有要求,工程端也需要了解模型。感觉比较硬核的岗位,尤其初创公司都是对好几个点都有要求的(应用,模型,框架,底层后端,硬件)。

xxue345678的博客 1343

手把手教你用CMake和MinGW64编译libuvc:静态链接与动态链接的选择

本文详细指导如何在Windows平台上使用CMake和MinGW64编译libuvc库,并深入探讨静态链接与动态链接的选择策略。通过对比两种链接方式在部署复杂度、内存占用和版本管理等方面的差异,帮助开发者根据项目需求做出最优决策,实现高效的USB摄像头开发。

weixin_29171087的博客 255

智能驾驶小白必看:MEB低速紧急制动系统的工作原理与传感器配置详解

本文深入解析了MEB低速紧急制动系统的工作原理与传感器配置。该系统作为智能驾驶的关键安全冗余,专为应对停车场、拥堵路段等复杂低速场景设计。文章详细拆解了其如何通过超声波雷达、环视摄像头等传感器融合感知环境,并基于碰撞时间(TTC)等模型进行风险评估与分级制动,最终实现主动防碰撞,是智能驾驶技术实用化的重要体现。

c2d3e4f的博客 1132

【2025超详细汇总】大模型面经指南(附答案)

LLM(Large Language Model,大型语言模型)是指基于大规模数据和参数量的语言模型。Transformer架构:大模型LLM常使用Transformer架构,它是一种基于自注意力机制的序列模型。Transformer架构由多个编码器层和解码器层组成,每个层都包含多头自注意力机制和前馈神经网络。这种架构可以捕捉长距离的依赖关系和语言结构,适用于处理大规模语言数据。自注意力机制(Self-Attention):自注意力机制是Transformer架构的核心组件之一。

2401_84208172的博客 1977

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

大模型面经,不要到处找了,收藏我这一篇就够了

在当前技术快速发展的背景下,大模型领域的职位成为了许多求职者的热门选择。为了帮助大家更好地准备面试,这里整理了一份大模型面试经验分享,涵盖了一些常见的面试流程、可能遇到的技术问题以及面试官可能会问到的行为问题等。大模型面试经验分享一、面试流程大多数大模型岗位的面试流程通常会包含以下几个阶段:简历筛选:根据简历中的技能和经验进行初步筛选。电话/视频初试:一般由HR进行,主要了解求职者的背景、工作经历及求职动机等。技术面试:由技术团队成员进行,侧重于考察求职者的专业知识和技术能力。

2401_84204207的博客 3006

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

超全大模型常见面试题(附答案)

在大模型中,特别是像Transformer这样的模型中,由于自注意力机制(self-attention mechanism)是位置无关的,即无论序列中的token顺序如何变化,通过自注意力机制计算得到的每个token的隐藏嵌入(hidden embedding)都是相同的。这种方法的好处是可以保持预训练模型的大部分参数不变,从而减少过拟合的风险,并加速训练过程。:为了保证Tokenizer在模型训练和推理过程中的一致性,我们需要确保训练和推理时使用的Tokenizer是相同的,并且使用了相同的词汇表。

lyy2017175913的博客 7625

面试面经|2025最新大模型面试八股含答案,非常详细收藏我这一篇就够了

Transformer模型的核心机制是自注意力(Self-Attention),它通过计算查询(Q)、键(K)和值(V)之间的相关性来捕捉输入序列中的依赖关系。为了优化训练过程,Transformer采用了缩放点积注意力(Scaled Dot-Product Attention),通过除以根号d_k来防止梯度消失。此外,Transformer使用层归一化(Layer Norm)而非批归一化(Batch Norm),因为层归一化更适合处理序列数据,能够保留同一序列内不同位置的信息。BERT模型引入了位置嵌入(

lyy2017175913的博客 3654

2025年大模型面试指南:超详细问题与答案汇总,助你轻松应对面试挑战!

文章摘要:本文全面探讨了大模型(LLMs)的基础、进阶、微调及LangChain应用等多个方面。基础部分涉及主流开源模型体系、prefix LM与causal LM的区别、涌现能力及大模型架构。进阶部分讨论了LLMs的复读机问题、模型选择、长文本处理等。微调部分详细介绍了全参数微调、SFT指令微调、领域模型训练等技术与挑战。LangChain部分则涵盖了文档对话、模型幻觉处理、核心概念及使用技巧。此外,还提供了丰富的学习资源,包括学习路线、必读书籍、实战项目等,为深入理解和应用大模型技术提供了全面指导。

m0_63171455的博客 2012

2024年最全汇总:国内24家大模型面试经验分享

2024年三月前后,大模型突然国内火了起来,笔者就面了一些公司,有大厂有初创。最近挺多朋友聊大模型相关的内容,对面试也感兴趣,想这里综合写一下,也希望能和各位同行交流下。因为有一段时间了(最早面的半年了),所以大部分细节记不清了,列表顺序大概齐按面试时间排的。后边会大体总结下面试的经验感悟,以及我认为要注重的内容,一家之言仅供参考。这段时间面试了很多家,也学到了超级多东西。

2401_84204413的博客 1881

超详细的总结!大模型算法岗面试题(含答案)来了!

如果你想加入我们的讨论群、星球或者希望要更详细的资料,加入我们。

机器学习社区 4370
上一篇: 2025年LLM技术突破全解析:从RLVR到氛围编程,小白也能掌握的大模型前沿指南
下一篇: 基础学大模型的3步高效法:点线面学习路线,快速掌握核心知识
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值