大模型显存计算:手把手教你计算Llama 70B所需显存

Cursor使用谷歌Gemini API Cursor本身是收费产品,在Cursor试用期过后,调用Cursor模型速率会下降,需要排队等待,现在谷歌Gemini API是暂时不收费的,上下文也足够长,本文配置Cursor使用Gemini API并进行编程体验。 阅读详情

文章详细介绍了大模型(以Llama 70B为例)推理所需GPU显存的计算方法,包括模型权重显存(140GB)、KV Cache显存(800GB)和其他开销(94GB),总计约1TB。文章强调KV Cache是显存占用的主要部分,受并发用户数和上下文长度影响显著。作者提供了优化建议,如单用户场景可减少至250GB,缩短上下文可降低至400GB,并指出实际可通过PagedAttention、量化等技术进一步优化显存使用。


引言:部署大模型的第一道门槛

当我们准备部署一个大语言模型并提供服务时,最先遇到的问题往往是:我到底需要准备多少GPU显存?

这不仅关系到硬件成本,更直接影响服务的并发能力和响应速度。今天,我们就以Llama 70B模型为例,手把手教你计算推理所需的GPU显存。

📋 案例参数设定

让我们先明确计算的基础参数:

  • 模型规模:Llama 70B(700亿参数)
  • 模型层数:80层
  • 上下文长度:最大支持32K tokens
  • Hidden Dimension:8196
  • 参数精度:每个参数2个bytes(FP16)
  • 并发用户数:10个同时请求

基于这些参数,我们开始逐步计算所需的GPU显存。

💾 第一部分:模型权重显存

首先要计算的是模型本身占据的显存,因为我们需要把整个模型加载到GPU中。

计算公式:


模型显存 = 参数量 × 每参数字节数
        = 70B × 2 bytes
        = 70 × 10^9 × 2 bytes
        = 140 GB
 

这个140GB是模型权重的基础占用,无论有多少用户请求,这部分都是固定的。

🚀 第二部分:KV Cache显存(重点!)

这是显存占用的大头,也是最容易被忽视的部分。

什么是KV Cache?

在大模型推理时,文本是逐个token生成的。为了加速这个过程,我们使用KV Cache机制来缓存中间计算结果。

如果没有KV Cache,每生成一个新token,都需要重新计算之前所有token的注意力权重,这会导致大量重复计算,严重影响推理效率。

KV Cache显存计算

KV Cache的计算分为两步:

步骤1:计算单个token的KV Cache大小


单token显存 = 层数 × Hidden Dimension × 字节数 × 2(Key + Value)
           = 80 × 8196 × 2 bytes × 2
           = 2.5 MB
 

步骤2:计算总KV Cache


总KV Cache = 单token显存 × 上下文长度 × 并发用户数
          = 2.5 MB × 32K × 10
          = 2.5 MB × 32,000 × 10
          = 800 GB
 

注意:每个用户都需要独立的KV Cache,因为每个请求的上下文都不同。这就是为什么并发数对显存需求影响巨大!

🔧 第三部分:其他显存开销

除了模型权重和KV Cache,还有一些额外的显存占用:

1. Activation(激活值)

神经网络每一层计算时产生的激活函数输出,需要暂存在显存中。

2. Buffers(缓冲区)

存放中间变量的临时空间,计算完成后可能会被释放。

3. Overheads(开销)

主要是显存碎片化导致的空间浪费。GPU显存分配是以block为单位的,可能会出现一些block未被充分利用的情况。

估算方法:

这些杂项通常按模型权重和KV Cache总和的**10%**来估算:


其他开销 = (140 GB + 800 GB) × 10%
        = 94 GB
 

📊 总显存需求计算

现在我们可以得出最终结果:


总显存需求 = 模型权重 + KV Cache + 其他开销
          = 140 GB + 800 GB + 94 GB
          = 1,034 GB ≈ 1TB
 

也就是说,要支持10个并发用户使用Llama 70B模型,我们大约需要1TB的GPU显存!

💡 实用优化建议

场景1:单用户场景

如果只有1个用户,KV Cache显存大幅降低:


KV Cache = 2.5 MB × 32K × 1 = 80 GB
总显存 = 140 + 80 + 22 = 242 GB
 

所需显存减少到约250GB,只需3-4张A100(80GB)即可。

场景2:更短的上下文

实际应用中,很多请求的上下文长度远小于32K。如果平均上下文为8K:


KV Cache = 2.5 MB × 8K × 10 = 200 GB
总显存 = 140 + 200 + 34 = 374 GB
 

显存需求降低到约400GB,大幅节省成本。

🎯 总结与延伸

通过本文的计算方法,你可以快速估算任何大模型在不同场景下的显存需求:

关键计算要素:

  1. ✅ 模型参数量 × 参数精度
  2. ✅ KV Cache = 层数 × Hidden维度 × 上下文长度 × 并发数
  3. ✅ 其他开销约为总和的10%

重要提示:

  • 本文计算基于标准KV Cache推理方式
  • 实际还有许多显存优化技术(如PagedAttention、量化等)可以大幅降低显存需求
  • 不同推理框架的实现也会影响实际显存占用

​最后

我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。

我整理出这套 AI 大模型突围资料包:

  • ✅AI大模型学习路线图
  • ✅Agent行业报告
  • ✅100集大模型视频教程
  • ✅大模型书籍PDF
  • ✅DeepSeek教程
  • ✅AI产品经理入门资料

完整的大模型学习和面试资料已经上传带到优快云的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
​​
在这里插入图片描述

为什么说现在普通人就业/升职加薪的首选是AI大模型?

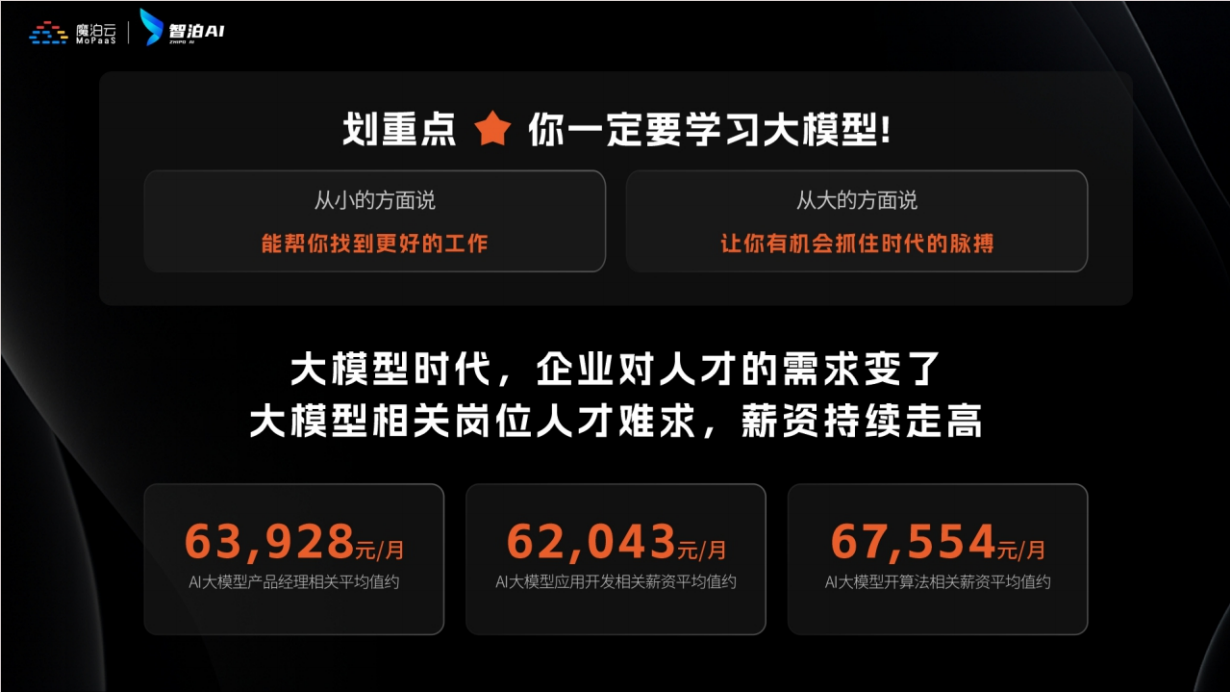
人工智能技术的爆发式增长,正以不可逆转之势重塑就业市场版图。从DeepSeek等国产大模型引发的科技圈热议,到全国两会关于AI产业发展的政策聚焦,再到招聘会上排起的长队,AI的热度已从技术领域渗透到就业市场的每一个角落。
img
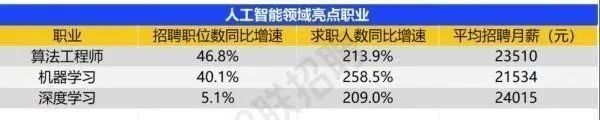
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。

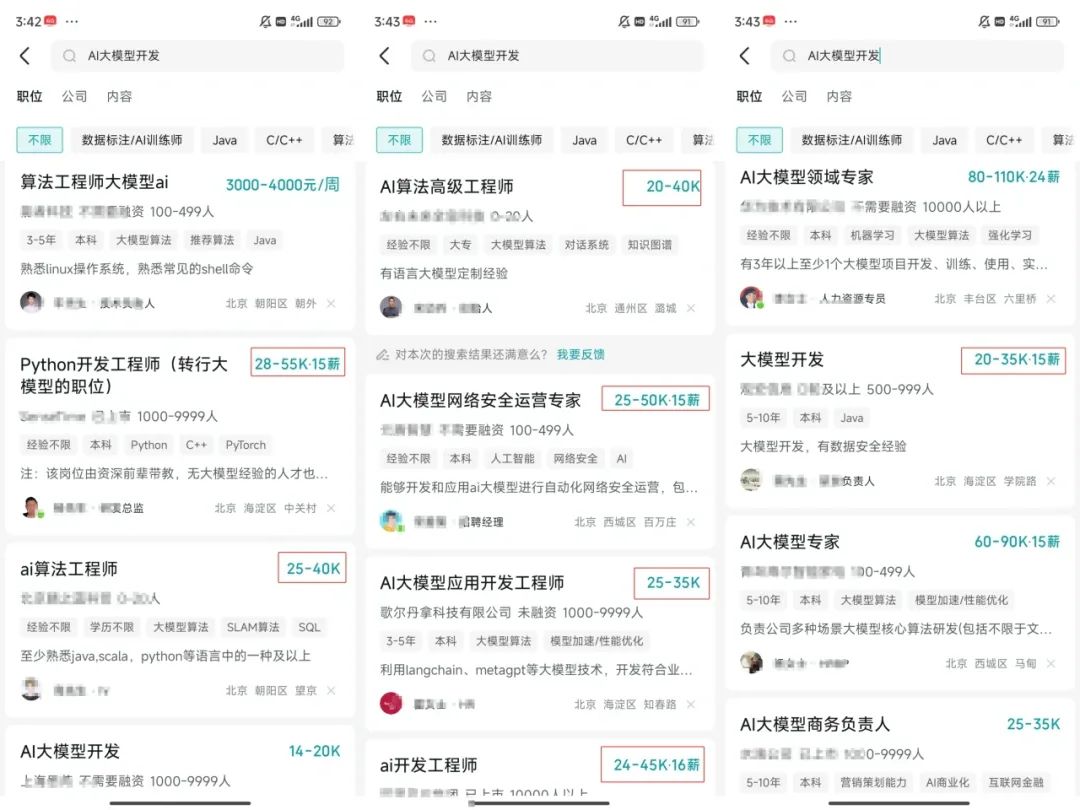
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
在这里插入图片描述

​​
在这里插入图片描述

资料包有什么?

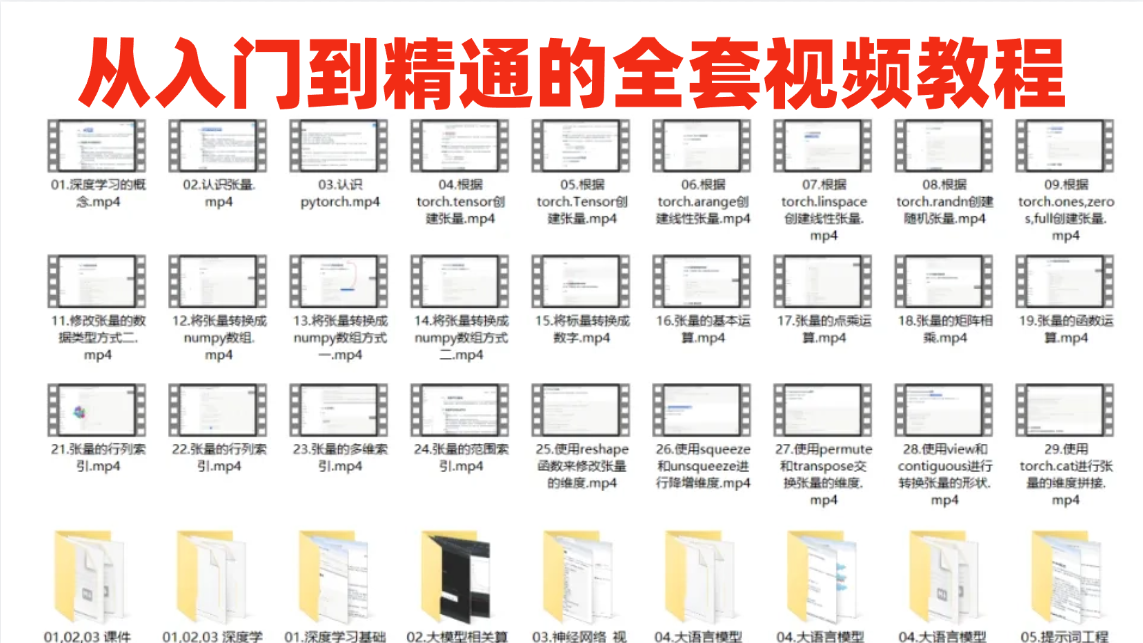
①从入门到精通的全套视频教程⑤⑥

包含提示词工程、RAG、Agent等技术点
在这里插入图片描述

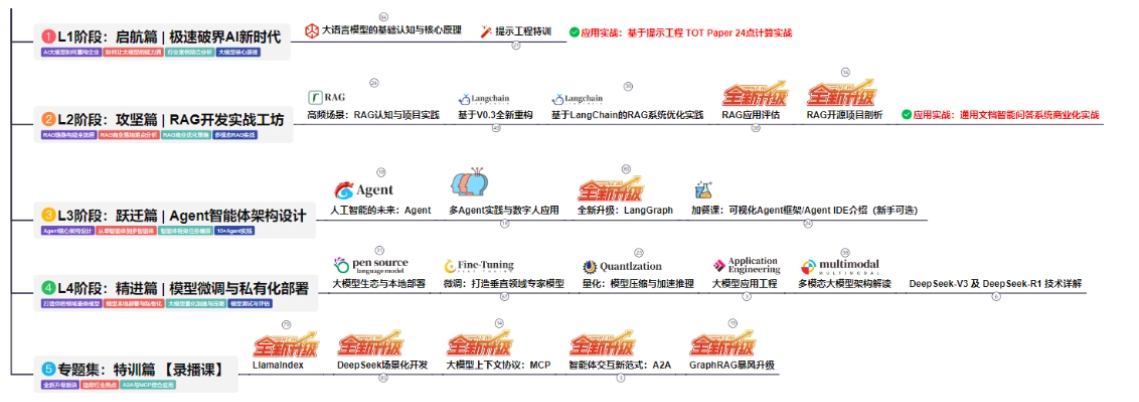
② AI大模型学习路线图(还有视频解说)

全过程AI大模型学习路线

在这里插入图片描述

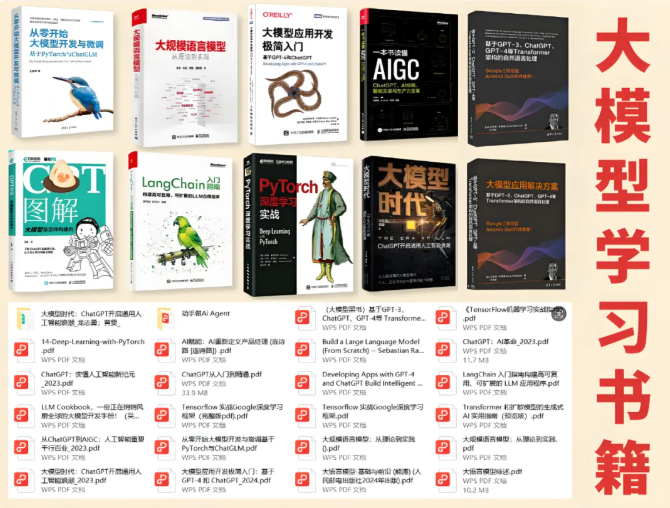
③学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
在这里插入图片描述

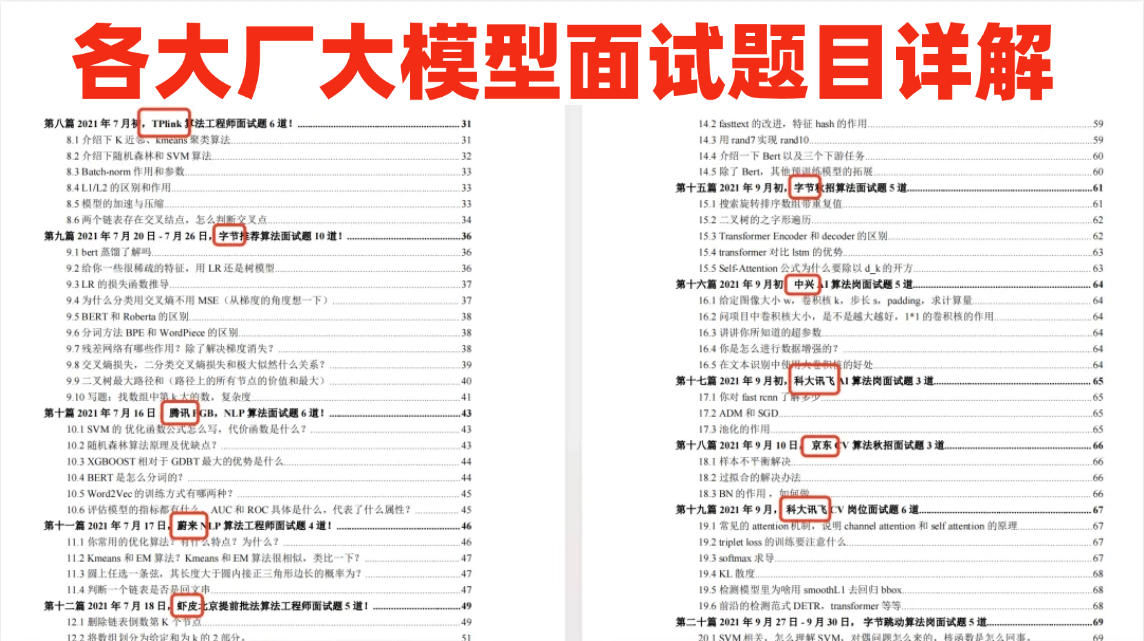
④各大厂大模型面试题目详解

在这里插入图片描述

⑤ 这些资料真的有用吗?

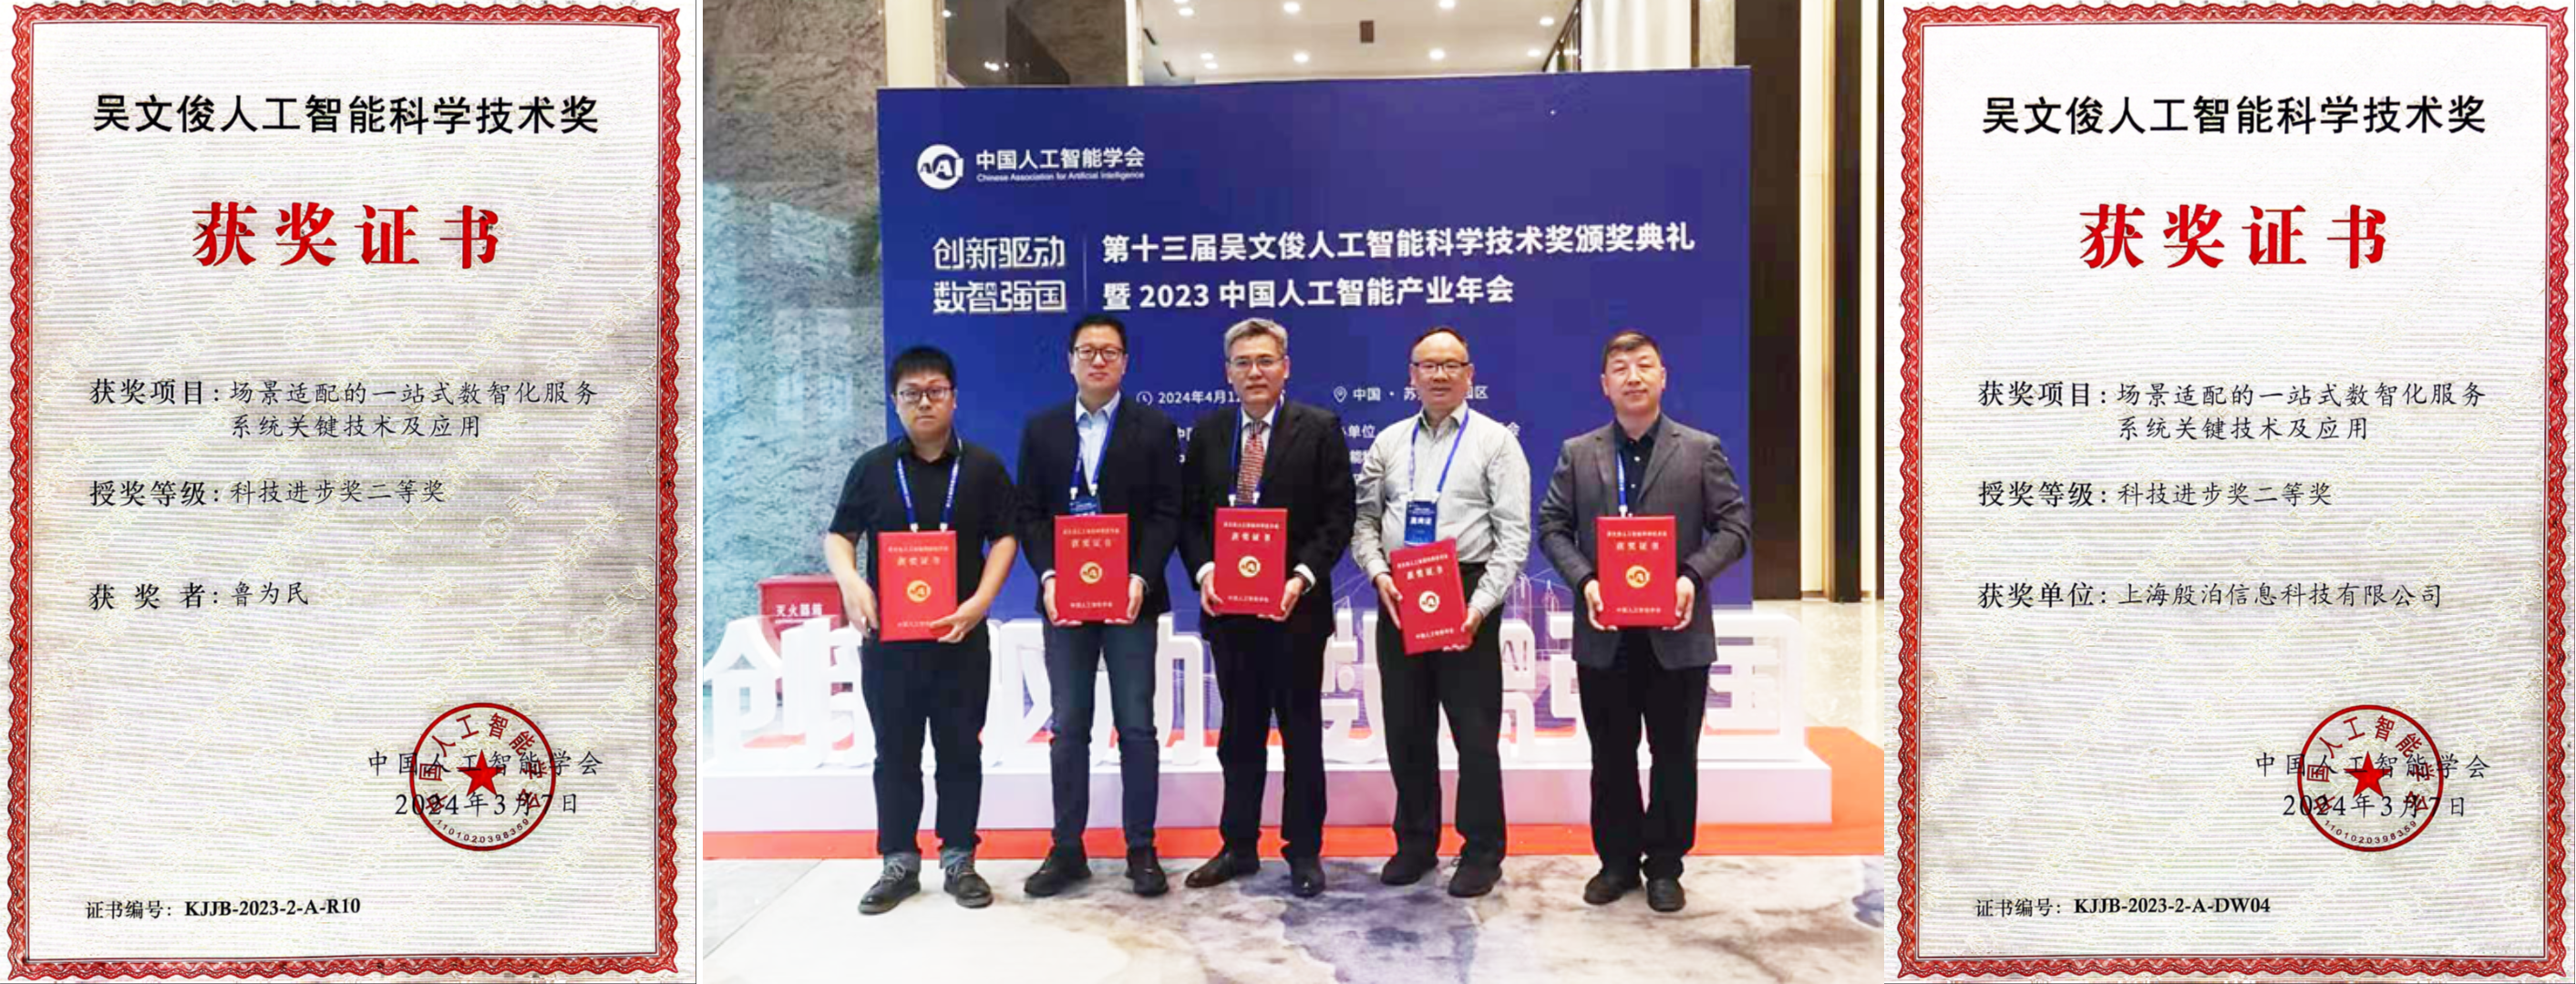
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。

所有的视频教程由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
在这里插入图片描述
在这里插入图片描述

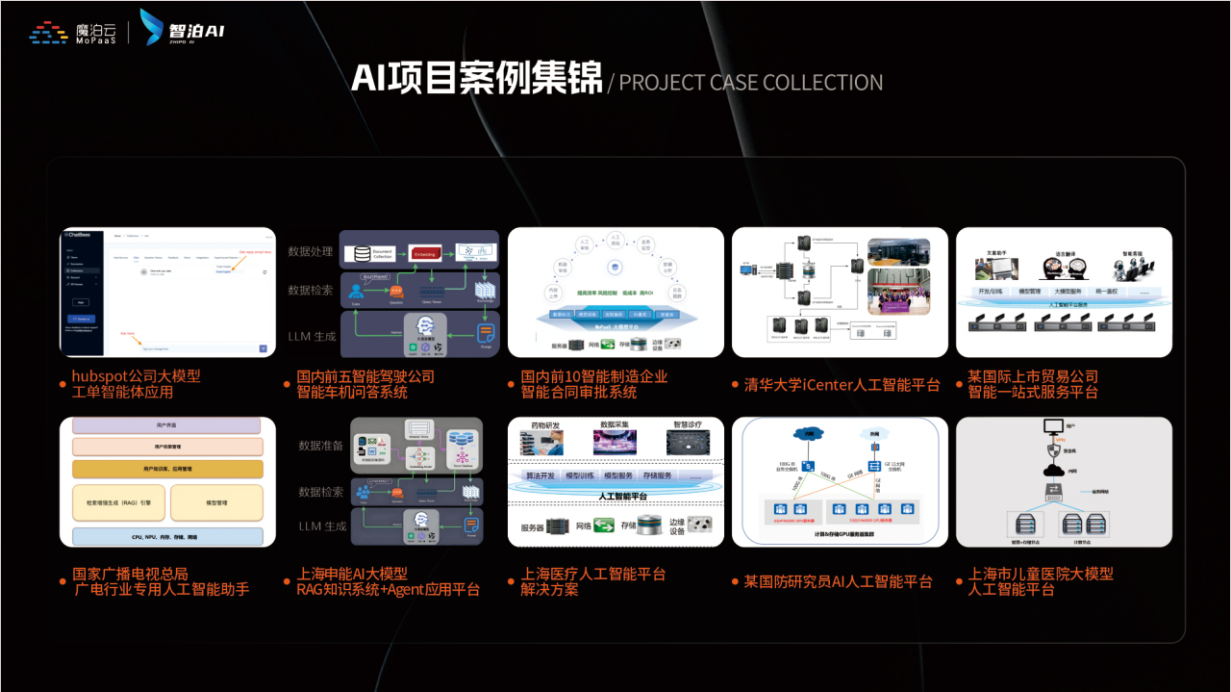
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念‌,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势‌,构建起"前沿课程+智能实训+精准就业"的高效培养体系。

课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

​​​​在这里插入图片描述
在这里插入图片描述

如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!

应届毕业生‌:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能 ‌突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

👉获取方式:

😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓**
在这里插入图片描述

​

Open Notebook:开源 AI 笔记工具,支持多种文件格式,自动转播客和生成总结,集成搜索引擎等功能 Open Notebook 是一款开源的 AI 笔记工具,支持多格式笔记管理,并能自动将笔记转换为博客或播客,适用于学术研究、教育、企业知识管理等多个场景。 阅读详情

相关推荐

高度复刻谷歌的AI播客产品NotebookLM:Open Notebook

随着人工智能技术的发展,笔记和研究工具也在不断进化。今天我们要介绍的是一个高度创新且功能强大的平台——Open Notebook。它不仅支持多种大语言模型(LLM),还提供了一系列先进的功能,如多笔记本管理、内容集成、自动生成播客等,旨在为用户提供一站式的智能化笔记解决方案。

这里汇聚了前沿的技术分享与实用的开发技巧,带你探索从创意到企业的技术创业之路。 840

【大模型微调】一文掌握7种大模型微调的方法

本篇文章深入分析了大型模型微调的基本理念和多样化技术,细致介绍了LoRA、适配器调整(Adapter Tuning)、前缀调整(Prefix Tuning)等多个微调方法。详细讨论了每一种策略的基本原则、主要优点以及适宜应用场景,使得读者可以依据特定的应用要求和计算资源限制,挑选最适合的微调方案。大型语言模型(LLM)的训练过程通常分为两大阶段:阶段一:预训练阶段在这个阶段,大型模型会在大规模的无标签数据集上接受训练,目标是使模型掌握语言的统计特征和基础知识。

python123456_的博客 5万+

语义通信高斯信道仿真代码

【代码】语义通信高斯信道仿真代码。

一去不复返的通信er 427

一文彻底搞懂大模型微调

大模型微调(Fine-tuning)是指基于预训练的大型语言模型(如GPT、BERT等),通过特定领域或任务的数据进行二次训练,使模型适应具体应用场景的技术过程。与从零开始训练相比,微调能够以较低成本实现模型的领域适配,是AI大模型落地应用的核心技术路径。

2501_91381485的博客 5226

Win11上WSL2安装Ubuntu22.04避坑指南:从镜像源到C++环境配置

本文详细介绍了在Win11系统上安装和配置WSL2及Ubuntu22.04开发环境的完整流程与避坑指南。内容涵盖从解决网络安装错误、更换国内镜像源以加速软件更新,到一站式配置C++开发工具链(包括GCC、GDB、CMake等),并提供了提升WSL2使用体验的实用技巧和故障排除方法,帮助开发者高效搭建稳定的Linux开发环境。

weixin_29306261的博客 474

告别黑盒调试:用MMSegmentation可视化工具链,从训练到评估一目了然

本文介绍了如何利用MMSegmentation的可视化工具链,从训练到评估实现语义分割模型的透明化调试。通过整合日志分析、混淆矩阵、PR曲线等工具,开发者可以快速定位模型问题,优化性能。文章详细展示了训练曲线分析、性能剖析、混淆矩阵解读和PR曲线应用等关键步骤,帮助用户告别黑盒调试,提升模型开发效率。

weixin_29100927的博客 105

手把手教你计算大模型GPU显存:Llama 70B实战案例

本文详细介绍了大模型GPU显存计算方法,以Llama 70B为例,分析模型权重显存(140GB)、KV Cache显存(800GB)和其他开销(94GB),总计约1TB支持10并发用户。文章提供优化建议,如减少并发数或上下文长度可降低显存需求,并指出显存计算是部署大模型的关键门槛,后续将介绍显存优化技术。

lvaolan168的博客 1326

Joule 终于会说 ABAP 了:从 ADT 提效到 ABAP AI SDK + ISLM 自建企业级 AI 场景的落地路线

生成结构化摘要(故障现象、初步原因、处理动作、备件消耗)自动给出建议分类(电气、机械、软件、网络)把摘要回写到工单抬头,方便后续统计与知识沉淀如果你用 CAP 来做这类服务,通常会在 Node.js 层封装一个对 AI Hub 的调用,再通过 OData 或 Event 把结果写回 SAP。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 343

大模型部署必备:GPU显存计算全解析,从Llama 70B看懂显存需求(建议收藏)

文章详细解析了大模型推理所需的GPU显存计算方法,以Llama 70B为例,分三部分计算显存需求:模型权重(140GB)、KV Cache(800GB)和其他开销(94GB),总计约1TB。文章强调了KV Cache是显存占用的主要部分,并提供了针对单用户和短上下文的优化方案,指出显存优化技术可进一步降低需求。通过本文方法可快速估算任何大模型在不同场景下的显存需求。

2401_85154887的博客 1376

uniapp - 实现苹果App打包上架App Store应用商店详细教程,详解Hbuilder打包编译ipa发布上传到苹果ios软件商店全流程,提供云打包/离线本地打包ios、申请IOS苹果证书方法

uni-app,苹果ios,苹果app,打包编译,appstore应用商店,ipa发布到软件商店,uniapp的app苹果应用商店上架,上架苹果APPStore,uniApp打包的ipa文件上传到商店,上架苹果商城,审核失败,被拒绝,UniApp打包ipa文件,上架iOSAppStore流程指南,最新详细教程最全,Hbuilder打包发布iosapp,苹果云打包上线全过程,云打包IPA并上传到商店,打包iOSipa文件后怎么发布到应用商店,苹果证书申请教程,ios证书申请,mac电脑,审核很久

🏆 前端领域优质创作者 1万+

如何用 Claude Code 阅读和理解陌生代码

摘要: 在接手陌生代码时,Claude Code能显著提升理解效率。核心策略是结构化拆解而非逐行阅读: 从整体入手:先扫描目录结构、定位核心模块,建立项目地图; 聚焦关键路径:通过数据流追踪、异常逻辑分析,识别技术债与风险点; 规避常见错误:避免抽象提问或一次性提交全部代码,应分模块精准提问; 高阶应用:可生成逻辑分层图、标记高复杂度区域,甚至定制阅读顺序。 最终目标是通过结构优先的提问策略,将理解周期从数天压缩至数小时。

sg_knight的专栏 1020

实测:本地跑llama3:70B需要什么配置

前几天发布的开源大语言模型的能力通过测试结果的展示已经达到了一个全新的高度,甚至可以与Claude 3 Sonnet和Gemini 1.5 Pro等一众顶级模型相媲美,甚至在某些方面已经超过了去年发布的两款GPT-4。这一突破使得Llama 3一举成为当前顶流的大语言模型之一。展示一波LLM排名,这么帅还不要钱,就问你想不想要也许从此强大的模型不再只是厂商云端的特权,现在每个人都可以在本地部署Llama 3。无论是8B还是70B的版本,用户都可以选择最适合自己需求的版本进行部署。

m0_59163425的博客 3万+

基于MATLAB的最大重叠离散小波变换(MODWT)算法详解

最大重叠离散小波变换(Maximal Overlap Discrete Wavelet Transform, MODWT)是DWT的重要改进形式,由Percival和Walden等人在20世纪90年代系统提出并完善。MODWT通过消除下采样操作,采用样本平移不变的分解方式,解决了DWT的多个固有缺陷。MODWT的核心创新在于取消下采样环节。与DWT每级分解后对滤波输出进行二分下采样不同,MODWT在每一级都使用相同的滤波器,但通过插入零值的方式调整滤波器系数,保持每级系数数量与原始信号相同。

qq_42212808的博客 115

LLM大模型显存计算

1b(10亿)个模型参数,约占用4G显存(实际大小:10^9 * 4 / 1024^3 ~= 3.725 GB),那么LLaMA的参数量为7b,那么加载模型参数需要的显存为:3.725 * 7 ~= 26.075 GB。综上,int8 精度的 LLaMA-6B 模型部分大致需要 6GB+6GB+12GB+1.3GB = 25.3GB 左右。例如,如果显卡具有1280个核心,时钟速度为1400 MHz,每个核心具有两个浮点运算单元,则该显卡的算力为。int8 的 LLaMA-6B,AdamW 需要 6B。

weixin_40777649的博客 1万+

基于Qt C++开发一个体测数据管理系统

advice.dietAdvice = "饮食建议:\n1. 控制总热量摄入,每天减少300-500大卡\n2. 减少精制碳水(白米饭、白面包、甜食)\n3. 增加优质蛋白和膳食纤维摄入\n4. 烹饪方式以蒸、煮、烤、凉拌为主,减少油炸\n5. 晚餐适量减少,睡前3小时避免进食";dataTable->setHorizontalHeaderLabels({"ID", "用户名", "身高(cm)", "体重(kg)", "BMI", "体脂率(%)", "记录时间"});

寒寒豆豆软件公司的博客 192

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

小显存福音:LLaMA Factory+QLoRA微调70B模型实测

LLaMA Factory支持多种数据格式。确保JSON文件包含"instruction"、"input"、"output"字段对于对话数据,使用"conversations"格式数据集文件应放在data目录下"instruction": "解释量子计算","output": "量子计算是利用..."},{"role": "human", "content": "你好"},{"role": "assistant", "content": "你好!有什么可以帮你的?"}

SunstoneOwl39的博客 1023

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

部署大模型需要多少GPU显存?一文教你精准计算

这不仅关系到硬件成本,更直接影响服务的并发能力和响应速度。今天,我们就以Llama 70B模型为例,手把手教你计算推理所需的GPU显存。

python1234567_的博客 1180

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

实测:本地跑llama3:70B需要什么配置,普通电脑能跑起来吗?

前段时间发布的开源大语言模型的能力通过测试结果的展示已经达到了一个全新的高度,甚至可以与Claude 3 Sonnet和Gemini 1.5 Pro等一众顶级模型相媲美,甚至在某些方面已经超过了去年发布的两款GPT-4。这一突破使得Llama 3一举成为当前顶流的大语言模型之一。展示一波LLM排名,这么帅还不要钱,就问你想不想要也许从此强大的模型不再只是厂商云端的特权,现在每个人都可以在本地部署Llama 3。无论是8B还是70B的版本,用户都可以选择最适合自己需求的版本进行部署。

程序员鑫港的博客 1849

Llama 2多GPU并行推理:70B大模型部署实战指南

你是否在部署Llama 2 70B模型时遇到过显存不足的问题?单张GPU无法容纳如此庞大的模型参数,多GPU并行推理成为必然选择。本文将详细介绍如何在多GPU环境下部署Llama 2 70B模型,解决模型并行(Model Parallelism)中的关键技术难题,让你轻松驾驭千亿级参数模型的推理任务。 读完本文,你将获得: - 理解Llama 2模型并行的底层原理 - 掌握70B模型多GPU部署...

gitblog_00449的博客 1277

部署大模型需要多少GPU显存?一文教你精准计算!

在大模型推理时,文本是逐个token生成的。为了加速这个过程,我们使用KV Cache机制来缓存中间计算结果。如果没有KV Cache,每生成一个新token,都需要重新计算之前所有token的注意力权重,这会导致大量重复计算,严重影响推理效率。通过本文的计算方法,你可以快速估算任何大模型✅ 模型参数量 × 参数精度✅ KV Cache = 层数 × Hidden维度 × 上下文长度 × 并发数✅ 其他开销约为总和的10%本文计算基于标准KV Cache推理方式实际还有许多显存优化技术。

2401_85375298的博客 915

用 LLaMA-Factory 微调 70B 大模型,单卡显存不够怎么破

本文详解如何利用 LLaMA-Factory 在单卡上微调 70B 大模型。通过 DeepSpeed ZeRO-3 与 CPU Offload 技术,将参数卸载至内存,有效突破显存瓶颈。文章提供实战配置与监控数据,助开发者低成本实现大模型训练。

2600_96323174的博客 361

RTX4090 云 GPU 在 LLaMA-2-70B 推理中的表现

本文探讨了在RTX 4090云GPU上部署LLaMA-2-70B大模型的推理优化技术,涵盖量化、分页注意力、连续批处理等方法,分析性能、成本与能效比,提出适用于中小团队的高效部署方案。

weixin_33628677的博客 1477

运行 70B的LLM,需要多大GPU显存 ?

正如文章标题所言,你是否也曾好奇过:加载使用一个 70B 大小的 LLM,究竟需要多大的 GPU 显存呢?读完这篇文章应该会有答案。为什么是GPU,而不是CPUAI 本质上是大量的矩阵 与向量运算 ,属于计算密集型运算,需要大量的内存空间来保存模型的训练参数。一般通用 CPU 运算单元都是标量,而 GPU 是一个把SIMD(单指令多数据)和SIMT(单指令多线程)运用到极致的协处理器,在体系结构上实现了运算单元的高度并行。简单讲,就是 GPU 比 CPU 更适合用来做计算密集型任务。

m0_59163425的博客 2402

GPU 模型部署实战以 Llama3 70B、Qwen 与 DeepSeek 为例

随着深度学习模型规模不断膨胀,如何高效部署这些大模型成为业界关注的焦点。本文将详细介绍在 GPU 上部署大模型的理论计算、硬件选择、部署策略以及调优过程,结合 Llama3 70B 与 Qwen 模型的实际案例,并介绍 DeepSeek 等工具如何助力分布式部署与性能优化。

hello.reader 2209

【Dify部署Llama 3 70B全攻略】:手把手教你配置千亿参数大模型的最优方案

掌握Dify部署Llama 3 70B模型配置方法,解决大模型本地化部署难题。适用于AI研发、企业级应用等场景,涵盖资源配置、容器化部署与性能优化关键步骤。提供稳定高效运行方案,显著提升推理效率,值得收藏。

LogicGap的博客 760
上一篇: AI大模型学习全攻略:从入门到精通的7个阶段详解,非常详细收藏我这一篇就够
下一篇: 2025大模型人才缺口500万,这三类人最吃香!AI程序员薪资翻倍指南
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值