


大模型学习路线
建议先从主流的Llama开始,然后选用中文的Qwen/Baichuan/ChatGLM,先快速上手体验prompt工程,然后再学习其架构,跑微调脚本
如果要深入学习,建议再按以下步骤,从更基础的GPT和BERT学起,因为底层是相通的,而且实际落地到一个系统中,应该也是大模型结合小模型(大模型在做判别性的任务上,比BERT优势不是特别大)
可以参考如下方案,按需学习。
一、简述
按个人偏好总结了学习目标与路径,后续将陆续整理相应学习资料,并输出学习笔记。
内容将同步更新在我的博客园文章https://www.cnblogs.com/justLittleStar以及Github仓库:DayDreamChaser/LLMLanding: Learning LLM Implementaion and Theory for Practical Landing (github.com)
学习思路: 快速应用Transformer等轮子来微调和使用LLM,同时深入学习NLP预训练模型原理和推理部署(因为偏底层的东西变化不大)
学习目标
- 熟悉主流LLM(Llama, ChatGLM, Qwen)的技术架构和技术细节;有实际应用RAG、PEFT和SFT的项目经验
- 较强的NLP基础,熟悉BERT、GPT、Transformer、T5等预训练语言模型的实现,有对话系统相关研发经验
- 掌握TensorRT-LLM、vLLM等主流推理加速框架,熟悉模型量化、FlashAttention等推理加速技术方案,对分布式训练DeepSpeed框架有实战经验
- 熟悉Pytorch,具备扎实的深度学习和机器学习基础,基本掌握C/C++、Cuda和计算机系统原理
参考项目
参考书籍
Alt text
参考课程
- 面向开发者的LLM入门课程(吴恩达课程-中文版)github.com/datawhalechi
- 普林斯顿-COS 597G (Fall 2022): Understanding Large Language Modelscs.princeton.edu/course
- 斯坦福-CS324 - Large Language Modelsstanford-cs324.github.io
教程
- Huggingface Transformers官方课程 huggingface.co/learn/nl
- Transformers快速入门(快速调包BERT系列)transformers.run/
学习方式
- 力求快速应用 (先调包,再深入学习)
- 在实践中动手学习,力求搞懂每个关键点
- 【原理学习】+【代码实践】 + 【输出总结】
基础知识
- 视频课程
- 吴恩达机器学习入门:coursera.org/learn/mach
- 李沐讲AI:space.bilibili.com/1567
- 台大李宏毅-机器学习: speech.ee.ntu.edu.tw/~h
- 斯坦福NLP cs224n: web.stanford.edu/class/
- 书籍
- 深度学习入门:基于Python的理论与实践, numpy实现MLP、卷积的训练
- 《深度学习进阶:自然语言处理》:numpy实现Transformers、word2vec、RNN的训练
- Dive In Deep Learning(动手学深度学习): d2l.ai/
- 《神经网络与深度学习》:nndl.github.io/
- 《机器学习方法》:李航的NLP相关的机器学习 + 深度学习知识(按需选学)
- 强化学习
- 强化学习教程-蘑菇书EasyRL(李宏毅强化学习+强化学习纲要): datawhalechina.github.io
- 动手学强化学习: github.com/boyu-ai/Hand
- 博客
- 苏剑林科学空间:信息时代下的文章 - Scientific Spaces
学习纲要
应用:
1、Zero Shot / Few Shot 快速开箱即用
- Prompt调优:
- 上下文学习In-Context Learning, ICL
- 思维链 Chain of Thought, COT
- RAG (Retrieval Augmented Generation)
- 基于文档分块、向量索引和LLM生成,如Langchain文档问答
2、领域数据-指令微调LLM
- PEFT (Parameter-Efficient Fine-Tuning):
- LORA (Low-Rank Adaption of LLMs)
- QLORA
- SLORA
- P-Tuning v2
参数高效的微调,适合用于纠正模型输出格式(PEFT上限不高,并向LLM输入的知识有限)
- SFT (Supervised Fintuning):
- 全参数监督微调,使用prompt指令样本全量微调LLM(可以注入新的领域知识)
- 需要控制样本配比(领域数据 + 通用数据)
3、对齐
- 对齐人类偏好 (RLHF):
- RewardModel 奖励模型 (排序标注,判断答案价值)
- RL (PPO, 更新SFT模型)
专注基于强化学习的大语言模型对齐,有前景的方向是SuperhumanAI AutoALign
4、预训练
- 小模型预训练 (GPT2, TinyLlama)不考虑训练参数规模较大的语言模型
5、训练推理优化
- 模型量化
- 推理加速
- 蒸馏
- 推理框架(vLLM、TensorRT-LLM、Llama.cpp)
如果你也想通过学大模型技术去帮助自己升职和加薪,可以扫描下方链接👇👇
二、学习目录
第1章 技术与需求分析
1.1 技术分析
- LLM的发展历程与趋势
- 开源LLM生态
- Llama系列
- Mistral / Mixtral-8X7B-MOE :mistral.ai/news/mixtral
- ChatGLM / Baichuan / Qwen
1.2 市场需求分析
- 需求和就业市场分析
- 预训练、对齐
- 微调、应用
- 推理加速
- 商业落地分析(2C、2B应用场景)
第2章 ChatGPT背景与原理
2.1 ChatGPT的工作原理
- 预训练与提示学习阶段
- 结果评价与奖励建模阶段
- 强化学习阶段
2.2 算法细节
- 标注数据
- 建模思路
第3章 预训练语言模型
3.1 Transformer
- 论文
- 《Attention Is All Your Need》
- 解析:
- 图解Transformer:jalammar.github.io/illu
- 详解Transformer原理:cnblogs.com/justLittleS
- 实战
- Torch代码详解和训练实战:cnblogs.com/justLittleS
3.2 GPT
- GPT论文
- GPT-1:Improving Language Understanding by Generative Pre-Training
- GPT-2: Language Models are Unsupervised Multitask Learners
- GPT-3:Language Models are Few-Shot Learners
- GPT-4:GPT-4 Technical Report(openai.com)
- 解析
- GPT2图解:jalammar.github.io/illu
- GPT2图解(中文):cnblogs.com/zhongzhaoxi
- GPT3分析:How GPT3 Works - Visualizations and Animations
- GPT原理分析:cnblogs.com/justLittleS
- 推理
- GPT2模型源码阅读系列一GPT2LMHeadModel
- 60行代码实现GPT推理(PicoGPT):cnblogs.com/justLittleS
- 动手用C++实现GPT:ToDo, 参考:CPP实现Transformer
- 训练
- 训练GPT2语言模型:基于Transformers库-Colab预训练GPT2
- Transformers库GPT实现分析:ToDo
- MiniGPT项目详解-实现双数加法:blog.youkuaiyun.com/wxc971231
- NanoGPT项目详解
- 代码分析:zhuanlan.zhihu.com/p/60
- 训练实战:莎士比亚数据训练, ToDo
- GPT2微调-文本摘要实战
- 数据预处理模块
- GPT-2模型模块
- 模型训练和推理模块
3.3 BERT
- 原理
- 实战
- BERT结构和预训练代码实现:ToDo
- BERT预训练实战:动手学深度学习-BERT预训练 Colab
- 基于HuggingFace的BERT预训练:
- BERT微调:
- 文本分类
- BERT-CRF NER
- BERT+指针网络(UIE)信息抽取
- 文本摘要/问答
- 相似性检索: SimCSE-BERT
- 衍生系列
- RoBERTa / ALBERT / DistillBERT
3.4 T5系列
- T5-Pegasus对话摘要微调
- PromptClue关键词抽取微调
3.5 UniLM
- UniLM模型介绍
- 基于夸夸闲聊数据的UniLM模型实战
第4章 提示学习与大型语言模型
4.1 提示学习PromptLearning
- 提示学习介绍
- 提示模板设计
- 答案空间映射设计
4.2 上下文学习 ContextLearning
- 上下文学习介绍
- 预训练阶段提升上下文
- 推理阶段优化上下文
4.3 指令数据构建
- 手动和自动构建指令
- 开源指令数据集
- 基于提示的文本情感分析实战: github.com/liucongg/Cha
第5章 开源大型语言模型
5.1 Mistral
- Mistral 7B Tutorial: datacamp.com/tutorial/m
- Mistral-8X7B-MOE的模型结构
- Mistral -8X7B-MOE源码解析
- Mistral-7B微调
5.2 Llama
- Llama1
- Llama1源码深入解析: zhuanlan.zhihu.com/p/64
- Llama2
- Llama2的优化
- Llama2源码解析
- llama 2详解: zhuanlan.zhihu.com/p/64
- Llama2-6B微调
5.3 ChatGLM
- ChatGLM简介
- ChatGLM-6B微调
- ChatGLM2微调保姆级教程: zhuanlan.zhihu.com/p/64
第6章 LLM微调
6.1 全量指令微调SFT
6.2 高效微调PEFT
LORA系列
- LoRA(Low Rank Adapter)
- ChatGLM-6B: zhuanlan.zhihu.com/p/62
- ChatGLM2微调保姆级教程: zhuanlan.zhihu.com/p/64
- ChatGLM3-6B微调
- QLoRA
- 用bitsandbytes、4比特量化和QLoRA打造亲民的LLM:cnblogs.com/huggingface
- AdaLoRa
- SLoRA
其他
- P-Tuning V2介绍
- P-Tuning v2微调实战
实战
- HuggingFace PEFT库详解
- Deepspeed-Chat SFT 实践
第7章 大型语言模型预训练
7.1 预训练模型中的分词器
- BPE详解
- WordPiece详解
- Unigram详解
- SentencePiece详解
- MinBPE实战和分析:github.com/karpathy/min
7.2 分布式训练
- 分布式训练概述
- 分布式训练并行策略
- 分布式训练的集群架构
- 分布式深度学习框架
- Megatron-LM详解
- DeepSpeed详解
- 实践
- 基于DeepSpeed的GLM预训练实战
- 基于DeepSpeed的LLaMA 分布式训练实践
7.3 MOE混合专家模型
- 基础概念
- Mixstral-8X7B-MOE-介绍
- 相关论文
第8章 LLM应用
8.1 推理规划
- 思维链提示(Chain-of-Thought Prompting)
- 论文
- 实战
- 由少至多提示(Least-to-Most Prompting)
8.2 综合应用框架
- LangChain框架核心模块
- 9个范例带你入门langchain: zhuanlan.zhihu.com/p/65
- 知识库问答实践
8.3 智能代理AI Agent
- 智能代理介绍
- LLM Powered Autonomous Agents: lilianweng.github.io/po
- 智能代理的应用实例
第9章 LLM加速
9.1 注意力优化
- FlashAttention系列
- PagedAttention
- 深入理解 BigBird 的块稀疏注意力: cnblogs.com/huggingfacehf.co/blog/big-bird
9.2 CPU推理加速
- Llama.c应用与代码详解
- Llama.cpp应用与代码详解
- ChatGLM.cpp应用与代码详解
9.3 推理优化框架
- vLLM推理框架实践
- TensorRT-LLM应用与代码详解
9.4 训练加速
第10章 强化学习
10.1 强化学习概述
10.2 强化学习环境
10.3 强化学习算法
- Q-learning算法
- DQN算法
- Policy Gradient算法
- Actor-Critic算法
第11章 PPO算法与RLHF理论实战
11.1 近端策略优化算法PPO
- PPO:Proximal Policy Optimization Algorithms 论文
- PPO介绍
- 广义优势估计
- PPO算法原理剖析
- PPO算法对比与评价
- 使用PPO算法进行RLHF的N步实现细节: cnblogs.com/huggingface
- PPO实战
- 基于PPO的正向情感倾向性 github.com/liucongg/Cha
11.2 基于人类反馈的强化学习RLHF
- InstructGPT模型分析
- InstructGPT:Training language models to follow instructions with human feedback
- 论文RLHF:Augmenting Reinforcement Learning with Human Feedback
- RLHF的流程
- RLHF内部剖析
- 详解大模型RLHF过程(配代码解读) zhuanlan.zhihu.com/p/62
- RLHF价值分析
- RLHF问题分析
- 数据收集与模型训练
- RLHF内部剖析
- RLHF实践
- 数据预处理模块
- 模型训练\生成\评估
- zhuanlan.zhihu.com/p/63
- MOSS-RLHF 实践
- 奖励模型训练
- PPO 微调
第12章 类ChatGPT实战
12.1 任务设计
12.2 数据准备
- 基于文档生成问题任务的类 github.com/liucongg/Cha
- SFT阶段
- RM阶段
- RL阶段
第13章 语言模型训练数据
13.1 数据来源
- 通用数据
- 专业数据
13.2 数据处理
- 低质过滤
- 冗余去除
- 隐私消除
13.3 数据影响分析
- 数据规模影响
- 数据质量影响
- 数据多样性影响
13.4 开源数据集合
- Pile
- ROOTS
- RefinedWeb
- SlimPajama
第14章 大语言模型评估
14.1 模型评估概述
14.2 大语言模型评估体系
- 知识与能力
- 伦理与安全
- 垂直领域评估
14.3 大语言模型评估方法
- 评估指标
- 评估方法
14.4 大语言模型评估实践
- 基础模型评估
- SFT/RL 模型评估
第15章 多模态大模型
- 多模态大模型调研
- 实战
第16章 大模型原生应用
16.1 落地调研
- 应用分析
- 提供大模型基础服务:ChatGPT、Gemini、文心一言和GLM4等,主要面向ToC/ToB提供chat能力(内容创作、代码开发等),通过会员收费或按Token计费
- ToB提供成套解决方案
- 集成现有接口二次开发,应用开发
- 开源模型增量预训练、全量微调、高效微调,行业内落地
模型最终还需落地解决实际问题,创造价值:优化现有问题、满足、甚至创造用户需求。
总的来说,就是规模化、自动化人的工作,替代人工,批量化、大规模生成或提供服务。
16.2 应用分析
一些思考
在企业里面做7B、13B量级的微调,主要就是在搞数据、样本,技术壁垒不高。预训练壁垒高,因为需要烧钱堆经验。
在这个日新月异的时代,如何紧跟行业主流发展,并具备不可替代性是个难题:
- 稀缺(不可替代性)
- 稳定(业务和表层技术天天变,但底层的理论变化不大)
- 需求持续(最好是类似衣食住行的刚需,否则技术 过时/热度褪去/不达预期,泡沫崩溃)
- 不能越老越吃香(放到绝大多数行业都适用:不能经验积累,持续长期创造价值)
- 壁垒(技术、业务、资本上有垄断)
尽量往底层和工程化上靠,学习相对不变的技术(理论上变化很难),迁移到稳定或有前景的行业,不断提升自己的学习效率:
- 计算机系统知识(训练、推理、开发,模型推理部署工程化)
- 数学(深入学习并实践)
最后
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。
我整理出这套 AI 大模型突围资料包:
- ✅AI大模型学习路线图
- ✅Agent行业报告
- ✅100集大模型视频教程
- ✅大模型书籍PDF
- ✅DeepSeek教程
- ✅AI产品经理入门资料
如果你也想通过学大模型技术去帮助自己升职和加薪,可以扫描下方链接👇👇
为什么说现在普通人就业/升职加薪的首选是AI大模型?
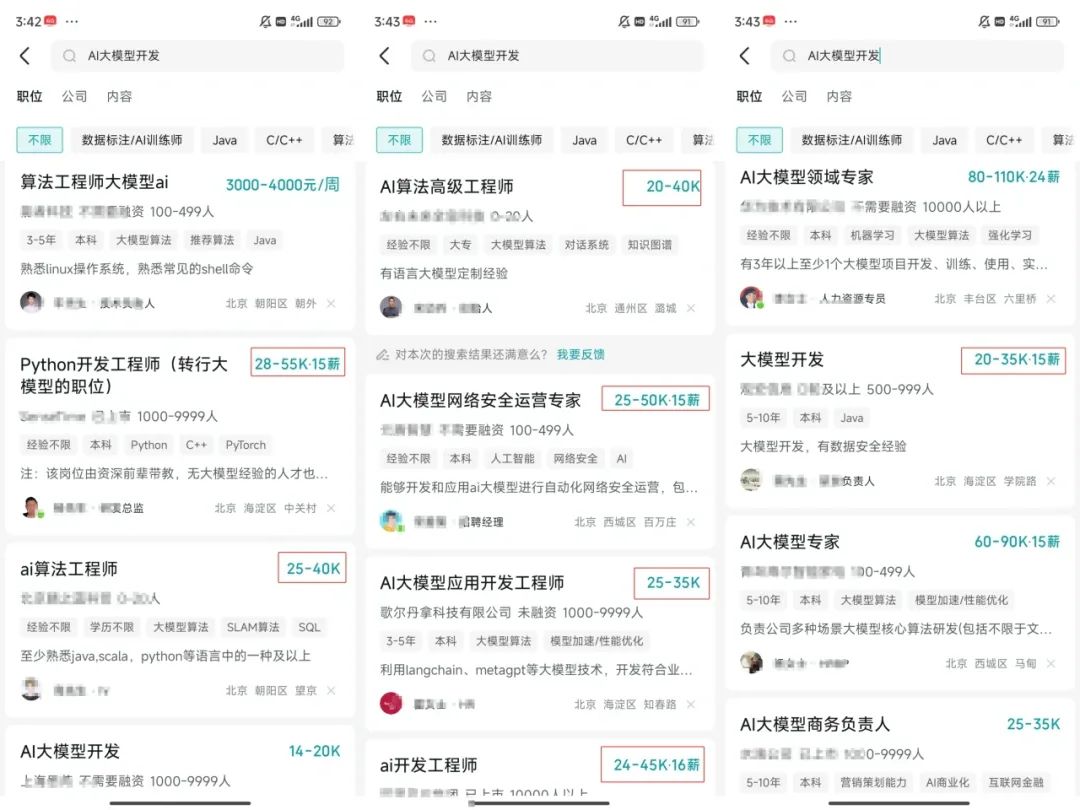
人工智能技术的爆发式增长,正以不可逆转之势重塑就业市场版图。从DeepSeek等国产大模型引发的科技圈热议,到全国两会关于AI产业发展的政策聚焦,再到招聘会上排起的长队,AI的热度已从技术领域渗透到就业市场的每一个角落。
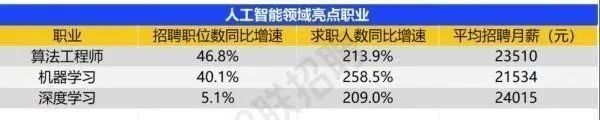
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
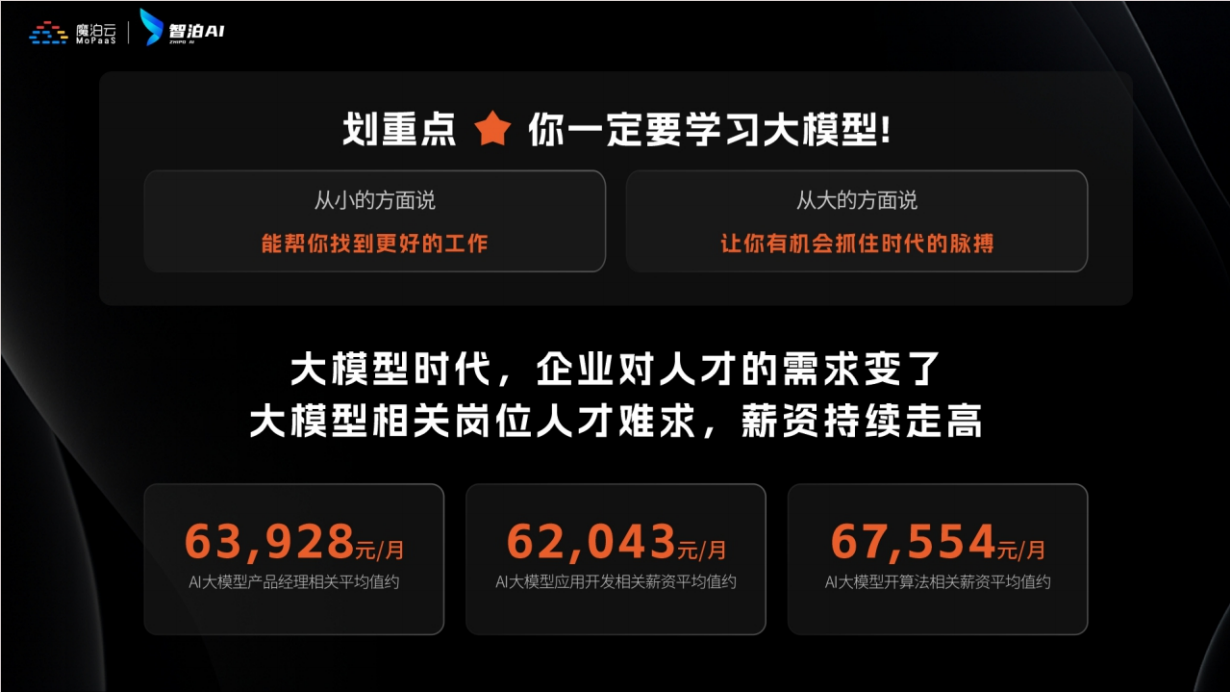
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
资料包有什么?
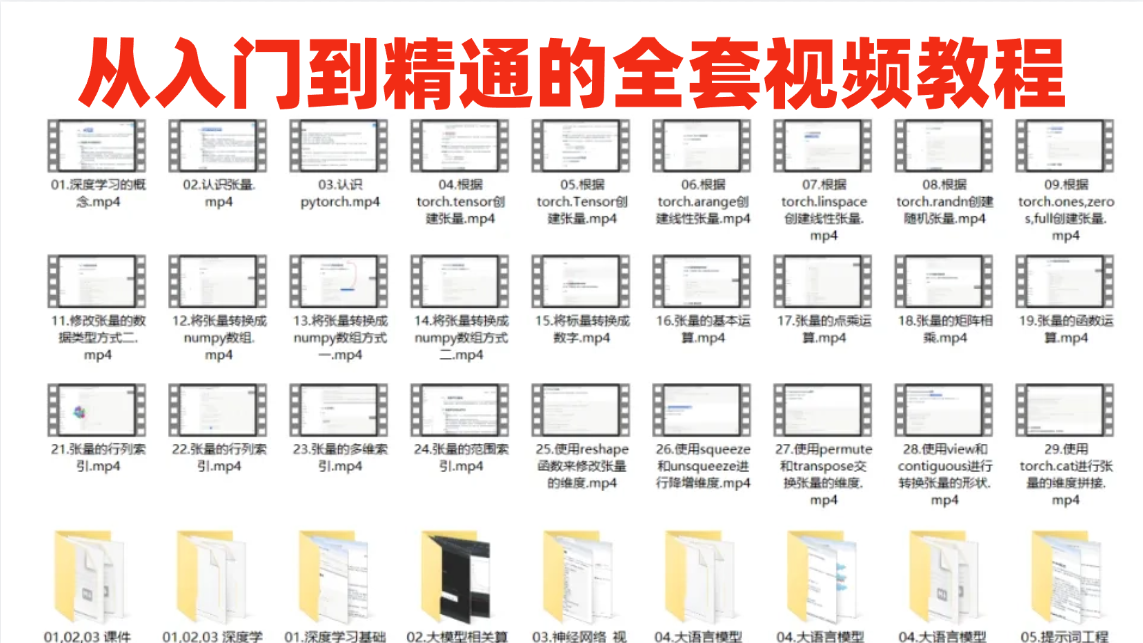
①从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
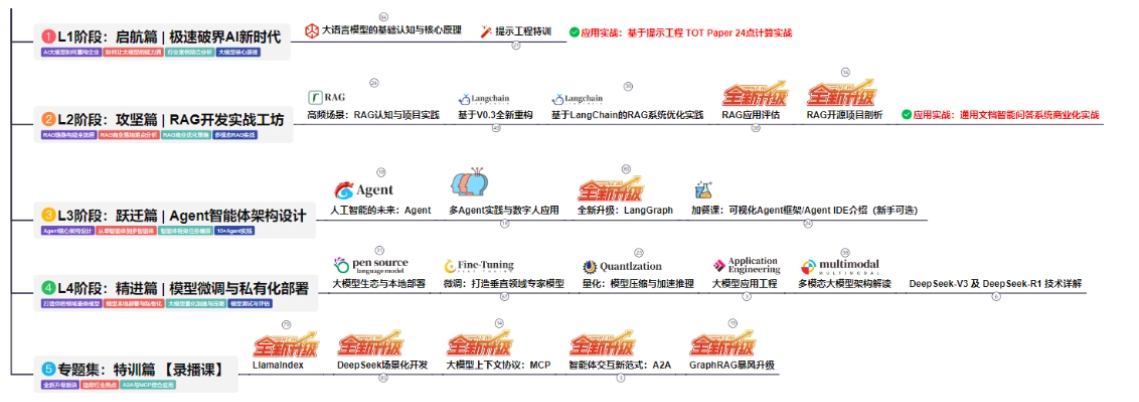
② AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
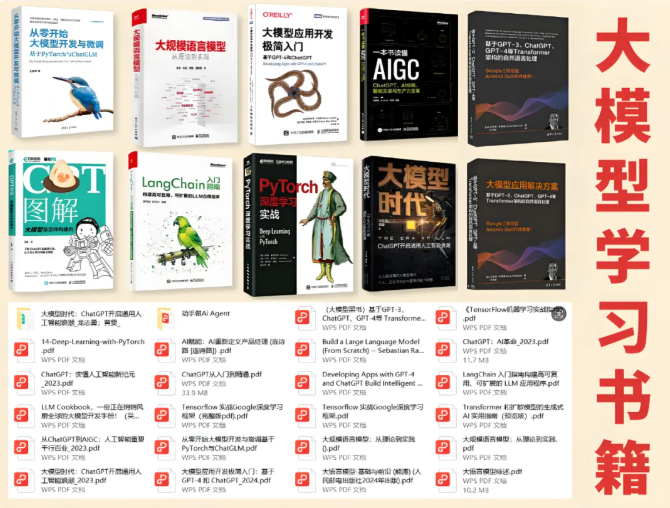
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
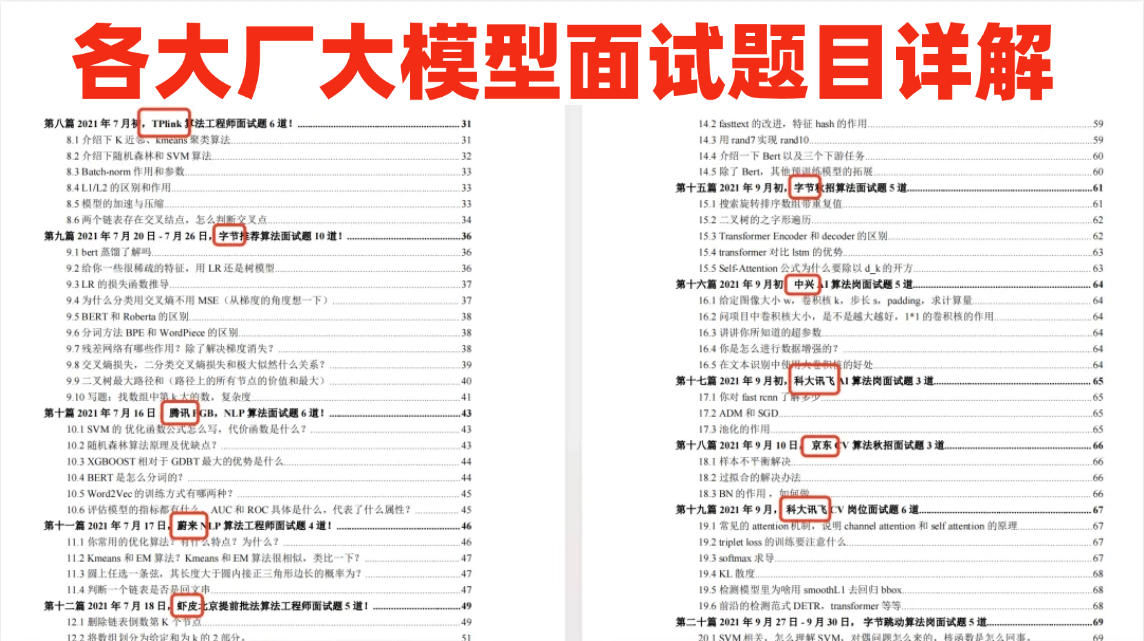
④各大厂大模型面试题目详解
⑤ 这些资料真的有用吗?
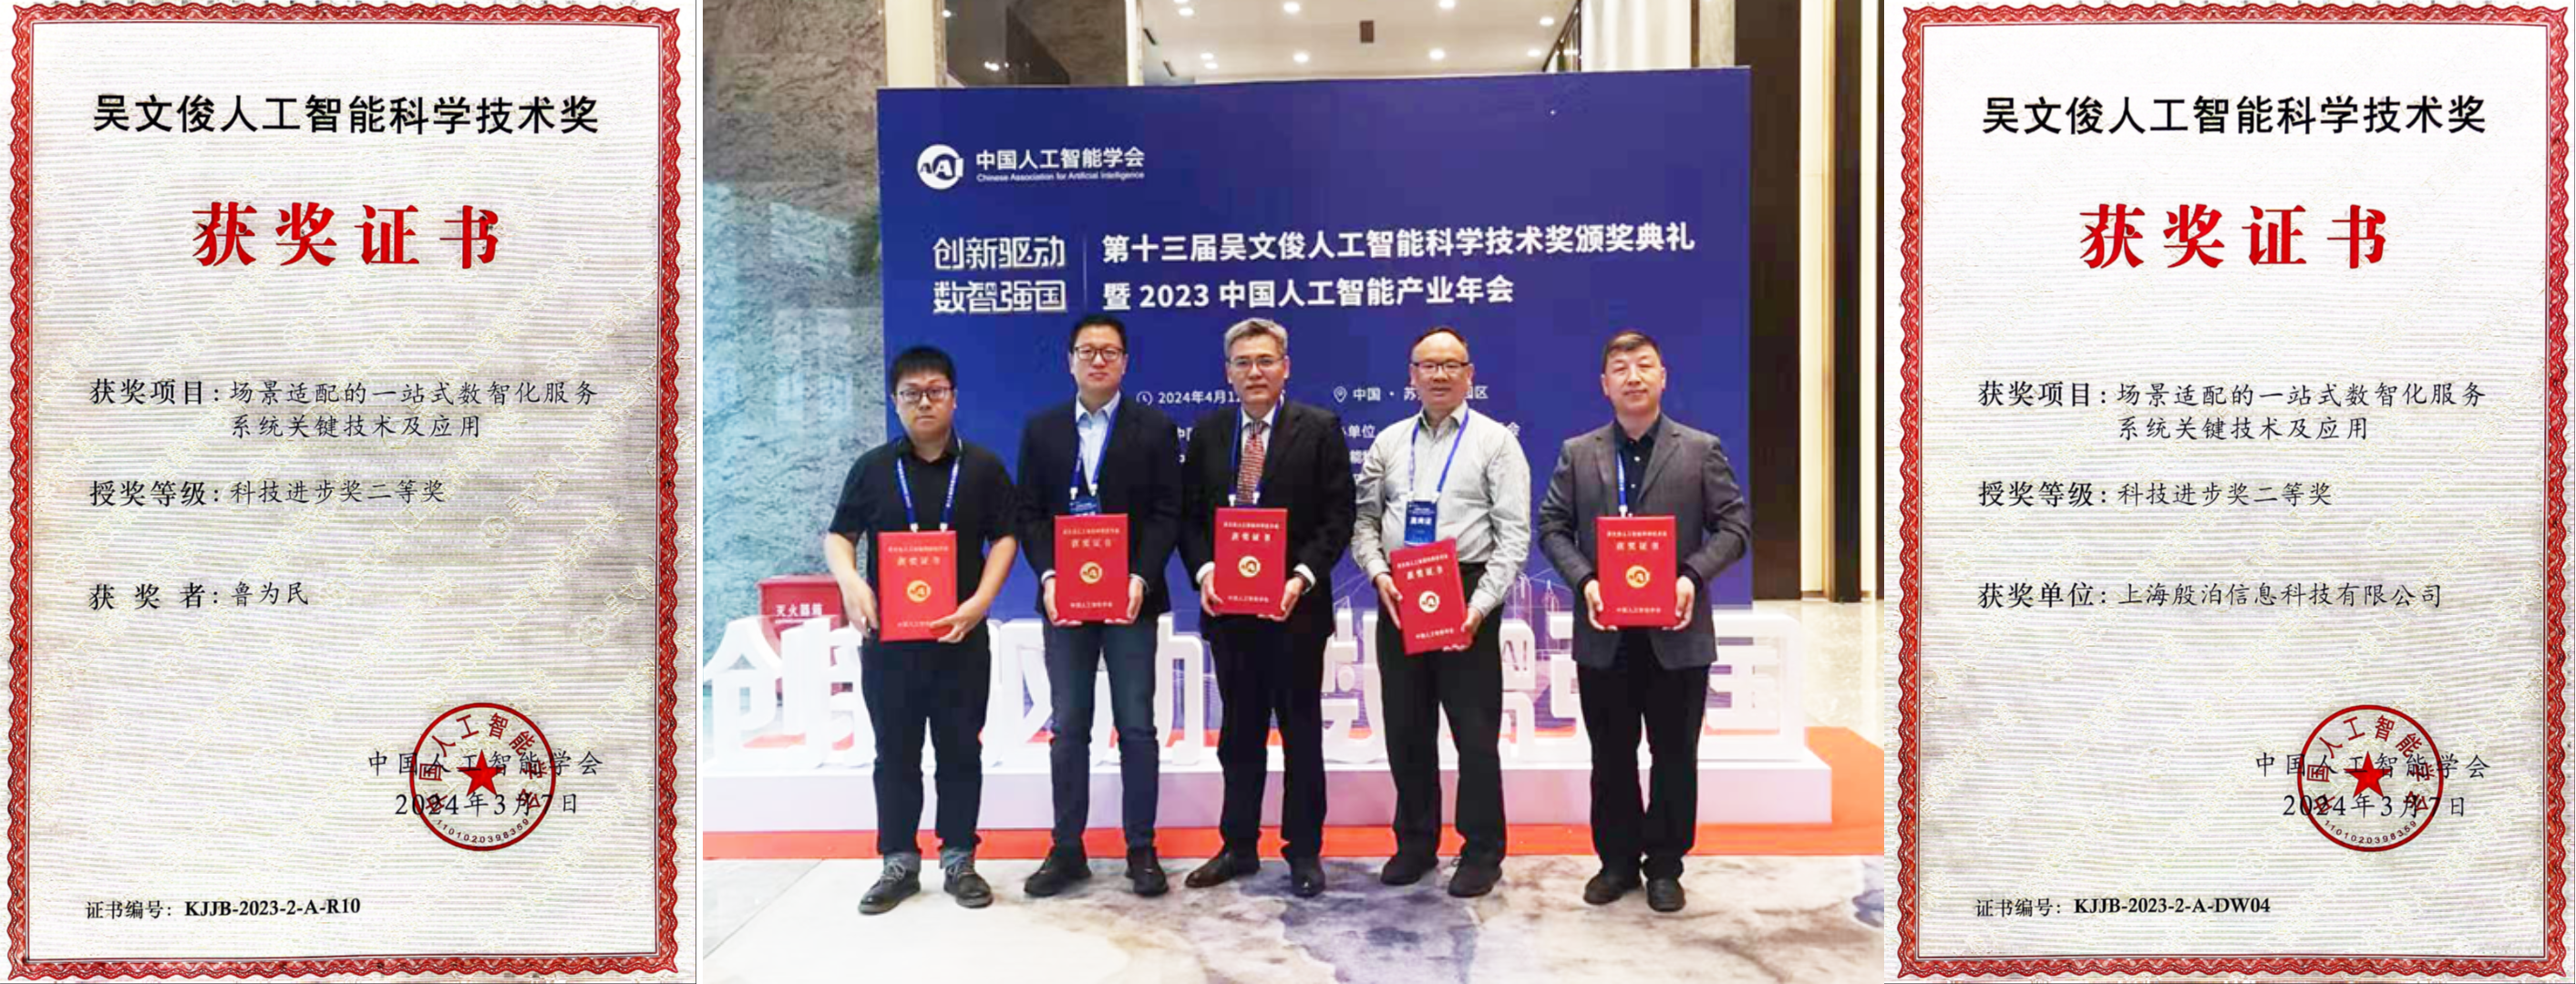
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频教程由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
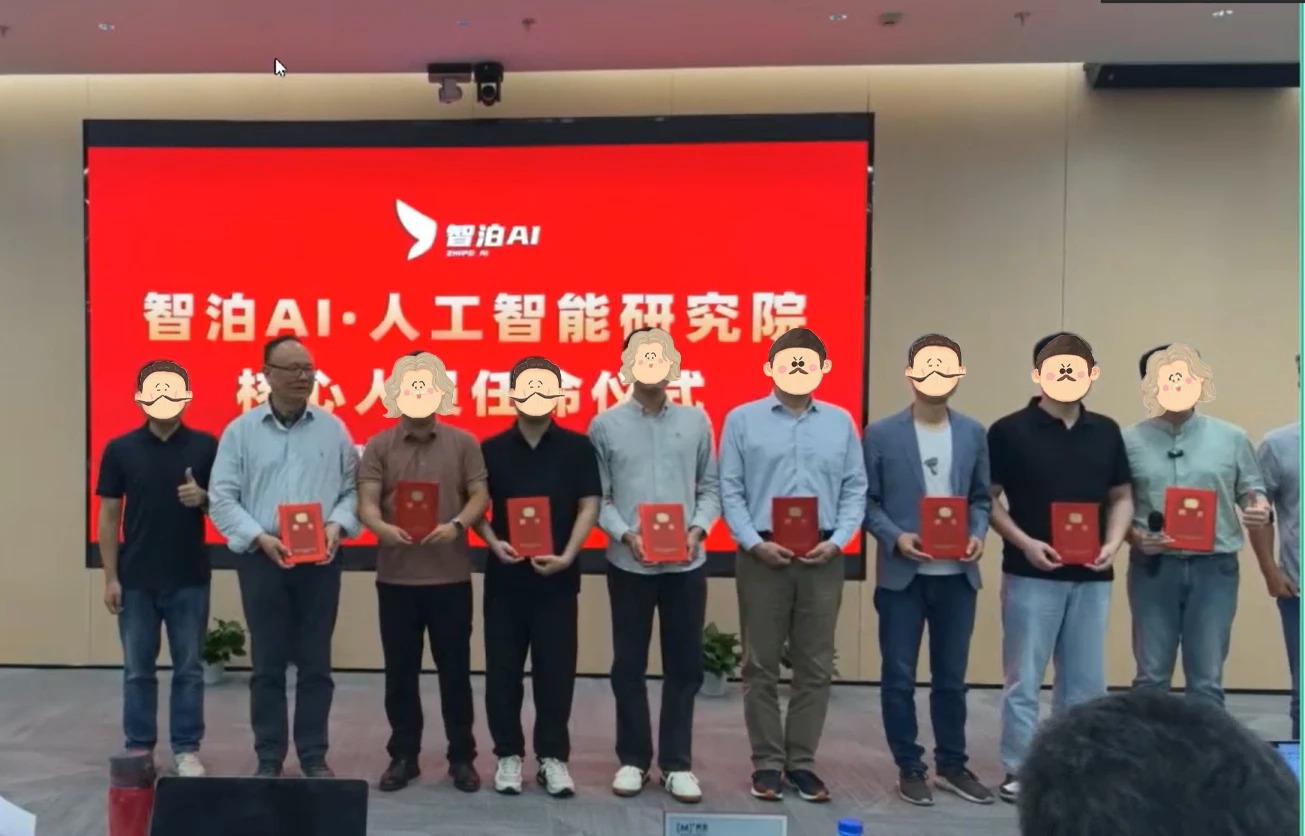
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
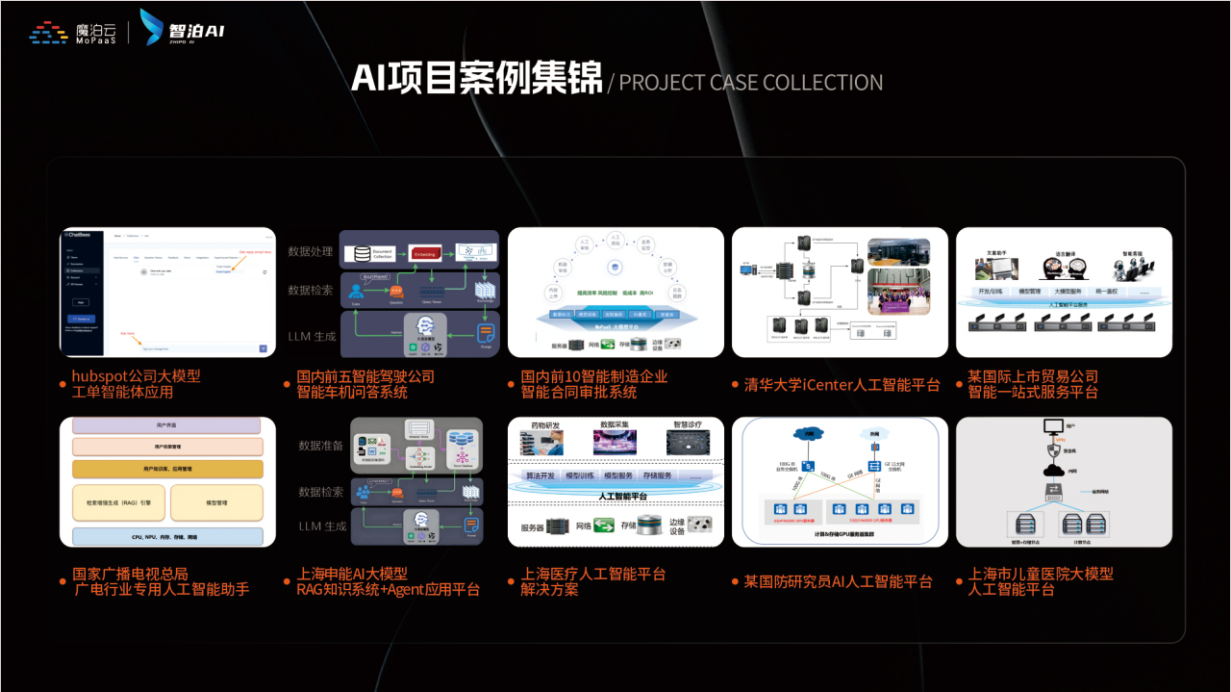
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓**
 322


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


