


简介
文章介绍了大模型微调过程中可能出现的"原始能力退化"现象,即模型在特定任务能力提升的同时,原有通用能力反而下降。文章分析了四种退化原因:灾难性遗忘、数据分布不平衡、任务冲突和过度微调。针对这些问题,文章提出了两种解决方案:参数高效微调(PEFT)如LoRA技术,只调整部分参数保留原始能力;多任务学习混合训练数据。这些方法可以帮助模型在获得新专业技能的同时,尽量保持原有的通用能力。
微调,英文名叫做 Fine-tuning。
你可能听周围搞过微调的朋友说到过一个现象——微调后模型的能力可能会退化,这种情况听起来很奇怪:我明明是为了让模型变得更好,为什么模型的能力退化了呢?
这其实也算是微调的一个弊端吧,所以,在学习微调技术之前,你要对微调有技术有个感性的认识——
微调并非是万能的,有些时候,它会使模型的原始能力退化。
什么是模型的原始能力?
微调是指在一个已经训练好的大模型基础上,用特定领域的数据再重新进行训练,让它更适应某个具体任务。
所以说,微调本质上也是一种“训练”的过程。
比如,你拿一个已经预训练好的语言模型,喂给它一堆法律文档,想让它变成“法律专家”;或者喂给他一些医疗数据,让它学会回答医学问题。
这个过程其实就是在教一个“通用的语言模型”重点强化某一技能。
模型的原始能力呢,其实就是大模型在微调之前具备的通用的知识和技能。
比如,它可能会写诗、翻译、回答历史问题,还能聊点天文地理,这些能力是大模型在海量数据上预训练(Pre-training)时学到的,覆盖面很广。
但问题来了:微调后,模型在特定任务上的技能变强了,却可能在其他任务上变弱了,甚至严重一点,可能会忘了它原来已经学会的东西。
这就是所谓的“原始能力退化”。
为什么会退化?
要搞懂退化原因,我们得从模型的学习过程讲起。
可以这么想象一下:大模型其实就是一个记忆有限的学生,虽然它的参数量很多(“脑容量”很大),但也不是无限大。
微调其实是给这个学生开了补习班,逼着它学习一些新东西,结果呢?新东西学会了,旧知识可能就挤掉了。
这里简单提几个具体的原因,仅做了解即可:
1. 灾难性遗忘(Catastrophic Forgetting)
模型的“记忆”是靠参数(也就是模型的权重)存储的。
微调时,我们用新数据调整这些参数,让模型适应新的任务。
但这些参数本来是用来支持原始能力的,改动太多,原来的知识就被覆盖了。
你原来会背唐诗三百首,后来天天背英语单词,时间一长,唐诗可能就忘得差不多了。
这种现象被称为“灾难性遗忘”。
这种情况在微调的过程中会经常出现,在后面我们介绍“全参数微调”的时候,还会再一次提到这个问题。
说白了,模型的参数被篡改了,导致了能力退化。
2. 数据分布不平衡
大模型预训练时用的是海量、多样化的数据,可以覆盖各种场景,而微调时,通常只用一个很窄很专业领域的数据集(比如只有法律文本)。
这就会导致模型过度适应新数据,忘了如何处理其他类型的数据。
比如,当你把一个模型微调成了“法律专家”后,如果你再让它写诗,它可能就只会蹦出“根据《民法典》第XX条”之类的东西,也就诗意全无了。
3. 任务冲突
有时候,新任务和原始任务的目标不一样,甚至互相冲突。
比如,预训练时模型学的是“尽量生成多样化的回答”,而微调时你要求它“严格按照格式输出”。
这种目标切换会让模型“迷失方向”,丢掉原来的灵活性。
4. 过度微调(Overfitting)
微调如果做得太狠(比如训练轮次太多,或者学习率太高),模型会“死记硬背”训练数据,更极端的时候可能连训练数据中的“噪声”都背下来。
这种情况下,它在新任务上可能表现得很好,但在其他场景下完全不行,因为它失去了泛化能力。
有点类似于模型训练中的“过拟合”现象。
模型原始能力的退化有哪些表现呢?
这个其实很好理解,不再赘述,举几个模型原始能力退化的例子——
-
语言能力变差
:一个通用的语言模型微调后,可能忘了怎么生成流畅的对话,只会机械地回答特定问题。
-
知识丢失
:微调前它能告诉你很多通用知识,比如“太阳系有八大行星”。微调后如果你再问它同样的问题,模型可能一脸懵,回答的“驴唇不对马嘴”。
-
创造力下降
:微调前模型原本可以写故事、编段子,微调后可能只会输出干巴巴的句子。
也就是说,微调后模型变得“专精”了,但“全面”没了,这就是一种“原始能力退化”的表现。
怎么避免模型原始能力的退化?
虽然微调模型会出现能力退化的情况,但是你也不用太过于担心,退化不是不可避免的。
微调是个技术活,只要用对方法,就能让模型既学会新技能,又尽量保住它原有的能力。
下面是一些常见的技术,可以避免模型原始能力的退化:
- 少调一点(控制微调范围)
微调时,不要把模型的所有参数(比如 7B 的模型中有 70亿的参数)都进行调整,可以只调整其中一部分(比如只调整注意力模块中的参数,或者在 transformer 架构中加个小的适配器模块等等,这就需要你对 transformer 架构有一定的的了解了)。
这样,模型的原始能力受影响就小得多。
这种只调整部分参数的方法叫“参数高效微调”(Parameter-Efficient Fine-Tuning, PEFT),比如 LoRA 和 Adapter。
PEFT 是目前非常流行的微调方法,效果好、算力需求低,也是本专栏会重点介绍的内容。
- 混着学(多任务学习)
在微调时,不要给模型只投喂新数据,可以把原始数据和新数据混在一起进行训练。
这样模型既能学新东西,也不至于忘了原有的知识。比如,让模型一边学法律的新知识,一边复习一些诗歌和历史。
不过这种方式很少会使用,毕竟我们的目的就是让他更加专业。如果让他在学法律的过程中,还要复习诗歌和历史,那我们需要准备的数据集就会多很多——
徒增不少额外的工作量,不值得。
模型在微调时的原始能力退化,本质上是模型学习新东西时“顾此失彼”的结果,但通过合理的微调方法,我们可以在提升专业能力的同时,尽量保住模型的“全能”属性,这也可以认为是 PEFT 提出的一个背景(原因)吧。
AI大模型从0到精通全套学习大礼包
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
只要你是真心想学AI大模型,我这份资料就可以无偿共享给你学习。大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!
如果你也想通过学大模型技术去帮助就业和转行,可以扫描下方链接👇👇
大模型重磅福利:入门进阶全套104G学习资源包免费分享!
01.从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
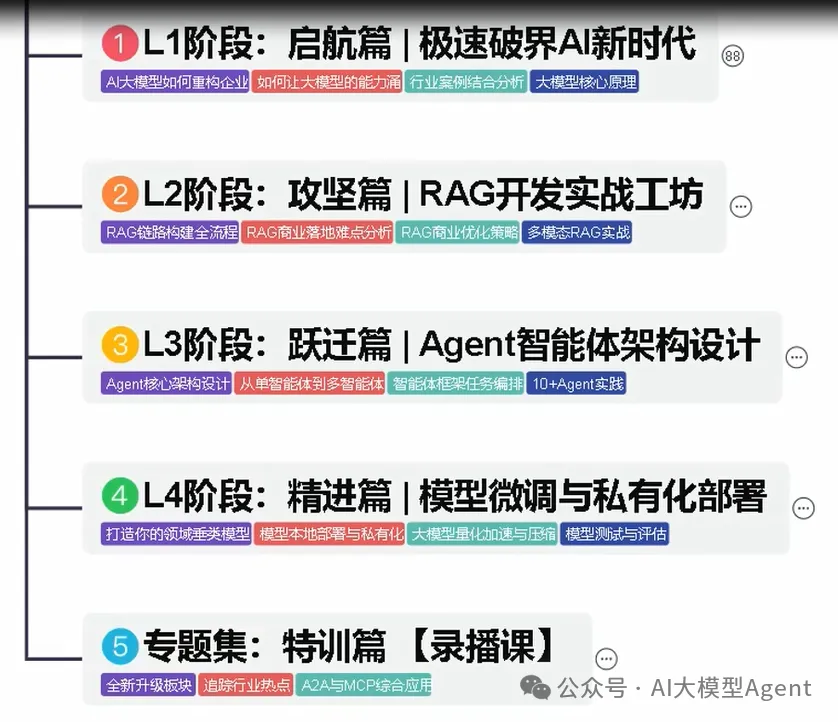
02.AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
03.学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
04.大模型面试题目详解
05.这些资料真的有用吗?
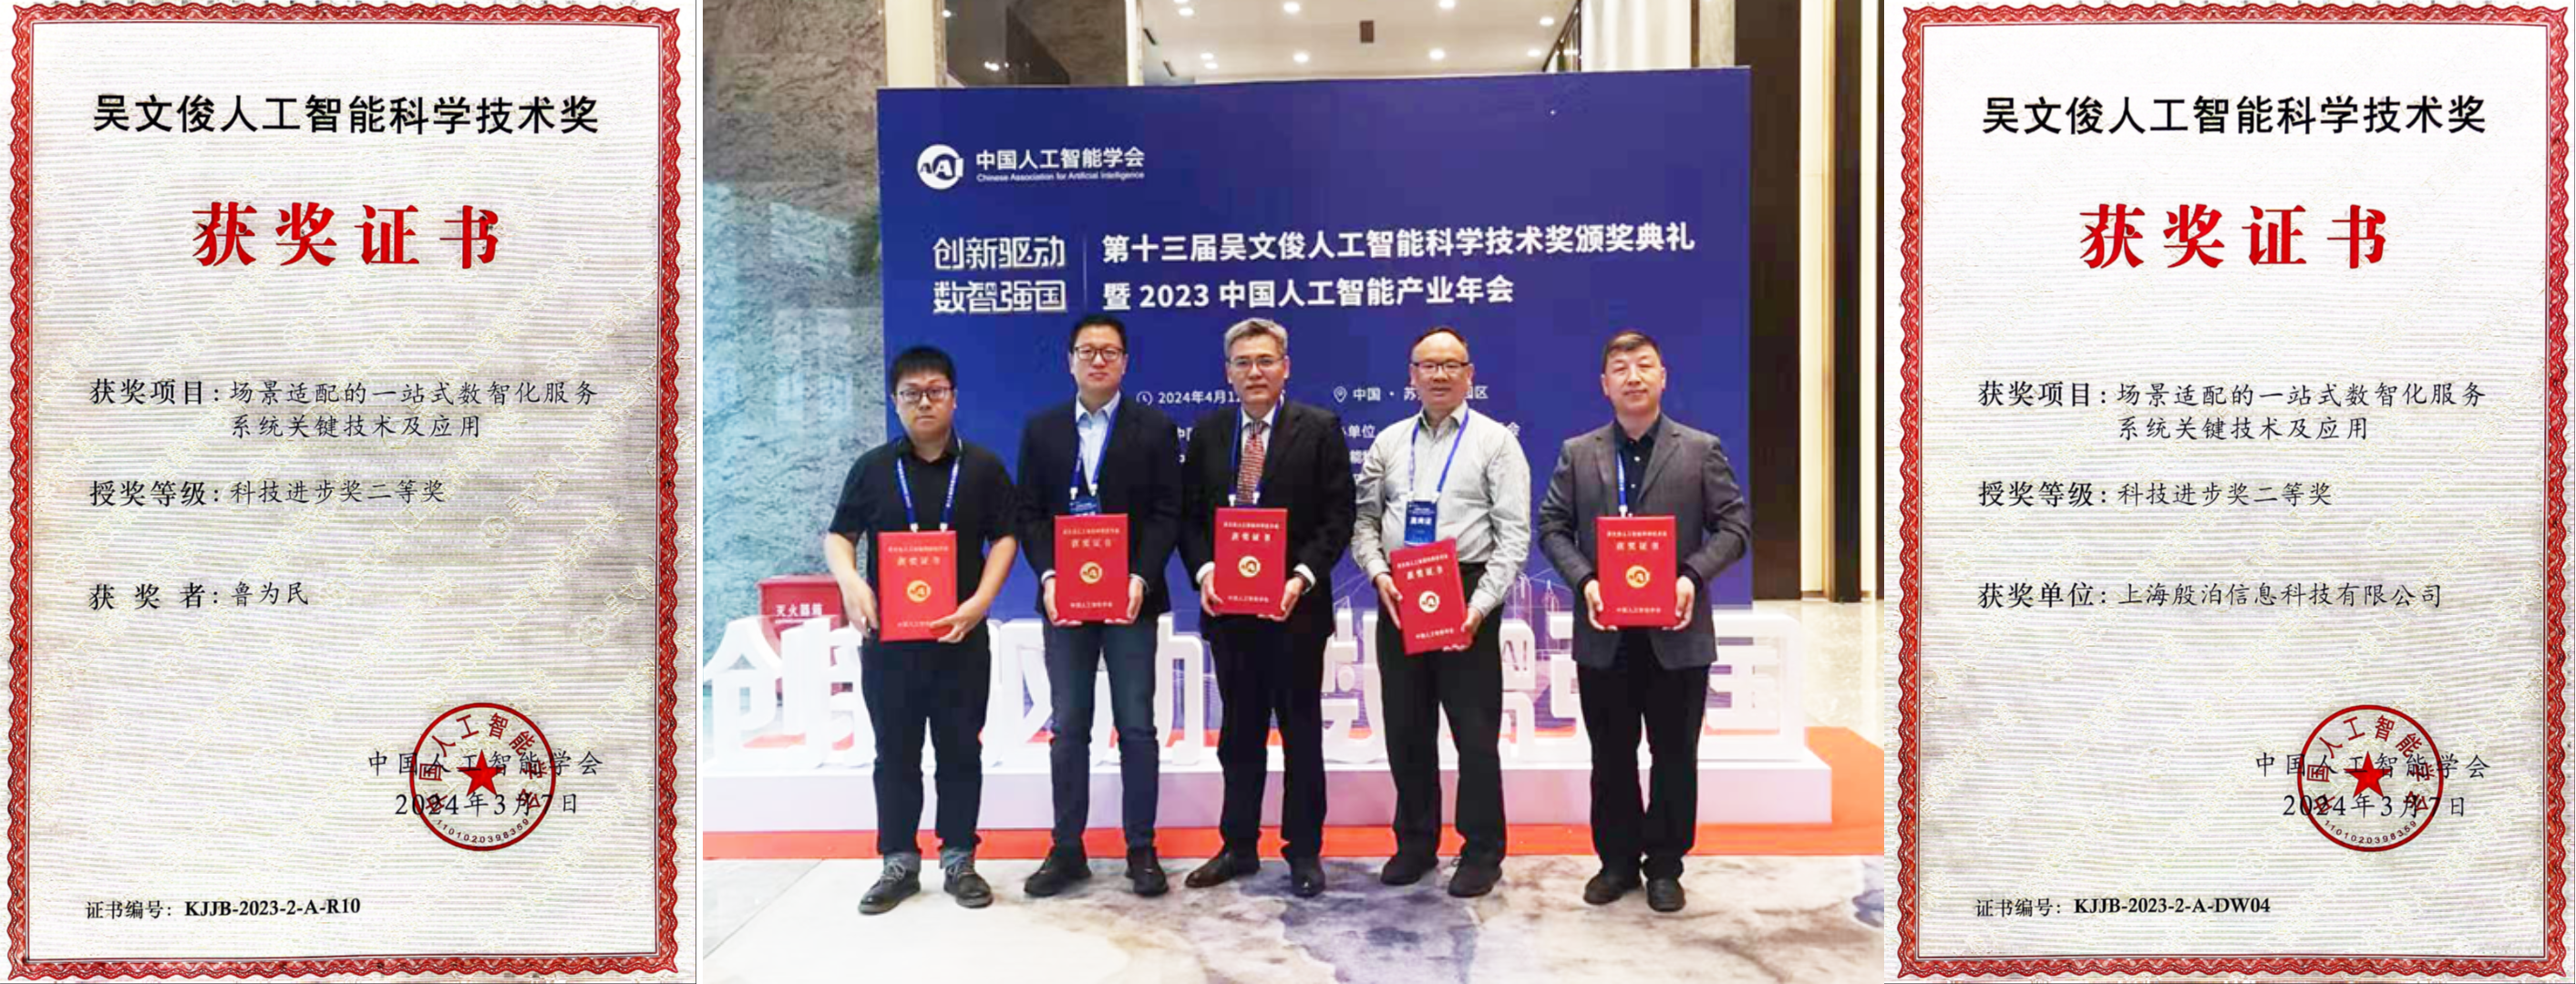
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
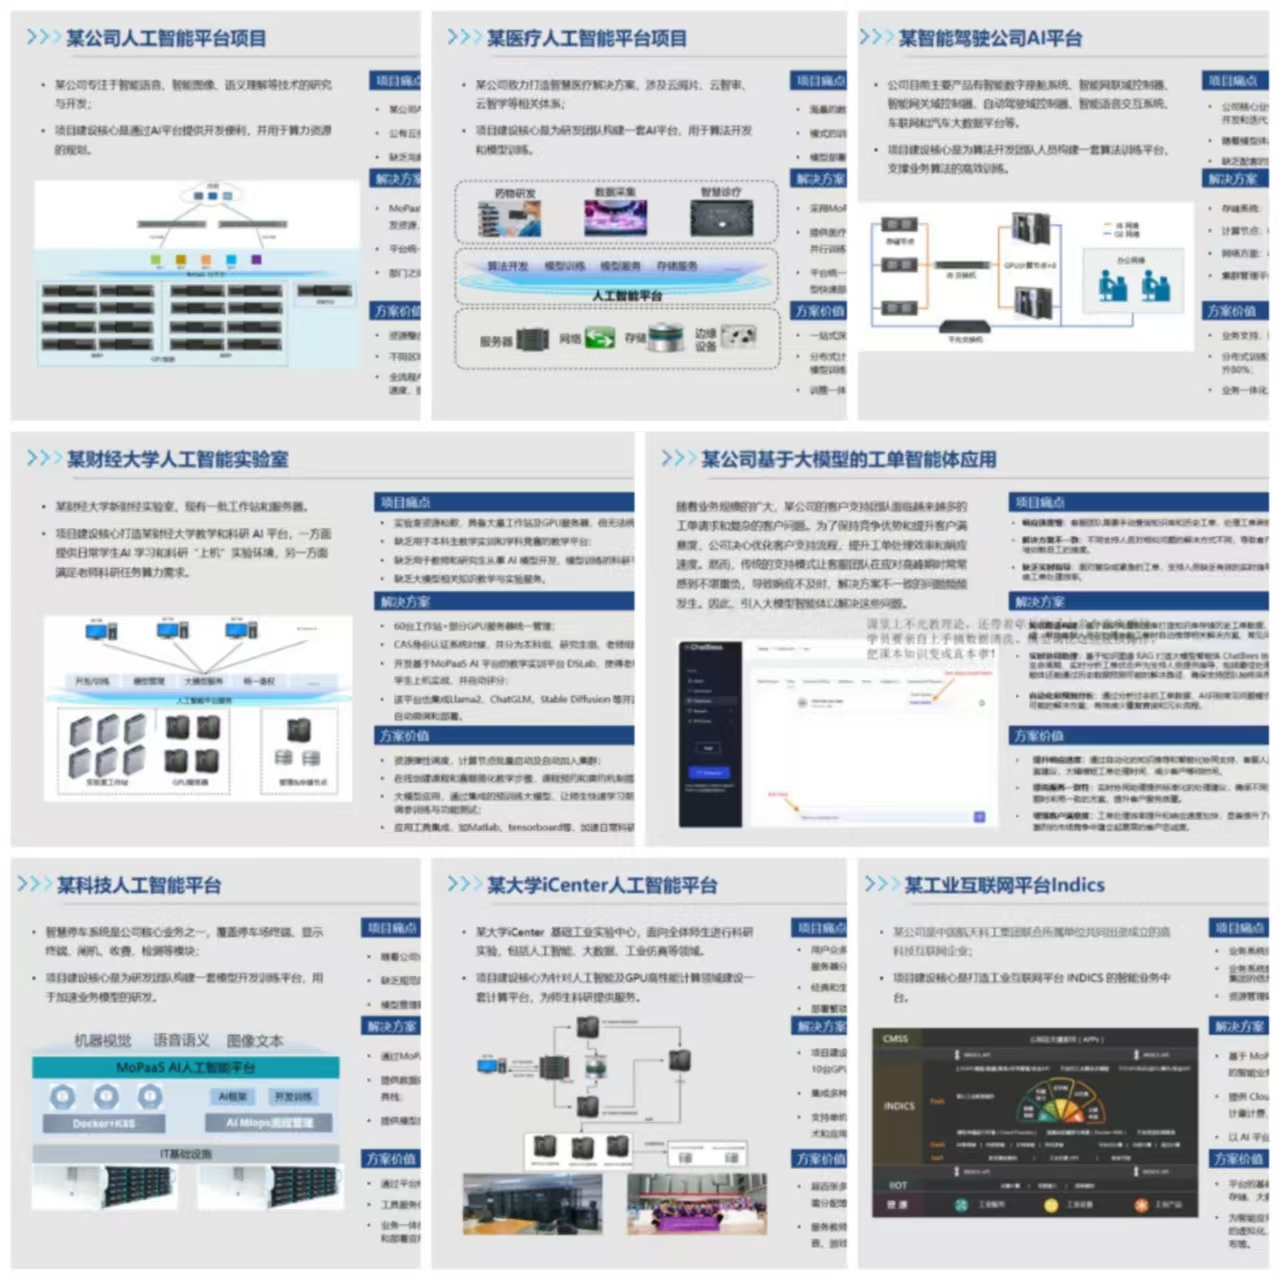
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
 588


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


