


AI Agent的元年,大模型走进企业的第一步,就是要大模型的领域适配。如何微调大模型,是企业接入大模型的重要话题。
阅读本文收益:
-
企业微调大模型的主要步骤有哪些?
-
一个医疗领域的大模型微调实战案例。
-
文末给出了高价值的企业微调实战学习资料
什么是大模型微调?
微调的本质是利用了迁移学习技术,即从预训练模型开始,通过特定数据集进一步训练以提高特定领域的性能。
主要方法包括:
-
全微调(Full- Fine-tuning):重新训练整个模型,更新所有参数权重,效果显著但资源密集。
-
参数高效微调(PEFT):仅更新少量参数(如 ),减少计算需求,适合资源有限的企业。常见技术有:LoRA(Low-Rank Adaptation)、QLoRA、P-tuning(前缀调优)、Adapter等。
-
蒸馏:训练较小模型模仿较大模型的行为,降低数据需求。
-
指令微调(Instruction Tuning)与RLHF(人类反馈强化学习)
本文重点讨论性价比超高的高参微调,助力中小企业在垂直领域中落地大模型。
为什么需要大模型微调?
常见的通用大模型(o1、Claude Sonnet3.7、DeepSeek),本质上都是在基于公开、通用的数据集上训练未来的知识,而对于中小企业,业务大都是面向特定领域、特定行业。那些通用大模型往往给不出有价值的反馈,甚至会有更多幻觉出现。
而从0到1再去训练一个大模型的电力、算力、数据集等,远远超出中小企业能够负担的范畴,因此,基于已有已经训练好的预训练模型,结合领域数据集,通过使用特定技术手段,训练出一个专有大模型,成了企业接入大模型能力的最佳实践。
总结来讲,企业微调主要有几大优点:
-
提升模型推理 表现(大模型视角):原始大模型通常是在大规模通用数据上训练的,可能对一些专业任务理解不够深入。微调能够在企业特定数据上进一步训练,从而改善模型在特定任务上的表现,减少误判和错误回答。
-
满足特定领域需求(企业视角):企业通常拥有自己独特的业务场景和专业术语。通过微调大模型,可以使模型更好地理解和处理行业内特定的信息,从而提高准确率和响应的相关性。
-
数据隐私与安全(数据安全视角):企业内部数据往往包含敏感信息,直接使用公共模型可能会引发隐私或安全问题。通过在企业内部环境中进行微调,可以确保数据安全,避免将敏感信息泄露给外部模型服务提供商。
-
满足合规要求(监管视角):许多行业都有严格的合规和监管要求,尤其是金融、医疗和法律等领域。微调模型可以使其输出符合企业自身和行业的合规标准,降低法律风险。
-
提升用户体验与效率(用户视角):经过微调的模型能够更好地适应企业内部系统和用户需求,提供更为精准和及时的响应。这不仅能提高内部工作效率,也能为客户提供更好的服务体验。
大模型微调一般流程是怎样的?
跟预训练的流程大体相似,微调也是一个工程化流程:数据准备、大模型选择、微调策略、训练与评估、模型优化、部署与监控,且随着业务的需求需要不断的迭代,这个流程也处在不断的自动化迭代。
数据准备
了解数据准备阶段的常见操作,如收集、清洗、标注与管理。并能够对处理好的数据进行质量的评估,并通过使用数据增强技术来提高数据的质量。企业环境下,通常会通过流程标准化之后进行自动化处理,或引入第三方的数据管理平台,来提高此阶段数据处理的效率。
数据的质量决定了模型的上限。在数据的准备阶段,还需要对数据进行清洗和处理。比如处理噪声数据(如去重、纠错、对抗样本过滤),并利用主动学习(Active Learning)优化标注成本。
有时候还需要进行一些数据增强操作。比如文本领域的回译(Back Translation)、词替换(如EDA)、合成数据生成。多模态领域的图像裁剪、文本-图像对齐增强。
数据集的格式:
比较常见的有,斯坦福指令格式Alpaca,还有一种是OpenAI常用的基于对话性质的ShareGPT格式,微调中的第一步,就是按照模型支持的数据格式去准备或者转换数据集。
大模型选择
市场上支持微调的大模型有很多,怎么去找个合适的那一个呢?企业在选择微调大模型时,需要平衡任务需求、算力成本、许可要求和开发生态。
任务类型:
-
文本生成(如医疗报告生成、患者问答)→ 选择生成式模型(如 LLaMA-2、Qwen、ChatGLM)。
-
文本理解(如病历分类、实体识别)→ 选择编码器-解码器或纯编码器模型(如 BERT 变种)。
-
多轮对话(如医患对话模拟)→ 选择对话优化模型(如 Baichuan、ChatGLM3)。
模型规模与计算资源
-
资源充足(多卡 A100/H100):可尝试 7B-13B 参数模型(如 Qwen-14B)。
-
资源有限(单卡 24G 显存):选择 7B 以下模型(如 ChatGLM3-6B)或使用 LoRA/P-Tuning 微调技术。
-
边缘设备部署:考虑 1B-3B 小模型(如 Phi-2、MiniCPM)。
语言支持
-
中文医疗任务:优先选择原生支持中文的模型(Qwen、ChatGLM、Baichuan)。
-
英文医疗任务:可考虑 LLaMA-2、Mistral 或领域专用模型(如 BioBERT)。
最后需要考虑模型的许可,用于学术场景(LLaMA-2、ChatGLM)一般问题不大,但要是商业场景(Falcon、Qwen等),得需要留意开源大模型的协议内容。同时要考虑大模型的生态和社区支持,这有利于找到好用的工具和遇到问题时的解答。建议先基于 Hugging Face 或类似平台上的模型进行试验,再根据实际效果和资源情况选择合适的模型进行部署和商业化应用。
微调策略
具体的微调策略有很多种:全参数微调、部分参数微调(如LoRA(Low-Rank Adaptation))、适配器(Adapter)微调、提示词微调等。
选用哪种微调策略,取决于业务需求、数据量、计算资源、任务复杂度。还有一种通用的策略,即超参数优化:调整学习率、批量大小(batch size)、训练轮数(epochs)等超参数,以优化微调效果。
训练与评估
这个环节涉及到具体的训练场景。使用准备好的企业数据对模型进行微调,监控训练过程中的损失值和验证集上的性能。
训练所使用的深度学习框架有:PyTorch(推荐)或TensorFlow,掌握分布式训练如torch.distributed。相对更加底层训练方法可能会使用到的库:PRFT、LoRA、transformer等。
当然也可以使用别人已经封装好的微调工具,如unsloth、Llama Factory(多显卡场景)、ms-SWIFT、ColossalAI(多节点分布式训练场景)。
微调完之后,需要对模型进行评估,在与业务相关的测试集上评估模型,使用任务特定的指标,例如:
-
分类任务:准确率(Accuracy)、F1分数。
-
生成任务:BLEU、ROUGE分数。
-
对话任务:用户满意度或流畅性。
同时对每次测试通过的模型,进行模型版本管理和实验过程的追踪,这里可以借助一些工具来处理(MLflow、Weights等)。
模型优化
在实际的部署之前,可能还会对模型进行量化(quantization)或剪枝(pruning),以减小模型体积,提升推理速度,适应企业资源限制。
进一步的,还可以通过模型蒸馏(Distillation)技术,训练一个更小的模型来模仿大模型的行为,降低计算需求,同时尽量保留性能。
大模型微调最佳实践
实践前的考虑因素
最佳实践核心关注三项内容:
-
确保数据质量:数据决定模型的上线,使用干净、相关且多样化的数据集。
-
模型的选择,根据算力资源、中英文支持等内容,确定一个合适得预训练且支持微调的大模型。
-
调整超参数:如学习率、批次大小和训练轮数,避免过拟合。
工具与平台
企业常用工具包括 Hugging Face(用于模型和数据集)、TensorFlow 和 PyTorch(深度学习框架)。平台如 SuperAnnotate 和 Snorkel AI 提供数据注释和微调支持,特别适合企业需求。例如,SuperAnnotate 博客 提供了最新 AI 新闻和案例研究,Hugging Face 博客 更新了转换器模型和微调技术。
算力考量
7B的参数量,如果使用全参微调的话,显存推荐选80G的A100。如果使用LoRA微调的话,显存大约需要在20~24G之内。这两种方式比较推荐考虑云或者算力平台的方式,这种方式在成本和速度方面都不错。
对于只是想熟悉下完整的微调过程的用户的话,可以考虑使用Google的Colab,平台提供的是T4/V100(V100有16G和32G两个版本),这个时候可以使用QLoRA(4-bit 量化 + LoRA),这种量化技术下对显存的要求可降至12-16GB,可以在代码中优化配置。
企业环境下问答系统最为常见,行业有很多:法律、医疗、金融、电商,这里就主要讨论医疗和行业。
医疗领域微调实战
基于中文-算力云-LM Studio环境,微调一个企业问答大模型。
任务分析与环境搭建
数据集:medical
模型考量:中文数据集,比较推荐使用Qwen或DeepSeek。本文使用Qwen作为演示。
算力环境:Google Colab
微调工具平台:使用流行开源工具Unsloth。
核心微调实战代码
模型选择
fourbit_models = [
    # 4bit dynamic quants for superior accuracy and low memory use
    "unsloth/gemma-3-1b-it-unsloth-bnb-4bit",
    "unsloth/gemma-3-4b-it-unsloth-bnb-4bit",
    "unsloth/gemma-3-12b-it-unsloth-bnb-4bit",
    "unsloth/gemma-3-27b-it-unsloth-bnb-4bit",

    # Other popular models!
    "unsloth/Llama-3.1-8B",
    "unsloth/Llama-3.2-3B",
    "unsloth/Llama-3.3-70B",
    "unsloth/mistral-7b-instruct-v0.3",
    "unsloth/Phi-4",
]
Unsloth支持很多开源大模型,其中包含有4位量化版本,比如Gemma3的4bit版本。
model = FastModel.get_peft_model(
    model,
    finetune_vision_layers     = False, # Turn off for just text!
    finetune_language_layers   = True,  # Should leave on!
    finetune_attention_modules = True,  # Attention good for GRPO
    finetune_mlp_modules       = True,  # SHould leave on always!

    r = 8,           # Larger = higher accuracy, but might overfit
    lora_alpha = 8,  # Recommended alpha == r at least
    lora_dropout = 0,
    bias = "none",
    random_state = 3407,
)
Google的免费版本GPU(是有一定的免费额度),显存为15G,所以我们选择高效参数微调QLoRA的方式进行大模型微调。
数据准备
对数据集来说,除了质量之外,重要的就是数据集的格式了,不同的大模型微调所支持的数据格式不一样,所以必要时可以使用一些脚本程序,完成数据格式的转换。
<bos><start_of_turn>user
Hello!<end_of_turn>
<start_of_turn>model
Hey there!<end_of_turn>
Gemma 3支持的是如上所示的多轮对话,
def apply_chat_template(examples):
    texts = tokenizer.apply_chat_template(examples["conversations"])
    return { "text" : texts }
pass
dataset = dataset.map(apply_chat_template, batched = True)
我们所使用的是conversations的数据集格式,所以这里需要做一层数据格式转换。
模型训练
from trl import SFTTrainer, SFTConfig
trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    train_dataset = dataset,
    eval_dataset = None, # Can set up evaluation!
    args = SFTConfig(
        dataset_text_field = "text",
        per_device_train_batch_size = 2,
        gradient_accumulation_steps = 4, # Use GA to mimic batch size!
        warmup_steps = 5,
        # num_train_epochs = 1, # Set this for 1 full training run.
        max_steps = 30,
        learning_rate = 2e-4, # Reduce to 2e-5 for long training runs
        logging_steps = 1,
        optim = "adamw_8bit",
        weight_decay = 0.01,
        lr_scheduler_type = "linear",
        seed = 3407,
        report_to = "none", # Use this for WandB etc
    ),
)
Huggingface已经把高参微调封装成了SFTTrainer,这里所要做的就是各种微调所需要的各种参数配置。
rainer_stats = trainer.train()
执行大模型的训练,这个会给出训练过程中的各种训练配置信息。
推理测试
from unsloth.chat_templates import get_chat_template
tokenizer = get_chat_template(
    tokenizer,
    chat_template = "gemma-3",
)
messages = [{
    "role": "user",
    "content": [{
        "type" : "text",
        "text" : "Continue the sequence: 1, 1, 2, 3, 5, 8,",
    }]
}]
text = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt = True, # Must add for generation
)
outputs = model.generate(
    **tokenizer([text], return_tensors = "pt").to("cuda"),
    max_new_tokens = 64, # Increase for longer outputs!
    # Recommended Gemma-3 settings!
    temperature = 1.0, top_p = 0.95, top_k = 64,
)
tokenizer.batch_decode(outputs)
微调好的模型可以使用这种方式,来测试评估微调训练的效果。到这一步,如果效果不好,就可能涉及到多轮调整,比如参数的调整,数据的调整。
模型保存与调用
对微调好的模型进行保存,目前保存有多种格式:LoRA adapters、vllm、gguf。
这里以GGUF为例,将保存好的模型上传到Huggingface账户上,之后就可以利用Ollama等方式进行下载并本地化部署。
model.push_to_hub_gguf(
        "gemma-3-lora",
        quantization_type = "Q8_0", # Only Q8_0, BF16, F16 supported
        repo_id = "hf_account/reposity",
        token = "hf_...",
    )
本地部署与测试
这是令人激动人心的环境,根据资源环境、并发、吞吐、延迟等要求,可以有不同的部署方案。这里梳理了一个表格,大家参考:
| 方案 | 吞吐量 | 延迟 | 适用场景 |
|---|---|---|---|
| Transformers |
低 |
高 |
快速验证、低并发 |
| vLLM |
高 |
低 |
生产环境、高并发 |
| TGI |
最高 |
最低 |
企业级部署、多 GPU 扩展 |
具体的方案选定好,完整的部署需要经过以下几步:
模型合并
微调训练好的模型,在生产环境部署的时候,需要将自定义微调后的模型与预训练的模型,通过权重合并导出更为通用的格式:
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

base_model = AutoModelForCausalLM.from_pretrained("unsloth/gemma-3-4B")
model = PeftModel.from_pretrained(base_model, "gemma-4b-medical-lora")
merged_model = model.merge_and_unload()  # 合并 LoRA 权重
merged_model.save_pretrained("gemma-4b-medical-merged")
API封装
使用Flask或者vLLM的方式,对大模型进行API化的封装。
API管理级别,在封装的基础上,可以对API做些更为安全的配置,比如对API增加API Key的验证、速率限制、额度管理等内容。
在运维级别,对API考虑性能监控、负载均衡、安全加固等操作。
容器化部署
-
编写Dockfile文件
# 基于 NVIDIA 基础镜像
FROM nvidia/cuda:12.1.0-base

# 安装依赖
RUN apt-get update && apt-get install -y python3.9 python3-pip
RUN pip install torch transformers fastapi uvicorn vllm

# 复制模型和代码
COPY qwen-7b-medical-merged /app/model
COPY app.py /app/

# 启动服务
WORKDIR /app
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "5000"]
-
构建并运行容器
docker build -t medical-llm-api .
docker run -d --gpus all -p 5000:5000 medical-llm-api
至此,大模型生产环境下的部署就完成了。
企业中集成大模型的考虑与挑战
隐私、集成与迭代
企业环境中微调涉及独特挑战,包括数据隐私、合规性和系统集成。以下是关键考虑:
-
数据隐私与合规:确保微调过程符合法规,如 GDPR。建立对数据的分类分级、脱敏、审计等需求。
-
系统集成:学习如何将微调模型集成到现有企业系统中。例如,SuperAnnotate 的 Python SDK 与 Databricks 集成,简化数据处理和模型训练。
-
硬件需求:微调通常需要 GPU/TPU,内存至少 16GB,支持分布式训练。云解决方案如 AWS、Azure 和 Google Cloud 适合企业扩展。
-
持续迭代:微调是一个持续过程,且AI是个技术不断推陈出新的领域,这就需要关注行业动态(推荐 SuperAnnotate 博客 和 Hugging Face 博客 ),参与社区讨论等方式,保持对AI前沿内容的敏感。建议关注行业动态,通过了解最新研究。
微调与RAG对比分析
微调和RAG都是两种调整大模型性能的方案,本质的区别在于是否对大模型进行调整。
从训练角度来看,RAG不需要相对复杂且陈本高的训练过程,通过构建外部知识库、检索系统结合大模型的能力,就能补充大模型在领域内的知识。而微调则需要按照大模型的完整条件,数据集的准备和算力资源的配置。
从推理视角来看,很明显微调之后的模型只需要封装成API,就可以对外提供高效的服务。而RAG则需要每次访问的使用,需要额外的系统支持,且随着知识库规模的增加,这个检索性能也会受影响。
从技术实现角度看,RAG需要检索算法与生成模型的配合,且需要对检索结果进行重排。
企业环境下,可以根据项目的周期、项目资金情况,团队的技术水平等因素进行考量。
最后,大模型的认识和学习,是一个比较偏实用且需要偏手动实践的事情。
AI大模型从0到精通全套学习大礼包
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
只要你是真心想学AI大模型,我这份资料就可以无偿共享给你学习。大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!
如果你也想通过学大模型技术去帮助就业和转行,可以点扫描下方👇👇
大模型重磅福利:入门进阶全套104G学习资源包免费分享!
01.从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
02.AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
03.学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
04.大模型面试题目详解
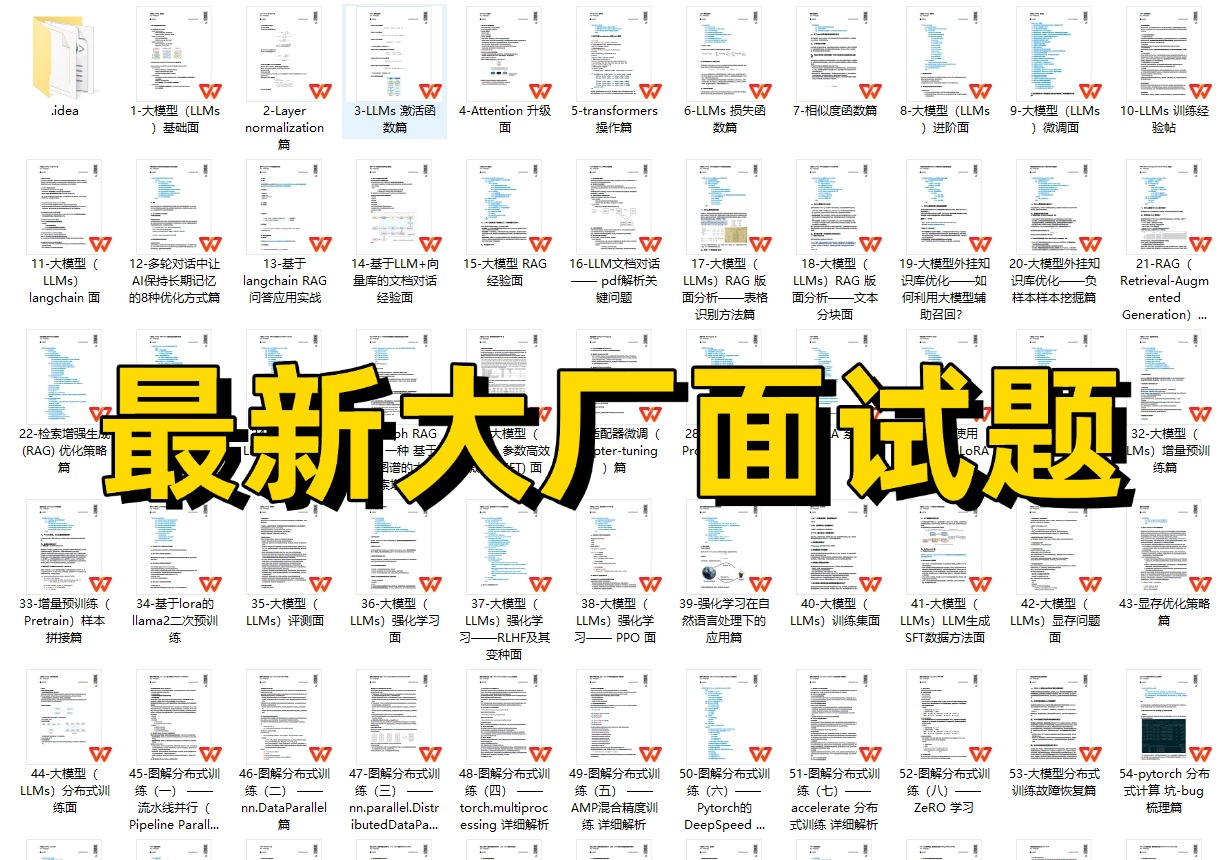
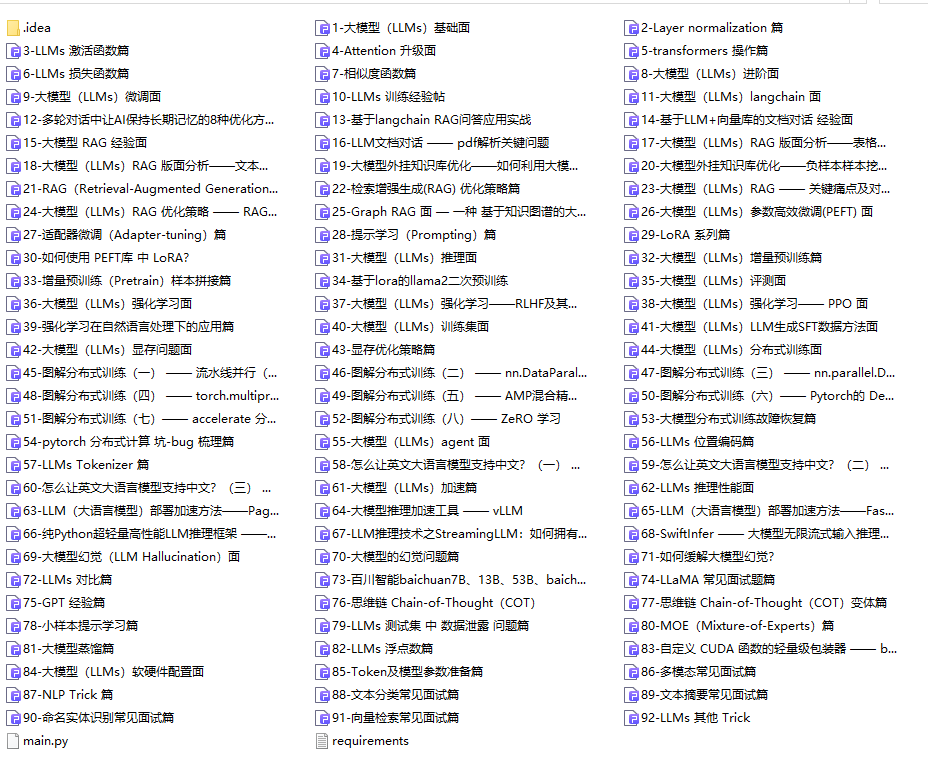
05.这些资料真的有用吗?
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
 1007


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


