遥感&机器学习入门实战教程|Sklearn案例⑬:数据集(datasets 模块)

《机器学习原理及应用》全套PPT课件2026(重庆工商大学) 获取 《机器学习原理及应用》全套PPT课件2026(重庆工商大学)::https://download.youkuaiyun.com/download/m0_54748666/93793958。13-第十三章高斯混合模型.pptx。1-第一章 机器学习概述.pptx。3-第三章模型评估与选择.pptx。12-第十二章K均值聚类.pptx。14-第十四章 谱聚类.pptx。6-第六章 逻辑回归.pptx。7-第七章 神经网络.pptx。11-特征选择与提取.pptx。9-第九章决策树.pptx。 阅读详情

在真实科研与工程中,强烈建议直接使用自己的遥感影像与标签数据,这样实验才具有实际意义。 不过,很多同学刚开始学习时可能没有准备好的数据集,可以借助 sklearn.datasets 里的内置与生成数据集功能来做练习。

往期内容和数据链接如下:

遥感&机器学习入门实战教程 数据集分享

🧩 datasets 模块能做什么?

sklearn.datasets 提供了三类常见功能:

  1. 内置小数据集:适合快速上手,常见有:

    • load_iris():鸢尾花分类

    • load_digits():手写数字(8×8 灰度图)

    • load_wine():红酒分类

    • load_breast_cancer():乳腺癌诊断

  2. 下载大型公开数据集(通过 fetch_ 前缀):

    • fetch_olivetti_faces():人脸数据

    • fetch_20newsgroups():新闻分类文本

    • fetch_openml():通用接口,可从 OpenML 平台拉取上百个公开数据集

  3. 生成模拟数据(适合调试算法):

    • make_classification():生成可控特征和类别的分类数据

    • make_blobs():聚类数据

    • make_moons()、make_circles():非线性可分的二维玩具数据

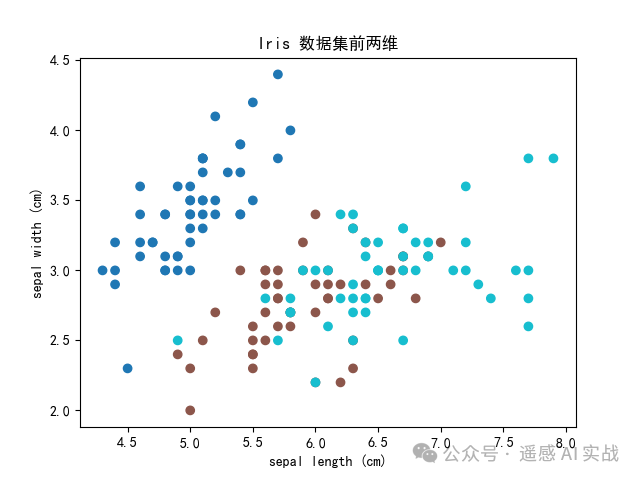
💻 示例1:加载内置鸢尾花数据集

from sklearn.datasets import load_iris
import matplotlib.pyplot as plt

iris = load_iris()
X, y = iris.data, iris.target
print("数据形状:", X.shape)

# 简单可视化
plt.scatter(X[:,0], X[:,1], c=y, cmap="tab10")
plt.xlabel(iris.feature_names[0]); plt.ylabel(iris.feature_names[1])
plt.title("Iris 数据集前两维")
plt.show()

输出:四维特征(萼片/花瓣长宽),三类花(Setosa/Versicolor/Virginica)。
图片

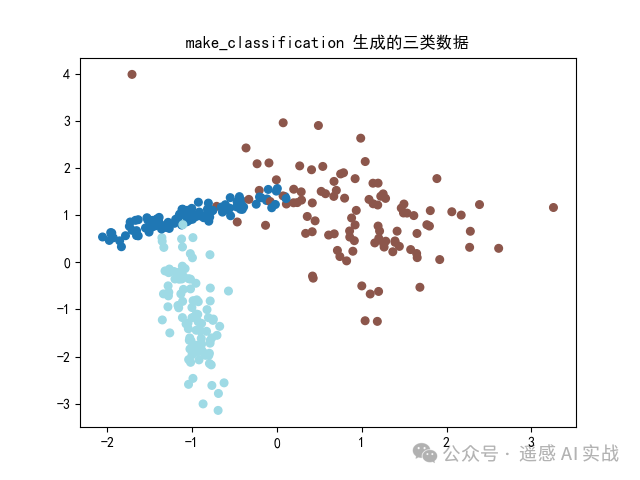
💻 示例2:生成模拟分类数据

from sklearn.datasets import make_classification
import matplotlib.pyplot as plt

X, y = make_classification(
    n_samples=300, n_features=2, n_redundant=0, n_clusters_per_class=1,
    n_classes=3, random_state=42
)

plt.scatter(X[:,0], X[:,1], c=y, cmap="tab20", s=30)
plt.title("make_classification 生成的三类数据")
plt.show()

这样就能快速生成一个分类任务,适合调试 SVM、kNN 等分类器。
图片

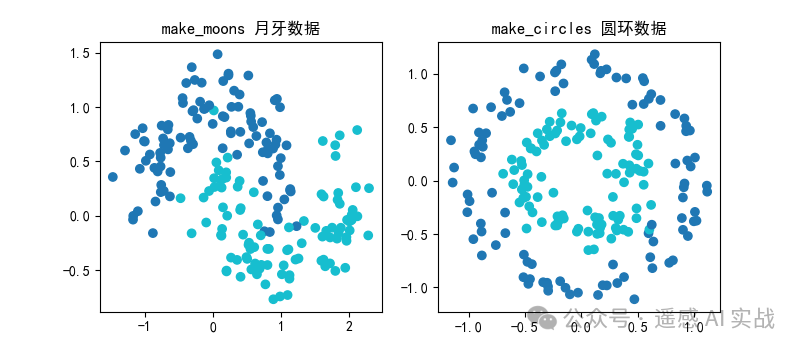
💻 示例3:非线性分布数据

from sklearn.datasets import make_moons, make_circles
import matplotlib.pyplot as plt

X1, y1 = make_moons(n_samples=200, noise=0.2, random_state=42)
X2, y2 = make_circles(n_samples=200, noise=0.1, factor=0.5, random_state=42)

plt.figure(figsize=(8,3.5))
plt.subplot(1,2,1)
plt.scatter(X1[:,0], X1[:,1], c=y1, cmap="tab10")
plt.title("make_moons 月牙数据")

plt.subplot(1,2,2)
plt.scatter(X2[:,0], X2[:,1], c=y2, cmap="tab10")
plt.title("make_circles 圆环数据")
plt.show()

这类数据常用于展示 非线性分类器(如核SVM、神经网络)的优势。
图片

✅ 小结

  • sklearn.datasets 非常适合入门学习与算法调试,但不适合直接替代真实的遥感实验。

  • 在实际工作中,应该使用 Sentinel、Landsat、高分等真实遥感影像;而在教学、算法原型验证时,可以用 make_classification 或 make_moons 快速生成样例。

  • 建议同学们:用 datasets 快速练手,理解算法 → 再切换到真实遥感数据完成应用。

欢迎大家关注下方公众号获取更多内容!

基于LORA的双机通信的智能农业系统 通过LoRa模块与主机进行通信,监测环境中的温度、湿度、土壤湿度和光照强度等参数,并根据预设的自动控制逻辑或者手动指令控制继电器开关,从而调节风扇、加热器、水泵、喷雾器和灯光等设备,为植物提供适宜的生长环境。使用的Lora是大夏龙雀的感觉这个是我使用过的Lora里面最好用的,因为不用设置频道就可以直接透明传输,使用起来得心应手。就像两个单片机直接串口通信一样,缺点是异步串行,不能同时进行接收和发送。继电器灯亮模拟打开对应的风扇、水泵、灯、喷雾、加热。1.使用温度传感器测当前环境的温湿度。 阅读详情

相关推荐

Ubuntu20.04 安装 MATLAB R2023b 常见问题及解决方案

本文提供了Ubuntu20.04系统上安装MATLAB R2023b的完整指南,包括系统要求检查、依赖项安装、详细安装步骤及常见问题解决方案。特别针对GTK模块加载失败、OpenGL图形加速问题和中文显示乱码等常见问题提供了有效解决方法,帮助用户顺利完成安装并优化使用体验。

weixin_42619061的博客 482

【机器学习300问】139、Post-LN 和 Pre-LN 的区别?

Post-LN与Pre-LN的核心区别在于LayerNorm的位置:Post-LN在残差连接后,导致梯度需经LayerNorm变换,深层易出现梯度衰减或震荡;Pre-LN先做归一化,使输入稳定,残差路径梯度可无损回传,显著提升深层训练稳定性。尽管Pre-LN支持更深层次模型(如LLaMA、Qwen),但存在“深度诅咒”——深层贡献不足。相比之下,Post-LN浅层表现尚可,深层数易发散。因此,现代大模型普遍采用Pre-LN以保障训练可靠性。

qq_39780701的博客 347

10分钟上手YOLOv11:最强姿态估计模型来了,代码开源,效果炸裂!

【10分钟玩转YOLOv11实时姿态估计】🚀 YOLOv11作为YOLO家族最新成员,在速度、精度和易用性上全面升级,尤其适用于姿态估计等复杂视觉任务。本文带您快速掌握: 1️⃣ 核心概念:姿态估计即识别人体17个关键点(如关节部位)并连接成数字骨架,是智能健身、体感游戏等应用的基础。 2️⃣ 技术优势: 超轻量级(最小仅2.9M参数) 极速推理(GPU仅1.7ms) 高精度(COCO mAP@50-95达50%) 3️⃣ 三步实操: ① 安装:pip install ultralytics ② 准备人物

weixin_41246802的博客 1783

python 机器学习 交叉验证train_test_split 网格搜索GridSearchCV

最佳参数: {'metric': 'euclidean', 'n_neighbors': 3, 'weights': 'uniform'}交叉验证 用于在数据集中拆分成测试集和验证集,用于模型训练和验证。最佳交叉验证得分: 0.9428571428571428。网格搜索 用于自动查找最合适的模型参数,用于模型调优。测试集准确率: 1.0。

frt的博客 240

[原创]Linux 802.11n CSI tool Monitor模式

Linux 802.11n CSI tool Monitor模式 使用AP模式的缺陷在于ping 命令速度比较慢,且不能精确控制发送的参数,比如接收的包数量是不可控的。Monitor模式可以调制发送速率、发包数量、发送天线个数、HT模式、short/long guard interval等等,因此调通Monitor模式是必须的。期间参考了博主沃一德的CSI Tool安装使用讲解,对他的工作表示感...

u014645508的博客 1万+

博图编写温度程序_s7 smart200的CRC-16校验程序

最近做一个小项目,项目中采用485自由口通讯方式,使用一台西门子S7 smart200对一台冷水机做多个状态和温度做监控,并能对冷水机进行启停控制,和参数设置,因为冷水机的协议不是标准modbus格式,所以要自己编写通信协议。其中要用到CRC校验,在网上找了些别人写的程序,基本上用不了。只能自力更生了。首先,找到CRC校验的算法,并理解。 下面就是我找的算法(这个网上很多),1....

weixin_39539761的博客 3062

【机器学习300问】138、LayerNorm和BatchNorm的区别?

本文阐述了归一化与标准化在深度学习中的核心作用。输入层标准化可统一初始输入,但深层网络仍面临激活分布漂移。为此,提出BatchNorm与LayerNorm两种主流方法。

qq_39780701的博客 176

VMware系列:此平台不支持虚拟化 Intel-VT-x/EPT 或 AMD-V/RVI

VMware系列:此平台不支持虚拟化 Intel-VT-x/EPT 或 AMD-V/RVI

weixin_54626591的博客 1万+

为什么生成对抗网络训练常不稳定,模式崩溃与判别器过强之间是什么关系?

当支持集不重叠时(即 $D$ 能完美区分真假),JS 散度为常数 $\log 2$,其梯度为 0。这意味着一旦 $D$ 训练得稍好,$G$ 就失去了学习方向,导致训练停滞。生成对抗网络(GAN)的训练本质上是生成器($G$)与判别器($D$)之间的非合作零和博弈。以下代码展示了如何通过梯度惩罚(Gradient Penalty)来约束判别器,避免其过强导致生成器梯度失效。判别器过强是导致模式崩溃的直接诱因之一,二者之间存在明确的**“梯度误导”**因果关系。

2402_84593233的博客 195

【ArcPy】用Python批量处理大规模地理数据的几何校正

在许多GIS应用中,尤其是在大规模地理数据处理时,几何校正(Geometric Correction)是一个至关重要的任务。它确保了不同来源的地理数据能够正确地对齐和匹配,从而为后续分析提供准确的基础。几何校正的常见应用包括遥感影像的地理配准、矢量数据的投影转换等。几何校正通常包括坐标转换、重采样等步骤。以下示例展示了如何使用arcpy的工具进行几何校正。"""实施几何校正:param input_layer: 输入待校正数据层。

陈书予 992

基于深度学习的图像识别技术在农业领域中的应用

是识别"病害种类"还是"病害严重度分级"?前者是分类,后者常需分割或分级回归。是叶片级(离体叶片图像)、植株级(田间单株)、地块级(无人机俯拍)?视角不同,模型差异巨大。实时无人机巡检可能要求 < 50 ms/帧(Jetson Orin),而离线测报可接受秒级推理。类别标签、结构化 JSON、GIS 图斑、报警事件?

AI天才研究院 2160

人工智能,机器学习,深度学习,神经网络之间到底是什么关系,它们之间有什么联系和区别

联系:四者是目标 - 方法 - 架构 - 深化的递进关系。AI 是终极目标,ML 是实现 AI 的主流路径,NN 是 ML 中模仿人脑的算法架构,DL 是利用深层 NN 解决复杂问题的最强工具。区别核心AI包含非学习型规则系统(如专家系统)。ML强调“从数据中学习”,但通常需要人工介入特征工程。NN是具体的算法模型,浅层 NN 属于传统 ML。DL特指“深层”NN,核心优势在于自动特征提取和处理非结构化大数据的能力。技术选型建议:若数据量小、特征明确且需要高可解释性(如金融风控表格数据),首选。

2402_84593233的博客 226

国家自然基金回避专家有必要填写吗?被回避专家能看到吗?

不填也能中填1–2个最保险只填1个最直接竞争者。✅一句话结论可以不填,但建议填1–2个被回避专家绝对看不到如果你愿意,我可以再告诉你一个很多人不知道的国家自然基金“评审分组规则”——它其实决定了你的项目最可能送到哪些专家手里,这对地区基金中标率影响很大。

qq_15963745的博客 155

【人工智能驱动的电催化研究-01】人工智能是什么?AI、机器学习、深度学习和神经网络之间有什么区别?

介绍人工智能、机器学习、神经网络和深度学习的基本概念及相互关系。围绕催化剂性能预测,解释样本、特征、标签、模型、参数、训练、预测与验证的含义。结合二硫化钼边缘位点与析氢活性的研究案例,说明科学问题如何指导特征选择。利用真实文献中的析氢数据,通过手算和Python实践,对比人工规则与均值模型,理解参数学习和误差评价。强调数据学习不保证预测更优,相关性不能直接证明反应机理,文献数据还须核查实验条件与适用范围,为后续编程、数学和电催化机器学习课程建立基础。

2402_84593233的博客 748

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

机器学习01,KNN使用与简单数学原理

个人笔记

qq_59247073的博客 247

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

机器学习教程,从入门到精通,高斯混合模型(GMM)——写给机器学习小白的保姆级教程(10)

高斯混合模型(Gaussian Mixture Model,简称 GMM):假设你手里的数据是由"好几堆正态分布的数据混在一起"形成的,GMM 的任务就是——把这几堆分开,并且描述清楚每一堆的样子。

qq_45746668的博客 108

机器学习01,了解与KNN

个人笔记

qq_59247073的博客 343

【slam公式】

F:状态转移矩阵H:观测矩阵R: 观测噪声协方差。

qq_44691564的博客 285

基于有效Token规模化的大模型预训练数据配方与工程体系研究——基于唐杰《高级机器学习》课程演讲

在此背景下,本文系统梳理GLM系列模型数据迭代轨迹,纠正数据墙认知偏差,分析天然数据与合成数据的互补机制,并完整构建支撑高质量Token挖掘的全链路数据工程体系,为大模型数据规模化建设提供理论与工程参考。早期小模型训练场景下,数据总量远大于算力可消化量,核心策略为择优筛选少量高质量数据。基于唐杰公开演讲核心观点、GLM数据迭代、数据墙、合成数据、清洗解析工具链、分层架构图、自研工程壁垒),完整重构成一篇结构严谨、逻辑连贯、标准期刊论文风格全文,预留精准图片插入位置,可直接定稿、查重、发表、结课提交。

interpromotion的博客 231

机器学习-支持向量机

本文通过多个案例深入解析SVM在二分类、多分类及高维文本数据中的应用。基于乳腺癌数据集,构建标准化+SVM的流水线,结合网格搜索优化C与gamma参数,实现98.02%的测试准确率。通过交叉验证评估模型稳定性,结果显示标准差仅0.0162,表明模型鲁棒性强。引入probability=True后,可输出预测概率,揭示模型不确定性(如样本4的52%良性概率),助力医疗决策。结果表明,特征维度提升需调小gamma、增大C以适应复杂数据,凸显参数与数据特性的交互关系。

buwangchuxinking的博客 325

茶叶病虫害目标检测数据集

目标检测 yolo 目标检测数据集 茶叶病虫害目标检测数据集

DL_data_set的博客 338

生成式对抗网络GAN(Generative Adversarial Network)

和我们之前所说的梯度消失的问题类似所以很长一段时间用GAN来生成Sequence文字是非常困难的更多的生成模型:但是一般还是GAN产生的结果最好。

2303_76561497的博客 155

分布式计算框架如何赋能大规模机器学习

PyTorch 和 TensorFlow 是当今最流行的深度学习框架,它们都提供了强大的内置库来支持分布式训练。其核心策略主要分为数据并行和模型并行。

Cat_fish_snow的博客 172

基于机器学习的酒店数据分析及流失预测系统

本系统是一个面向酒店行业的客户数据分析与流失预测平台,基于 Antonio et al. (2019) 公开的酒店预订需求数据集,采用 Flask + SQLite + ECharts + scikit-learn 技术栈,实现数据可视化分析、机器学习流失预测、模型管理等功能,帮助酒店管理者识别流失风险客户并制定针对性挽留策略。流失(1):预订取消(is_canceled = 1),或非回头客且有历史取消记录未流失(0):不符合上述条件的客户。

aiyuanma_vip的博客 335

40V/24A高频率增强型GaN HEMT功率开关管/高频DC转换/电动工具/GaN充电器 方案首选

是一种增强型硅基氮化镓晶体管。氮化镓是一种宽禁带半导体,具有高功率密度。氮化镓晶体管的特点是没有体二极管,因此反向恢复电荷为零。这种氮化镓高电子迁移率晶体管(HEMT)是一种高性能增强型氮化镓HEMT,可实现优异的高频和高效率运行。该氮化镓功率HEMT结合了最高的dv/dt抗扰性以及行业标准的低轮廓、低电感FCQFN 3x4封装,使设计人员能够实现简单、快速且可靠的解决方案。符合RoHS、无铅、REACH标准。提供FCQFN 3x4封装。无人机及遥控模型电子调速器。高频DC-DC转换器。

2301_76864527的博客 224

分类模型评估:混淆矩阵、精确率、召回率与阈值调整

模型训练后仅凭准确率(如87%)无法判断是否可用,因它忽略错误类型与业务代价。本文以BERT中文情感分类为例,系统演示模型评估流程:通过混淆矩阵分析预测结果,结合精确率、召回率、F1等指标全面评估性能。代码实现中,使用sklearn计算各类指标,并可视化混淆矩阵,揭示模型在类别不平衡下的真实表现,强调应根据实际场景选择合适评估标准,避免误判风险。

weixin_50260670的博客 278

scikit-learn 1.9.1发布解读:Array API、元数据路由与稳定性修复全面汇总

在 1.9.1 中,支持 Array API、且能够处理混合输入命名空间的函数和估计器,会在通过 DLPack 将负步长 NumPy 数组传递给 PyTorch 之前,先将该数组转换为连续内存布局。此前,在这种场景中,元数据可能不会继续传递给元估计器内部的子估计器,而是被静默丢弃。此前,预测过程中的元数据路由可能无法根据底层子估计器真正对应的方法进行动态分发。在复杂的 Pipeline、元估计器和组合模型结构中,元数据是否能够准确传递到真正需要它的子估计器,会直接影响训练流程的正确性。

福大大架构师每日一题 573
上一篇: 遥感&机器学习入门实战教程|Sklearn案例⑫:神经网络(MLP)+ 全图预测
下一篇: 遥感&机器学习入门实战教程|Sklearn案例⑭:数据划分与交叉验证(KSC 真实数据)
遥感AI实战
博客等级 码龄9年 1002粉丝 107原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

遥感AI实战

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值