CentOS7 手动部署Hadoop集群2.7.2

Linux(centos7)部署hadoop集群 dfs.datanode.data.dir/data/dn 说明:配置DataNode存储实际数据块的本地目录位置,这里是 /data/dn。dfs.datanode.data.dir.perm700 说明:该配置项设置DataNode存储数据块目录的权限模式。dfs.namenode.name.dir/data/nn 说明:此配置项指定了NameNode存储元数据信息(如文件系统的命名空间,文件到数据块映射等)的本地目录位置,这里是 /data/nn。bin:存放Hadoop的各类程序(命令) 阅读详情

目的:新项目的一个测试环境,需要手动部署集群,由于之前都是用ambari进行部署,好久没有手动了,因此借此机会整理下部署文档,方便以后查看

环境信息

[root@test-01 ~]# cat /etc/redhat-release
CentOS Linux release 7.4.1708 (Core)
主机名IP部署内容
test-01172.18.0.1NameNode、SecondaryNameNode、ResourceManager
test-02172.18.0.2NodeManager、DataNode
test-03172.18.0.3NodeManager、DataNode

部署前提

1、环境初始化(各个节点执行)
包括句柄数,调参

echo -e '* soft nofile 102400\n* hard nofile 102400\n* soft nproc 102400\n* hard nproc 102400' >> /etc/security/limits.conf

2、更改主机名并配置hosts文件
因为之前其他环境部署过ansible,因此此步骤使用ansible直接执行,过程略
更改后/etc/hosts为:

cat /etc/hosts
127.0.0.1   localhost localhost.localdomain localhost4 localhost4.localdomain4
::1         localhost localhost.localdomain localhost6 localhost6.localdomain6
172.18.0.1 test-01
172.18.0.2 test-02
172.18.0.3 test-03

3、配置SSH免密
a.新建用户组(各个节点执行)

groupadd hadoop

b.新建hdfs用户,其中需设定userID<1000

useradd -u 501 hdfs -g hadoop

c.并使用passwd命令为新建用户设置密码

passwd hdfs 输入新密码

d.用户建好后,用id user命令查看用户信息如下所示

[root@test-01 /tmp]# id hdfs
uid=501(hdfs) gid=1002(hadoop) groups=1002(hadoop)

e.配置root、hdfs免密
以hdfs用户为例配置免密登录:

  • 分别在master和worker上执行
ssh-keygen -t rsa

执行完命令后 在/home/hdfs/.ssh目录下生成如下两个文件

id_rsa 私钥文件
id_rsa.pub 公钥文件

  • 分别在master和worker上执行以下命令
ssh-copy-id -i /home/hdfs/.ssh/id_rsa.pub ${ip}

其中,如果在test-01上执行,则写test-02节点对应的ip

ssh-copy-id -i /home/hdfs/.ssh/id_rsa.pub 172.18.0.1
ssh-copy-id -i /home/hdfs/.ssh/id_rsa.pub 172.18.0.2
ssh-copy-id -i /home/hdfs/.ssh/id_rsa.pub 172.18.0.3
  • 验证是否配置成功
ssh hdfs@test-01
ssh hdfs@test-02
ssh hdfs@test-03

继续为root用户配置免密,步骤略
4、安装jdk
此步骤依然使用ansible进行部署,jdk版本为

[root@test-01]#java -version
java version "1.8.0_131"
Java(TM) SE Runtime Environment (build 1.8.0_131-b11)
Java HotSpot(TM) 64-Bit Server VM (build 25.131-b11, mixed mode)

下载Hadoop并安装(主节点)

cd /opt
wget http://archive.apache.org/dist/hadoop/common/hadoop-2.7.2/hadoop-2.7.2.tar.gz
#下载后解压
tar xf hadoop-2.7.2.tar.gz

配置hadoop-env.sh中jdk信息

cd /opt/hadoop-2.7.2/etc/hadoop
[root@test-01 /opt/hadoop-2.7.2/etc/hadoop]# echo $JAVA_HOME
/opt/java
[root@test-01 /opt/hadoop-2.7.2/etc/hadoop]# vim hadoop-env.sh
#export JAVA_HOME=${JAVA_HOME}
export JAVA_HOME=/opt/java

为了方便我们以后开机之后可以立刻使用到Hadoop的bin目录下的相关命令,可以把Hadoop的环境变量加到/etc/profile.d/下

[root@test-01 /etc/profile.d]# cat hadoop.sh 
export HADOOP_HOME=/opt/hadoop-2.7.2
export PATH=$PATH:$HADOOP_HOME/bin

使得命令配置信息生效,是否生效可以通过

source /etc/profile.d/hadoop.sh
#查看
hadoop version

配置Hadoop分布式集群(主节点)

在hadoop安装目录下创建四个文件夹

mkdir -p current/tmp hdfs hdfs/data hdfs/name

其中:

目录current/tmp,用来存储临时生成的文件
目录/hdfs,用来存储集群数据
目录hdfs/data,用来存储真正的数据
目录hdfs/name,用来存储文件系统元数据

配置hadoop文件
1、修改core-site.xml

cd /opt/hadoop-2.7.2/etc/hadoop/
[root@test-01 /opt/hadoop-2.7.2/etc/hadoop]# vim core-site.xml 
<!-- 添加以下内容 -->
<!-- 指定HDFS老大(namenode)的通信地址 -->
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://test-01:9000</value>
    </property>
    <!-- 指定hadoop运行时产生文件的存储路径 -->
    <property>
        <name>hadoop.tmp.dir</name>
        <value>file:/opt/hadoop-2.7.2/current/tmp</value>
    </property>
    <property>
        <name>io.file.buffer.size</name>
        <value>131072</value>
    </property>

变量fs.defaultFS保存了NameNode的位置,HDFS和MapReduce组件都需要它。这就是它出现在core-site.xml文件中而不是hdfs-site.xml文件中的原因。
2、修改mapred-site.xml
默认没有mapred-site.xml文件,需要从模板复制一份

cp mapred-site.xml.template mapred-site.xml
[root@test-01 /opt/hadoop-2.7.2/etc/hadoop]# vim mapred-site.xml
<!--添加如下内容-->
<!-- 通知框架MR使用YARN -->
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
    <property>
        <name>mapreduce.jobhistory.address</name>
        <value>test-01:10020</value>
    </property>
    <property>
        <name>mapreduce.jobhistory.webapp.address</name>
        <value>test-01:19888</value>
    </property>

3、修改hdfs-site.xml

[root@test-01 /opt/hadoop-2.7.2/etc/hadoop]# vim hdfs-site.xml
<!--添加如下内容-->
<!-- 设置namenode存放的路径 -->
    <property>
        <name>dfs.namenode.name.dir</name>
        <value>file:/opt/hadoop-2.7.2/hdfs/name</value>
    </property>
    <!-- 设置datanode存放的路径 -->
    <property>
        <name>dfs.datanode.data.dir</name>
        <value>file:/opt/hadoop-2.7.2/hdfs/data</value>
    </property>
    <!-- 设置hdfs副本数量 -->
    <property>
        <name>dfs.replication</name>
        <value>2</value>
    </property>
    <!-- 设置secondarynamenode的http通讯地址 -->
    <property>
        <name>dfs.namenode.secondary.http-address</name>
        <value>test-01:9001</value>
    </property>
    <property>
    <name>dfs.webhdfs.enabled</name>
    <value>true</value>
    </property>

PS:变量dfs.replication指定了每个HDFS数据块的复制次数,即HDFS存储文件的副本个数.我的实验环境只有一台Master和两台Worker(DataNode),所以修改为2。

4、配置yarn-site.xml

[root@test-01 /opt/hadoop-2.7.2/etc/hadoop]# vim yarn-site.xml
<!--添加如下内容-->
<!-- reducer取数据的方式是mapreduce_shuffle -->
        <property>
               <name>yarn.nodemanager.aux-services</name>
               <value>mapreduce_shuffle</value>
        </property>
        <property>
               <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name>
               <value>org.apache.hadoop.mapred.ShuffleHandler</value>
        </property>
        <property>
               <name>yarn.resourcemanager.address</name>
               <value>test-01:8032</value>
       </property>
       <property>
               <name>yarn.resourcemanager.scheduler.address</name>
               <value>test-01:8030</value>
       </property>
       <property>
               <name>yarn.resourcemanager.resource-tracker.address</name>
               <value>test-01:8031</value>
       </property>
       <property>
               <name>yarn.resourcemanager.admin.address</name>
               <value>test-01:8033</value>
       </property>
       <property>
               <name>yarn.resourcemanager.webapp.address</name>
               <value>test-01:8088</value>
       </property>

5、修改slaves内容
将localhost修改成 test-02、 test-03

[root@test-01 /opt/hadoop-2.7.2/etc/hadoop]# vim slaves
test-02
test-03

分发hadoop目录(主节点)

将配置好的hadoop目录分发的其他节点上

cd /opt/
rsync -av hadoop-2.7.2 root@test-02:/opt
rsync -av hadoop-2.7.2 root@test-03:/opt

启动hadoop分布式集群(主节点)

1、在主节点上格式化集群的文件系统

hadoop namenode -format

2、启动集群

cd /opt/hadoop-2.7.2/sbin
[root@test-01 /opt/hadoop-2.7.2/sbin]# ./start-all.sh

3、查看各个节点的进程

jps

可以看到

#test-01:
SecondaryNameNode
NameNode
ResourceManager
#test-02:
DataNode
NodeManager
#test-03:
DataNode
NodeManager

此时分布式的hadoop集群已经搭好了
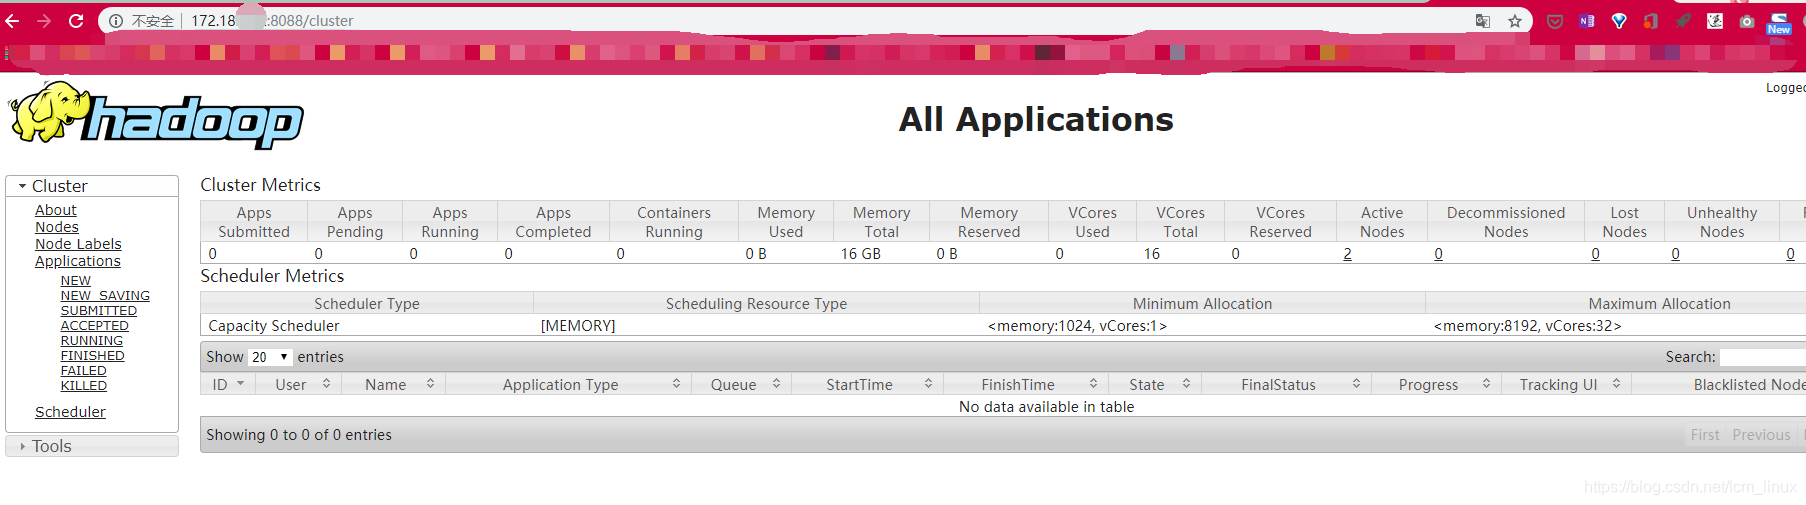
在浏览器输入:

172.18.0.1:50070
172.18.0.1:8088
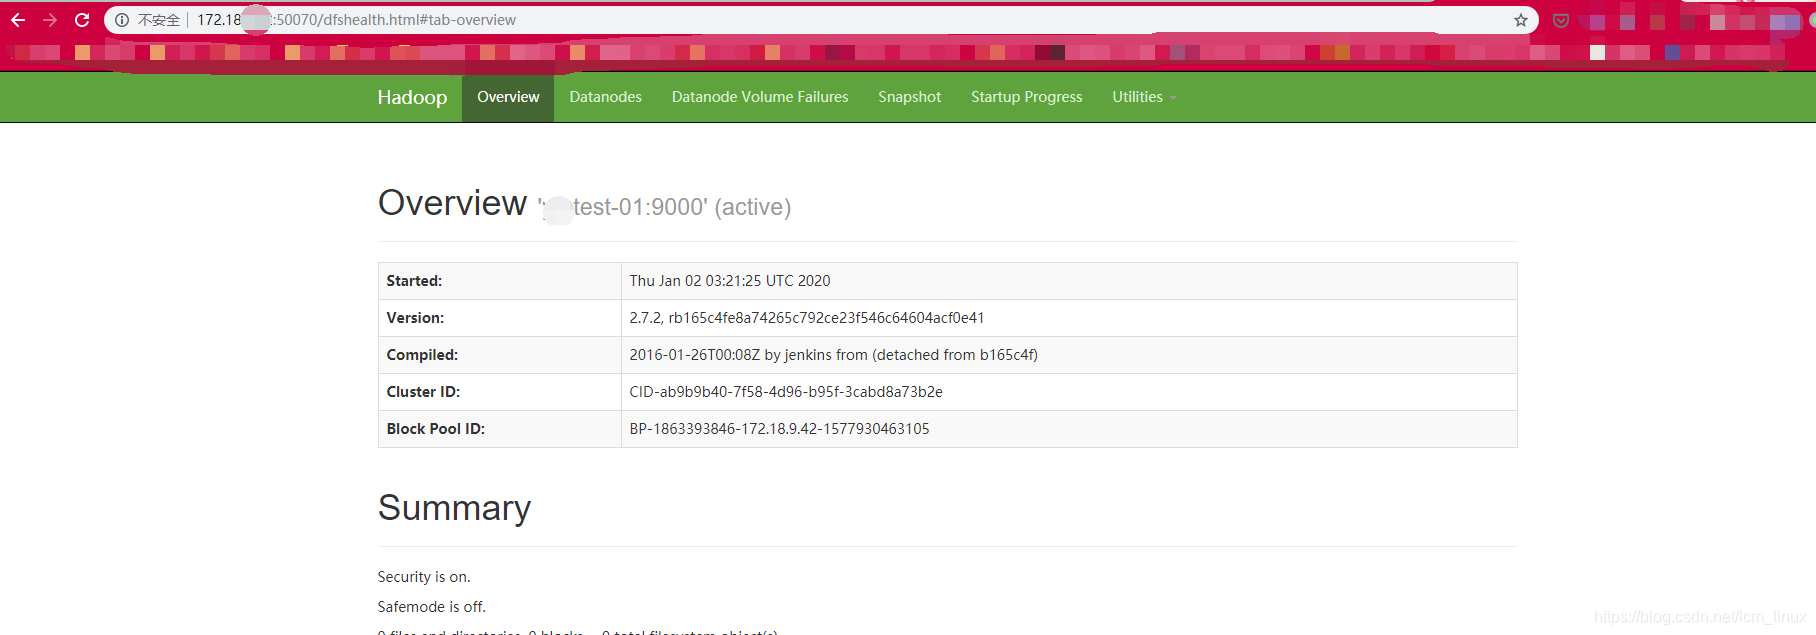
在这里插入图片描述
在这里插入图片描述

在Centos7上配置Hadoop集群 硬件 创建虚拟机 自定义 先不要安装操作系统,后面再装 选择对应系统,以及硬件配置 虚拟机存放位置 磁盘存放位置 总核心数不要超过电脑的配置(2核n线程 硬盘50G) 软件 打开虚拟化 关闭hyper-V delete进入bios (SVM选项) 配置操作系统(centos) 在官网下载一个镜像 在设备的CD/DVD插入系统 GNOME桌面 或者 最小安装 分配磁盘 /boot 启动 1g 文件系统 ext4 /swap 共享内存 4g / 根目录 剩下的内容 KDUMP 系统崩溃备份一部分数据 网络和主机 阅读详情

相关推荐

[Hadoop]在CentOS7上使用Docker部署Hadoop

在踩了众多的坑之后,即使是使用阿里云开源的Docker镜像来部署Hadoop,也会出现很多错误,本文帮助你更好的使用Docker来部署全分布式Hadoop的环境,如果出现问题的,请联系tangweixuan1995@foxmail.com,请支持原创

dannistang的博客 4475

Centos7安装hadoop2.7.2完全分布式集群

Centos7安装hadoop2.7.2完全分布式集群 为了模拟生产环境,我们需要搭建一个完全分布式集群,以供后续的学习​和实验所用。下面是安装hadoo完全分布式集群的详细操作步骤。 一、虚拟机环境配置 系统 主机 地址 hadoop版本 jdk版本 centos7 hadoop01 192.168.241.201 2.7.2 1.8 centos7 hadoop02 192.168.241.202 2.7.2 1.8 centos7 hadoop03 192.168.241.20

a308432439的博客 600

Centos7部署CDH6.3.2集群

Centos7部署CDH6.3.2集群 文章目录Centos7部署CDH6.3.2集群一、简述二、环境准备1、硬件:2、软件包下载三、环境初始化1、关闭防火墙2、修改主机名3、配置hosts文件4、配置免密登录5、设置时间同步6、主节点hadoop01部署MySQL5.7第一步:彻底卸载系统原装的MySQL第二步:yum源设置为阿里源第二步:下载配置MySQL的rpm安装包第三步:安装mysql第...

DevinKim的博客 5847

在CentOS7部署Hadoop

Hadoop部署安装教程

qq_66281927的博客 2115

Hadoop集群安装与配置指南(CentOS 7)

【笔记】大数据hadoop环境配置

2401_83769134的博客 2286

Linux Hadoop 2.7.3 集群部署

一、说明:到写本文时间为止,3.0没有发布稳定的版本,所以本文基于2.7.3 系统为centOS ,用 debian核心的linux(比如ubuntu) 基本设置相同,只要把yum换成apt-get,推荐使用更稳定的centOS二、集群部署1、 准备理论实验室没有服务器,我利用自己的电脑和舍友的电脑搭建了1个namenode 7个datanode的分布式集群,虚拟机为VMware Workstat

zslomo的博客 2259

CentOS7搭建Hadoop集群(V3.3.4)

hadoop集群搭建

Button的博客 3070

centos7搭建hadoop

前言 hadoop是其他大数据框架的基础运行环境,尤其是hdfs,是其他大数据框架的基础存储载体,因此学习和掌握hadoop对学习大数据很有必要 haddop常用的3种运行模式包括: 本地模式 ,单机运行,只是用来演示一下官方案例。生产环境不用 伪分布式模式,也是单机运行,但具备Hadoop集群所有功能,一台服务器模拟一个分布式的环境 完全分布式模式:多台服务器组成分布式环境。生产环境使用 本篇将基于centos7系统,在腾讯云环境快速搭建一个单节点的haddop运行环境 前置准备 一台配置好网络连接

congge 1万+

在CentOS7上安装Hadoop分布式系统

全程无失误配置Hadoop分布式系统

m0_53317797的博客 1061

window部署open claw(使用wsl-Ubuntu-docker部署)

本文详细介绍了在Windows 11系统下通过WSL2+Docker部署OpenClaw的完整流程。首先需要满足硬件配置要求并开启虚拟化功能,然后依次完成WSL2安装配置、Docker Desktop安装、OpenClaw镜像拉取等步骤。重点说明了端口映射、socat转发配置及openclaw.json文件修改方法。最后通过验证WSL2内网IP和端口访问服务。该方案具有最佳兼容性,能有效避免Windows环境下的依赖冲突问题。

Kmoyic的博客 2764

ipsec 加密流程(一):ipsec策略匹配

《openswan》专栏系列文章主要是记录openswan源码学习过程中的笔记。 Author: Toney Email: vip_13031075266@163.com Date: 2020.11.22 Copyright: 未经同意不得转载!!! Version:2.6.51.5 Reference:https://download.openswan.org/openswan/ 1. ipsec策略匹配流程(ipsec_tunnel_start_xmit) 注:open...

遇见你是我最美丽的意外 9122

保姆级教程:在CentOS 7上手动搭建Spark 2.4.8集群(含Hadoop 2.7集成与WebUI端口避坑)

本文提供在CentOS 7上手动搭建Spark 2.4.8集群的详细教程,包括Hadoop 2.7集成与WebUI端口避坑方案。从环境准备、关键配置解析到集群资源分配策略,涵盖spark-2.4.8-bin-hadoop2.7.tgz下载安装配置全过程,帮助用户高效部署和调优Spark集群。

weixin_30615767的博客 399

【MATLAB代码】UKF组合导航例程,15维状态量、3维观测量。附完整的代码,有中文注释、误差输出图像

摘要 本文提出了一种基于15维误差状态模型的UKF组合导航算法,实现了三维位置、速度和姿态的高精度估计。算法采用严格的误差状态模型,包含位置(3)、速度(3)、姿态(3)、陀螺偏差(3)和加速度计偏差(3)共15个状态量,通过3维GNSS位置观测进行校正。仿真结果表明,相比纯IMU积分,UKF算法能有效抑制误差积累,显著提高导航精度。文中提供了完整的MATLAB源代码,可直接运行并复现三维轨迹对比、位置/速度曲线及误差分析结果。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 312

CentOS7下Ambari+HDP集群搭建避坑指南:从JDK配置到MySQL元数据存储

本文详细解析了在CentOS 7环境下,从零开始搭建企业级Ambari+HDP大数据集群的完整流程与核心避坑要点。内容涵盖从系统环境准备、JDK配置、本地YUM源构建,到MySQL元数据存储配置、Ambari Server/Agent部署,以及通过Web UI安装HDP服务的全链路实战指南。重点分享了网络配置、软件包管理、数据库连接等关键环节的常见问题与解决方案,旨在帮助运维人员高效、稳定地完成集群部署。

raspberrypi5的博客 189

计算机专业保研攻略(一):个人定位与院校推荐(必看干货)

写在最前 又是一年保研季,作为过来人,我深知保研就是一场信息战。在保研过程中,需要注意的信息太多了,最初我也因为经验不足,走了不少弯路。我写下这篇博客,希望能帮助更多有需要的同学。 怎样做好保研信息分析 我想举几个发生在我身边真实的例子: A同学推免排名不如B同学,但A保研去向比B同学好很多; C同学在年级里成绩并不算突出,但他拿到了最好的offer; D、E同学纷纷圆梦北大、浙大等名校,但是他们的成绩似乎并不突出; F同学取得了目标院校夏令营offer,但没有拿到本校推免资格; G同学认为自己拿不到推免

乔卿的博客 8392

基于STM32、HAL库的TLV320AIC3204IRHBR音频接口芯片驱动程序设计

* 开启所有数字部分 */#define TLV320AIC3204_REG_LEFT_HEADPHONE_OUT_VOLUME 0x0C /* 左声道耳机输出音量 */#define TLV320AIC3204_REG_DIGITAL_AUDIO_PATH_CONTROL 0x05 /* 数字音频路径控制 */#define TLV320AIC3204_REG_ANALOG_HP_FILTER_CONTROL 0x34 /* 模拟耳机滤波器控制 *//* 最大音量 */

corlin6688的博客 522

基于VMware与CentOS 7的Hadoop集群部署全景指南

本文档旨在提供一个全面、细致的Hadoop部署教程,覆盖从基础环境准备到Hadoop伪分布式集群成功运行的每一个环节。内容严格遵循新手友好的原则,对每一步操作、每一条命令以及可能遇到的问题进行深入剖析,确保初学者能够顺利完成部署。整个过程将在VMware Workstation Pro虚拟机环境中,使用CentOS 7.9操作系统进行。第一章:基础环境搭建——虚拟机与操作系统的准备部署任何复杂的系统,一个稳定可靠的基础环境是成功的基石。

2301_80863610的博客 5万+

lammps蒙特卡洛MC模拟案例

在lammps中,和MC相关的模拟命令有三个:fix gcmc、fix atom/swap、fix sgcmc。在一个lammps模拟中,mc和md可同时存在,间隔运行,所以设置fix sgcmc命令的同时,可以同时设置系综(nve、nvt或者npt)。lammps官网自带案例中也有一个fix sgcmc的案例,主要模拟FeCu合金的MC建模。sgcmc命令可应用到合金的模拟中,如短程有序模拟。MC运行间隔为100步,最终的浓度比例为0.02,也就是2%的Fe原子交换为Cu原子。大家好,我是小马老师。

lammps_jiayou的博客 1827

CentOS7搭建Hadoop集群

10、部署完成可以通过start-all.sh和stop-all.sh控制Hadoop-HA所有节点的启停。-- 配置该user(superUser)允许通过代理访问的主机节点 -->-- 把多个NameNode的地址组装成一个集群mycluster -->-- 配置该user(superUser)允许通过代理用户所属组 -->-- 配置该user(superUser)允许通过代理的用户-->-- 指定hadoop运行时产生文件的存储目录 -->-- 配置HDFS网页登录使用的静态用户为user -->

指针先生 3837

【2025软考高级架构师】论文篇——4、论可靠性系统中软件容错技术的应用

软件容错技术对软件的稳定性起着至关重要的作用,尤其是针对互联网性质的软件并发高存在流量峰值等问题,软件容错技术的应用的重要性就不言而喻了。经过这次我所采用的软件容错技术的方法和措施的实施效果后,使我也看到了自己身上的不足之处,我会在今后的架构设计过程中,不断更新自己的知识,不断完善自己的架构设计领域,设计出更好的软件架构,更好的支撑业务平台的运行,提高公司的竞争力,为公司为社会尽一份绵薄之力。

qq837993702的博客 619

华为面试手撕真题【求1-n的最小公倍数】

求1-n的最小公倍数

MISAYAONE的博客 2万+

Linux部署hadoop2.7.7集群

在CentOS7环境下,hadoop2.7.7集群部署的实战

程序员欣宸的博客 7075

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

CentOS-7 Linux 上部署hadoop集群(3台)

本文记载一次在虚拟机上Linux 上部署hadoop集群(3台)

yang_z_1的博客 5196

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

基于CentOS 7的Hadoop-2.7.7集群搭建手册

文章目录1 基于 VMware workstations 的CentOS7安装1.1 安装虚拟机1.2 安装CentOS7操作系统2 Linux系统配置2.1 上传安装包2.2 配置时钟同步2.2.1 查看时间2.2.2 时间不一致的解决办法2.3 配置主机名2.3.1 命令设置主机名永久有效2.3.2 配置文件2.4 关闭防火墙2.4.1 关闭防火墙2.4.2 禁止firewall开机启动2.4...

鲨鱼胃的博客 5347

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

centos7 Hadoop集群部署

centos7 Hadoop集群部署 一、Hadoop环境配置 从0开始构建一套Hadoop大数据平台,CentOS 7.x系统。Hadoop的安装部署都属于java进程,就是启动了JVM进程,运行服务。 HDFS:存储数据,提供分析的数据; NameNode/DataNode YARN:提供程序运行的资源; ResourceManager/NodeManager Hadoop版本:hadoop-3.2.2 192.168.0.47 namenode、datanode、secondary namenod

oToyix的博客 925

记一次 Centos7.6 基于 Hadoop3.x 集群部署 HBase 2.4.0 集群

基本信息 安装部署 [root@master ~]# wget -P /usr/bigdata/ https://mirror.bit.edu.cn/apache/hbase/2.4.0/hbase-2.4.0-bin.tar.gz [root@master ~]# cd /usr/bigdata/ [root@master bigdata]# tar zxf hbase-2.4.0-bin.tar.gz [root@master bigdata]# ll [root@master ~]# cd /us

一花一世界 2772
上一篇: 记一次DataNode节点数据磁盘爆满的问题
下一篇: CentOS7 手动部署Hive1.2.1
lcm_linux
博客等级 码龄7年 7258粉丝 73原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值