你理解的控制LLM幻觉的方法可能是错的

大语言模型LLM解决AI幻觉方法的深度分析 本文深度分析了大型语言模型(LLM)产生AI幻觉的成因机制与解决方案。研究表明,AI幻觉源于数据质量缺陷、训练机制偏差、模型架构局限和推理过程放大四方面因素,形成"概率生成-错误传导"的完整链条。在解决方案上,数据层面通过Concept7数据集等优化技术提升知识覆盖度,模型架构采用Gemini 2.5 Pro的混合注意力机制增强推理能力,动态数据更新和假设验证循环等技术可显著降低幻觉率。当前研究虽取得一定进展,但模型对自身知识边界的识别能力仍有待突破,这将成为未来AI可靠性研究的关键方向 阅读详情

那什么是粗暴的控制LLM的幻觉的方法呢?

正常你们大家学到的应该是

temperature=0

top_k=1

top_p=0.1

类似这种的

但是这种是不是能解决幻觉呢?很显然在做的各位试过,应该是没什么效果的

为什么呢?

正常来讲,我们不是把生成next token的概率放到最大的那个token上了吗?

今天先回忆个概念

LLM是靠什么来决定next_token生成的
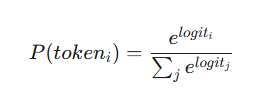
Image

就是Logit,就是softmax你的前向计算的最后一层(这么表达不精确,但是你可以认为就算最后一层了)

Image

过了output之后呢?要和词表做一个矩阵乘,得到一个logit,但是这个不能直接用,需要给softmax转换为对应词的概率,就是我刚才的公式

(不理解transformer架构的兄弟可以参考我以前的博文,草履虫也能学懂得Transformer系列

https://mp.weixin.qq.com/s/Qi9-SqTGk5yHkF0WQ1CdYQ?token=1866303267&lang=en_US

如果志在玩大模型,至少目前Transformer还是绕不开的基础)

1- 为什么temperature要设置低

Image

温度采样是一种基本技术,可控制 token 选择的随机性。它的工作原理是在应用 softmax 函数之前缩放 logits(未归一化的预测分数)

其中:

P(xi)是选择 token 

i
i

 的概率

Z i是选择token 

i
i

 的 logit

T就是温度参数了

较低的温度(T < 1)使分布更加尖锐,倾向于高概率 token。较高的温度(T > 1)会使分布变平,增加选择较低概率 token 的机会。

2- TOP P 和K 呢?

这就不仔细讲了,TOP是核采样,就是排序计算累加概率,知道累加概率超过p剩下的就不要了,然后归一化,从里面选出来

TOPK 不用说了把,选K个归一化

一般的理解认为,如果把上述的设置都设置为最严格的

比如设置topK=0,TOP_P=1, 先把这两个参数废掉

然后temperature=0.0 就应该是绝对无幻觉的答案了

如文章开头说的,事实上是不行的,下面讲一下为什么

    因为LLM还有两个比较关键的概念,当然你也可以说这俩概念是人为加上的,引入这些概念的就是entropix采样:

    Image

    第一个注意力熵entropy:

    理解语言模型中的熵

    在语言模型的上下文中,熵衡量模型预测中的不确定性或随机性。它量化了概率分布在可能的下一个 token 上的分散程度。

    Image

    其中 pi是第 i 个 token 的概率。

    较高的熵值表示模型对下一个 token 不确定,概率分布在许多选项上。相反,较低的熵表示模型更有信心,概率集中在较少的 token 上。

    注意力熵方差 (Varentropy)

    熵方差(Varentropy),或熵的方差,衡量了在单个位置上,不同可能的 token 之间的信息内容(惊奇度)变化有多大。它提供了对模型不确定性和其对给定上下文的预测多样性的洞察。

    熵方差的计算涉及以下步骤:

    步骤 1:计算概率和对数概率

    使用 softmax 计算当前位置上每个可能的 token 的概率,并计算它们的对数概率。

    步骤 2:计算熵

    计算当前位置概率分布的熵。

    步骤 3:计算熵方差

    对于每个可能的 token,计算其信息内容(负对数概率)与平均信息内容(熵)之间的平方差。用它们的概率加权这些差异并将它们加总。

    熵方差在识别模型正在考虑惊奇度水平非常不同的 token 的情况时特别有用。高熵方差可能表明上下文复杂或模糊,模型的预测更加多样化或不确定。

    在采样决策中的意义

    熵和熵方差的组合在 Entropix 的采样策略中起着至关重要的作用。以下是它们如何影响决策过程:

    1. 低熵,低熵方差:表示高置信度和一致性。Entropix 在这些情况下可能会使用贪婪采样。

    2. 高熵,低熵方差:表明一致的不确定性。这可能会触发插入澄清(clarification insertion)或增加探索。

    3. 低熵,高熵方差:表示不同程度的置信度。Entropix 可能会采用探索采样来调查不同的可能性。

    4. 高熵,高熵方差:代表高度不确定性和不一致性。这种情况通常会导致使用调整参数的高不确定性采样。

    在 Transformer 模型中,注意力通常以多头注意力(multi-head attention)的形式实现。这意味着注意力机制并行应用多次,允许模型同时关注输入的各个不同方面。

    Transformer 模型中的每个注意力头计算一组注意力分数,确定在生成每个输出 token 时,要将多少注意力放在输入的不同部分。

    注意力熵用于量化注意力在不同 token 上的不确定性或分散程度。

    较高的注意力熵表示模型的注意力分散在许多 token 上,而较低的熵表示模型专注于少数特定的 token。

    而如果分散在许多token上,也就是所谓的熵分散,代表模型此时根本不知道哪个token更合适

    这个时候你比如temperature=0.0,你是选择了一个所谓概率最高的,但是你其实也限制了模型探索的能力,这也是幻觉可能产生的开始

    注意力一致性 (Agreement)

    注意力一致性衡量不同注意力头之间的注意力模式的一致程度。它通过将每个头的注意力分布与平均注意力分布进行比较来计算

    较低的一致性表明不同的头正在关注输入的各个不同方面,这可能表明上下文复杂或模糊。

    这是第二个引入幻觉的可能性,因为上下文的理解不确认

    我们今天介绍的Entropix 使用这些基于注意力的指标来指导其采样决策。例如:

    • 较高的注意力熵可能导致采样中增加探索。

    • 较低的注意力一致性可能导致温度或 top-k 参数的调整。

    所以大家基本就能看明白了,如果模型不确认哪个token最优,那就增加一些探索的可能性,比如对上下文模糊,那就动态调整模型的配置参数

    交互强度 (Interaction Strength)

    交互强度定义为 Transformer 模型中所有层、头和位置的注意力分数的绝对值的平均值。在数学上,它可以表示为:

    Image

    L代表层数,H是注意力头,N是序列长度,Alhji就是第l层第h头种从位置i到位置j的注意力分数

    较高的交互强度值表示序列中 token 之间存在更强的关系

    交互强度在 Entropix 的自适应采样过程中起着至关重要的作用。它影响采样策略的几个关键方面:

    1. 温度调整:较高的交互强度可能导致温度升高,当 token 之间连接紧密时,促进更多样化的输出。

    2. Top-k 参数:交互强度用于动态调整 top-k 参数,从而根据 token 关系的强度允许更多或更少的候选 token。

    3. 探索与利用:在交互强度较高的场景中,采样策略可能会倾向于更具探索性的行为,以捕获 token 之间复杂的联系。

    说白了,我token之间交互强度高,证明我们之间的注意力更高,需要输出更多元化,人话说就是更多探索路径,来捕捉复杂的注意力

    Image

    下面是entropix的完整采样过程:

    Image

    如上图所示

    数据流和决策过程

    Entropix 系统在文本生成过程中遵循特定的流程:

    步骤 1:Token 生成

    语言模型处理输入 token 并生成 logits 和注意力分数。

    步骤 2:指标计算

    指标计算器基于模型输出计算熵、熵方差、注意力熵、注意力一致性和交互强度。

    步骤 3:策略选择

    自适应采样器分析计算出的指标,并选择最合适的采样策略。

    步骤 4:参数调整

    根据选择的策略和指标,动态调整采样参数(温度、top-k、top-p、min-p)。

    步骤 5:Token 采样

    应用选择的采样策略来选择下一个 token。

    步骤 6:迭代

    从步骤 1 开始重复该过程,并加入新生成的 token。

    采样策略

    Entropix 采样方法的核心是其策略选择逻辑。该系统持续评估模型的输出指标,并为每个 token 生成步骤选择最合适的采样方法。

    Image

    自适应采样

    当 logits 的熵和熵方差没有落入极端类别时(与触发专门采样技术的场景不同),自适应采样策略就会启动。它旨在平衡探索和利用,适应当前的上下文和模型状态

    自适应采样过程

    步骤 1:计算指标

    首先,模型的 logits 和注意力分数中计算各种指标:

    • Logits 熵和熵方差

    • 注意力熵和熵方差

    • 注意力一致性

    • 交互强度

    步骤 2:调整采样参数

    基于这些指标,动态调整采样参数:

    • 温度

    • Top-p(核采样阈值)

    • Top-k

    • 最小概率阈值 (min_p)

    步骤 3:生成多个样本

    使用调整后的参数生成多个候选 token。样本数量是可配置的,默认为 12。(现在不是流行带搜索的中间过程吗,你可以理解为带搜索的token生成

    Image

    )

    步骤 4:样本评分

    每个样本都根据两个因素评分:

    1. 来自模型 logits 的对数概率

    2. 从计算出的指标导出的置信度分数

    步骤 5:选择最佳样本

    得分最高的样本被选为最终输出 token。

    生成多个样本后,每个样本都使用对数概率和置信度分数的组合进行评分:

    def score_sample(sample):    log_prob = jnp.sum(jax.nn.log_softmax(logits) * jax.nn.one_hot(sample, logits.shape[-1]))    confidence_score = (        (1 - metrics["logits_entropy"]) * 0.1 +        (1 - metrics["attn_entropy"]) * 0.2 +        (1 - metrics["logits_varentropy"]) * 0.3 +        (1 - metrics["attn_varentropy"]) * 0.4 +        metrics["agreement"] * 0.5 +        metrics["interaction_strength"] * 0.6    )    return log_prob + confidence_score

    此评分函数平衡了 token 的可能性(log_prob)和从各种指标导出的置信度度量。置信度分数中每个组件的权重可以根据经验结果进行调整。

    现在回到最开始我们说的集中情况来分析:

    1-如果熵和熵方差都非常低时,模型对其预测非常有信心。在这种情况下,使用贪婪采样,说白了模型知道它在干什么,它对自己的答案也足够确认,那就选择概率最高的,就是标准的logit

    2- 如果熵高,但是熵方差低,证明模型是不确定的,但是其不确定性是一致的,所以需要澄清

    这个澄清就是以特殊token的形式

    如果插入了澄清token,那么下一个token就会动态调整temperature,用更高的温度拿到更大的多样性,来进行采样,找到最合理的token!

    其实某种程度上有点像李飞飞的S1的wait token

    3- 另外如果,模型熵很低,证明它很确认,但是熵的方差高,就证明它本身就看到了很多不同的可能性,那采样的temperature就直接升高(基于交互强度指标)就可以了,top k当然也顺手就给升了

    4- 如果熵和熵方差都高,记忆是又不确定,又看到了好多的可能性,那就直接下猛药,但是其实和3的请款一样,也是升temperature,但是是基于熵方差的强度来调整temperature,而不是注意力一致性,另外此时因为熵升高,所以要降低top-p的参数来让它收敛

    Image

    这就是entropix的思路,通过动态的采样参数和澄清token来实现fitting化的采样保证模型的输出更合理化,更少幻觉

    其实entropix的思路在OAI的o系列是有引入类似的概念的

    比如你们使用o系列api就会发现一个申请的问题,temperature和top p k都不允许设置

    原因就是来自于这

    所以大家理解了为什么temperature=0.0和有没有幻觉并没有本质联系的原因了吗?

    基于RAG的幻觉检测方法基准测试 与此类似,光年AI平台通过多模型整合,提供无缝操作的高效功能,可以帮助企业在不同的业务场景中实现流量增长,具体方式可以在光年AI官网了解更多。借助光年AI平台,企业可以自定义AI工作流,并在各种业务场景中实现高效的流量增长,从而优化幻觉检测算法,提高整体决策的准确性和可靠性。在这个基准测试中,TLM 是识别幻觉最有效的方法,紧随其后的是幻觉指标、自我评估和 RAGAS 真实性。每个检测方法接收 {用户查询,检索到的上下文,LLM回应} 并返回一个0到1之间的分数,指示出现幻想的可能性。 阅读详情

    相关推荐

    LLM幻觉控制:从原理到实践的七层技术架构实现99%无幻觉输出

    大语言模型(LLM)幻觉是指模型生成看似合理但实际错误内容的现象,这在金融分析、医疗咨询等关键场景中存在严重风险。幻觉产生的技术根源包括训练数据噪声、概率采样机制和知识截止限制等。通过检索增强生成(RAG)和知识图谱约束等工程方法,可以显著提升模型的事实准确性。在应用层面,结合数据清洗、模型微调和推理时验证的多层技术架构,能够将幻觉率从行业常见的3-15%降低到1%以下。本文基于RAG和模型微调等核心技术,详细拆解了实现高可靠性AI系统的完整解决方案,为生产环境部署提供可直接落地的实践指南。

    weixin_30598225的博客 383

    LLM的幻觉起因、类型以及解决方法

    LLM的幻觉起因、类型以及解决方法

    安静的软件工程师 1797

    彻底告别LLM幻觉!RAGFlow:企业级RAG应用知识库构建的神兵利器

    RAGFlow:一站式企业级RAG引擎解决LLM幻觉问题 摘要: 大语言模型(LLM)在实际应用中存在"幻觉"问题,即生成不准确或虚构内容。检索增强生成(RAG)技术通过结合外部知识库检索来解决这一问题。RAGFlow是由InfiniFlow团队开发的一站式企业级RAG引擎,具有三大核心技术优势:1)智能文档处理引擎,支持多格式解析和基于语义的智能分块;2)高效多模态检索系统,结合Milvus向量数据库实现多路召回与融合;3)灵活的LLM集成,支持主流API和本地私有模型。RAGFlow

    wylee的博客 1153

    LLM幻觉根源解析

    通过上述分析与方案可以看出,虽然 Agent 的幻觉问题难以完全根除,但通过结合 RAG 技术、强化自我反思机制、优化 Prompt 工程以及引入人工审核,可以显著提升 Agent 在复杂任务执行中的准确性和可信度。AI Agent 在完成任务时出现“幻觉”,本质上是其作为核心驱动的大语言模型(LLM)所产生的不可靠输出在复杂任务执行中的具体表现。Agent 通过 RAG(检索增强生成)或 API 调用获取外部信息来减少幻觉,但工具本身的使用过程也会引入新的风险。1. 基础大模型的内在缺陷(数据与机制)

    2501_92368624的博客 584

    LLM幻觉问题深度解析:从原理到99%无幻觉输出的实战方案

    大规模语言模型(LLM)作为自然语言处理的核心技术,其生成机制基于深度学习的概率预测原理。在工程实践中,LLM通过自回归方式逐词生成文本,这种统计特性虽然带来了强大的语言表达能力,但也导致了幻觉问题的产生。幻觉抑制技术的核心价值在于提升模型输出的可靠性和事实准确性,特别是在企业级应用如智能客服、知识问答等场景中至关重要。通过检索增强生成(RAG)等技术框架,结合事实核查和置信度校准机制,可以有效降低模型生成虚构或错误内容的概率。本文聚焦LLM幻觉问题的系统化解决方案,详细解析了从检测到抑制的完整技术路径,为

    weixin_33841503的博客 352

    控制LLM幻觉的四大实战技巧

    在训练数据和过程固定的情况下,控制幻觉的本质是**通过外部引导(提示词)、过程约束(推理策略)、参数调整(解码规则),让模型的输出更贴近“训练数据中的正确关联”,同时抑制“错误关联的高概率输出”**。这些方法无法彻底消除幻觉(因模型底层仍是概率关联),但可显著降低高频幻觉的发生率,尤其适用于事实性问答、专业领域检索等对准确性要求高的场景。 实际应用中,建议结合多种方法(如**“CoT提示+低温度解码+自一致性验证**”)

    ZhangJiqun&191cm&85kg 9598

    迈向可信 AI:LLM 幻觉的分析与优化

    在进入正题之前,我们先初步了解一下LLM的工作原理,有利于后面理解为什么LLM会出现幻觉。LLM的幻觉(Hallucination)现象,即模型生成与事实不符或虚构的信息。例如:在实际应用中,LLM幻觉不只表现在随意“编造”信息,其内容和表现形式多样。细分类型有助于更准确地定位问题,并为后续优化方案提供针对性思路。事实性幻觉(Factual Hallucination):模型输出明确违背客观真实的信息,如“水的沸点是150°C”。

    欢迎来到我的博客 1142

    【LLM】大模型幻觉问题的原因和缓解方法

    一、幻觉定义 备注(下面提及的两个名词): Faithfulness:是否遵循input content; Factualness:是否符合世界知识; 传统nlp任务重,幻觉大多数是faithfulness,比如Intrinsic Hallucination(冲突),摘要内容和document内容有冲突;再比如Extrinsic Hallucination(无中生有),生成内容中包含input要求的其他杂七杂八虚假信息;但LLM应该考虑的幻觉Factualness,因为数据源是Open-doman的世界知

    发现问题,并解决问题,批判性思维 1万+

    【论文阅读 | LLM幻觉】A Comprehensive Survey of Hallucination Mitigation Techniques in Large Language Models

    一篇有关LLM幻觉修正的综述阅读笔记,可以当做文献索引用。

    weixin_62100548的博客 2055

    Pika Labs vs Runway ML:零基础小白如何选择最适合自己的AI视频生成工具?

    本文详细对比了Pika Labs和Runway ML两款AI视频生成工具,从操作界面、生成效果、隐藏成本、工作流适配性和未来兼容性五个维度进行分析。Pika Labs适合零基础用户快速生成社交媒体短内容,而Runway ML则更适合专业级视频制作。帮助用户根据自身需求选择最适合的AI视频生成工具。

    wood5的博客 599

    每天一个优秀提示词学习收藏 - 文本去AI化(四)

    宝子们,今天不藏私啦!我把这段时间四处搜罗、潜心钻研出来的文本去AI化Prompt 提示词大礼包双手奉上,这可都是能让你的 AI 创作水平原地起飞的干货!走过路过不要错过,赶紧码住,开启你的 AI 创作进阶之旅吧!

    2446

    大语言模型LLM中的幻觉

    实话说,想彻底解决这个问题可以说很难很难,在数据收集的时候很多数据我们无法保证它的正确性,就算是当前科学界确认的东西也可能在某方面是不正确的,本身就没有绝对正确的事物,我们都在这个过程中不断的摸索,并找寻最终答案而已。

    红目香薰 660

    PLC期末速成——顺序功能图转梯形图

    一、根据顺序功能图写出梯形图程序 顺序功能图: 梯形图: 1、程序段1,系统运行标志M0.0的启-保-停控制电路。 2、程序段2,PLC上电与逆行,初始化脉冲M1.0激活初始化步M2.0。 3、程序段3,当M2.0初始化步为活动步,并且M0.0系统运行标志位为1时,置位M2.1步,复位M2.0步。 4、当M2.1为活动步,并且I0.3中液位传感器为1时,置位M2.2步,复位M2.1步。 5、程序段5,当M2.2为活动步,并且I0.2高液位传感器为1时,置位M2.3步,复位M2.2步。 6、程序段

    qq_52251819的博客 1万+

    LLM离线幻觉控制:荣格式AI梦境层架构解析

    大型语言模型(LLM)的幻觉现象通常被视为技术缺陷,但最新研究表明,通过受控的离线环境,这些想象输出可以转化为增强模型能力的资源。借鉴荣格的集体无意识理论和神经科学的过拟合大脑假说,研究人员设计了AI梦境层架构,实现严格隔离的受控幻觉生成。该架构包含在线交互层、本地记忆存储和梦境层子系统,通过抽象化提取、去标识化处理等步骤确保安全。技术原理上采用高温采样和噪声注入等机制,在保持事实性检查的同时释放创造力。这种将缺陷转化为资源的方法,为提升LLM的语义多样性、边缘案例覆盖等能力提供了新思路,在诗意生成、对话系

    weixin_30776545的博客 311

    考试遇到 Assistant API 考点时,该掌握哪些要点?

    【摘要】聚焦阿里云大模型 ACP 认证中智能体 Assistant API 考点,我结合自学认证成功经验,分享复习攻略。先解析 assistants、threads 等五个核心组件作用与关系,点明各组件支持及不支持的方法,最后给出计算 Python 代码调用大模型次数的思路,助力考生攻克考点、顺利拿证 。

    davidkorhenn的博客 495

    【计算摄影】相机成像原理:从光到JPEG图像

    本文我们将从最基本的相机成像原理开始论述,再讨论光线进入相机后,经过一系列处理成为JPEG图像的大致流程。

    qq_35149975的博客 2万+

    大模型面试题82:你有什么办法避免LLM输出时的幻觉问题?

    不让瞎猜:限定知识范围,调低温度,告诉AI“不知道就说不知道”;让它查资料:用RAG给AI配“随身小抄”,先检索再回答;说完再核对:让AI标来源,用工具或人工校验。这一套组合拳下来,LLM的幻觉问题就能减少90%以上。

    叫好与叫座虽然不是对立面,但想在同一个作品中达到双重效果很难。 888

    超越防抖:索尼CXD5254GG芯片如何重新定义电子影像稳定

    索尼CXD5254GG芯片通过融合6轴IMU与图像传感器数据,重新定义了电子影像稳定技术。其核心突破在于实时地平线校正、抑制果冻效应和镜头畸变校正,并搭载智能画质控制器提升画面细节。该芯片适用于广播制作、体育娱乐、安防监控和机器人视觉导航等专业领域,提供开箱即用的优化参数配置,大幅缩短开发周期。CXD5254GG不仅实现稳定成像,更通过姿态感知与智能优化,为专业影像应用提供了完整的稳定解决方案。

    致力于lidar应用开发 114

    什么是大模型“幻觉“?大模型为什么有“幻觉”?

    AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

    star_nwe的博客 1738

    把 SAP Event Mesh 讲透:从事件驱动架构到 SAP BTP 落地实践

    摘要: SAP Event Mesh是SAP BTP上的云端消息与事件服务,支持企业构建解耦、弹性的应用架构。它通过异步通信模式(如发布/订阅)解决传统同步集成的痛点,如系统紧耦合、链路脆弱等问题。核心能力包括事件驱动通信、可靠消息投递(支持至少一次送达)、与SAP生态深度集成(如S/4HANA事件扩展)以及混合环境支持。典型场景包括订单处理、库存同步等,发布方只需发出业务事件,订阅方按需消费,避免系统间直接依赖,符合Clean Core理念。两种关键模式为广播式的Publish/Subscribe和定向的

    2007 年 ~ 2025 年,深耕 SAP 技术 18 年 116

    构建基于知识图谱的金融风险关联网络

    在金融领域,风险的识别和管理至关重要。传统的风险分析方法往往只能处理单一维度的数据,难以全面捕捉金融市场中复杂的风险关联关系。构建基于知识图谱的金融风险关联网络的目的在于整合多源异构的金融数据,通过知识图谱的方式清晰地展示金融实体之间的复杂关系,从而更准确地识别潜在的金融风险,为金融机构的风险管理决策提供有力支持。本项目的范围涵盖了从金融数据的收集、预处理,到知识图谱的构建,再到金融风险关联网络的搭建和分析。

    SuperAGI2025 1421

    LLM:语言的模仿大师,而非世界的理解者——对“幻觉”本质与工程边界的再思考

    摘要: 大语言模型(LLM)常被拟人化地比作能“思考”或“创造”的智能体,但其本质是概率预测引擎,缺乏真正的世界认知。这种误读导致应用中产生矛盾:LLM既能展现复杂推理能力,又会犯基本错误。其“幻觉”并非记忆失误,而是统计生成的必然结果。要驾驭LLM,需通过检索增强生成(RAG)、思维链推理(CoT)和情境切换等工程方法,构建外部约束系统,将LLM从语言模仿者转变为可靠工具。核心在于接受其概率本质,以外置逻辑弥补其“世界模型”的缺失,实现可控应用。

    daihaoxin的专栏 490

    C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

    基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

    【大模型幻觉】什么是LLM幻觉,原因及解决办法

    大模型幻觉是当前人工智能领域面临的一个重要挑战,主要表现为大模型产生的错误或不合理输出,包括上下文矛盾、与要求不一致、与事实不符以及荒谬的回答。这些幻觉严重影响了大模型在产业界的应用,其背后的原因多种多样,涉及到训练数据的质量问题、模型设计缺陷、使用方式不当以及提示问题设计不合理等方面。

    m0_46686599的博客 1275

    Data-Structures-and-Algorithm-Analysis-in-Java.pdf

    作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

    IMSL CNL 7.0.0 (x86-64)Crack

    IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

    大语言模型LLM,幻觉现象综述和调研

    来源:深度图学习与大模型LLM 本文约3000字,建议阅读6分钟 本文介绍了一篇关于大语言模型LLM的调研综述。‍‍‍1. 基本信息论文题目:A Survey on Hallucination in Large Language Models链接: https://arxiv.org/pdf/2309.01219.pdf作者:Yue Zhang, Yafu Li, Leyang Cui, Deng...

    数据派THU 561

    SIMATIC S7-1200, S7-1500 PID 控制[手册]

    SIMATIC S7-1200, S7-1500 PID 控制[手册]

    迈向可信AI:LLM幻觉的分析与优化

    导语随着LLM的广泛应用,其生成内容的准确性和可靠性成为AI落地的关键挑战之一。幻觉(Hallucination)现象,即模型生成与事实不符或虚构的信息,不仅影响用户体验,更可能带来实际风险。本文将系统性分析LLM幻觉产生的根本原因,探讨其在实际应用中的优缺点,并结合RAG、SFT、强化学习、思维链、Agent Workflow等技术,提出多维度的优化方案。旨在为构建更可信、可控的大模型应用提供理论基础与实践路径,助力AI迈向更高的可靠性与价值创造。LLM的工作原理简介在进入正题之前,我们先初步了解一下LL

    年轻即出发, 1291
    上一篇: SSI用量子计算来玩AI
    下一篇: 手把手带你理解OpenManus
    周博洋K
    博客等级 码龄9年 2005粉丝 156原创
    评论
    成就一亿技术人!
    拼手气红包6.0元
    还能输入1000个字符
     
     条评论被折叠 查看
    添加红包

    请填写红包祝福语或标题

    个

    红包个数最小为10个

    元

    红包金额最低5元

    当前余额3.43元 前往充值 >
    需支付:10.00元
    成就一亿技术人!
    领取后你会自动成为博主和红包主的粉丝 规则
    hope_wisdom
    发出的红包
    实付元
    使用余额支付
    点击重新获取
    扫码支付
    钱包余额 0

    抵扣说明:

    1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
    2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

    余额充值