VLA 是什么

VLA技术介绍 2023年7月28日,Google DeepMind发布Robotic Transformer 2(RT-2),是一种新颖的模型,可以从网络和机器人数据中学习,并将这些知识转化为机器人控制的通用指令。视觉-语言-动作模型 (VLA)是一种多模态,一些模型专注于通过预训练来改进特定组件。其他模型则旨在开发善于预测低级动作的控制策略。某些 VLA 充当高级任务规划器,能够将长期任务分解为可执行的子任务。过去几年,大量 VLA 应运而生,体现了​​具身智能的快速发展。 阅读详情

VLA 是什么

假设你面前有一台机器人,你对它说一句:

“把桌上的红色杯子递给我。”

对人来说,这句话几乎不用思考。你看一眼桌面,找到那只红色杯子;理解“递给我”意味着不是碰一下,而是要把它拿起来、送过来;然后伸手、抓取、抬起、递出。 在这个过程中,看见、理解、行动几乎是连在一起发生的。

但机器人长期以来并不是这样工作的。

在经典人工智能和机器人框架里,系统通常先通过传感器获取环境信息,再通过内部决策过程选择动作,最后由执行器对外部世界施加影响。AIMA 对智能体的介绍就是这种基本框架:agent 通过 sensors 感知环境,通过 actuators 作用于环境。机器人只是这种一般性框架在现实世界中的一个具体实现。

落到机器人操作任务上,这条链路通常会进一步被拆成几个更具体的部分:先做感知,再做规划,最后做控制。MIT 的机器人操作课程就是围绕 perception、planning 和 control 来组织内容的,因为这是机器人系统最经典、也最工程化的结构。

如果还是刚才那个“递杯子”的任务,传统机器人内部往往会经历这样一条长链条:

  • 先识别桌上有哪些物体,哪个是杯子,哪个是红色

  • 再把“递给我”翻译成一个任务目标

  • 接着规划机械臂该走什么轨迹、怎样避开障碍

  • 最后把规划结果变成电机、关节和夹爪的控制指令

这种做法在工厂等高度结构化环境中非常成功,因为环境固定、物体固定、流程固定,模块化设计稳定、可控,也容易排查问题。

但一旦机器人进入家庭、仓库、餐厅这类更开放的环境,这条链路就开始显得沉重。
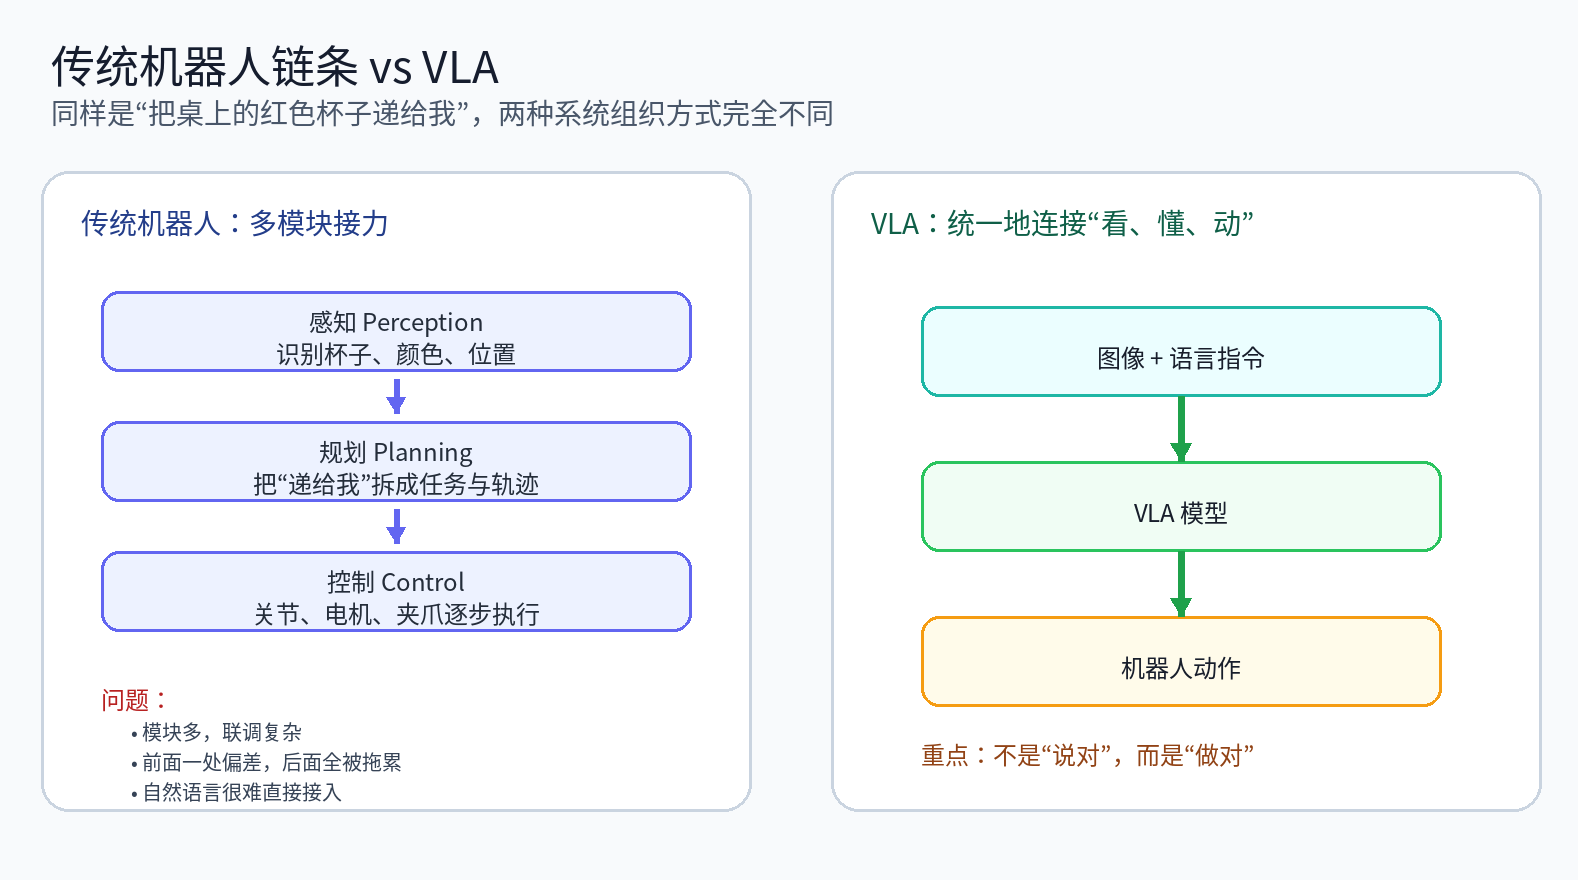
首先,模块太多,系统太碎。 一个在人类看来很自然的动作,机器人却要经过很多独立模块才能完成。每个模块都有自己的输入、输出和假设,结果就是联调成本很高。前面某个环节只要偏一点,后面的环节都可能跟着出问题。MIT 的课程也明确把“如何把这些能力组合起来”当作机器人操作中的核心难题之一。

其次,误差会沿链条传递。 如果视觉模块把杯子的位置看偏了两厘米,规划模块通常并不会知道“前提已经错了”,它仍然会认真规划;控制模块也会忠实执行。最后,机器人可能动作看起来很标准,但就是没抓到杯子。 这正是传统链条最麻烦的地方:每个局部模块都可能“基本正常”,但整体任务仍然失败。

再次,自然语言很难真正接进去。 传统机器人更擅长接收格式化命令,而不擅长处理人类日常语言。对人来说,“把桌上的红色杯子递给我”和“把那个红杯子拿过来”几乎没有区别;但对许多传统系统来说,这往往意味着额外的语义解析、规则设计和任务映射。结果就是,机器人明明有摄像头、有机械臂、有算力,却仍然不像一个真正“听得懂并能动手”的助手。

这正是 VLA 出现的背景。

过去几年里,视觉语言模型取得了非常明显的进展。以 DeepMind 介绍 RT-2 的文章为例,这类模型已经不只是“看图说话”,而是能够把视觉理解和语言理解结合起来,并把这种能力迁移到机器人任务中。RT-2 的核心表述很直接:它接收机器人相机图像和语言指令,直接预测机器人动作。

于是,一个很自然的问题出现了:

如果模型已经越来越会“看”和“懂”,为什么不让它再往前迈一步,直接学会“动”?

这就是 VLA 的基本想法。


  1. 什么是 VLA

VLA 是 Vision-Language-Action 的缩写,可以直译为:

视觉—语言—动作模型

它的核心目标很简单:

把机器人“看到的环境”和“接收到的语言指令”,直接连接到“下一步该执行的动作”。

如果用最简洁的形式来表示,VLA 学习的是这样一种映射关系:

(图像,指令)→ 动作

也就是说,给模型一帧或多帧视觉输入,再给它一句任务指令,模型输出的不是一段解释文字,而是机器人真正要执行的动作。RT-2 的官方介绍就是这种表述方式:把视觉语言模型适配到机器人控制上,并将动作表示成模型可以预测的序列。


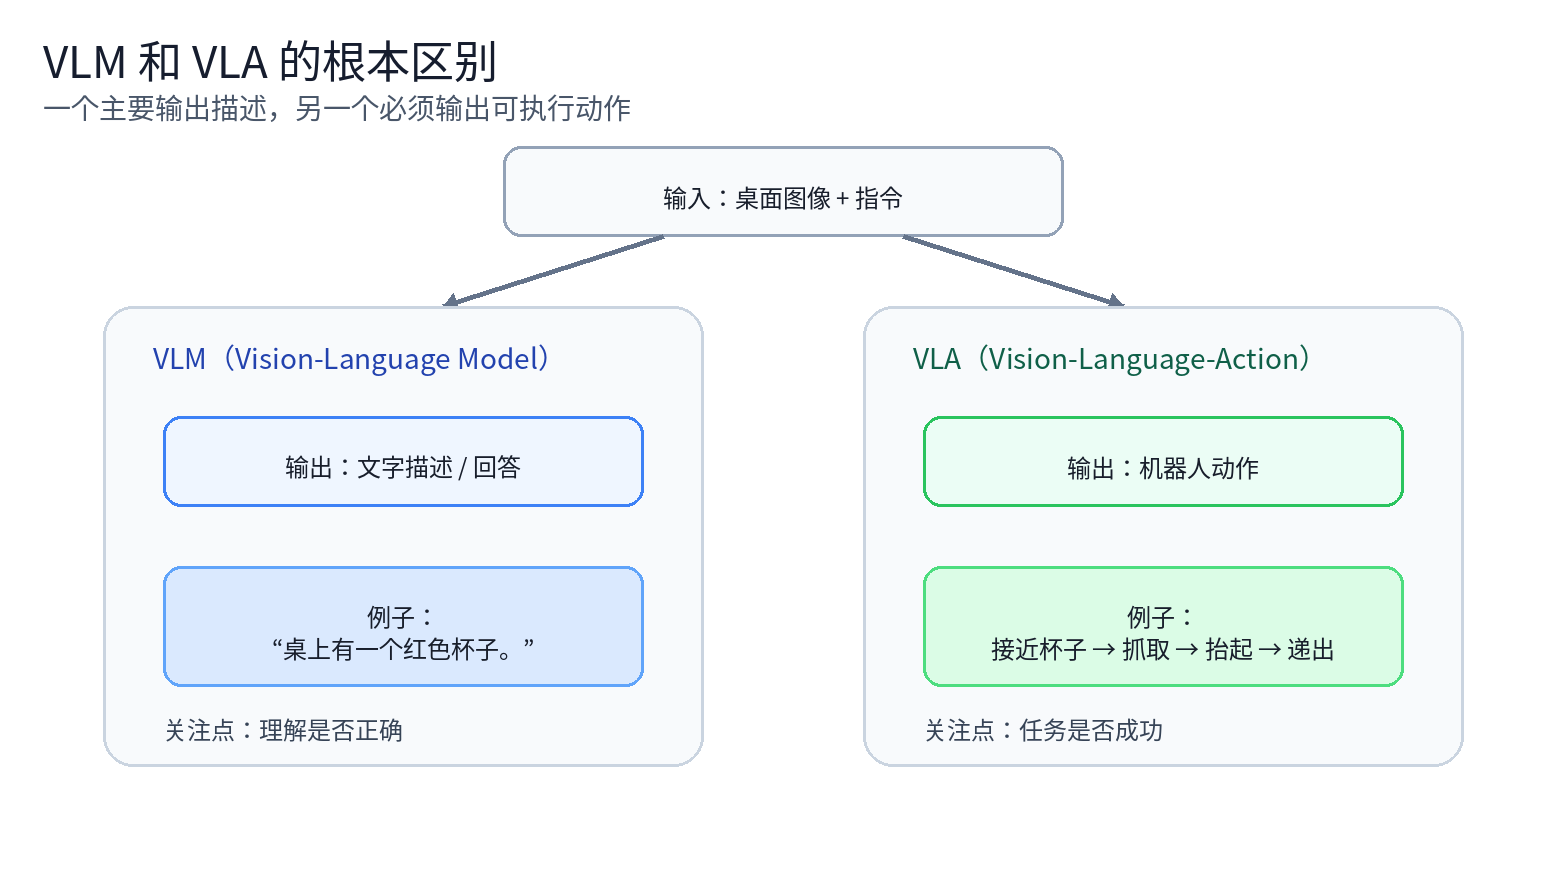
  1. VLA 和 VLM 的根本区别

理解 VLA,一个最直接的方法,是把它和 VLM(视觉语言模型) 做对比。

如果你给一个 VLM 看一张桌面图片,并问它:

“桌上有什么?”

它可能会回答:

“桌上有一个红色杯子。”

这说明它完成的是理解和描述。

但如果你面对的是 VLA,问题会变成:

“把桌上的红色杯子递给我。”

这时系统的目标就不再是“说对”,而是“做对”。

它需要输出可执行动作,让机械臂真的去接近杯子、抓起杯子、再把杯子递出来。

所以可以把两者的差别概括成一句很适合记忆的话:

VLM 的输出通常是描述;VLA 的输出必须是可执行动作。

前者主要回答:“它看到了什么?” 后者必须回答:“它下一步该怎么动?”

这也是为什么 VLA 比普通视觉语言模型更难。 因为它不只是接受语言正确性的检验,还要接受物理世界的检验:抓没抓住、放没放稳、动作快不快、系统稳不稳。


  1. 这里的“动作”到底是什么

对初学者来说,一个很重要的问题是:

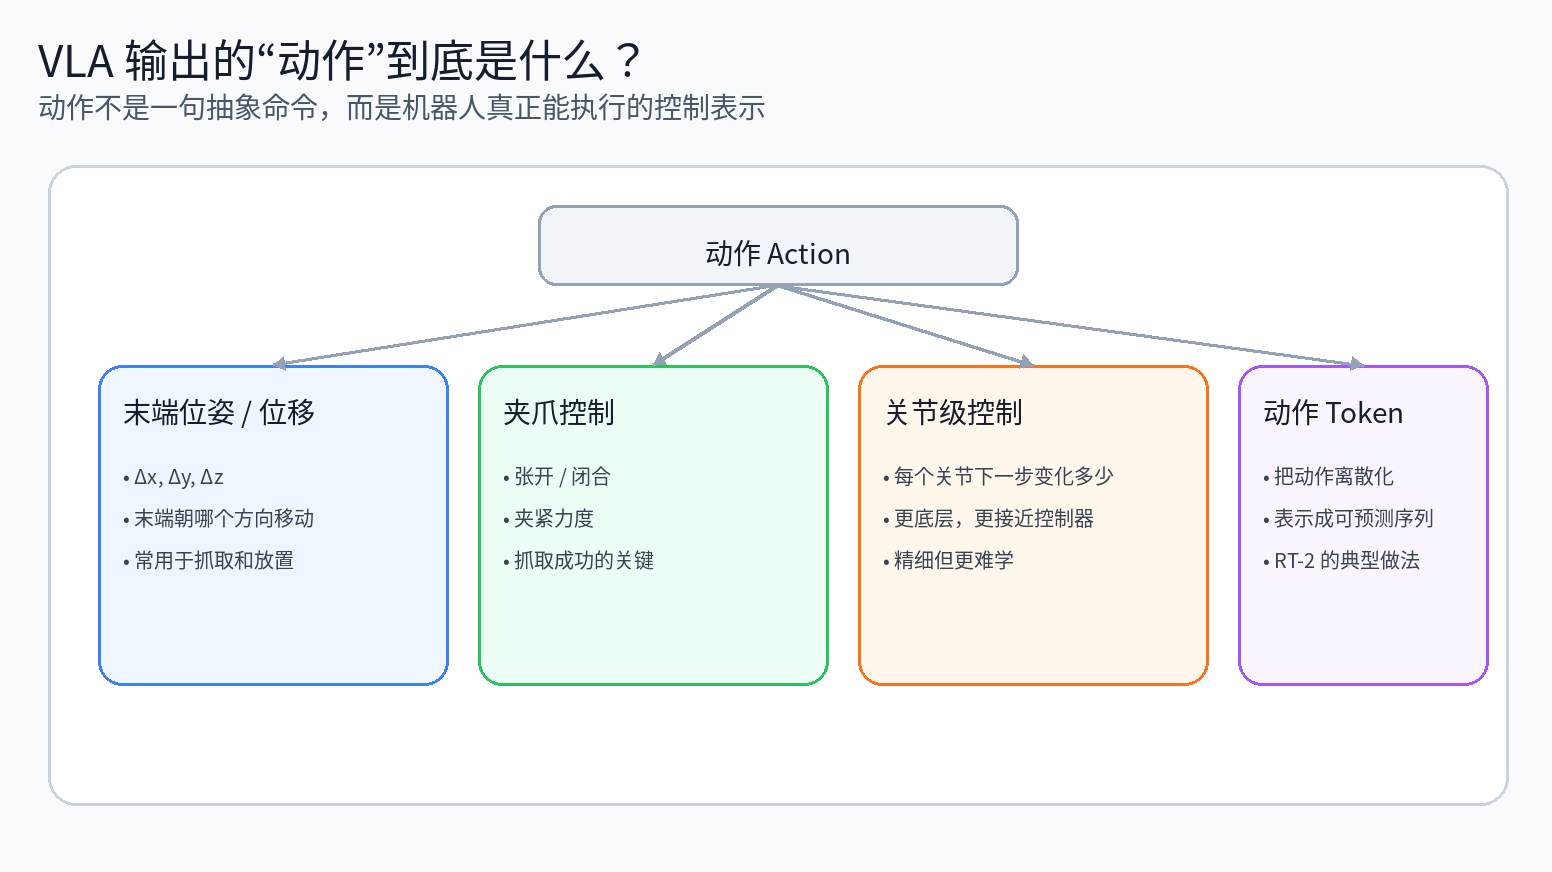
VLA 输出的“动作”,到底是什么?

这里的动作不是一句抽象的中文描述,比如“去抓杯子”;它必须是机器人真正能执行的控制信号。不同系统里,这种动作的表示方式可能不同,常见形式包括:

  • 机械臂末端向哪个方向移动多少

  • 夹爪是张开还是闭合

  • 各个关节下一步应该变化多少

  • 或者把动作离散化成一串可预测的 token

RT-2 就采用了把动作离散化并表示成 token 序列的方法,这样它可以沿用大模型擅长的序列预测范式来生成机器人动作。

所以,“动作”这个词在 VLA 里并不是泛泛而谈的任务意图,而是机器人可以直接执行的低层或中层控制表示。


  1. VLA 是从哪里来的

VLA 并不是突然冒出来的新名词。更准确地说,它是两条技术路线逐渐汇合后的结果。

第一条路线,来自机器人策略学习。 机器人研究一直在尝试让模型直接从观测学到动作,也就是尽量减少手工规则和复杂中间表示,让系统直接学习“看到什么,就怎么动”。

第二条路线,来自视觉语言模型的发展。 随着多模态模型越来越擅长同时理解图像和语言,研究者开始意识到:如果一个模型已经能较好地处理“看”和“懂”,那么让它进一步参与动作生成,就是一件很自然的事。近年的 VLA 综述也基本按这个脉络来描述这一方向。

所以,VLA 可以理解为这两条路线的交汇点:

一边是机器人学习长期追求“从观测到动作”的直接映射; 另一边是多模态大模型不断增强“看图像、懂指令”的能力。 VLA 把这两者连接了起来。


VLA 不是一个凭空冒出来的新词,它背后其实是机器人研究在近几年经历的一次非常自然的“合流”。

如果把时间线往前拨一点,你会发现,在 2022 年之前,机器人领域已经在做两件彼此接近、但还没有完全合在一起的事。

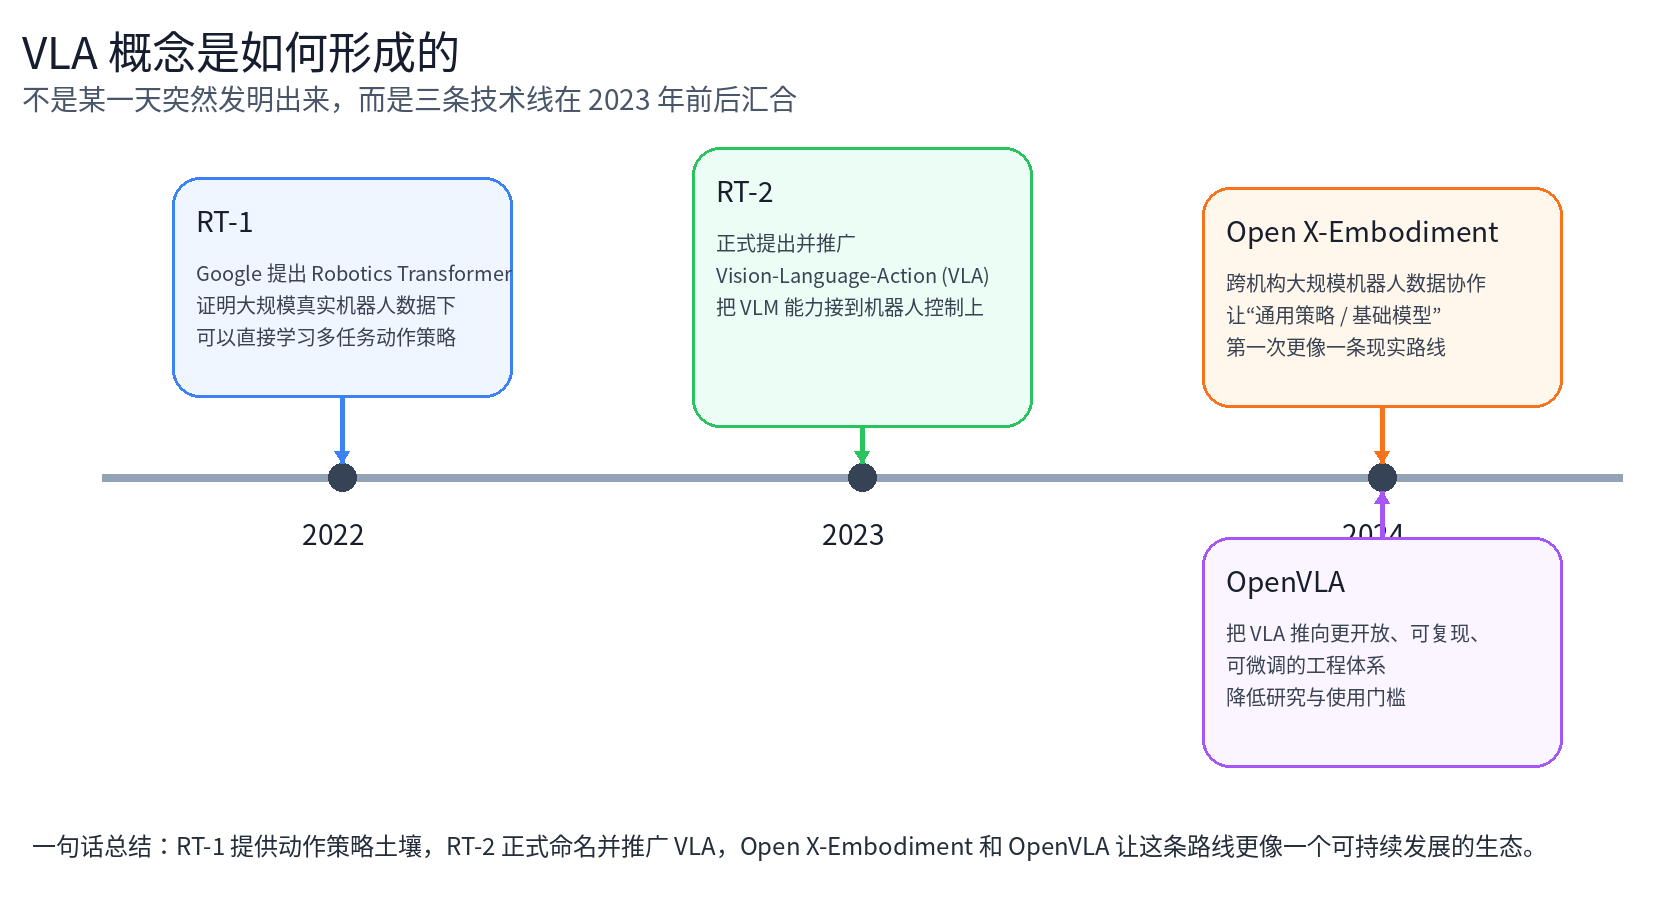
第一件事,是让机器人直接从观察学动作。 例如 2022 年 Google 提出的 RT-1(Robotics Transformer),就已经在做一件很关键的事:把图像、语言指令和动作都表示成序列,让模型直接学习“从观察到动作”的映射。RT-1 的重点是证明:如果机器人数据足够多、模型足够大,端到端的动作生成策略是可以在真实世界里扩展起来的。换句话说,RT-1 已经非常接近后来 VLA 的核心形态了,只是那时大家还没有把这类模型统一叫做 VLA。

第二件事,是视觉语言模型在 2022–2023 年迅速成熟。 这一时期,多模态模型已经越来越擅长“看图像 + 懂语言”。它们能回答视觉问题、理解物体关系、执行语言指令,甚至展现出一定的推理能力。于是机器人研究者开始意识到:如果这些模型已经这么会“看”和“懂”,那下一步最自然的方向,就是让它们进一步参与“动”。

真正把这两件事明确连起来、并且把 “Vision-Language-Action” 这个名字正式打出来的,是 2023 年的 RT-2。
RT-2 的论文标题就非常直接:

RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control

在这篇论文里,作者写得很清楚:他们希望把在互联网规模数据上训练出来的视觉语言模型,直接接入端到端机器人控制;为了让自然语言输出和机器人动作进入同一个统一框架,他们把动作也表示成文本 token,并明确说:他们把这一类模型称为 vision-language-action models(VLA)。这不是后人总结出来的标签,而是 RT-2 论文正文里作者自己给出的命名。

所以,如果你问:

“VLA 这个概念是谁明确提出来的?”

比较稳妥、也最符合主流文献的说法是:

在当前主流机器人基础模型文献中,VLA 这个类别是由 2023 年 Google DeepMind / Google Robotics 的 RT-2 论文明确命名并正式推广开的。

这里要注意一个细节。 如果非常严格地说,“VLA 的技术雏形”并不是从 RT-2 才开始,因为 RT-1 以及更早的一些机器人策略学习工作,已经在做“图像/状态到动作”的端到端学习了。但 RT-2 的重要性在于,它第一次把“视觉 + 语言 + 动作”作为一个统一类别明确讲出来,并把它和大模型时代的 VLM 预训练直接联系起来。 这一步,才让 VLA 从“若干相似工作的集合”变成了一个被广泛讨论的明确方向。


为什么偏偏是在 2023 年前后,大家突然开始认真做 VLA?

因为到那个时间点,几个条件刚好同时成熟了。

第一,视觉语言模型已经足够强。 如果模型还停留在“只能识别图片里有什么”的水平,那它很难承担机器人任务。但到了 RT-2 那个阶段,研究者已经看到了一个新可能:模型不仅能理解图像和指令,还能把从网页和图文数据里学到的语义知识迁移到机器人操作中。RT-2 论文和官方介绍都把这一点说得很明确:它的目标就是把 web-scale 的视觉语言知识迁移到 robotic control。

第二,机器人领域开始拥有更大规模、更多样的数据。 机器人一直有一个老问题:真实世界数据太贵、太慢、太难采。没有足够的数据,就很难像语言模型那样做“规模化学习”。到了 2023 年,Open X-Embodiment 这类大规模协作数据集开始出现,汇集了 20 多家机构、22 种机器人本体、100 多万条真实机器人轨迹。它的重要意义不只是“数据更多了”,而是它让研究者第一次比较认真地看到:机器人领域也许真的可以走向 foundation model / generalist policy 这条路。

第三,大家已经越来越不满足于“会说不会做”的模型。 视觉语言模型可以很好地描述世界,但机器人面对的是另一个更苛刻的问题: 它不能只说“我知道杯子在哪里”,它必须真的把杯子拿起来。 这就是为什么 VLA 会在具身智能里变得特别有吸引力。它不是把 VLM 再包装一层,而是试图把“理解能力”直接推进到“执行能力”。


所以,VLA 这个概念到底是怎么形成的?

可以把它理解成一个三步过程。

第一步:机器人领域先有了端到端动作策略的土壤。 RT-1 这类工作说明,机器人可以把图像、语言和动作统一到一个序列预测框架中,直接学习多任务控制。

第二步:多模态大模型成熟了。 视觉语言模型开始具备强大的图像理解和指令理解能力,这让研究者第一次认真考虑:能不能把这种“看懂 + 听懂”的能力直接接到机器人控制上。

第三步:RT-2 在 2023 年把这件事正式命名为 VLA。 它不仅做了一个模型,还把这类模型归纳成一个新的类别: Vision-Language-Action models。后来 2024 年的 VLA 综述也明确回顾说:最初的 VLA 概念,就是指把 VLM 适配到机器人任务上的模型。

从这个角度看,VLA 并不是“某一天被突然发明”的,而是:

机器人端到端控制、视觉语言模型、多机器人大规模数据,这三条线在 2023 年前后交汇后,被 RT-2 正式命名并推向了舞台中央。


后来为什么 OpenVLA 会重要?

因为 RT-2 虽然把 VLA 这个方向打响了,但它本身是一个偏封闭的体系。 到了 2024 年 OpenVLA,研究者开始进一步推动这条路线走向开放和可复现。OpenVLA 论文的表述很直接:它要解决的问题之一,就是现有 VLA 大多封闭、外界难以使用,以及如何高效微调到新任务还没有被充分探索。也就是说,OpenVLA 的意义不是重新发明 VLA,而是把 VLA 从“一个很强但较封闭的研究方向”,推进到“一个更开放、可训练、可迁移的工程体系”。

  1. 为什么很多人重视 VLA

VLA 之所以受到关注,不是因为它只是多了一个新缩写,而是因为它代表了一种很重要的趋势:

让机器人系统从高度分段、强模块化的设计,逐渐转向更统一、更数据驱动的任务学习方式。

这里要特别注意,VLA 并不意味着传统的 perception–planning–control 会立刻消失。事实上,很多当前系统仍然是混合式或层级式的:高层负责理解任务、分解目标,低层仍然依赖传统控制器或运动规划器。相关综述也明确指出,今天很多具身系统仍在不同程度上保留层级结构。

但 VLA 仍然重要,因为它至少带来了三个清晰的变化方向:

  • 更自然地接入人类语言

用户不再需要把任务写成机器格式的命令,而可以更自然地说出意图。模型的目标,是尽量把日常语言和机器人动作连接起来。

  • 更少依赖硬模块边界

传统系统的一个问题,是信息在模块之间传递时容易丢失、扭曲,或者被早期误差拖累。VLA 的潜在优势,是用更统一的学习框架减少这种硬边界带来的误差传播。

  • 更强调“任务有没有完成”

传统方法常常分别优化局部指标,比如检测准不准、轨迹平不平;而 VLA 更自然地把重点放在整体任务上:杯子有没有拿起来、门有没有打开、动作是否稳定。RT-2 这一类工作也正是沿着“把高级语义能力接到真实机器人任务上”的思路推进。

具身智能中 VLA 主流方案 本文详细总结了具身智能中 VLA 的主流方案,包括基于经典 Transformer 结构、预训练 LLM/VLM、扩散模型、LLM + 扩散模型、视频生成 + 逆运动学以及不同类型的端到端方案。通过对各方案的开源项目和核心思想的介绍,对比了它们在模型架构、动作类型、训练目标等方面的特点,得出了相应的结论共识。同时,探讨了 VLA 面临的数据稀缺、运动规划、实时响应、多模态融合、泛化能力、长时域任务执行、基础模型、多智能体协作以及安全伦理等挑战,并展望了未来的发展方向。 阅读详情

相关推荐

【RL in VLA】VLA中的强化学习

本文提出了一种名为 Reinforcement Learning Distilled Generalist(RLDG) 的方法,通过强化学习生成高质量训练数据来微调机器人基础模型。通过在多个精确操作任务上的实验,我们证明了 RLDG 在成功率和泛化能力上显著优于使用人类演示的传统微调方法。RLDG 不仅减少了对人类演示数据的依赖,还展示了在复杂多阶段任务中的灵活性和有效性。

三木今天学习了嘛の博客 2257

VLA模型

主要介绍了目前的VLA大模型

wm199的博客 4482

解释VLA和具身智能之间的关系

视觉-语言-动作(Vision-Language-Action,VLA)模型是指能够同时处理视觉和语言输入,并产生动作输出的模型,用于在物理环境中完成任务 ()。换句话说,VLA 模型将计算机视觉对环境的感知、自然语言对指令的理解,与动作控制结合起来,直接从图像/视频和文本推断机器人应该执行的操作 ()。这一多模态能力使机器能够“看”,能够“读/听”,并能够“动”,从而在开放环境下完成复杂指令。

qq_50857609的博客 2327

iRe-VLA——RL微调VLA:先SFT、后在线RL,最后结合“离线演示和在线成功数据”对VLA做SFT(含GRAPE的详解)

过去的这两年,工作之余,我狂写大模型与具身的文章,加之具身大火,每周都有各种朋友通过优快云私我帮忙:要么是做科研想复现,要么是工厂想做自动化生产线的智能升级,要么是想通过机械臂/人形解决各种业务场景问题让我感慨:二零一一年,因为算法,首次有「天下无人不识君」的感觉,过去这两年,因为大模型和具身机器人,再次有了这感觉具身的论文解读过很多之后,便会发现整个具身的技能图谱大概如下所示(建议按照从下至上的顺序看)其中,action head有基于LSTM的基于diffusion model的。

结构之法 算法之道 1万+

VLA技术论文阅读

背景生成式人工智能和多模态基础模型的快速发展在推进机器人操纵方面显示出巨大的潜力。特别是视觉语言动作(VLA)模型。现有测试方法的不足然而,当前的VLA模型通常使用有限的一组手工制作的场景进行评估,这使得它们在各种场景中的总体性能和鲁棒性在很大程度上没有得到探索。为了解决这一差距,我们提出了VLATest,这是一个模糊框架,旨在生成用于测试VLA模型的机器人操作场景。实验基于VLATest,我们进行了一项实证研究,以评估七个代表性VLA模型的性能。

weixin_42690036的博客 867

VLM,VLA,VLN的区别与联系

VLM 提供了理解世界的“眼睛和大脑”,VLN 赋予了这个智能体在空间中“移动的双腿”,而 VLA 则进一步赋予了它“灵巧的双手”来改变世界。三者共同构成了一个完整具身智能体的核心能力模块。

l0409044222的博客 1314

VLA模型与OpenPi

VLA 模型是“视觉-语言-动作”(Visual-Language-Action)模型的缩写。这是一种能够结合视觉、语言和动作信息的先进人工智能模型,专门设计用于机器人技术。openpi 是一个专注于机器人技术的开源项目,由 Physical Intelligence 团队发布。该项目包含了一系列先进的模型和工具包,旨在推动机器人技术在具身智能和空间智能领域的发展。π₀ 模型是一个基于流的扩散视觉 - 语言 - 动作模型(VLA)。

weixin_42396076的博客 2314

强化学习和VLA怎么结合?

摘要:强化学习与视觉语言动作模型(VLA)的结合,通过多阶段任务分解、在线策略优化和安全探索机制,显著提升机器人操作能力。VLA提供任务理解和初始策略,强化学习则优化动作细节和适应新场景。典型方法包括GRAPE框架的任务分解、VLA-RL的多模态交互建模,以及ConRFT的实时微调技术。该方向面临数据效率、安全性等挑战,当前解决方案通过预训练模型初始化、人类干预约束和多模态编码优化取得突破,在复杂任务中成功率最高提升144%,操作时间缩减近半。(149字)

CyberSoma的博客 1188

关于 VLA,它有问题,但也不是一无是处

关于 VLA 的影响、好处和坏处。

GKxx 3814

【阿里云大模型高级工程师ACP习题集】2.7 通过微调增强模型能力 (下篇)(⭐️⭐️⭐️ 重点章节!!!)

【摘要】这是我精心整理出对应的习题集,里面足足有 30 道题目,从基础概念到深度拓展,全方位覆盖章节重点、难点。不管你是想检验自己的学习成果,还是想针对薄弱环节进行强化训练,它都能完美适配!

davidkorhenn的博客 1118

低速信号设计之 LPC 篇

摘要:LPC总线作为服务器低速信号设计的关键技术,在BIOS芯片连接、Super I/O芯片控制和嵌入式管理等方面发挥着重要作用。其采用33MHz时钟频率和4位并行传输机制,理论速率达16.5MB/s。设计时需重点关注布线长度(建议<10cm)、信号完整性(45°走线、合理层间隔离)和过孔优化等要点。典型应用案例表明,通过规范设计可确保在工业控制等复杂环境中稳定工作。LPC总线凭借低成本、低引脚数和良好兼容性,仍是服务器低速外设连接的重要解决方案。

qq_16237389的博客 1166

VLA概述

1.传统的机器人决策系统有很强的规则性,没有很好的泛化性。2.VLA就是从给定的视觉和文本信号,去产生相应的动作信号并驱动机器人去执行3.整体流程4.主体要素4.1对于视觉信号而言,最常见的就是ViT4.2对于语言信号而言,最常见的就是基于LLaMA,ChatGPT等大模一些发展。4.3动作模型:Diffusion Policy等6.视觉发展历程6.1Transformer这种模型是具有更强的泛化性,并且其skills要高于CNN。

2201_75538301的博客 1620

告别手动复制粘贴:3种高效合并Excel表格的方法对比(含代码)

本文对比了VBA、Power Query和Python三种高效合并Excel表格的方法,并提供了可直接运行的代码。针对不同数据量、更新频率和技术背景,详细分析了各方案的优缺点与适用场景,帮助读者告别低效的手动操作,实现自动化数据整合。

weixin_29057237的博客 442

分层端到端VLA和纯端到端VLA有什么区别?

这类端到端的范式依赖于先前广泛的研究先验,通过不同架构(diffusion/ transformer/dit),不同的模型大小,不同的应用场景(2d/3d),不同的任务需求(从头训/下游微调),产生了各类不同的方案,取得了不错的性能。无论是显示端到到VLA,还是隐式/分层端到端VLA,其中涉及到的模块、细节众多。隐式端到端VLA,则不同于前者,更加关注工作的可解释性,旨在利用当前的video diffusion模型实现未来状态的预测,再根据未来的状态通过逆运动学规律生成未来可执行的动作。

CV_Autobot的博客 1428

告别屏幕闪烁:手把手教你用示波器抓取并分析MIPI DSI信号(以RK平台为例)

本文详细介绍了如何利用示波器抓取并分析MIPI DSI信号,以解决LCD屏幕闪烁、花屏等问题。以RK平台为例,从工具准备、示波器参数配置到信号捕获与波形解读,提供了一套完整的调试方案,帮助硬件工程师快速定位和解决显示接口信号完整性问题。

weixin_33704591的博客 654

【Qt笔记】1.VSCode搭建Qt运行环境

Qt6之后已经抛弃qmake,使用cmake。cmake相对qmake来说只有优点没有缺点。使用VSCode搭建完Qt的运行环境就能开开心心debug了.vscode需要使用的插件:2.Qt tools3.CMakec++插件可以不关注,缺啥都会提醒你.正常安装即可。

没有手牌的博客 2万+

从VLA到VLM——VLA-0

本文重构了VLA-0的训练框架,可提升20倍训练速度。

W_extend的博客 788

数字IC笔记-低功耗技术

传统的降低Power的方法主要有: 1.门控时钟技术(clock gating) 2.多阈值电压技术(MultiShreshold) 3.动态电压频率调节技术(DVFS) 目前有以下几种低功耗技术: 1.多电压技术(Multi-Voltage) 2.MTCOMS Power Gating 技术(多阈值功耗控制技术),比如基带部分中的2G、3G、CDMA、LTE等通过awake—>sleep—>awake的方式间歇式的打开或关断其电源,power gating 可以完全关掉dynamic的pow

sinat_41774721的博客 1932

VLA-Adapter:一种适用于微型 VLA 的有效范式

关键词:具身智能;VLA。

VLyb 1424

2.3 MMU Notifier(上):KVM 催生的页表变化通知

探讨了MMU Notifier机制的作用及其在虚拟化等场景中的应用。当CPU页表发生变更(如munmap、页面迁移等操作)时,需要通知拥有"第二套页表"的子系统(如KVM的EPT/NPT、IOMMU、GPU等)失效其映射。MMU Notifier通过订阅-通知机制实现这一功能,核心数据结构包括mmu_notifier订阅对象和回调接口mmu_notifier_ops。当CPU页表修改时,通过mmu_notifier_range描述变更范围,调用订阅者的回调函数进行同步,确保外部MMU与CPU页表一致性。

图形/计算GPU的驱动与虚拟化技术分享园地 1037

基于 Qt C++ 的智能工厂数字孪生系统

你想要实现一个基于 Qt C++ 的智能工厂数字孪生系统,核心是 **Qt 3D** 场景搭建 + **实时数据驱动** 设备模型。下面我将为你提供一个完整的解决方案,包含 **核心思路、实现步骤、完整代码示例** 和 **注意事项**。| **渲染层** | 3D 场景搭建、设备模型加载、实时动画渲染、用户交互。| **业务逻辑层** | 数据处理(滤波、转换)、设备状态管理、动画逻辑控制。| **数据层** | 实时采集设备数据(如传感器、PLC、MES 系统),提供数据接口。

寒寒豆豆软件公司的博客 193

Robotic Manipulation VLA 综述

机器人操纵作为机器人学与具身人工智能的重要前沿,要求精确的运动控制以及在动态环境中对视觉与语义线索的整合性理解。机器人操控在许多领域具有广泛应用价值,包括先进制造、智能物流、精密医疗和多功能家务服务等。传统方法基于预先定义的任务规格与刚性的控制策略,这些方法在非结构化的真实环境中会明显失效——尤其面对新物体、含糊的自然语言指令或未见过的场景布局时——从而暴露出其在可扩展性与泛化能力上的固有局限。

2401_83634908的博客 1323

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

VLA-OS:NUS邵林团队探究机器人VLA做任务推理的秘密

近期,新加坡国立大学邵林团队发表了一项突破性研究 VLA-OS,首次系统性地解构和分析了机器人 VLA 模型进行任务规划和推理,进行了任务规划表征与模型范式的统一对比。本文第一作者为新加坡国立大学博士生高崇凯,其余作者为新加坡国立大学博士生刘子轩、实习生池正昊、博士生侯懿文、硕士生张雨轩、实习生林宇迪,中国科学技术大学本科生黄俊善,清华大学本科生费昕,硕士生方智睿,南洋理工大学硕士生江泽宇。本文的通讯作者为新加坡国立大学助理教授邵林。为什么机器人能听懂指令却做不对动作?

欢迎来到我的博客 1251

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

无人驾驶的VLA 和具身智能的VLA,VLN有什么区别和联系?

a) VLN:基础试验场目标:在受限环境中,验证“语言指挥视觉导航”这一核心范式的可行性。场景:仿真的室内环境(如R2R, Habitat)。任务:根据一句具体的指令,执行一组离散动作到达终点。本质:一个研究导向的基准任务。b) 无人驾驶VLA:垂直领域王者目标:解决真实世界中最复杂、最危险的单一连续控制问题——驾驶。场景:开放、动态、高风险的公共道路。任务:全栈驾驶(感知、预测、规划、控制),语言输入可能是高层导航点或安全规则。本质:一个任务特定、安全至上、产品化的复杂系统。

l0409044222的博客 1168

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

什么是VLA?从 ICLR 2026看VLA的研究趋势

本文总结了 视觉-语言-动作模型在ICLR 2026 上的研究现状:什么“算作”VLA、当前VLA领域的研究热点(离散扩散、具身推理、新分词器等)、如何解读VLA研究中的基准测试结果,以及一个被模拟排行榜掩盖的“前沿差距”

青年AI研究员idea加油站,AI开发者的新能源充电桩。 1719
上一篇: C-PHY与D-PHY差异
下一篇: Gemini3 提示词
norlan_jame
博客等级 码龄16年 4568粉丝 63原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值