我用Python爬取了《安家》所有数据,分析后发现它背后的一些秘密

【深度学习】Python爬取豆瓣实现影评分析 Python爬取豆瓣 阅读详情

最近最火的电视剧,非《安家》莫属了。这是一部讲述房产中介的故事,有一个中介公司叫做“安家天下”,其中有两个店长,在剧情设定方面,我们就知道,这中间肯定会发生一些有(gou)趣(xue)的故事。因此我用Python爬取了豆瓣《安家》下所有的评论,进行了一波分析,从观众的角度来了解这部电视剧。

Part.1 爬虫部分

先来讲下技术栈,这个项目我用的是Scrapy+JSON的方式实现的。技术难度并不复杂,毕竟豆瓣并不是一个反爬虫很厉害的网站(学爬虫基本上都做过爬取top250),只要设置好User-Agent就行。在这里我就大概的描述一下代码过程,想要代码的可以在评论区评论“安家”,获取。
第一步通过Scrapy命令创建一个项目和爬虫:

scrapy startproject anjia_scrapy
cd anjia_scrapy
scrapy genspider anjia "douban.com"

然后开始编写爬虫。爬虫部分可以分开来讲一下,首先找到《安家》的评论页面的链接:https://movie.douban.com/subject/30482003/reviews?sort=time&start=0,这个链接是通过offset来获取评论的,每一页展示20条评论,因此如果要获取下一页的数据,就是设置在当前页面基础上,给start+20就行了,这是第一点。然后总共有38页(后续页数据没有)因此可以生成一个range(0,760,20)了。

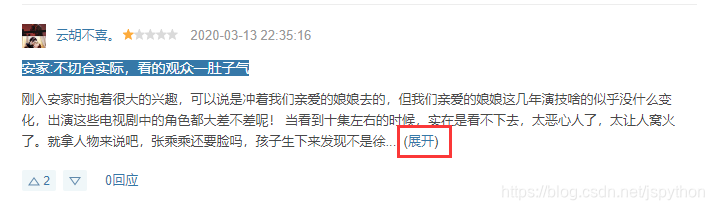
第二点是评论内容数据,如果超过一定的字数是会隐藏的,看下截图:
在这里插入图片描述
他的这个展开操作,并不是直接在界面上显示一下而已,而是发送了一次网络请求,因此我们还得针对每条评论重新请求一次,链接为:https://movie.douban.com/j/review/12380383/full,其中review后面的是这个评论的id,id可以在源代码中获取,这里就不再赘述了。

搞清楚了以上两点,我们就可以开始写代码了(数据提取规则这里不展开来讲,有兴趣的可以在评论区评论:安家获取源代码):

class AnjiaSpider(scrapy.Spider):
    name = 'anjia'
    allowed_domains = ['douban.com']
    start_urls = ['https://movie.douban.com/subject/30482003/reviews?sort=time&start=0']

    def parse(self, response):
        # 获取评论标签列表
        review_list = response.xpath("//div[contains(@class,'review-list')]/div")
        for review_div in review_list:
            # 作者
            author = review_div.xpath(".//a[@class='name']/text()").get()
            # 发布时间
            pub_time = review_div.xpath(".//span[@class='main-meta']/text()").get()
            # 评分
            rating = review_div.xpath(".//span[contains(@class,'main-title-rating')]/@title").get() or ""
            # 标题
            title = review_div.xpath(".//div[@class='main-bd']/h2/a/text()").get()
            
            # 是否有展开按钮
            is_unfold = review_div.xpath(".//a[@class='unfold']")
            if is_unfold:
                # 获取评论id
                review_id = review_div.xpath(".//div[@class='review-short']/@data-rid").get()
                # 获取内容
                content = self.get_fold_content(review_id)
            else:
                content = review_div.xpath(".//div[@class='main-bd']//div[@class='short-content']/text()").get()
            if content:
                content = re.sub(r"\s",'',content)
            # 创建item对象
            item = AnjiaItem(
                author=author,
                pub_time=pub_time,
                rating=rating,
                title=title,
                content=content
            )
            yield item
        # 如果有下一页
        next_url = response.xpath("//span[@class='next']/a/@href").get()
        if next_url:
            # 请求下一页的数据
            yield scrapy.Request(response.urljoin

Python 爬虫和数据分析实战 课程介绍 本课程是 Python 爬虫和数据分析项目实战课程,主要分 3 部分: 第 1 部分是 Python 爬虫,主要使用 Urllib 3 和 BeautifulSoup 抓取天猫商城和京东商城胸罩销售数据,并保存到 SQLite 数据库中; 第 2 部分是对抓取的胸罩销售数据进行数据清洗,主要是去除空数据,让数据格式更规范; 第 3 半部分利用 Pandas 对数据进行分析,以及使用 M... 阅读详情

相关推荐

用python3爬取天猫商品评论并分析(1)

  在上一篇文章我们已经完成数据的采集,并将数据存储在mysql,现在我们来继续后面的数据分析工作,先放出项目流程:0. 主要流程0. 数据采集0. 目标网址获取1. 爬虫框架选用注:了解这一步请登录https://www.jianshu.com/p/2b015d289083    或http://blog.youkuaiyun.com/weixin_41716128/article/details/7930...

weixin_41716128的博客 8915

基于Python《安家》电影影评爬取与数据分析.zip

资源包含文件:设计报告word+项目源码 使用 Scrapy 框架编写爬虫程序抓取《安家》影评信息,爬取电视剧的短评(55593条)、评分、有用数量等数据,保存为 json 格式! 结合 Pandas、Numpy和Matplotlib ,系统存储和处理爬取的大量数据,使用中文 Jieba 分词工具对爬取的短评信息文本处理, wordcloud 库处理数据关键词绘制词云图展示观众情感倾向和影片评分统计等信息!分别从评论时间、评分、评论内容进行数据可视化分析!

使用SSE流式输出(Javaweb前后端实战)

SSE(Server-Sent Events)是一种在Web应用中实现单向实时通信的技术。通过SSE,服务器可以主动向客户端发送更新,而无需客户端不断发起请求。这对于需要实时更新的应用场景(如聊天应用、实时数据监控等)非常有用。(服务端单向传输客户端,长连接)

记得开心一点嘛的博客 1万+

An工具介绍之摄像头

An工具介绍之摄像头

人生得意须尽欢 6185

Multisim 14.0实战:从零搭建可调幅多波形信号发生器(附仿真文件)

本文详细介绍了如何在Multisim 14.0中从零搭建一个可调幅多波形信号发生器,涵盖方波、三角波和正弦波的生成原理与实现步骤。通过核心电路架构解析、关键参数设计及Multisim实战操作,帮助电子工程学习者和硬件工程师掌握信号发生器的设计与调试技巧,并提供仿真文件供实践验证。

nokia的博客 1073

thinkphp6/8 - 实现评论区发表评论、回复评论功能数据库表设计与整个逻辑思路过程分析,tp5 评论盖楼等功能(附带源码稍加改造即可使用)

tp5评论区数据库表设计,tp5发表回复评论功能设计,thinkphp5如何做评论功能,tp5 php评论区实现发表回复删除评论,tp5评论区盖楼源码及数据表设计思路,thinkphp评论功能详细教程,thinkphp实现评论与回复功能,thinkphp实现文章评论和回复评论功能,tp5实现评论回复功能,thinkphp如何实现评论区,tp5网站PC移动端h5怎么做评论区发表留言及回复功能,thinkphp实现评论区插件,thinkphp评论区相互发表回复功能详细教程,thinkphp有没有评论区的组件插件

✅ 精选推荐文章 3159

WorkBuddy最新更新特性(2026-07-21)

WorkBuddy最新更新特性

AI人人懂 572

华为OD机试真题 新系统2026-04-08 Python&JS 实现【配置操作失败数量统计】

模拟一个系统的命令行配置,包含添加、修改、删除三项操作,详情如下: 添加操作命令:add_rulerule_id=1rule_index = 18 修改操作命令: mod_rule rule_id= 1rule_index = 100 删除操作命令:del_rulerule_id=1

MISAYAONE的博客 586

【RT-DETR涨点改进】全网独家创新、细节涨点改进篇 | ICML 2024 | RT-DETR引入ICB交互式卷积模块和ASB自适应频谱模块,助力目标检测、异常检测有效涨点、含多种创新改进点

RT-DETR目标检测模型通过引入ICB和ASB模块实现性能提升。ICB模块采用多尺度卷积交互,有效捕获局部和长程依赖特征;ASB模块通过自适应频域滤波优化特征表示,降低噪声干扰。两者结合使模型在复杂场景中表现更优,显著提升检测精度和鲁棒性。文章详细介绍了模块原理、代码实现及配置方法,并提供了8种改进版本的YAML配置文件,适用于不同网络结构。这些创新改进为RT-DETR模型提供了高效涨点方案,特别适合复杂背景和高噪声环境下的目标检测任务。

Ai缝合怪、助力小伙伴高效发论文 211

电气:蒙特卡洛1000个风光场景并通过削减法|聚类法得到几个典型场景(matlab\python实现)

    个人电气目录传送门:学好电气全靠它,个人电气博文目录(持续更新中…)     本文内容包括22页(代码和一些自己对风光的观点) 提示:专栏解锁后,可以查看该专栏所有文章,划算。 文章目录一、理论依据1.风电DG出力概率模型1.2光伏DG出力概率模型1.3对风光的认识二、蒙特卡洛模拟1000个风光场景、并通过削减法得到5个典型风电场景 (Matlab 版程序)三、蒙特卡洛模拟1000个风光场景、并通过聚类法得到5个典型

总裁余(余登武)博客 7681

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

上一篇: 大厂面试必问-Python是如何管理内存的?
下一篇: Python+xlwings操作Excel实战
jspython
博客等级 码龄7年 61粉丝 109原创
评论 23
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值