数据库写轮眼:看透 MVCC 版本链、快照、隔离级别。

数据库丢失更新:第一类与第二类并发冲突深度解析 丢失更新是数据库并发控制中的核心一致性问题,本质源于‘读-算-写’操作链的时间窗口竞争。其原理分为两类:第一类由脏读+回滚引发(脏写回),依赖低隔离级别如READ UNCOMMITTED;第二类由两个成功事务基于相同旧值计算后覆盖写入,MVCC机制下REPEATABLE READ亦无法规避。技术价值在于保障金融、电商、协作编辑等强一致场景的数据准确性;典型应用场景包括账户余额变更、库存扣减、投票计数等。本文聚焦两类丢失更新的机制差异、binlog诊断特征及悲观锁/乐观锁工程落地,直击‘测试不现、生产丢数’这 阅读详情

引言:

在数据库高并发场景下,海量事务同时读写同一份数据,单纯依赖锁机制相互制衡,只会造成无休止的阻塞等待;脏读、不可重复读与幻读,更如同忍界无解的幻术,牢牢桎梏着系统性能。

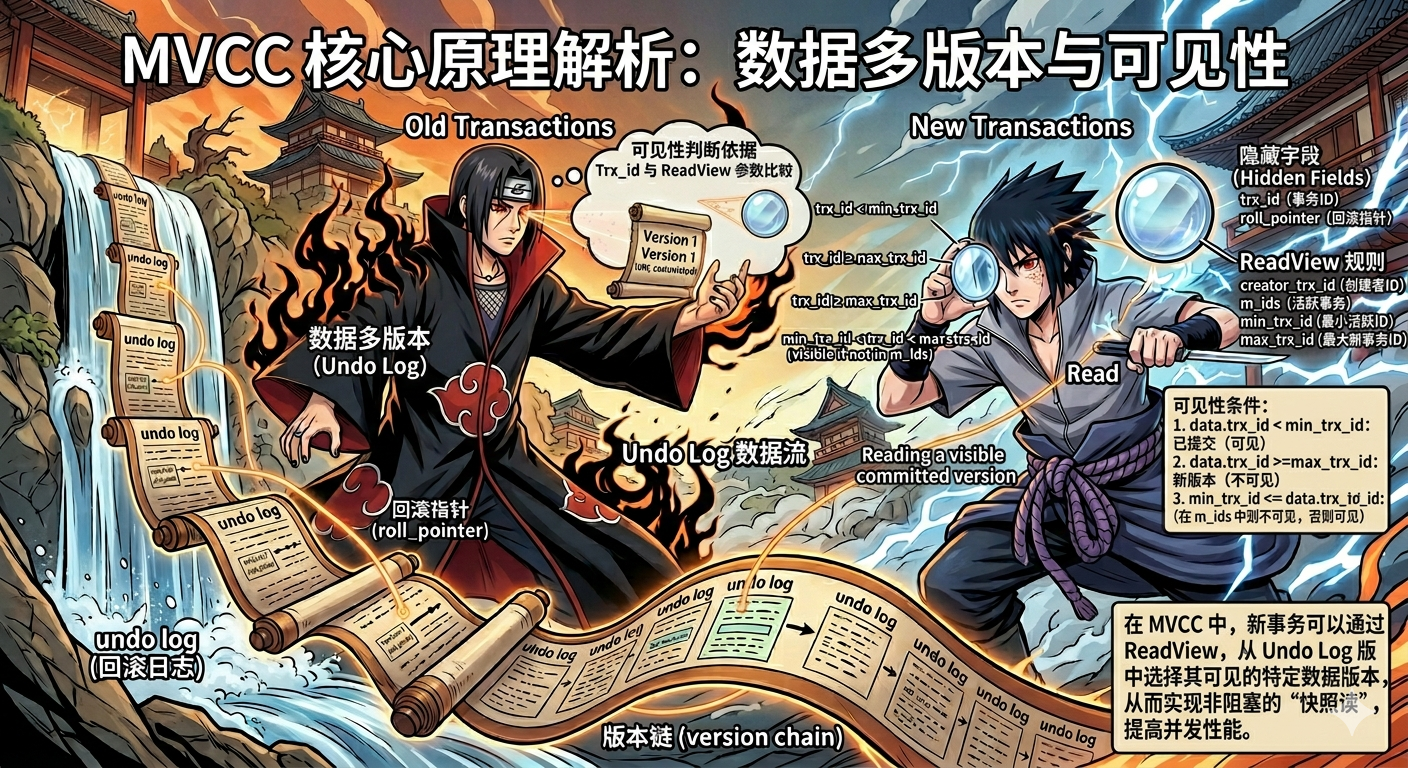
正如这幅图中,宇智波鼬借 Undo Log 铺展绵延不绝的数据历史分身版本链,佐助则凭借 ReadView 写轮眼,筛选出仅对当前事务可见的数据快照。

MVCC 正是数据库世界里独一份的宇智波瞳术,它摒弃锁竞争的对抗思路,依托多版本数据与视图可见性规则,为每一笔事务划分独立读写时空,从根源化解并发读写矛盾。

为什么需要 MVCC?

多事务并发访问数据库时,会引发脏读、不可重复读、幻读等并发异常。

为平衡数据一致性与并发性能,数据库提供了不同事务隔离级别。传统悲观锁方案也可以解决问题,但是并发效率低。

因此数据库设计者想设计一种办法既保证事务隔离,又尽量不加锁。于是MVCC 出现了。

MVCC是什么?是如何实现的?

先思考一个问题:如果事务A正在读一条数据1000,事务B把它改为2000。那么事务A应该看到哪个值?

不同隔离级别要求不同:

  • Read Committed 希望看到最新已提交版本

  • Repeatable Read 希望永远看到第一次读取的版本

所以本质问题变成了:一条数据到底应该给事务看哪个版本?

既然不同事务想看不同版本。那么最直接的方法就是:保存多个历史版本。

核心思想为数据维护多个历史版本,让不同事务读取不同版本的数据,实现无锁读,提升数据库并发性能

底层实现:

MVCC 依靠隐藏字段、undo log、ReadView三大核心组件协作,完成数据版本管理与可见性判断。

表隐藏字段:

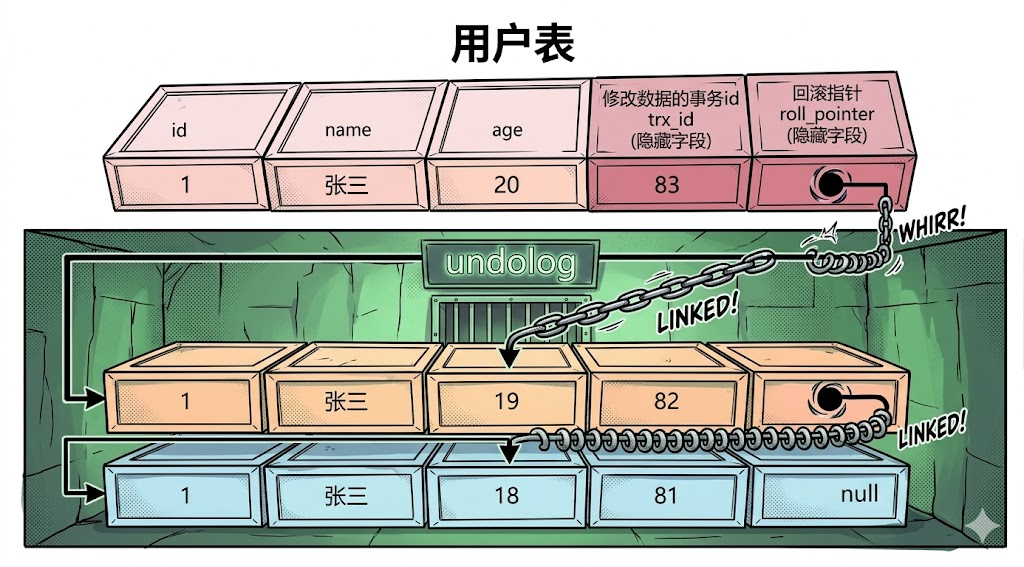
每张数据表默认包含两个关键隐藏字段:

  1. trx_id(事务ID):记录最后修改该条数据的事务 ID(事务 ID 全局自增,可判断事务先后顺序);

  2. roll_pointer(回滚指针):指向undo log中的历史数据版本,将所有版本串联成版本链表,用于追溯历史数据。

undo log(回滚日志):

  • 每次数据被修改时,会将修改前的旧数据存入 undo log,生成一个新数据版本;

  • 依靠回滚指针串联所有历史版本,形成版本链;

  • 作用:既支持事务回滚,也为 MVCC 提供历史数据版本。

ReadView(读视图)

ReadView 是事务读取数据时的可见性判断规则,用来判定某条数据版本对当前事务是否可见,包含 4 个核心字段:

  1. creator_trx_id:创建当前 ReadView 的事务 ID;

  2. m_ids:创建视图时,数据库中所有活跃(未提交)的事务 ID 集合;

  3. min_trx_id:活跃未提交事务中的最小事务 ID;

  4. max_trx_id:数据库下一个待分配的新事务 ID。

数据版本可见性判断规则
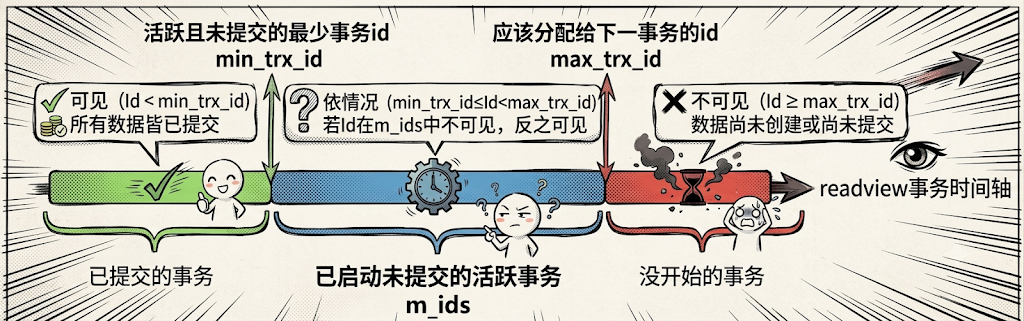
对比数据版本的trx_id与ReadView 字段,分三类场景判断可见性:

  1. 数据 trx_id < min_trx_id:该版本在 ReadView 创建前就已提交,当前事务可见;

  2. 数据 trx_id ≥ max_trx_id:该版本是 ReadView 创建后新启动的事务生成,当前事务不可见;

  3. min_trx_id < 数据 trx_id < max_trx_id:

    1. 若 trx_id 存在于m_ids(事务未提交):不可见;

    2. 若 trx_id 不存在于m_ids(事务已提交):可见。

一句话总结MVCC:

MVCC本质上由两部分组成分别是Undo Log和ReadView。Undo Log用来保存历史版本,ReadView负责判断哪个版本对当前事务可见。

修改数据时,记录事务 ID 到隐藏字段、旧数据存入 undo log 形成版本链;查询数据时,通过 ReadView 对比事务 ID,判断版本可见性,最终读取对应版本数据。

各个隔离级别是如何实现的?

  • 读未提交:最低的隔离级别, 每个事务都可以看到其他事务未提交的数据.

  • 读已提交:解决了脏读的问题,每个事务只能读到其他事务已经提交的数据。

  • 可重复读:mysql默认的隔离级别,解决了脏读和不可重复读。同一个事务内永远读到第一次查询的快照数据。

  • 串行化:事务完全串行执行,不允许并发,底层实现是加锁。

读未提交

无需 MVCC 特殊处理,事务可直接读取其他事务未提交的数据;仅写操作需加锁,防止并发写冲突。

读已提交

通过MVCC实现,读已提交的要求是只能读到已提交的数据,并且后续查询要能看见最新提交的数据,所以事务内每次执行 SELECT 查询都创建新的 ReadView。 每次读取都以最新的事务状态判断可见性,因此能读到其他事务已提交的最新数据,解决脏读。

可重复读

通过MVCC实现,可重复读要求:无论查询多少次,都看到同一份数据。

事务内第一次 SELECT 时生成 ReadView,后续所有查询复用该 ReadView。 事务全程读取同一个数据版本,保证多次查询结果一致,解决脏读、不可重复读。

串行化

不使用 MVCC,依靠全表 / 行锁强制事务串行执行,所有读写操作都需排队,隔离级别最高,但并发性能最差。

MVCC是如何解决幻读?

幻读:同一个事务内多次查询,其他事务新增 / 删除数据,导致前后数据条数不一致。

串行化:强制所有事务从头到尾串行执行,读写都互斥,隔离级别最高,但并发性能最差。

前面提到了MVCC解决了脏读和不可重复读的并发问题,那么幻读是如何被解决的呢?我们当然可以通过串行化可以解决幻读,但是性能太差, 一般不会使用。所以我们利用可重复读的隔离级别解决幻读问题。

可重复读下解决幻读的核心方案

  1. 快照读

  • 触发场景:普通 SELECT 查询

  • 实现原理:基于 MVCC 读取数据历史快照,无锁查询

  • 效果:只能看到事务启动时的数据版本,无法感知其他事务新增的数据,天然规避大部分幻读。

  1. 当前读

快照读存在短板:执行插入、修改等操作时,必须读取数据最新状态做校验,因此产生了当前读。

  • 触发场景:SELECT ... FOR UPDATE、SELECT ... LOCK IN SHARE MODE、增 / 删 / 改语句

  • 实现原理:读取数据最新版本,同时加临键锁(锁定目标行 + 数据间隙)

  • 效果:阻塞其他事务在锁范围内插入新数据,从而避免幻读。

极端场景:仍会出现幻读

成因:同一事务中先快照读、后当前读,两种读取方式混用,临键锁也无法规避。

典型案例:

  1. 事务 A 先用普通 SELECT(快照读)查询某条数据,结果为空;

  2. 事务 B 插入该条数据并提交;

  3. 事务 A 再次快照读,依旧查不到数据;但执行SELECT ... FOR UPDATE(当前读),能查到新数据,出现幻读。

彻底解决幻读的方案:

核心思路:通过加锁限制其他事务对数据表做新增、删除操作。

  1. 表锁:执行 SELECT * FROM 表名 FOR UPDATE,锁定整张表,其他事务所有操作都会阻塞;

  2. 行锁:基于索引列执行 SELECT 索引列=值 FOR UPDATE,锁定指定行与间隙,阻止数据插入。

补充辨析:可重复读加锁 vs 串行化

很多人会混淆两种加锁逻辑,二者有本质区别:

  • 串行化:全局管控,所有事务强制串行执行,完全牺牲并发能力;

  • 可重复读中的锁:仅对当前读做局部加锁控制,普通快照读依旧依靠 MVCC 无锁并发,保留了高并发能力。

文章创作不易,希望大家动动发财的小手,点点赞,评论下。希望给大家带来更优质的内容。

深度解析 PostgreSQL 中的 ctid、xmin、xmax:从原理到实战 隐藏列数据类型核心作用ctidtid数据行的物理位置标识,指向数据在磁盘块中的具体位置xminxid生成当前数据行版本的事务ID(即“谁创建了这一行”)xmaxxid标记删除/替换当前数据行版本的事务ID(即“谁删除/更新了这一行”,0表示未被操作)注意:虽然这三个列是“隐藏”的,但可以通过SELECT语句直接查询(无需额外配置),这为我们观察数据变化提供了极大便利。ctidxminxmaxctid记录数据的物理位置,是定位数据的“指南针”;xmin标记数据版本的“创建者”,xmax。 阅读详情

相关推荐

C#分布式数据库炼狱:用Serializable+分布式事务锻造“钻石级“隔离——从CAP定理到跨节点幻读的全栈解决方案

核心问题脏读(Dirty Read):读取未提交事务的数据不可重复读(Non-Repeatable Read):同一事务内多次读取结果不一致幻读(Phantom Read):查询条件范围内出现新数据分布式幻影(Distributed Phantom):跨节点数据插入导致的全局不一致// 隔离级别枚举(IsolationLevel.cs)SnapshotIsolation = 1005 // SQL Server快照隔离// 隔离级别与问题映射表。

墨夶的博客 554

【吃透 MySQL InnoDB连载】第 4 章・MVCC 多版本并发控制

本章承接前两章事务隔离与锁机制,剖析线上查询数据忽新忽旧问题,详解 MVCC 完整原理。依靠 UndoLog 构建版本链存储历史数据,兼顾事务回滚与多版本读取;借助 ReadView 控制数据可见性,过滤无效脏数据。区分无锁快照读与加锁当前读,说明 MVCC 实现读写互不阻塞、高并发访问的核心逻辑。RC、RR 隔离级别的本质差异是 ReadView 生成时机不同,同时分析长事务造成 Undo 日志膨胀隐患,串联锁机制形成完整事务隔离知识体系。

热爱各类技术,习惯把实践沉淀成文,已出版 MySQL、智慧养老架构相关专业书籍。日常深耕数据库优化、行业系统架构设计,也广泛关注各类后端、数字化相关技术方向。博客分享真实项目经验、技术踩坑与架构设计思路,和同好一起交流学习,共同成长。 1215

数据库内核实战:从零实现TPC-C压测的RMDB框架

数据库内核是支撑ACID事务、并发控制与持久化的核心系统,其本质在于B+树索引、WAL日志、MVCC快照、锁管理与查询优化器的协同运作。理解其原理需超越SQL接口,深入存储引擎页面布局、Buffer Pool置换策略(如LRU-K)及事务隔离机制。技术价值体现在高并发下确定性性能与崩溃可恢复性,典型应用场景为TPC-C基准测试——它并非单纯跑分,而是对锁竞争、IO调度、日志刷盘与内存管理的全链路压力体检。本文聚焦教学级内核框架RMDB的设计实践,涵盖Debian 13环境调优、C++17工程实现与TPC-C

weixin_34174105的博客 370

InnoDB MVCC原理详解:Undo Log与ReadView的版本链机制

数据库并发控制是保证数据一致性与系统吞吐量的核心课题。面对读写冲突,传统锁方案要么阻塞读,要么牺牲一致性。多版本并发控制(MVCC)通过保留数据行的多个历史版本,让读操作无需加锁即可获得一致快照,从根本上化解了读-写互斥,成为MySQL InnoDB等主流存储引擎的关键设计。以InnoDB为例,其MVCC由Undo Log构建的版本链与ReadView可见性判断共同实现:每次更新都会在Undo Log中留存旧值,形成可回溯的历史链条;ReadView依据事务ID与活跃事务列表,裁决当前事务应看到哪个版本。理

weixin_30702441的博客 82

Winform使用TreeView控件实现带复选框的三态树

刚接触c#,项目中用到Treeview实现三态,即选中、未选中、半选中状态,并且要求父子节点选择联动,效果类似下图网上有很多例子,于是研究了一下,结合网上大佬们的例子,所以在这里记录一下。首先新建一个Winform工程拖个TreeView控件,然后运行。。。嗯。。。加点数据吧。private void CreateTree() { TreeNode anime = new TreeNode...

laoyezha的博客 2万+

VPS环境搭建及配置

VPS(Virtual Private Server)是一种虚拟化技术,可以将一台物理服务器分成多个虚拟服务器,每个虚拟服务器都有独立的操作系统和资源,相互之间互不影响。VPS可以提供类似于独立服务器的功能,但价格更便宜,适合中小企业和个人用户使用。VPS可以用于网站托管、应用程序部署、游戏服务器、数据备份等各种场景。

YJ_12340的博客 1万+

告别并发脏写:从 MySQL 事务隔离级别到 GORM 工业级事务实战

本文探讨了MySQL事务隔离级别和GORM框架在工业级高并发场景下的实战应用。首先介绍了事务的四大特性(ACID),重点分析了隔离性在不同并发场景下的表现。针对电商系统中订单和库存操作的典型业务场景,文章详细比较了四种隔离级别(读未提交、读提交、可重复读和串行化)对脏读、不可重复读和幻读问题的防范能力,特别指出MySQL在默认的"可重复读"级别下通过MVCC机制已能解决幻读问题。 在实践部分,文章展示了如何利用GORM的Transaction闭包特性实现安全的事务控制,包括Service层的事务管理逻辑和R

jieyucx的博客 482

告别Keil手动分区!用CubeMX+VS Code一键生成带Bootloader的STM32 OTA工程

本文详细介绍了如何利用STM32CubeMX和VS Code实现STM32 OTA工程的自动化构建,告别传统Keil手动分区的繁琐流程。通过图形化配置Flash分区、自动生成链接脚本以及实现Bootloader跳转逻辑,开发者可以高效完成远程升级功能开发,显著提升嵌入式开发效率。

weixin_33720956的博客 389

【MySQL常见面试题 · 14】数据早被改了十次,为什么你查到的还是旧值?从Undo链看透MVCC并发读真相

很多人困惑:某行数据明明被并发事务改了十次且已提交,为什么你查到的依然是旧值?这个旧值究竟藏在哪?本文从串行化真相切入,彻底拆解 Undo 版本链、Read View 算法与快照读工程陷阱。数据早被改了十次,为什么你查到的依然是最初的旧值?这不是数据库发生了灵异故障,而是 InnoDB 存储引擎在物理聚簇索引与 Undo Log 历史链之间,用一致性 Read View 精心构筑的一场时空折叠。串行化通过物理互斥锁封冻了一切并发,带来绝对一致的同时也扼杀了吞吐;

weixin_45413272的博客 165

多模型对抗性审查:用AI辩论提升技术文档质量

在软件工程领域,技术文档是团队协作和项目成功的关键基础。传统的文档评审依赖人工经验,存在盲区和效率瓶颈。通过引入多模型对抗性审查机制,不同大语言模型从各自视角对文档进行批判性分析,模拟现实中的专家评审过程。这种技术方法的核心价值在于利用模型间的思维差异,自动发现单个视角容易忽略的边界情况、逻辑漏洞和隐含假设。在应用场景上,特别适合产品需求文档和技术规格书这类需要多角度审视的复杂文档。adversarial-spec工具通过Claude协调多模型辩论,实现从概念到实现的完整文档质量保障,显著提升文档的完整性和

weixin_42531579的博客 379

【光伏风电功率预测】基于 ICEEMDAN + MSCNN-BiGRU-Attention 的并行预测模型

本文提出一种基于ICEEMDAN分解与多尺度深度学习的光伏/风电功率并行预测框架。针对多能源、多时间尺度、强非平稳特性带来的建模挑战,该模型首先通过改进的ICEEMDAN算法将原始功率序列分解为不同频段的IMF分量;随后为每个IMF构建包含多尺度CNN、双向GRU和注意力机制的子模型,实现局部特征提取与时序依赖建模;最后通过并行预测与重构获得最终功率输出。实验表明,该方法能有效解决模式混叠问题,提升预测精度,并支持光伏/风电的独立或联合预测部署,适用于风光联合调度等工程场景。

专注AI大模型,软件混淆,授权 155

大二的我手写了一把内存锁(下)

本文通过实验揭示Java内存锁与MySQL事务的微妙关系。核心发现: 内存锁局限性:LockOperator虽能串行化请求,但无法保证事务读取最新版本,因MVCC快照读可能隔离写操作; MVCC机制:RR隔离级别下,事务内首次读生成ReadView,后续快照读可能看不到其他事务已提交的修改; 兜底方案:UPDATE的当前读+SQL条件更新才是最终防线。实验数据显示本地锁在单机场景性能优于Redis锁,但需注意锁边界与事务边界对齐问题。多实例部署需转向分布式锁实现。

qq_35383950的博客 687

Qt/C++ 音视频开发 - FFmpeg 安卓版

通过将 FFmpeg 集成到 Qt/C++ 项目中,我们可以实现强大且灵活的音视频处理功能。本文介绍了在安卓平台上使用 FFmpeg 的基本步骤,包括初始化、解码、处理和编码等。实际应用代码示例展示了如何在安卓设备上播放视频。

走向CTO的路上... 1192

面试官追问MySQL默认隔离级别?别只答‘可重复读’,用这个Spring Boot测试项目讲清楚原理和坑

本文深入探讨MySQL默认隔离级别‘可重复读’的原理与实践,通过Spring Boot测试项目展示MVCC机制和间隙锁的应用。文章揭示了常见误区,如幻读问题,并提供了Spring事务配置的实战建议,帮助开发者更好地理解和应用隔离级别。

weixin_30855761的博客 405

医院批量排班实战指南(三)日期列表生成与时段批量操作

在上一篇《批量排班功能实现指南(二):日期与时段设置》中,我们完成了日期范围选择和重复规则配置的界面搭建,实现了从第一步到第二步的跳转功能。现在我们已经可以选择日期范围和重复规则,但还缺少最关键的功能——根据规则生成日期列表并进行时段配置。本篇将继续深入批量排班的核心功能——日期列表生成与时段批量操作。根据日期范围和重复规则智能生成日期列表为每个日期配置上午、下午、夜诊时段批量时段操作提升配置效率日期列表的展示与管理。

低代码布道师的博客 1346

用Python爬虫抓取大宗交易成交数据:全面解析与实战代码

大宗交易是指在证券市场中,涉及大额买卖的交易。此类交易通常由机构投资者进行,其交易量较大,对市场的影响显著。大宗交易数据包含了买卖双方的成交价格、成交量等关键信息,这些数据对于投资者和分析师而言,具有重要的市场预测意义。Python爬虫是一种自动化抓取互联网上数据的工具。通过爬虫,我们可以定期获取大宗交易数据,节省人工查询的时间。爬虫的工作原理通常包括:发送HTTP请求、获取响应数据、解析网页内容、提取关键信息、存储和展示数据。

2201_76125261的博客 417

别再死记硬背了!用这3个真实业务场景,彻底搞懂MySQL的4种隔离级别

本文通过电商库存扣减、用户余额校验和订单状态更新三个真实业务场景,深入解析MySQL的4种隔离级别(未提交读、提交读、可重复读和串行化)的应用与区别。帮助开发者理解如何在不同业务需求下选择合适的隔离级别,避免脏读、不可重复读和幻读问题,提升数据库操作的性能与数据一致性。

weixin_30527323的博客 374

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

并发之下的秩序:深入解析MySQL事务隔离与锁的博弈

维度推荐方案理由默认选择RR (可重复读)MySQL 的看家本领,利用 MVCC+ 间隙锁完美平衡一致性与并发,适合绝大多数 OLTP 场景。高并发写入RC (读已提交)如果你的系统写操作极其频繁,且深受间隙锁导致的锁等待困扰,可考虑切换至 RC。需应用层处理不可重复读逻辑(通常业务上影响不大)。金融核心RR 或 Serializable涉及资金账务,必须保证强一致性。若 RR 仍无法满足极端场景,才考虑 Serializable(需慎重评估性能)。锁优化核心索引 + 短事务无论何种级别,

2609_95039045的博客 375

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

MySQL锁机制详解:从表锁到行锁,看透并发控制与排查实践

在数据库并发访问中,事务隔离与数据一致性依赖锁机制来保障。MySQL 的 InnoDB 引擎通过行锁、表锁、间隙锁(Gap Lock)与意向锁协同工作,既解决脏读、不可重复读与幻读,又需平衡并发性能。理解锁的粒度、模式与兼容矩阵,是排查锁等待、死锁及“锁表”问题的关键。在实际应用中,慢 SQL 或未走索引的更新可能导致行锁升级为表锁,阻塞大量业务请求。借助 information_schema 与 performance_schema 表可精准定位持锁事务与锁状态,进而通过优化事务长度、索引使用及加锁顺序减

weixin_32325225的博客 259

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

MySQL InnoDB面试作战地图:从一条UPDATE看透索引、事务与锁机制

数据库核心是围绕数据一致性与访问高效性持续权衡的系统,其底层原理植根于存储引擎设计、并发控制模型与日志恢复机制。InnoDB作为MySQL默认引擎,以B+树索引组织物理数据,通过MVCC(多版本并发控制)与next-key lock协同实现事务隔离,依赖redo log保障持久性、undo log支撑回滚与快照读。理解这些机制,关键在于把握‘代价与权衡’——如索引提升查询却增加写入开销,RR级别避免幻读但扩大锁范围并消耗更多内存。本文以一条UPDATE语句的完整执行路径为线索,串联索引失效场景、执行计划解读

weixin_30219613的博客 162

网易校招DBA笔试卷拆解:从SQL到高可用,看大厂如何筛选数据库人才

数据库管理工程师是保障企业数据核心稳定运行的关键角色,校招笔试则是对候选人理论基础、工程实践与应急思维的多维检验。一套高质量的笔试卷,往往从SQL书写、索引优化、事务隔离、锁机制等基本功切入,逐步延伸至主从复制、故障切换、备份恢复等生产级运维场景,考察的不仅是知识记忆,更是数据一致性、可用性与性能之间的权衡能力。随着国产数据库、时序数据库、向量数据库等技术生态的快速发展,大厂笔面试也开始融入达梦、人大金仓、TDengine等新元素,要求候选人具备更广的技术视野和架构思维。理解数据库底层原理,掌握从单机到集群

weixin_34152820的博客 378

深入PostgreSQL内核算法:从MVCC到查询优化器的性能调优实战

数据库索引与查询优化是提升应用性能的核心技术。其原理在于通过高效的数据结构(如B-Tree、哈希表)组织数据,减少磁盘I/O,从而加速数据检索。理解这些底层机制的技术价值在于,开发者能够针对特定场景选择最优索引类型,并编写出更高效的SQL语句。在应用场景上,无论是高并发的在线事务处理(OLTP),还是复杂分析查询(OLAP),合理的索引设计和查询优化都能显著提升系统吞吐和响应速度。本文聚焦PostgreSQL的MVCC机制和查询优化器,通过分析多版本并发控制如何实现读写不阻塞,以及优化器如何基于统计信息选择

Eric.Net的专栏 332

数据库事务与锁机制:从ACID到分布式锁的实战指南

在数据库并发控制的底层逻辑中,事务与锁始终是保障数据一致性的基石。事务通过ACID模型确保一组操作的原子性、一致性、隔离性与持久性,而锁机制则在此基础上协调多事务的并发访问。MySQL InnoDB通过redo log与undo log落实持久化和回滚能力,并借助MVCC与间隙锁实现高性能隔离级别。理解脏读、不可重复读、幻读等并发问题,以及表锁、行锁、间隙锁的适用场景,是排查线上死锁和锁等待的关键。在微服务与分库分表架构下,分布式事务和Redis分布式锁进一步扩展了数据一致性的边界。本文从基础原理出发,结合

weixin_32612263的博客 287

很多企业都是面试造火箭,入职拧螺丝?这些套路总算是看透了

在清楚了各个大厂的面试重点之后,就能很好的提高你刷题以及面试准备的效率,接下来小编也为大家准备了最新的互联网大厂资料。网上学习资料一大堆,但如果学到的知识不成体系,遇到问题时只是浅尝辄止,不再深入研究,那么很难做到真正的技术提升。需要这份系统化的资料的朋友,可以添加V获取:vip1024b (备注Java)一个人可以走的很快,但一群人才能走的更远!不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!

938

【MySQL常见面试题 · 12】数据还没落盘怎么敢返回成功?从undo与redo日志看透ACID实现

很多开发者以为事务提交就是数据写进了磁盘文件。为了极致吞吐,修改往往只在内存中,磁盘数据页根本没动。数据还没落盘凭什么敢返回成功?从 undo 与 redo 日志看透 ACID 底层协同。在高性能数据库的工程进化史中,WAL 机制、双日志协同与环形缓冲区的设计,无一不是在“物理硬件的冷酷约束”与“业务系统对极致吞吐的渴求”之间所做出的天才折中。用顺序 I/O 规避随机 I/O:把高昂的随机数据页写入延后为内存脏页的批量异步合并,用低廉而高效的轻量级顺序追加写抢先守住持久性底线。物理与逻辑的清晰分工。

weixin_45413272的博客 134

Oracle静默安装,含仅软件安装和数据库安装及常见报错处理方法DBT-10317 DBT-05509 [FATAL] ORA-03114

本文详解Oracle 19c单机版静默安装与数据库创建全流程,涵盖目录配置、响应文件编写、安装及建库命令,附常见报错(如DBT-10317、ORA-03114)解析与解决方案,包含删库指令与日志分析,适合内网环境自学实战,免费干货,实用性强。

qq_41474349的博客 177
上一篇: 为什么鸣人的拉面钱不能凭空消失?——事务与 ACID 详解
下一篇: 深入理解 MySQL 三大日志:Undo Log、Redo Log 与 Binlog 的协同之道
程序员晨曦
博客等级 码龄2年 58粉丝 40原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值