‌Logstash 与 Filebeat 核心定位与职责对比‌

OpenSearch日志投递选型:Filebeat、Logstash与Fluentd实战对比 Log Shipper(日志投递器)是构建OpenSearch可观测性体系的核心枢纽,其本质并非简单转发工具,而是承担协议适配、流控背压、错误恢复与字段预处理的关键组件。理解OpenSearch的Bulk API行为、索引模板约束及线程池边界,是避免日志丢失、重复与延迟的根本前提。Filebeat以轻量低耗和强稳定性见长,适合文件类日志与中小规模集群;Logstash凭借JVM生态与复杂ETL能力,适用于深度定制化处理场景;Fluentd则依托插件化架构,在多源异构日志(如Kafka、Syslog、S3)接 阅读详情

‌Logstash 与 Filebeat 核心定位与职责对比‌表格

维度LogstashFilebeat
核心定位企业级数据处理管道,承担 ETL(提取、转换、加载)核心角色,是 Elastic Stack 中的数据“加工厂”轻量级日志采集代理,专注于边缘节点的日志“搬运工”,是 Beats 家族中的日志转发核心
核心功能- 丰富的输入插件:支持文件、Syslog、Kafka、Redis、HTTP、Beats、数据库等多种数据源
- 强大的过滤插件:提供 Grok(解析非结构化日志)、GeoIP、Mutate、Date、Ruby 等上百种插件,可进行复杂的解析、格式化、匿名化、 enrich 等操作
- 灵活的输出插件:可将处理后的数据发送至 Elasticsearch、Kafka、文件、数据库、HTTP 端点等
- 监控指定日志文件或目录
- 通过 Prospector 管理 Harvester 读取文件内容
- 支持将数据发送至 Elasticsearch、Logstash、Kafka、Redis 等
- 支持基本的过滤(如添加字段、丢弃事件)
主要职责- 从多种数据源(文件、数据库、API、消息队列等)采集数据
- 对原始数据进行结构化解析、字段转换、信息增强与过滤
- 实现复杂的数据清洗逻辑(如 Grok 解析、GeoIP 补全、JSON 处理)
- 将处理后的标准化数据输出至 Elasticsearch、Kafka 等目标系统
- 监控指定路径下的日志文件(如 /var/log/*.log)
- 通过 Harvester 逐行读取文件内容,确保不丢失数据
- 记录文件偏移量至注册表(Registry),支持断点续传
- 将原始日志事件高效、低耗地转发至 Logstash 或 Elasticsearch
资源占用较高(需 JVM 环境,内存与 CPU 消耗显著)极低(基于 Golang 编写,适合大规模部署)
处理能力支持复杂过滤与转换(filter 插件丰富)仅支持基础处理(如多行合并、JSON 解析),无复杂过滤能力
典型部署位置集中式处理节点或专用数据处理服务器分布式应用节点、容器(Docker/K8s)边缘侧
可靠性内部没有持久化队列,在异常情况下(如下游 Elasticsearch 不可用),存在数据丢失的风险。通过 registry 文件记录每个文件的读取偏移量,保证数据不丢失。在异常中断或网络波动后,能从上次停止的位置继续读取。
可靠性机制依赖外部缓冲(如 Kafka)或持久化队列保障数据不丢失内建注册表机制,自动记录采集进度,重启后可续传
集成方式常作为 Filebeat 的下游,接收其发送的数据进行深度处理可直接输出至 Elasticsearch,也可通过 beats 输入插件发送至 Logstash
语言与性能使用 JRuby 编写,运行在 JVM 上,资源消耗较高(默认堆内存可达 1GB),启动较慢,对服务器负载影响较大。使用 Go 语言编写,轻量级,内存占用极低(通常仅需几十 MB),启动快,对系统资源影响小。
数据处理能力功能全面,是处理复杂、非结构化日志(如 Java 应用堆栈、混合格式日志)的首选工具,能将杂乱日志转化为结构化、标准化的字段。功能相对简单,不擅长复杂的日志解析和转换。对于结构化日志(如 JSON),可直接发送至 Elasticsearch,利用其 Ingest 功能进行处理。
配置复杂度配置相对复杂,需要编写详细的 pipeline 配置,定义 input、filter 和 output。配置相对简单,主要涉及指定日志路径和输出目标。
典型应用场景- 集中处理来自多个来源的异构日志(如服务器日志、网络设备日志、应用日志)
- 需要对日志进行深度解析、字段提取、数据丰富(如添加地理位置、用户信息)
- 需要将日志路由到不同的 Elasticsearch 索引或下游系统
- 作为 Kafka 消费者,进行大规模日志的集中处理
- 部署在应用服务器上,轻量采集本地日志文件
- 将日志直接发送至 Elasticsearch(日志为 JSON 或使用 Ingest Pipeline)
- 将日志发送至 Kafka/Redis 作为缓冲,再由其他消费者处理
- 替代 Logstash 作为应用端的采集代理,构建 EFK(Elasticsearch, Filebeat, Kibana)架构

Logstash和Filebeat有同时使用的必要吗?

在ELK或EFK架构中,‌Logstash和Filebeat通常需要协同使用,但并非绝对必要‌。实际是否同时使用,取决于日志处理的复杂度、系统资源约束和架构目标。以下是具体分析:


一、推荐同时使用的场景:发挥各自优势,构建完整流水线

在大多数生产级ELK/EFK架构中,‌Filebeat与Logstash是互补关系,建议同时使用‌,形成“轻量采集 + 集中处理”的分层架构。

  1. ‌Filebeat 负责高效采集‌

    • 部署在应用服务器或容器中,资源占用极低(CPU和内存几乎可忽略)。
    • 实时监控日志文件变化,支持多行日志合并、文件旋转跟踪,确保日志不丢失。
    • 将原始日志数据发送给Logstash或直接写入Elasticsearch。
  2. ‌Logstash 负责深度处理‌

    • 接收Filebeat转发的日志,执行过滤、解析、格式化等操作。
    • 支持Grok正则提取、时间戳识别、字段增删、JSON化、脱敏等复杂处理。
    • 最终将结构化数据写入Elasticsearch,便于Kibana高效查询与可视化。

✅ ‌典型流程‌:应用日志 → Filebeat(采集) → Logstash(解析) → Elasticsearch(存储) → Kibana(展示)。

这种组合既保证了采集端的轻量稳定,又实现了日志的标准化处理,是业界最常见的ELK架构模式。


二、可省略Logstash的场景:简化架构,降低成本

在以下情况下,‌可以仅使用Filebeat,直接写入Elasticsearch‌,跳过Logstash:

  1. ‌日志格式已结构化‌

    • 若应用本身输出JSON格式日志(如Spring Boot + Logback JSON Encoder),无需额外解析。
    • Filebeat可直接将结构化日志发送至Elasticsearch。
  2. ‌资源受限或追求极致轻量‌

    • Logstash基于JVM,资源消耗较高(内存通常需1GB以上),不适合部署在边缘节点。
    • Filebeat为Go编写,二进制运行,无依赖,更适合大规模部署。
  3. ‌使用Ingest Node替代Logstash‌

    • Elasticsearch提供Ingest Node功能,可在索引前执行简单预处理(如Grok、日期解析)。
    • 适用于处理逻辑简单的场景,减轻Logstash压力。

⚠️ 注意:Filebeat不具备Logstash的复杂过滤能力,无法实现条件判断、多源关联、数据 enrichment 等高级功能。


三、可省略Filebeat的场景:集中式采集或代码侵入式方案

虽然少见,但在以下情况也可不使用Filebeat:

  1. ‌应用直接发送日志到Logstash‌

    • 使用Log4j2的SocketAppender或HttpAppender,将日志直接推送到Logstash的Beats输入插件(端口5044)。
    • 但会增加应用进程负担,且网络异常可能导致日志丢失。
  2. ‌使用其他采集器替代Filebeat‌

    • 如Fluent Bit、Promtail等,适用于Kubernetes等云原生环境。

四、总结:按需选型,平衡能力与成本

架构模式适用场景优势风险
‌Filebeat + Logstash‌复杂日志解析、企业级系统功能完整、处理能力强资源开销大
‌Filebeat → ES(直连)‌结构化日志、轻量需求架构简单、成本低处理能力弱
‌应用 → Logstash(直连)‌小规模、集中管理减少Agent维护影响应用稳定性

因此,‌对于你正在构建的分布式微服务日志系统,若需实现日志的标准化、可观测性与长期可维护性,建议保留Filebeat与Logstash的协同工作模式‌。若日志已结构化且处理逻辑简单,可评估使用Filebeat直连Elasticsearch方案以降低成本。

附件一:Logstash基本定义与核心价值
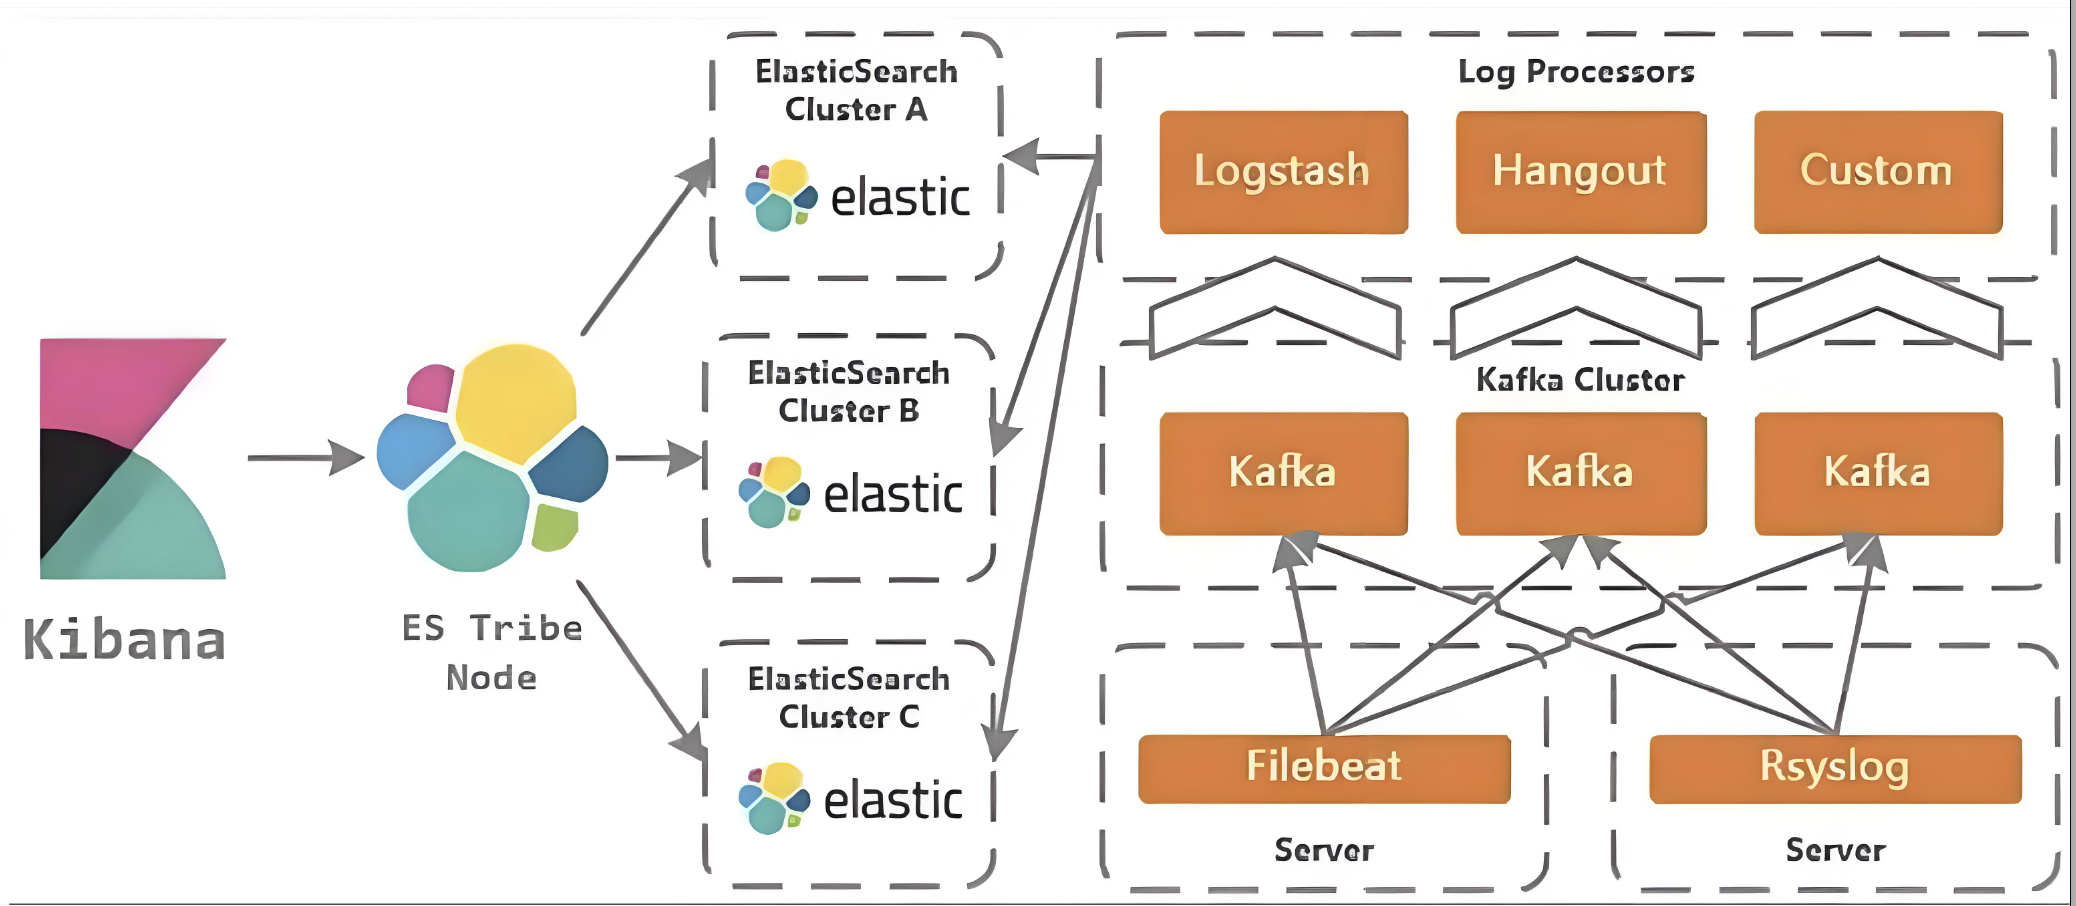
Logstash 是一个‌开源的数据收集和处理引擎‌,属于 Elastic Stack (ELK) 的核心组件,它通过实时管道能力从多种来源采集数据,并进行清洗、转换后发送到指定目的地。‌‌1‌

基本定义与核心价值

  1. ‌定义与读音‌:Logstash 是一个开源的服务器端数据处理管道,能够同时从多个来源采集数据、进行转换,并将数据发送到指定的“储藏地”(如 Elasticsearch)。其名称来源于“Log”(日志)和“Stash”(储藏),读音通常为 /ˈlɔɡstæʃ/。它最初专注于日志收集,但其能力已扩展至处理任何类型的事件数据。‌‌
  2. ‌核心价值‌:Logstash 的核心价值在于‌动态统一来自不同来源的数据并将其规范化‌,从而为下游的分析、可视化、监控和归档等用例提供高质量的数据基础
OpenSearch日志采集工具选型:Logstash、Filebeat与Fluentd实战指南 日志采集是OpenSearch可观测体系的关键入口,其本质不是功能比拼,而是对日志源格式、集群负载能力与团队工程能力的综合匹配。Logstash擅长复杂日志的精细解析与跨事件聚合,适合多行堆栈、多格式混杂及trace_id关联等高阶场景;Filebeat以轻量、低侵扰和确定性见长,是边缘设备、容器化环境及标准化文本日志的理想‘静音引擎’;Fluentd凭借Kubernetes原生集成与插件化架构,成为云原生日志管道的灵活基座,但需警惕缓冲区溢出与插件组合风险。三者价值不在孤立性能,而在于与OpenSearc 阅读详情

相关推荐

基于Canfestival的对象字典工具objdictedit.py的运行环境配置

本文以菜狗的视角,一步一步地对对象字典的环境进行配置,旨在能给读者一个比较详细的参考,不恰之处,还请指正。

在线求职中... 3707

Filebeat与Logstash怎么选?一文搞懂两者分工与典型架构

日志采集是构建可观测性体系的基础环节,完整的数据管道通常包含生产、采集、缓冲、处理、存储与展示等多个阶段。在ELK技术栈中,Filebeat作为轻量级采集代理,以极低资源占用负责日志的读取与传输;Logstash则依托丰富的插件生态和强大的处理能力,承担数据解析、字段标准化与富化等加工任务。理解两者的定位差异,有助于在日志量、解析复杂度和可靠性之间做出合理的架构选型。从单机直连Elasticsearch到引入Kafka做削峰填谷,不同场景下的部署模式各有优劣。本文围绕数据管道原理、核心职责对照与典型架构设计

weixin_30984001的博客 229

8155平台multi-display(多屏显示)原理与配置

8155平台多屏互动原理与配置

漂流瓶の海岸 1603

Logstash vs Filebeat:日志采集与加工的分工与选型指南

日志系统的建设离不开采集、解析、传输与存储检索这条完整链路,而数据从业务服务器到 Elasticsearch 的过程中,轻量采集与集中加工是两个既有重叠又职责分明的环节。Filebeat 作为基于 Go 的轻量级采集器,负责跟踪文件、断点续传并低资源消耗地将日志送出;Logstash 则依托 JVM 管道模型,在 filter 阶段完成 grok 正则解析、字段标准化、时间校准与数据富化。理解两者在资源占用、吞吐性能和可靠性机制上的差异,能帮助运维和开发同学在日志采集架构选型时避免将采集与加工混为一谈。无论

weixin_29913663的博客 191

MATLAB控制信号发生器(USB-GPIB-HS)GPIB仪器控制教程(含matlab代码)

自动化测试时需要自动产生信号,通过matlab控制信号发生器的频率与功率,以实现自动化信号生成输出

qq_43686057的博客 1606

ovs实现lb负载均衡

负载均衡器的实现原理是通过硬件或软件设备将客户端访问流量根据转发策略分发到多个服务器或设备上,以确保系统的负载均衡。二层负载均衡‌:使用虚拟MAC地址方式,根据OSI模型的二层进行负载均衡。‌四层负载均衡‌:基于IP+端口的负载均衡,主要分析IP层及TCP/UDP层,实现四层负载均衡。‌七层负载均衡‌:从应用层开始,根据虚拟的URL或IP、主机名接收请求,再转向相应的处理服务器。

bobi的博客 949

5 分钟手把手做出 Windows 启动盘:Rufus 免安装 U 盘启动完整教程

Rufus 是免费开源的小工具:把 Windows ISO 写进 U 盘,就能做出 Windows 启动盘;无 TPM 2.0 的老机器,也能绕过硬件检查装 Windows 11。当前版本 4.15(2026.06.30 发布),双击便携 exe 即用,免安装。 ## Rufus 适合谁 - 老机器系统装崩要重装,手头却没有现成的启动盘 - 机器没有 TPM 2.0,过不了 Windows 1

gitblog_00756的博客 89

【高清照片】深圳光博会看PCIe Over Fibre 实现方案

本文分析了PCIe over Fibre技术及其在数据中心的应用前景。该技术通过光纤延伸PCIe总线,解决了传统铜缆距离限制问题,支持跨机架资源池化。目前主要有两种实现方式:CDFP混合光缆方案和Retimer转接卡方案,各有优缺点。文章还探讨了CDFP接口的现状、低速信号传输解决方案,以及PCIe速率与光通信发展的对应关系。最后对比了PCIe光缆与以太网光缆的关键差异,指出PCIe光互连在协议透明度和边带信号处理上的特殊要求。随着标准推进,PCIe over Fibre将成为数据中心扩展高带宽、低时延互连

Saniffer的博客 1383

在 Logstash 中使用 Filebeat 提供的 Ingest Pipelines 解析数据:加载、配置与实战

当你在 Logstash 中使用 Filebeat modules 时,可以复用 Filebeat 自带的 ingest pipelines 来完成数据解析,无需在 Logstash 侧重复编写 grok、date、geoip 等解析逻辑。本文以 [docs/reference/use-ingest-pipelines.md](https://link.gitcode.com/i/f8018c1a

gitblog_01122的博客 492

文本分析-使用jieba库进行中文分词和去除停用词(附案例实战)

本文将手把手教会你使用jieba库进行中文分词和去除停用词,这是学会文本分析的必经之路!

m0_64336780的博客 4万+

把 Custom Business Configurations 变成你的定制化维护台:Business Configuration Maintenance Object 设置全解

摘要:SAP BTP的Business Configuration(BCMO)为ABAP环境提供标准化的配置维护方案,通过RAP对象暴露为OData V4服务,自动生成Fiori elements维护界面,省去单独开发应用的成本。关键配置包括:Service Configuration定义业务名称和分组;List Report控制初始加载和视图变体;Object Page配置布局(Tabs/Page)和编辑权限;Table Settings选择表格类型(Grid/Responsive)和创建模式(Inlin

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 166

Filebeat与Logstash职责解析:从日志采集到处理管道的协同

日志采集与处理是构建可观测性体系的基础环节,而Filebeat与Logstash分别扮演了轻量级采集器和数据处理管道的角色。Filebeat基于文件指针机制实现断点续读与轮转处理,资源占用极低,适合部署在业务服务器边缘侧;Logstash则依托grok、mutate、date等丰富过滤器插件,对日志进行结构化解析与清洗,是集中式处理层的核心。两者通过beats协议协作,形成Filebeat接入、Logstash解析、Elasticsearch存储的经典ELK架构,支持背压保护与扩展Kafka缓冲。在日志格式

weixin_34072296的博客 212

openclaw update时出现Skipped:this OpenClaw install isn‘t a git checkout,and the package manager解决方案

本文主要介绍了openclaw update时出现openclaw update时出现Skipped:this OpenClaw install isn’t a git checkout,and the package manager解决方案,希望能对使用openclaw的同学们有所帮助。 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 12万+

【ES专题】Logstash与FileBeat详解以及ELK整合详解

这一篇笔记给大家分享一些日志管理相关的组件。为什么需要这个玩意呢?这主要还是因为分布式微服务的兴起啊!试想一下,现在的电商场景,动不动就百万流量进来,万一线上出了什么问题了,异常啊什么的,总该需要追溯日志吧?而且这些日志,在微服务场景下,通常是分布在多个机器里面的。那在这种海量业务日志里面,如何快速找到分布在各服务器里面的日志呢?海量日志多台服务器集中化日志管理思路:日志收集 -> 格式化分析 -> 检索和可视化 -> 风险告警Logstash 是免费且开放的服务器端数据处理管道,能够从多个来源。

qq_32681589的博客 2220

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

Elasticsearch 、Logstash以及Filebeat介绍与配置详解

Elasticsearch(ES)是一个开源的分布式搜索分析引擎,基于Apache Lucene构建。其核心能力包括实时数据分析、全文检索、结构化/非结构化数据处理以及水平扩展性,能够处理PB级数据。ES通过分布式架构、高性能原理和创新数据模型解决了传统数据库在搜索与分析场景的性能瓶颈。关键特性包括灵活的节点角色配置、分片分配策略和安全体系。典型应用场景涵盖企业搜索、日志分析、安全监控和业务分析。生产环境部署需要重点关注配置优化、安全设置和性能调优,涉及网络、内存、JVM等多个维度的参数调整。ES 7.x版

2501_92915057的博客 888

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

elasticsearch+kibana+logstash+filebeat/heartbeat链路部署流程

node1:Elasticsearch + Kibana(存储+展示层)= node2:Logstash(数据处理层)= node3:Filebeat(日志采集层)

2301_81704123的博客 268

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

统一日志格式规范与 Filebeat+Logstash 实践落地

在多部门、多技术栈并存的企业环境中,日志收集与分析是保障系统稳定运行的核心能力之一。然而,不同开发团队采用各异的日志打印方式,导致日志数据结构混乱,严重影响后续的收集、存储、检索与告警效率。本文将介绍我们如何建立统一的日志格式规范,并基于 Filebeat + Logstash 实现多环境(宿主机/Kubernetes)下的高效日志采集、解析与存储。团队B采用Logback,格式为%date %level [%thread] %logger - %msg%n。行业兼容性:符合主流日志框架的最佳实践。

Java_fenxiang的博客 725

实时日志监控告警管道实践:Pathway 对接 Filebeat/Logstash、Kafka 与 ElasticSearch

本文基于仓库中的端到端示例项目 [logstash-pathway-elastic](https://link.gitcode.com/i/6372c33de5c9355083673f43fa38f11f),讲解如何用 Pathway Live Data Framework 搭建一套「日志采集 → 消息中转 → 流式告警分析 → 告警落库」的完整实时监控链路:由 Filebeat 采集容器内日志,

gitblog_00300的博客 906

SpringBoot 日志接入 ELK 实战:Filebeat + Logstash 采集与 Kibana 可视化

在分布式系统中,日志集中管理与全文检索是保障服务可观测性的基础能力。其核心原理是通过轻量级采集器将散落在多台机器上的日志文件实时收集,经结构化解析与字段清洗后,写入支持倒排索引的分布式搜索引擎,最终借助可视化平台实现秒级查询与趋势分析。这套技术栈的价值在于将原本耗时数十分钟的日志排查工作压缩到几秒内完成,尤其适用于多节点、多服务的 SpringBoot 应用场景。当线上接口出现超时或异常时,开发人员可基于 traceId 快速串联全链路日志,精准定位问题根因。本文围绕 SpringBoot 日志接入 ELK

weixin_34269583的博客 375

BLG架构实战:基于Filebeat、Logstash与Grafana构建精细化日志监控平台

日志监控是现代分布式系统可观测性的基石,其核心在于高效采集、解析与可视化。传统ELK栈虽广泛使用,但在处理复杂业务日志的实时解析与动态扩展时,常面临灵活性不足的挑战。本文引入BLG架构,通过轻量级采集器Filebeat、强大数据处理管道Logstash与可视化平台Grafana的组合,实现资源与职责的分离。该架构强调精准的“卡蜜尔式”配置,支持字段动态裁剪、条件路由与索引分片,显著提升处理能力。在可视化层面,Grafana的仪表盘卡片支持联动与钻取,便于实现业务洞察。本文以电商微服务场景为例,详解从环境搭建

android_mylove的专栏 301

用 Logstash 解析 Apache 日志:Filebeat 输入、Grok 结构化与 GeoIP 增强实战

本文基于 [docs/reference/advanced-pipeline.md](https://link.gitcode.com/i/6386a3e3ac8724204a6ff1f9d5590345) 的完整教程脉络,带你从"测试用单事件流水线"升级为生产形态的多插件流水线:使用 Filebeat 采集 Apache Web 日志并发送到 Logstash,用 `grok` 过滤器把非结构化

gitblog_00815的博客 177
上一篇: Filebeat、Fluent Bit、Fluentd‌三者全方位对比
下一篇: ELK(Elasticsearch+Logstash+Kibana)传统日志采集架构与ELFKK(Elasticsearch+Logstash+Kibana+Filebeat+Kafka)对比
飞火流星02027
博客等级 码龄19年 782粉丝 121原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

飞火流星02027

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


