






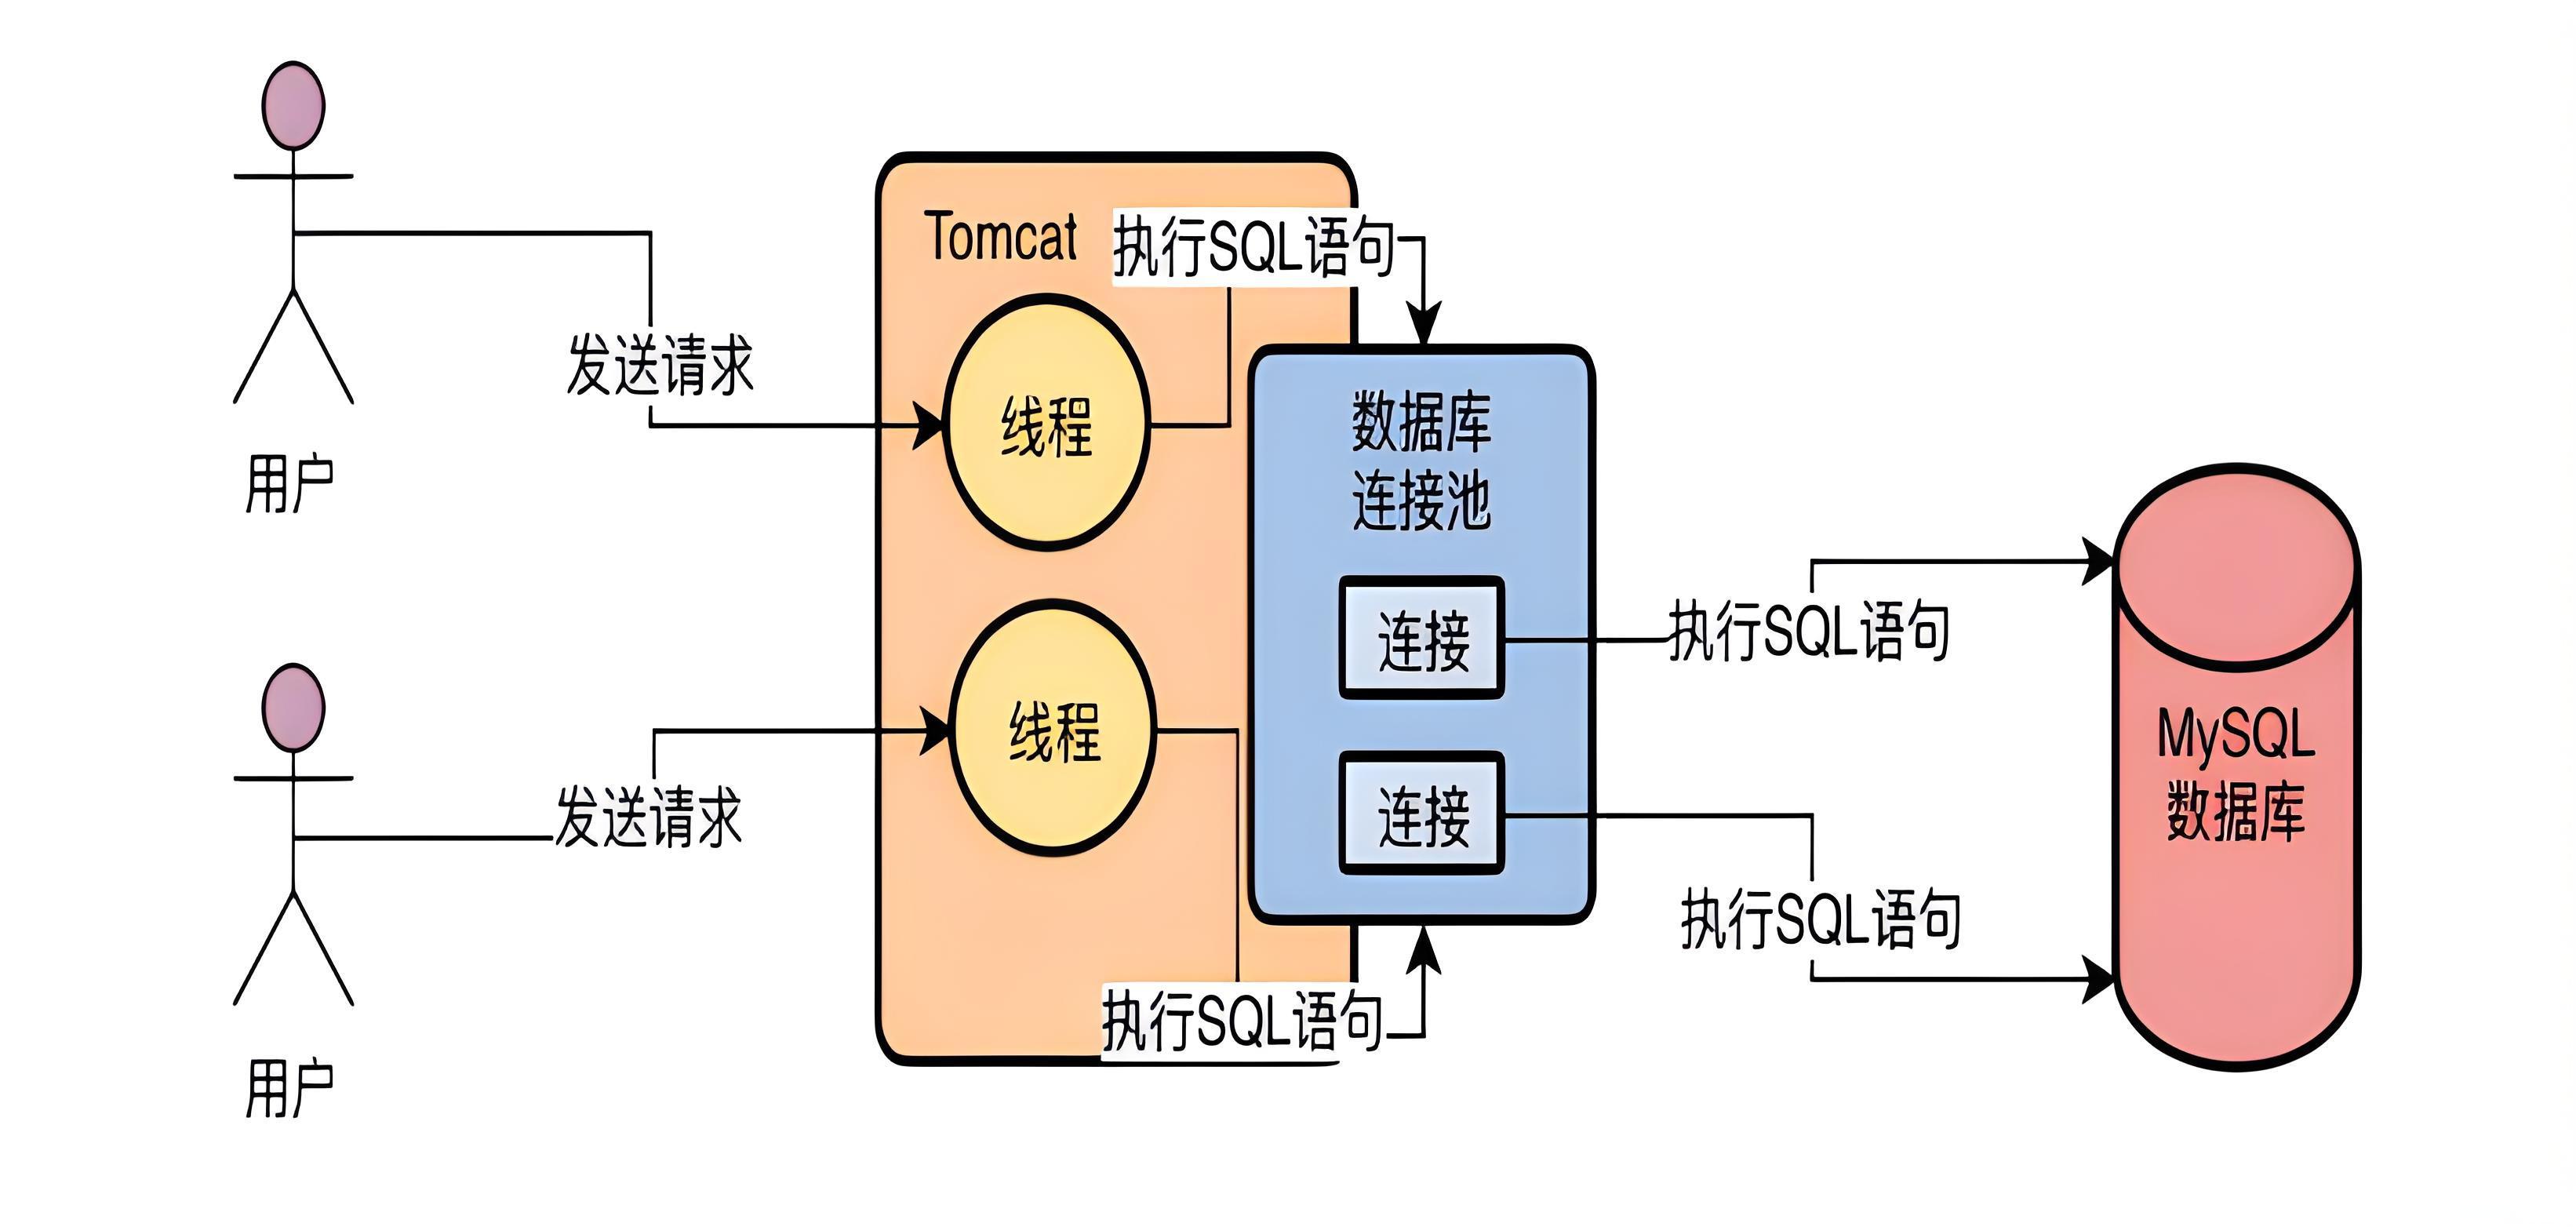
 软件环境
Druid Starter官方网址:https://github.com/alibaba/druid/tree/master/druid-spring-boot-starter
Druid帮助文档:https://github.com/alibaba/druid/wiki/%E9%A6%96%E9%A1%B5
Druid源代码工程:https://github.com/alibaba/druid
Druid官方文档
https://github.com/alibaba/druid/wiki
Druid配置文档
https://github.com/alibaba/druid/wiki/DruidDataSource配置属性列表
Druid最佳实践
https://github.com/alibaba/druid/wiki/DruidDataSource配置
摘要
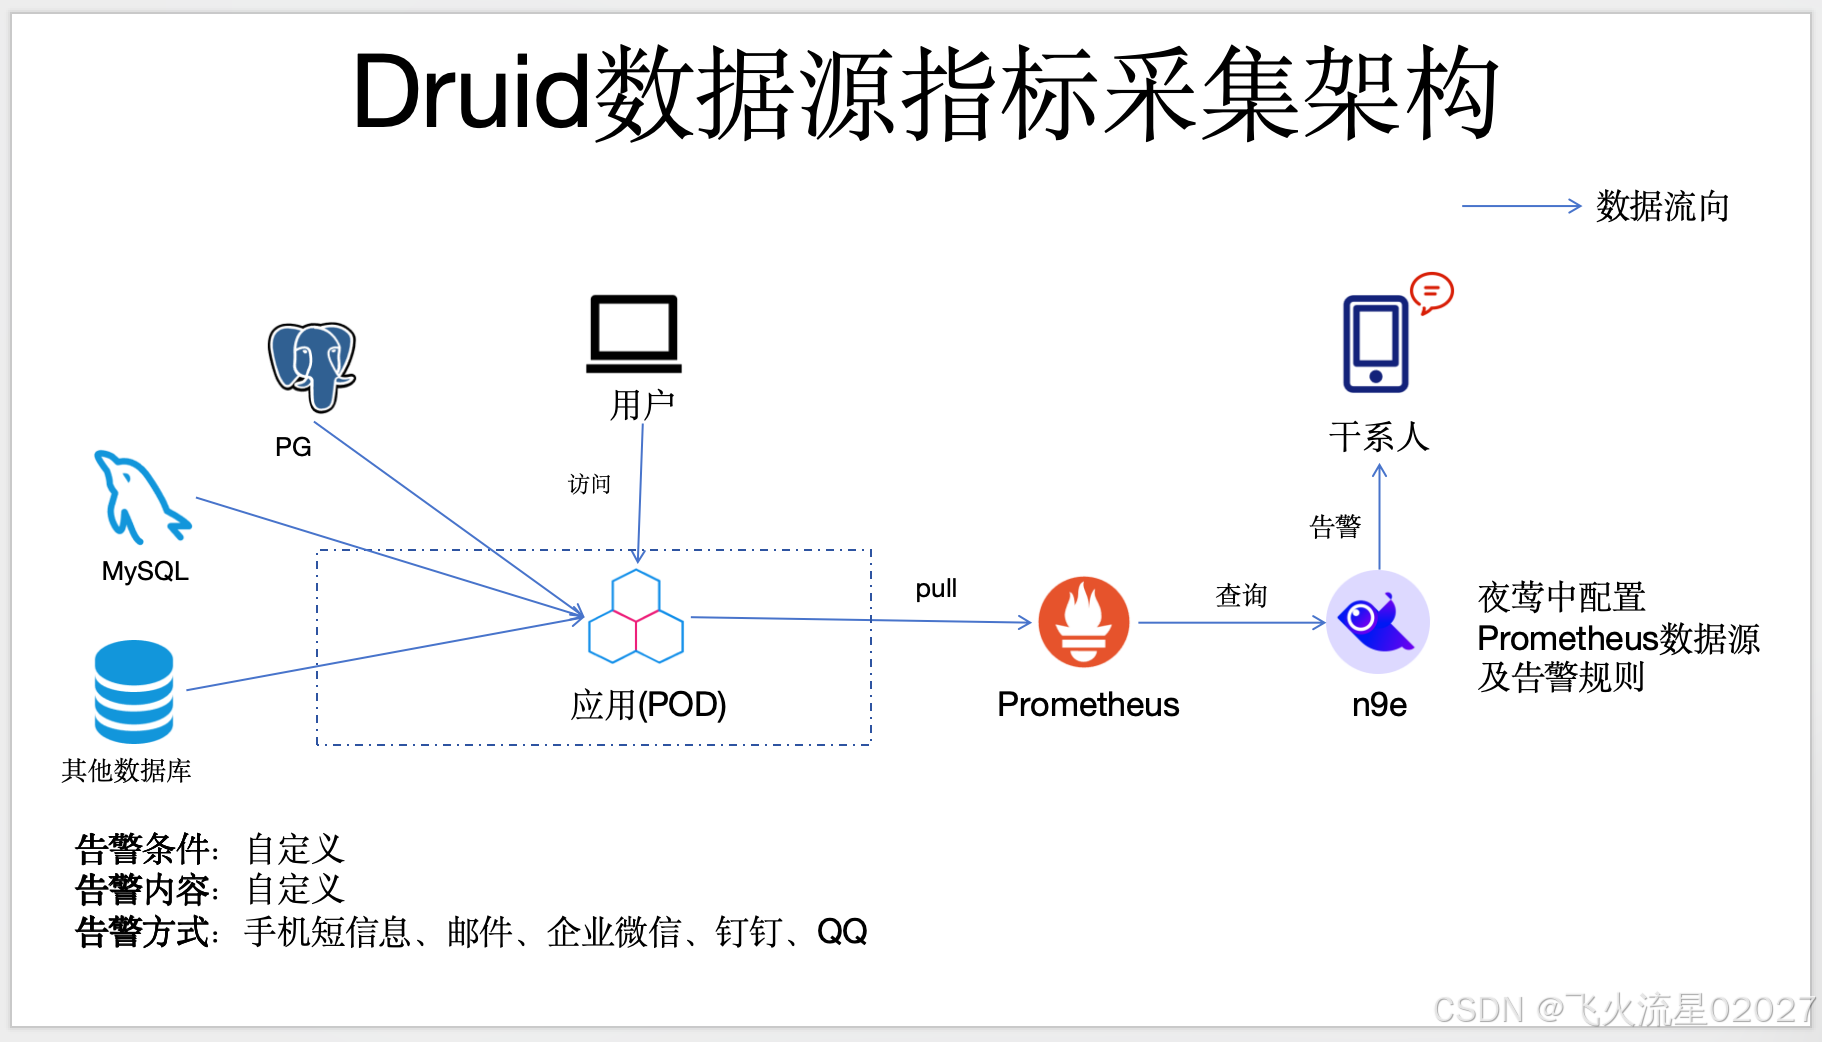
Druid数据源指标监控分数据采集和指标告警,是指通过开发java代码获取应用的Druid数据源指标并暴露到应用的指标端点,然后通过普米等监控工具拉取该指标,然后通过alert-manager、n9e等告警工具配置域值从而实现告警和监控的能力。
本文亮点
1、实现了一般的Druid数据源监控,
2、还额外支持tomcat内置JNDI做为底层数据源的Druid数据源监控
3、如需实现HikariCP数据源指标采集只需改一下代码中的指标名即可(代码可复用)
特别说明
Springboot2的较新版本自带HikariCP且默认HikariCP,且不需要额外开发,自带此类监控指标。如果需要附加其他指标tag(属性)可参考此文稍作修改。
标签
JNDI数据源指标监控、Druid指标监控、HikariCP指标监控
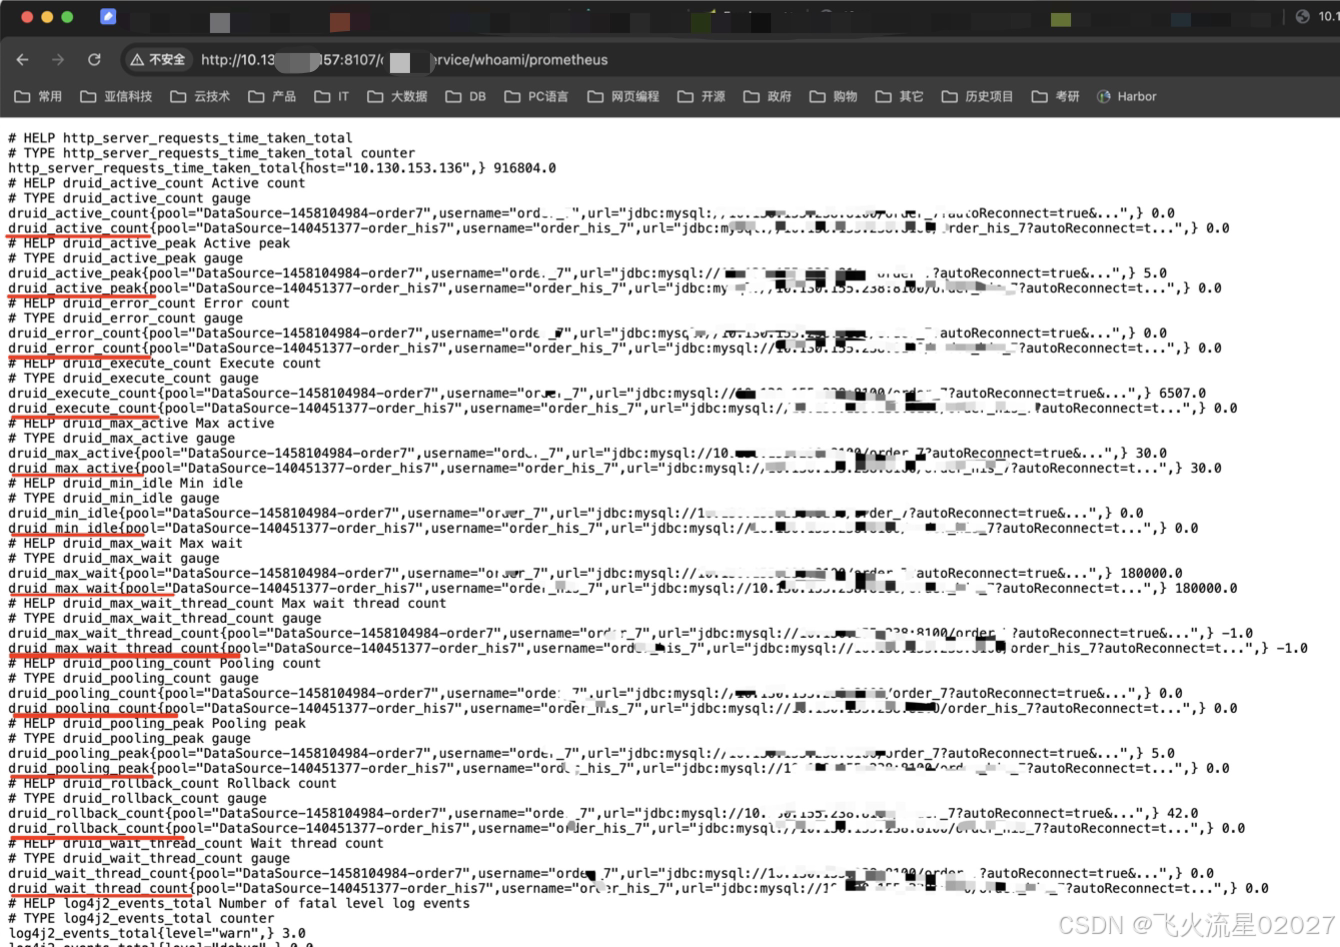
一、效果图
二、数据流图/组件架构图
三、代码
1、Druid数据源指标配置类
package person.daizhongde.common.monitor.druid;

import person.daizhongde.datasources.DynamicDataSource;// AbstractRoutingDataSource 的实现类,用于支持Druid代理tomcat JNDI数据源
import com.alibaba.druid.pool.DruidDataSource;
import io.prometheus.client.CollectorRegistry;
import lombok.extern.slf4j.Slf4j;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.autoconfigure.condition.ConditionalOnClass;
import org.springframework.boot.autoconfigure.condition.ConditionalOnProperty;
import org.springframework.boot.jdbc.DataSourceUnwrapper;
import org.springframework.context.annotation.Configuration;

import javax.sql.DataSource;
import java.util.Collection;
import java.util.LinkedHashMap;
import java.util.Map;

/**
 * @Description:    Druid数据源指标配置类
 * @Author:         bricklayer(飞火流星02027)
 * @CreateDate:     2024/10/23 10:28 AM
 * @Version:        1.0
 */
@Slf4j
@Configuration
@ConditionalOnClass({DruidDataSource.class, CollectorRegistry.class})
@ConditionalOnProperty(name = "monitor.datasource.druid.enabled", havingValue = "true", matchIfMissing = false )
public class DruidMetricsConfiguration {
    private static final Logger LOGGER = LoggerFactory.getLogger(DruidMetricsConfiguration.class);
    private final CollectorRegistry registry;

    public DruidMetricsConfiguration(CollectorRegistry registry) {
        this.registry = registry;
    }

    @Autowired
    public void bindMetricsRegistryToDruidDataSources(Collection<DataSource> dataSources) {
        Map<String, DruidDataSource> druidDataSources = new LinkedHashMap<>();

        for (DataSource dataSource : dataSources) {
            // 如果没有使用动态数据源代理可以注释掉if代码,只保留else中的
            if(dataSource instanceof DynamicDataSource){
                DynamicDataSource dynamicDataSource = (DynamicDataSource)dataSource;

                Map<Object, Object> map = dynamicDataSource.getTargetDataSources();

                //Lambda表达式
                map.forEach((k,v) ->{
                    // key 为 name  , v为 datasource
                    log.info("数据源:{}====={}",k, v);
//                    System.out.println("$$$$$$$$$$$$$$  test5  $$$$$$$$");
                    DataSource crmDataSource = (DataSource) map.get(k);
                    DruidDataSource druidDataSource = DataSourceUnwrapper.unwrap(crmDataSource, DruidDataSource.class);
                    if (druidDataSource != null) {
                        druidDataSources.put(druidDataSource.getName()+"-"+k, druidDataSource);
                    }else{

                        Object obj1 = map.get(k);
                        try {
                            druidDataSource = (DruidDataSource)DruidAopUtils.getProxyTarget(obj1 );
                            druidDataSources.put( druidDataSource.getName()+"-"+k,  druidDataSource );
                        } catch (Exception e) {
                            log.error("DruidAopUtils获取Druid数据源代码时出错!error:{}",e.getLocalizedMessage());
                            throw new RuntimeException(e);
                        }
                    }
                });
            }else{
                DruidDataSource druidDataSource = DataSourceUnwrapper.unwrap(dataSource, DruidDataSource.class);
                if (druidDataSource != null) {
                    druidDataSources.put(druidDataSource.getName(), druidDataSource);
                }
            }
        }
        DruidCollector druidCollector = new DruidCollector( druidDataSources );
        druidCollector.register(registry);
    }
}
2、Druid数据源指标聚合类
package person.daizhongde.common.monitor.druid;

import com.alibaba.druid.pool.DruidDataSource;
import io.prometheus.client.Collector;
import io.prometheus.client.GaugeMetricFamily;

import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;
import java.util.Map;
import java.util.function.Function;

/**
 * @Description:    Druid数据源指标聚合类
 * @Author:         bricklayer(飞火流星02027)
 * @CreateDate:     2024/10/23 10:28 AM
 * @Version:        1.0
 */
public class DruidCollector extends Collector {

    private static final List<String> LABEL_NAMES = new ArrayList<String>();
    static {
        LABEL_NAMES.add("pool");
        LABEL_NAMES.add("username");
        LABEL_NAMES.add("url");
    }

    private final Map<String, DruidDataSource> dataSources;

    public DruidCollector(Map<String, DruidDataSource> dataSources) {
        this.dataSources = dataSources;
    }

    @Override
    public List<MetricFamilySamples> collect() {
        return Arrays.asList(
                createGauge("druid_active_count", "Active count",
                        druidDataSource -> (double) druidDataSource.getActiveCount()),
                createGauge("druid_active_peak", "Active peak",
                        druidDataSource -> (double) druidDataSource.getActivePeak()),
                createGauge("druid_error_count", "Error count",
                        druidDataSource -> (double) druidDataSource.getErrorCount()),
                createGauge("druid_execute_count", "Execute count",
                        druidDataSource -> (double) druidDataSource.getExecuteCount()),
                createGauge("druid_max_active", "Max active",
                        druidDataSource -> (double) druidDataSource.getMaxActive()),
                createGauge("druid_min_idle", "Min idle",
                        druidDataSource -> (double) druidDataSource.getMinIdle()),
                createGauge("druid_max_wait", "Max wait",
                        druidDataSource -> (double) druidDataSource.getMaxWait()),
                createGauge("druid_max_wait_thread_count", "Max wait thread count",
                        druidDataSource -> (double) druidDataSource.getMaxWaitThreadCount()),
                createGauge("druid_pooling_count", "Pooling count",
                        druidDataSource -> (double) druidDataSource.getPoolingCount()),
                createGauge("druid_pooling_peak", "Pooling peak",
                        druidDataSource -> (double) druidDataSource.getPoolingPeak()),
                createGauge("druid_rollback_count", "Rollback count",
                        druidDataSource -> (double) druidDataSource.getRollbackCount()),
                createGauge("druid_wait_thread_count", "Wait thread count",
                        druidDataSource -> (double) druidDataSource.getWaitThreadCount())

                // 还可添加其他指标
                // .....
        );
    }

    private GaugeMetricFamily createGauge(String metric, String help,
                                          Function<DruidDataSource, Double> metricValueFunction) {
        GaugeMetricFamily metricFamily = new GaugeMetricFamily(metric, help, LABEL_NAMES);
        dataSources.forEach((s, druidDataSource) -> {

            List<String> list = new ArrayList<String>();
            list.add(s);
            list.add(druidDataSource.getUsername());
            String url = druidDataSource.getUrl();
            url = url.length()>60?url.substring(0,60)+"...":url;
            list.add( url );

            metricFamily.addMetric(
                list,
                metricValueFunction.apply(druidDataSource)
            );
        });
        return metricFamily;
    }
}
3、从代理对象中取druid数据源对象的工具类
package person.daizhongde.common.monitor.druid;

import org.springframework.aop.framework.AdvisedSupport;
import org.springframework.aop.framework.AopProxy;
import org.springframework.aop.support.AopUtils;

import java.lang.reflect.Field;

/**
 * @Description: 从代理对象中取druid数据源对象的工具类
 * @Author:         bricklayer(飞火流星02027)
 * @CreateDate:     2024/10/23 10:28 AM
 * @Version: 1.0
 */
public class DruidAopUtils {
    public static Object getProxyTarget(Object proxy) throws Exception {
        //判断是否是代理对象
        if(AopUtils.isAopProxy(proxy)){
            //cglib 代理
            if(AopUtils.isCglibProxy(proxy)){
                //通过暴力反射拿到代理对象的拦截器属性,从拦截器获取目标对象
                Field h = proxy.getClass().getDeclaredField("CGLIB$CALLBACK_0");
                h.setAccessible(true);
                Object dynamicAdvisedInterceptor = h.get(proxy);

                Field advised = dynamicAdvisedInterceptor.getClass().getDeclaredField("advised");
                advised.setAccessible(true);
                Object target = ((AdvisedSupport)advised.get(dynamicAdvisedInterceptor)).getTargetSource().getTarget();
                //返回目标对象
                return target;
            }
            //jdk代理
            if(AopUtils.isJdkDynamicProxy(proxy)){
                //通过暴力反射拿到代理对象的拦截器属性,从拦截器获取目标对象
                Field h = proxy.getClass().getSuperclass().getDeclaredField("h");
                h.setAccessible(true);
                AopProxy aopProxy = (AopProxy) h.get(proxy);

                Field advised = aopProxy.getClass().getDeclaredField("advised");
                advised.setAccessible(true);

                Object target = ((AdvisedSupport)advised.get(aopProxy)).getTargetSource().getTarget();

                return target;
            }
        }
        return null;
    }
}
附件一、参考资料(不支持JNDI数据源)
https://github.com/lets-mica/mica
https://github.com/feicuimeipo/nx-cloud
https://github.com/gtiger666/taotao-cloud-project
当前github上实现该功能的项目约21个,上面列举了排名靠前的3个
附件二:Springboot 应用中Druid数据库连接池常用指标及指标名
在使用Spring Boot结合Druid数据库连接池时,了解和监控连接池的性能和健康状态是非常重要的。Druid提供了丰富的监控指标,帮助开发者了解连接池的使用情况、性能瓶颈以及可能的配置问题。以下是一些常用的Druid数据库连接池指标及其对应的指标名,这些指标主要通过Druid的监控页面或JMX(Java Management Extensions)来查看。
1. 基本指标
-
ActiveConnections:当前活跃的连接数。
-
Connections:当前空闲的连接数。
-
CreateCount:自启动以来创建的连接数。
-
DestroyCount:自启动以来销毁的连接数。
-
PoolingCount:当前在池中的连接数。
-
WaitThreadCount:等待获取连接的线程数。
2. 性能指标
-
ConnectError:建立连接的错误次数。
-
ConnectTimeout:建立连接的超时次数。
-
MaxWait:获取连接所等待的最大时间(毫秒)。
-
MaxWaitThreadCount:等待时间最长的线程数。
-
NotEmptyWaitCount:连接池非空时,等待获取连接的次数。
-
NotEmptyWaitMillis:连接池非空时,等待获取连接的总时间(毫秒)。
3. 配置与限制
-
MaxActive:池中最大活跃连接数。
-
MinIdle:池中最小空闲连接数。
-
InitialSize:初始化时建立连接的数目。
-
MaxWait:获取连接时的最大等待时间(毫秒)。
-
TimeBetweenEvictionRunsMillis:两次检查连接是否有效的间隔时间(毫秒)。
-
MinEvictableIdleTimeMillis:连接在池中最小生存时间(毫秒),到达这个时间后,默认逐出连接。
-
MaxEvictableIdleTimeMillis:连接在池中最大生存时间(毫秒),到达这个时间后,逐出连接,不再使用时立即关闭。
4. 异常与警告
-
ErrorBorrowConnection:从池中获取连接时发生的错误次数。
-
ErrorPutBackConnection:归还连接时发生的错误次数。
-
NotClosedConnections:未关闭的连接数。
5. 性能优化指标
-
RemoveAbandoned:是否移除弃用(超过removeAbandonedTimeout)的连接。
-
RemoveAbandonedTimeout:超过时间限制被视为被遗弃而应被清除的时长(秒)。
-
TestOnBorrow:当从池中借用连接时,是否执行connection.isValid()验证。
-
TestOnReturn:当归还到池中时,是否执行connection.isValid()验证。
-
TestWhileIdle:当连接空闲时,是否执行connection.isValid()验证。
如何查看这些指标?
-
Druid Stat页面:在启动Spring Boot应用后,通常可以通过访问
http://localhost:8080/druid/index.html来访问Druid的监控页面(端口和路径可能根据配置不同而变化)。在这个页面上,你可以看到上述提到的所有指标以及它们的当前值和历史趋势图。 -
JMX监控:你也可以通过JMX连接到你的应用,然后使用JConsole或者VisualVM等工具来查看和管理这些指标。在JMX中,你可以找到
com.alibaba.druid.pool下的相关MBean来获取和监控这些指标。
通过这些指标,你可以更好地理解你的数据库连接池的运行状态,及时发现并解决潜在的性能问题或配置错误。
 426


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


