kafka与zk的leader选举的混沌不清

【信息科学与工程学】计算机科学与自动化 第二百三十三篇 凤凰架构01 编号类型领域系统软件/硬件或系统集成方案及系统架构模块子模块函数名称/算法名称算法的数学分析及计算机体系架构及数据结构与算法详细设计及参数列表及数值范围设计关联知识1共识算法分布式基石状态机复制架构:Proposer/Acceptor/Learner 多节点角色模型,基于操作转移(Operation Transfer)分布式共识PaxosPaxos 协议(Prepare/Promise/Accept/Accepted 两阶段)数学基础:多数派(Quorum)投票,基于鸽巢原理保证 W+R>N 时读写集合必有 阅读详情

在kafka中,同个topic下的partition分布在多个broker中,topic下的partitions使用zookeeper进行分布式协调,可以说kafka与zk是牢牢联系在一起的。但其中,都存在leader选举、主从复制、同步有效个数(zk是超过一半,kafka则是在isr列表中个数),在学习的初始造成一些混淆与困惑。

认清zookeeper的leader选举的内与外

内
一般书籍或者网络上提到zk的leader选举,指是的zk集群内部多台zk机器的选举。zk集群中多台机器都会存在全量数据,有且只有一台机器是zk集群的leader,负责zk集群的写入,事务提交等工作。但leader宕机时候,zk切换到leader选举模式(平时是数据同步,即进行数据复制模式),每台机器都根据zxid和serverId投票出新的leader。zk在cap理论模型中,支持的是ap,也即会存在不可用的风险,这也是被诟病作为服务治理配置中心的缺点。且客户端在连接的zk节点(客户端可以连接zk集群中任何一台机器,读的时候在连接的机器上进行,写的时候由连接的机器转发到leader进行)断开时候,客户端重连新的zk机器,也只会选择zxid不小于当前客户端缓存的机器。

外
集群管理是zk输出给外部的能力,如kafka的partitions副本使用zk提供的集群管理功能,达到多个partition副本间能进行leader选举。外部的机器在kafka中的体现就是一个目录下的多个znode节点,如下图所示
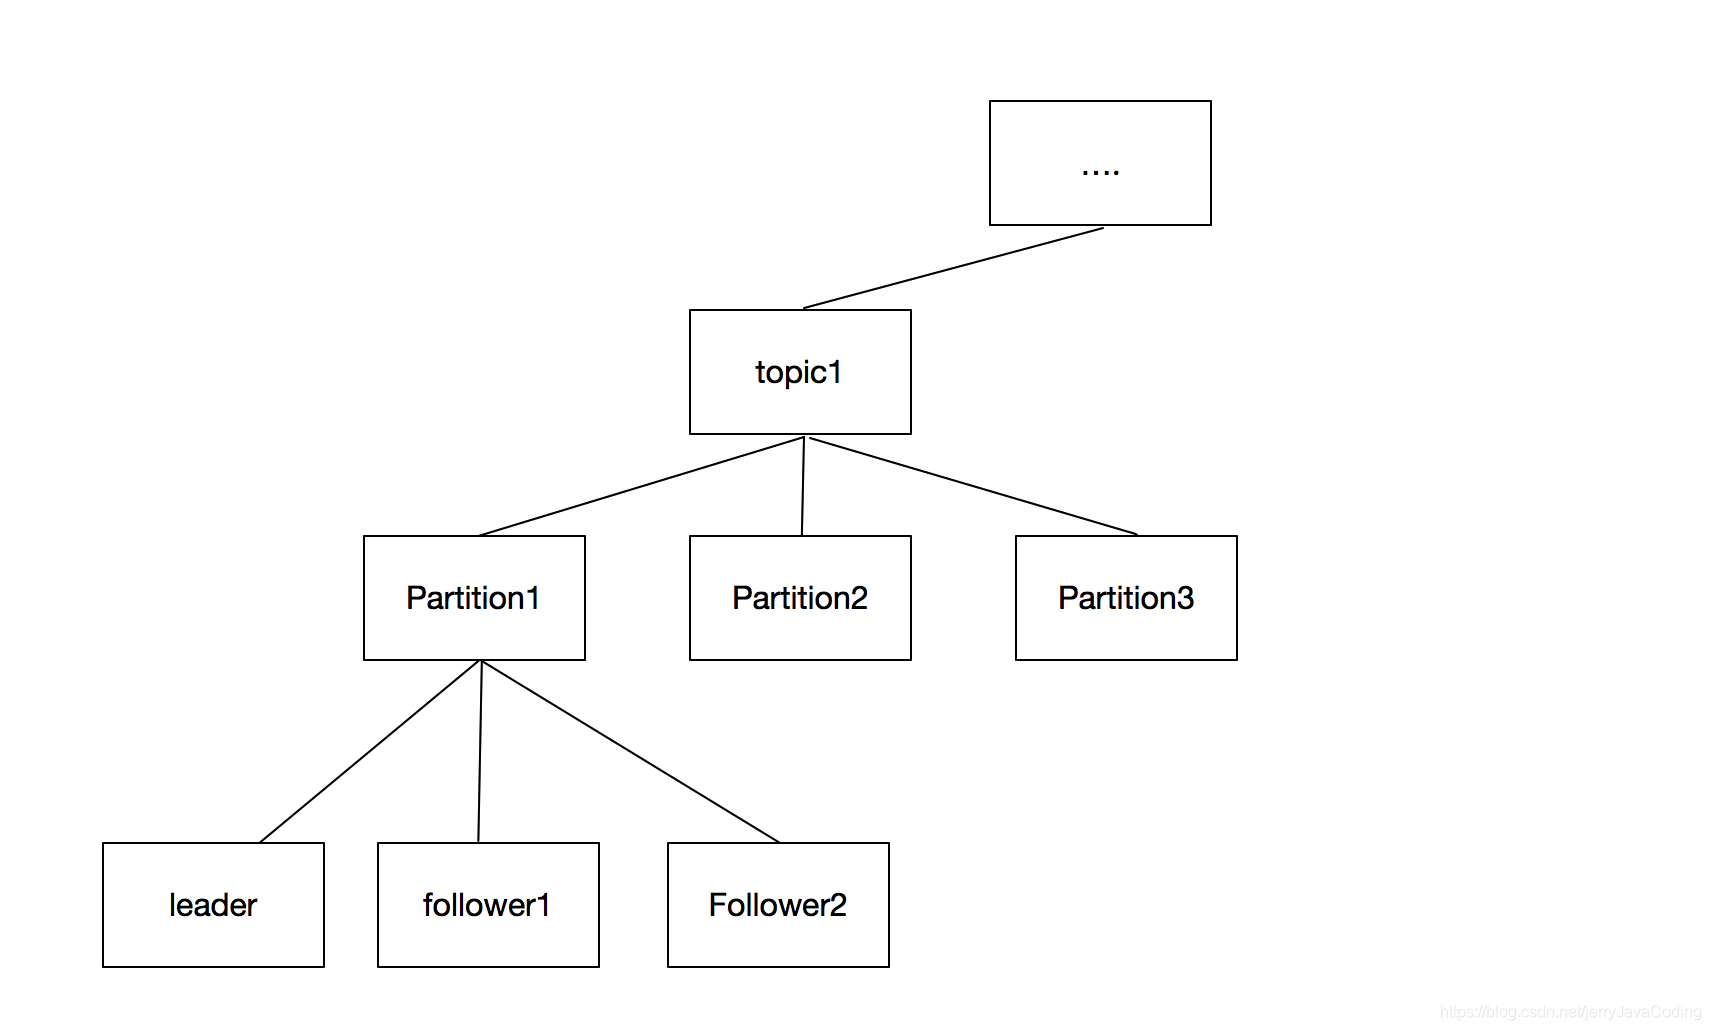
kafka在zk中的存储
而上图所示的数据,在每个zk的集群节点机器上,都会冗余存储。kafka使用的leader选举并非是zk自身用于选举zk leader节点的方法(这是zk集群内部的能力,对于框架使用者不需要了解),而是使用类似zk提供的分布式锁能力,kafka各个副本节点只会有一个当选leader,当leader释放或者宕机,其他副本节点再重新当选leader。

zk与kafka数据同步的作用对象

zab协议是在zk集群节点上用于同步节点数据,所以同步的是同一个znode节点上的数据,比如将上图值为的“leader”的节点数据同步到集群中其他机器上的,同个目录结构上的”leader",使用类似两阶段提交的方式,由leader推行推送控制。
而kafka的主从同步是副本之间的,在zk中即是上图的“leader”节点将数据复制到“follower1”节点,不同的节点中复制不受zk管控,而且数据也不会存在zk中。kafka使用follower主动拉取leader的方式,定义isr列表进行同步,所以针对的是不同的znode之间的数据同步。

cursor提供的leader选举的两种方式

实际应用开发中使用cursor框架作为zk的客户端,提供了两种方式的leader选举

  • leaderLatch
    类似于java的countDownLatch,只有一个节点选中为leader,其他的节点处于await方法的阻塞中,当调用close或者失效时候断开给其他节点
  • leaderElection
    每个节点都能当选leader,当选后调用节点的takeLeadership方法,方法调用完后就会释放leader角色,如果希望能继续持有leader角色,就要写个死循环。该方法能对于领导权进行控制,在适当时候可以进行释放,相对于前者有更大的领导控制权(前者是当选后通知,其他一直处于阻塞)

【信息科学与工程学】【运营科学】第二篇 C4信息与通信网络运营 (C4) ——数据中心网络运营04 典型值:λ1​∈[−0.02,−0.01], λ2​∈[−0.01,0], η1​,η3​∈[0.1,0.3], η2​,η4​∈[0.05,0.15]参数:δ1​∈[−0.8,−0.3], δ2​∈[−0.5,−0.2], δ3​∈[−0.4,−0.1], δ4​∈[−0.6,−0.2]参数:φ1​∈[0.1,0.3], φ2​∈[−0.2,−0.05], φ3​∈[−0.1,0.1], φ4​∈[−0.3,−0.1]参数:α∈[0.3,0.6], β∈[0.2,0.4], γ∈[0.01,0.03] 阅读详情

相关推荐

【信息科学与工程学】【数据中心】第三十五篇 云计算数据中心的学科知识04

编号学科(课程)核心知识点在云计算/云存储/云网络/云安全/云MaaS中的作用代表教材/资料/论文 + 数学方程式列表工业界应用D1421​云原生数据库:TiDB​HTAP(混合事务/分析处理)、分布式SQL、水平扩展、强一致(Raft)、自动故障恢复、与MySQL兼容、TiFlash列式引擎提供弹性扩展的分布式数据库;支撑高并发在线交易与实时分析教材:《TiDB in Action》PingCAP(2020) 论文:《TiDB: A Raft-based HTAP Database》(2017)

weixin_49199313的博客 404

kafka架构组件概念详解:Broker、Topic、Partition、Leader/Follower、Consumer Group、zookeeper

消息队列mq的两种模式 发布订阅模式分为两种:①队列推送数据(消费者能力不平均);②消费者拉取消息(要维护一个长轮询)。kafka属于消费者主动拉取数据的模式。 kafka架构 Broker kafka服务器。 Topic主题 不同消息的分类。将消费分类。topic包含多个partition,partition有leader和follower备份机制,leader挂掉follower会上升为leader。 Partition分区 分区是为了提高主题Topic的负载能力。消息会轮询发送到同一Topi

学亮编程手记 7351

【信息科学与工程学】计算机科学与自动化——第三十五篇 调度理论和调度算法01——资源调度算法

算法逻辑

weixin_49199313的博客 685

kafka和ZK的关系

kafka和zk的基本交互关系 1,kafaka集群的 broker,和 Consumer 都需要连接 Zookeeper。Producer 直接连接 Broker。 2,Producer 把数据上传到 Broker,Producer可以指定数据有几个分区、几个备份。上面的图中,数据有两个分区 0、1,每个分区都有自己的副本:0'、 1'。 3,leader 处理 partition 的所有读写请求,与此同时,follower会被动定期地去复制leader上的数据。 4,如果leader发生故障

Elfe_的博客 5948

【信息科学与工程学】【数据中心】第三十二篇 云数据中心的计算/存储/网络的核心挑战01

状态方程: SOCk+1​=SOCk​−Qn​ik​Δt​;: 三相电流变换到αβ坐标系: iα​=32​​(ia​−21​ib​−21​ic​), iβ​=32​​(23​​ib​−23​​ic​). 计算瞬时有功功率p和无功功率q,经低通滤波器分离直流分量,反变换得基波电流,差值即为谐波指令。: 节点i的信念 bi​(xi​)=ϕi​(xi​)∏j∈N(i)​mji​(xi​), 消息 mij​(xj​)=∑xi​​ϕi​(xi​)ψij​(xi​,xj​)∏k∈N(i)\j​mki​(xi​).

weixin_49199313的博客 218

【产品体系】第六十五篇 Nacos / HiClaw / HiMarket 体系01

子系统核心现象主力数学工具​变更传播 fan-out / cache staleness图 fan-out 分析、概率上界 P(Tstale​)、logical-clock version monotonicityHigress 网关​突发限流、延迟堆积排队论 (M/G/1)、Token/Leaky Bucket ODE、Little's Law L=λWHiMarket 检索​语义匹配召回、去冗余。

weixin_49199313的博客 61

ZooKeeper与Kafka介绍

ZooKeeper介绍 官网:http://zookeeper.apache.org/ ZooKeeper是一个分布式协调服务,它的主要作用是为分布式系统提供一致性服务,提供的功能包括:配置维护、命名服务、分布式同步、组服务等。Kafka的运行依赖ZooKeeper。 ZooKeeper最早起源于雅虎研究院的一个研究小组。在当时,研究人员发现,在雅虎内部很多大型系统基本都需要依赖一个类似的系统来...

变成习惯 3万+

kafka的分区的leader和follower

在kafka中,每个topic都可以配置多个分区以及多个副本。每个分区都有一个leader以及0个或者多个follower,在创建topic的时,kafka会将每个分区的leader均匀的分配在每个broker上。我们正常使用kafka是感觉不到leader,follower的存在的。但其实,所有的读写操作都是由leader处理,而所有的follower都复制leader的日志数据文件,如果leader出现故障时,follower就会被选举为leader。所以,可以这样说: kafka中的leader负责处

科学的N次方 5892

zookeeper和kafka

目录 一、zookeeper理论 1、zookeeper定义 2、zookeeper工作机制 3、zookeeper特点 4、zookeeper的数据结构 5、zookeeper应用场景 6、zookeeper的选举机制 6.1 第一次启动时选举机制 6.2非第一次启动时选举机制 二、部署Zookeeper 集群 1、环境准备 2、安装zookeeper 2.1 安装zookeeper 软件包 2.2 修改配置文件 3、每个节点上创建数据目录和日志目录 4、在每个节点的d

abjava1的博客 1463

【实战揭秘】高胜率集合竞价抓涨停策略:融合MACD背离与斐波那契的量化模型

本文揭秘了一种高胜率集合竞价抓涨停策略,融合MACD背离与斐波那契数列的量化模型。通过量能异动、技术形态突破和资金共识形成的交叉验证,该策略在实盘中表现出色。文章详细解析了MACD背离的量化实现细节、斐波那契数列的实战应用,以及策略的量化建模过程,帮助投资者提升交易胜率。

herb5的博客 1561

CAN总线BusOff恢复机制详解:快慢恢复策略在车载网络中的实战应用

本文深入解析了CAN总线BusOff恢复机制,重点阐述了快慢恢复策略在车载网络中的工程应用。通过对比NXP S32K与STM32平台的实现代码,并结合CANoe仿真与参数优化方法,为工程师提供了从理论到实战的完整解决方案,旨在提升车载网络的可靠性与功能安全。

7up55的博客 615

Zookeeper集群 + Kafka集群

主要原因是由于在高并发环境下,同步请求来不及处理,请求往往会发生阻塞。比如大量的请求并发访问数据库,导致行锁表锁,最后请求线程会堆积过多,从而触发 too many connection 错误,引发雪崩效应。我们使用消息队列,通过异步处理请求,从而缓解系统的压力。消息队列常应用于异步处理,流量削峰,应用解耦,消息通讯等场景。当前比较常见的 MQ 中间件有 ActiveMQ、RabbitMQ、RocketMQ、Kafka 等。

Z的博客 352

nsight-system教程

参考nsight-compute使用教程-优快云博客。

youzjuer的博客 1894

【Kafka源码解读和使用指南】第65篇:Kafka故障转移实战——Broker宕机了怎么办

Kafka故障转移实战:Broker宕机处理指南 本文详细解析Kafka集群中Broker宕机后的完整故障转移流程,帮助运维人员快速应对生产环境中的紧急情况。 故障转移全景 Kafka的高可用机制能在单个Broker宕机时自动完成Leader选举和分区重新分配。典型流程包括: 自动恢复阶段:Controller通过ZooKeeper心跳检测Broker状态,在6-8秒内完成Leader选举 人工介入阶段:当自动恢复失败时需要手动干预 预防措施:包括脑裂处理、滚动重启等 Controller的故障检测与响应

xyghehehehe的专栏 194

《AgentScope-Java 深入浅出教程》第10章 RAG 知识检索

RAG(Retrieval-Augmented Generation,检索增强生成)是一种将信息检索与文本生成相结合的技术架构。它通过从外部知识库中检索相关文档,将检索到的信息作为上下文注入到语言模型的提示中,从而增强模型的回答质量。│ RAG 工作流程 ││ ││ 用户问题 向量检索 上下文增强 生成回答 ││ ▼ ││ │ A │ ││ ││ 1. 接收问题 ││ 2. 将问题转换为向量,在知识库中检索相似文档 ││ 3. 将检索到的文档作为上下文添加到提示词中 │。

步子哥的博客 462

基于YOLOv8/YOLOv7/YOLOv6/YOLOv5的农作物害虫检测系统(深度学习模型+UI界面+训练数据集)

随着人工智能技术在农业领域的深入应用,基于深度学习的害虫检测系统已成为智慧农业的重要组成部分。本文详细介绍了一种基于YOLOv8/YOLOv7/YOLOv6/YOLOv5的农作物害虫检测系统,涵盖算法原理、数据集构建、模型训练、系统实现及完整代码。该系统能够实时检测并识别多种农作物害虫,为农业生产提供精准的病虫害监测解决方案。

YOLO 273

ZooKeeper连接超时故障排查:从OperationTimeout到MasterNotRunningException的解决之道

在分布式系统中,ZooKeeper作为核心的协调服务,其稳定连接是保障HBase、Kafka等框架正常运行的基础。其工作原理基于客户端与服务器间的心跳机制和会话管理,一旦网络波动或服务器负载过高,便可能引发操作超时。这一问题的技术价值在于,它直接关系到分布式系统的可用性与数据一致性。典型的应用场景包括HBase Master启动时注册元数据、Kafka Controller选举等关键流程。当出现MasterNotRunningException并伴随Can't get connection to ZooKe

weixin_33671935的博客 328

摆脱英文束缚!群晖Transmission4.0.4全新中文界面攻略

在群晖安装完官方Transmission4.0.4套件后,界面是英文状态的,不太好用。但是按照网上分享的原来4.0以前版本的方法更新UI又失败,所以自己搞了下成功了,分享给需要的朋友。

XiaoqiangClub的博客 5214

kafka 副本数据同步原理和数据丢失解决方案

副本的协同机制请移步:kafka 消息分发机制、分区和副本机制(三、分区的副本机制) 副本还有一个重要的机制,就是数据同步过程,它需要解决 怎么传播消息 在向消息发送端返回 ack 之前需要保证多少个 Replica 已经接收到这个消息 一、 副本的结构 深红色部分表示 test_replica 分区的 leader 副本,另外两个节点上浅色部分表示 follower 副本 二、 数据的处理过程 Producer 在发布消息到某个 Partition 时: 先通过 ZooKeeper 找到该 Pa

weixin_43281498的博客 4804

windows使用jupyter notebook读取文件路径的几种方法和设置默认打开路径

简单分享小虎这段时间以来学到的jupyter notebook操作技巧。

狂小虎/Anthony Dave的博客 KuangXiaoHu's Blogs 1万+

通信算法之264: DJI O2 协议物理层逆向工程解析

对于 DroneID,标志之间的间隙由循环前缀 (CP) 填充:每个标志末尾的副本附加在相应标志的开头。有了关于确切标志开始的信息,可以使用 FFT 将标志转移到频域 - 来自时域的 1024 个样本导致频域中的 1024 个子载波。使用比特流的解扰和涡轮解码,并将生成的数据映射到如上的DroneID 结构,通过逆向工程在无人机的固件中找到了它。注意到一些无人机(Mavic 2 和更早的 OcuSync 无人机)不发送第一个标志(标志 1),这导致更短的帧持续时间为 576 µs。//产品型号数字代号。

leegang12的专栏 3945

ZooKeeper 基本操作 与 Java APIs

前言 在前章ZooKeeper安装(集群化)我们安装ZooKeeper集群. 本章, 我们讲解下ZooKeeper的基本操作. 命令行操作 我们通常使用zkCli.sh脚本进行登陆.登陆命令:./zkCli.sh --server 192.168.31.60:2181 其后,基本操作主要有如下几种: help命令 显示客户所支持的所有命令,如: [zk: 192.168.31.60:2181...

Be yourself. 804

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

kafka中leader和follower、AR、ISR、OSR、Controller的选举、为什么不能通过ZK的方式来选举partition的leader?

在Kafka中,每个topic都可以配置多个分区以及多个副本。每个分区都有一个leader以及0个或者多个follower,在创建topic时,Kafka会将每个分区的leader均匀地分配在每个broker上。我们正常使用kafka是感觉不到leader、follower的存在的。但其实,所有的读写操作都是由leader处理,而所有的follower都复制leader的日志数据文件,如果leader出现故障时,follower就会被选举为leader**。**

qq_40585384的博客 2676

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

es的master选举摘要

1.es的master选举采用的是自己实现的类似raft算法的方式,而不是采用zk去实现,他的master选举的依据有两点:第一点比较clusterstate的version版本,谁的版本高谁就是master,第二点:clusterstate的version版本一样的情况下,比较节点的id,谁的id比较小,谁就是master,这里的id比较小应该是有这个节点先启动的愿望在里面 2.在每一轮投票中,每个节点只投一票并汇总受到的选择本节点为master的选票,只要选择本节点为master节点的选票超过半数,那么

lixia0417mul2的博客 447

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

cursor的遍历时moveToFirst和moveToNext的区别

问题:当时刚接触sqlite和contentProvider时候记得cursor初始位置不正确 所以要moveToFirst 才能使cursor正确指向第一个位置。那么问题来了,遍历的时候要用moveToNext(在我印象中是同时使用的),所以脑海中默认写法是这样: if (cursor!=null){ try{ cur

Zero的博客 2万+

Kafka生产者

分区策略 分区的原因 (1) 方便在集群中扩展,每个 Partition 可以通过调整以适应它所在的机器,而一个 topic又可以有多个 Partition 组成,因此整个集群就可以适应任意大小的数据了; (2) 可以提高并发,因为可以以 Partition 为单位读写了。 分区的原则 我们需要将 producer 发送的数据封装成一个 ProducerRecord 对象。 (1) 指明 par...

weixin_38932035的博客 205
上一篇: Apache Kafka简介
下一篇: springMVC重定向method转换问题排查
@云师兄
博客等级 码龄10年 10粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值