


 本文深入剖析Codex与Claude在编程场景中的差异化定位:Codex适合明确任务(如修bug),以高效、精准、低沟通成本为特征;Claude擅长模糊需求(如原型设计),强调协作、解释与整体规划。文章指出模型选择本质是工作流编排问题,而非单纯性能比较,并提出基于真实任务评测集的实证选型方法,强调任务明确性、错误代价、预算限额三大决策维度,以及多模型协同(方案生成+执行+互审)的Agent级实践路径。
后台被问得最多的技术问题,不是转型,是这个:「老师,我该上Codex还是Claude?」
问的人分两拨。一拨刚看完网上的架构分析,说Codex是混合专家架构,天生适合修bug,Claude是稠密架构,天生适合氛围编程,问我是不是真的。另一拨在团队里吵过架:用Codex的说Claude话多、限额抠、干活磨叽;用Claude的说Codex出来的代码没法维护,像个不管同事死活的甩手掌柜。
前两天一个学员给我发消息,说他两个都订了,白天在公司写业务用Codex,晚上做自己的小项目用Claude。他问我:老师,我这算不算精神分裂。
我说你这不叫精神分裂,叫觉醒得比同事早。先把结论放这:这两个你都该留着,但不用平分时间。这道题九成人从第一句就答错了——它不是「哪个模型更强」,它真正在问的是:你日常干的活,长什么样。
先看两个场景。
第一个,修一个线上bug。报错堆栈贴进去,配一句「别动别的文件」。Codex的表现像接了个外包工单:不寒暄,不追问,给你一个最小改动,diff干净得像手写的。跑测试,过了,提交。社区里那句顺口流行的话就是这么来的——「Claude会跟你聊天,Codex直接出活」。那个学员的原话:「我用Codex像找外包,用Claude像招了个话多的产品经理。」
第二个,只有一个模糊想法。「做一个像Notion的笔记工具,要好用。」Claude不会马上动键盘,它会跟你聊:界面偏极简还是功能全?先出个能看的原型再迭代?然后给你实时预览、多文件规划,一条龙到能点开玩。做产品的人管这个叫懂我,Karpathy管这个叫Vibe Coding。
同一个需求扔给Codex,大概率你半夜回来看到一版功能齐但长得像后台管理系统的东西,还附赠二十个你没让它做的小优化。
于是网上流行一种解释:Claude是稠密架构,所有参数全程参与计算,像全脑思考,所以输出有整体感、有「灵魂」;Codex是混合专家架构,一次只激活少数几个专家,像分包商干活,所以快、省、准。这个比喻漂亮,但我要先泼盆冷水:两个模型的内部结构都没有完整公开,说Claude「纯稠密」本身就带猜测成分,OpenAI开源的gpt-oss确实是明确的混合专家架构,但Codex系列的正式架构从未官宣。架构决定论,目前更像一种性格描述,不是工程结论。
不过这个比喻里有一点是准的,而且足够指导实践了:这两个东西被调教成了两种性格,一种被训练成多想少做、先对齐再动手的协作型同事,一种被训练成拿到规格就闷头交付的执行型员工。你在哪个场景下干活,该要哪种性格,其实不用问任何人。
真正有意思的是,人的评价会反转。
去年十二月,Anthropic把Claude Opus 4.5的价格砍了三分之二,编程基准冲到80.9%,成了第一个在这项测试上过80%的模型。此前抱怨Claude限额太抠的一批开发者,转头就在社区里说「是时候从Codex切回Claude了」,原话我印象很深,因为说这话的人前一个月还在夸Codex不用操心。
反过来的例子也一堆。有人从Codex换到Claude,用了两个月换回去,理由是「Claude每改三行代码配三百字解释,我只想要它闭嘴干活」。还有人两个用了半年,结论是「各有各的错法,谁也别吹」。社区里对这俩的性格有一句很准的总结:一个像外包公司,你给规格,它给结果,中间不沟通;一个像结对程序员,你能盯着它干,跑偏了随时拽回来。
同一个人,同一个模型,评价从吹到踩。变量是什么?是他手里那个月的活变了,是限额政策和价格变了。这说明一个事:网上那些「程序员更喜欢谁」的投票,量的不是模型,是投票那天大家手里活的样子。
模型这边还有一层:它的「性格」按月迭代。训练方法一换、后期调教一改,今天让你恼火的毛病,下个版本可能就没了,如今风头正劲的优势,也可能两个月后变成标准配置。你要是跟着模型版本站队,这辈子都站不完。
但你的任务不会一个月换一次。你的代码库、你的发布节奏、你能容忍的返工次数,这些是按年计的。所以这道题的正确解法不是押注,是测量。
说个我们自己这行的土办法。做Agent开发的人天天被问「你们用的哪个模型好」,没有一个人用嘴回答,全部用评测集回答:攒二十条你真实干过的活,修过的bug、做过的原型、重构过的模块,定期让候选模型跑一遍,记通过率、返工率、改坏几处。跑两周,哪个适合你,数字比任何测评博主都诚实。
这套东西没有门槛,一张表就够。但据我观察,一百个开发者里跑过一遍的不到三个。大家宁可吵三个月,也不肯花两小时建个自己的记录。
如果非要给个能今天就用的判断,就三个问题。
这周的活是模糊的还是明确的?模糊的、探索性的,交给话多的那个,让它陪你把问题聊清楚;明确的、有验收标准的,交给话少的那个,扔出去等结果。
出错的代价多大?改坏了能回滚、能 overnight 重来的,选便宜的快的;错一次要开复盘会的,选稳的、可解释的,并且自己盯着diff。
你的预算和限额撑不撑得住?这一条最俗,但去年一年社区风向的摆动,一半是价格和限额驱动的,不是能力。工具好不好用之前,先确认你用不用得起、用不用得完。
还有一条比选哪个更重要:别只养一个。让话多的出方案,让话少的执行,再让它们互相审对方的代码——两个模型的盲区不一样,互相查一遍,能拦下不少单模型看不见的坑。有位开发者总结得很准:键盘上的活交给一个,commit交给另一个。
当你开始这么干,你其实已经在做一件更大的事:编排。选哪个模型不再是一道单选题,而是给你的工作流里每个环节配一台合适性格的机器。
上面说的都是拿它们当编程助手。如果你本身就是做 Agent 开发的,这道题还要再翻一层——选底座模型。
这是两道完全不同的题。编程助手选型,挑的是陪你干活的同事;Agent 底座选型,选的是要上线、要兜底、要算成本的生产组件。评判标准也跟着换:不再是你用着顺不顺手,而是工具调用稳不稳、指令遵循严不严、一次调用多少钱。写代码的模型能写对一个函数只是及格线,Agent 底座的门槛是连续几十次发出格式正确的工具调用、跨多轮还不跑偏——这两件事用的不是一个能力,很多代码写得很漂亮的模型,做底座会栽在第二条上。
更现实的一层,是国内企业落地。数据不出域是常态,私有化部署几乎是必选项。这时候开头那套架构分析反而有点用了:不是「MoE 适合修 bug」的性格论,是一笔很实的账——混合专家架构省显存,开源模型总参数一千多亿、一次只激活五十多亿,一张八十G的卡就能跑。写代码你可以在云端谁顺手用谁,做企业 Agent 底座,开源模型往往先过第一轮。
打法上给三步。原型期用官方 API,最快跑通,同时把评测集搭起来;过了原型关,带着评测集去测开源模型,哪个通过率接近、成本低一个量级,就用哪个;上线之后评测集跟着 bad case 长大,换模型、换版本,都拿它当尺子。评测集是你唯一能带过换模这道坎的行李——提示词要重写,代码要改,只有「什么算对」的定义不用改。
写到这里想起一件旧事。编程语言吵了四十年,Java和Python谁更强这种问题,现在没人认真吵了,因为所有人都默认了答案:不是谁更强,是你的活长在哪。写业务的用Java,写脚本的用Python,写内核的用C,工具箱里没有主力,只有分工。
模型是这个故事的最新一章。与其问「我该用哪个」,不如问「我的工作流里,哪个环节需要什么性格的机器」。能回答后一个问题的人,已经从工具的使用者变成了工具的设计者——这一步,比任何一次选对模型都值钱。
软件工程教了我们二十年的第一课:先定义什么是好,再谈怎么做好。选模型这道题,是它今年给的练习题。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
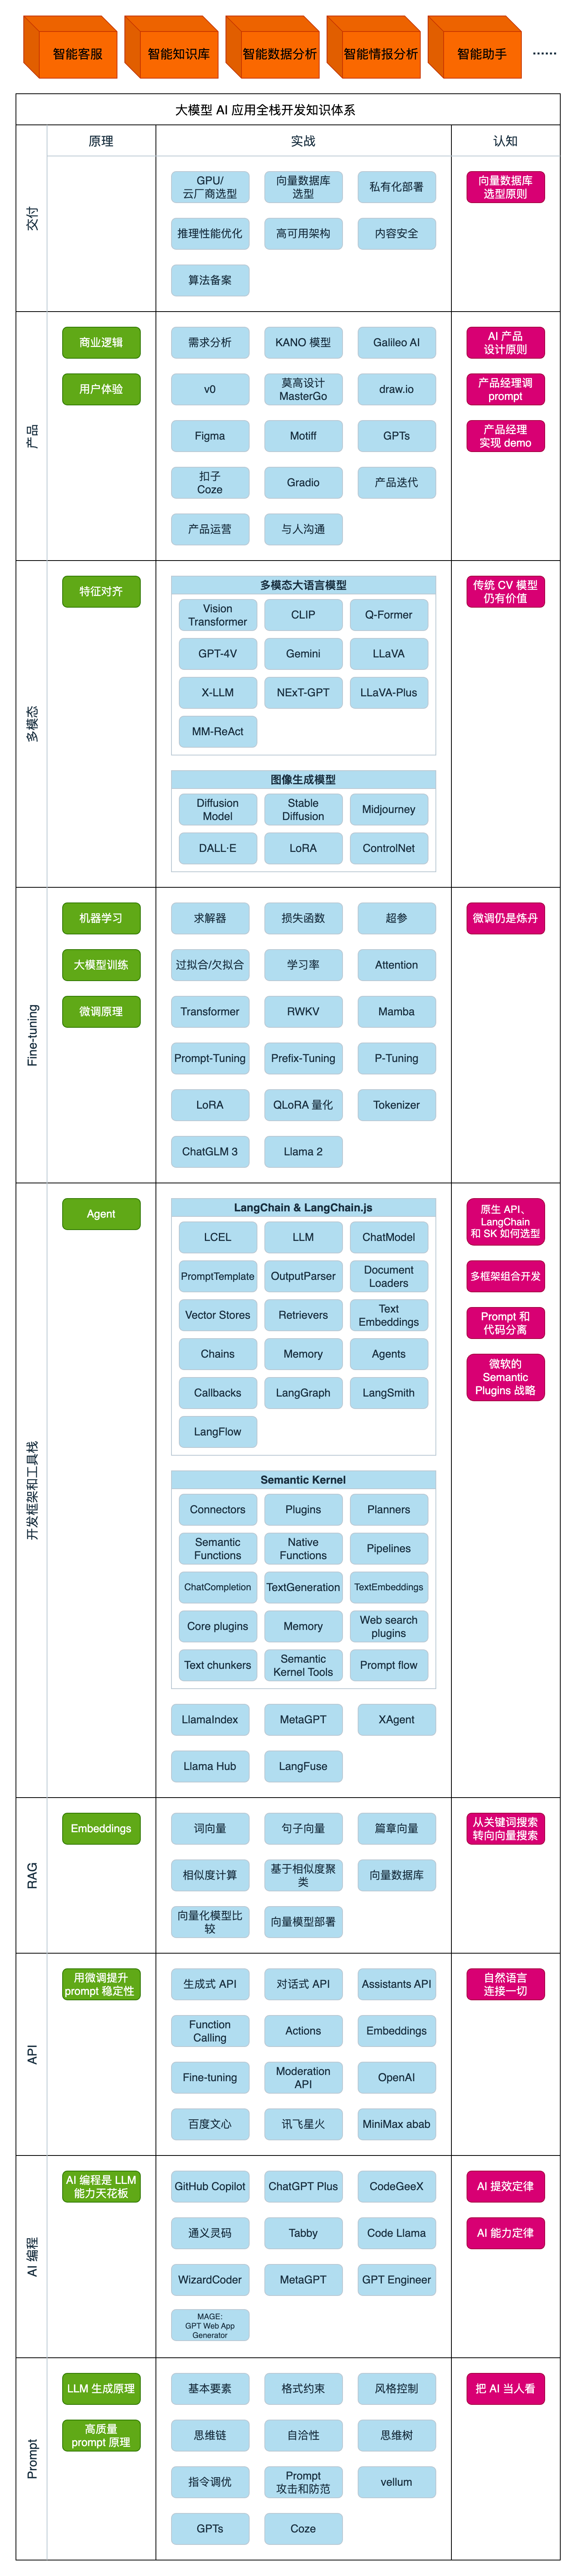
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】


 扫一扫


 702

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


