flink GROUPING SETS多维度聚合、设置Table state 到期时间

flink 使用grouping sets 实现累计窗口 -- step1 CREATE TABLE `inputtable` ( `name` STRING NOT NULL, `timeLong` STRING NOT NULL, `bizID` STRING NOT NULL, `time` STRING NOT NULL, `age` BIGINT NOT NULL, `message` STRING NOT NULL, `cloud_wise_proc_time` AS `proctime`(), ... 阅读详情

文章目录


1. GROUPING SETS

  在一个GROUP BY 查询中,根据不同的维度组合进行聚合。GROUPING SETS就是一种将多个GROUP BY逻辑UNION在一起。GROUPING SETS会把在单个GROUP BY逻辑中没有参与GROUP BY的那一列置为NULL值。空分组集意味着所有行都聚合到一个组中

SELECT supplier_id, rating, COUNT(*) AS total
FROM (VALUES
    ('supplier1', 'product1', 4),
    ('supplier1', 'product2', 3),
    ('supplier2', 'product3', 3),
    ('supplier2', 'product4', 4))
AS Products(supplier_id, product_id, rating)
GROUP BY GROUPING SETS ((supplier_id, rating), (supplier_id), ())
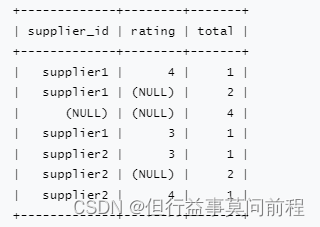
在这里插入图片描述

代码实例:


public class TableExample {
    public static void main(String[] args) throws Exception {
        // 获取流执行环境
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);
        // 读取数据源
        SingleOutputStreamOperator<Event> eventStream = env
                .fromElements(
                        new Event("Alice", "./home", 1000L),
                        new Event("Bob", "./cart", 1000L),
                        new Event("Alice", "./prod?id=1", 5 * 1000L),
                        new Event("Cary", "./home", 60 * 1000L),
                        new Event("Bob", "./prod?id=3", 90 * 1000L),
                        new Event("Alice", "./prod?id=7", 105 * 1000L)
                );
        //获取表执行环境
        StreamTableEnvironment tableEnvironment = StreamTableEnvironment.create(env);

        Table eventTable = tableEnvironment.fromDataStream(eventStream, $("url"), $("user"), $("timestamp").as("times"));
        //eventTable.printSchema();
        tableEnvironment.createTemporaryView("myTable", eventTable);


        Table resultTable = tableEnvironment.sqlQuery("select url,user,count(times) from myTable group by GROUPING SETS ((url,user),(url),(user))");

        Table setsTable = tableEnvironment.sqlQuery("SELECT supplier_id, rating, COUNT(*) AS total\n" +
                "FROM (VALUES\n" +
                "    ('supplier1', 'product1', 4),\n" +
                "    ('supplier1', 'product2', 3),\n" +
                "    ('supplier2', 'product3', 3),\n" +
                "    ('supplier2', 'product4', 4))\n" +
                "AS Products(supplier_id, product_id, rating)\n" +
                "GROUP BY GROUPING SETS ((supplier_id, rating), (supplier_id), ())");
        tableEnvironment.toChangelogStream(setsTable).print("setsTable");
  //      TableResult tableResult = tableEnvironment.executeSql("   explain plan for select url,user,sum(times) from myTable group by GROUPING SETS ((url,user),(url),(user))");

       Table rowNumTable = tableEnvironment.sqlQuery("SELECT user, url, times, row_num\n" +
                "FROM (\n" +
                " SELECT *,\n" +
                " ROW_NUMBER() OVER (\n" +
                "PARTITION BY user\n" +
                " ORDER BY CHAR_LENGTH(url) desc \n" +
                ") AS row_num\n" +
                " FROM myTable)\n" +
                "WHERE row_num <= 2");
      //  tableResult.print();

        //  Table resultTable = eventTable.select($("url"));

        //  tableEnvironment.toDataStream(resultTable).print();
        //  tableEnvironment.toChangelogStream(resultTable).print();
       // tableEnvironment.toChangelogStream(rowNumTable).print();
        env.execute();
    }
}

在这里插入图片描述


2. TTL

  在持续查询的过程中,由于用于分组的 key 可能会不断增加,因此计算结果所需要维护的状态也会持续增长。为了防止状态无限增长耗尽资源,Flink Table API 和 SQL 可以在表环境中配置状态的生存时间(TTL):

TableEnvironment tableEnv = ...
// 获取表环境的配置
TableConfig tableConfig = tableEnv.getConfig();
// 配置状态保持时间
tableConfig.setIdleStateRetention(Duration.ofMinutes(60));

或

TableEnvironment tableEnv = ...
Configuration configuration = tableEnv.getConfig().getConfiguration();
configuration.setString("table.exec.state.ttl", "60 min");

  配置 TTL 有可能会导致统计结果不准确,这其实是以牺牲正确性为代价换取了资源的释放

Flink 的state管理(1) -Flink SQL的状态清理 Flink 的状态管理Flink SQL实现状态清理 Flink SQL实现状态清理 背景:分组处理产生的结果会作为中间状态存储下来,随着分组key的不断增加,状态自然也就会不断膨胀。但是这些状态数据基本都具有时效性,不必永久保留。例如:topN语法进行去重,重复的数据一般都位于特定的区间内(例如1小时或者1天),过了这段时间之后,对应的状态就不需要了。随着时间的增长以及key的增加,面临超出存储的风险越来越大。在一些continuous queries的情况下,不得不去限制state的大小。是否去限制s 阅读详情

相关推荐

多维聚合实战:用GROUPING SETS实现动态钻取与自助分析

多维聚合是OLAP分析的核心能力,指在星型模型等维度建模基础上,对时间、地理、产品等多维度组合进行灵活切片、下钻、上卷等协同计算。其技术本质在于突破传统GROUP BY的静态局限,通过标准SQL(如GROUPING SETS)实现一次查询输出多粒度结果,兼顾ROLAP实时性与MOLAP灵活性。该能力直接支撑BI自助分析、实时数据驾驶舱和敏捷报表开发,广泛应用于零售销量归因、金融风险多维监控、电商用户行为分析等场景。本文聚焦数据工程师与BI开发者高频痛点,详解五种原子操作的SQL落地及空值处理、维度爆炸防御等

shikun520的专栏 466

FlinkSql中的时间语义和TTL

专门用来保存当前的处理时间。在创建表的DDL中定义。

qq_42456324的博客 6326

Flink SQL窗口聚合避坑指南:从GROUPING SETS到CUBE,如何高效分析用户购买行为?

本文深入解析Flink SQL窗口聚合在电商用户行为分析中的高效应用,重点介绍GROUPING SETS、ROLLUP和CUBE等高级特性的实战技巧与避坑指南。通过实际案例展示如何优化多维分析查询性能,解决NULL值歧义和级联窗口等常见问题,帮助数据工程师提升实时分析效率并降低资源消耗。

weixin_42563415的博客 377

Flink SQL 双表 JOIN 介绍与原理简析

带你探究各类 Flink SQL 语法和实现细节

cloudbigdata的博客 9155

用Flink SQL的ROLLUP和CUBE,5分钟搞定电商订单的多维度实时分析报表

本文详细介绍了如何利用Flink SQL的ROLLUP和CUBE功能,快速构建电商订单的多维度实时分析报表。通过窗口表值函数(TVF)和高级分组技术,实现秒级延迟的数据聚合,帮助电商企业在大促期间实时监控销售数据,优化运营策略。

weixin_28716181的博客 74

Flink SQL窗口聚合实战:用TVF函数+GROUPING SETS搞定电商实时销售额多维分析

本文详细介绍了如何利用Flink SQL的TVF函数和GROUPING SETS实现电商实时销售额的多维分析。通过滚动窗口(TUMBLE)、滑动窗口(HOP)和累积窗口(CUMULATE)的灵活运用,结合GROUPING SETS实现一次计算多维输出,大幅提升实时数据处理效率。文章包含完整的生产环境代码示例和优化指南,帮助开发者快速构建高性能的实时分析系统。

weixin_28702105的博客 331

Flink SQL聚合优化实战:Distinct与Grouping Sets性能提升指南

你是否还在为Flink SQL聚合查询的性能问题困扰?当数据量激增时,COUNT(DISTINCT)是否频繁引发状态膨胀?多维度分析时的GROUPING SETS是否让任务不堪重负?本文将通过实战案例,详解Flink SQL中Distinct聚合与Grouping Sets的优化技巧,帮你突破性能瓶颈,实现查询效率的数倍提升。读完本文,你将掌握: - MiniBatch与Local-Global聚...

gitblog_00267的博客 894

用Flink SQL的CUBE和ROLLUP,5分钟搞定电商订单多维度实时分析(附Kafka数据源配置)

本文详细介绍了如何利用Flink SQL的CUBE和ROLLUP功能,快速实现电商订单的多维度实时分析。通过Kafka数据源配置和窗口聚合技术,可在5分钟内搭建秒级响应的销售看板,帮助运营团队实时掌握用户、商品和时间维度的销售动态,优化促销策略。

weixin_30709061的博客 229

Flink 窗口聚合状态管理:从GROUPING SETS到多级窗口的3个进阶场景

本文深入探讨Flink窗口聚合状态管理的三个高阶场景:GROUPING SETS的多维分析、ROLLUP/CUBE的层级聚合,以及基于`window_time`的多级窗口聚合。通过实战代码示例和性能优化对比,帮助开发者掌握复杂实时数据分析技术,提升Flink在大规模数据处理中的效率与准确性。

weixin_30274627的博客 406

多维聚合实战指南:超越GROUP BY的数据操作方法论

多维聚合是BI分析、实时报表与OLAP查询的核心技术基础,其本质是在多个维度组合下对度量值进行分组计算与上下文感知的汇总。它不仅涉及SQL语法(如GROUPING SETS、ROLLUP、窗口函数),更关乎数据建模合理性、内存资源调度及业务口径一致性。在电商大促、IoT设备监控、金融风控等高频场景中,盲目使用GROUP BY易引发维度爆炸、内存溢出与结果歧义;而结合交叉分析、分组粒度控制与聚合上下文管理,才能实现亚秒级响应与灵活下钻。本文聚焦真实工程落地,详解如何通过维度亲和性分析、预聚合表设计、窗口函数帧

weixin_34224941的博客 388

多维聚合实战:从Pandas到ClickHouse的三级优化方案

多维聚合是OLAP分析的核心能力,本质是在高维空间中对指标进行灵活切片、钻取与上卷。其技术原理源于维度建模与分组聚合的协同——通过构建星型模型、预计算物化视图、合理设计排序键,将计算复杂度从运行时前置到构建时。它显著提升BI报表响应速度、降低资源消耗,并支撑自助分析、实时下钻等关键业务场景。本文聚焦工程落地,覆盖pandas透视表优化、SQL GROUPING SETS高级用法、ClickHouse物化视图与ReplacingMergeTree实战配置,兼顾可读性、性能与可维护性。

weixin_30378623的博客 365

Flink SQL 窗口聚合进阶:GROUPING SETS/ROLLUP/CUBE 3种多维分析实战

本文深入探讨了Flink SQL窗口聚合在电商实时数据分析中的高级应用,重点介绍了GROUPING SETS、ROLLUP和CUBE三种多维分析技术。通过实战案例展示如何构建高效的多维聚合查询,解决传统单维度聚合的痛点,提升实时看板的决策价值。文章还提供了性能优化策略和最佳实践,帮助开发者充分利用Flink窗口聚合的强大功能。

ciqiaofu0192的博客 437

Flink state使用

讲解flink的state的分类以及如何使用

chanyue123的博客 3897

Flink 系列之二十六 - Flink SQL - 中间算子:普通聚合

本章先讲解group by的功能,再基于group by的简单聚合函数进行演示说明。接下来一章还是讲聚合函数。但是是FlinkSQL特有的一个OVER函数,也成为“开窗函数”,虽然还没有讲到FlinkSQL如何设置窗口,但是OVER函数并不会与窗口冲突,它更像是SQL特有的窗口语法。

代码让AI扣 1167

大数据Flink(八十五):Window TVF 支持多维数据分析

这时,有离线 Hive SQL 使用经验的就会想到,如果有了 Grouping Sets,我们就可以直接用 Grouping Sets 将维度组合写在一条 SQL 中,写起来方便并且执行效率也高。对于经常需要对数据进行多维度的聚合分析的场景,您既需要对a列做聚合,也要对b列做聚合,同时要按照a、b两列同时做聚合,因此需要多次使用UNION ALL。CUBE会枚举指定列的所有可能组合作为GROUPING SETS,而ROLLUP会以按层级聚合的方式产生GROUPING SETS。也可以用于非窗口函数的场景。

Lansonli(蓝深李)的博客 779

OpenClaw记忆插件升级实战:从memory-lancedb-pro安装到AgentSkill封装

向量数据库作为现代AI应用的核心基础设施,通过将非结构化数据转换为高维向量并利用相似度检索实现语义理解。其原理基于嵌入模型生成向量表示,结合近似最近邻搜索算法实现高效查询。这项技术为智能体系统提供了长期记忆和上下文感知能力,显著提升了对话连贯性与任务执行效率。在AI智能体开发领域,向量数据库常用于知识库构建、对话历史管理和个性化推荐等场景。本文聚焦OpenClaw框架中memory-lancedb-pro插件的部署实践,针对**插件加载顺序**和**Apache Arrow依赖**两大常见痛点,通过封装成可

weixin_42525482的博客 637

Hive分析窗口函数(五) GROUPING SETS,GROUPING__ID,CUBE,ROLLUP 操作指南

问题导读1.GROUPING SETS与另外哪种方式等价?2.根据GROUP BY的维度的所有组合进行聚合由哪个关键字完成?3.ROLLUP与ROLLUP关系是什么? GROUPING SETS,GROUPING__ID,CUBE,ROLLUP 这几个分析函数通常用于OLAP中,不能累加,而且需要根据不同维度上钻和下钻的指标统计,比如,分小时、天、月的UV数。 Hive版本为 apac...

阿尼古 601

电机控制易混知识点1-基波频率/载波频率/采样频率

在电机控制学习工作中会接触到很多专业名词,其中基波频率,载波频率,采样频率是最常接触到的,特别对于电机控制小白开说,不容易理解,现对这几个概念做下总结归纳。

新能源电机控制工程师 | 聚焦实战问题,搭建互助平台 分享电机控制代码调试、现场故障排查、算法优化中的真实困惑;开放讨论电机基础知识以及工作中遇到难点等共性难题。拒绝单向输出,只做工程师的“技术树洞”与“解忧杂货铺”! 2190

【常用操作】高阶聚合函数

⌘ 总结 cube的分组组合最全,是各个维度值的笛卡尔(包含null)组合; rollup的各维度组合应满足,前一维度为null后一位维度必须为null,前一维度取非null时,下一维度随意; grouping sets则为自定义维度,根据需要分组即可。 PS:通过grouping sets的使用可以简化SQL,比group by单维度进行union all性能更好。 ⌘ 数据准备 ⌘⌘ 表结构 CREATE TABLE test (f1 string, f2 st

Together 576

YOLO系列算法改进 | 主干改进篇 | 替换LSKNet主干特征提取网络 | 通过动态调整感受野自适应融合长程上下文,显著提升小目标与复杂背景下的检测精度!

YOLO系列算法改进 | 主干改进篇 | 替换LSKNet主干特征提取网络 | 通过动态调整感受野自适应融合长程上下文,显著提升小目标与复杂背景下的检测精度! (以YOLO26最新目标检测模型为基础,利用LSKNet替代Backbone)

2502_91881744的博客 211

如何在Dify中安装运行pandas、numpy库(离线、在线均支持,可提供远程指导)

pandas和numpy这两个库是数据科学和数据分析中经常使用的工具包,原生的Dify无法直接使用这两个库,需要手动安装后才可以使用。本文将介绍如何在Dify中安装pandas和numpy,并在代码执行节点中运行使用pandas和numpy。Dify的代码执行节点中的python逻辑,实际是运行在Dify沙盒中的,因此我们在沙盒中安装pandas和numpy就可以了。如果您有在Dify中添加pandas、numpy的应用需求,欢迎关注作者进行交流。

litlit023的专栏 5632

多维聚合本质:从GROUP BY到OLAP立方体的数据变形术

多维聚合是现代数据分析的核心能力,它超越传统单维度GROUP BY,本质是在高维空间中对数据进行折叠、切片与投影的结构化操作。其技术原理根植于OLAP立方体建模,通过ROLLUP、CUBE、GROUPING SETS等机制预置维度组合关系,结合窗口函数实现时序比较,再经PIVOT/UNPIVOT完成形态适配,最终支撑BI下钻、同比分析与业务语义标注。这一过程强调数据形态的主动设计而非被动计算,直接决定报表性能、分析灵活性与决策响应速度。本文聚焦Data Manipulation在Multi-Dimensio

weixin_30653023的博客 520

16、树莓派Pico W:蓝牙与Wi-Fi应用指南

本文介绍了树莓派Pico W在蓝牙与Wi-Fi通信方面的应用,涵盖蓝牙配对原理、使用HC-06模块实现手机远程控制LED和传输内部温度,以及通过Wi-Fi进行网络连接、扫描和UDP协议下的设备控制。文章包含详细电路连接、代码实现与测试步骤,并提供拓展建议、常见问题解决方法及开发注意事项,帮助读者快速掌握基于Pico W的无线通信项目开发,适用于物联网入门与实践场景。

sun99的博客 289
上一篇: flink 窗口表值函数
下一篇: YARN 切换ResourceManager主备
但行益事莫问前程
但行益事莫问前程 新星创作者: 数据库技术领域 新星创作者: 数据库技术领域
博客等级 码龄7年 8490粉丝 225原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

但行益事莫问前程

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值