scrapy 爬取论坛帖子名称及链接(递归方式获取)

爬虫练习之递归爬取入口页面下所有链接(scrapy-redis分布式) 实现scrapy-redis前的一些准备 参考前文,在centos7环境下安装redis,实现远程登录redis服务功能并开启服务 https://blog.youkuaiyun.com/wxfghy/article/details/80349405 下载scrapy-redis源代码并解压 https://github.com/rmax/scrapy-redis pycharm中安装scrapy和s... 阅读详情

本文主要爬取西安论坛帖子,如果要爬取内容及评论热度等可以再深入爬取

首先建立spider xi'an,命令 scrapy genspider xian ixian.com

xian.py内容:

import scrapy
from scrapy.selector import Selector,HtmlXPathSelector
from scrapy.http import Request

class XianSpider(scrapy.Spider):
    name = 'xian'
    allowed_domains = ['ixian.cn']
    header = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.110 Safari/537.36'}
    start_urls = ['https://www.ixian.cn/forum-13-1.html']

    url_set = set()
    def parse(self, response):

        #获取荣耀西安论坛城市发展板块所有文章内容及url
        hxs1 = Selector(response).xpath("//div[@class='busforumlist_item_title']/a")
        #print(hxs)
        for item in hxs1:
            #print(item.xpath(".//@href"))
            title = item.xpath(".//text()").extract_first()
            url = item.xpath(".//@href").extract_first()
            #print(title,url)
            from spider1.items import XianItem
            obj = XianItem(title=title,url=url) #这里参数一定要加上参数名
            yield obj


        #获取所有页码url  分页url
        hxs2 = Selector(response).xpath("//div[@class='pg']/a[re:test(@href,'https://www.ixian.cn/forum-13-\d+.html')]/@href").extract()
        for url in hxs2:
            if url in self.url_set:
                #print("url已收集,重复数据 %s"%url)
                pass
            else:
                self.url_set.add(url)
                print("新增一条url: %s"%url)
                #将新url加入到调度器,进行新的url递归访问并解析
                yield  Request(url=url,callback=self.parse)

item.py建立class类,存储爬出来的帖子类对象

import scrapy


class XianItem(scrapy.Item):
    # define the fields for your item here like:
    # name = scrapy.Field()
    title = scrapy.Field()
    url = scrapy.Field()

建立piplines, 爬出来的内容持久化到txt文档中

class XianPipeline(object):
    def process_item(self, item, spider):
        temp_news = "%s\n%s\n\n"%(item['title'],item['url'])
        f = open('荣耀西安网帖子.txt','a+',encoding="utf-8")  #a+表示追加内容
        f.write(temp_news)
        f.close()
        #return item

setting文件中设置 爬取深度:DEPTH_LIMIT=2,  以及piplines

# Configure item pipelines
# See https://doc.scrapy.org/en/latest/topics/item-pipeline.html
ITEM_PIPELINES = {
   'spider1.pipelines.XianPipeline': 300, #300代表pipline执行权重,顺序
}

DEPTH_LIMIT=1 #递归深度 0表示不设深度,无线循环

命令行执行:

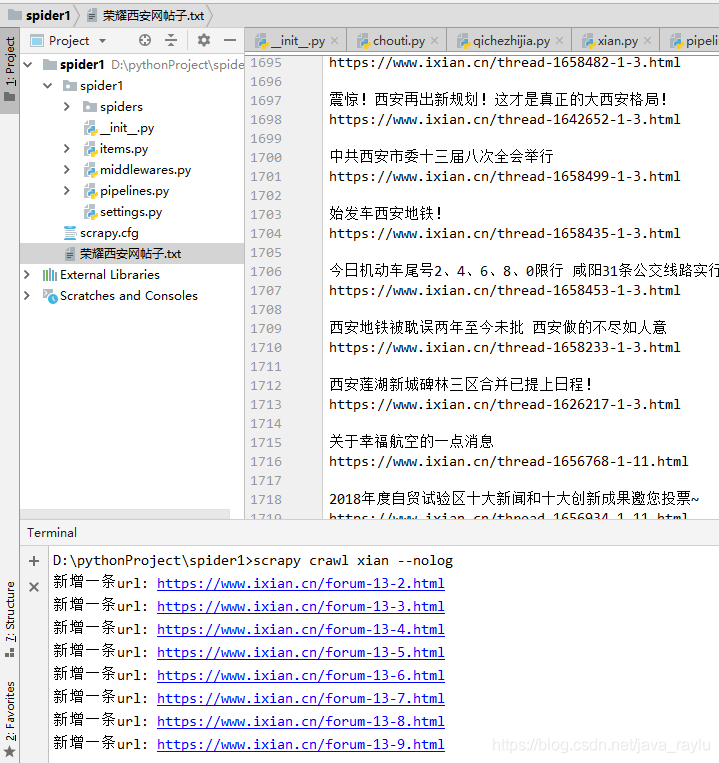
scrapy crawl xian --nolog
爬取到3000多条帖子:
从PardusClawer项目看专用爬虫系统设计:架构、实现与工程实践 网络爬虫作为自动化数据采集的核心技术,其原理是通过模拟浏览器行为,向目标服务器发送HTTP请求并解析响应内容,从而高效、结构化地获取网络信息。这项技术的核心价值在于打通数据孤岛,将分散、异构的网页数据转化为可供分析和决策的结构化数据。在工程实践中,一个健壮的爬虫系统通常包含调度器、下载器、解析器和数据管道等核心组件,并需妥善处理反爬策略、数据清洗与存储等关键问题。其应用场景广泛,从市场情报收集、学术研究到开源生态监控均不可或缺。本文以PardusClawer项目为例,深入探讨了针对特定Linux发行版生态( 阅读详情

相关推荐

scrapy的全网站爬取数据

scrapy的全网站爬取数据

Davidzhuming的博客 768

scrapy递归抓取网页数据

scrapy spider的parse方法可以返回两种值:BaseItem,或者Request。通过Request可以实现递归搜索。 如果要抓取的数据在当前页,可以直接解析返回item(代码中带**注释的行直接改为yield item); 如果要抓取的数据在当前页指向的页面,则返回Request并指定parse_item作为callback; 如果要抓取的数据当前页有一部分,指向的页面有一部分(比如博客或论坛,当前页有标题、摘要和url,详情页面有完整内容)这种情况需要用Request的meta参数把

junglezax的专栏 6282

东方财富股吧评论爬虫和情绪分析

目录爬虫准备爬虫情绪分析 爬虫准备 本次用selenmium和bs4进行爬虫,最后把数据储存进json文件里,需要使用的库有这些。 from selenium import webdriver from bs4 import BeautifulSoup from selenium.webdriver.chrome.options import Options import json 爬虫 先爬取贴子的基本信息,如评论,阅读数,帖子链接等。有些咨询帖子是官方发的,和爬取的股票没有关系,所以需要过滤掉。 de

quant学习记录 8337

scrapy实现递归爬取

使用scrapy踩的坑之如何使用scrapy实现递归爬取 在使用scrapy爬取一个网站上所有的图片时,所遇到的一点坑,因为自己对scrapy不是很熟,所以最后是解决了一部分问题,但是还有一部分没有搞懂。以及对网上一些DEMO的不理解。

wly 1万+

爬取在线论坛帖子:使用 Python 获取帖子及评论

在这篇博客中,我们将学习如何使用 Python 编写一个网络爬虫,从一个在线论坛(例如:Reddit)中获取帖子及其评论。我们将使用requests和库来实现这个功能。

斌擎科技 637

从零组装电赛送药小车:OpenMV视觉核心+STM32控制,我的软硬件联调全记录

本文详细记录了从零构建电赛智能送药小车的全过程,重点解析了OpenMV视觉识别与STM32控制的深度协同方案。通过硬件选型对比、通信协议设计、PID调参等实战经验,解决了巡线精度、十字路口识别等核心问题,最终实现稳定可靠的送药小车系统,助力电子设计竞赛取得优异成绩。

weixin_42641741的博客 447

使用Scrapy递归爬取网页

1. scrapy介绍与安装  Scrapy,Python开发的一个快速,高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。(百度百科的描述)      安装过程见CentOS7下安装Scrapy,基于Python2.7.5版本。2. 项目代码与分析(1)创建项目scrapy startproject Fi

lujian1989的专栏 1万+

Linux CentOS7文件系统(/dev/var)的容量扩充

原因是之前安装docker后,再想安装Nessus,系统说home、var文件系统的内存都不够。

JHoanna的博客 3223

scapy递归爬

前面介绍了Scrapy如何实现一个最简单的爬虫,但是这个Demo里只是对一个页面进行了抓取。在实际应用中,爬虫一个重要功能是”发现新页面”,然后递归的让爬取操作进行下去。 发现新页面的方法很简单,我们首先定义一个爬虫的入口URL地址,比如《Scrapy入门教程》中的start_urls,爬虫首先将这个页面的内容抓取之后,解析其内容,将所有的链接地址提取出来。这个提取的过程是很简单的,通过一...

VergiL Wang的专栏 424

地心地固坐标系与北天东坐标系的转换

经过这一步旋转,x3轴和y3轴就处在过O3点的经度线所在的平面了,而且z3轴指向了东。将图3的坐标系旋转成图2的样子。这里需要多次旋转,每次以某个轴为对称轴进行旋转,对应的坐标变换参考。的原点在地心,Z轴指向北极点,X轴指向本初子午线与赤道的交点,Y轴指向符合右手定则,如下图所示。下面实现地心地固坐标系到北天东坐标系的转换,问题描述为:设一点。以y1轴为对称轴,顺时针旋转90°,得到图4的样子。,X轴指向北,Y轴指向天,Z轴指向东,如下图所示。因此,北天东坐标下的坐标为。点在图3坐标系下的坐标。

csdnqixiaoxin的博客 3555

离散数学期末复习笔记【精华版】

文章目录前言一、????理逻辑1. 命题逻辑2. 等值演算3. 主合取范式、主析取范式4. 【题】推理证明5. 辖域、自由变元、约束变元二、????合1. 环和、环积,幂集,笛卡尔乘积三、 ????????关系1. 自反、对称、传递2&3. 合成运算,逆关系、闭包4. 哈斯图、上下界、偏序5. 等价关系、划分四、????1. 幺元(么元、单位元)、零元、逆元,半群、群、阿尔贝群、独异点、循环独异点2. 【题】由表判断3. 【题】证明五、????论1. 简单图、平凡图、多重图、子图、补图、出度、入度、

林大夕可的博客 17万+

爬虫教程( 2 ) --- scrapy 教程、可视化管理工具、反爬框架、ai 爬虫

scrapy 教程、可视化管理工具、反爬框架、ai 爬虫

freeking101的博客 5250

OpenCV实例(二)手势识别

手势识别的范围很广泛,在不同场景下,有不同类型的手势需要识别,例如:● 识别手势所表示的数值。● 识别手势在特定游戏中的含义,如“石头、剪刀、布”等。● 识别手势在游戏中表示的动作,如前进、跳跃、后退等。● 识别特定手势的含义,如表示“OK”的手势、表示胜利的手势等。理论基础凸包和凸缺陷在图像处理中具有非常重要的意义,被广泛地用于图像识别等领域。逼近多边形是轮廓的高度近似,但是有时候,我们希望使用一个多边形的凸包来简化它。凸包和逼近多边形很像,只不过凸包是物体最外层的凸多边形。

小幽余生不加糖 9409

python爬虫技能总结-快速爬虫指导-含代码演示---[最强の提纲挈领!]

关于本文: 本文主要目的为提纲挈领,爬虫知识总览 内容包含爬虫所依赖的知识以及爬虫流程 相关技能点请自行查找,网上文档较全面 代码演示只给了一个项目,建议动手实践 目录 分析工具 所需技能点-了解即可,建议实践中深入研究 手动爬虫流程-编码逻辑 scrapy爬虫流程-启动过程 数据存储/持久化 反爬对抗策略 可练手项目:注意编解码问题 代码/项目演示:爬取XX贴吧图片...

Smookey的博客 518

ardupilot 获取避障传感器数据

本节主要记录自己学ardupilot的避障代码过程,首先看下怎么注册避障传感器,然后怎么获取避障数据。

陌城烟雨 5524

【ARMv8 异常模型入门及渐进7 - GIC及安全中断介绍】

GIC-v3中,引入了支持2种安全状态(secure state),也就是对于中断,根据secure状态,分为安全中断和非安全中断。当然也可以只支持一种安全状态。这里的2种安全状态和1种安全状态,主要是影响中断分组,所使用IRQ和FIQ管脚的映射,以及gic中的寄存器访问。

CodingCos的博客 2116

Scrapy递归抓取数据存入数据库(示例二)

参考:http://www.hulufei.com/post/Some-Experiences-Of-Using-Scrapy           http://www.shahuwang.com/?p=1620 scrapy爬取了链接之后,如何继续进一步爬取该链接对应的内容? parse可以返回Request列表,或者items列表,如果返回的是Request,则这个Request

知多知少的博客 930

[Python] 为什么你的脚本明明没报错,却什么也没发生?

Python脚本运行后没报错却没结果?这是许多开发者遇到的棘手问题。文章分析了六种常见原因:代码未进入目标逻辑分支、输出路径错误、中间数据为空、异常被吞掉、异步操作未完成、运行了错误脚本版本。建议通过"过程可视化"排查,如打印关键变量、检查工作目录、验证数据状态等。职场中更应关注结果验证而非单纯代码执行,确保脚本真正解决问题。建立结果验证意识是从"会写代码"到"稳定交付"的关键转变。

技术小甜甜:传播可落地技术,帮助个人和企业降低解决真实场景问题的成本 302

python爬取论坛帖子_Python爬虫实战(1):爬取Drupal论坛帖子列表

1,引言在《Python即时网络爬虫项目: 内容提取器的定义》一文我们定义了一个通用的python网络爬虫类,期望通过这个项目节省程序员一半以上的时间。本文将用一个实例讲解怎样使用这个爬虫类。我们将爬集搜客老版论坛,是一个用Drupal做的论坛。2,技术要点我们在多个文章都在说:节省程序员的时间。关键是省去编写提取规则的时间,尤其是调试规则的正确性很花时间。在《1分钟快速生成用于网页内容提取的xs...

weixin_39712611的博客 1068

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Python爬虫实战(1)——抓取帖子并保存内容和图片

最近在网上看了很多的爬虫脚本,写的参差不齐,但是其中有很多写的非常的优秀,代码质量很高,规范性也很好,很具有代表性,非常值得我们去学习!~ 之前的帖子中介绍过url,也就是网址,在我们抓取网页的过程中也要非常注意网页的各项细节,而且需要我们不断的积累经验,也需要细心的分析: 例: http://tieba.baidu.com/p/3138733512?see_lz=1&pn=1 这

MISAYAONE的博客 6900

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

怎样使用scrapy通过递归的方式进行采集?

1、需求,在进行采集时,没有一个总的入口页面,或者入口页面无法采集所有的页面。但是或许可以通过在内容页中类似“上一页”“下一页”来“循环的”采集。 2、重点在于rules 在scrapy中,通过定义规则rules就可以实现自动的迭代爬取,甚至爬取全站内容。写rules要特别注意,其中all...

cheyuan4575的博客 423

scrapy框架之CrawlSpider全站自动爬取

全站数据爬取的方式   1.通过递归的方式进行深度和广度爬取全站数据,可参考相关博文(全站图片爬取),手动借助scrapy.Request模块发起请求。   2.对于一定规则网站的全站数据爬取,可以使用CrawlSpider实现自动爬取。 CrawlSpider是基于Spider的一个子类。和蜘蛛一样,都是scrapy里面的一个爬虫类,但 CrawlSpider是蜘蛛的子类,子类要...

diaolouan9546的博客 611

scrapy框架之全站深度爬取数据

1.2 在终端输入如下命令,切换到新建的文件目录下 1.3 在spiders子目录中创建一个名essay,初始url为www.xxx.com的爬虫文件,在终端输入如下命令 2、配置文件修改 双击打开essays文件目录下的settings.py文件,

qq_52431815的博客 532

Python爬虫实战(1):爬取Drupal论坛帖子列表

1,引言在《Python即时网络爬虫项目: 内容提取器的定义》一文我们定义了一个通用的python网络爬虫类,期望通过这个项目节省程序员一半以上的时间。本文将用一个实例讲解怎样使用这个爬虫类。我们将爬集搜客老版论坛,是一个用Drupal做的论坛。2,技术要点我们在多个文章都在说:节省程序员的时间。关键是省去编写提取规则的时间,尤其是调试规则的正确性很花时间。在《1分钟快速生成用于网页内容提取的xs...

weixin_30449453的博客 142

python爬取论坛帖子_网络抓取每个论坛帖子(Python,Beautifulsoup)

Hello once again fellow stack'ers. Short description.. I am web scraping some data from an automotive forum using Python and saving all data into CSV files. With some help from other stackoverflow mem...

weixin_39753857的博客 640

python天涯帖子_python爬虫获取多页天涯帖子

今天练习了抓取多页天涯帖子,重点复习的知识包括soup.find_all和soup.selcet两个筛选方式对应不同的参数;希望将获取到的多个内容组合在一起返回的时候,要用'zip()'的代码来实现;两层代码结构之间的关系如何构造;这里有一个疑问:有时候一个标签可以有多个属性,不知道soup.find_all()能不能接受不止一个属性以缩小查找的范围。# 引入库和请求头文件import reque...

weixin_39653405的博客 246
上一篇: python scrapy 对爬虫爬到的url 进行md5加密
下一篇: scrapy批量爬取校花网图片并保存到本地
路路的小豆
博客等级 码龄10年 1763粉丝 99原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

