
Flink on yarn任务日志怎么看

Flink 1.13 cdc 任务 on yarn 日志查询详解 目录 一,正常部署之后,flink on yarn 任务查看 二,shell命令查看具体日志 三,开启historyserver 四,使用yarn的restfulApi查看信息 五,总结: 一,正常部署之后,flink on yarn 任务查看 1,正在运行任务: 2,杀死任务之后: 3,我们点击History按钮 进入页面: 这并不是我们想要的效果,so,我们要看看具体的操作。 二,shell命令查看具体日志 在shell命令执行:.. 阅读详情
AI摘要

在YARN上可以直接查看jobmanager日志,而taskmanager日志通常可以在Flink的webUI中查看。但当任务失败导致webUI不可用时,可以通过JobManager的日志找到taskmanager注册信息,从而获取taskmanager的日志地址。例如,从日志中找到类似RegisteringTaskManagerwithResourceID的条目,可以构建taskmanager的日志URL,如http://hadoop02:19888/jobhistory/logs/hadoop03:45454/container_e03_1684463979345_0028_01_000003/root来访问。

1、jobmanager日志

        在yarn上可以直接看

2、taskmanager日志

         在flink的webui中可以看,但是flink任务失败后,webui就不存在了,那怎么看?

这是jobmanager的地址

hadoop02:19888/jobhistory/logs/hadoop02:45454/container_e03_1684463979345_0028_01_000001/container_e03_1684463979345_0028_01_000001/root

你要看taskmanager的地址,首先我们要知道taskmanager运行在哪里

 打开Jobmanager日志

 全局搜索

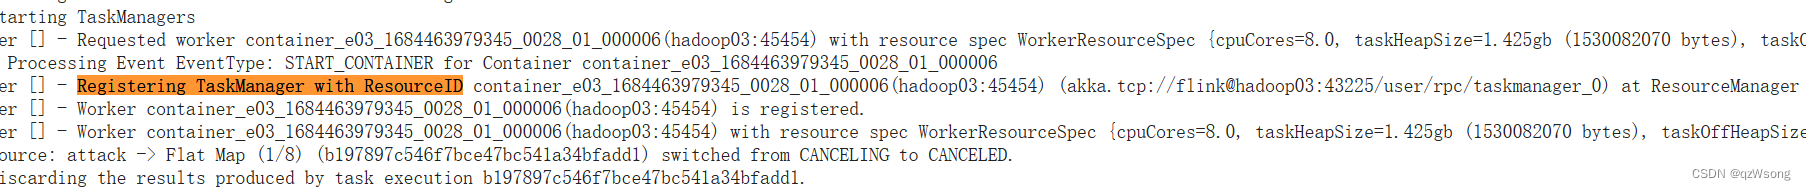
 Registering TaskManager with ResourceID 

后边就是taskmanager地址因此,替换一下url就可以得到这个taskmanger的地址

2023-05-30 03:19:35,136 INFO  org.apache.flink.runtime.resourcemanager.active.ActiveResourceManager [] - Registering TaskManager with ResourceID container_e03_1684463979345_0028_01_000003(hadoop03:45454) (akka.tcp://flink@hadoop03:43225/user/rpc/taskmanager_0) at ResourceManager
2023-05-30 03:19:35,147 INFO  org.apache.flink.runtime.resourcemanager.active.ActiveResourceManager [] - Worker container_e03_1684463979345_0028_01_000003(hadoop03:45454) is registered.
http://hadoop02:19888/jobhistory/logs/{taskmangerIp}:45454/{taskmanager的容器名}/{taskmanager的容器名}/root

taskmanager容器名:container_e03_1684463979345_0028_01_000003

taskmangerIp:  hadoop03

http://hadoop02:19888/jobhistory/logs/{taskmangerIp}:45454/{taskmanager的容器名}/{taskmanager的容器名}/root

注意:应该会有好多个taskmanger

flink yarn模式提交及查看日志 一、Yarn session(一般测试环境) yarn session会初始启动指定的tm数量。 job提交后再指定的session 内运行。 其它job运行,如果资源不够,就会一直等待直到占用的job运行完毕释放资源。jm所有job共享 1 在任意几点启动yarn-session: 下述属性启动4个任务管理器。 每个任务管理器占用1024M内存,且每任务管理器分配2个SLO... 阅读详情

相关推荐

Flink任务监控(基于API接口编写shell脚本)

Flink部署模式主要分为Flink StandAlone 模式,flink-on-yarn 模式。 Flink StandAlone 模式 主要是通过调用

qq_36470898的博客 5134

Flink日志输出查看方式

在网上查看flink日志查看方式,竟然查询不到,因此写下这篇文章,给有此困惑的小盆友们,也给自己做个总结! 前情提要: 我是通过flink web ui提交的flink任务的,因此通过flink ui查看自身控制台打印输出的。 第一步:打开flink的Dashboard 看到TaskManager的控制面板之后,点击右侧的具体job所在的taskManager主机 进入如下界面,点迹Stdou...

fct2001140269的博客 4万+

提交Flink的jar包到Yarn上,web界面log报错

在hadoop环境下运行flink的batch程序: ./flink run /home/hadoop/proj/wordcount.jar --input hdfs://mycluster/flinkProjectData/111.txt 一段时间后,flink的web界面上,taskmanager和jobmanager下的logs分别出现error: taskmanager: ER...

piaoken5588的博客 3167

关于Flink,TaskManager日志问题的一个记录

疑问:不知道大家有和我一样,开发完的flink代码推送到flink集群上执行的时候log.info(xxxx)打印的日志不会打印到task-manager节点上去(在IDEA上执行可以打印日志到控制台上),为此一直在困扰了,经过一系列的尝试,终于在java和scala中实现log.info(xxx)打印到task-manager节点上。scala中不支持使用lombok的方式,所以这里通过伴生对象的方式实现编译后的文件创建static final类型的Logger对象。

qq_43413036的博客 2531

Flink任务卡在INITIALIZING状态的深度排查与解决

本文深入剖析了Flink任务在YARN集群中长时间卡在INITIALIZING状态的常见原因与系统化排查方法。文章从YARN资源队列检查入手,详细讲解了如何通过分析TaskManager日志和抓取线程堆栈来定位问题根源,并总结了资源不足、依赖缺失、外部系统连接失败等典型场景的解决方案,帮助运维和开发人员高效恢复任务运行。

sql99的博客 245

Flink系列:在Flink集群提交任务、查看日志、查看输出结果详细步骤

基础 Flink系列:最新flink集群搭建、配置完整步骤 Flink系列:IDEA创建flink项目开发环境(附完整WordCount例子) 编写Flink程序 提交任务 查询

NIO4444 9567

Flink on yarn Container released on a *lost* node

目录背景Yarn 上面查看日志 背景 FLink on yarn Cluster 模式运行一段时间后,程序突然报错, 查找Exceotion 发现 ”Container released on a *lost* node” 具体报错如下。 2021-12-24 09:43:43,931 INFO org.apache.flink.runtime.executiongraph.ExecutionGraph - Filter -> Process -> (Sink: status,

Jhon_yh的博客 2256

flink实战 -- flink on yarn 任务日志收集与监控

背景 在 Flink on yarn 的模式下,taskManager的日志会存储到所在的DataNode上,当 Flink 任务发生异常,产生异常日志时,需要我们第一时间感知任务已经出现异常,避免影响业务。因此我们需要将Flink任务的日志实时收集起来,出现异常日志立刻报警,做的真正意义上的实时报警,而不是等flink任务掉线了在发出报警。收集到了任务日志,即使任务掉线了也方便我们通过日志定位问题。 日志收集方案 在 Flink 1.1...

阿华田的博客 4360

hadoop yarn 使用_flink on yarn 模式下提示yarn资源不足问题分析

背景在实时计算平台上通过YarnClient向yarn上提交flink任务时一直卡在那里,并在client端一直输出如下日志:(YarnClusterDescriptor.java:1036)- Deployment took more than 60 seconds. Please check if the requested resources are available in th...

weixin_29208327的博客 3640

【Flink】flink on yarn 并行度设置高导致任务失败

1.概述 flink on yarn 并行度设置高了就失败有遇到过没,400的并行度就没事,设置成600就不断失败,是需要做什么额外的配置吗,比如网络缓冲?看报错日志没找到什么相关提示,版本是1.13.2 看了一下源码,发现是你启动的时候 改改初始化 或者 开始运行的时候失败的,感觉像是tm节点没起来就失败了。 其他错误如下 报错中的 这个域名看起来是正常的,能登陆到它,负载也不高,扫了下端口也可通,看样子像是taskmanager连不上job manager 大致是这样,taskmanager获取到了

九师兄 988

ComfyUI破限版全中文AI绘画环境搭建与工作流实战指南

节点式工作流是AI绘画领域的核心技术架构,通过将图像生成过程拆分为可配置的模块化节点,实现了对Stable Diffusion模型的精细化控制。其技术原理基于数据流编程范式,每个节点负责特定功能处理,如文本编码、采样器配置和VAE解码等。这种设计在工程实践中的核心价值在于提供了可追溯、可复用的可视化工作流,特别适合需要参数调优和批量生产的商业场景。ComfyUI作为典型的节点式AI绘画工具,在破限版中针对中文用户优化了界面支持和显卡兼容性,显著降低了技术门槛。在实际应用中,结合ControlNet和LoRA

weixin_29038155的博客 446

Flink on yarn 实时日志收集到 kafka 打造日志检索系统

点击上方"JasonLee实时计算",选择"设为星标"再也不用担心错过重要文章后台回复"监控",获取 grafana 监控 Flink最...

JasonLee实时计算 1791

DPO(Direct Preference Optimization)实战全流程指南

《DPO实战全流程指南》摘要 本文提供了端到端的DPO(直接偏好优化)实战方案,包含数据准备、模型训练、评估部署全流程。核心内容包括: 数据构建:推荐UltraFeedback等高质量数据集,提供数据预处理代码 训练配置:基于HuggingFace TRL库的DPO实现,详解beta值等关键参数调优 工业优化:显存节省技巧(LoRA、梯度检查点)、领域自适应方法和在线学习架构 效果评估:量化对比显示DPO可降低86%有害回复率,提升24%用户满意度 常见问题:针对灾难性遗忘、过度安全化等问题给出解决方案 附

技术引领业务创新 1466

Flink on yarn 开发过程中遇到的问题

去到正常和异常的节点下比较,确实异常节点缺失这个文件夹(用于存储运行时nodemanager和taskmanager的日志),怀疑是部署中间件框架时遗漏,通过手动增加文件夹的方式,问题解决。如果source端的数据量最小,拿到source端流过来的数据后做了细粒度的拆分,数据量不断的增加,到sink端的数据量非常大的这种情况,就需要提高并行度。keyby之后的算子,视具体情况而定,可以通过测试反压的方法,得到keyby算子上游的数据发送量和该算子的处理能力来得到合理的并行度(在无倾斜情况下)

sinat_27593959的博客 1803

别再手动调时间了!用Windows自带的tzutil命令,1分钟搞定时区错误

本文介绍了如何使用Windows自带的tzutil命令快速解决时区错误问题。通过简单的命令行操作,用户可以一键切换时区、查看全球时区代码库,并实现自动化时区同步。相比传统GUI设置,tzutil更可靠且高效,特别适合企业环境批量部署。

weixin_42531494的博客 312

SWIPT技术(无线通信携能技术)的简介与架构——(后续补充无人机SWIPT方向)

SWIPT一、SWIPT(无线通信携能)技术简介1.1、组成:1.2、与传统无线通信的区别:1.3、SWIPT 的集成接收器架构设计1、单独的接收器2、TS架构——时间开关(Time switching,TS)3、PS架构——功率分流(Power splitting,PS)4、天线开关接收器主要两种架构的区别参考文献SWIPT的发展 一、SWIPT(无线通信携能)技术简介 SWIPT(Simultaneous Wireless Information and Power Transfer )是各种WPT技术

Blue 1万+

真实集群中Flink命令行各种模式提交wordcount

依然使用[1]中的代码和工程目录结构。 Reference: [1]intellij运行flink的wordcount实验

微电子学与固体电子学-俞驰 2290

【大语言模型 14】Transformer权重初始化策略:从Xavier到GPT的参数初始化演进之路

权重初始化是深度学习训练成功的隐秘基石,特别是在Transformer这样的深层架构中,合适的初始化策略能够决定模型的训练稳定性和收敛速度。本文从经典的Xavier和He初始化出发,深入解析Transformer特有的初始化策略,通过数学推导、代码实现和实验分析,揭示不同初始化方法对大语言模型训练的深层影响。我们将探讨为什么GPT系列模型采用特定的初始化方案,以及如何针对不同层设计最优的初始化策略。

熵数实验室 1686

Flink On YARN任务卡在INITIALIZING?5个排查步骤帮你快速定位问题

本文针对Flink On YARN任务卡在INITIALIZING状态的常见问题,提供了一套系统性的排查框架。通过从YARN资源层、Flink日志、线程堆栈分析到用户代码与连接器配置的五个核心步骤,帮助运维人员快速定位资源不足、外部系统连接超时、依赖冲突或代码初始化阻塞等根本原因,从而高效恢复任务运行。

web99的专栏 237

OpenCV-Python实战(11)——OpenCV轮廓检测相关应用

在计算机视觉领域,轮廓通常指图像中对象边界的一系列点。因此,轮廓通常描述了对象边界的关键信息,包含了有关对象形状的主要信息,该信息可用于形状分析与对象检测和识别。在本文中,我们将学习如何利用获取到的轮廓,进行形状分析以及对象检测和识别。

盼小辉丶的博客 1万+

YOLOv8改进,MobileNetV3轻量化架构改进特征提取网络,助力涨点

MobileNetV3通过结合硬件感知网络架构搜索(NAS)和NetAdapt算法,通过新颖的架构改进进一步提升了性能。本文开始探讨了自动化搜索算法与网络设计如何协同工作,以利用互补方法来提升整体技术水平。通过这一过程,创建了两个新的MobileNet模型:MobileNetV3-Large和MobileNetV3-Small,分别针对高资源和低资源使用场景。这些模型随后被适配并应用于目标检测和语义分割任务。

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 3834

fink on yarn任务卡在100% No TaskExecutor registered under container原因是字符类型不匹配

这里打眼一看以为是资源或者是网路通信问题,我检查了网络和资源问题都排除了,最后看源表达梦数据表的表结构以及数据,发现有。这个clob用dbeaver看会很奇怪,在页面上最开始可能显示DmdbNClob,但是一刷新就会变为正常的数值显示。clob是用于存储大文本数据,而我使用的hive表字段与之对应的是varchar存储字符串类型,自然是错误的。flink on yarn某个将达梦数据库数据采集到hive表的任务一直处于running 100%,解决方法类型将clob字段采集时,截取或者转换为字符串即可。

qq_44540985的博客 549

工程级 RK3588 YOLOv5 Android 架构拆解:NPU 量化优化 + 多线程推理 + 跟踪算法源码

本文将带你完成一个完整的AI视觉项目:在搭载RK3588芯片的Android开发板上运行实时目标检测与跟踪应用。实战目标:成功运行官方YOLOV5摄像头实时检测案例技术深度:深入理解RKNN开发框架和源码实现核心技能:掌握NPU推理、多线程并发、目标跟踪等关键技术。

LXY_LOVE36的博客 128

【Flink流式计算框架】Local模式安装_Standalone模式安装(local)_Flink on Yarn模式安装_Flink Shell使用

004FlinkLocal模式安装(集群只有一个节点)Local模式安装在集群上提交任务Standalone模式安装(local)Flink on Yarn模式安装第一种方式第二种方式help信息(yarn-session.sh和flink run) Local模式安装(集群只有一个节点) Local模式安装 (1)安装jdk,配置JAVA_HOME,建议使用jdk1.8以上 (2)安装包下载地址:http://mirrors.tuna.tsinghua.edu.cn/apache/flink/flink-

一梦 745

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Flink on yarn日志收集

背景 在 Flink on yarn 的模式下,程序运行的日志会分散的存储在不同的 DN 上,当 Flink 任务发生异常的时候,我们需要查看日志来定位问题,一般我们会选择通过 Flink UI 上面的 logs 来查看日志,或者登录到对应的服务器上去查看,但是在任务日志量非常大的情况下,生成的日志文件就非常多,这对于我们排查问题来说,就造成了很大的不便,所以,我们需要有一种统一的日志收集,检索,展示的方案来帮忙我们快速的分析日志,定位问题. 那么我们很容易就能想到 ELK 分布式日志收集解决方案 EL

Baron_ND的博客 2318

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

上一篇: 排查linux大文件
下一篇: Kafka开启SASL认证,访问速度很慢
JNWsong
博客等级 码龄9年 287粉丝 204原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值