


Redis数据类型与数据结构之间的关系
在Redis6中:

而Redis7中有所变化:

由图中可知,底层的数据结构有所变化,在Redis7中不再推荐使用ziplist,而是使用listpack代替,但考虑兼容性,目前仍保留ziplist。
K-V键值对
我们知道Redis是key-value键值对系统,key一般是 String 类型的字符串对象,而Value的类型就比较多了,比如:字符串、List、Hash、Set、Zset等对象,所以Redis将所有数据结构进行统一,通过 redisObject 对象统一表示 value 值,每一个对象都是一个 redisObject 结构体,这样所有的数据类型就都可以以相同的形式在函数间传递而不用使用特定的类型结构。(可以理解为redisObject就是 string、hash、list、set、zset 的父类,可以在函数间传递时隐藏具体的类型信息)
为了识别不同的数据类型,redisObject 包含了 type、encoding和ptr 三个属性。type 表示 value 的类型,encoding 表示 value 的编码方式,ptr 指向 value 的实际存储数据。不同的类型和编码方式会有不同的数据结构来实现,比如字符串类型的value可以用int、raw或embstr来编码,分别对应整数、动态字符串或预分配空间的动态字符串。
使用redisObject来包装value有以下几个好处:
- 可以统一管理不同类型和编码方式的value,方便进行操作和转换。
- 可以根据value的特点选择合适的编码方式,提高存储效率和性能。
- 可以在redisObject中添加额外的信息,比如引用计数、LRU时间戳等,方便实现一些功能,比如内存回收、过期删除等。
typedef struct redisObject {
	unsigned type:4; // 对象的类型,包括 OBJ_STRING,OBJ_LIST,OBJ_HASH,OBJ_SET,OBJ_ZSET
	unsigned encoding:4 // 具体的数据结构
	unsigned lru:LRU_BITS; // 24位,对象最后一次被命令程序访问的时间,与内存回收有关
	int refcount; // 引用计数,当refcount为0时,表示该对象已经不在被任何对象引用,可以进行垃圾回收了。
	void *ptr; // 指向对象实际的数据结构
} robj;

SDS动态字符串
在Redis中存储string类型虽然都是RedisObject, 但其内部对应的物理编码是变化的,底层对应的有三种物理编码类型:int、embstr 和 raw。这三种编码类型的区别如下:
- int 编码
当value为long类型的64位有符号整数,且长度小于等于8字节,使用int编码。这种编码可以节省内存空间,因为Redis会预先建立10000个redisObject,值为0 - 9999的值,将这10000个redisObject作为共享对象。所以如果我们set的值在0 - 10000之间,则指向共享对象,不需要创建新的redisObject。
注:只有整数才会使用int,如果是浮点数,Redis内部是先将浮点数转为字符串值,然后再保存。当字符串键值的内容可以用一个64位有符号整形来表示时,Redis会将键值转化为long型来进行存储,此时即对应 OBJ_ENCODING_INT 编码类型。
- embstr 编码
当value为小于44字节的字符串时,使用embstr编码。这种编码是一种简单动态字符串(SDS),是可以修改的字符串,内部结构实现上类似于Java的ArrayList,采用分配冗余空间的方式来减少内存的频繁分配。embstr编码的优点是它可以减少内存碎片,因为它只需要一次内存分配和释放。
在传统的字符串实现中(c语言使用的是char数组,它没有string 类型),每当创建一个新的字符串对象时,都需要为其分配一个新的缓冲区来存储字符数据。如果使用传统字符串实现,在内存分配过程中就需要调用两次内存分配函数,分别创建redisObject和字符串对象,然后redisObject通过存储字符串的引用链接指向字符串的对象。当有大量的字符串创建或者过期,就会导致频繁的内存分配和释放,增加了内存管理的开销,且由于分配的空间都是离散的,就容易导致内存碎片的产生。
embstr考虑了上述的问题,于是它通过一次内存分配来分配一块连续的内存空间,空间中包含redisObject和sdshdr(动态字符串)两个结构,两者在同一个内存块中。如下图所示,redisObject中的ptr指针直接指向下面的sdshdr,这就相当于把字符串对象的字符数据存储在redisObject对象本身的内存中,而不是只存储引用,这样可以减少内存的频繁分配和释放,只要一次分配或释放即可实现内存的管理。
对于长度小于 44的字符串,Redis 对键值采用OBJ_ENCODING_EMBSTR 方式,表示嵌入式的String。从内存结构上来讲, 即字符串 sds结构体与其对应的 redisObject 对象分配在同一块连续的内存空间,字符串SDS嵌入在redisObject对象之中一样。
对于长度小于 44的字符串,Redis 对键值采用OBJ_ENCODING_EMBSTR 方式,EMBSTR 顾名思义即:embedded string,表示嵌入式的String。从内存结构上来讲, 即字符串 sds结构体与其对应的 redisObject 对象分配在同一块连续的内存空间,字符串SDS嵌入在redisObject对象之中一样。 - raw编码
当value为大于44字节的字符串时,使用raw编码。这种编码也是一种简单动态字符串(SDS),但是它需要两次内存分配和释放,一次是分配redisObject结构体,一次是分配SDS结构体,分配空间不一定连续(存储的数据较大,无法直接分配一大块内存同时存放两个结构体)。raw编码的优点是它可以存储任意长度的字符串,最多可以达到512M。
当字符串的键值为长度大于44的超长字符串时,Redis 则会将键值的内部编码方式改为OBJ_ENCODING_RAW格式,这与OBJ_ENCODING_EMBSTR编码方式的不同之处在于,此时动态字符串sds的内存与其依赖的redisObject的内存不再连续了。

Hash

Hash结构和Zset结构十分相似,都是键值存储,都是要求根据键来获取对应的值,况且键都是唯一的,但是它们的区别也是很明显的:
- Zset 的值要求是member,值是score,但是哈希类型的键和值都是任意值
- Zset 要根据score值进行排序,hash则无需进行排序
因此Hash结构底层采用的编码和Zset也是基本一致的只需要把排序有关的ZipList去掉即可 - Hash结构底层默认使用的是ZipList编码,用来节省内存,ZipList中的两个相邻Entry分别保存field和value
- 但数据量比较大的时候,Hash结构默认会转化为 hashtable 编码也就是Dict,但是触发条件有两个
- ZipList中的元素数量超过了 hash-max-ziplist-entries 默认是512字节
- ZipList中的任意entry大小超过了 hash-max-ziplist-value 默认是64字节
| 编码属性 | 描述 | object encoding命令返回值 |
|---|---|---|
| OBJ_ENCODING_ZIPLIST | 使用压缩列表实现哈希对象 | ziplist |
| OBJ_ENCODING_HT | 使用字典实现哈希对象 | hashtable |
压缩链表ziplist
在Redis7以前,ziplist是一种紧凑的、节省内存的、经过特殊编码的双向链表结构,总体思想是多花时间来换取节约空间(内存利用率提高,查询速度会降低,多了编码解码操作),它将多个键值对存储在一个连续内存块组成的顺序型数据结构中(类似数组),每个键值对占用一个Entry,包含前一个元素长度、编码字段长度、实际内容等信息。ziplist适合存储小对象(因为要编解码)。
因此只会用于字段个数少,且字段值也较小的场景。压缩列表内存利用率极高的原因与其连续内存的特性是分不开的。
既然ziplist是由连续的内存块组成,那我们是不是就不用维护指向节点的双指针了,我只要知道上一节点的长度和当前entry的长度,我们就可以通过长度推算下一个元素在什么地方。即“时间换空间”
其结构如下:
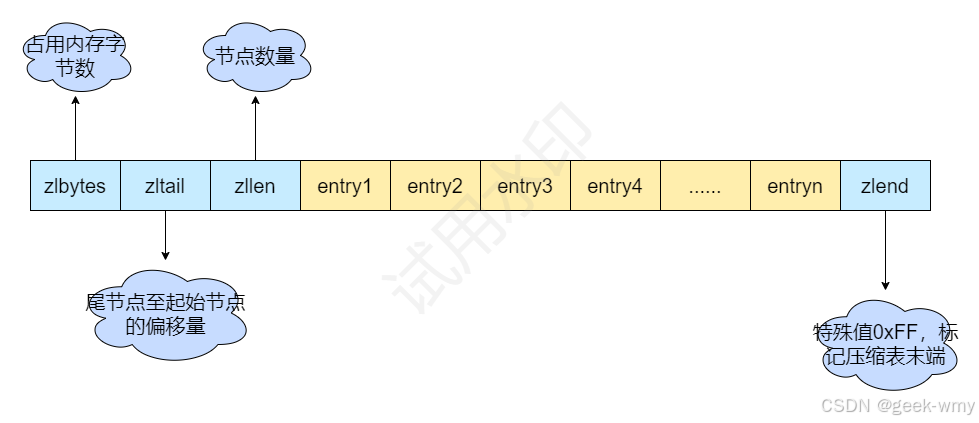
| 属性 | 类型 | 长度 | 用途 |
|---|---|---|---|
| zlbytes | uint32_t | 4字节 | 记录整个压缩列表占用的内存字节数,在对压缩列表进行内存重新分配或者计算zlend的位置时使用 |
| zltail | uint32_t | 4字节 | 记录压缩列表表尾节点距离起始地址有多少字节,通过这个偏移量程序无须遍历整个压缩列表就可以确定表尾节点的地址 |
| zllen | uint16_t | 2字节 | 记录列表包含的节点数量,当值小于 UNIT16_MAX(65535)时,这个属性的值就是压缩列表包含节点的数量,当这个值等于 UINT16_MAX时,节点的真实数量需要遍历整个列表才能计算出来 |
| entryX | 列表节点 | 不定 | 列表包含的各个节点,节点的长度由节点保存的内存决定 |
| zlend | uint8_t | 1字节 | 特殊值0xFF,用于标记列表末端 |
再介绍一下这个entry节点
/* We use this function to receive information about a ziplist entry.
 * Note that this is not how the data is actually encoded, is just what we
 * get filled by a function in order to operate more easily.
*/
typedef struct zlentry {
    unsigned int prevrawlensize; /* 上一个链表节点占用的长度*/
    unsigned int prevrawlen;     /* 存储上一个链表节点的长度数值所需要的字节数 */
    unsigned int lensize;        /* 存储当前链表节点长度数值所需要的字节数*/
    unsigned int len;            /* 当前链表节点所占用长度 */
    unsigned int headersize;     /* 当前链表节点的头部大小:prevrawlensize + lensize. */
    unsigned char encoding;      /* 编码方式*/
    unsigned char *p;            /* 压缩链表以字符串的形式保存,该指针指向当前节点起始位置 */
} zlentry;
为什么entry这么设计?记录前一个节点的长度?
链表在内存中,一般是不连续的,遍历相对比较慢,而ziplist可以很好的解决这个问题。如果知道了当前的起始地址,因为entry是连续的,entry后一定是另一个entry,想知道下一个entry的地址,只要将当前的起始地址加上当前entry总长度。如果还想遍历下一个entry,只要继续同样的操作。
ziplist分配的内存是连续的,但每个节点的长度又是可变长的。即当一个节点被更新时,如果更新后的数据长度和原始数据长度相同,那么只需要直接更新节点中的数据即可。但是,如果更新后的数据长度不同,就需要进行节点的重新分配和移动。这会导致当前节点后面的节点所保存的数据的内存地址发生了变化,因此需要将当前节点后面的所有节点都移动到新的内存地址。这个过程会连锁反应到后续的节点,直到最后一个节点,如果最后一个节点也需要移动,那么就需要重新分配整个 ziplist 的内存空间,将所有节点都移动到新的内存地址。
这就是 ziplist 的连锁更新问题,所以Redis7后弃用了ziplist结构,采用了另一种数据结构紧凑列表listpack。
哈希表hashtable
在Redis 中,hashtable被称为字典(dictionary),它是一个数组+链表的结构。我们知道HashMap在JDK1.8之前也是采用数组+链表的结构,所以可以类比学习。
之前讲过,Redis中的key-value是通过dictEntry对象来实现的,而HashTable就是将dictEntry对象进行了再一次的包装得到的,这就是哈希表对象dictht。
在 Redis内部,从 OBJ_ENCODING_HT类型到底层真正的散列表数据结构是一层层嵌套下去的:
💡 OBJ_ENCODING_HT → dict → dictht → dictEntry
其中,OBJ_ENCODING_HT 是HashTable的对象编码方式(Redis会在不同的场景选择不同的编码方式,即选择不同的底层实现),内部才是真正的哈希表结构,或称为字典结构,其可以实现O(1)复杂度的读写操作,因此效率很高。
Hash这种数据结构有着非常多的优势,但也存在着一些问题,包括哈希冲突,如何扩容、缩容等。
随着哈希表中元素数量逐渐增加时,产生hash冲突的概率逐渐增大,由于dict采用拉链法解决hash冲突的,因此随着元素的增多,链表会越来越长,这就会导致查找效率下降。相反,当元素不断减少时,元素占用dict的空间就越少,出于对内存的极致利用,此时就需要进行缩容操作。
而扩容和缩容,参考Java中的HashMap的扩容机制,Redis也采用同样的方式,即负载因子loadfactor。负载因子是指哈希表中键值对数量与哈希表长度之间的比率,即负责因子=哈希表中已保存节点数量/哈希表的大小。当键值对数量增加时,负载因子也会随之增加。
扩容机制
当负载因子超过一定阈值时,Redis会自动对哈希表进行扩容操作,以保证哈希表的性能。在Redis中,哈希表的默认长度为4。当Redis没有进行BGSAVE相关操作且负载因子>=1时,Redis会自动对哈希表进行扩容操作。扩容操作会将哈希表长度翻倍,并将原哈希表中的所有键值对重新分配到新哈希表中。在扩容过程中,Redis会使用渐进式rehash的方式,将原哈希表中的所有键值对慢慢地迁移到新哈希表中,最后释放原哈希表的内存空间。在扩容过程中,如果有客户端对哈希表进行了写操作,则会将写操作转移到新哈希表中。如果正在执行BGSAVE和BGREWRITEAOF指令的情况下,负载因子>=5时强行扩容。
缩容机制
当负载因子<0.1的时候,进行缩容。缩容时,Redis会新建一个小于等于原哈希表大小的哈希表,然后将原哈希表中的所有键值对rehash到新哈希表中,最后释放原哈希表的内存空间。缩容后的dictEntry数组数量为第一个大于等于ht[0].used的(因为table数组大小一定是2的幂次方)。在缩容操作期间,字典会同时使用ht[0]和ht[1]两个哈希表,所以在缩容操作进行期间,字典的删除(delete)、查找(find)、更新(update)等操作会在两个哈希表上进行。
渐进式Rehash
在扩容过程中,Redis会将原哈希表中的所有键值对慢慢地迁移到新哈希表中,这个过程被称为rehash。
但这里有个问题:Java中的HashMap在rehash时,需要一次性全部rehash,这是一个耗时操作。因为在rehash时,需要将所有的键值对重新计算hash值,然后放到新的数组中。如果不一次性全部rehash,而是分批次地rehash,那么就会出现一些键值对被放到了新数组中,而另一些键值对还在旧数组中的情况,这样就会导致get操作时无法找到对应的键值对,put操作时也会出现重复的键值对。
而对于Redis来说,如果哈希表里保存的键值对数量很大时,如:四百万、四千万甚至更多,一次性地将所有键值对rehash,会导致Redis服务在几秒钟甚至几十秒钟内停止响应,这对于单线程的Redis是很难承受的。
所以Redis采用了渐进式rehash的平滑扩容机制,它通过两个哈希表+渐进式rehash的方式来实现扩容机制,从而实现平滑扩容,又不阻塞读写。在Redis中,哈希表扩容或收缩时需要将 ht[0] 里面的所有键值对rehash到 ht[1] 里面。但是这个rehash动作并不是一次性、集中式地完成的,而是分多次、渐进式地完成的。
它的基本思想是:将原哈希表ht[0]中的键值对分批迁移到新哈希表ht[1]中,每次迁移一个桶(链表)的数据,同时保持两个哈希表都可用,直到所有数据都迁移完毕,然后释放原哈希表,将新哈希表设为ht[0]。
具体流程如下:
- 为ht[1]哈希表分配足够的内存空间,其大小取决于当前哈希表当前的负载因子和已保存节点数(即:ht[0].used)
- 维护rehashidx变量:这是一个索引计数器,表示当前要迁移的桶的位置。初始值为0,每次迁移一个桶后+1,直到等于原哈希表大小时,表示rehash完成。
- 在ht[0]中取出一个键值对进行rehash,并将其插入到ht[1]中,完成后rehashix的值需要+1。
- 重复步骤2,直到ht[0]中所有键值对都被rehash到ht[1]中。
- 完成rehash后,即当rehashidx等于原哈希表大小时,将rehashidx属性设为-1,释放ht[0]的内存空间,将ht[1]设置为ht[0],并在ht[1]中创建一个空白的哈希表,为下一次rehash做准备。
在每次执行增删改查操作时,都会检查是否需要执行渐进式rehash操作。每次对字典执行添加、删除、查找或更新操作时,除了执行指定的操作外,还会顺带将ht[0]中rehashidx位置上的所有键值对迁移到ht[1]中,并更新rehashidx的值。
跳表skiplist
ZSet 有两种不同的实现,分别是 ziplist 和 skiplist。具体使用哪种结构进行存储,规则如下:
- ziplist满足以下两个条件(Redis7.0以下使用)
- [value,score] 键值对数量少于 128 个
- 每个元素的长度小于 64 字节
- skiplist不满足以上两个条件时使用跳表、组合了 hash 和 skiplist
- hash 用来存储 value 到 score 的映射,这样就可以在 O(1) 时间内找到 value 对应的分数
- skiplist 按照从小到大的顺序存储分数
- skiplist 每个元素的值都是 [value,score] 对
什么是跳跃表
跳跃表(skiplist)是一种有序数据结构,它通过在每个节点中维持多个指向其他节点的指针,从而达到快速访问节点的目的。它的效率和红黑树以及 AVL 树不相上下,但实现起来比较容易。是一种可以于平衡树媲美的层次化链表结构——查找、删除、添加等操作都可以在对数期望时间下完成。跳跃表支持平均O (LogN)、最坏O(N) 复杂度的节点查找,还可以通过顺序性操作来批量处理节点。在大部分情况下,跳跃表的效率可以和平衡树相媲美,并且因为跳跃表的实现比平衡树要来得更为简单,所以有不少程序都使用跳跃表来代替平衡树。Redis使用跳跃表作为有序集合键的底层实现之一,如果一个有序集合包含的元素数量比较多,又或者有序集合中元素的成员(member)是比较长的字符串时,Redis就会使用跳跃表来作为有序集合键的底层实现。
zskiplist 结构属性
- header:指向跳跃表的表头节点
- tail:指向跳跃表的表尾节点
- level:记录目前跳跃表内,层数最大的那个节点层数(表头节点的层数不计算在内)
- length:记录跳跃表的长度,也就是跳跃表目前包含节点的数量(表头节点不计算在内)
zskiplistNode 结构属性
- 层(level):节点中用 L1、L2、L3 等字样标记节点的各个层,L1 代表第一层,L2 代表第二层,以此类推。每个层都带有两个属性:前进指针和跨度。前进指针用于访问位于表尾方向的其它节点,而跨度则记录了前进指针所指向节点和当前节点的距离。
- 后退(backward)指针:节点中用 BW 字样标识节点的后退指针,它指向位于当前节点的前一个节点。后退指针在程序从表尾向表头遍历时使用。
- 分值(score):各个节点中的 1.0、2.0 和 3.0 是节点所保存的分值。在跳跃表中,节点按各自所保存的分值从小到大排列。
- 成员对象(obj):各个节点中的 o1、o2 和 o3 是节点所保存的成员对象。
为什么使用跳跃表
上面所说的 zset 需要支持随机的插入和删除,所以它不宜使用数组来实现,关于排序问题,我们也很容易就想到红黑树/ 平衡树这样的树形结构,那为什么 Redis 不使用这样一些结构呢?主要两方面进行考虑:
- 实现方面:在复杂度与红黑树相同的情况下,跳跃表实现起来更简单,看起来也更加直观,比如平衡树的插入和删除操作可能引发子树的调整,逻辑复杂,而 skipList 的插入和删除只需要修改相邻节点的指针,操作简单又快速。
- 性能方面:在高并发的情况下,树形结构需要执行一些类似于 rebalance 这样的可能涉及整棵树的操作,相对来说跳跃表的变化只涉及局部。
双向链表
redis的双向链表(linkedlist)是基于链表的一种数据结构
链表是一种常见的基础数据结构,是一种非顺序存储数据的线性表,在每一个节点里存储了下一个节点的指针
链表充分利用内存实现灵活的内存动态管理,但是失去了数组随机读取的优点,同时链表由于增加了结点的指针域,空间开销比较大
Redis中linkedlist特性
- 双向: linkedlist的每个节点都包含前置节点和后置节点的指针
- 无环: 头节点的prev指针和尾节点的next指针都指向 NULL
- 常数时间复杂度获取linkedlist长度:len属性获取链表长度的时间复杂度为O(1)
优缺点
优点:增删节点无需内存重排,直接操作复杂度为 O(1)。维护了 len 字段,取长度操作为 O(1)
缺点:由于各节点在内存上不连续,遍历搜索复杂度为 O(N)。但可以通过空间换时间,使用 O(N) 空间的哈希表,可将搜索复杂度降为 O(1),这点在链表实现 LRU 时有应用。
结构
// 链表节点结构
typedef struct listNode {
    struct listNode *prev; // 前驱节点
    struct listNode *next; // 后继节点
    void *value;           // 节点值,类型为 void*,可保存任意类型的数据
} listNode;

// 双端链表结构,注意是无环的
typedef struct list {
    listNode *head; // 表头节点
    listNode *tail; // 表尾节点

    void *(*dup)(void *ptr); // 节点值复制函数
    void (*free)(void *ptr); // 节点值释放函数
    int (*match)(void *ptr, void *key); // 节点值对比函数

    unsigned long len; // 链表所包含的节点数量
} list;
整数数组intset
intset的实现
typedef struct intset {
    uint32_t encoding; // encoding 决定该集合存储的整数的类型
    uint32_t length; // length 记录了整个集合的元素数量,即 contents 数组的长度,当需要获取元素个数的时候,直接返回这个值就行了,时间复杂度 O(1);
    int8_t contents[]; // 是一个柔性数组,它里面存储的就是 intset 的所有整数项,需要注意的是,虽然 contents 是 int8_t,不表示 contents 内部只能存 int8_t 类型的数据
} intset;
升级和降级
当我们需要将一个新的元素放入到集合中,并且这个新的数据比集合中的其他元素的类型的最大值还要大的时候,Redis 就需要统一使用较大的类型来存储了,即需要扩容,这在 Redis 中叫做升级(upgrade)。
Redis 中升级集合并添加新元素总共需要三步:
- 根据新元素的大小,确定数组的类型,并为数组分配空间;
- 将底层已存在的转换成新的类型,并按照原先的顺序,放置在固定的内存位置上;
- 将新元素放在数组里。
因为集合中的元素都是有序的,就算我们不需要进行升级,仍然需要从头遍历元素,也就是还是上面三步,所以插入元素的时间复杂度为 O(N)。
一旦出现需要升级操作,则表示新元素一定比老的元素要大,所以新元素放在最后就好。
Redis 的 intset 是不支持降级操作的,一旦数据升级,就会保持升级之后的类型,哪怕唯一个占用内存大的元素被删除了,剩下的元素仍然占用大的类型的元素占用的内存。
总结
- 整数集合的底层实现是数组,这个数组以有序、无重复的方式存储元素,在需要时会根据新添加元素的类型升级数组的类型。
- 只支持升级操作,不支持降级操作
- 整数集合是有序集合的底层实现之一
快速列表quicklist
quicklist 实际上是 zipList 和 linkedList 的混合体,它将 linkedList 按段切分,每一段使用 zipList 来紧凑存储,多个 zipList 之间使用双向指针串接起来。在列表元素较少的情况下会使用一块连续的内存存储,这个结构是zipList,他将所有的元素紧挨着一起存储。当数据量较多时才会改成quickList,因为普通的链表需要的附加指针空间太大,会比较浪费空间,而且会加重内存的碎片化。比如列表存的只是int类型,结构上还需要两个额外的指针prev和next,甚至指针占用的大小超过了实际数据占用的内存。
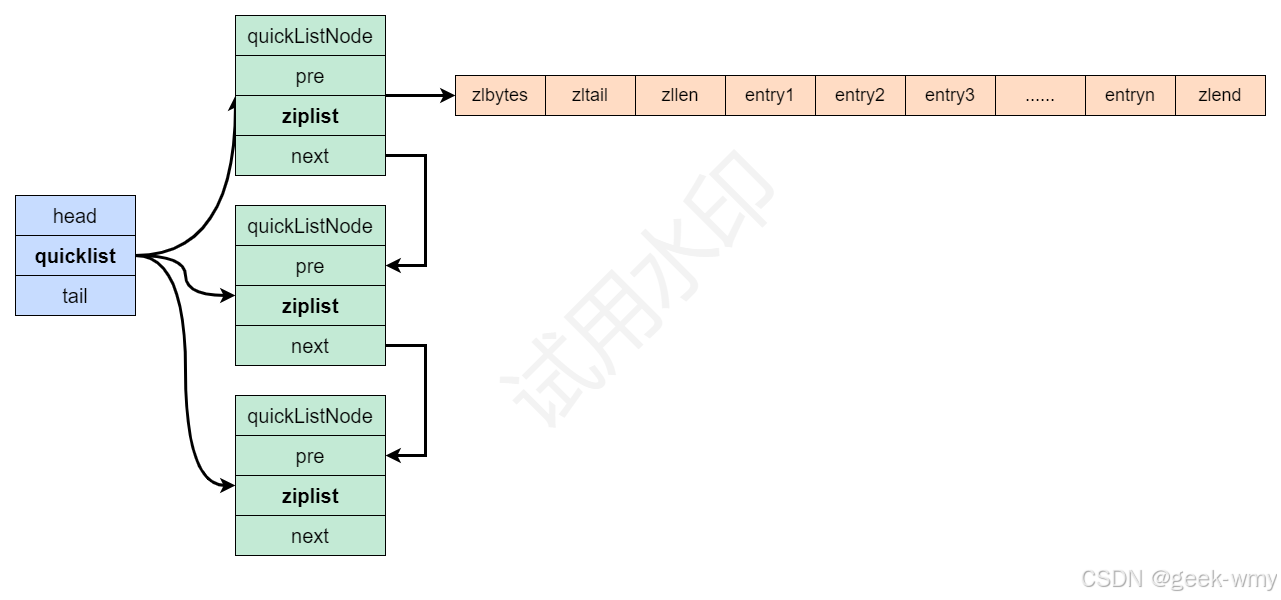
quicklist表头结构
typedef struct quicklist {
    quicklistNode *head;
    quicklistNode *tail;
    unsigned long count;
    unsigned long len;
    int fill : QL_FILL_BITS;
    unsigned int compress : QL_COMP_BITS;
    unsigned int bookmark_count: QL_BM_BITS;
    quicklistBookmark bookmarks[];
} quicklist;
这个结构体定义了 quicklist 的布局,在 64 位的操作系统中它使用了 40 字节。看起来不是很复杂。结构中的各项代表含义如下:
- quicklistNode:32字节的结构体,用于描述 ziplist 的节点。这里很明显的体现了 quicklist 是一个复合的数据类型,在本版本中是且包含了 ziplist 的,未来可能会出现其他的结构体作为选项。
- count:记录所有节点中 ziplist 的所有 entry 的数量。比如有 2 个节点,每个节点中 ziplist 有 3 个 entry 。那这个值就是 6。
- len: 记录所有节点的数量。
- fill:记录控制节点中 ziplist 的最大 entry 个数,由参数 list-max-ziplist-size 控制。
- compress :记录控制 quicklist 左右两边 quicklistNode 不被压缩的个数,由参数 list-compress-depth 控制。取 0 时候代表不压缩,大于0 代表前后分别被压缩的个数。
- bookmark_count :记录数组 bookmarks[] 的长度。Redis 高版本 6.0 才新加的。
- bookmarks :quicklist重新分配内存空间时使用,否则只是声明不张占用内存空间。同样也是 6.0 后新增。
quicklistNode节点结构
typedef struct quicklistNode {
    struct quicklistNode *prev;
    struct quicklistNode *next;
    unsigned char *zl;
    unsigned int sz;
    unsigned int count : 16;
    unsigned int encoding : 2;
    unsigned int container : 2;
    unsigned int recompress : 1;
    unsigned int attempted_compress : 1;
    unsigned int extra : 10;
} quicklistNode;
Redis 会将 quicklistNode 控制在 32 个字节大小,其中每项的定义如下:
- quicklistNode *prev、*next :记录前后节点的指针,quicklist 是一个双向链表。
- *zl:指针类型。若当前节点没有被压缩,则指向 ziplist 结构;否则指向 quicklistLZF 结构,下面还会解读。
- sz:记录 ziplist 总字节数。包括所有的结构,若不记得了,先去看看文章:《ziplist - 压缩列表》。
- count:记录 ziplist 的 entry总个数。
- encoding:记录当前节点是否被压缩,若被压缩则也同时指定压缩算法。当前版本只有 RAW1 or LZF2 取值。1代表没压缩;2代表被压缩且使用了 LZF 压缩算法。这个算法可以在 lzf.c 文件中了解。
- container:记录节点数据是使用那种结构存储。目前版本默认选择 ziplist ,取值范围 NONE1 or ZIPLIST2 ,是一个预留的字段,可能后续还会出现其他的结构。
- recompress:记录标记该节点是否需要被压缩。当取值为 1 时候需要被压缩。
- attempted_compress:自动化测试程序才有用。
- extra:预留字段,可能后面的版本会使用。
quicklistLZF
上面 quicklistNode 若是被压缩则会使用 quicklistLZF 结构,它的布局是比较简单的
typedef struct quicklistLZF {
    unsigned int sz; /* LZF size in bytes*/
    char compressed[];
} quicklistLZF;
紧凑列表listpack
上面有说过ziplist结构会产生连锁更新问题,所以Redis7中设计了紧凑列表listpack,用来取代掉 ziplist 的数据结构,它通过每个节点记录自己的长度且放在节点的尾部,来彻底解决掉了 ziplist 存在的连锁更新的问题。
紧凑列表(listpack)是一种紧凑的列表存储方式,它用一块连续的内存空间来紧凑地保存数据,同时为了节省内存空间,listpack 列表项使用了多种编码方式,来表示不同长度的数据,这些数据包括整数和字符串。
下面是listpack的底层结构:
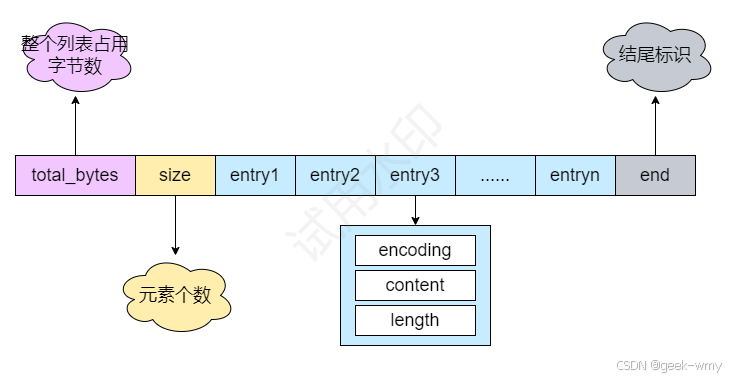
从定义可以看出,紧凑列表由一个字节数组和一些辅助信息组成,其中字节数组存储着所有的元素,辅助信息则记录了列表数据的长度、空闲空间大小和元素个数等信息。
紧凑列表中的每个元素都由一个或多个entry组成,一个entry包含一个编码类型、一个指向数据的指针和数据的长度。其中编码类型表示数据的类型和编码方式,指向数据的指针指向数据在字节数组中的起始位置,数据的长度则表示该entry中数据的长度。一个entry可以表示不同类型的数据,例如字符串、整数、浮点数等。
分析一下entry结构, 由于 Redis7.0 已经将 listpack 完整替代 ziplist,所以下面是 基于7.0版本介绍。在Redis 7中,entry的定义如下:
/* Each entry in the listpack is either a string or an integer. */
typedef struct {
    /* When string is used, it is provided with the length (slen).
     * 表示当前节点存储的字符串类型的数据,指向一个连续的内存块。
	*/
    unsigned char *sval;
    // 表示当前节点存储的字符串类型的数据的长度
    uint32_t slen;
    /* When integer is used, 'sval' is NULL, and lval holds the value. */
    // 表示当前节点存储的整数类型的数据。
    long long lval;
} listpackEntry;
可以看出,不同于ziplist,listpackEntry中的len记录的是当前entry的长度,而非上一个entry的长度。listpackEntry中可存储的为字符串或整型。
- 当存储的为字符串,那么lsentry的sval不为空,slen记录大小
- 当存储的为整形,那么lval记录整型,sval字段为空
和ziplist 列表项类似,listpack 列表项也包含了元数据信息和数据本身。不过,为了避免ziplist引起的连锁更新问题,listpack 中的每个列表项不再像ziplist列表项那样保存其前一个列表项的长度。
紧凑列表相比于压缩链表,有以下几个优点: - 更节省内存空间:紧凑列表将所有的值紧凑地存储在一块连续的内存空间中,没有额外的指针开销。同时,紧凑列表会根据值的大小动态选择合适的字节数来存储,避免浪费内存。此外,紧凑列表还会对相邻的小整数进行编码优化,进一步节省空间。
- 支持更快地在两端插入或删除值:紧凑列表可以在O(1)时间内在列表的头部或尾部插入或删除值,与压缩链表一样。但是,紧凑列表在插入或删除值时,不需要移动后面所有值的内存空间,而是通过一种差分编码技术来更新后面所有值的长度信息,提高效率。
- 支持更快地获取指定位置或范围内的值:紧凑列表可以在O(1)时间内获取列表的头部或尾部的值,或者在O(log n)时间内获取指定位置上的值,或者在O(n)时间内获取指定范围内的所有值。与压缩链表相比,紧凑列表在获取指定位置上的值时,不需要从头或尾开始遍历,而是通过二分查找来定位到目标位置,提高效率。
对于紧凑列表来说,虽然它具有一定的优势,但也有其明显的缺点。 - 由于它采用的是一段连续的字节数组来存储多个元素,因此在对元素进行修改时需要对整个字节数组进行重新分配。这样的操作可能会导致大量的内存复制操作,从而影响性能。
- 在进行元素查找时,需要遍历整个字节数组才能找到目标元素,这也会带来一定的性能损失。
因此,在实际使用中,我们需要根据数据类型的特点来选择合适的数据结构来存储数据。 - 如果我们需要存储一些单一类型的数据,那么使用整数数组或者压缩列表可能更为适合。
- 如果我们需要存储一些复杂类型的数据,比如哈希表或者跳表等,那么我们可以考虑使用这些数据结构来存储数据。
当然,在具体选择数据结构时,还需要考虑访问模式、数据规模、并发性等因素,综合考虑选择最优的方案。如果数据的类型比较简单,而且经常需要进行修改操作,那么使用快速列表可能会更为适合。而如果数据类型比较复杂,而且对存储空间的利用效率要求比较高,那么使用紧凑列表可能会更为合适。

 749


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


