数据结构---Trie

Trie与可持久化Trie Trie,也称为字典树或前缀树,是一种用于高效存储和检索字符串的树形数据结构。它的主要特点是利用字符串的公共前缀来减少存储空间和提高查询效率。下面是对 Trie 的常见操作的介绍:插入(Insertion):将一个字符串插入到 Trie 中。从根节点开始,逐个字符检查字符串,并根据字符是否存在于当前节点的子节点中进行相应的操作。如果字符不存在,则创建一个新的节点并将其链接到当前节点的子节点上。删除(Deletion):从 Trie 中删除一个字符串。与插入操作类似,逐个字符检查字符串并找到对应的节点。 阅读详情

1.01 Trie

Trie,又称字典树、单词查找树或键树,是一种树形结构,是一种哈希树的变种。
典型应用:是用于统计,排序和保存大量的字符串(但不仅限于字符串),所以经常被搜索引擎系统用于文本词频统计。
它的优点是:利用字符串的公共前缀来减少查询时间,最大限度地减少无谓的字符串比较,查询效率比哈希树高。

1.Trie的核心思想:

是空间换时间,利用字符串的公共前缀来降低查询时间的开销以达到提高效率的目的。

2.Trie的理解:
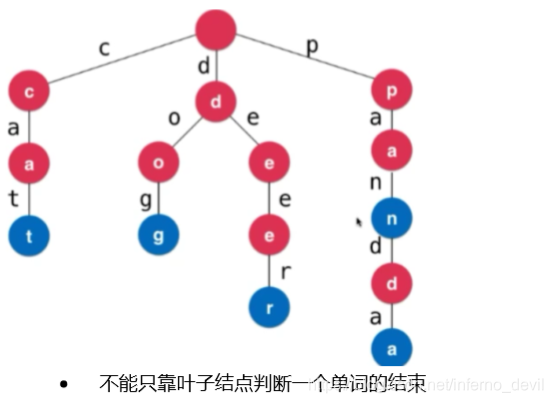
在这里插入图片描述在这里插入图片描述

3.Trie的基本性质:

根节点不包含字符,除根节点外每一个节点都只包含一个字符。
从根节点到某一节点,路径上经过的字符连接起来,为该节点对应的字符串。
每个节点的所有子节点包含的字符都不相同。

4.Trie的应用:

  1. 串的快速检索

      给定N个互不相同的仅由一个单词构成的英文名,让你将他们按字典序从小到大
    输出,用字典树进行排序,采用链表的方式创建字典树,这棵树的每个结点的所有
    儿子很显然地按照其字母大小排序。对这棵树进行先序遍历即可。
    

在这里插入图片描述

  1. “串”排序

      对所有串建立字典树,对于两个串的最长公共前缀的长度即他们所在的结点
    的公共祖先个数,于是,问题就转化为当时公共祖先问题。
    
  2. 最长公共前缀

      字典树把要查找的关键词看作 一个字符序列,并根据构成关键词字符的先后
    顺序构造用于检索的树结构。一棵n度的字典树或者为空,或者由n棵n度的字典树
    构成。 在进行查找字符的时候是按照树结构广度遍历的方式来遍历树中每一个结点数据信息。
    
  3. 典树拼法检查算法

    (1)对关键词拼法检查,总是在字典树的根结点开始,且树的根结 点为空。
    (2)扫描第一层各个结点获得查找关键词的第一个字符,并根据 关键词的第二个
    字符选择对应的子树并转到该子树继续进行检索所在 层各个结点信息,如果查找
    成功则转到;否则,继续选择对应的子树进行搜索。
    (3)关键词的所有字符已被扫描完毕,则读取附在该结点上的数 据信息,即完成
    对关键词的扫描过程,匹配结束。如果扫描后,没有匹 配的字符,则匹配失败,输出可能字符串。
    

1.02 Trie类的定义

  1. 定义类
public class Trie	//无需定义泛型 本身就是对字符串数据处理
  1. 定义内部类结点
private class Node{
	public boolean isWord;	//当前为止 是否已经组成一个单词
	public TreeMap<Character,Node> next;	//当前之后的字母以及其映射的结点
	public Node(boolean isWord){
		this.isWord=isWord;
		next=new TreeMap<Character,Node>();
	}
	public Node(){
		this(false);
	}
}
  1. 定义成员变量
private Node root;	//根节点
private int size;	//单词的个数
  1. 定义构造函数
public Trie(){
	root=new Node();
	size=0;
}
  1. 定义功能
//向Trie中添加一个新的单词word
public void add(String word){
	Node cur=root;	//cur指针从根节点开始
	for(int i=0;i<word.length();i++){
		char c=word.charAt(i);	//获取单词中的字母
		if(cur.next.get(c)==null){	//当前为叶子结点
			cur.next.put(c,new Node());	//添加字母
		}
		cur=cur.next.get(c);
	}
	if(!cur.isWord){	//如果是单词
		cur.isWord=true;	
		size++;
	}
}
//查询单词word是否存放在Trie中
public boolean contains(String word){
	Node cur=root;
	for(int i=0;i<word.lenght();i++){
		char c=word.charAt(i);
		if(cur.next.get(c)==null){	//如果树中没有这个字母
			return false;
		}
		cur=cur.next.get(c);
	}
	return cur.isWord;
}
//查询是否在Trie中有单词以prefix为前缀
public  boolean isPrefix(String prefix){
	Node cur=root;
	for(int i=0;i<prefix.length();i++){
		char c=prefix.charAt(i);
		if(cur.next.get(c)==null){
			return false;
		}
		cur=cur.next.get(c);
	}
	return true;
}

数据结构之Radix和Trie Radix和Trie 阅读详情

相关推荐

java实现的Trie树数据结构

最近在学习的时候,经常看到使用Trie树数据结构来解决问题,比如“ 有一个1G大小的一个文件,里面每一行是一个词,词的大小不超过16字节,内存限制大小是1M。返回频数最高的100个词。” 该如何解决? 有一种方案就是使用Trie树加 排序实现 。 什么是Trie 树呢?也就是常说的字典树,网上对此讲得也很多,简单补充一下个人理解: 它实际上相当于把单词的公共部分给拎出来,这样一层一层往上拎直

abcd_d_的专栏 1万+

「字符串」详解Trie(字典树|前缀树)并实现对应的功能 / 数据结构模版(C++)

字典树是一种高效记录字符串和查找字符串的数据结构。本文实现了这种数据结构。

dakingffo的博客 1705

【数据结构】Trie树

1.Trie树简介 Trie树,又称字典树、前缀树,被用于信息检索(information retrieval)的数据结构。Trie一词便来自于单词retrieval。基本思想:用字符串的公共前缀降低查询时间。比如,在最优的查询二叉树中查询关键字的时间复杂度为M * log N,M是字符串最大长度,N为字符串数量;而用Trie树时,只需O(M)时间。 [1] 中给出一个简单

听雨草堂 2518

一文绝对弄懂Trie(前缀树)数据结构

首先,我们需要定义一个Trie节点结构,表示Trie中的一个节点。public:// 子节点// 标记是否为单词的结尾// 构造函数// 析构函数children:存储子节点的映射(字符 → 子节点)。:标记当前节点是否为某个单词的结尾。TrieNode():构造函数,初始化节点。:析构函数,释放节点的内存。接下来,我们定义一个Trie类,包含对Trie的基本操作。private:// 根节点public:// 构造函数Trie();// 析构函数~Trie();

m0_74107848的博客 621

【愚公系列】数据结构(十)-Trie树

数据结构是计算机科学中的一个重要概念,它描述了数据之间的组织方式和关系,以及对这些数据的访问和操作。常见的数据结构有:数组、链表、栈、队列、哈希表、树、堆和图。数组(Array):是一种线性数据结构,它将一组具有相同类型的数据元素存储在一起,并为每个元素分配一个唯一的索引。数组的特点是具有随机访问的能力。链表(Linked List):也是一种线性数据结构,它由一系列的节点组成,每个节点包含数据和指向下一个节点的引用。链表的特点是可以动态地插入或删除节点,但访问某个节点时需要从头开始遍历。

愚公智库 48万+

AutoSAR RTE调度机制揭秘:从定时器事件到Runnable执行的完整流程

本文深入解析了AutoSAR RTE(运行时环境)的核心调度机制,详细阐述了从定时器事件触发到Runnable(可运行实体)执行的完整流程。通过剖析Rte_Start()函数、OS任务与警报的交互,以及事件驱动循环,揭示了RTE如何作为幕后指挥家,高效、可靠地协调软件组件间的周期性任务执行,是打通AutoSAR应用开发的关键。

weixin_29169899的博客 226

Trie 简介

一、Trie简介   在计算机科学中,Trie,又称字典树、前缀树、单词查找树或键树,是一种树形结构,是一种哈希树的变种。典型应用是用于统计,排序和保存大量的字符串(但不仅限于字符串),所以经常被搜索引擎系统用于文本词频统计。它的优点是:利用字符串的公共前缀来减少查询时间,最大限度地减少无谓的字符串比较,查询效率比哈希树高。   Trie树主要是利用词的公共前缀缩小查词范围、通过状态间的映射关...

weixin_30892037的博客 183

高频功率放大器的设计实现

摘 要 随着无线通信技术的高速发展,市场对射频电路的需求越来越大,同时对射频电路的性能要求也越来越高。高频功率放大器是位于无线发射级末端的重要部件,为了弥补信号在无线传输过程中的衰耗,要求发射机具有较大功率的输出,通信距离越远,要求的输出功率越大。在高频范围内,为了获得足够大的高频输出功率,就要采用高频功率放大器。 本次课程设计的高频功率放大器的技术指标包括输出功率、效率、功率增益、由于高频频功率放大器的输出功率比较大,耗能比较多,所以工作效率就显得比较重要。本课程设计的高频功率放大器电路由两极功率放大器

qq_43543515的博客 3万+

数据结构:Trie(前缀树/字典树)

Trie 又称字典树、前缀树和单词查找树,是一颗非典型的多叉树模型,即每个结点的分支数量可能为多个。Trie这个名字取自“retrieval”,检索,读音和 try 相同。

m0_63997099的博客 3950

RocketMQ源码分析之消息轨迹

文章目录前言一、消息轨迹二、消息轨迹源码分析1、producer端2、consumer端三、消息轨迹中存储的信息1.TraceContext2.TraceBean3.TraceType四、总结 前言   本篇文章将会从以下方面介绍消息轨迹:什么是消息轨迹?如何启用消息轨迹?示例demo、消息轨迹的源码分析和消息轨迹中存储的信息。最后会用一张图来总结消息轨迹的工作原理。 一、消息轨迹 1.什么是消息轨迹? 消息轨迹是用来跟踪记录消息发送、消息消费的轨迹。 2.如何启用消息轨迹? broker端 需要在b

不爱学习的小妞博客 1076

思科模拟器实战:MQTT协议实现物联网设备通信全流程解析

本文详细解析了如何在思科模拟器中利用MQTT协议实现物联网设备通信的全流程。通过搭建网络拓扑、配置MQTT Broker与客户端,并编写发布/订阅逻辑,手把手指导读者完成一个“开关控制电灯”的经典物联网场景实验,帮助零成本掌握物联网通信核心。

weixin_29294975的博客 381

【数据结构与算法】Trie

本次要带大家认识的的是Trie,这是一个便于快速查询字符串等数据出现次数的数据结构,在算法竞赛中也是一个比较好用的结构。虽然使用也能实现类似功能,但是Trie更加节省空间并且在存储数字等结构,它还有无法代替的优势,这里先买个关子,在下面文章中我会详细讲解。Trie字典树又叫前缀树(prefix tree),用以较快速地进行单词或前缀查询。Trie树本质上就是一棵多叉树,用来存储字符串或者其他数据。

白晨的博客 1912

MC_SetOverride指令详细应用介绍(基恩士PLC)

基恩士KV系列PLC和松下总线绝对值伺服运动控制(详细配置+轴控完整ST源代码)

RXXW_Dor的博客 334

【数据结构】Trie

Trie需求简介接口设计实现类测试类总结 需求 如何判断一堆不重复的字符串是否以某个前缀开头? 用Set\Map存储字符串 遍历所有字符串进行判断 时间复杂度: O(n) 有没有更优的数据结构实现前缀搜索 Trie 简介 Trie 也叫做字典树、前缀树(Prefix Tree)、单词查找树 Trie搜索字符串的效率主要跟字符串的长度有关 假设使用Trie存储cat、dog、doggy、does、cast、add六个单词 接口设计 或者 实现类 public class Trie<

qq_43478625的博客 431

[AI] 嵌入模型选择:bge / text-embedding-3 / Jina Embeddings 对比与选型指南

摘要: 本文对比了BGE-M3、OpenAI和Jina三种主流嵌入模型在语言覆盖、性能、延迟、维度和成本等维度的差异。BGE-M3适合中文场景,本地部署成本低;OpenAI API多语能力强但依赖网络;Jina在多语表现突出但需关注商用许可。测试显示BGE-M3本地延迟3-6ms,OpenAI API延迟200-600ms。选型建议:隐私场景选BGE本地部署,多语低维护选OpenAI,高精度选Jina。部署时需注意批处理优化、向量库压缩和商用许可等问题,建议建立评测指标并监控关键指标。

每日出拳老爷子的博客 428

大模型系列——Ollama简明教程

在这篇文章中,我们将了解如何使用 Ollama、如何在 Ollama 中创建自己的模型 以及如何使用 Ollama 构建聊天机器人。这是深入研究 Ollama 的第一部分,以及我所学到的有关本地 LLM 的知识以及如何将它们用于基于推理的应用程序。在这篇文章中,你将了解——

2401_84052244的博客 1万+

树:Trie 数据结构

此外,trie数据结构可以用于基于前缀的搜索,而我们不能使用哈希表来进行基于前缀的搜索。为了在 Trie 数据结构中实现删除操作,我们首先搜索查询字符串是否存在于 Trie 中。在本文中,我们将讨论搜索操作,以检查查询函数中给出的整个字符串是否存在于 Trie 数据结构中。第二个参数是我们要插入到 Trie 数据结构中的字符串。我们将一一理解每一个操作的代码,然后在文章的后半部分实现Trie数据结构的整个代码。另一个需要注意的重要事项是 Trie 数据结构中的每个字符串都是按字典顺序从左到右排序的。

新华编程特战队 1485

1. linux系统下在QT中配置OPenCV开发环境

在Linux系统下配置OpenCV的开发环境,需要在官网上下载源码,并使用CMake工具对源码进行编译,与在Windows系统中配置相比复杂许多,本文linux系统为linux minit,opencv是最新版本4.7.0,不过对于linux和opencv的版本要求行不高。此项更改为自己OPenCV想要安装的路径内,默认是安装在**/usr/local。在打开的文件中添加下图中的一行代码,路径是opencv默认的安装路径。按钮,弹出下图界面,默认选择即可,然后点击。

山间点烟雨 2906

数据结构之Trie树

搜索引擎的搜索关键词提示功能,我想你应该不陌生吧?为了方便快速输入,当你在搜索引擎的搜索框中,输入要搜索的文字的某一部分的时候,搜索引擎就会自动弹出下拉框,里面是各种关键词提示。你可以直接从下拉框中选择你要搜索的东西,而不用把所有内容都输入进去,一定程度上节省了我们的搜索时间。像Google、百度这样的搜索引擎,它们的关键词提示功能非常全面和精准,肯定做了很多优化,但万变不离其宗,底层最基本的原理就是今天要讲的这种数据结构:Trie树。树,也叫“字典树”。顾名思义,它是一个树形结构。

weixin_44399827的博客 639

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

trie树的数据结构_Trie数据结构实现

trie树的数据结构 介绍 (Introduction ) The word trie is an inflix of the word “retrieval”, because the trie can find a single word in a dictionary with only a prefix of the word. 单词trie是单词“ re trie val”的词缀,因为t...

523

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

数据结构之trie树

今天看了下trie树,总结下: 1、trie树定义: trie树可以看做用位置来标记元素。 下图是一个trie树的例子: 从图中可以知道,从跟节点开始遍历树的话,在一个路径上会生成单词(当然不一定遍历到叶子节点,图中是叶子节点才形成一个单词,但实际中并不一定这样的。可以在路径中的某个子路径上形成一个单词,当然这样的话需要通过一定的标记来说明一个单词已经形成了) 可以通过

疯狂算法~ 4751

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

【Trie树数据结构及其应用】

Trie树是一种高效的字符串存储和检索数据结构,具有很高的空间和时间效率。在实际开发过程中,根据具体需求选择合适的数据结构来提高程序的性能和可维护性。在处理具有大量相同前缀字符串的场景时,Trie树是一个非常实用的选择。

我是Java程序员廖志伟,感谢朋友们的支持! 1089

【数据结构】01Trie

01Trie是字典树的一种变种,其只有两种情况,即 0 和 1,实现方式其实和字典树是一样的。

qq_61422664的博客 1223

Trie树数据结构模板

Trie树数据结构模板Trie树 Trie树 int son[N][26], cnt[N], idx; // 0号点既是根节点,又是空节点 // son[][]存储树中每个节点的子节点 // cnt[]存储以每个节点结尾的单词数量 // 插入一个字符串 void insert(char *str) { int p = 0; for (int i = 0; str[i]; i ++ ) { int u = str[i] - 'a'; if (!so.

佛系更新 719

C++ 高级数据结构——Trie树

trie树,又称字典树或前缀树,是一种有序的、用于统计、排序和存储字符串的数据结构,它与二叉查找树不同,关键字不是直接保存在节点中,而是由节点在书中的位置决定。 一个节点的所有子孙都有相同的前缀,也就是这个节点对应的字符串,而根节点对应空字符串。一般情况下,不是所有的节点都有对应的值,只有叶子节点和部分内部节点所对应的键才有相关的值。 trie树的最大优点就是利用字符串的公共前缀来减少存储空间与查...

weixin_44208324的博客 879

数据结构之Trie——Java实现

Trie ◼ Trie 也叫做字典树、前缀树(Prefix Tree)、单词查找树 ◼ Trie 搜索字符串的效率主要跟字符串的长度有关 ◼ 假设使用 Trie 存储 cat、dog、doggy、does、cast、add 六个单词 实现代码 package trie; import java.util.HashMap; public class Trie<V> { private int size; private Node<V> root; public int

Mrrr_Li的博客 551
上一篇: 数据结构---堆和优先队列
下一篇: LeetCode98. 验证二叉搜索树(java)
inferno devil
博客等级 码龄9年 54粉丝 172原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值