【从caffe到Tensorflow 1】io 操作

caffe/PyTorch/TensorFlow 在Jupyter Notebook GPU中运用 Caffe、TensorFlow、Pytorch 阅读详情

最近项目要频繁用到tensorflow,所以不得不认真研究下tensorflow而不是跟之前一样遇到了就搞一下了。

首先我觉得所有这些框架里面caffe是最清晰的,所以就算是学习tensorflow,我也会以caffe的思路去学习,这就是这个系列的用意。

今天是第1篇,咱们说io操作,也就是文件读取,载入内存。

01

Caffe的io操作

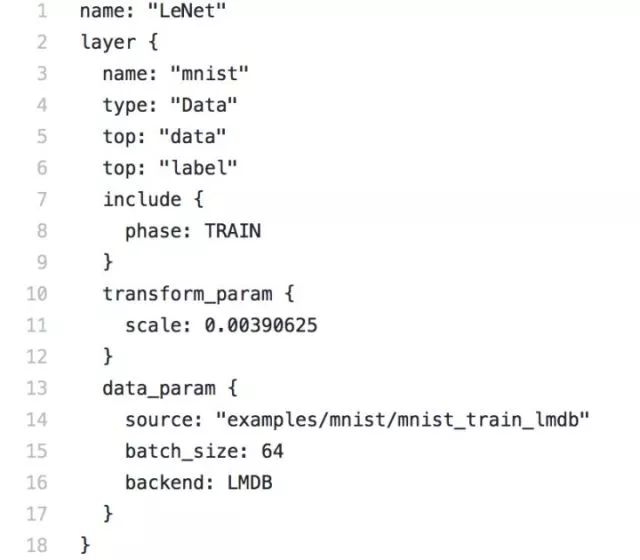
caffe的io,是通过在prototxt中定义数据输入,默认支持data,imagedata,hdf5data,window data等类型。Data layer,输入是LMDB数据格式,image data 支持的是image list的数据格式。

对于LMDB来说,我们在caffe layer中配置准备好的二进制数据即可。

对于image data,我们准备一个data list,官方的image data是一个分类任务的list,格式为每行image,label,当然随着任务的不同我们可以自定义。比如分割任务image,mask。检测任务,image num of object, object rect1,object rect2等。

典型的格式是这样:
640?wx_fmt=jpeg

具体的载入,就是在相关层的DataLayerSetUp函数中设置好输入大小,load_batch函数中,读取原始数据,再利用data_transform塞入内存。

当然caffe也可以自定义python层使用,不过我还是更习惯c++,何况这里比较的也是官方自带的layer。

从上面我们可以看出,caffe的io都是从文件中载入,只是文件的组织方式不同。

Tensorflow的io输入则要复杂,全面很多,我们参考tensorflow1.5的API。

http://link.zhihu.com/?target=https%3A//

www.tensorflow.org/api_docs/python/tf/data

02

Tensorflow的io操作

Tensorflow不止是读取文件这一种方法,它可以包含以下几种方式。

  • 预加载数据: 在TensorFlow图中定义常量或变量来保存所有数据(仅适用于数据量比较小的情况)

import tensorflow as tf

如上,x1,x2都是预加载好的数据。在设计Graph的时候,x1和x2就已经被定义成了两个有值的列表,在计算y的时候直接取x1和x2的值。这种方法的问题是将数据直接内嵌到Graph中,再把Graph传入Session中运行。当数据量比较大时,Graph的传输会遇到效率问题。

  • Feeding 它定义变量的时候用占位符替代数据,待运行的时候填充数据。

import tensorflow as tf

定义的时候,x1, x2只是占位符所以没有具体的值,运行的时候使用sess.run()中的feed_dict参数,将Python产生的数据喂给后端,并计算y。

  • Reading From File

前两种方法很方便,但是遇到大型数据的时候就会很吃力,即使是Feeding,中间环节的增加也是不小的开销,比如数据类型转换等等。而且,面对复杂类型的数据,也是处理不过来的。因此与caffe一样,tensorflow也是支持从文件中读取数据。

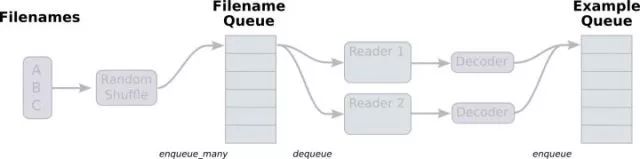
下面举一个利用队列读取硬盘中的数据到内存的例子:假如需要读取的数据存在一个list中。这篇博客举了一个很好的例子;

http://honggang.io/2016/08/19/tensorflow-data-reading/
640?wx_fmt=jpeg

在上图中,首先由一个单线程把文件名堆入队列,两个Reader同时从队列中取文件名并读取数据,Decoder将读出的数据解码后堆入样本队列。

利用了string_input_producer + tf.TextLineReader() + train.start_queue_runners来读取数据,string_input_producer的定义在

https://github.com/tensorflow/tensorflow/blob/r1.5/tensorflow/python/training/input.py

string_input_producer(

从上面可见,可以指定num_epochs,是否shuffle等,这就是一个最简单的从文件中读取的例子了。

假设有文件A.csv如下:

Alpha1,A1

Alpha2,A2

Alpha3,A3

单个reader读取单个数据脚本如下;

import tensorflow as tf

讲了上面的基础例子之后,我们开始看更复杂的例子。

上面的例子包含两类,一种是从placeholder读内存中的数据,一种是使用queue读硬盘中的数据,而1.3以后的Dataset API同时支持从内存和硬盘的读取。

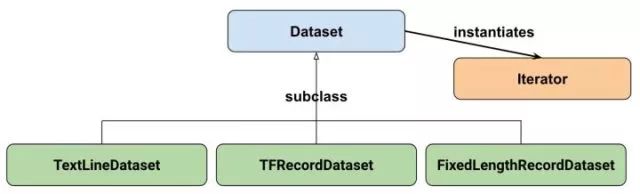
它们支持多种类型的输入,分别是FixedLengthRecordDataset, TextLineDataset, TFRecordDataset类型的。

TextLineDataset:这个函数的输入是一个文件的列表,输出是一个dataset。dataset中的每一个元素就对应了文件中的一行。可以使用这个函数来读入CSV文件,跟上面例子类似。

TFRecordDataset:这个函数是用来读TFRecord文件的,dataset中的每一个元素就是一个TFExample,这是很常用的。

FixedLengthRecordDataset:这个函数的输入是一个文件的列表和一个record_bytes,之后dataset的每一个元素就是文件中固定字节数record_bytes的内容。通常用来读取以二进制形式保存的文件,如CIFAR10数据集就是这种形式。

迭代器:提供了一种一次获取一个数据集元素的方法。

所有定义都在tensorflow/python/data/ops/readers.py中。

参考文章

https://zhuanlan.zhihu.com/p/30751039
640?wx_fmt=jpeg

我们先理解一下dataset是什么?

Dataset可以看作是相同类型“元素”的有序列表,而单个“元素”可以是向量,也可以是字符串、图片,甚至是tuple或者dict。

先以最简单的,Dataset的每一个元素是一个数字为例:

import tensorflow as tf

这样,我们就创建了一个dataset,这个dataset中含有5个元素,分别是1.0, 2.0, 3.0, 4.0, 5.0。

如何将这个dataset中的元素取出呢?方法是从Dataset中示例化一个Iterator,然后对Iterator进行迭代。

iterator = dataset.make_one_shot_iterator()

对应的输出结果应该就是从1.0到5.0。语句iterator = dataset.make_one_shot_iterator()从dataset中实例化了一个Iterator,这个Iterator是一个“one shot iterator”,即只能从头到尾读取一次。one_element = iterator.get_next()表示从iterator里取出一个元素,调用sess.run(one_element)后,才能真正地取出一个值。

如果一个dataset中元素被读取完了,再尝试sess.run(one_element)的话,就会抛出tf.errors.OutOfRangeError异常,这个行为与使用队列方式读取数据的行为是一致的。在实际程序中,可以在外界捕捉这个异常以判断数据是否读取完,请参考下面的代码:

dataset = tf.data.Dataset.from_tensor_slices(np.array([1.0, 2.0, 3.0, 4.0, 5.0]))

dataset还可以有一些基本的数据变换操作,即transform操作,常见的有map,batch,shuffle,repeat

把数据+1dataset = dataset.map(lambda x: x + 1)

组合成batch,dataset = dataset.batch(32)

进行shuffle,dataset = dataset.shuffle(buffer_size=10000)

repeat 组成多个epoch,dataset = dataset.repeat(5)

03

来一个实例

理解了dataset之后,我们再看如何从文件中读取数据。由于tfrecord是非常常用的格式,下面我们就以这个为例。

假如我们有两个文件夹,一个是整理好的固定大小的图片,一个是对应label图片,这是一个分割任务,下面我们开始做。

  • 处理成tfrecord格式

首先,我们要把数据处理成tfrecord格式。

我们先定义一下存储格式:

直接贴完整代码了

import tensorflow as tf

_convert_to_example这个函数,就是定义存储的格式;tf.gfile.FastGFile就是读取图片原始文件格式且不编解码,writer = tf.python_io.TFRecordWriter(sys.argv[3])是定义writer,写起来其实挺简单。

tf.train.Example是一个protocol buffer,定义在

https://github.com/tensorflow/tensorflow/blob/r1.5/tensorflow/core/example/example.proto

将数据填入到Example后就可以序列化为一个字符串。一个Example中包含Features,Features里包含Feature,每一个feature其实就是一个字典,如上面的一个字典包含4个字段。

  • 读取tf.records

读取数据就可以使用tf.TFRecordReader的tf.parse_single_example解析器。它将Example protocol buffer解析为张量。

简单的利用队列读取,可以采用下面的方法

filename_queue = tf.train.string_input_producer([filename])

不过,我们这里利用新的API的dataset来读取,更加高效。直接贴上代码如下:

上面定义过_convert_to_example,我们这里先定义一个读取格式。

def _extract_features(example):

下面这个函数就是create迭代器了,在这里我们使用最简单的iterator,one-shot iterator来迭代,当然它只支持在一个dataset上迭代一次,不需要显式初始化。这里不需要怀疑epoch的问题,因为dataset.repeat(num_epoch)就会设置epoch数目,所以虽然只在dataset上迭代一次,但是已经遍历过数据epoch次。

def create_one_shot_iterator(filenames, batch_size, num_epoch):

就这样完毕!

打一个小广告,我的摄影中的图像基础技术公开课程《AI 程序员码说摄影图像基础》上线了,主要从一个图像处理工程师的角度来说说摄影中的基础技术和概念,欢迎大家订阅交流。
640?wx_fmt=png

加入我们做点趣事

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=png

微信

Longlongtogo

640?wx_fmt=png

公众号内容

1 图像基础|2 深度学习|3 行业信息

640?wx_fmt=jpeg 640?wx_fmt=jpeg

往期精彩


[caffe解读] caffe从数学公式到代码实现5-caffe中的卷积


打败了大魔王一统天下的男主角。

为了压榨CNN模型,这几年大家都干了什么

Windows:Opencv 调用深度学习模型(Caffe, Tensorflow)部署推理过程 Windows:Opencv 调用深度学习模型部署推理过程一、Opencv调用Caffe模型Step1:VS 基础设置Step2:Python代码Step3:C++代码Step4:对比总结二、调用Tensorflow pb模型文件 一、Opencv调用Caffe模型 Step1:VS 基础设置 包含文件目录.\include 库文件目录.\lib 链接器添加opencv_world420.lib Step2:Python代码 import cv2 as cv import numpy as np # 阅读详情

相关推荐

汽车OBD接口实战:如何用STM32读取CAN总线数据(附完整代码)

本文详细介绍了如何利用STM32微控制器通过汽车OBD接口读取CAN总线数据的完整实战方案。内容涵盖硬件连接(如OBD引脚定义与TJA1050收发器接线)、STM32的CAN外设初始化与滤波器配置,并深入解析OBD-II诊断协议,演示了如何请求和解析发动机转速、车速等关键数据。文末提供了构建稳定数据读取系统的代码框架与错误处理建议,为嵌入式开发者和汽车电子爱好者提供了从零到一的实践指南。

9q8w7e6r5的博客 304

tensorflow介绍_实例介绍TensorFlow的输入流水线

作者:叶 虎编辑:赵一帆前 言在训练模型时,我们首先要处理的就是训练数据的加载与预处理的问题,这里称这个过程为输入流水线(input pipelines,或输入管道,[参考:https://www.tensorflow.org/performance/datasets_performance])。在TensorFlow中,典型的输入流水线包含三个流程(ETL流程):提取(Ex...

weixin_31854867的博客 239

模糊控制——基本原理(附MATLAB程序)

模糊化:使用隶属函数将实际输入转换为模糊集合的隶属度值。规则库:利用“如果-那么”规则将模糊输入映射到模糊输出。推理机制:通过规则的模糊化和模糊集合的合成,生成模糊输出。去模糊化:将模糊输出转换为具体的控制信号,常用的方法包括质心法和最大隶属度法。这些步骤综合起来,实现了模糊控制系统对复杂和不确定系统的有效控制。模糊控制系统通过结合模糊逻辑和规则库来处理复杂系统中的不确定性和模糊性。它的核心在于模糊集合和隶属函数,通过推理机处理模糊规则,并最终通过去模糊化生成具体的控制信号。

qq_35623594的博客 5561

梳理caffe代码io(十三)

io包含了创建临时文件临时目录操作,以及从txt文件以及bin文件读取proto数据或者写入proto的数据到txt或者bin文件。io其实就是提供如何读取如何写入的一些读取图像或者文件,以及它们之间的一些转化的函数。 hpp文件: #ifndef CAFFE_UTIL_IO_H_ #define CAFFE_UTIL_IO_H_ #include #include #include

深藏功与名 1万+

Halcon实战:基于图像清晰度自动筛选最佳对焦图片

本文详细介绍了如何使用Halcon实现基于图像清晰度的自动筛选最佳对焦图片技术。通过分析灰度值统计和标准差等核心指标,结合实战代码示例,帮助开发者高效处理工业检测中的对焦问题,提升自动化检测的准确性和效率。

weixin_27015733的博客 444

Claude Code与Codex深度对比:终端AI编程助手选型指南

大语言模型驱动的AI编程助手已成为开发者提效的重要工具,它们基于自然语言交互,自动完成代码生成、重构和调试。这类工具依赖上下文理解与工程实践,不同产品在交互模式、模型接入和任务执行上差异显著。从终端CLI编程场景出发,梳理AI编程助手的设计原理与技术价值,重点对比Anthropic Claude Code与OpenAI Codex在安装配置、上下文管理、第三方模型接入(如DeepSeek)以及高频报错处理上的实际表现。无论你是新手还是资深工程师,理解这些差异有助于根据自身工作流选择合适工具,或在两者间灵活切

weixin_33755649的博客 3341

tensorflow——openpose代码和原理分析

 做openpose已经做了两个月了,精度和速度都还没有提上去,但是还是要总结一下。 人体姿态估计(pose estimation)的目标    实时地对图片中每个人的姿态进行精准的估计。总结起来,就是实时的多人姿态精准估计 现状     实时的算法精度不高,精度高的算法慢的要死。     openpose——比较快,比较准      cpn——慢,准(pass,在实际场景中,慢等于没...

芝士就是力量 2万+

Python3实现基于ARIMA模型来预测茅台股票价格趋势

ARIMA(Autoregressive Integrated Moving Average)模型是一种广泛使用的时间序列分析方法,它可以用于对未来的数据进行预测。ARIMA模型由自回归模型(AR模型)、差分整合模型(I模型)和移动平均模型(MA模型)组成,因此也被称为ARIMA(p,d,q)模型。其中,p表示自回归阶数,d表示差分阶数,q表示移动平均阶数。具体来说,ARIMA模型可以通过以下步骤进行建模:数据预处理:对时间序列进行平稳性检验,如果不满足平稳性,则进行差分操作。

m0_64336780的博客 2万+

RNN入门详解及TensorFlow源码实现--深度学习笔记

RNN入门详解及TensorFlow源码实现–深度学习笔记一、RNN简介RNNs的目的使用来处理序列数据。在传统的神经网络模型中,是从输入层到隐含层再到输出层,层与层之间是全连接的,每层之间的节点是无连接的。但是这种普通的神经网络对于很多问题却无能无力。例如,你要预测句子的下一个单词是什么,一般需要用到前面的单词,因为一个句子中前后单词并不是独立的。RNNs之所以称为循环神经网路,即一个序列当前的输

知行_那片天 1万+

论文阅读:2024 ACM CCS “Do Anything Now”: Characterizing and Evaluating In-The-Wild Jailbreak Prompts on

大语言模型(LLMs)的滥用问题引起了公众和大语言模型供应商的高度关注。有一种特殊的对抗性提示,叫做越狱提示,它已成为绕过防护措施、让大语言模型生成有害内容的主要攻击手段。在这篇论文中,作者使用新框架JailbreakHub,对2022年12月至2023年12月期间的1405个越狱提示进行了全面分析。作者识别出131个越狱提示社区,发现了越狱提示的独特特征以及主要攻击策略,比如提示注入和权限提升。

CSPhD-winston的博客 1414

PowerDesigner 数据库建模使用详解

PowerDesigner 数据库建模使用详解

congge 7082

TensorFlow和Caffe、MXNet、Keras等其他深度学习框架的对比

[转] http://www.leiphone.com/news/201702/T5e31Y2ZpeG1ZtaN.html 雷锋网按:本文作者黄文坚,PPmoney 大数据算法总监,《 TensorFlow 实战》作者。本文节选自《 TensorFlow 实战》第二章。 在下周二(2月28日)雷锋网(公众号:雷锋网)硬创公开课栏目将会推出黄文坚老师的公开课《深度学习之经典卷积神

xiangz_csdn的博客 5万+

ResNet改进(7):添加 SK注意力机制

实现 SK 注意力机制。

2401_82355416的博客 732

【Tensorflow】io 操作

文章首发于微信公众号《有三AI》 【从caffe到Tensorflow 1】io 操作 最近项目要频繁用到tensorflow,所以不得不认真研究下tensorflow而不是跟之前一样遇到了就搞一下了。 首先我觉得所有这些框架里面caffe是最清晰的,所以就算是学习tensorflow,我也会以caffe的思路去学习,这就是这个系列的用意。 今天是第1篇,咱们说io操作,也就是文件读取,载...

hacker_long的专栏 1443

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Caffe、TensorFlow、MXnet三个开源库对比

from http://chenrudan.github.io/blog/2015/11/18/comparethreeopenlib.html#0-tsina-1-2654-397232819ff9a47a7b7e80a40613cfe1 最近Google开源了他们内部使用的深度学习框架TensorFlow[1],结合之前开源的MXNet[2]和Caffe[3],对三个开源库做了一些讨

wangzhebupt的专栏 6283

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

tensorflow框架到caffe框架的模型转换

本文参考以下系列内容: tensorflow2caffe(1) : caffemodel解析,caffemodel里面到底记录了什么? tensorflow2caffe(2) : 如何在tensorflow中取出模型参数 tensorflow2caffe(3) : 如何将tensorflow框架下训练得到的权重转化为caffe框架下的权重参数 tensorflow2caffe(4) : c...

loveliuzz的博客 1457

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

【TensorFlow】Caffe模型转tensorflow模型并使用模型进行预测

做了一个Caffe模型转tensorflow的实验,把ResNet模型和prototxt转为tensorflow模型和tensorflow代码,挺有意思的。 主要参考: https://my.oschina.NET/yilian/blog/672135 这个开源项目 caffe-tensorflow 提供了caffe转tensorflow的功能: https://github.com/ethereo

FC_1231的博客 918

tensorflow 转 caffe(4)

转自:https://blog.youkuaiyun.com/jiongnima/article/details/78435500 在笔者的上一篇博客中,提到了如何从tensorflow框架下提取出模型参数并转化为caffe框架下的模型参数,并在最后生成了一个1.1GB的.prototxt格式的参数文件,该文件里面主要记录了网络架构以及各层对应的参数。可是我们在使用caffe进行网络前传得到结果的时候,是需...

gaotihong的博客 700

ubuntu14.04+cuda8.0+cudnn5.1+caffe+tensorflow 安装教程(二)

-要想安装深度学习平台caffe与tensorflow,基础是装好操作系统,装好cuda,再开始装学习平台。教程分为3个部分: 1、ubuntu14.04+cuda8.0+cudnn5.1安装 2、caffe安装 3、tensorflow安装 以此文感谢所有在互联网上分享知识的人和交流群中为我答疑解惑的人。Caffe安装参照官网说明 Caffe has several dependenc

echo爱毛毛的专栏 1850

【tensorflow2caffe】三、 将tensorflow框架下训练得到的权重转化为caffe框架下的权重参数

在博客开始前,首先郑重感谢博主jiongnima的博客对我的帮助,我按照博主的方法顺利的把bcnn模型的tensorflow版转为caffe版,关于bcnn模型,它是个细粒度分类模型,我将在后续的博客中详细介绍。 首先隆重呈上博主的链接: https://blog.youkuaiyun.com/jiongnima/article/details/78382972 转模型系列博文的操作主要基于博主...

zl3090的博客 687

tensorflow 转 caffe(1)

转自:https://blog.youkuaiyun.com/jiongnima/article/details/72904526 在本文正式开始之前,笔者要先和各位读者朋友们道个歉。因为身为研一小白的笔者实在身不由己,除了各种任务之外,还要应付繁忙的课程,忙于各种考试像一只咸鱼。因此耽误了博文的撰写,对不起各位读者朋友,笔者在忙完6月进入研二之后一定再接再厉。下面开始干货~ 本篇还是一个插播的博客...

gaotihong的博客 235

【tensorflow2caffe】一、caffemodel存储解析

在博客开始前,首先郑重感谢博主jiongnima的博客对我的帮助,我按照博主的方法顺利的把bcnn模型的tensorflow版转为caffe版,关于bcnn模型,它是个细粒度分类模型,我将在后续的博客中详细介绍。 首先隆重呈上博主的链接: https://blog.youkuaiyun.com/jiongnima/article/details/72904526 转模型系列博文的操作主...

zl3090的博客 917

PyTorch——nn.Conv2d和其中的padding策略,Caffe、Tensorflow的padding策略

caffe偷偷摸摸地把一行0补在上面 或者 把一列0补在左边,tensorflow正好镜像对称,把一行0补在下面或者把一列0补在右边。这就是导致输出对齐不了的原因,前面几层输出的feature map的中间还能勉强对上,随着网络结构的加深,到fc之前已经完全对不上了。 也就是说: caffe的padding策略是把0补在左上。 tensorflow的padding策略是把0补在右下。

AbiUni(YY熊) 1946

【tensorflow2caffe】四、 将权重写入deploy以及生成caffemodel

在博客开始前,首先郑重感谢博主jiongnima的博客对我的帮助,我按照博主的方法顺利的把bcnn模型的tensorflow版转为caffe版,关于bcnn模型,它是个细粒度分类模型,我将在后续的博客中详细介绍。 首先隆重呈上博主的链接: https://blog.youkuaiyun.com/jiongnima/article/details/78435500 转模型系列博文的操作主要基于博主...

zl3090的博客 941
上一篇: [caffe解读] caffe从数学公式到代码实现5-caffe中的卷积
下一篇: 【深度学习图像项目实战-从入门到上线1】怎样学会科学的调研并启动一个项目...
言有三
言有三 领域专家: 人工智能技术领域 领域专家: 人工智能技术领域
博客等级 码龄15年 3635粉丝 976原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

言有三

三人行必有AI

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值