DolphinScheduler 调度 DataX 实现 MySQL To ElasticSearch 增量数据同步实践

DolphinScheduler 调度 DataX 实现 MySQL To MySQL 增量数据同步实战 背景 MySQL库A 到 MySQL库B的增量数据同步需求 DolphinScheduler中配置DataX MySQL To MySQL工作流 工作流定义 工作流定义 > 创建工作流 > 拖入1个SHELL组件 > 拖入1个DATAX组件 SHELL组件(文章) 脚本 echo '文章同步 MySQL To MySQL'DATAX组件(t_article) 用到2个插件mysqlreader^[1]、mysqlwriter^[2] 选 自定义模板: { &q. 阅读详情

数据同步的方式

数据同步的2大方式

  • 基于SQL查询的 CDC(Change Data Capture):
    • 离线调度查询作业,批处理。把一张表同步到其他系统,每次通过查询去获取表中最新的数据。也就是我们说的基于SQL查询抽取;
    • 无法保障数据一致性,查的过程中有可能数据已经发生了多次变更;
    • 不保障实时性,基于离线调度存在天然的延迟;
    • 工具软件以Kettle(Apache Hop最新版)、DataX为代表,需要结合任务调度系统使用。
  • 基于日志的 CDC:
    • 实时消费日志,流处理,例如 MySQL 的 binlog 日志完整记录了数据库中的变更,可以把 binlog 文件当作流的数据源;
    • 保障数据一致性,因为 binlog 文件包含了所有历史变更明细;
    • 保障实时性,因为类似 binlog 的日志文件是可以流式消费的,提供的是实时数据;
    • 工具软件以Flink CDC、阿里巴巴Canal、Debezium为代表。

基于SQL查询增量数据同步原理

我们考虑用SQL如何查询增量数据? 数据有增加、修改、删除 删除数据采用逻辑删除的方式,比如定义一个is_deleted字段标识逻辑删除 如果数据是 UPDATE的,也就是会被修改的,那么 where update_datetime >= last_datetime(调度滚动时间)就是增量数据 如果数据是 APPEND ONLY 的除了用更新时间还可以用where id >= 调度上次last_id

结合任务调度系统 调度时间是每日调度执行一次,那么 last_datetime = 当前调度开始执行时间 - 24小时,延迟就是1天 调度时间是15分钟一次,那么 last_datetime = 当前调度开始执行时间 - 15分钟,延迟就是15分钟

这样就实现了捕获增量数据,从而实现增量同步

DolphinScheduler + Datax 构建离线增量数据同步平台

本实践使用 单机8c16g DataX 2022-03-01 官网下载 DolphinScheduler 2.0.3(DolphinScheduler的安装过程略,请参考官网)

DolphinScheduler 中设置好DataX环境变量 DolphinScheduler 提供了可视化的作业流程定义,用来离线定时调度DataX Job作业,使用起来很是顺滑

基于SQL查询离线数据同步的用武之地 为什么不用基于日志实时的方式?不是不用,而是根据场合用。考虑到业务实际需求情况,基于SQL查询这种离线的方式也并非完全淘汰了 特别是业务上实时性要求不高,每次调度增量数据没那么大的情况下,不需要分布式架构来负载,这种情况下是比较合适的选择 场景举例: 网站、APP的百万级、千万级的内容搜索,每天几百篇内容新增+修改,搜索上会用到ES(ElasticSearch),那么就需要把 MySQL内容数据增量同步到ES DataX就能满足需求!

DolphinScheduler中配置DataX MySQL To ElasticSearch工作流

工作流定义

工作流定义 > 创建工作流 > 拖入1个SHELL组件 > 拖入1个DATAX组件 SHELL组件(文章) 脚本

echo '文章同步 MySQL To ElasticSearch'

DATAX组件(t_article) 用到2个插件mysqlreader、elasticsearchwriter^[1] 选 自定义模板:

{
    "job": {
        "content": [
            {
                "reader": {
                    "name": "mysqlreader",
                    "parameter": {
                        "connection": [
                            {
                                "jdbcUrl": [
                                    "jdbc:mysql://${biz_mysql_host}:${biz_mysql_port}/你的数据库?useUnicode=true&zeroDateTimeBehavior=convertToNull&characterEncoding=UTF8&autoReconnect=true&useSSL=false&&allowLoadLocalInfile=false&autoDeserialize=false&allowLocalInfile=false&allowUrlInLocalInfile=false"
                                ],
                                "querySql": [
                                    "select a.id as pk,a.id,a.title,a.content,a.is_delete,a.delete_date,a.create_date,a.update_date from t_article a.update_date >= '${biz_update_dt}';"
                                ]
                            }
                        ],
                        "password": "${biz_mysql_password}",
                        "username": "${biz_mysql_username}"
                    }
                },
                "writer": {
                    "name": "elasticsearchwriter",
                    "parameter": {
                        "endpoint": "${biz_es_host}",
                        "accessId": "${biz_es_username}",
                        "accessKey": "${biz_es_password}",
                        "index": "t_article",
                        "type": "_doc",
                        "batchSize": 1000,
                        "cleanup": false,
                        "discovery": false,
                        "dynamic": true,
                        "settings": {
                            "index": {
                                "number_of_replicas": 0,
                                "number_of_shards": 1
                            }
                        },
                        "splitter": ",",
                        "column": [
                            {
                                "name": "pk",
                                "type": "id"
                            },
                            {
                                "name": "id",
                                "type": "long"
                            },
                            {
                                "name": "title",
                                "type": "text"
                            },
                            {
                                "name": "content",
                                "type": "text"
                            }
                            {
                                "name": "is_delete",
                                "type": "text"
                            },
                            {
                                "name": "delete_date",
                                "type": "date"
                            },
                            {
                                "name": "create_date",
                                "type": "date"
                            },
                            {
                                "name": "update_date",
                                "type": "date"
                            }
                        ]
                    }
                }
            }
        ],
        "setting": {
            "errorLimit": {
                "percentage": 0,
                "record": 0
            },
            "speed": {
                "channel": 1,
                "record": 1000
            }
        }
    }
}

reader和writer的字段配置需保持一致

自定义参数:

biz_update_dt: ${global_bizdate} 
biz_mysql_host: 你的mysql ip
biz_mysql_port: 3306
biz_mysql_username: 你的mysql账号
biz_mysql_password: 你的mysql密码
biz_es_host: 你的es地址带协议和端口 http://127.0.0.1:9200
biz_es_username: 你的es账号
biz_es_password: 你的es密码

配置的自定义参数将会自动替换json模板中的同名变量
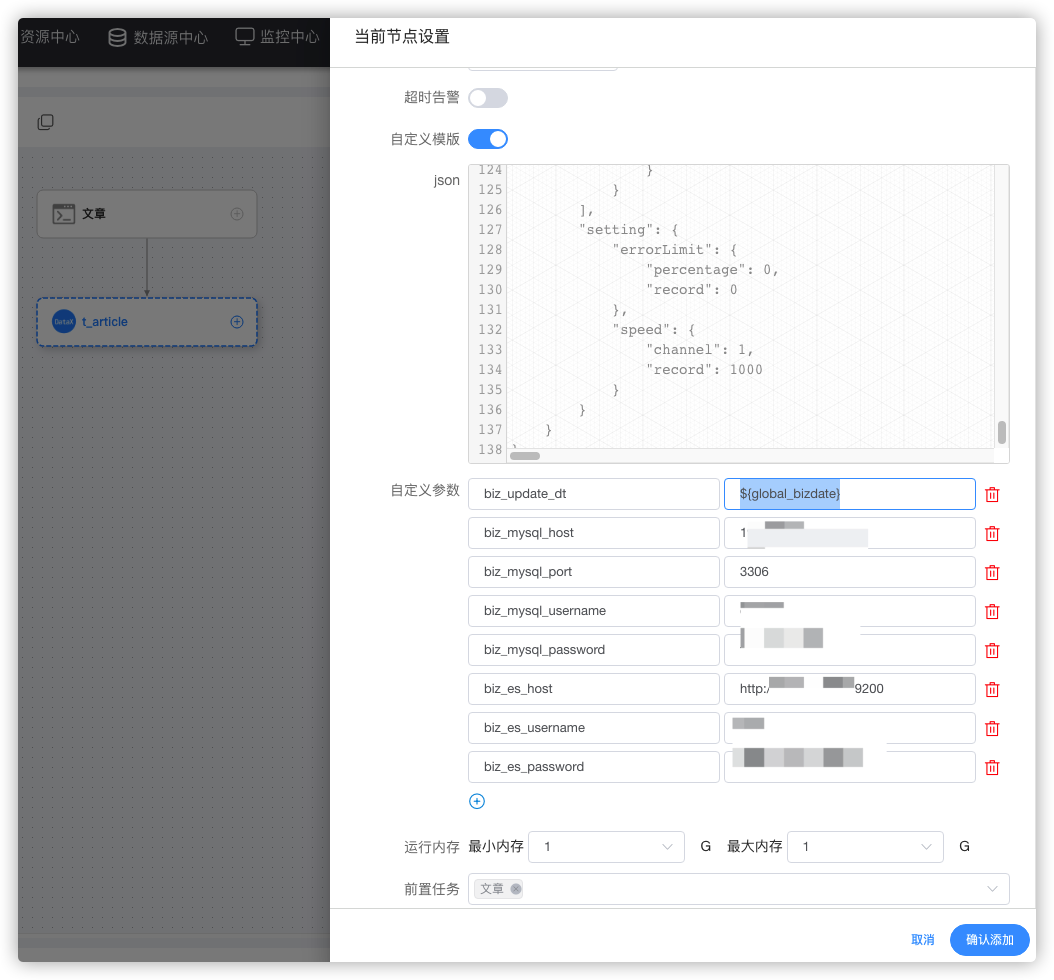
reader mysqlreader插件中关键配置: a.update_date >= '${biz_update_dt}' 就是实现增量同步的关键配置 writer elasticsearchwriter插件中关键配置: ``

"column": [
    {
        "name": "pk",
        "type": "id"
    },
    ......
]

type = id 这样配置,就把文章主键映射到es主键 _id 从而实现相同主键id重复写入数据,就会更新数据。如果不这样配置数据将会重复导入es中

保存工作流

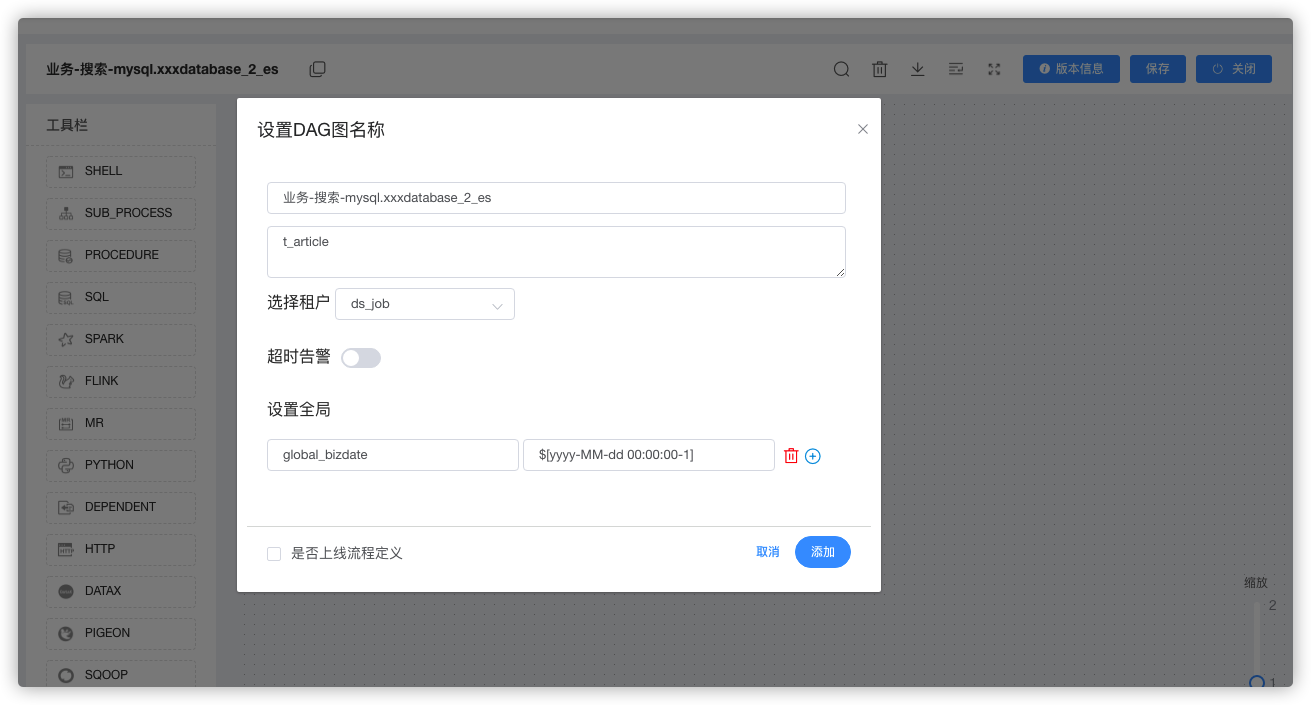
全局变量设置 global_bizdate: $[yyyy-MM-dd 00:00:00-1]

global_bizdate 引用的变量为 DolphinScheduler 内置变量,具体参考官网文档^[2] 结合调度时间设计好时间滚动的窗口时长,比如按1天增量,那么这里时间就是减1天
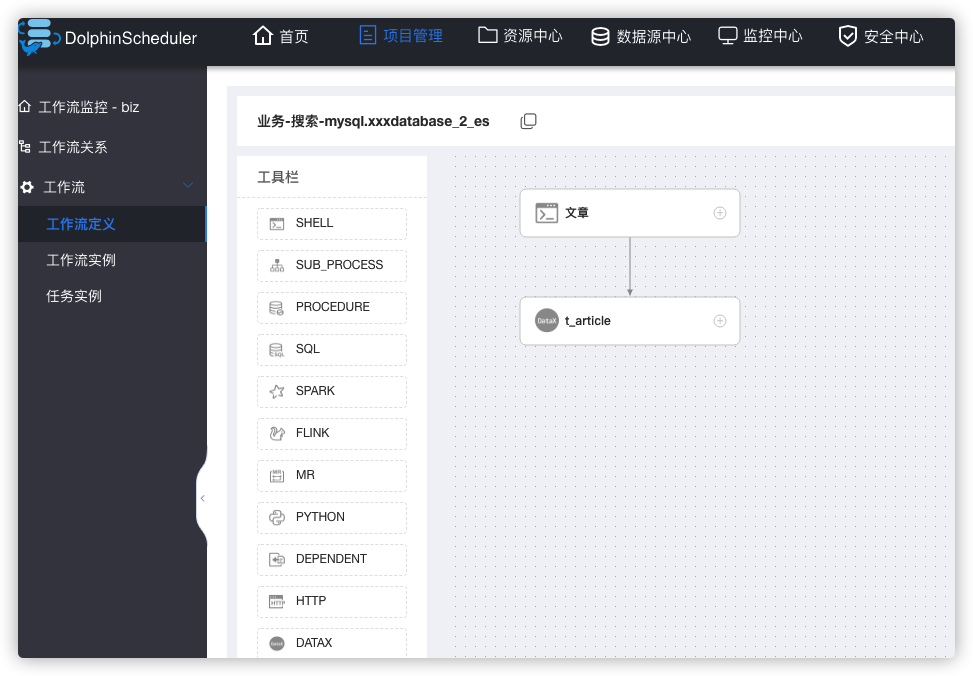
最终的工作流DAG图为:
by 流水理鱼|wwek

参考

1. DataX ElasticSearchWriter 插件文档 2. Apache DolphinScheduler 内置参数 本文首发于流水理鱼博客,如要转载请注明出处。 欢迎关注我的公众号:流水理鱼(liushuiliyu),全栈、云原生、Homelab交流。 如果您对相关文章感兴趣,也可以关注我的博客:www.iamle.com 上面有更多内容

【Dolphinscheduler3.2.0+DATAX】同步数据(mysql,pgsql,oracle,sqlserver)到clickhouse 【代码】【Dolphinscheduler3.2.0+DATAX】同步数据mysql到clickhouse。 阅读详情

相关推荐

基于dolphinscheduler的增量数据同步至hive分区表

基于dolphinscheduler的增量数据同步至hive分区表前言一、创建新的hive分区表1.外部分区表sql准备2.创建工作流3、将sql语句写入工作流中4、保存选择租户,上线运行5、任务实例中查看运行状态,状态:成功 即创建成功,可以通过hive的beeline客户端执行如下命令查看表创建详情二、hive分区表创建好后需要增加分区,使用shell命令创建分区1、添加每天的定时增加分区任务2、配置shell命令,使用hivevar的方式提交参数3、配置参数:1)增加自定义变量2)点击保存 并增加.

fengyu_lc的博客 6322

DolphinScheduler使用Datax同步Hive结果到MYSQL

1、安装DolphinScheduler 2、创建租户信息 注意:租户名称就是Linux的执行命令的用户名称,所以不能出错 3、根据实际情况确定是否需要创建工作组,存在一个default默认工作组,是当前的所有机器,可以通过组信息来确定定特定的机器执行某个任务,比如DataX插件执行同步任务,可以只在某个机器上安装DataX,之后通过组信息来确定某个安装了同步插件的机器执行同步任务,这样可以降低每台机子上安装的插件个数,但可能会存在,某个机子宕机,任务不能执行的风险 4、环境管理 默认使用 ./dolp

熊浪的博客 5615

数据中台-常用工具组件:DataX、Flink、Dolphin Scheduler、TensorFlow和PyTorch等

拖拽式设计任务依赖关系,支持跨系统任务(SQL、Shell、Spark等)。DataX离线同步历史数据至ODS,Flink实时接入流数据至DWD。将业务系统数据(如订单表、日志文件)离线同步至数据仓库ODS层。:统一处理实时流数据(如Kafka)与离线数据(如HDFS)。ODS任务成功后,触发Flink实时清洗任务生成DWD层。:TFX(端到端ML流水线)、TFLite(移动端推理)。调度DataX离线同步任务、Flink实时任务启停。实时清洗DWD层数据(如过滤无效日志、补全字段)。

lcwdzl的专栏 1596

Datax的同步调研

的开源版本,在阿里巴巴集团内被广泛使用的离线数据同步工具/平台。DataX 实现了包括 MySQL、Oracle、OceanBase、SqlServer、Postgre、HDFS、Hive、ADS、HBase、TableStore(OTS)、MaxCompute(ODPS)、Hologres、DRDS, databend 等各种异构数据源之间高效的数据同步功能。Dolphinscheduler对Datax的支持。Sqlserver同步到MySQL。Datax的全量同步和增量同步。DataX 是阿里云。

wangqiaowq的博客 390

DataX 3.0 数据同步实战:从零构建企业级大数据管道

本文详细介绍了如何使用DataX 3.0构建企业级大数据同步管道。通过实战案例,从环境安装、JSON作业配置到性能调优,系统讲解了如何高效、稳定地实现异构数据源(如MySQL到HDFS)的同步,解决数据孤岛问题,为数据分析提供高质量数据供给。

weixin_29239279的博客 249

Hadoop与MySQL的核心差异:大数据技术选型与共存之道

在构建数据系统时,经常需要面对关系型数据库与大数据框架的选型问题。MySQL作为典型的OLTP数据库,以事务一致性、毫秒级响应支撑在线业务;而Hadoop作为分布式存储与计算底座,以横向扩展和批处理能力应对海量离线分析。两者本质上是面向在线事务与离线分析的不同设计,并非替代关系。理解它们的底层原理与适用边界,有助于规划合理的数据链路——从MySQL通过Sqoop、Canal等工具同步至HDFS/Hive,经过清洗加工后再将结果回写MySQL,形成完整的离线数仓闭环。掌握Hadoop与MySQL的协同方式,不

weixin_34354945的博客 247

利用DolphinScheduler实现Hive分区表的高效增量数据同步方案

本文详细介绍了如何利用DolphinScheduler和DataX实现Hive分区表的高效增量数据同步方案。通过自动化分区管理、DataX配置优化和任务调度设计,解决了TB级数据同步中的效率与稳定性问题,显著降低同步失败率。方案特别适用于电商日志等需要每日增量更新的场景。

weixin_30247781的博客 434

基于数据编织理念,构建自动化异构数据治理平台的实战指南

在数据驱动的业务环境中,数据治理是确保数据资产价值得以释放的关键环节。其核心原理在于通过系统化的方法,对数据的可用性、完整性、安全性和一致性进行管理。随着企业数据架构日益复杂,数据分散在MySQL、Hive、对象存储等多种异构系统中,传统依赖人工的治理模式面临巨大挑战,难以应对元数据散落、数据发现困难等问题。数据编织作为一种新兴的架构框架,其技术价值在于通过构建全局知识图谱和引入主动元数据管理,能够自动化地连接、发现和治理这些分散的数据资产。它本质上是一个覆盖在异构数据源之上的“智能网络”,旨在实现数据的自

weixin_34341117的博客 516

剑指大数据:企业级数据仓库项目实战(金融租赁版)读书笔记__大数据测试集群的服务器节点服务分配规划表__解读(附:技术选型清单、数据同步工具选择)

本文展示了一个由3台服务器(hadoop102/103/104)组成的大数据测试集群服务部署方案。核心架构特点包括: 角色分工明确:hadoop102作为主控节点(部署NameNode、MySQL等16项服务),hadoop103专管资源调度(含ResourceManager),hadoop104承担辅助功能(如SecondaryNameNode); 关键分布式服务(DataNode、ZooKeeper等)采用三节点部署确保基础功能; 采用非高可用模式(单NameNode/RM),适合测试环境;

木木的学习笔记 86

【信息科学与工程学】【数据科学】第一百二十二篇 大数据产品中的函数与算法01

它通常指。下面按照你给出的表格列💡 说明:下表中的"产品"以开源/主流商业组件为具象载体(Hadoop、Spark、Flink、Kafka、Hive、HBase、Iceberg、Atlas、Ranger、TensorFlow 等),它们共同构成一个完整的大数据产品家族;代码为实现示例,用于说明算法在工程系统中的落地方式。

weixin_49199313的博客 197

【信息科学与工程学】计算机科学与技术——第七十七篇 系统架构设计1002 大数据Lambda架构设计 第一章 1.1

与批处理处理有界(Bounded)数据集不同,流处理处理的是无界(Unbounded)数据流。数据流是连续不断产生的、没有终点的数据序列。无界性:你永远不知道数据何时结束,因此无法像批处理那样“等所有数据都到了再算”。无序性:数据产生的顺序和到达处理系统的顺序往往不一致,尤其是当数据来自多个分布式源头时。延迟与准确性:如何在数据到达后尽快给出结果,同时保证结果的准确性?这本身就是一对矛盾。状态管理。

weixin_49199313的博客 453

开源数据中台实战:从架构设计到核心组件部署指南

数据中台是企业数字化转型的核心基础设施,旨在解决数据孤岛问题,通过统一的数据整合、治理与服务化,构建可复用的数据能力中心。其技术原理通常基于分层架构,涵盖数据采集、存储计算、治理资产与服务应用等层面,以实现数据资产的价值最大化。在工程实践中,利用开源技术栈是构建高效、灵活且成本可控的数据中台的关键路径,例如采用DataX进行高效数据集成,或部署DolphinScheduler实现可视化任务调度。这些技术方案能有效支撑实时数据分析、用户画像构建等典型应用场景,最终帮助企业快速落地符合自身业务需求的、可演进的数

weixin_34007886的博客 339

别再调PID了!用MATLAB/Simulink给四旋翼无人机搭个ADRC控制器(附完整仿真模型)

本文详细介绍了在MATLAB/Simulink环境中为四旋翼无人机搭建ADRC控制器的完整流程,包括核心原理、Simulink建模、参数调试技巧及与PID控制的性能对比。ADRC通过扩张状态观测器(ESO)有效提升无人机在复杂扰动下的控制性能,特别适合四旋翼无人机这类强耦合系统。文章还提供了完整的仿真模型和工程实践问题解决方案。

weixin_26808439的博客 382

数据资产目录实战:从元数据采集到智能搜索的架构与实现

元数据管理是数据治理的核心基础,它通过系统化地采集、存储和管理数据资产的描述信息,为数据发现、理解与消费提供支撑。其核心原理在于构建统一的数据资产模型与关系网络,将散乱的技术元数据(如表结构、字段)与业务上下文(如术语、标签)关联。这一技术的核心价值在于破解“数据孤岛”,提升数据可见性、可信度与复用效率,是数据驱动决策的基石。典型应用场景包括数据血缘分析、影响评估、合规审计与自助式数据发现。本文聚焦于数据资产目录这一具体实现形式,深入探讨如何基于Hive Metastore等系统进行自动化元数据采集,并利用

weixin_30292843的博客 397

MCU 微控制器,在实际项目中如何选型(以 STM32为例)

1.MCU 选型需要考虑的一些因素 2.案例:传感器设备的 MCU 选型

创享 AIOT 的专栏 1万+

自监督学习与上下文赌博机融合:视觉决策中的协同优化与实战指南

在机器学习领域,自监督学习(Self-Supervised Learning)通过设计前置任务从无标注数据中学习通用表征,已成为解决标注数据稀缺问题的关键技术。其核心原理是利用数据自身的结构生成监督信号,训练编码器提取鲁棒特征。上下文赌博机(Contextual Bandits)作为强化学习的简化分支,专注于在给定上下文信息下做出单步最优决策,平衡探索与利用,广泛应用于推荐系统、广告投放等场景。将两者结合,构建端到端的协同训练框架,能让视觉表征的优化直接服务于最终的决策目标,同时利用自监督任务作为正则化项提

weixin_33721344的博客 520

Apache SeaTunnel详解与部署(版本2.3.11)

Apache SeaTunnel是一款高性能的分布式数据集成平台,专注于实时海量数据同步。它具有丰富可扩展的连接器(支持100+数据源)、批流一体化、多引擎支持(Zeta/Flink/Spark)等特点,解决了数据源多样、同步场景复杂等技术难题。相比于DataX、Sqoop等工具,SeaTunnel在部署难度、资源占用、功能支持等方面都具有优势。部署方式支持Docker和发布包两种形式,发布包部署需配置Maven镜像、安装插件等步骤,同时提供Web管理界面便于作业监控。该平台已被近百家企业应用于生产环境,社

super_mochi1 6324

Astah 9.0升级步骤(Widnows/Mac OS)

Astah Professional是一款全新的轻量级UML建模工具。软件集思维导图和UML建模于一体,采用100%纯JAVA构建, 兼容性强,不仅能够实现分布式建模、项目合并,还能够实现和其它建模工具的交互。

tequiero777的博客 2824

数据编织实战:自动化治理异构数据存储,从概念到部署验证

数据治理是企业数据管理的核心环节,旨在确保数据的可用性、一致性、安全性与可靠性。其核心原理是通过建立统一的标准、流程和技术体系,对数据进行全生命周期的管控。在数据湖、数据仓库等复杂架构成为常态的今天,自动化治理的技术价值日益凸显,它能显著提升数据发现、血缘追踪和质量监控的效率,降低人工成本。数据编织正是实现这一目标的关键架构理念,它通过虚拟化集成与自动化能力,为散落在MySQL、Hive、对象存储等异构数据源中的数据提供逻辑统一的视图与治理。本文聚焦于数据编织项目的落地实践,详细拆解其自动化元数据发现、数据

weixin_33739646的博客 370

EB Tresos激活失败?3种实用解决方案帮你搞定(含离线激活步骤)

本文针对EB Tresos软件激活失败问题,提供了三种实用的解决方案。详细分析了激活失败的常见根源,并系统阐述了在线环境下的排查步骤、无网环境下的离线激活全流程,以及高级许可证环境修复方法,帮助汽车电子工程师快速恢复开发环境。

milk8的博客 609

从零搭建ROS1导航小车(一):松灵SCOUT Mini底盘通讯配置与ROS包编译避坑指南

本文详细介绍了从零开始搭建ROS1导航小车的初始步骤,重点讲解松灵SCOUT Mini底盘的通讯配置与ROS包编译避坑指南。内容包括硬件连接、CAN通讯配置、ROS工作空间构建及编译优化等实用技巧,帮助开发者快速实现自主导航小车的通讯功能。

weixin_27014595的博客 188

Hadoop生态组件介绍

Hadoop生态组件介绍

qq_37771475的博客 410

Mac用户必看:Typora最新版永久激活+弹窗屏蔽保姆级教程(附崩溃解决方案)

本文为Mac用户提供了一份详尽的Typora最新版永久激活与弹窗屏蔽教程。通过修改关键JS文件,实现软件激活状态并彻底关闭成功提示弹窗。文章深入剖析了操作原理,并重点提供了解决由此引发的多文档崩溃问题的实用临时方案,同时客观讨论了该方法的局限性与潜在风险。

wine的专栏 2353

数据全栈知识架构解析:从平台到应用的四层实战指南

在数据驱动的时代,数据处理已从单一工具演变为涵盖数据采集、存储、计算、管理和应用的全栈体系。其核心原理在于围绕数据的生命周期,通过分层架构实现价值转化。数据全栈的技术价值在于打通数据从产生到产生业务价值的完整链路,确保数据在规模、效率和可靠性上满足现代企业的需求。典型的应用场景包括实时数据分析、数据仓库构建、机器学习平台搭建以及数据治理等。本文以数据平台层、数据开发层、数据管理层和数据分析层这四层架构为主线,结合**数据治理**和**实时计算**等关键技术,系统阐述了如何构建一个高效、可靠的数据处理体系,并

weixin_34112181的博客 380

《Android系统开发中高级定制专栏导读》

欢迎来到【Android 中高级系统定制】专栏!在这里,将深入探讨Android系统开发与定制的方方面面,涵盖从权限管理、驱动开发到系统应用配置等多个领域。

我其实什么都不会 1579

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

数据血缘落地实战:从概念到核心引擎的技术架构与实施路径

数据血缘是数据治理领域的关键技术,它通过追踪数据从产生到消费的全链路关系,构建起数据资产间的关联网络。其核心原理在于解析数据加工任务(如SQL脚本)或监听运行时行为,提取并存储表与表、任务与表之间的依赖关系,通常使用图数据库进行高效存储与多层关系查询。这项技术的核心价值在于将隐性的数据处理逻辑显性化、系统化,从而直接赋能数据质量保障、影响分析、成本优化与合规审计。在工程实践中,数据血缘的落地通常遵循分阶段策略,从核心链路可视化入手,逐步扩展到全链路覆盖与智能运营。典型的应用场景包括:当核心报表数据异常时,能

weixin_30908941的博客 380

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

上一篇: 使用微创联合M5S空气检测仪、树莓派3b+、prometheus、grafana实现空气质量持续监控告警WEB可视化
下一篇: DolphinScheduler 调度 DataX 实现 MySQL To MySQL 增量数据同步实战
流水理鱼
博客等级 码龄19年 7粉丝 14原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值