【python】小说素材收集器

利用python基本的几个拓展库爬取小说(request,lxml,re) 总从自学python之后就没有使用过了,但是课程学到了,一年后又重新捡起了python。 最近迷上小说,但是奈何钱包薄,只能平时上盗版网站瞅瞅(关爱作者,支持正版,平时好看的小说wo) 阅读详情

背景:

文笔不够,技术来凑。其实应该配合爬虫,把文章爬到本地,再批量分析,效果会更好。但是代理ip要钱,之前免费站点没了。所以先做了一个简陋版。


目录结构:
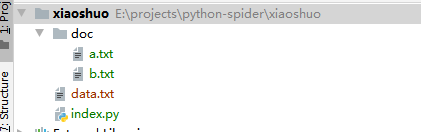
 

代码:

import re
import copy
import os

#  ================================ 变量 ============================================
"""
公共变量
"""
#文件夹目录
path = "./doc"

#得到文件夹下的所有文件名称
files= os.listdir(path)

#key(按下面的分组,对应的关键字去收集)
keyList = [
    ['眼','眸','瞳','眼底'],
    ['嘴','唇'],
    ['眉'],
    ['脸颊']
]


#变量存储
# eye = []
# mouth = []
result =[];
resultList = [[] for i in range(len(keyList))];
#  ================================ 函数 ============================================

"""
返回删除所有空值后的arr
"""
def get_real_arr(arr):
    arr_copy = copy.deepcopy(arr)
    arr_copy = list(filter(None, arr_copy))
    while '' in arr_copy:
        arr_copy.remove('')
    return arr_copy


"""
遍历文件,过滤字符
"""
def getAllList(position):
    #用于存储当前文件的所有的断句
    matrix = []
    with open(position, encoding='utf-8') as f:
        for line in f.readlines():
            line = line.strip('\n')  # 去掉列表中每一个元素的换行符
            line = line.strip();
            #清空对话等标点符号
            line = re.sub(r"[:“”]", "", line);
            #根据标点去断句,逗号区域不断句
            a = re.split('[.。::!!??]', line)
            # 清除数组中的空字符
            a = get_real_arr(a);
            # 合并数组(当前文件的所有的断句)
            matrix.extend(a);

        #筛选符合条件的
        for each in matrix:
            # print(each, len(matrix))
            for index,key in enumerate(keyList):
                for type in key:
                    if type in each:
                        resultList[index].append(each);
                        continue


"""
初始化
"""
def init():
    """
    获取所有txt,并遍历
    """
    for file in files:  # 遍历文件夹
        position = path + '\\' + file  # 构造绝对路径,"\\",其中一个'\'为转义符
        print(position)
        getAllList(position)

    """
    打印
    """
    with open('data.txt', 'w', encoding='utf-8') as f:  # 设置文件对象
        for index,word in enumerate(resultList):
            print(keyList[index]);
            print('\n'.join(word));
            f.write("\n【"+','.join(keyList[index])+"】\n")
            f.write('\n'.join(word))
            f.write('\n\n')


#  ================================ 初始化 ============================================
init();


生成效果:

python免费采集器 自动采集,自动上传数据库,使用方法,发言咨询百度贴吧10537902 立即下载

相关推荐

线性代数学习笔记(十)——矩阵运算(二)

本篇笔记讲解矩阵的幂运算和矩阵的转置,其中矩阵进行幂运算的前提是矩阵为方阵,矩阵幂运算的两条性质与数的幂运算规则类似;矩阵转置的定义与行列式转置类似,但要注意由于矩阵的行数和列数不同,所以转置之后行数和列数变换。

li2008kui的专栏 1万+

写作素材大丰收,这些小说创作神器你值得拥有

该网站持续更新内容,注重用户体验,提供便捷的分享功能,并注重故事的教育意义,旨在帮助读者树立正确的价值观和人生观,提高他们的道德素养和综合素质,成为广大读者喜爱的阅读平台。它有丰富的素材库,涵盖多个领域,用户输入关键词后,会迅速推荐相关创作素材和文章,为小说创作提供丰富的参通过分析大量文本数据,笔灵AI不仅能提供灵感和素材,还能根据用户创作的小说类型和风格,给出针对性的优化建议,使素材更加贴合创作需求。:进行登陆后,会出现您关键词相应的名句,相关作品等,可以用于您的文章,为文章增添色彩。

EdwardAITooL的博客 3997

MaaS 商业模式全面分析报告:从技术赋能到商业变现的全链条探索

MaaS(模型即服务)商业模式正成为AI产业主流,2024年上半年中国市场规模达2.5亿元,预计2027年占比将提升至47%。该模式通过云服务提供预训练AI模型,大幅降低企业应用AI的技术门槛和成本。核心盈利方式包括按使用量计费、订阅制、定制化服务等,其中混合模式因灵活性成为趋势。MaaS产业链包含模型提供商、云平台、应用开发商和最终用户,重塑了AI产业格局。随着《数据法案》等监管加强,数据增值服务面临更严格合规要求。未来五年,中国MaaS市场增速预计超50%,用户规模将从2025年2.1亿增至2030年5

芯片行业20年 · 参与定义实现千万级量产出货 · AI芯片PM 2889

亲测10款免费AI写小说软件推荐(2025年10月最新版)

【AI写小说工具测评:10款实用软件助你突破创作瓶颈】 针对小说创作中的卡文困扰,本文实测了10款AI写作工具,为不同创作需求提供解决方案。DeepSeek擅长复杂结构搭建,笔灵AI适合快速起稿,Kimi长于拆解爆款节奏,ChatGPT精于创意脑暴,Claude则专攻文笔润色。工具覆盖大纲生成、章节创作、人物设定、爽点设计等全流程,新手可选用笔灵AI整章生成,连载作者可结合DeepSeek与Claude优化结构文笔,短篇创作者则推荐豆包快速获取灵感。

EdwardAITooL的博客 2704

一生一芯 预学习阶段 NEMU代码学习(2)

如果 nemu_state.state == NEMU_ABORT:说明程序处于 "中止" 状态,输出 "ABORT",并且使用 ANSI_FG_RED 红色格式化显示。如果 halt_ret == 0,表示程序正常终止(触发了 "GOOD TRAP"),输出 "HIT GOOD TRAP",并使用 ANSI_FG_GREEN 绿色显示。如果要执行的指令数量 n 小于预定义的常量 MAX_INST_TO_PRINT,则将 g_print_step 置为 true,表示会逐步打印指令执行的过程。

weixin_45041054的博客 826

可视化大屏系列(5):设备状态面板与数据分析仪表盘

在这篇文章中,我们将重点讨论如何通过智能化手段提升工地设备的管理效率与维护质量。随着智能工地系统的不断发展,设备监控与维护管理变得尤为重要。本篇将从 设备状态实时监控、自动化维护提醒、设备管理与维修记录 三个方面入手,展示如何通过 Vue3 和 ECharts 构建一个智能化的设备管理平台,实时采集和展示设备运行状态、及时生成维护提醒并记录维修历史,以提高设备的使用效率与安全性。我们还将结合实际代码示例,详细讲解如何实现这些功能,帮助你在智能工地项目中实现设备管理的智能化、数字化和自动化。

一名热衷于技术的全栈开发者,专注于前端与后端的全面技术探索。在这里,我将分享我在技术领域的学习与成长,助力更多开发者的进步。 3364

盘点2025年10款免费AI写小说软件合集【亲测推荐,建议收藏】

【AI小说写作工具测评指南】精选10款实用工具,助你高效创作。Kimi支持文档续写,适合剧情作者;笔灵AI可一键生成整章内容;DeepSeek长文本逻辑连贯;豆包AI新手友好;文心一言擅长大纲优化;Claude结构处理专业;腾讯元宝支持可视化创作;灵犀速写专攻短篇模板;百度作家平台集创作投稿于一体;蛙蛙写作适合灵感收集。建议将AI生成内容作为底稿,加入个人风格。工具能解决卡文痛点,但作品灵魂仍需作者赋予。

EdwardAITooL的博客 2816

ZYNQ实战:PS端驱动DMA实现高效数据流转与验证

本文详细介绍了在ZYNQ平台上通过PS端驱动DMA实现高效数据流转的实战方法。从ZYNQ的PS与PL数据交互基础出发,深入解析DMA核心价值,包括硬件平台搭建、Vivado配置、PS端软件架构设计及性能优化技巧,帮助开发者提升数据传输效率与系统性能。

weixin_29192141的博客 434

资料收集整理工具软件汇总(更新中)

  国内部分: 1、Mybase Desktop Edition/Mybase Networking Edition 软件类型:共享软件介绍:Mybase 是一个功能强劲且可随心所欲自定义格式及层次关系的通用资料管理软件, 可用于管理各种各样的信息,如:各类文档、文件、资料、名片、事件、日记、项目、笔记、下载的精华、收集的各种资料等等,即使毫无规律的资料,经过精心组织后,也一样可以管理得有条不紊

sczhoubing的专栏 1万+

使用Python进行核磁数据预处理

随着医学与人工智能技术的快速崛起,伴随算法算力、数据等关键要素的积累和突破,人工智能技术在精准医学领域的科研应用也随之飞快增长,相关科研成果和学术论文数量逐年激增,医学影像人工智能涉及的技术如图像分割、病灶识别、病灶自动勾画、影像组学、深度学习模型构建和临床信息解析越来越趋于分析流程化,模块化,帮助越来越多的医生在临床科研实践中获得突破性的进展。根据具体的应用和数据类型,你可能需要调整或添加额外的步骤。对于更高级的处理,如图像分割或NMR数据的复杂处理,你可能需要查阅更专业的文献或使用更专业的软件工具。

xhlo521的博客 3131

Codesys.运动控制修改凸轮点

通过改凸轮曲线的主从轴缩放比例或者偏置。 新建多个凸轮曲线,对CAM曲线进行切换。 程序中动态修改,仅修改中间的关键点(凸轮末点修改or凸轮曲线运行中修改)。 程序中动态修改,修改首未关键点及关键点个数,需要重新触发MC_TableSelect。 使用程序新建凸轮表代码,实现电子凸轮基本运动。 我们讲的凸轮表切换、关键点修改、程序新建电子凸轮,这些方法没有本质区别,总之都是“趁曲线不注意,把凸轮表改了。

傻响雨 6827

用python快速整理你的素材库

一个整理素材库的小脚本,可以根据目录结构快速命图片名字 用两张图简单说一下。附件有视频说明。下面附代码。这个就算是我学习过程中的一个练习题吧。公司有一堆素材要整理。有了这个我觉得我一天就可以完成工作啦~~~   #!/usr/bin/env python # -*- coding: utf-8 -*- __author__ = 'liDong' from Tkinter impor...

DLILH的博客 1278

STM32 HAL库驱动BMP388:从寄存器配置到高精度气压温度采集

本文详细介绍了如何使用STM32 HAL库驱动BMP388气压温度传感器,实现高精度数据采集。内容涵盖从硬件连接到STM32CubeMX配置、关键寄存器解析、驱动源码编写,到核心补偿算法与海拔换算的完整流程,并提供了针对不同应用场景的优化配置与调试技巧,帮助开发者快速构建稳定可靠的测量方案。

weixin_29299807的博客 170

编辑的福音——一款用python编写的文字素材采集分析工具

笔者渔鱼之前做文字编辑,写稿时总感觉文字素材的收集整理会占用大量时间。往往确定一个主题后,先后会在百度、各种门户甚至app内容平台去找相关材料。找不到很多又很疲劳,就想如果能有个工具,在网上各个地方快速收集文字素材,还能下载到本地做批量分析,那该多好。写稿时如果有大量相关文字素材可供选择,岂不事半功倍!百度很久都没找到类似的工具,由于之前对python有些了解,想想用python应该可以实现我要的...

weixin_42238050的博客 1158

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

杰奇python采集器_极速杰奇采集器

一,功能特色本程序是杰奇小说系统的辅助采集器,使用的是杰奇后台采集规则,不像网上其他一些采集器,还需要重新编写采集规则,杰奇后台的采集规在网上随处都可以下到,并且本程序在所有windows系统上都可完美使用.本程序可以多开,采集一万本小说,最多使用24小时.并且本程序不会卡死,可以完美代替杰奇后台和其他采集器.二,使用方法1,用户名和密码填写杰奇小说系统后台用户名和密码2,开始和结束分别填写开始I...

weixin_39801714的博客 523

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

Python爬虫小说采集程序

开发工具:python3.4 操作系统:win8 主要功能:去指定小说网页爬小说目录,按章节保存到本地,并将爬过的网页保存到本地配置文件。 被爬网站:http://www.22pq.com/ 小说名称:武道宗师 代码出处:本人亲自码的 import urllib.request import http.cookiejar import socket import time

cmdos的专栏 1626

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Python脚本抓取采集小说网站

你是否苦恼于网上无法下载的“小说在线阅读”内容?或是某些文章的内容让你很有收藏的冲动,却找不到一个下载的链接?是不是有种自己写个程序把全部搞定的冲动?是不是学了 python,想要找点东西大展拳脚,告诉别人“哥可是很牛逼的!”?那就让我们开始吧! 哈哈~      好吧,我就是最近写 Yii 写多了,想找点东西调剂一下.... = =     本项目以研究为目的,所有版权问题我们都是站在作

cmdos的专栏 1784

小说自动生成工具

小说工具箱的搭建 最近逐渐喜欢上写小说,除了码代码之余,还会出去旅游。 不过有时候在写小说的时候,会遇上不知道怎么给人物起名字。于是动手做了个小工具,顺便发到线上,供各位喜欢写小说的作者们使用。 网站是:http://www.xsxia.com/ 给人物起名字 姓规则:输入单或者复姓 名字规则:可以选择男性、女性或者是中性 参考模型是通过训练普查人物姓名得出的,因此还是比较通顺。 近义词查找 2...

C7 5万+

python写采集程序_Python爬虫小说采集程序

开发工具:python3.4操作系统:win8主要功能:去指定小说网页爬小说目录,按章节保存到本地,并将爬过的网页保存到本地配置文件。被爬网站:http://www.22pq.com/小说名称:武道宗师代码出处:本人亲自码的import urllib.requestimport http.cookiejarimport socketimport timeimport retimeout = 20s...

weixin_42350544的博客 282

写作没素材咋办?分享三个我的方法

今天是涛哥日更38/100天,大家多鼓励鼓励我哦。大家都只知道我除了日更视频号还在进行日更写作,那经常读者朋友来问我,涛哥你一天那儿有那么多内容可以输出阿?刚刚我打完上面一句话,马上就又...

涛哥聊Python 686

Python网络爬虫(二):多线程爬取小说

这里我们爬取的小说是网站:笔趣阁,其中一本小说:一念永恒。 (一)准备阶段 1、网站URL:http://www.biqukan.com/1_1094/ 2、浏览器:搜狗 3、我们打开网址,找到搜狗浏览器的审查元素(F12),可以看到标签中的内容是我们想要的小说每个章节的链接地址。 4、我们单击其中一个章节的链接。我们发现,每个章节的正文内容放在了 标签中。 有了这些了解,

mmayanshuo的博客 5225

matlab在线_【网站】matlab在线站

关于公众号发布的内容介绍:hello,大家好。本公众号内容追求简洁,公众号名字:万能的书签,书签乃是浏览器书签/收藏夹之意,也就是一些我们平时常用的网站,涉及场合方方面面,但主要还是软件数码学习之类的,目的还是很纯洁的,那就是扩充各位的浏览器收藏夹数量,让各位在网页浏览上扩充知识、开拓视野。当然哈,授人以鱼不如授人以渔,网站内容还需要各位细心探索,举一反三,找到更多适合自己的网站才是硬道...

weixin_39840111的博客 1606

【python】for循环获取index

需要获取index: list = ['a','b','c'] for index ,v in enumerate(list): print(index) print(v) 不需要获取index: for v in list: print(v)

gz-郭小敏的博客 3万+

【Scrapy】Scrapy的pipelines管道使用方法

在讲解pipelines之前,我先举个例子,这样好了解爬取数据的具体过程: 发送请求 获取到数据(从网站上爬取了数据) 数据清洗(处理数据) 存储(把数据存储起来) 而现在,我介绍一下pipelines,它可以负责的就是第3和第4步的工作,专业述语就是管道。我们通过定义一个或多个class,可以用来处理我们传入的数据。 代码目录: 爬虫代码 mingyan_spider.py...

gz-郭小敏的博客 7810

【Scrapy】Scrapy的items.py用法

之前写了pipelines.py的一些用法:【Scrapy】Scrapy的pipelines管道使用方法,主要是用来处理获取数据后做的操作。 而这次介绍的items.py,它的作用主要是用来处理获取的的数据,做数据清洗用的,具体也很难一时讲清,先看代码。 1.首先我们通过ItemLoader 获取到数据 import sys sys.path.append(r'E:\projects...

gz-郭小敏的博客 4075

【python】自动生成一定数量的随机请求头header,对爬虫进行伪装

背景: 通过User-Agent构建请求头headers能够将爬虫伪装,但是有的网站会去检查请求头,进而封掉ip地址。所以在每次提交网站请求的时候,使用随机请求头迷惑对方能更好的保护我们的爬虫。 如我之前的例子,用了一个比较笨的方法:搜集各种User-Agent构建请求头,写一个随机函数,每次挑选一个User-Agent。然而人生苦短,聪明的程序员早已专门设计了一个库来生成header用于py...

gz-郭小敏的博客 3606
上一篇: 【antd】Warning: findDOMNode is deprecated in StrictMode. findDOMNode was passed an
下一篇: 【python】爬取小说网站文章
gz-郭小敏
博客等级 码龄9年 39粉丝 112原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
