昇思25天学习打卡营第20天|linchenfengxue

MindNLP-基于Mindspore2.0的GPT2预训练模型迁移教程 这篇文章主要目的是为了让大家能够清楚如何用MindSpore2.0来进行模型的迁移,因此更加注重整体的开发流程介绍,针对迁移中代码的编写不会详细讲解,但是会给出样例以及供查阅的文档链接。最终希望读者能够了解迁移模型需要做什么,每一步应该怎么做,做完了应该怎么验证。 阅读详情

文本解码原理--以MindNLP为例

自回归语言模型
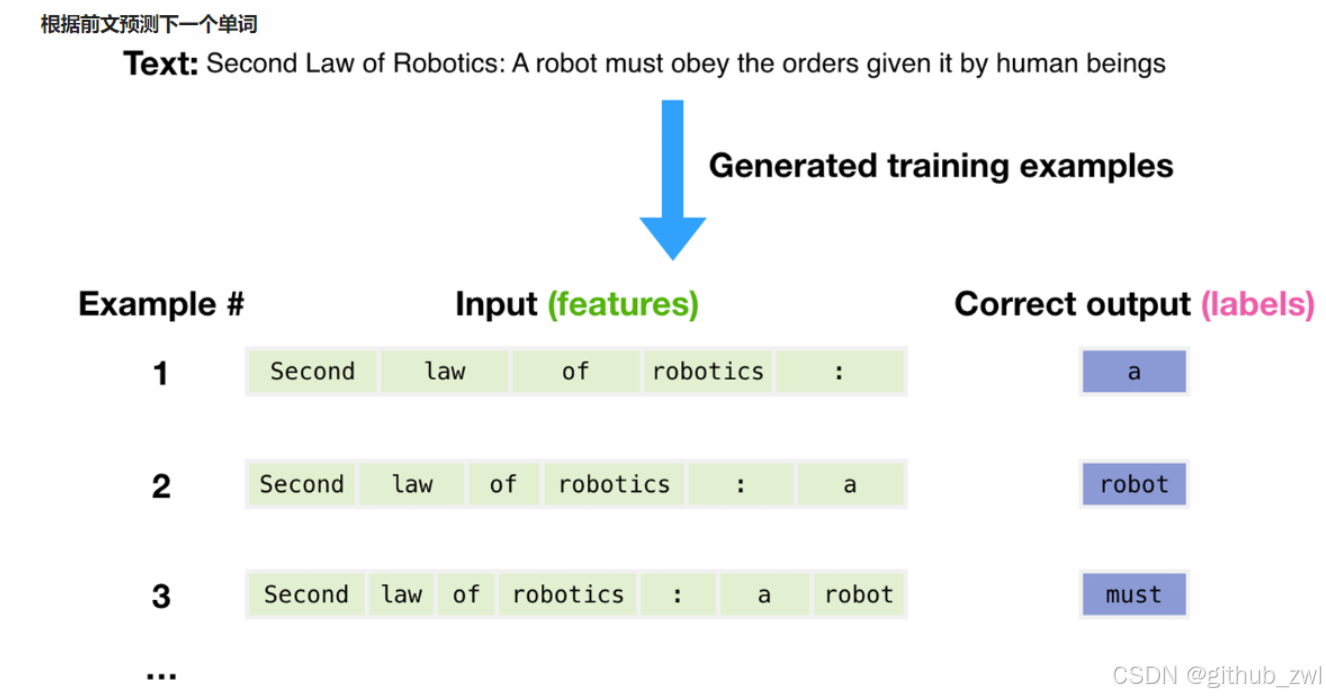
一个文本序列的概率分布可以分解为每个词基于其上文的条件概率的乘积
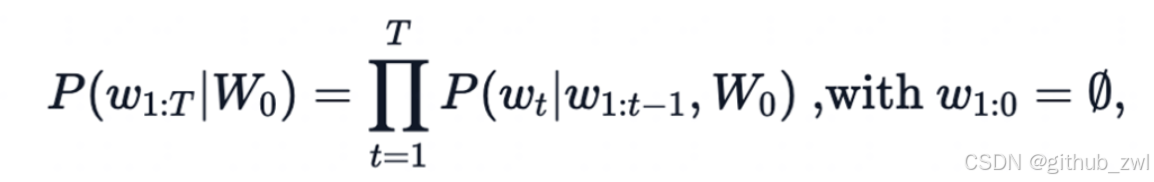
  • 𝑊_0:初始上下文单词序列
  • 𝑇: 时间步
  • 当生成EOS标签时,停止生成。

MindNLP/huggingface Transformers提供的文本生成方法
Greedy search

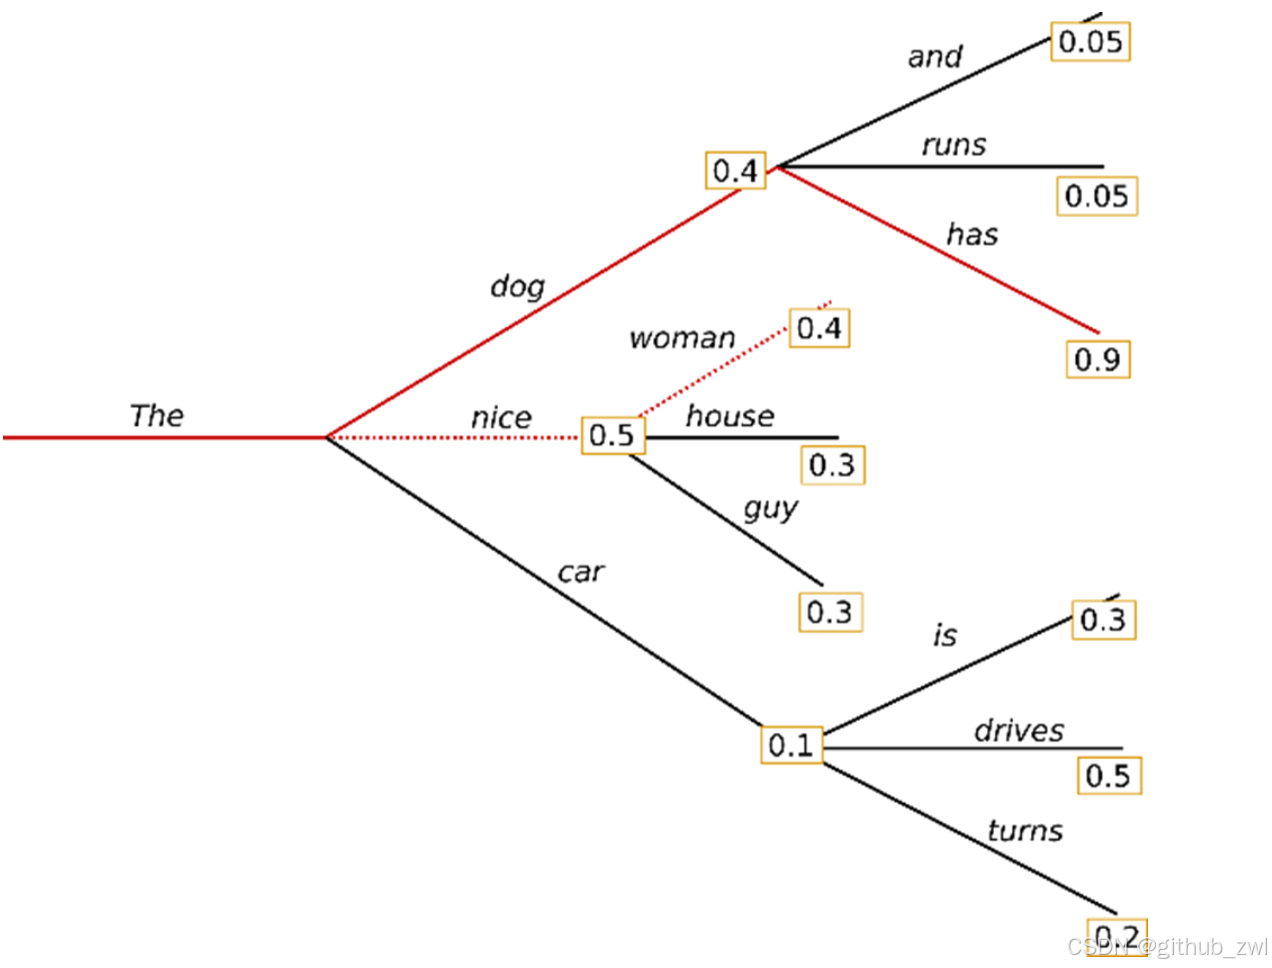
在每个时间步𝑡都简单地选择概率最高的词作为当前输出词:

𝑤𝑡=𝑎𝑟𝑔𝑚𝑎𝑥_𝑤 𝑃(𝑤|𝑤(1:𝑡−1))

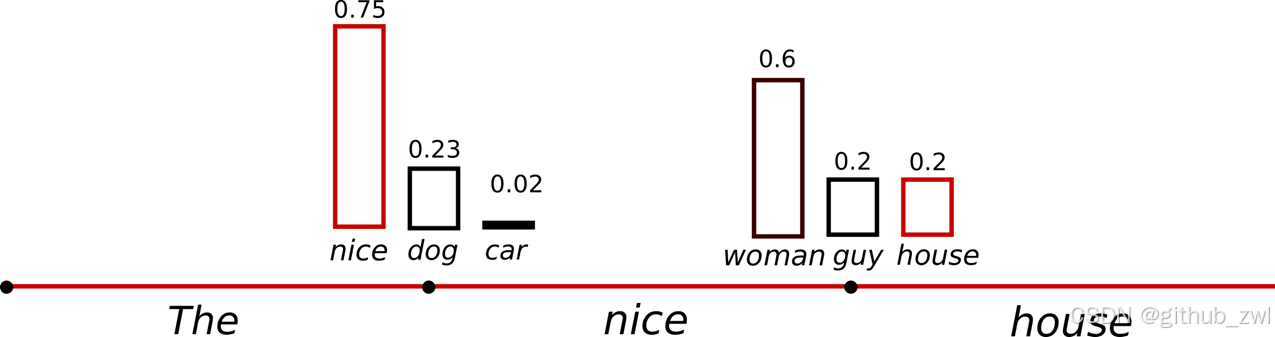
按照贪心搜索输出序列("The","nice","woman") 的条件概率为:0.5 x 0.4 = 0.2

缺点: 错过了隐藏在低概率词后面的高概率词,如:dog=0.5, has=0.9 ![image.png](attachment:image.png =600x600)

Beam search

Beam search通过在每个时间步保留最可能的 num_beams 个词,并从中最终选择出概率最高的序列来降低丢失潜在的高概率序列的风险。如图以 num_beams=2 为例:

("The","dog","has") : 0.4 * 0.9 = 0.36

("The","nice","woman") : 0.5 * 0.4 = 0.20

优点:一定程度保留最优路径

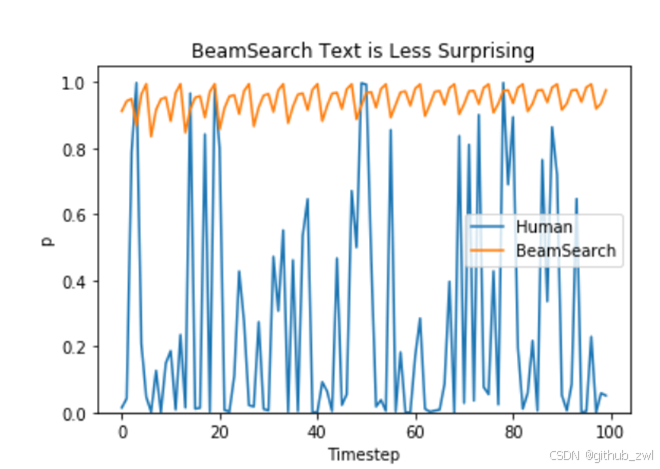
缺点:1. 无法解决重复问题;2. 开放域生成效果差
Beam search issues  
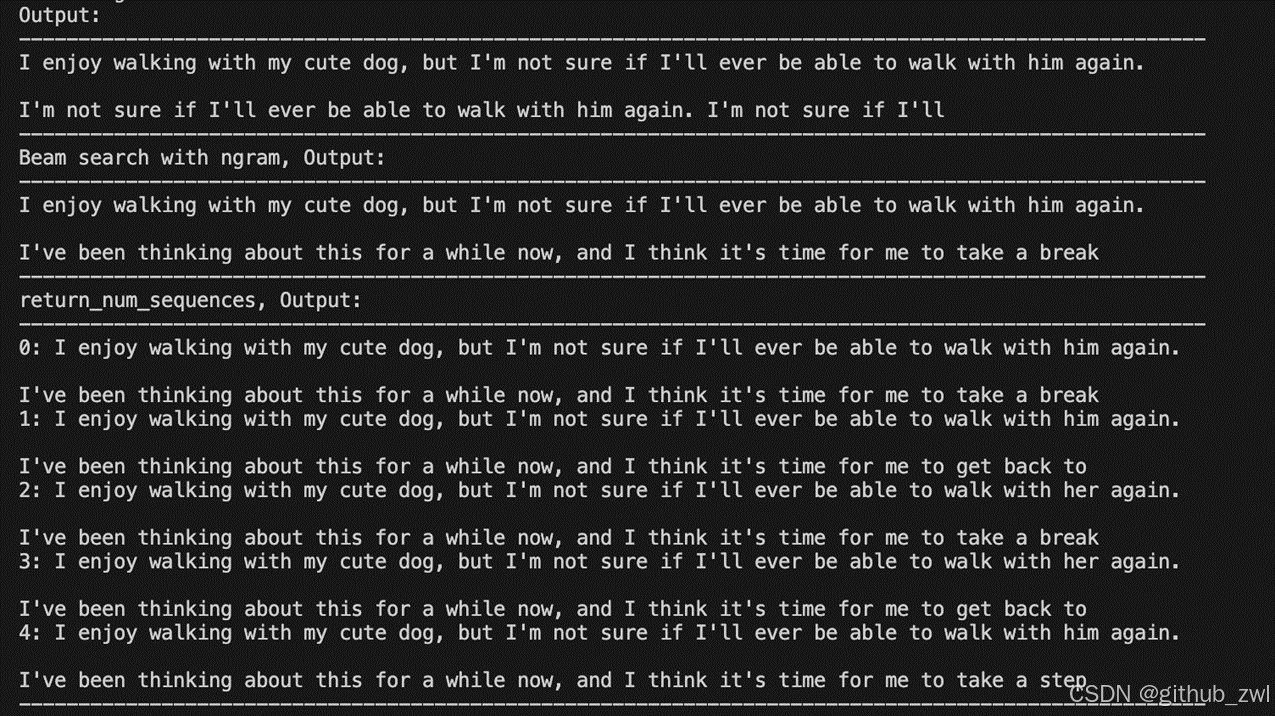
缺点:1. 无法解决重复问题;2. 开放域生成效果差

Repeat problem  
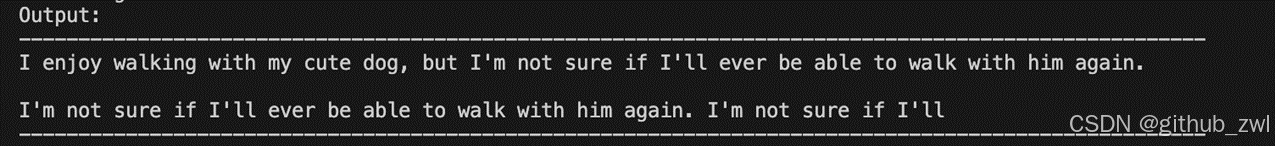
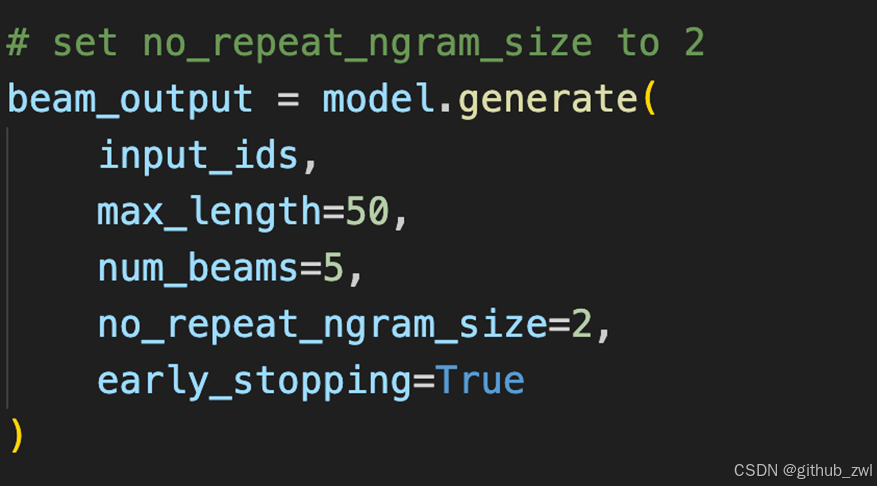
n-gram 惩罚:

将出现过的候选词的概率设置为 0

设置no_repeat_ngram_size=2 ,任意 2-gram 不会出现两次

Notice: 实际文本生成需要重复出现

Sample

根据当前条件概率分布随机选择输出词𝑤_𝑡
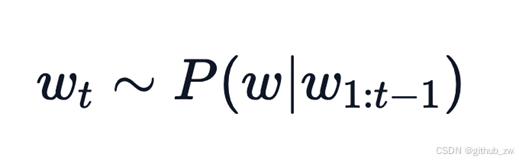
("car") ~P(w∣"The") ("drives") ~P(w∣"The","car") 
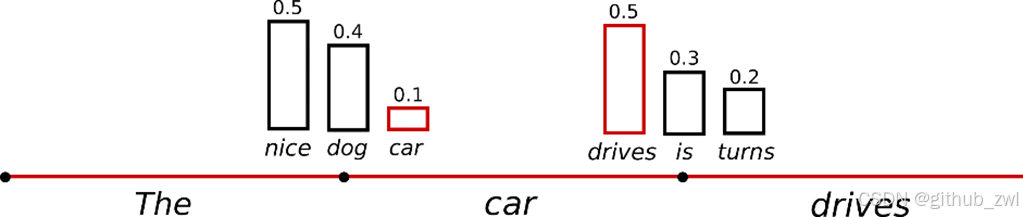
优点:文本生成多样性高

缺点:生成文本不连续

Temperature 降低softmax 的temperature使 P(w∣w1:t−1​)分布更陡峭

增加高概率单词的似然并降低低概率单词的似然

TopK sample

选出概率最大的 K 个词,重新归一化,最后在归一化后的 K 个词中采样 
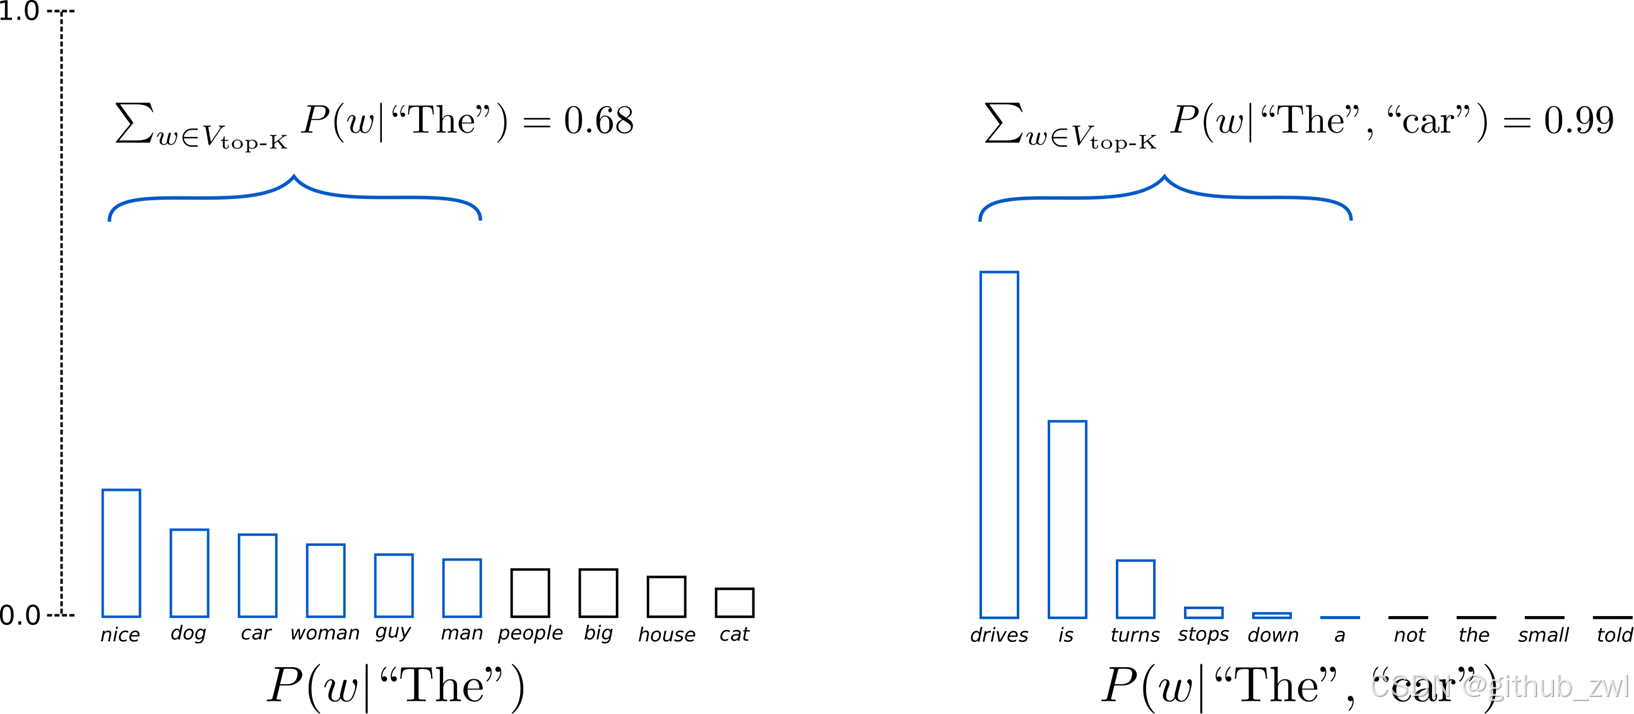
TopK sample problems
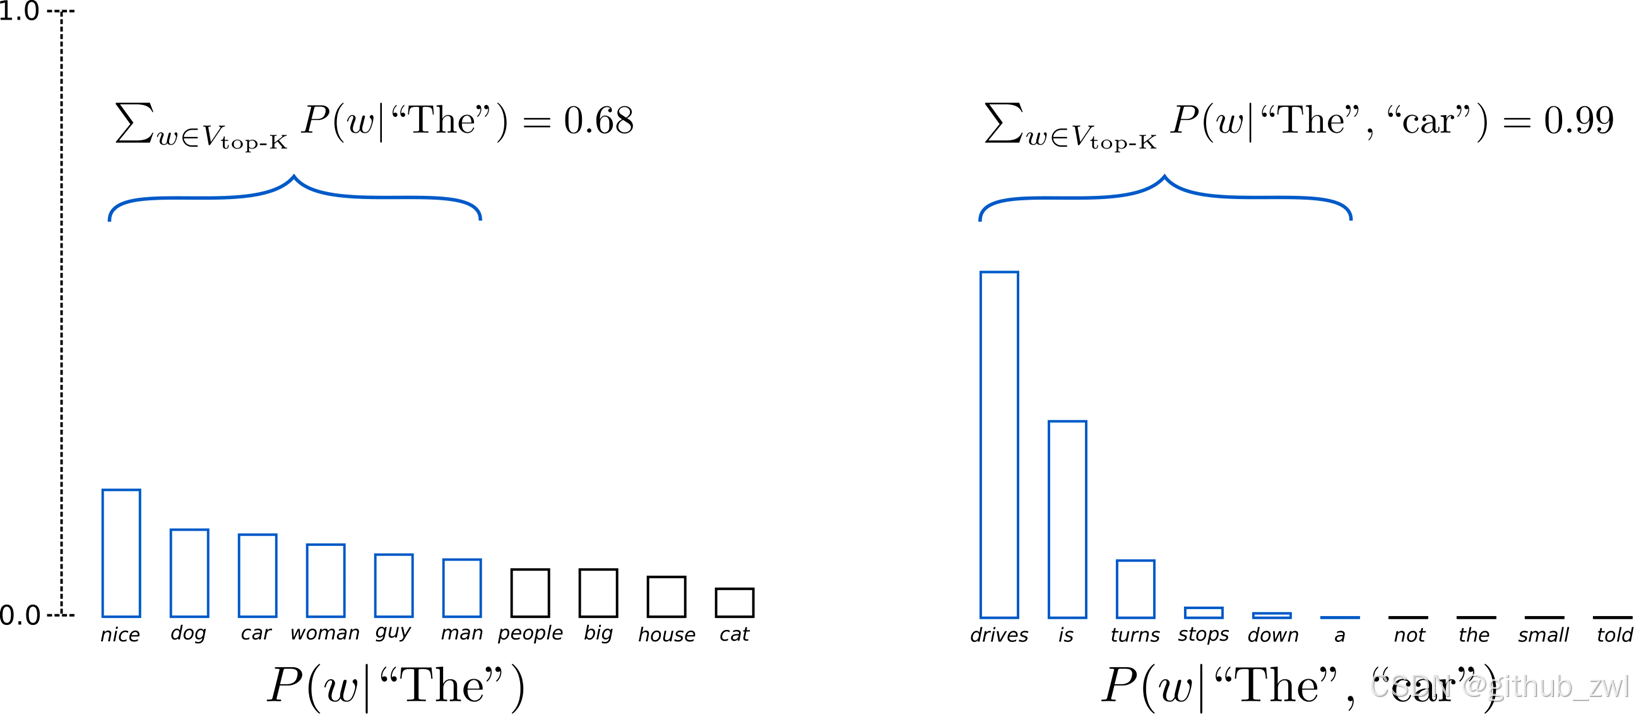
将采样池限制为固定大小 K :

  • 在分布比较尖锐的时候产生胡言乱语
  • 在分布比较平坦的时候限制模型的创造力

Top-P sample

在累积概率超过概率 p 的最小单词集中进行采样,重新归一化
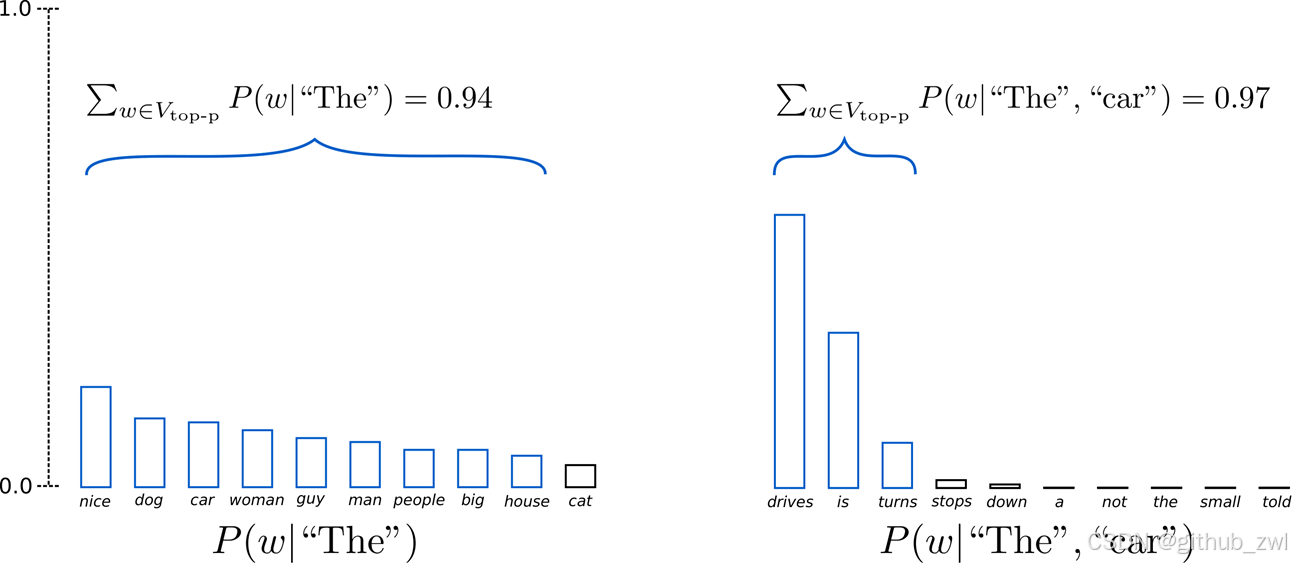
采样池可以根据下一个词的概率分布动态增加和减少

基于华为Mindspore深度学习框架的NLP机器翻译与文本生成的入门教学。.zip 深度学习是机器学习的一个子领域,它基于人工神经网络的研究,特别是利用多层次的神经网络来进行学习和模式识别。深度学习模型能够学习数据的高层次特征,这些特征对于图像和语音识别、自然语言处理、医学图像分析等应用至关重要。以下是深度学习的一些关键概念和组成部分: 1. **神经网络(Neural Networks)**:深度学习的基础是人工神经网络,它是由多个层组成的网络结构,包括输入层、隐藏层和输出层。每个层由多个神经元组成,神经元之间通过权重连接。 2. **前馈神经网络(Feedforward Neural Networks)**:这是最常见的神经网络类型,信息从输入层流向隐藏层,最终到达输出层。 3. **卷积神经网络(Convolutional Neural Networks, CNNs)**:这种网络特别适合处理具有网格结构的数据,如图像。它们使用卷积层来提取图像的特征。 4. **循环神经网络(Recurrent Neural Networks, RNNs)**:这种网络能够处理序列数据,如时间序列或自然语言,因为它们具有记忆功能,能够捕捉数据中的时间依赖性。 5. **长短期记忆网络(Long Short-Term Memory, LSTM)**:LSTM 是一种特殊的 RNN,它能够学习长期依赖关系,非常适合复杂的序列预测任务。 6. **生成对抗网络(Generative Adversarial Networks, GANs)**:由两个网络组成,一个生成器和一个判别器,它们相互竞争,生成器生成数据,判别器评估数据的真实性。 7. **深度学习框架**:如 TensorFlow、Keras、PyTorch 等,这些框架提供了构建、训练和部署深度学习模型的工具和库。 8. **激活函数(Activation Functions)**:如 ReLU、Sigmoid、Tanh 等,它们在神经网络中用于添加非线性,使得网络能够学习复杂的函数。 9. **损失函数(Loss Functions)**:用于评估模型的预测与真实值之间的差异,常见的损失函数包括均方误差(MSE)、交叉熵(Cross-Entropy)等。 10. **优化算法(Optimization Algorithms)**:如梯度下降(Gradient Descent)、随机梯度下降(SGD)、Adam 等,用于更新网络权重,以最小化损失函数。 11. **正则化(Regularization)**:技术如 Dropout、L1/L2 正则化等,用于防止模型过拟合。 12. **迁移学习(Transfer Learning)**:利用在一个任务上训练好的模型来提高另一个相关任务的性能。 深度学习在许多领域都取得了显著的成就,但它也面临着一些挑战,如对大量数据的依赖、模型的解释性差、计算资源消耗大等。研究人员正在不断探索新的方法来解决这些问题。 立即下载

相关推荐

同花顺PC端逆向解析:Hook注入与加密破解实战指南

在Windows客户端数据采集场景中,当常规HTTP爬虫失效时,内存级逆向分析成为获取实时行情数据的关键路径。其核心涉及进程注入、运行时解密、反调试绕过等底层技术,本质是理解PE加载机制、函数调用约定与内存保护策略的协同过程。同花顺作为典型加固客户端,采用ASPack加壳+自研解密+多线程校验三重防护,迫使开发者转向APC注入、动态密钥提取与XXTEA算法复刻等高阶手段。本文聚焦于DLL注入选型依据、解密函数定位方法及二进制Blob结构化解析,最终实现从内存读取到Pandas DataFrame的端到端数据

weixin_32234493的博客 1194

MindNLP入门学习资料汇总 - 基于MindSpore的易用高性能NLP框架

MindNLP是一个基于MindSpore的开源NLP库,旨在为自然语言处理任务提供一个解决方案平台。它包含了NLP中的许多常用方法,可以帮助研究人员和开发人员更方便快捷地构建和训练模型。全面的数据处理:封装了多个经典NLP数据集,如Multi30k、SQuAD、CoNLL等,使用起来非常方便。友好的NLP模型工具集:提供了多种可配置的组件,方便使用MindNLP自定义模型。易用的训练引擎:简化了MindSpore中复杂的训练流程,支持Trainer和Evaluator接口轻松训练和评估模型。

2401_87189860的博客 500

C#实战:如何用TSCLIB.dll实现TSC打印机的状态监控与异常处理(附完整代码)

本文详细介绍了如何利用C#和TSCLIB.dll构建企业级TSC打印机状态监控与智能异常处理系统。通过解析十六进制状态码、设计高可靠性的轮询引擎以及实现事件驱动的报警机制,开发者可以打造一个稳定、可观测的打印服务,有效保障物流仓储、生产制造等高频打印场景的业务连续性。

weixin_29227585的博客 64

项目分享 | 如何通过MindNLP将HuggingFace Datasets嫁接到昇思MindSpore

MindNLP的开发大概也有小一年时间了,整体而言面临着诸多的问题,并且还伴随着LLM带来的一系列冲击和挑战。作为一个依赖昇思MindSpore向上生长的后来者NLP框架,其实也要考虑怎么扩大生态的问题。还是那句俗话——打不过就加入。不过对于开源世界而言,又何谈加入,你中有我我中有你才是常态,况且在前两天Pytorch2.1+Ascend官宣的这个当口,生态嫁接毫无疑问是最优解。闲话就到这,进入正题。

Kenji_Shinji的博客 656

遥感图像处理实战:DOTA数据集旋转框转YOLO格式全流程解析(附代码)

本文详细解析了将DOTA遥感数据集的旋转框标注转换为YOLO格式的全流程。针对遥感图像中物体朝向任意性的特点,文章重点阐述了将旋转框转换为外接水平框的数学原理与代码实现,并提供了批量转换脚本和可视化验证方法,帮助开发者高效处理数据,为基于YOLO的遥感目标检测项目奠定基础。

weixin_29082143的博客 398

全志V3S嵌入式驱动开发(驱动开发准备)

【 声明:版权所有,欢迎转载,请勿用于商业用途。 联系信箱:feixiaoxing @163.com】 之前的文章都是教大家怎么搭建环境、看原理图、编译内核和根文件系统、做镜像,直到现在才进入驱动开发的主题。毕竟整个专栏的目的,还是希望大家能够学会驱动外部硬件。驱动好硬件,分成硬件和软件两个部分,硬件的部分比较好理解,就是看相关的信号有没有对接上即可,但是软件对接、甚至于怎么写软件,大家好像接触的比较少,所以这个时候,就可以简单讨论一下,怎么样才能写驱动代码。 1、了解外部驱动芯

嵌入式-老费,一个分享专业嵌入式知识的blog 2024

一天适配Gemma,MindNLP凭什么紧追开源SOTA?

从框架用户的角度出发,易用性和性能一直都是不能两全的trade-off,但是仔细分析可以发现,大家要的灵活性,全部都集中在蓝色部分,也就是正向执行,而反向传播由于不可见,可以选择不同的方案。熟悉AI领域的同学都知道,现在主要的AI研发还是依托GPU+友商框架路线,国产框架和国产硬件对SOTA模型的快速适配,是大家是否会选择使用的核心痛点,能够紧追SOTA,才有机会弯道超车。动态图的适应是真的舒适,但是只有动态图可能永远只能做小弟,这时候,自上而下的设计,还是要全面为真正的用户着想。

Kenji_Shinji的博客 1132

全志V3S嵌入式驱动开发(编译器升级到7.5)

【 声明:版权所有,欢迎转载,请勿用于商业用途。 联系信箱:feixiaoxing @163.com】 看过我们文章的朋友都知道,前面为了做v3s的驱动,对linux kernel进行了两次升级。第一次升级时从4.10.y升级到4.14.y,另外一次升级是从4.14.y升级到5.2.y。这中间最主要的原因,就是为了驱动适配的需要,更新的内核可以对硬件驱动有更好的支持,架构也更合理。 如果说内核升级尚且可以理解,那为什么要对编译器升级呢?这里面,最重要的一点就是语言的升

嵌入式-老费,一个分享专业嵌入式知识的blog 1166

MindNLP: 基于MindSpore的高性能自然语言处理框架

MindNLP是一个基于MindSpore深度学习框架开发的开源自然语言处理(NLP)库。它为解决各种NLP任务提供了一个强大的平台,包含了许多常用的NLP方法和模型。MindNLP的目标是帮助研究人员和开发者更方便快捷地构建和训练NLP模型。

m0_75126181的博客 1469

【Flutter 问题系列第 16 篇】如何防止软键盘弹出后顶掉内容

Flutter 如何防止软键盘弹出后顶掉内容

“Allen Su”的博客 3314

Oracle EBS Interface/API(43) -自定义AP发票状态说明API

在某项目,客户需求获得AP发票的状态说明,例如对账系统或者某些报表。由于标准系统未提供状态说明,需要通过AP发票的标准Form获得相关业务逻辑,然后自定义AP发票状态说明API。

陈显平的专栏-Oracle EBS 605

昇思25天学习打卡营第1天|linchenfengxue

介绍了张量tensor、数据集dataset提供了内置的文本、图像、音频等数据集加载接口,并提供了自定义数据集加载接口。数据集迭代的训练等等。数据变换等,明天继续。1.昇思MindSpore是一个全场景深度学习框架,旨在实现易开发、高效执行、全场景统一部署三大目标。

github_zwl的博客 499

3dmax文件格式转换——.max 转换为 .flt(解决转换后.flt没有纹理贴图的问题)

本文主要介绍如何在3dmax中将.max格式文件转换为.flt格式文件,并解决转换后的文件没有纹理贴图的问题。 在3dmax中,将.max文件转换为.flt格式,只需导出选择.flt格式即可,但是导出的文件在osgEarth中加载后,缺少纹理和贴图。 下面是解决方案: 1、选中加载的模型,然后点击 渲染-> 渲染到纹理 2、将 渲染到纹理 子窗口往下拉,点击 添加 按钮,添加 ...

cchangcs 6164

昇思25天学习打卡营第13天|linchenfengxue

如果将Diffusion与其他生成模型(如Normalizing Flows、GAN或VAE)进行比较,它并没有那么复杂,它们都将噪声从一些简单分布转换为数据样本,Diffusion也是从纯噪声开始通过一个神经网络学习逐步去噪,最终得到一个实际图像。Diffusion对于图像的处理包括以下两个过程:我们选择的固定(或预定义)正向扩散过程 𝑞𝑞 :它逐渐将高斯噪声添加到图像中,直到最终得到纯噪声。

github_zwl的博客 1126

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

昇思25天学习打卡营第14天|linchenfengxue

生成式对抗网络(Generative Adversarial Networks,GAN)是一种生成式机器学习模型,是近年来复杂分布上无监督学习最具前景的方法之一。最初,GAN由Ian J. Goodfellow于2014年发明,并在论文生成器的任务是生成看起来像训练图像的“假”图像;判别器需要判断从生成器输出的图像是真实的训练图像还是虚假的图像。GAN通过设计生成模型和判别模型这两个模块,使其互相博弈学习产生了相当好的输出。GAN模型的核心在于提出了通过对抗过程来估计生成模型这一全新框架。

github_zwl的博客 1159

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

昇思25天学习打卡营第16天|linchenfengxue

序列标注指给定输入序列,给序列中每个Token进行标注标签的过程。序列标注问题通常用于从文本中进行信息抽取,包括分词(Word Segmentation)、词性标注(Position Tagging)、命名实体识别(Named Entity Recognition, NER)等。以命名实体识别为例:如上表所示,清华大学和北京是地名,需要将其识别,我们对每个输入的单词预测其标签,最后根据标签来识别实体。

github_zwl的博客 952

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

昇思25天学习打卡营第12天|linchenfengxue

输入是3x64x64的图像,输出是该图像为真图像的概率。输入是标准正态分布中提取出的隐向量𝑧𝑧,输出是3x64x64的RGB图像。按照Goodfellow的方法,是希望通过提高其随机梯度来更新判别器,所以我们要最大化𝑙𝑜𝑔𝐷(𝑥)+𝑙𝑜𝑔(1−𝐷(𝐺(𝑧))𝑙𝑜𝑔𝐷(𝑥)+𝑙𝑜𝑔(1−𝐷(𝐺(𝑧))的值。如DCGAN论文所述,我们希望通过最小化𝑙𝑜𝑔(1−𝐷(𝐺(𝑧)))𝑙𝑜𝑔(1−𝐷(𝐺(𝑧)))来训练生成器,以产生更好的虚假图像。判别器需要判断从生成器输出的图像是真实的训练图像还是虚假的图像。

github_zwl的博客 778

昇思25天学习打卡营第11天|linchenfengxue

CycleGAN(Cycle Generative Adversarial Network) 即循环对抗生成网络,来自论文。该模型实现了一种在没有配对示例的情况下学习将图像从源域 X 转换到目标域 Y 的方法。该模型一个重要应用领域是域迁移(Domain Adaptation),可以通俗地理解为图像风格迁移。

github_zwl的博客 699

昇思25天学习打卡营第25天|linchenfengxue

从网络构建中加载代码,构建一个神经网络模型。超参(Hyperparameters)是可以调整的参数,可以控制模型训练优化的过程,不同的超参数值可能会影响模型训练和收敛速度。目前深度学习模型多采用批量随机梯度下降算法进行优化,随机梯度下降算法的原理如下:公式中,𝑛𝑛是批量大小(batch size),ηη是学习率(learning rate)。另外,𝑤𝑡𝑤𝑡为训练轮次𝑡𝑡中的权重参数,∇𝑙∇𝑙为损失函数的导数。

github_zwl的博客 812

昇思25天学习打卡营第17天|linchenfengxue

情感分类是自然语言处理中的经典任务,是典型的分类问题。输入: This film is terrible正确标签: Negative预测标签: Negative输入: This film is great正确标签: Positive预测标签: Positive最后我们设计一个预测函数,实现开头描述的效果,输入一句评价,获得评价的情感分类。将输入句子进行分词;使用词表获取对应的index id序列;index id序列转为Tensor;送入模型获得预测结果;打印输出预测结果。

github_zwl的博客 974

昇思25天学习打卡营第7天|linchenfengxue

近些年,随着基于自注意(Self-Attention)结构的模型的发展,特别是Transformer模型的提出,极大地促进了自然语言处理模型的发展。由于Transformers的计算效率和可扩展性,它已经能够训练具有超过100B参数的空前规模的模型。ViT则是自然语言处理和计算机视觉两个领域的融合结晶。在不依赖卷积操作的情况下,依然可以在图像分类任务上达到很好的效果。

github_zwl的博客 720

昇思25天学习打卡营第15天|linchenfengxue

Pix2Pix是基于条件生成对抗网络(cGAN, Condition Generative Adversarial Networks )实现的一种深度学习图像转换模型,该模型是由Phillip Isola等作者在2017年CVPR上提出的,可以实现语义/标签到真实图片、灰度图到彩色图、航空图到地图、白天到黑夜、线稿图到实物图的转换。生成器和判别器。传统上,尽管此类任务的目标都是相同的从像素预测像素,但每项都是用单独的专用机器来处理的。

github_zwl的博客 741

昇思25天学习打卡营第6天|linchenfengxue

SSD是单阶段的目标检测算法,通过卷积神经网络进行特征提取,取不同的特征层进行检测输出,所以SSD是一种多尺度的检测方法。在SSD的网络结构图中我们可以看到,SSD使用了多个特征层,特征层的尺寸分别是38 ×× 38,19 ×× 19,10 ×× 10,5 ×× 5,3 ×× 3,1 ×× 1,一共6种不同的特征图尺寸。SSD的网络结构如图所示。SSD对比了YOLO系列目标检测方法,不同的是SSD通过卷积得到最后的边界框,而YOLO对最后的输出采用全连接的形式得到一维向量,对向量进行拆解得到最终的检测框。

github_zwl的博客 770

昇思25天学习打卡营第22天|linchenfengxue

通常情况下,直接加载的原始数据并不能直接送入神经网络进行训练,此时我们需要对其进行数据预处理。MindSpore提供不同种类的数据变换(Transforms),配合数据处理Pipeline来实现数据预处理。图像的每个像素将根据这两个参数进行调整,输出的像素值为𝑜𝑢𝑡𝑝𝑢𝑡𝑖=𝑖𝑛𝑝𝑢𝑡𝑖∗𝑟𝑒𝑠𝑐𝑎𝑙𝑒+𝑠ℎ𝑖𝑓𝑡𝑜𝑢𝑡𝑝𝑢𝑡𝑖=𝑖𝑛𝑝𝑢𝑡𝑖∗𝑟𝑒𝑠𝑐𝑎𝑙𝑒+𝑠ℎ𝑖𝑓𝑡。提供了面向图像、文本、音频等不同数据类型的Transforms,同时也支持使用Lambda函数。方法传入,实现对指定数据列的处理。

github_zwl的博客 699

昇思25天学习打卡营第18天|linchenfengxue

BERT全称是来自变换器的双向编码器表征量(Bidirectional Encoder Representations from Transformers),它是Google于2018年末开发并发布的一种新型语言模型。与BERT模型相似的预训练语言模型例如问答、命名实体识别、自然语言推理、文本分类等在许多自然语言处理任务中发挥着重要作用。模型是基于Transformer中的Encoder并加上双向的结构,因此一定要熟练掌握Transformer的Encoder的结构。

github_zwl的博客 1114

昇思25天学习打卡营第8天|linchenfengxue

与传统方法不同,MusicGen采用单个stage的Transformer LM结合高效的token交织模式,取消了多层级的多个模型结构,例如分层或上采样,这使得MusicGen能够生成单声道和立体声的高质量音乐样本,同时提供更好的生成输出控制。MusicGen是来自Meta AI的Jade Copet等人提出的基于单个语言模型(LM)的音乐生成模型,能够根据文本描述或音频提示生成高质量的音乐样本,相关研究成果参考论文《,默认使用small规格的权重,生成的音频质量较低,但是生成的速度是最快的。

github_zwl的博客 862
上一篇: 昇思25天学习打卡营第19天|linchenfengxue
下一篇: 昇思25天学习打卡营第21天|linchenfengxue
github_zwl
博客等级 码龄11年 300粉丝 171原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值