[paddleocr]文档图像方向分类模块使用教程

关于提高PaddleOCR识别准确率的一些优化(二) 关于提高OCR识别准确率的一些优化(二)前言一、为什么要判断方向?二、paddleocr方向分类器1.方法介绍2、实际效果测试3、文本框检测实际效果4、结果分析5、解决办法6、方向检测测试结果三、paddlex图像分类1.训练2.测试结果分析四、后续优化方向总结 前言 本文基于关于提高OCR识别准确率的一些优化做出了一些改进和尝试,主要分为以下两点: 1、使用paddleocr方向分类器判断文本方向 2、用paddlex训练一个方向分类器判断文本方向 一、为什么要判断方向? 在我们的数据集中,有很多用户 阅读详情
AI摘要

该博客是PaddleOCR文档图像方向分类模块使用教程。介绍了模块可区分并矫正文档图像方向,提高OCR处理准确性。给出支持模型的测试环境和推理模式说明,讲解快速开始步骤,还提及二次开发,可参考PaddleX训练模型并集成到PaddleOCR进行推理。

文档图像方向分类模块使用教程

一、概述

文档图像方向分类模块主要是将文档图像的方向区分出来,并使用后处理将其矫正。在诸如文档扫描、证照拍摄等过程中,有时为了拍摄更清晰,会将拍摄设备进行旋转,导致得到的图片也是不同方向的。此时,标准的OCR流程无法很好地应对这些数据。利用图像分类技术,可以预先判断含文字区域的文档或证件的方向,并将其进行方向调整,从而提高OCR处理的准确性。

二、支持模型列表

模型模型下载链接Top-1 Acc(%)GPU推理耗时(ms)
[常规模式 / 高性能模式]
CPU推理耗时(ms)
[常规模式 / 高性能模式]
模型存储大小(M)介绍
PP-LCNet_x1_0_doc_ori推理模型/训练模型99.062.31 / 0.433.37 / 1.277基于PP-LCNet_x1_0的文档图像分类模型,含有四个类别,即0度,90度,180度,270度

测试环境说明:

  • 性能测试环境
    • 测试数据集:自建多场景数据集(1000张图片,含证件/文档等场景)
    • 硬件配置:
      • GPU:NVIDIA Tesla T4
      • CPU:Intel Xeon Gold 6271C @ 2.60GHz
      • 其他环境:Ubuntu 20.04 / cuDNN 8.6 / TensorRT 8.5.2.2
  • 推理模式说明
模式GPU配置CPU配置加速技术组合
常规模式FP32精度 / 无TRT加速FP32精度 / 8线程PaddleInference
高性能模式选择先验精度类型和加速策略的最优组合FP32精度 / 8线程选择先验最优后端(Paddle/OpenVINO/TRT等)

三、快速开始

❗ 在快速开始前,请先安装 PaddleOCR 的 wheel 包,详细请参考 安装教程。

使用一行命令即可快速体验:

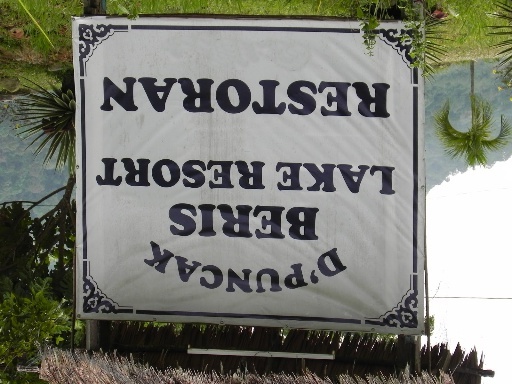
paddleocr doc_img_orientation_classification -i https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/img_rot180_demo.jpg

您也可以将文档图像方向分类模块中的模型推理集成到您的项目中。运行以下代码前,请您下载示例图片到本地。

from paddleocr import DocImgOrientationClassification

model = DocImgOrientationClassification(model_name="PP-LCNet_x1_0_doc_ori")
output = model.predict("img_rot180_demo.jpg",  batch_size=1)
for res in output:
    res.print(json_format=False)
    res.save_to_img("./output/demo.png")
    res.save_to_json("./output/res.json")

运行后,得到的结果为:

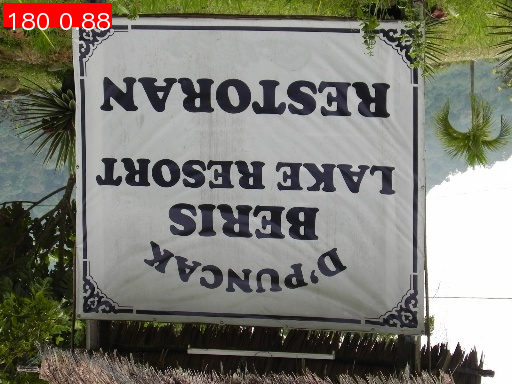
{'res': {'input_path': 'img_rot180_demo.jpg', 'page_index': None, 'class_ids': array([2], dtype=int32), 'scores': array([0.88164], dtype=float32), 'label_names': ['180']}}

运行结果参数含义如下: - input_path:表示输入图片的路径。 - class_ids:表示预测结果的类别id,含有四个类别,即0度,90度,180度和270度。 - scores:表示预测结果的置信度。 - label_names:表示预测结果的类别名。

可视化图片如下:
相关方法、参数等说明如下:

  • DocImgOrientationClassification实例化文档图像方向分类模型(此处以PP-LCNet_x1_0_doc_ori为例),具体说明如下:
参数参数说明参数类型可选项默认值
model_name模型名称str无无
model_dir模型存储路径str无无
device模型推理设备str支持指定GPU具体卡号,如“gpu:0”,其他硬件具体卡号,如“npu:0”,CPU如“cpu”。gpu:0
use_hpip是否启用高性能推理插件bool无False
hpi_config高性能推理配置dict | None无None
  • 其中,model_name 必须指定,指定 model_name 后,默认使用内置的模型参数,在此基础上,指定 model_dir 时,使用用户自定义的模型。

  • 调用文档图像方向分类模型的 predict() 方法进行推理预测,该方法会返回一个结果列表。另外,本模块还提供了 predict_iter() 方法。两者在参数接受和结果返回方面是完全一致的,区别在于 predict_iter() 返回的是一个 generator,能够逐步处理和获取预测结果,适合处理大型数据集或希望节省内存的场景。可以根据实际需求选择使用这两种方法中的任意一种。predict() 方法参数有 input 和 batch_size,具体说明如下:

参数参数说明参数类型可选项默认值
input待预测数据,支持多种输入类型Python Var/str/list
  • Python变量,如numpy.ndarray表示的图像数据
  • 文件路径,如图像文件的本地路径:/root/data/img.jpg
  • URL链接,如图像文件的网络URL:示例
  • 本地目录,该目录下需包含待预测数据文件,如本地路径:/root/data/
  • 列表,列表元素需为上述类型数据,如[numpy.ndarray, numpy.ndarray],["/root/data/img1.jpg", "/root/data/img2.jpg"],["/root/data1", "/root/data2"]
无
batch_size批大小int任意整数1
  • 对预测结果进行处理,每个样本的预测结果均为对应的Result对象,且支持打印、保存为图片、保存为json文件的操作:
方法方法说明参数参数类型参数说明默认值
print()打印结果到终端format_jsonbool是否对输出内容进行使用 JSON 缩进格式化True
indentint指定缩进级别,以美化输出的 JSON 数据,使其更具可读性,仅当 format_json 为 True 时有效4
ensure_asciibool控制是否将非 ASCII 字符转义为 Unicode。设置为 True 时,所有非 ASCII 字符将被转义;False 则保留原始字符,仅当format_json为True时有效False
save_to_json()将结果保存为json格式的文件save_pathstr保存的文件路径,当为目录时,保存文件命名与输入文件类型命名一致无
indentint指定缩进级别,以美化输出的 JSON 数据,使其更具可读性,仅当 format_json 为 True 时有效4
ensure_asciibool控制是否将非 ASCII 字符转义为 Unicode。设置为 True 时,所有非 ASCII 字符将被转义;False 则保留原始字符,仅当format_json为True时有效False
save_to_img()将结果保存为图像格式的文件save_pathstr保存的文件路径,当为目录时,保存文件命名与输入文件类型命名一致无
  • 此外,也支持通过属性获取带结果的可视化图像和预测结果,具体如下:
属性属性说明
json获取预测的json格式的结果
img获取格式为dict的可视化图像

四、二次开发

由于 PaddleOCR 并不直接提供文档图像方向分类的训练,因此,如果需要训练文档图像方向分类模型,可以参考 PaddleX 文档图像方向分类二次开发部分进行训练。训练后的模型可以无缝集成到 PaddleOCR 的 API 中进行推理。

PaddleOCR文档图像方向分类模型训练与应用指南 文档图像方向分类是OCR预处理中的关键技术,通过深度学习模型自动识别0°、90°、180°和270°四种常见旋转角度。基于PaddleOCR的PP-LCNet网络结构,该技术能高效完成文档图像的自动校正,显著提升后续OCR识别的准确率。在实际应用中,该技术广泛适用于扫描文档处理、移动端拍摄文档预处理等场景,结合PaddleX工具链可实现从训练到部署的全流程开发。通过合理配置数据增强、学习率策略等参数,模型准确率可达98%以上,部署时还可使用TensorRT加速和模型量化技术优化性能。 阅读详情

相关推荐

PaddleOCR方向分类器实战:如何用矩形框长宽比提升文本方向检测准确率

本文针对PaddleOCR内置方向分类器在90/270度旋转图片上易误判的痛点,提出一种创新优化方案。通过分析文本检测输出的矩形框长宽比特征,结合统计决策逻辑,与分类器结果进行智能融合,有效提升了文本方向检测的准确率。该方法无需额外模型计算,即可显著改善复杂场景下的OCR预处理效果。

xxx12的博客 1073

PP-LCNet_x1_0_doc_ori:99.06%准确率的文档方向校正利器

**导语**:百度飞桨开源文档方向分类模型PP-LCNet_x1_0_doc_ori,以99.06%的平均识别准确率和7M的轻量化体积,为文档数字化处理提供高效可靠的方向校正解决方案。 ## 行业现状:文档数字化的"旋转难题" 随着企业数字化转型加速,文档扫描、证件识别等场景对OCR技术的依赖日益加深。然而,在实际操作中,由于拍摄角度、设备摆放等问题,文档图像常常出现0°、90°、180°或2

gitblog_00392的博客 1085

PaddleOCR的方向分类器代码解析(二)

2021SC@SDUSC   方向分类器是文本检测矫正的一部分。文本检测一般是检测四个点,通过对四个点的水平变化,把文本框矫正成水平方向,这一步在PaddleOCR中称为几何变换。但是文本框内的输入方向可能不是正向的。方向分类器的作用就是判断水平文本框中的文字是正向的还是倒向的(根据yml配置文件的label_list项可知,文本分类器仅支持这两种)。倒向的文字由方向分类器正向化后再去识别。 ...

ScarlettWX的博客 4783

PaddleOCR PP-StructureV3模型重复下载问题分析与解决方案

PaddleOCR PP-StructureV3模型重复下载问题分析与解决方案 【免费下载链接】PaddleOCR 飞桨多语言OCR工具包(实用超轻量OCR系统,支持80+种语言识别,提供数据标注与合成工具,支持服务器、移动端、嵌入式及IoT设备端的训练与部署) Awesome multilingual OCR tool...

gitblog_01429的博客 1240

76、迁移飞浆PaddlePaddle的PP-LCNet_x1_0_doc_ori到onnx、mnn、ncnn、昇腾平台

文章摘要:本文介绍了将PaddlePaddle的PP-LCNet_x1_0_doc_ori模型迁移到onnx等平台的过程。首先通过ModelScope下载模型,使用PaddleOCR进行文档方向分类测试,成功输出180度旋转图片的识别结果(准确率89.2%)。包含模型预测、结果保存为图片和JSON文件的具体实现。后续计划进行onnx模型转换,为迁移到mnn、ncnn和昇腾平台做准备。

sxj731533730 541

PPOCRv5所有训练模型+推理模型

文件列表: ├── PP-LCNet_x0_25_textline_ori/ ├── PP-LCNet_x1_0_doc_ori/ ├── PP-OCRv5_mobile_det/ ├── PP-OCRv5_mobile_rec/ ├── PP-OCRv5_server_det_infer/ ├── PP-OCRv5_server_rec_infer/ ├── UVDoc/ ├── 多场景识别模型/ │ ├── 推理模型/ │ │ ├── PP-OCRv5_mobile_rec_infer.tar │ │ └── PP-OCRv5_server_rec_infer.tar │ └── 预训练模型/ │ ├── PP-OCRv5_mobile_rec_pretrained.pdparams │ └── PP-OCRv5_server_rec_pretrained.pdparams └── 训练模型/ ├── PP-OCRv5_mobile_det_pretrained.pdparams ├── PP-OCRv5_mobile_rec_pretrained.pdparams ├── PP-OCRv5_server_det_pretrained.pdparams └── PP-OCRv5_server_rec_pretrained.pdparams

PaddleOCR系列--《文档图像方向分类模块》数据集制作

Labelme 是一个 python 语言编写,带有图形界面的图像标注软件。可用于图像分类,目标检测,图像分割等任务,在目标检测的标注任务中,标签存储为 JSON 文件。

xin_yao_xin的博客 1082

对比实验系列:Efficientdet环境配置及训练个人数据集

可以通过下方链接下载Efficientdet源码。

Yayisheng的博客 4585

PaddleOCR系列--《文档图像方向分类模块》模型训练

上面已经制作完数据集,现在开始进行模型训练。

xin_yao_xin的博客 1235

Xiaojie雷达之路---毫米波雷达基础知识---中频信号的相位

本篇文章主要介绍毫米波雷达的基础知识中的中频信号的相位 文章目录傅里叶变换的快速回顾中频信号的相位中频信号对物体微小位移的灵敏度如何2个chirps来对一个物体的速度进行测量测量一个振动的物体 傅里叶变换的快速回顾 傅里叶变换是将一个信号从时域中转换到频域中,在时域中的一个正弦信号将在频域中产生一个峰值,在大多数情况下,在频域中的一个信号是一个复数(每个值是一个振幅和相位的向量),表示为AejθAe^{j\theta}Aejθ 在频域中峰值的相位等于正弦函数的初始相位 中频信号的相位 上一篇文章中提到,

XiaoJie的博客 1万+

Shopee App加密算法逆向实战:从抓包到libshpssdk.so的深度解析

本文详细解析了Shopee App加密算法的逆向过程,从网络抓包发现加密参数入手,通过Frida动态Hook定位到Java层关键方法,并深入追踪至Native层的libshpssdk.so核心函数。文章结合实战演示了如何利用Unidbg模拟执行环境进行算法分析与验证,并探讨了核心参数生成逻辑及风控规避要点,为移动安全与逆向工程研究提供了完整的技术路径。

weixin_28347369的博客 527

[paddleocr]表格分类模块使用教程

¶表格分类模块是计算机视觉系统中的关键组成部分,负责对输入的表格图像进行分类,该模块的性能直接影响到整个表格识别过程的准确性和效率。表格分类模块通常会接收表格图像作为输入,然后通过深度学习算法,根据图像的特性和内容,将其分类到预定义的类别中,例如有线表和无线表。表格分类模块的分类结果将作为输出,供表格识别相关产线使用。

futureflsl的博客 922

wflow模型hbv

毛管水的处理 😄 快速流的处理 K4是为了产生基流的 找到了令人激动的kenematic模块 😄

m0_46268055的博客 778

[paddleocr]文本图像矫正模块使用教程

¶文本图像矫正的主要目的是针对图像进行几何变换,以纠正图像中的文档扭曲、倾斜、透视变形等问题,以供后续的文本识别进行更加准确。

futureflsl的博客 1633

YOLO26优化:特征融合 | 一种新颖的多尺度特征融合iAFF,适配小目标检测

在YOLO26中如何使用:iAFF加入Neck替代Concat;

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 270

Python 爬虫实战:爬取股票数据做 K 线图可视化

摘要:本文介绍基于Python的股票数据爬取与K线图可视化全流程技术方案。通过Requests库抓取东方财富网股票数据,使用Pandas进行清洗处理,并利用mplfinance库实现专业K线图绘制。文章详细讲解了数据爬取接口分析、反爬策略配置、K线图绘制方法(包含基础K线图和带均线的进阶版本),以及核心统计指标计算。该方案可应用于股票价格趋势分析,为投资决策提供数据支持,同时强调了数据使用的合规性和技术优化方向。

2503_91057718的博客 2045

[paddlocr]文本行方向分类模块使用教程

¶文本行方向分类模块主要是将文本行的方向区分出来,并使用后处理将其矫正。在诸如文档扫描、证照拍摄等过程中,有时为了拍摄更清晰,会将拍摄设备进行旋转,导致得到的文本行也是不同方向的。此时,标准的OCR流程无法很好地应对这些数据。利用图像分类技术,可以预先判断文本行方向,并将其进行方向调整,从而提高OCR处理的准确性。

futureflsl的博客 1202

RK3588平台开发系列讲解(硬件篇-功能外设2)

RK3588 芯片内置两个USB3.0 OTG控制器(内嵌2个USB2.0 OTG,下图绿色处),1个USB3.0 HOST 控制器,2个USB2.0 HOST控制器。这些控制器与PHY的内部复用图如下:USB3.0 OTG0 控制器支持SS/HS/FS/LS, 内嵌的USB2.0(HS/FS/LS)信号采用USB2.0 OTG PHY, 信号名见下图的红色方框内;RK3588目前仅此接口支持做Fireware的Download,应用中请务必要预留出。

whm128的博客 2508

PaddleOCR—图片文字识别提取—快速使用教程

Paddle-OCR 属于Paddle 框架其中的一个应用,Paddle 除了 OCR 之外还有许多其它好玩的模型,关键开发者提供有训练好的预权重文件、降低了使用门槛。

weixin_45897172的博客 2万+

让 ABAP 再次优雅:全面认知 ABAP Development Tools for SAP HANA(ADT)与可运行示例

本文介绍了ABAP开发工具ADT(ABAP Development Tools for SAP HANA)的核心概念与价值。ADT是基于Eclipse的现代化ABAP集成开发环境,支持ABAP Platform、S/4HANA等后端开发,提供代码编辑、CDS数据建模、质量检查等全流程功能,相比传统SAP GUI具有显著优势。文章详细阐述了ADT与SAP HANA的关系、关键能力模块(如代码重构、CDS建模、质量管控等),并通过一个制造企业案例说明其实际应用场景。最后提供了ADT安装指南和一个完整的ABAP

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 669

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

[paddleocr]文本方向分类器训练

文本方向分类器主要用于图片非0度的场景下,在这种场景下需要对图片里检测到的文本行进行一个转正的操作。在PaddleOCR系统内, 文字检测之后得到的文本行图片经过仿射变换之后送入识别模型,此时只需要对文字进行一个0和180度的角度分类,因此PaddleOCR内置的 文本方向分类器只支持了0和180度的分类。如果想支持更多角度,可以自己修改算法进行支持。

futureflsl的博客 2025

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

PaddleOCR模型训练及使用详细教程

PaddleOCR是基于PaddlePaddle深度学习框架的开源OCR工具,但它提供了推理模型/训练模型/预训练模型,用户可以直接使用推理模型进行识别,也可以对训练模型或预训练模型进行再训练。支持约80种语言的文本识别,并具有较高的准确性和速度。

Elaine的博客 2万+

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

PaddleOCR使用

目录一 快速安装1 win10安装二 paddleocr package使用说明1 安装whl包2 代码使用 一 快速安装   本节内容来自这里。 1 win10安装 2. 安装PaddlePaddle Fluid v2.0 pip3 install --upgrade pip 如果您的机器安装的是CUDA9或CUDA10,请运行以下命令安装 python3 -m pip install paddlepaddle-gpu==2.0.0b0 -i https://mirror.baidu.com/pypi/

kessity的博客 2万+

PaddleOCR文档方向分类实战:从训练到部署全流程

文档方向分类是OCR预处理中的关键技术,通过判断图像旋转角度(0°、90°、180°、270°)提升识别准确率。基于CNN的轻量级模型(如PaddleOCR的1.4MB模型)可实现98%+的分类精度,其核心原理是通过卷积网络学习旋转不变特征。在OCR工业应用中,该技术能有效解决扫描件、手机拍摄文档的方向问题,特别适用于合同、票据等业务场景。通过迁移学习和数据增强(如旋转增强、困难样本挖掘),可以进一步提升模型在医疗报告等专业文档上的表现。PaddleOCR提供的训练工具链支持从数据准备、模型训练到移动端部署

weixin_30314813的博客 352

[paddleocr]版面区域检测模块使用教程

¶版面区域检测任务的核心是对输入的文档图像进行内容解析和区域划分。通过识别图像中的不同元素(如文字、图表、图像、公式、段落、摘要、参考文献等),将其归类为预定义的类别,并确定这些区域在文档中的位置。

futureflsl的博客 1149
上一篇: [paddleocr]文档类视觉语言模型模块使用教程
下一篇: [paddleocr]ppocrv5使用教程
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值