


现在越来越多的网站也已经应用了这些技术对其数据接口进行了保护,在做爬虫时如果我们遇到了这种情况,我们可能就不得不硬着头皮来去想方设法找出其中隐含的关键逻辑了,这个过程我们可以称之为 JavaScript 逆向。
既然我们要做 JavaScript 逆向,那少不了要用到浏览器的开发者工具,因为网页是在浏览器中加载的,所以多数的调试过程也是在浏览器中完成的。
工欲善其事,必先利其器。本节我们先来基于 Chrome 浏览器介绍一下浏览器开发者工具的使用。但由于开发者工具功能十分复杂,本节主要介绍对 JavaScript 逆向有一些帮助的功能,学会了这些,我们在做 JavaScript 逆向调试的过程会更加得心应手。
本节我们以一个示例网站 https://spa2.scrape.center/ 来做演示,用这个示例来介绍浏览器开发者工具各个面版的用法。
1. 面板介绍
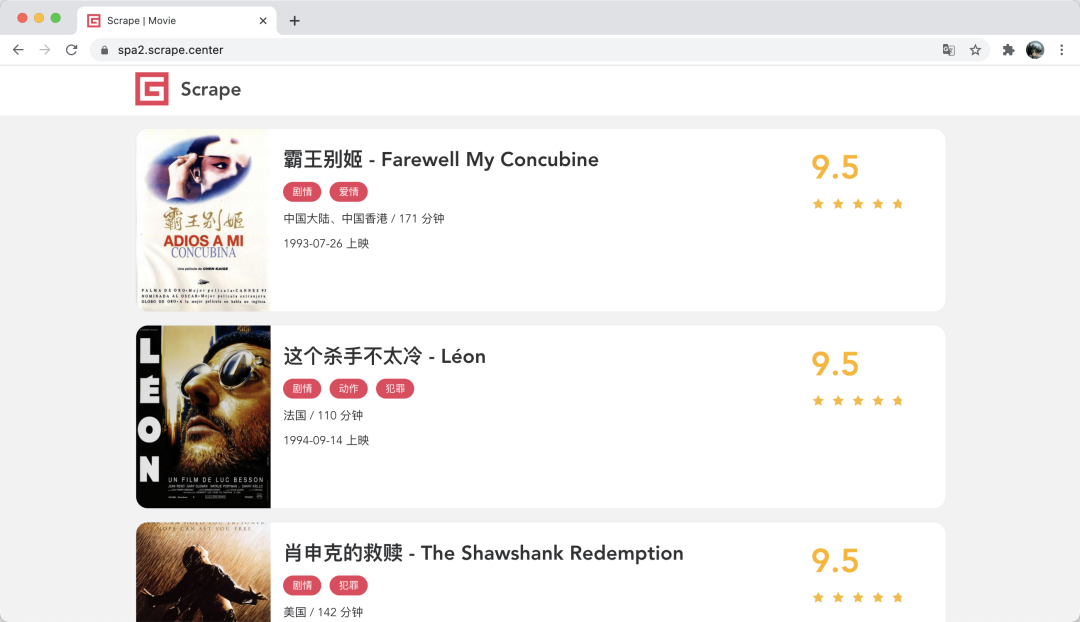
首先我们用 Chrome 浏览器打开示例网站,页面如图所示:
示例网站页面
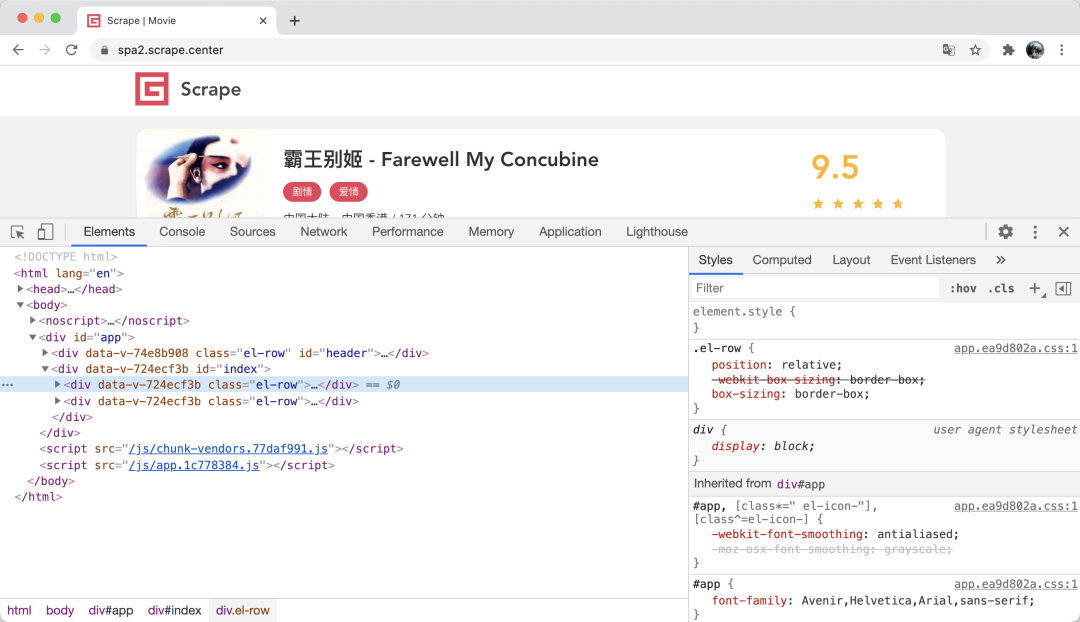
接下来打开开发者工具,我们会看到类似图 xx 所示的结果。
打开开发者工具
这里可以看到多个面板标签,如 Elements、Console、Sources 等,这就是开发者工具的一个个面板,功能丰富而又强大,先对面板作下简单的介绍:
Elements:元素面板,用于查看或修改当前网页 HTML 节点的属性、CSS 属性、监听事件等等,HTML 和 CSS 都可以即时修改和即时显示。
Console:控制台面板,用于查看调试日志或异常信息。另外我们还可以在控制台输入 JavaScript 代码,方便调试。
Sources:源代码面板,用于查看页面的 HTML 文件源代码、JavaScript 源代码、CSS 源代码,还可以在此面板对 JavaScript 代码进行调试,比如添加和修改 JavaScript 断点,观察 JavaScript 变量变化等。
Network:网络面板,用于查看页面加载过程中的各个网络请求,包括请求、响应等各个详情。
Performance:性能面板,用于记录和分析页面在运行时的所有活动,比如 CPU 占用情况,呈现页面性能分析结果,
Memory:内存面板,用于记录和分析页面占用内存情况,如查看内存占用变化,查看 JavaScript 对象和 HTML 节点的内存分配。
Application:应用面板,用于记录网站加载的所有资源信息,如存储、缓存、字体、图片等,同时也可以对一些资源进行修改和删除。
Lighthouse:审核面板,用于分析网络应用和网页,收集现代性能指标并提供对开发人员最佳实践的意见。
了解了这些面板之后,我们来深入了解几个面板中对 JavaScript 调试很有帮助的功能。
2. 查看节点事件
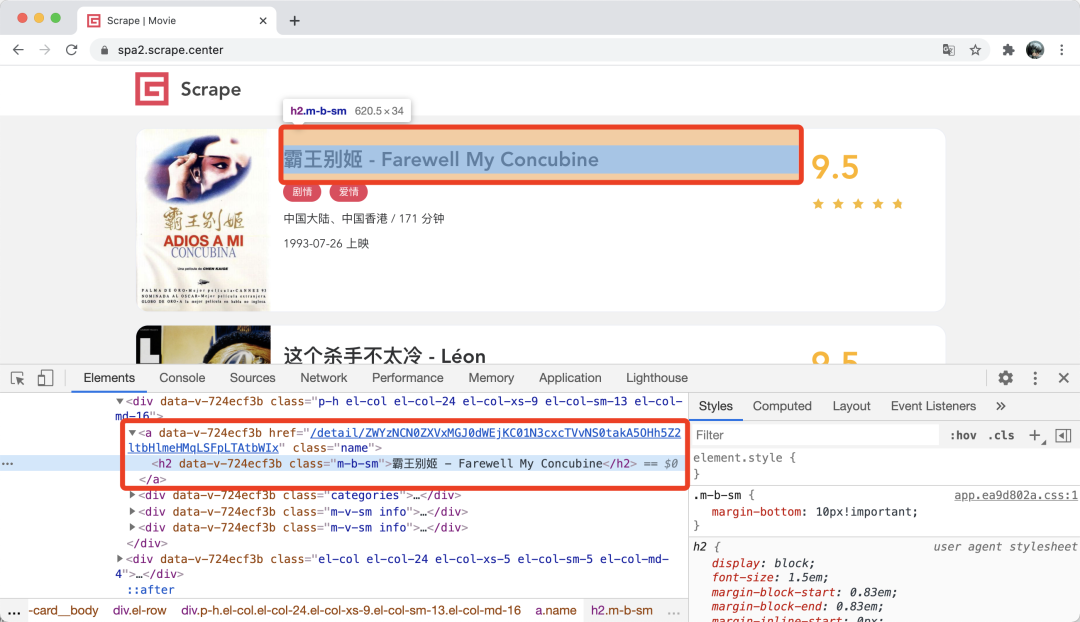
之前我们是用 Elements 面板来审查页面的节点信息的,我们可以查看当前页面的 HTML 源代码及其在网页中对应的位置,查看某个条目的标题对应的页面源代码,如图所示。
查看源代码
点击右侧的 Styles 选项卡,可以看到对应节点的 CSS 样式,我们可以自行在这里增删样式,实时预览效果,这对网页开发十分有帮助。
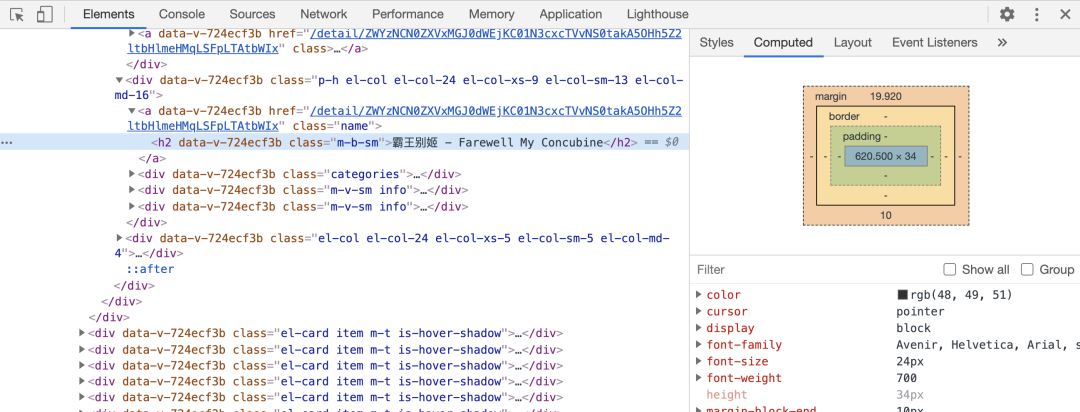
在 Computed 选项卡中还可以看到当前节点的盒子模型,比如外边距、内边距等,还可以看到当前节点最终计算出的 CSS 的样式,如图所示。
盒子模型
接下来切换到右侧的 Event Listeners 选项卡,这里可以显示各个节点当前已经绑定的事件,都是 JavaScript 原生支持的,下面简单列举几个事件。
change:HTML 元素改变时会触发的事件。
click:用户点击 HTML 元素时会触发的事件。
mouseover:用户在一个 HTML 元素上移动鼠标会触发的事件。
mouseout:用户从一个 HTML 元素上移开鼠标会触发的事件。
keydown:用户按下键盘按键会触发的事件。
load:浏览器完成页面加载时会触发的事件。
通常,我们会给按钮绑定一个点击事件,它的处理逻辑一般是由 JavaScript 定义的,这样在我们点击按钮的时候,对应的 JavaScript 代码便会执行。比如在图 xx 中,我们选中切换到第 2 页的节点,右侧 Event Listeners 选项卡下会看到它绑定的事件。
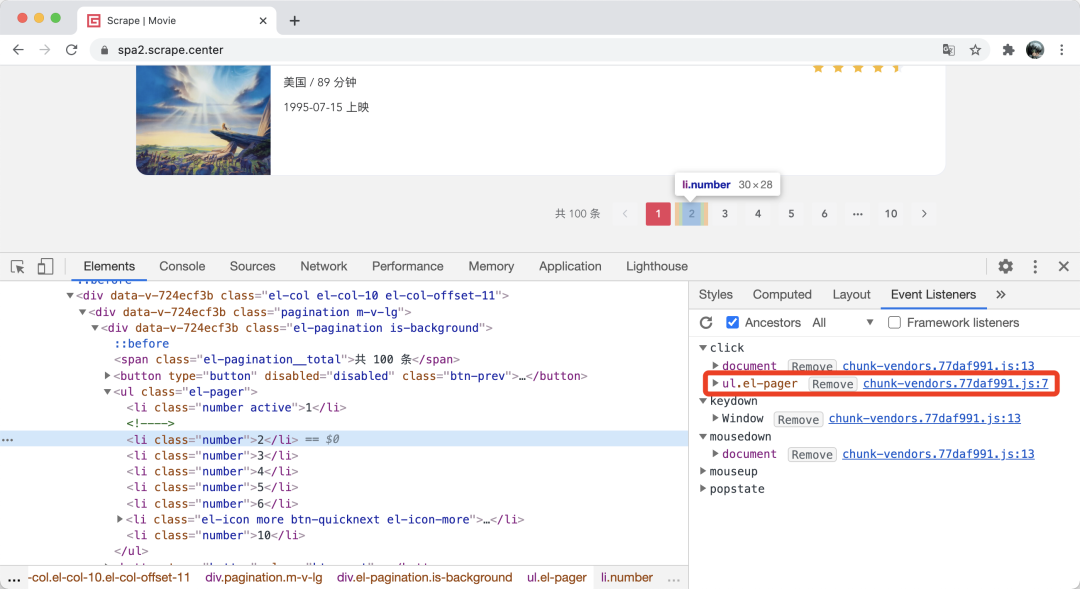
选中切换到第 2 页的节点
这里有对应事件的代码位置,内容为一个 JavaScript 文件名称 chunk-vendors.77daf991.js,然后紧跟一个冒号,然后再跟了一个数字 7。所以对应的事件处理函数是定义在 chunk-vendors.77daf991.js 这个文件的第 7 行。点击这个代码位置,便会自动跳转 Sources 面板,打开对应的 chunk-vendors.77daf991.js 文件并跳转到对应的位置,如图所示。
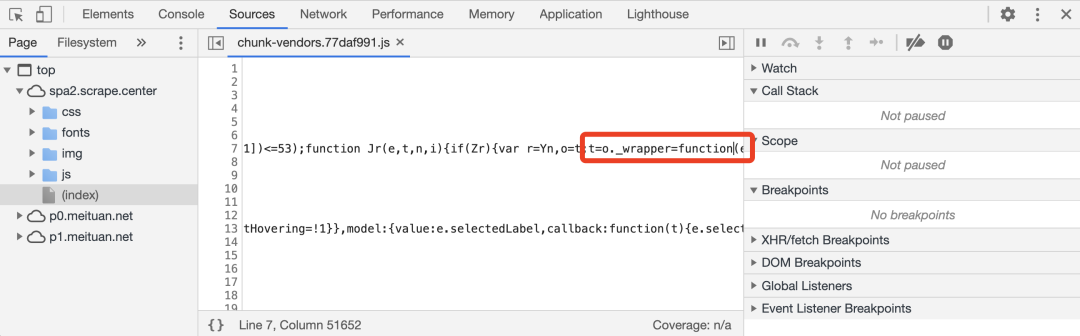
跳转到对应的代码位置
所以,利用好 Event Listeners,我们可以轻松地找到各个节点绑定事件的处理方法所在的位置,帮我们在 JavaScript 逆向过程中找到一些突破口。
3. 代码美化
刚才我们已经通过 Event Listeners 找到了对应的事件处理方法所在的位置并成功跳转到了代码所在的位置。
但是,这部分代码似乎被压缩过了,可读性很差,根本没法阅读,这时候应该怎么办呢?
不用担心,Sources 面板提供了一个便捷好用的代码美化功能。我们点击代码面板左下角的格式化按钮,代码就会变成如图所示的样子。
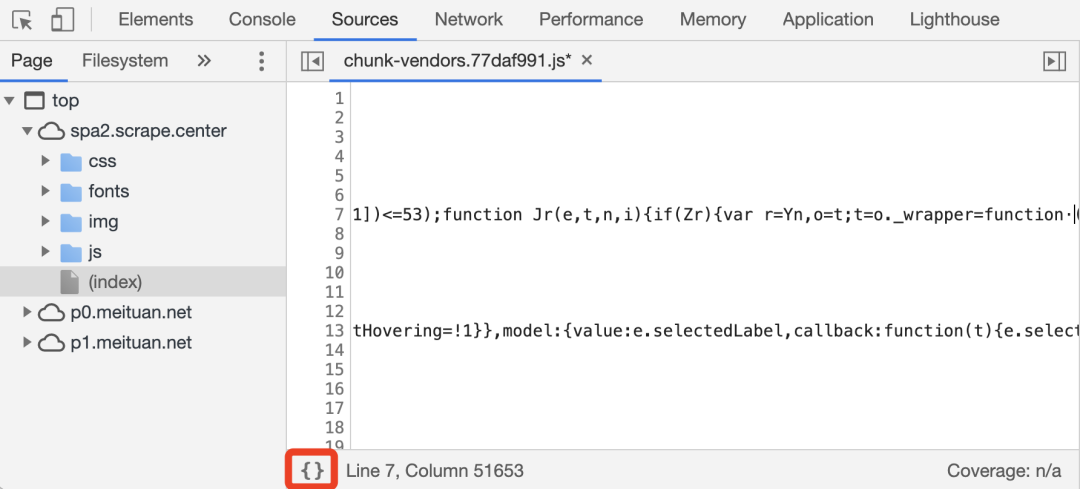
代码格式化按钮
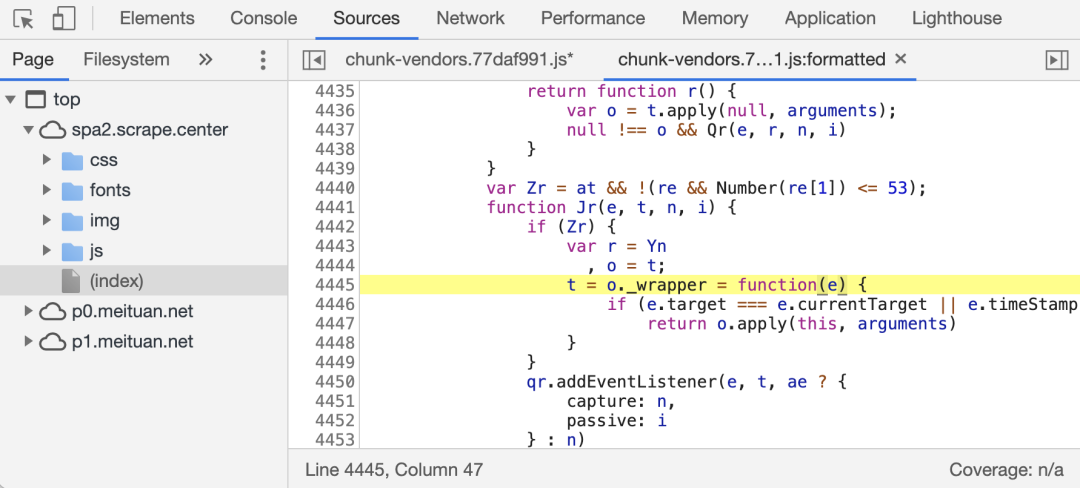
格式化后的代码
此时会新出现一个叫作 chunk-vendors.77daf991.js:formatted 的选项卡,文件名后面加了 formatted 标识,代表这是被格式化的结果。我们会发现,原来代码在第 7 行,现在自动对应到了第 4445 行,而且对应的代码位置会高亮显示,代码可读性大大增强!
这个功能在调试过程中非常常用,用好这个功能会给我们的 JavaScript 调试过程带来极大的便利。
4. 断点调试
接下来介绍一个非常重要的功能——断点调试。在调试代码的时候,我们可以在需要的位置上打断点,当对应事件触发时,浏览器就会自动停在断点的位置等待调试,此时我们可以选择单步调试,在面板中观察调用栈、变量值,以更好地追踪对应位置的执行逻辑。
那么断点怎么打呢?我们接着以上面的例子来说。首先单击如图所示的代码行号。
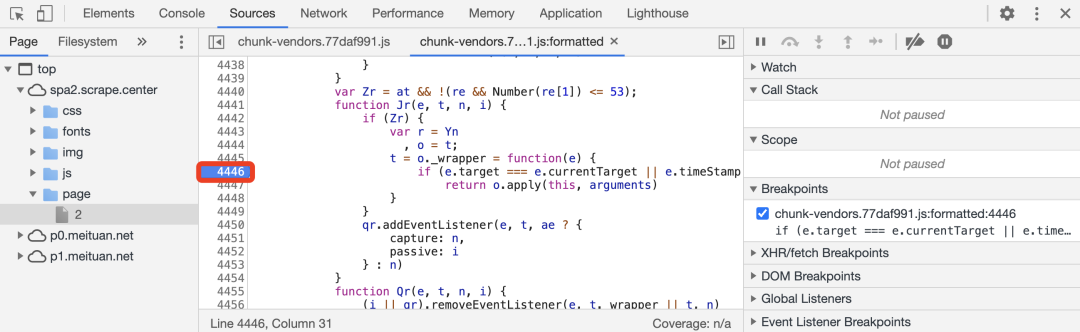
单击代码行号
这时候行号处就出现了一个蓝色的箭头,这就证明断点已经添加好了,同时在右侧的 Breakpoints 选项卡下会出现我们添加的断点的列表。
由于我们知道这个断点是用来处理翻页按钮的点击事件的,所以可以在网页里面点击按钮试一下,比如点击第 2 页的按钮,这时候就会发现断点被触发了,如图所示。
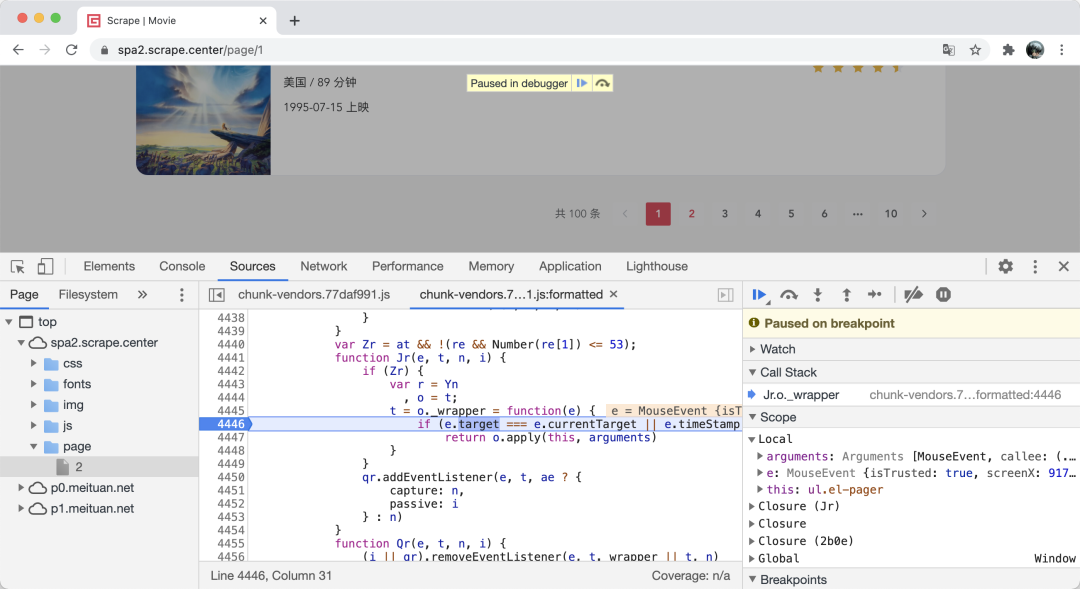
断点被触发
这时候我们可以看到页面中显示了一个叫作 Paused in debugger 的提示,这说明浏览器执行到刚才我们设置断点的位置处就不再继续执行了,等待我们发号施令执行调试。
此时代码停在了第 4446 行,回调参数 e 就是对应的点击事件 MouseEvent 。在右侧的 Scope 面板处,可以观察到各个变量的值,比如在 Local 域下有当前方法的局部变量,我们可以在这里看到 MouseEvent 的各个属性,如图所示。
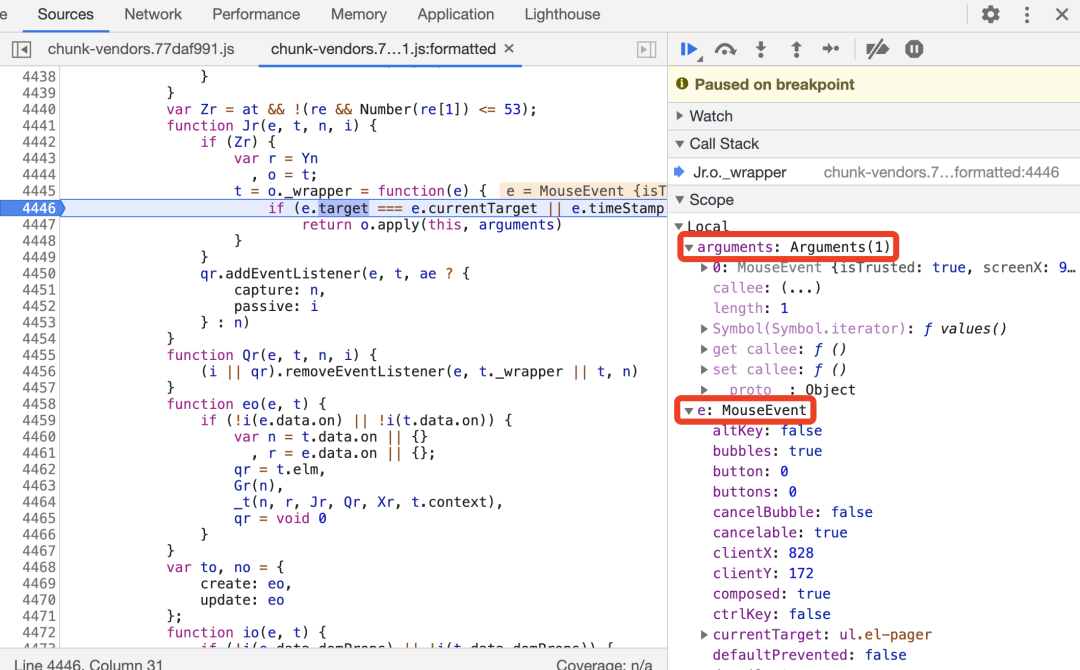
查看 Local 域
另外我们关注到有一个方法 o,它在 Jr 方法下面,所以切换到 Closure(Jr) 域可以查看它的定义及其接收的参数,如图所示。
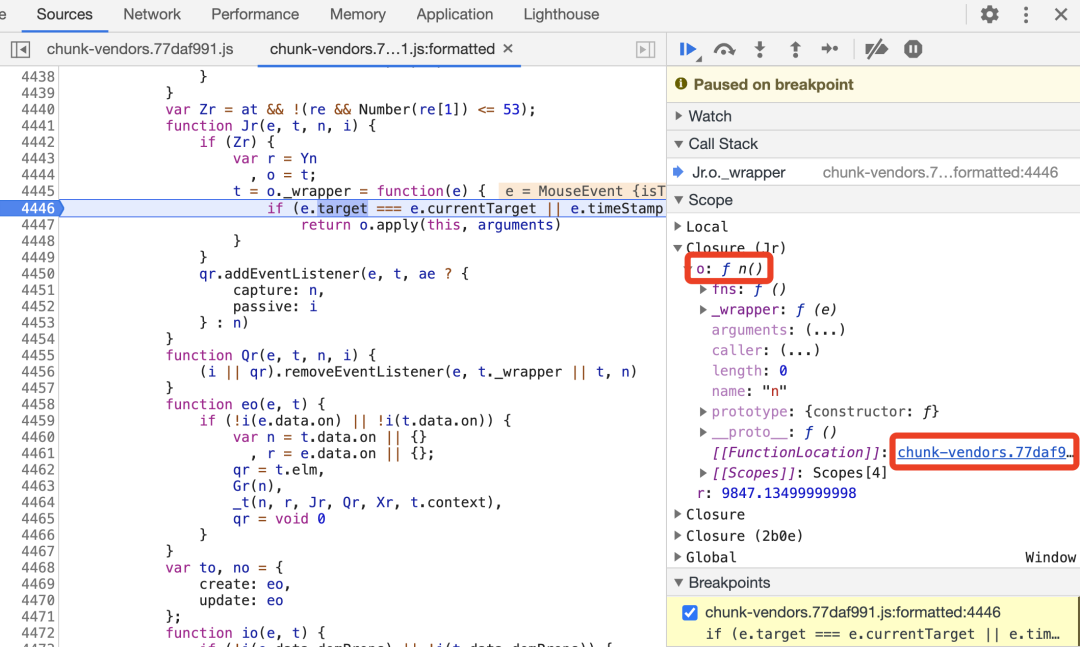
查看 Closure(Jr) 域
我们可以看到,FunctionLocation 又指向了方法 o ,点击之后便又可以跳到指定位置,用同样的方式进行断点调试即可。
在 Scope 面板还有多个域,这里就不再展开介绍了。总之,通过 Scope 面板,我们可以看到当前执行环境下的变量的值和方法的定义,知道当前代码究竟执行了怎样的逻辑。
接下来切换到 Watch 面板,在这里可以自行添加想要查看的变量和方法,点击右上角的 + 号按钮,我们可以任意添加想要监听的对象,如图所示。
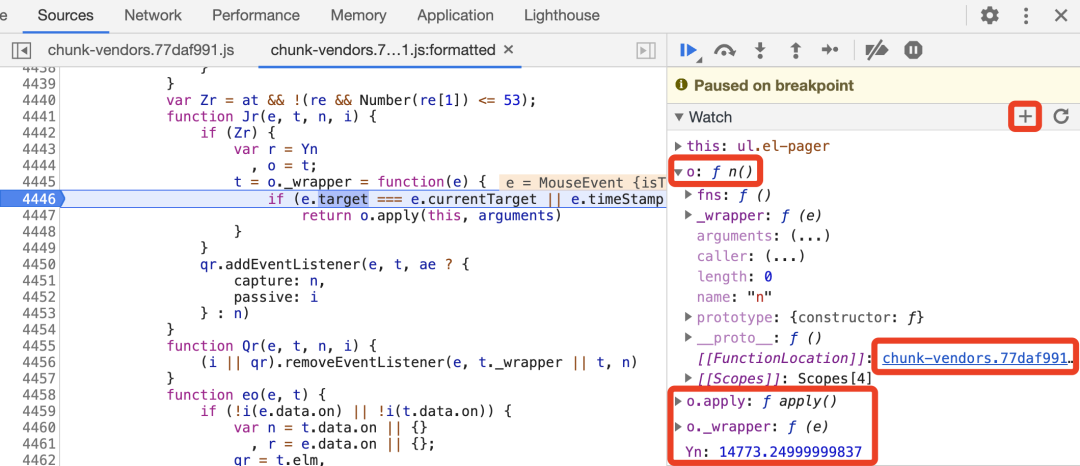
Watch 面板
比如这里我们比较关注 o.apply 是一个怎样的方法,于是点击添加 o.apply,这里就会把对应的方法定义呈现出来,展开之后可以再点击 FunctionLocation 定位其源码位置。
我们还可以切换到 Console 面板,输入任意的 JavaScript 代码,便会执行、输出对应的结果,如图所示。
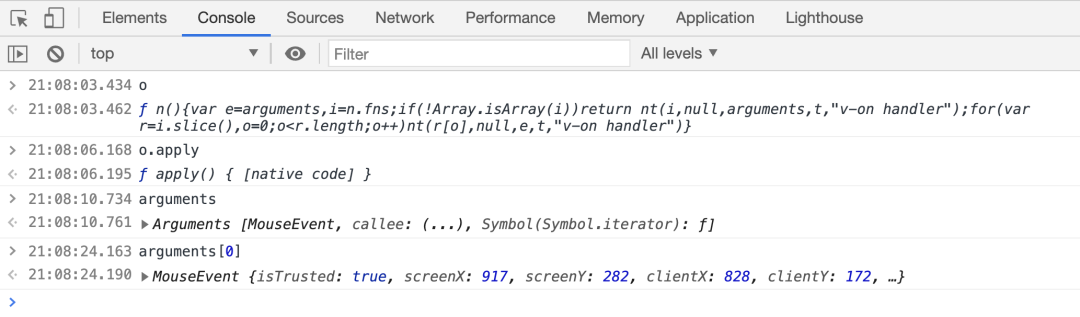
Console 面板
如果我们想看看变量 arguments 的第一个元素是什么,那么可以直接敲入 arguments[0],便会输出对应的结果 MouseEvent,只要在当前上下文能访问到的变量都可以直接引用并输出。
此时我们还可以选择单步调试,这里有 3 个重要的按钮,如图所示。
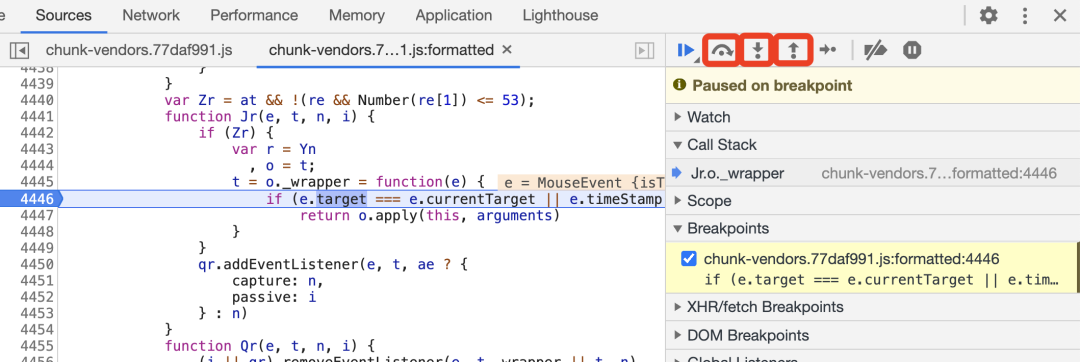
单步调试按钮
这 3 个按钮都可以做单步调试,但功能不同。
Step Over Next Function Call:逐语句执行
Step Into Next Function Call:进入方法内部执行
Step Out of Current Function:跳出当前方法
用得较多的是第一个,相当于逐行调试,比如点击 Step Over Next Function Call 这个按钮,就运行到了 4447 行,高亮的位置就变成了这一行,如图所示。
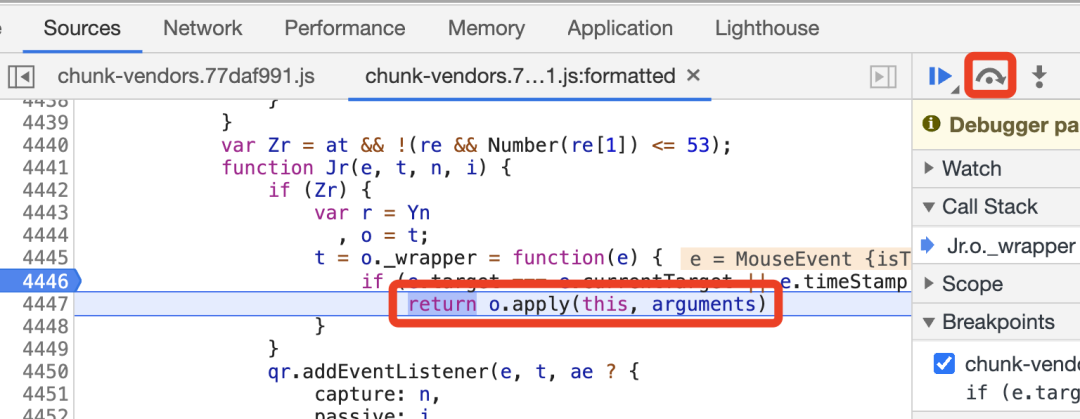
点击 Step Over Next Function Call 按钮
5. 观察调用栈
在调试的过程中,我们可能会跳到一个新的位置,比如点击上述 Step Over Next Function Call 几下,可能会跳到一个叫作 ct 的方法中,这时候我们也不知道发生了什么,如图所示。
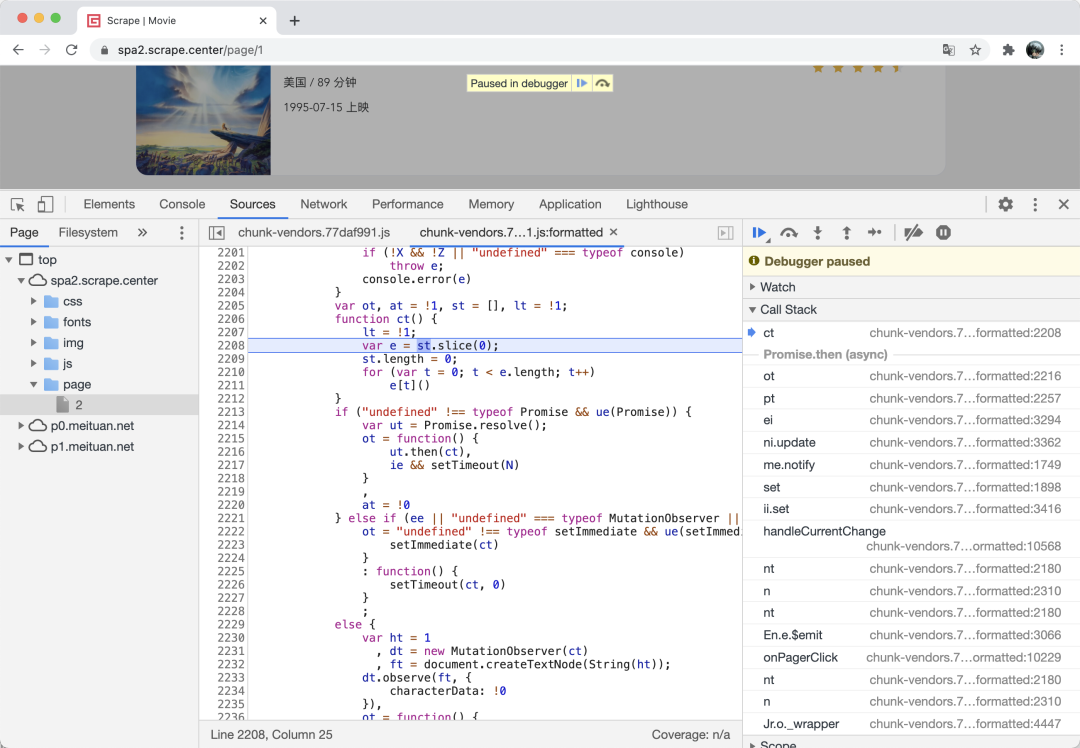
跳到 ct 方法中
那究竟是怎么跳过来的呢?我们可以观察一下右侧的 Call Stack 面板,就可以看到全部的调用过程了。比如它的上一步是 ot 方法,再上一步是 pt 方法,点击对应的位置也可以跳转到对应的代码位置,如图所示。
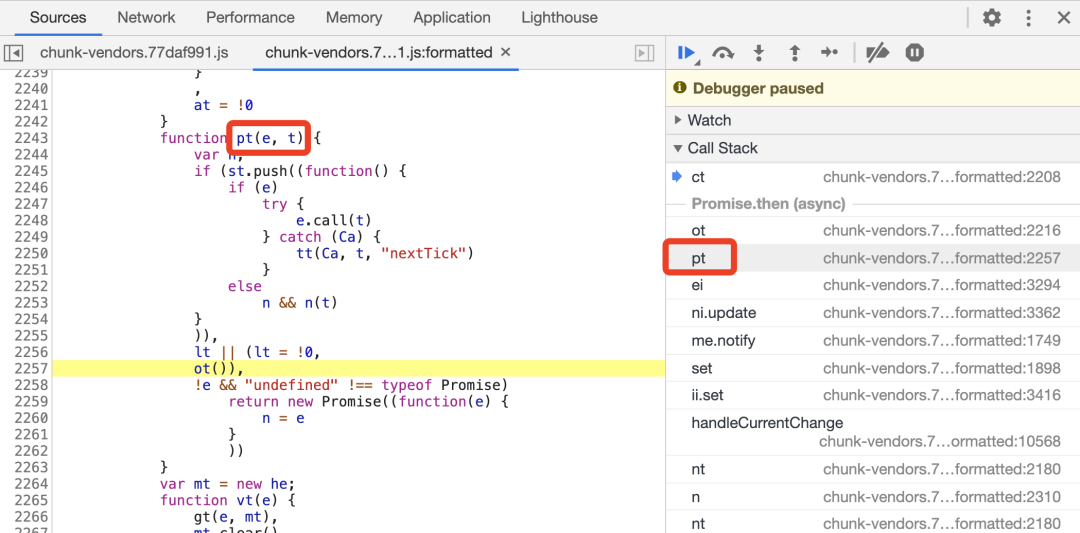
Call Stack 面板
有时候调用栈是非常有用的,利用它我们可以回溯某个逻辑的执行流程,从而快速找到突破口。
6. 恢复 JavaScript 执行
在调试过程中,如果想快速跳到下一个断点或者让 JavaScript 代码运行下去,可以点击 Resume script execution 按钮,如图所示。
Resume script execution 按钮
这时浏览器会直接执行到下一个断点的位置,从而避免陷入无穷无尽的调试中。
当然,如果没有其他断点了,浏览器就会恢复正常状态。比如这里我们就没有再设置其他断点了,浏览器直接运行并加载了下一页的数据,同时页面恢复正常,如图所示。
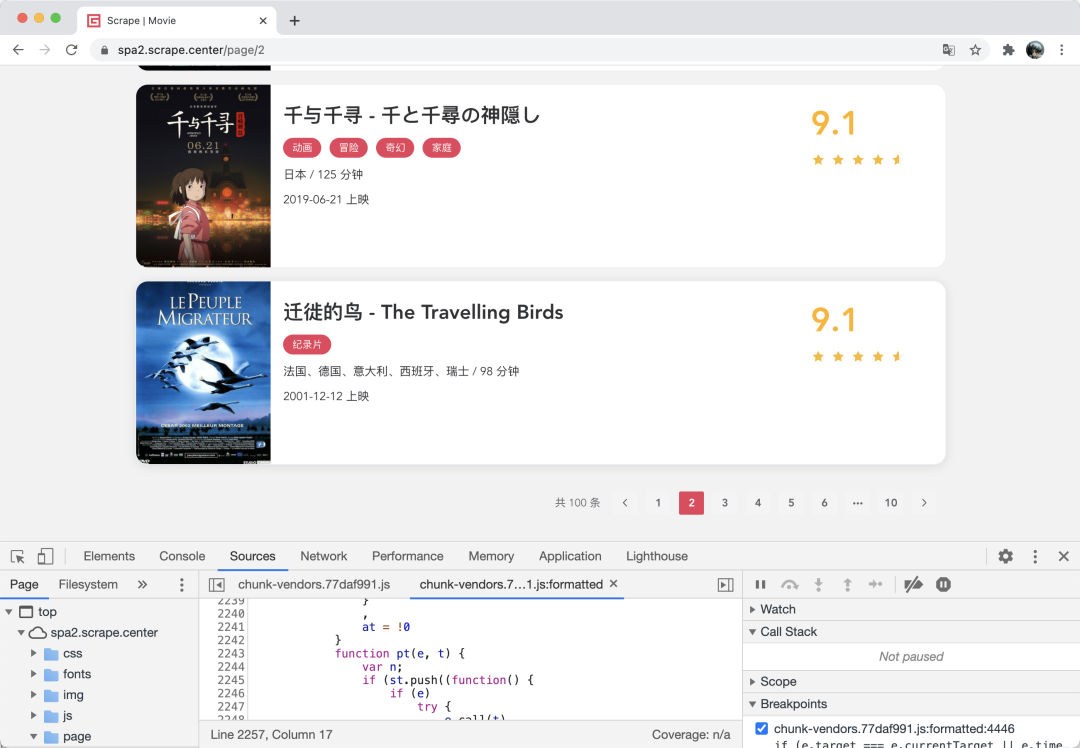
浏览器恢复正常状态
7. Ajax 断点
上面我们介绍了一些 DOM 节点的 Listener,通过 Listener 我们可以手动设置断点并进行调试。但其实针对这个例子,通过翻页的点击事件 Listener 是不太容易找到突破口的。
接下来我们再介绍一个方法—— Ajax 断点,它可以在发生 Ajax 请求的时候触发断点。对于这个例子,我们的目标其实就是找到 Ajax 请求的那一部分逻辑,找出加密参数是怎么构造的。可以想到,通过 Ajax 断点,使页面在获取数据的时候停下来,我们就可以顺着找到构造 Ajax 请求的逻辑了。
怎么设置呢?
我们把之前的断点全部取消,切换到 Sources 面板下,然后展开 XHR/fetch Breakpoints,这里就可以设置 Ajax 断点,如图所示。

展开 XHR/fetch Breakpoints
要设置断点,就要先观察 Ajax 请求。和之前一样,我们点击翻页按钮 2,在 Network 面板里面观察 Ajax 请求是怎样的,请求的 URL 如图所示。
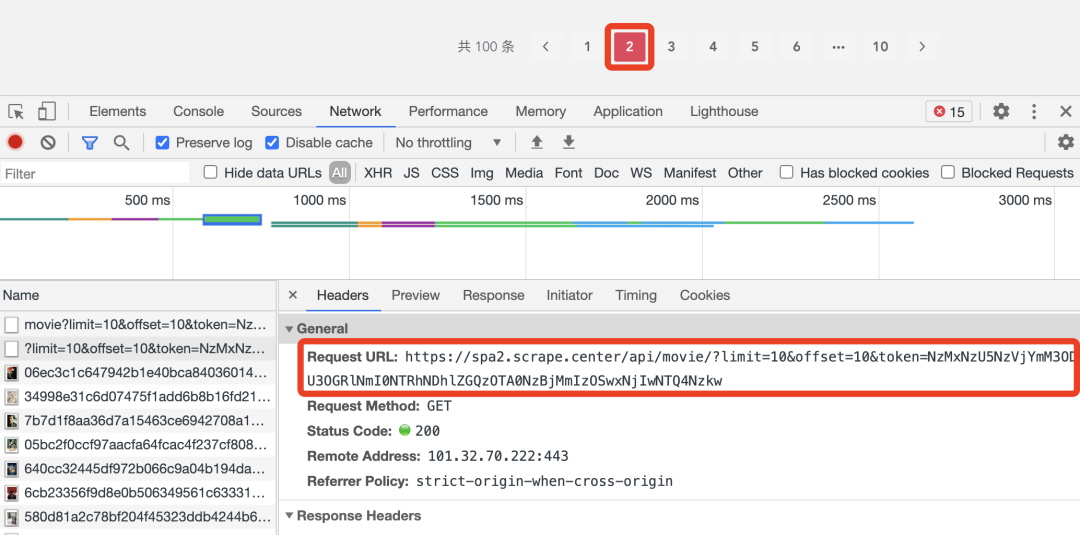
请求的 URL
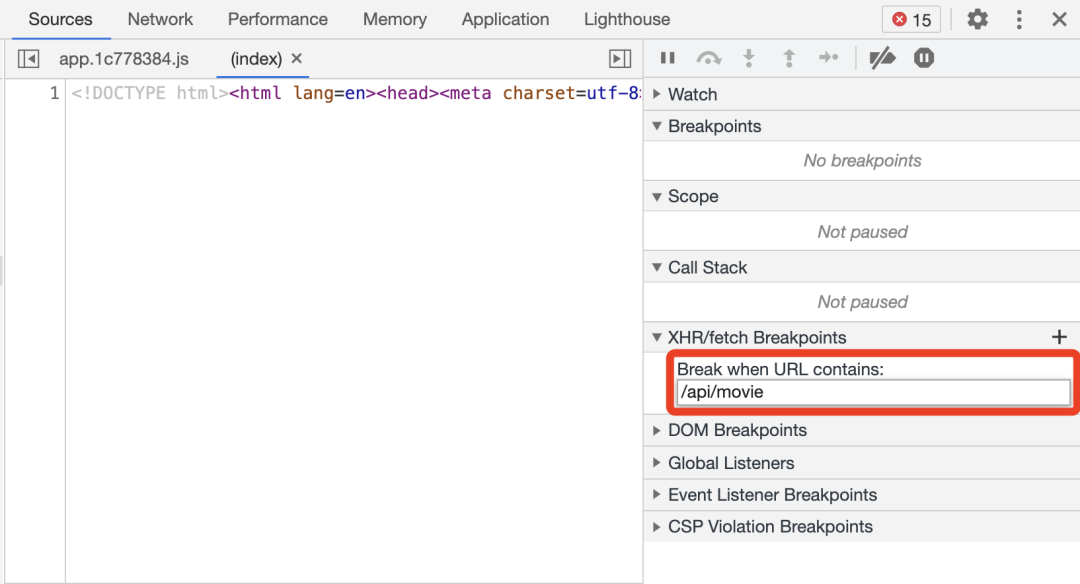
可以看到 URL 里面包含 /api/movie 这样的内容,所以我们可以在刚才的 XHR/fetch Breakpoints 面板中添加拦截规则。点击 + 号,可以看到一行 Break when URL contains: 的提示,意思是当 Ajax 请求的 URL 包含填写的内容时,会进入断点停止,这里可以填写 /api/movie,如图所示。
这时候我们再点击翻页按钮 3,触发第 3 页的 Ajax 请求。会发现点击之后页面走到断点停下来了,如图所示。
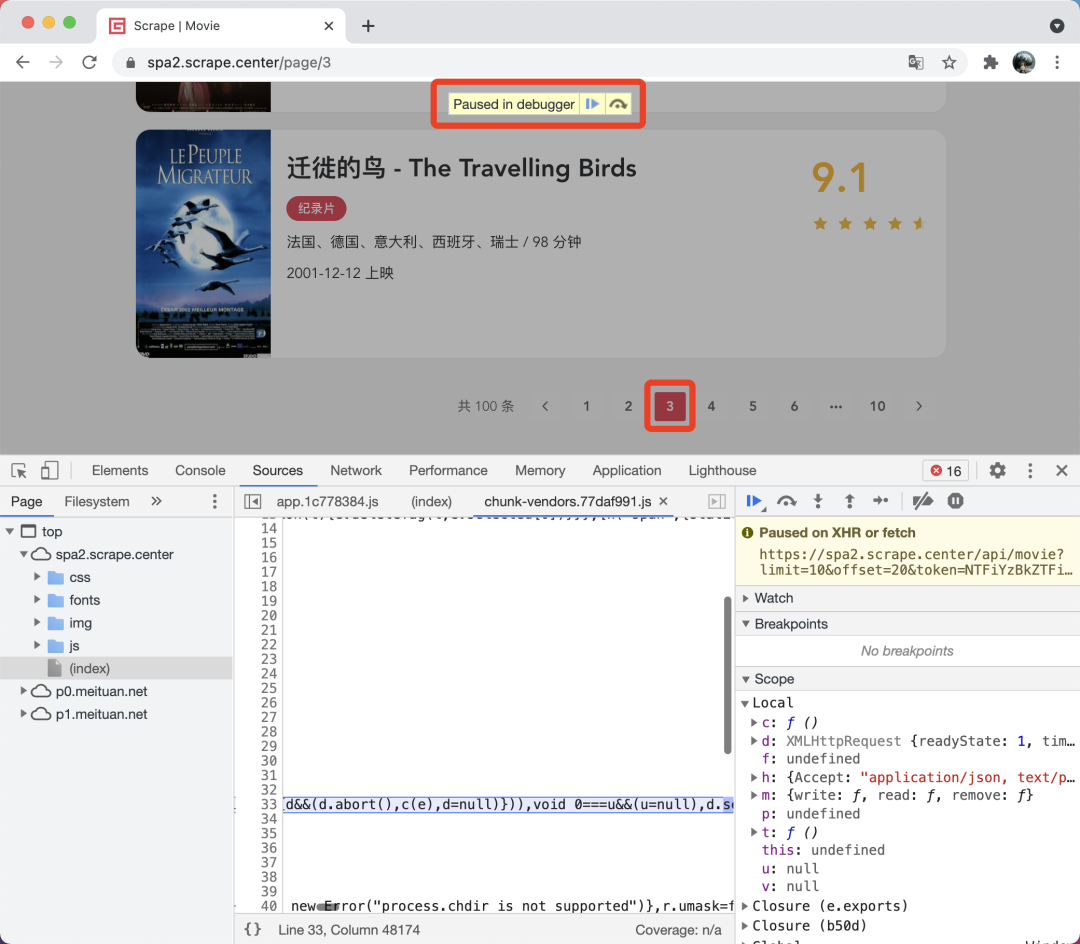
断点调试模式
格式化代码看一下,发现它停到了 Ajax 最后发送的那个时候,即底层的 XMLHttpRequest 的 send 方法,可是似乎还是找不到 Ajax 请求是怎么构造的。前面我们讲过调用栈 Call Stack,通过调用栈是可以顺着找到前序调用逻辑的,所以顺着调用栈一层层找,也可以找到构造 Ajax 请求的逻辑,最后会找到一个叫作 onFetchData 的方法,如图所示。
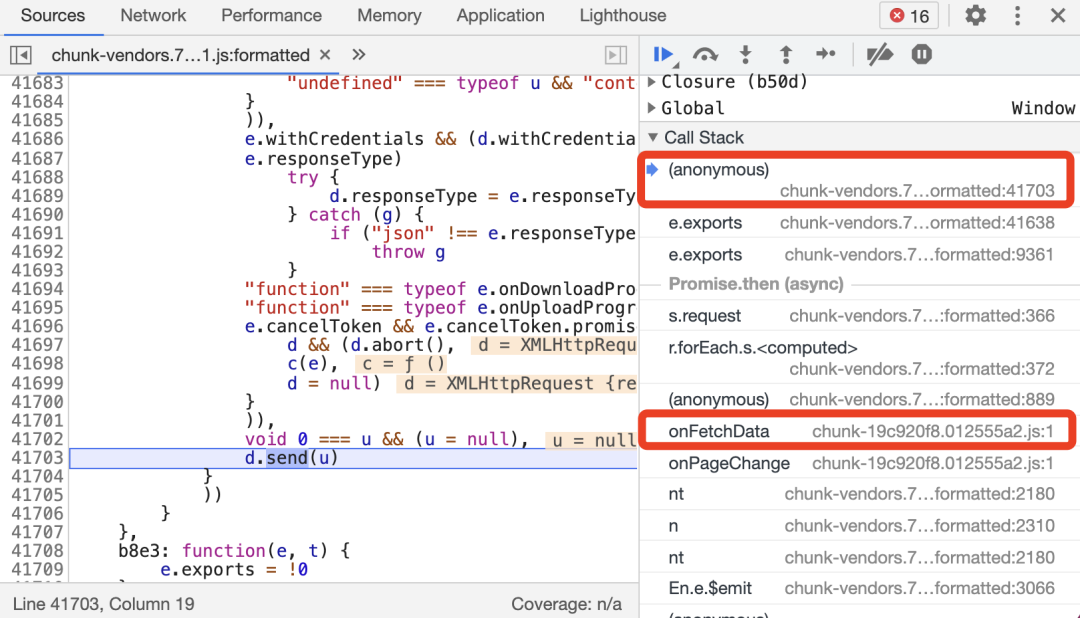
找到 onFetchData 方法
接下来切换到 onFetchData 方法并将代码格式化,可以看到如图所示的调用方法。
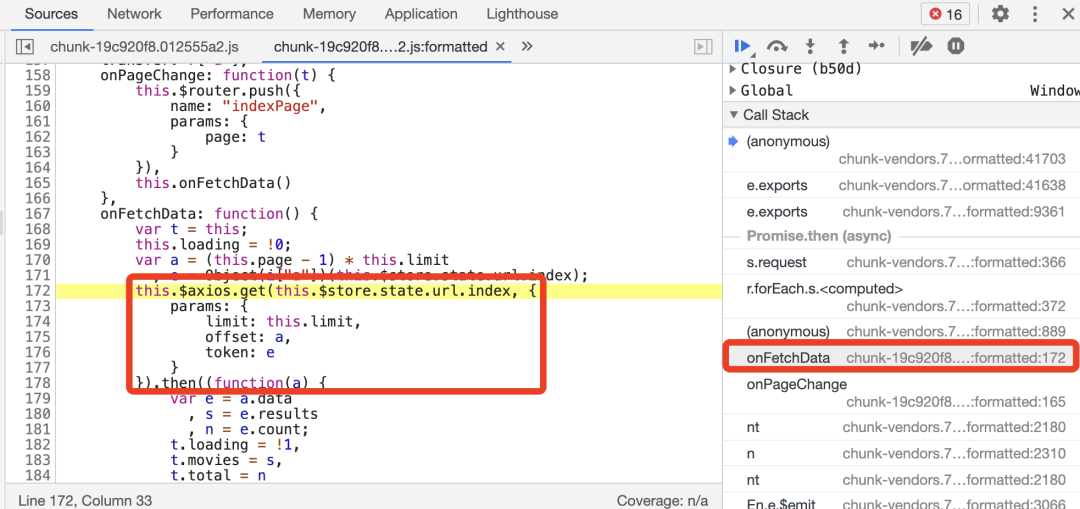
调用方法
可以发现,可能使用了 axios 库发起了一个 Ajax 请求,还有 limit、offset、token 这 3 个参数,基本就能确定了,顺利找到了突破口!我们就不在此展开分析了,后文会有完整的分析实战。
因此在某些情况下,我们可以在比较容易地通过 Ajax 断点找到分析的突破口,这是一个常见的寻找 JavaScript 逆向突破口的方法。
要取消断点也很简单,只需要在 XHR/fetch Breakpoints 面板取消勾选即可,如图所示。
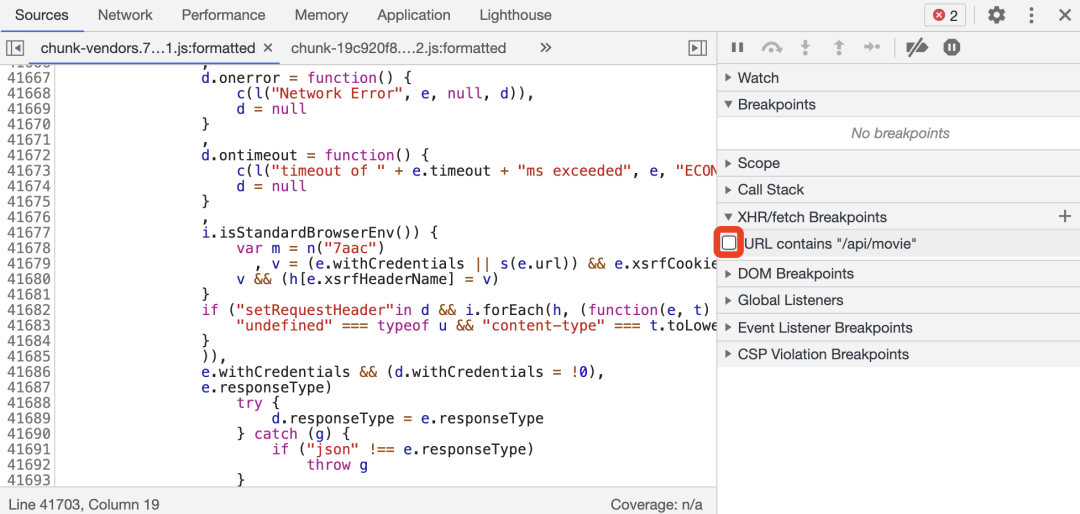
取消断点
8. 改写 JavaScript 文件
我们知道,一个网页里面的 JavaScript 是从对应服务器上下载下来并在浏览器执行的。有时候,我们可能想要在调试的过程中对 JavaScript 做一些更改,比如说有以下需求:
发现 JavaScript 文件中包含很多阻挠调试的代码或者无效代码、干扰代码,想要将其删除。
调试到某处,想要加一行 console.log 输出一些内容,以便观察某个变量或方法在页面加载过程中的调用情况。在某些情况下,这种方法比打断点调试更方便。
调试过程遇到某个局部变量或方法,想要把它赋值给 window 对象以便全局可以访问或调用。
在调试的时候,得到的某个变量中可能包含一些关键的结果,想要加一些逻辑将这些结果转发到对应的目标服务器。
这时候我们可以试着在 Sources 面板中对 JavaScript 进行更改,但这种更改并不能长久生效,一旦刷新页面,更改就全都没有了。比如我们在 JavaScript 文件中写入一行 JavaScript 代码,然后保存,如图所示。
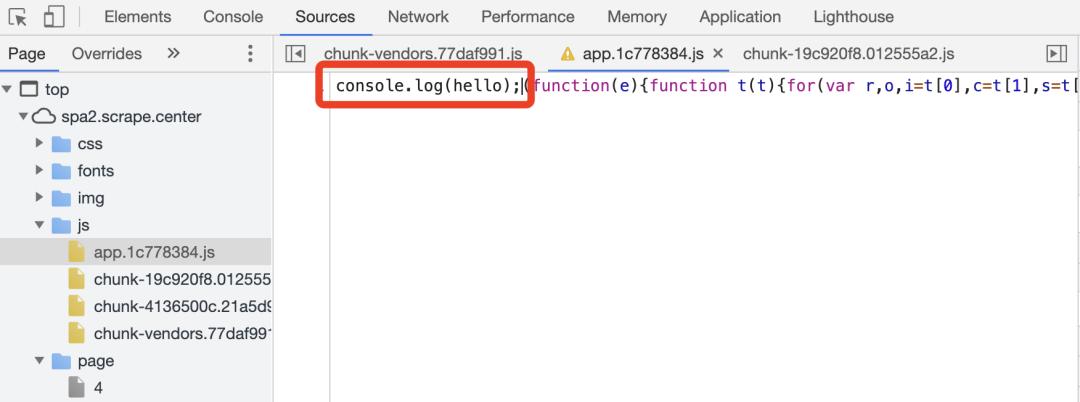
在 JavaScript 文件中写入一行 JavaScript 代码
这时候可以发现 JavaScript 文件上出现了一个感叹号标志,提示我们做的更改是不会保存的。这时候重新刷新页面,再看一下更改的这个文件,如图所示。
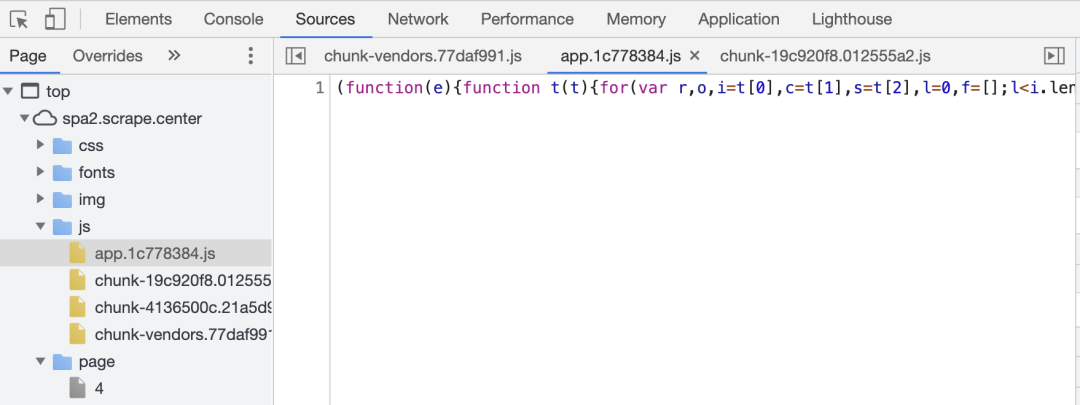
刷新页面后的 JavaScript 文件
有什么方法可以修改呢?其实有一些浏览器插件可以实现,比如 ReRes。在插件中,我们可以添加自定义的 JavaScript 文件,并配置 URL 映射规则,这样浏览器在加载某个在线 JavaScript 文件的时候就可以将内容替换成自定义的 JavaScript 文件了。另外,还有一些代理服务器也可以实现,比如 Charles、Fiddler,借助它们可以在加载 JavaScript 文件时修改对应 URL 的响应内容,以实现对 JavaScript 文件的修改。
其实浏览器的开发者工具已经原生支持这个功能了,即浏览器的 Overrides 功能,它在 Sources 面板左侧,如图所示。
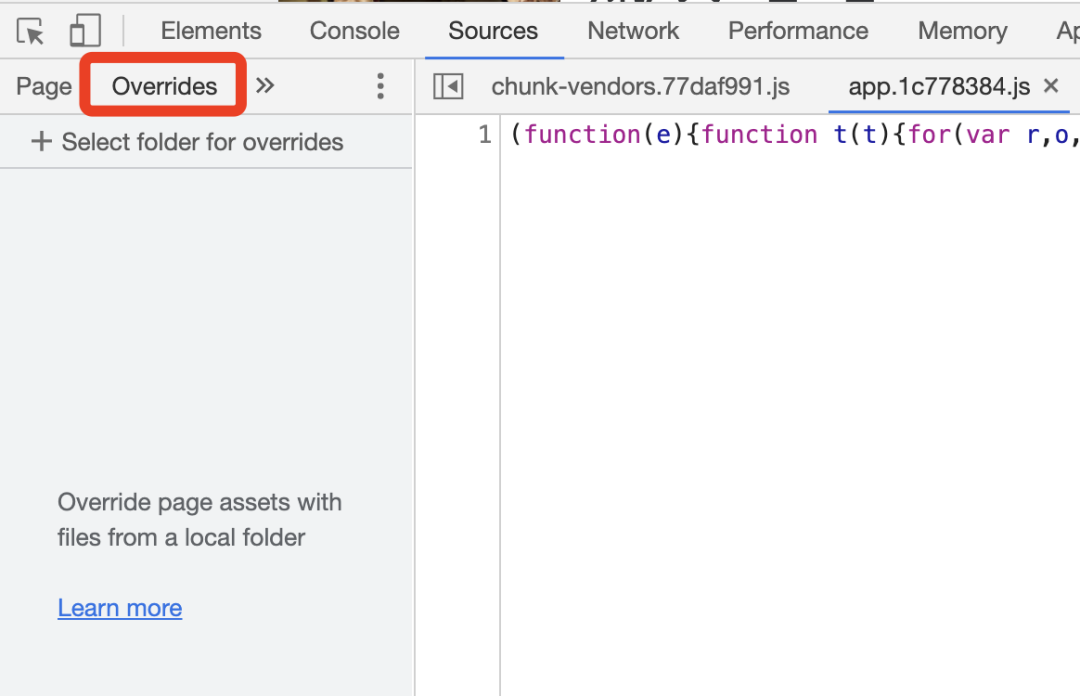
Overrides 功能
我们可以在 Overrides 面板上选定一个本地的文件夹,用于保存需要更改的 JavaScript 文件,我们来实际操作一下。
首先,根据上文设置 Ajax 断点的方法,找到对应的构造 Ajax 请求的位置,根据一些网页开发知识,我们可以大体判断出 then 后面的回调方法接收的参数 a 中就包含了 Ajax 请求的结果,如图所示。
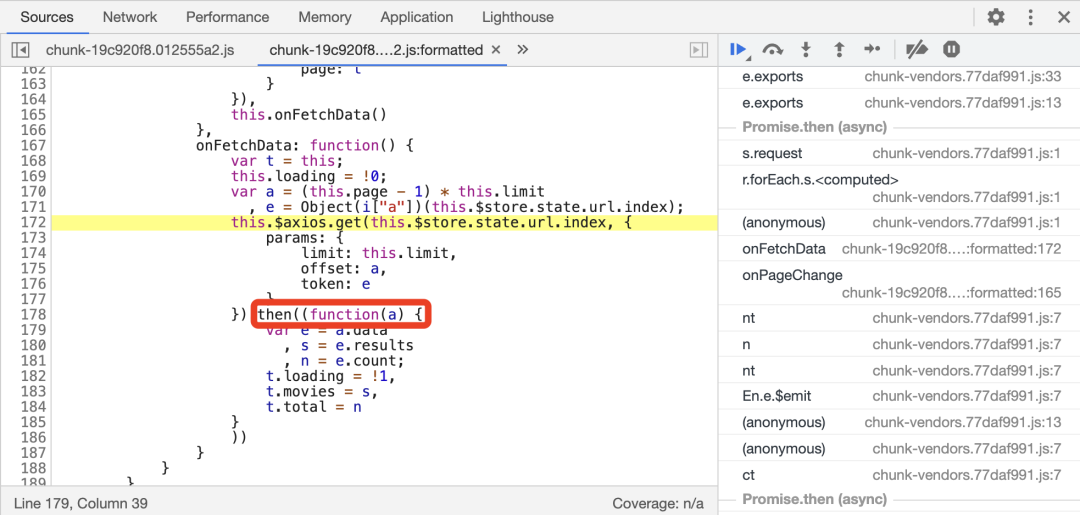
我们打算在 Ajax 请求成功获得 Response 的时候,在控制台输出 Response 的结果,也就是通过 console.log 输出变量 a。
再切回 Overrides 面板,点击 + 按钮,这时候浏览器会提示我们选择一个本地文件夹,用于存储要替换的 JavaScript 文件。这里我选定了一个我任意新建的文件夹 ChromeOverrides,注意,这时候可能会遇到如图所示的提示,如果没有问题,直接点击“允许”即可。
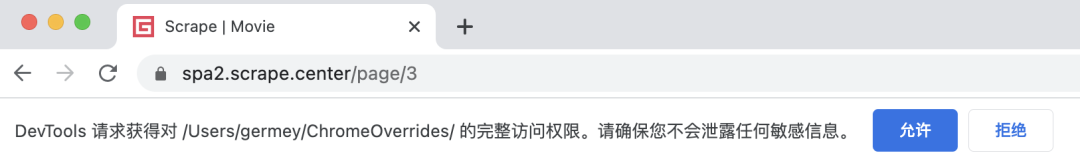
弹出提示
这时,在 Overrides 面板下就多了一个 ChromeOverrides 文件夹,用于存储所有我们想要更改的 JavaScript 文件,如图所示。
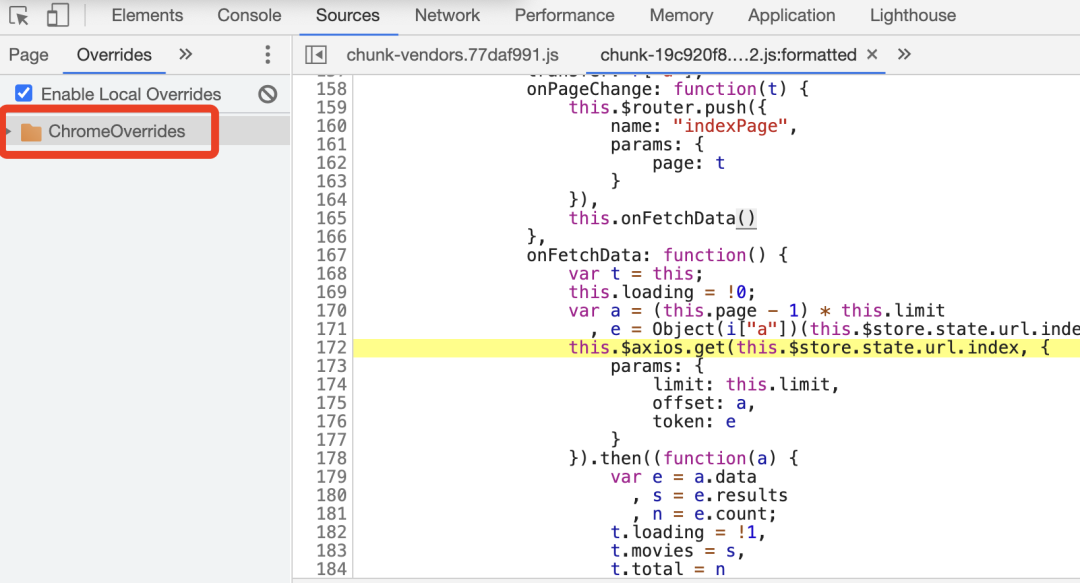
Overrides 面板下出现 ChromeOverrides 文件夹
我们可以看到,现在所在的 JavaScript 选项卡是 chunk-19c920f8.012555a2.js:formatted,代码已经被格式化了。因为格式化后的代码是无法直接在浏览器中修改的,所以为了方便,我们可以将格式化后的文件复制到文本编辑器中,然后添加一行代码,修改如下:
...}).then((function(a) { console.log('response', a) // 添加一行代码 var e = a.data , s = e.results , n = e.count; t.loading = !1,...接着把修改后的内容替换到原来的 JavaScript 文件中。这里要注意,切换到 chunk-19c920f8.012555a2.js 文件才能修改,直接替换 JavaScript 文件的所有内容即可,如图所示。
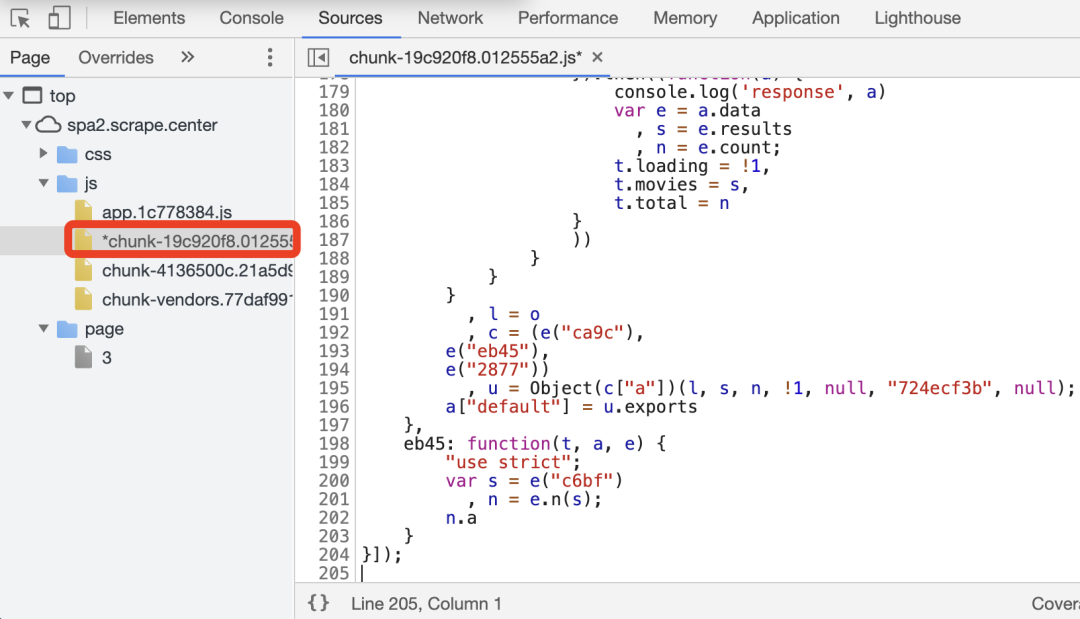
替换 JavaScript 文件的所有内容
替换完毕之后保存,这时候再切换回 Overrides 面板,就可以发现成功生成了新的 JavaScript 文件,它用于替换原有的 JavaScript 文件,如图所示。
生成了新的 JavaScript 文件
好,此时我们取消所有断点,然后刷新页面,就可以在控制台看到输出的 Reponse 结果了,如图所示。
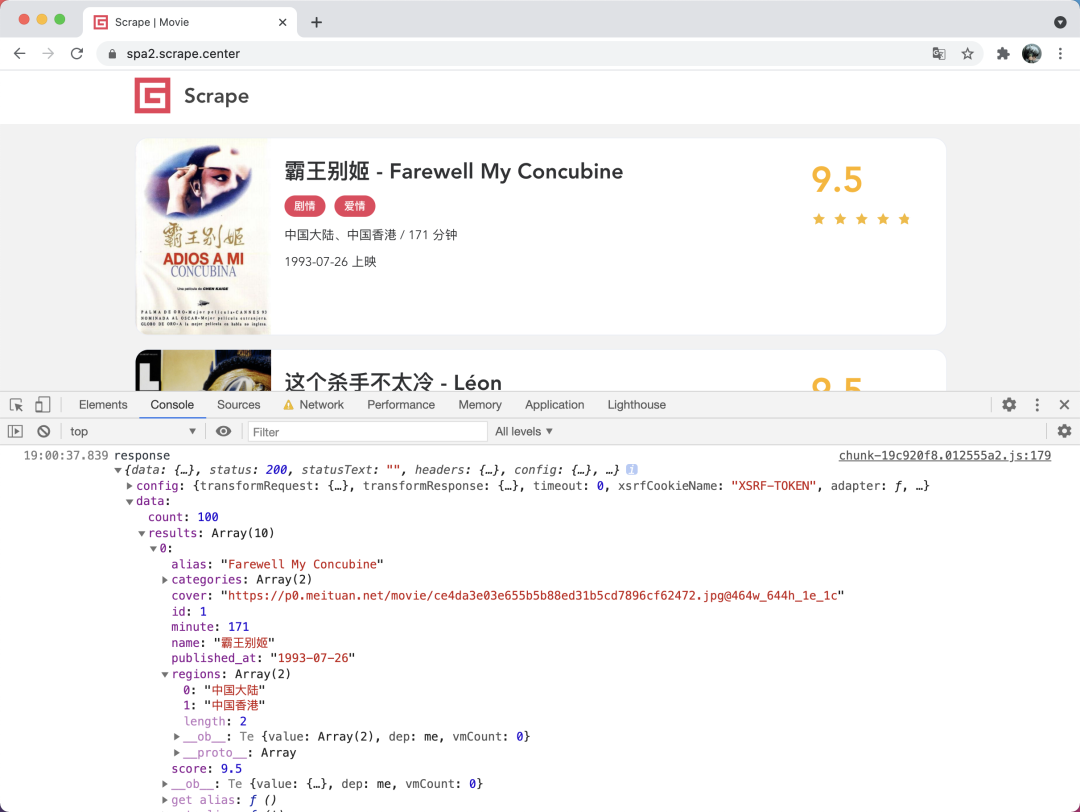
Reponse 结果
正如我们所料,我们成功将变量 a 输出,其中的 data 字段就是 Ajax 的 Response 结果,证明改写 JavaScript 成功!而且刷新页面也不会丢失了。
我们还可以增加一些 JavaScript 逻辑,比如直接将变量 a 的结果通过 API 发送到远程服务器,并通过服务器将数据保存下来,也就完成了直接拦截 Ajax 请求并保存数据的过程了。
修改 JavaScript 文件有很多用途,此方案可以为我们进行 JavaScript 的逆向带来极大的便利。
9. 总结
本节总结了一些浏览器开发者工具中对 JavaScript 逆向非常有帮助的功能,熟练掌握了这些功能会对后续 JavaScript 逆向分析打下坚实的基础,请大家好好研究。
 402


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


