OCR开源API——MinerU批量调用下载方法

【Ragflow】14.MinerU解析脚本,接入ragflow知识库 前文写了下 MinerU 的解析效果,收到不少读者催更,想利用 MinerU 替换 Deepdoc 的原始的解析器。我认为,开发新功能基本可遵循这三个阶段:能用:先通过脚本实现该功能,主打的是能用就行好用:不仅能够满足需求,而且搭配简洁易操作的界面,方便用户无需编程也能操作用好:考虑可拓展性,进一步满足日益变化的新需求。本文借助 MinerU 和 Ragflow 的原生接口,实现 MinerU 对指定文件进行解析,批量插入解析块,先实现能用的阶段。 阅读详情
AI摘要

MinerU是上海AILab开发的PDF处理工具,可将PDF转换为markdown。它支持多语言PDF解析,能提取文字、表格等信息。其API处于内测,有上传和解析页数限制。因官方批量调用示例不适用于大规模场景,作者开源批量检测代码,还写了自动获取解析结果md文件的Python代码。

MinerU概述

MinerU是上海AILab开发的PDF处理工具,可以将PDF(部分PDF加密,模糊,使得PDF处理起来很麻烦)转换为markdown,进而方便进一步处理(比如复制粘贴,喂给AI 大模型或者编程进一步处理等等)。
官网:https://mineru.net/https://mineru.net/

github:https://github.com/opendatalab/MinerU

特点与技术原理

支持多语言(中文、英文、日文等)PDF文档的解析,可以同时将PDF中的文字,表格,数学公式,图片等信息都提取出来,并转换为markdown相对应的格式。也可以上传图片类型的pdf文档进行识别。

其技术原理本质是将PDF解析拆分为以下几步,并使用不同的模型识别对应内容:

布局检测:使用 LayoutLM v3 模型进行区域检测,如图像,表格,标题,文本等;
公式检测:使用 YOLO v8 进行公式检测,包含行内公式和行间公式;
公式识别:使用 UniMERNet 进行公式识别;
表格识别:使用 StructEqTable 进行表格识别;
光学字符识别:使用 PaddleOCR 进行文本识别;

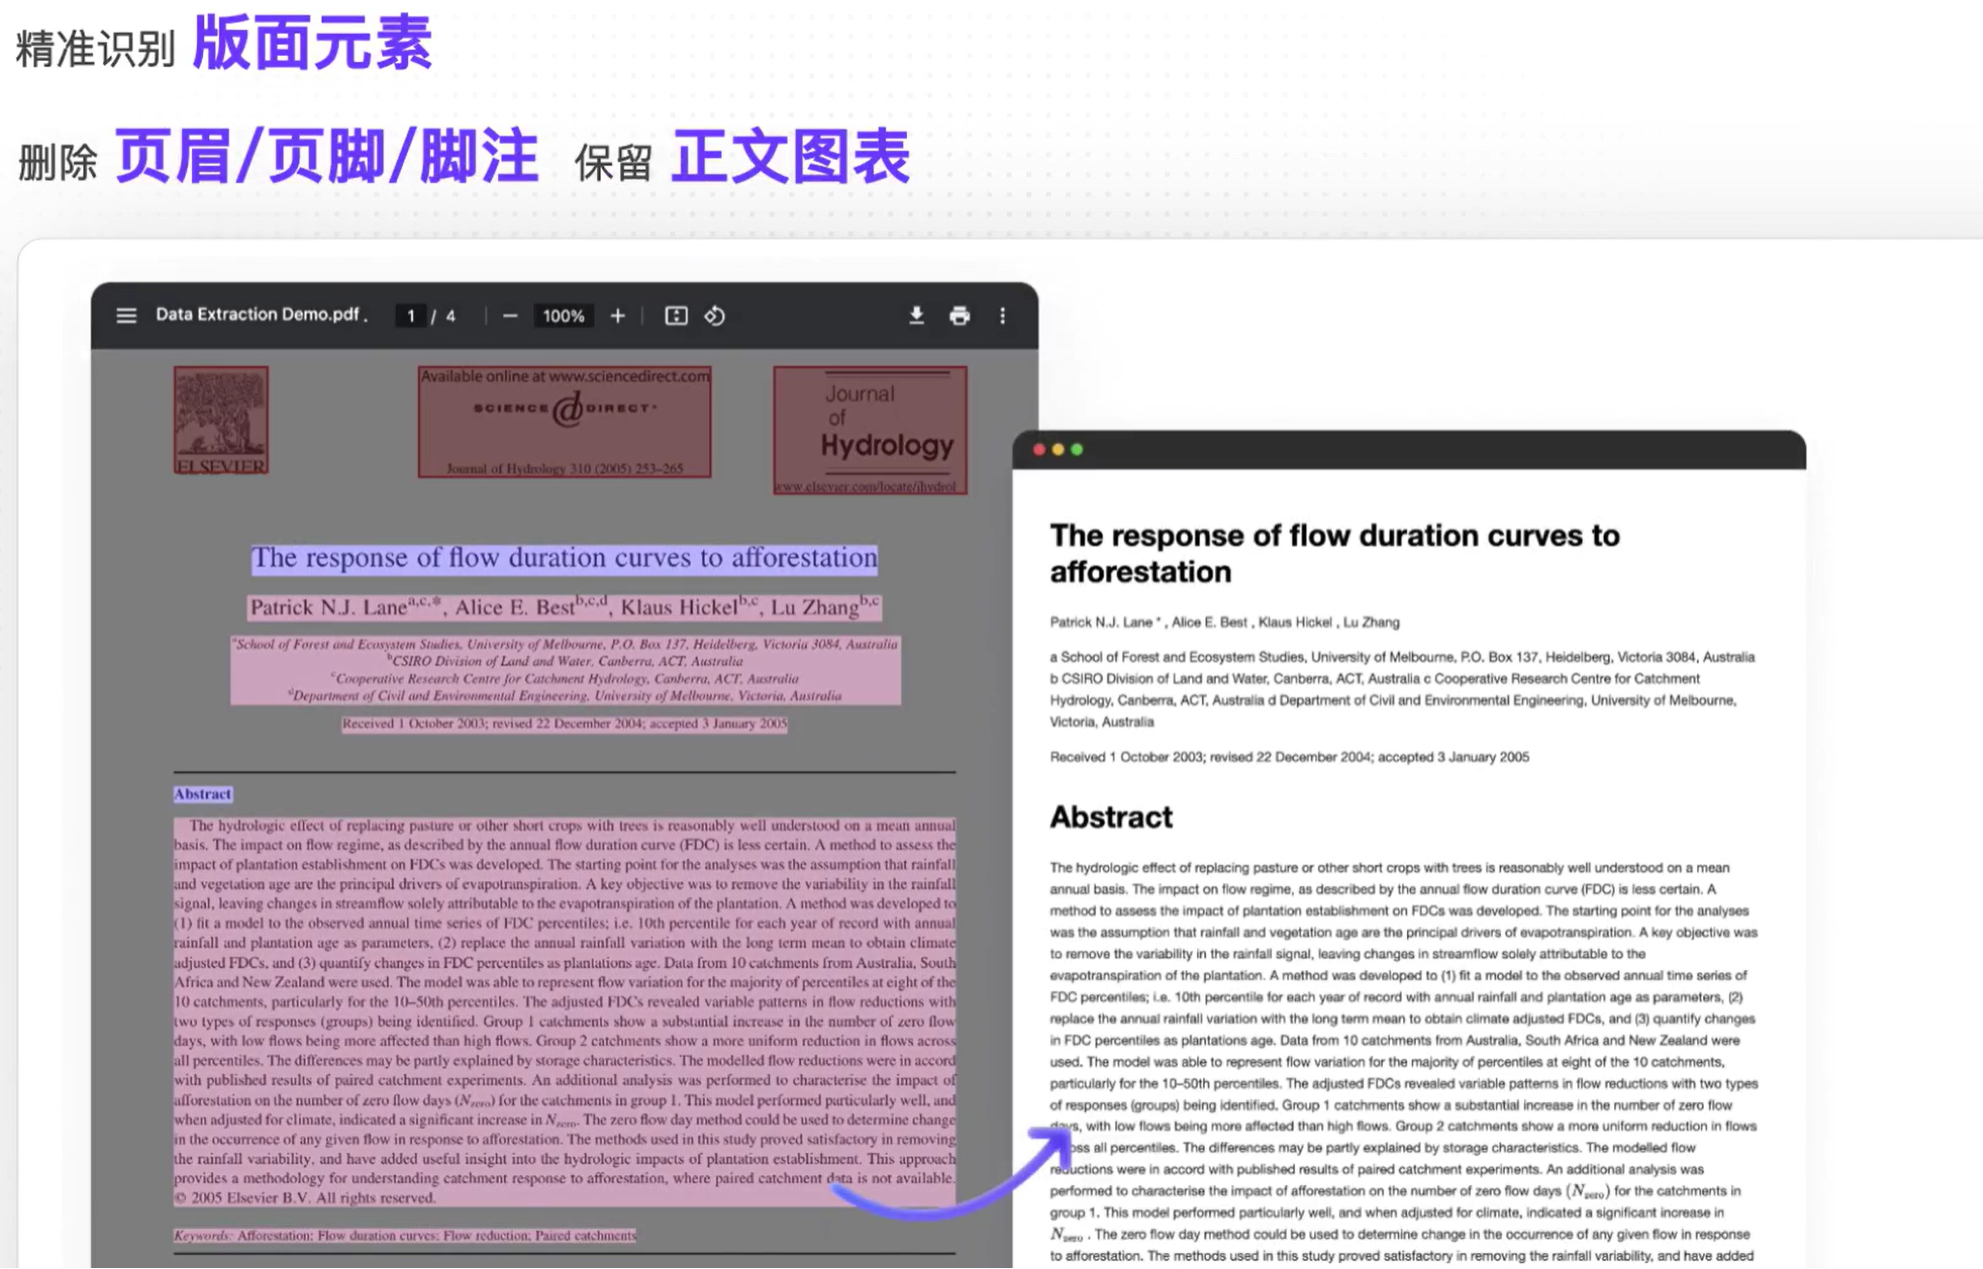
图片也可以原文原位置转换,公式也可以较精确的转换pdf公式为Latex格式公式:
API

MinerU的API提供了丰富的接口以及相应的调用示例,如下图:
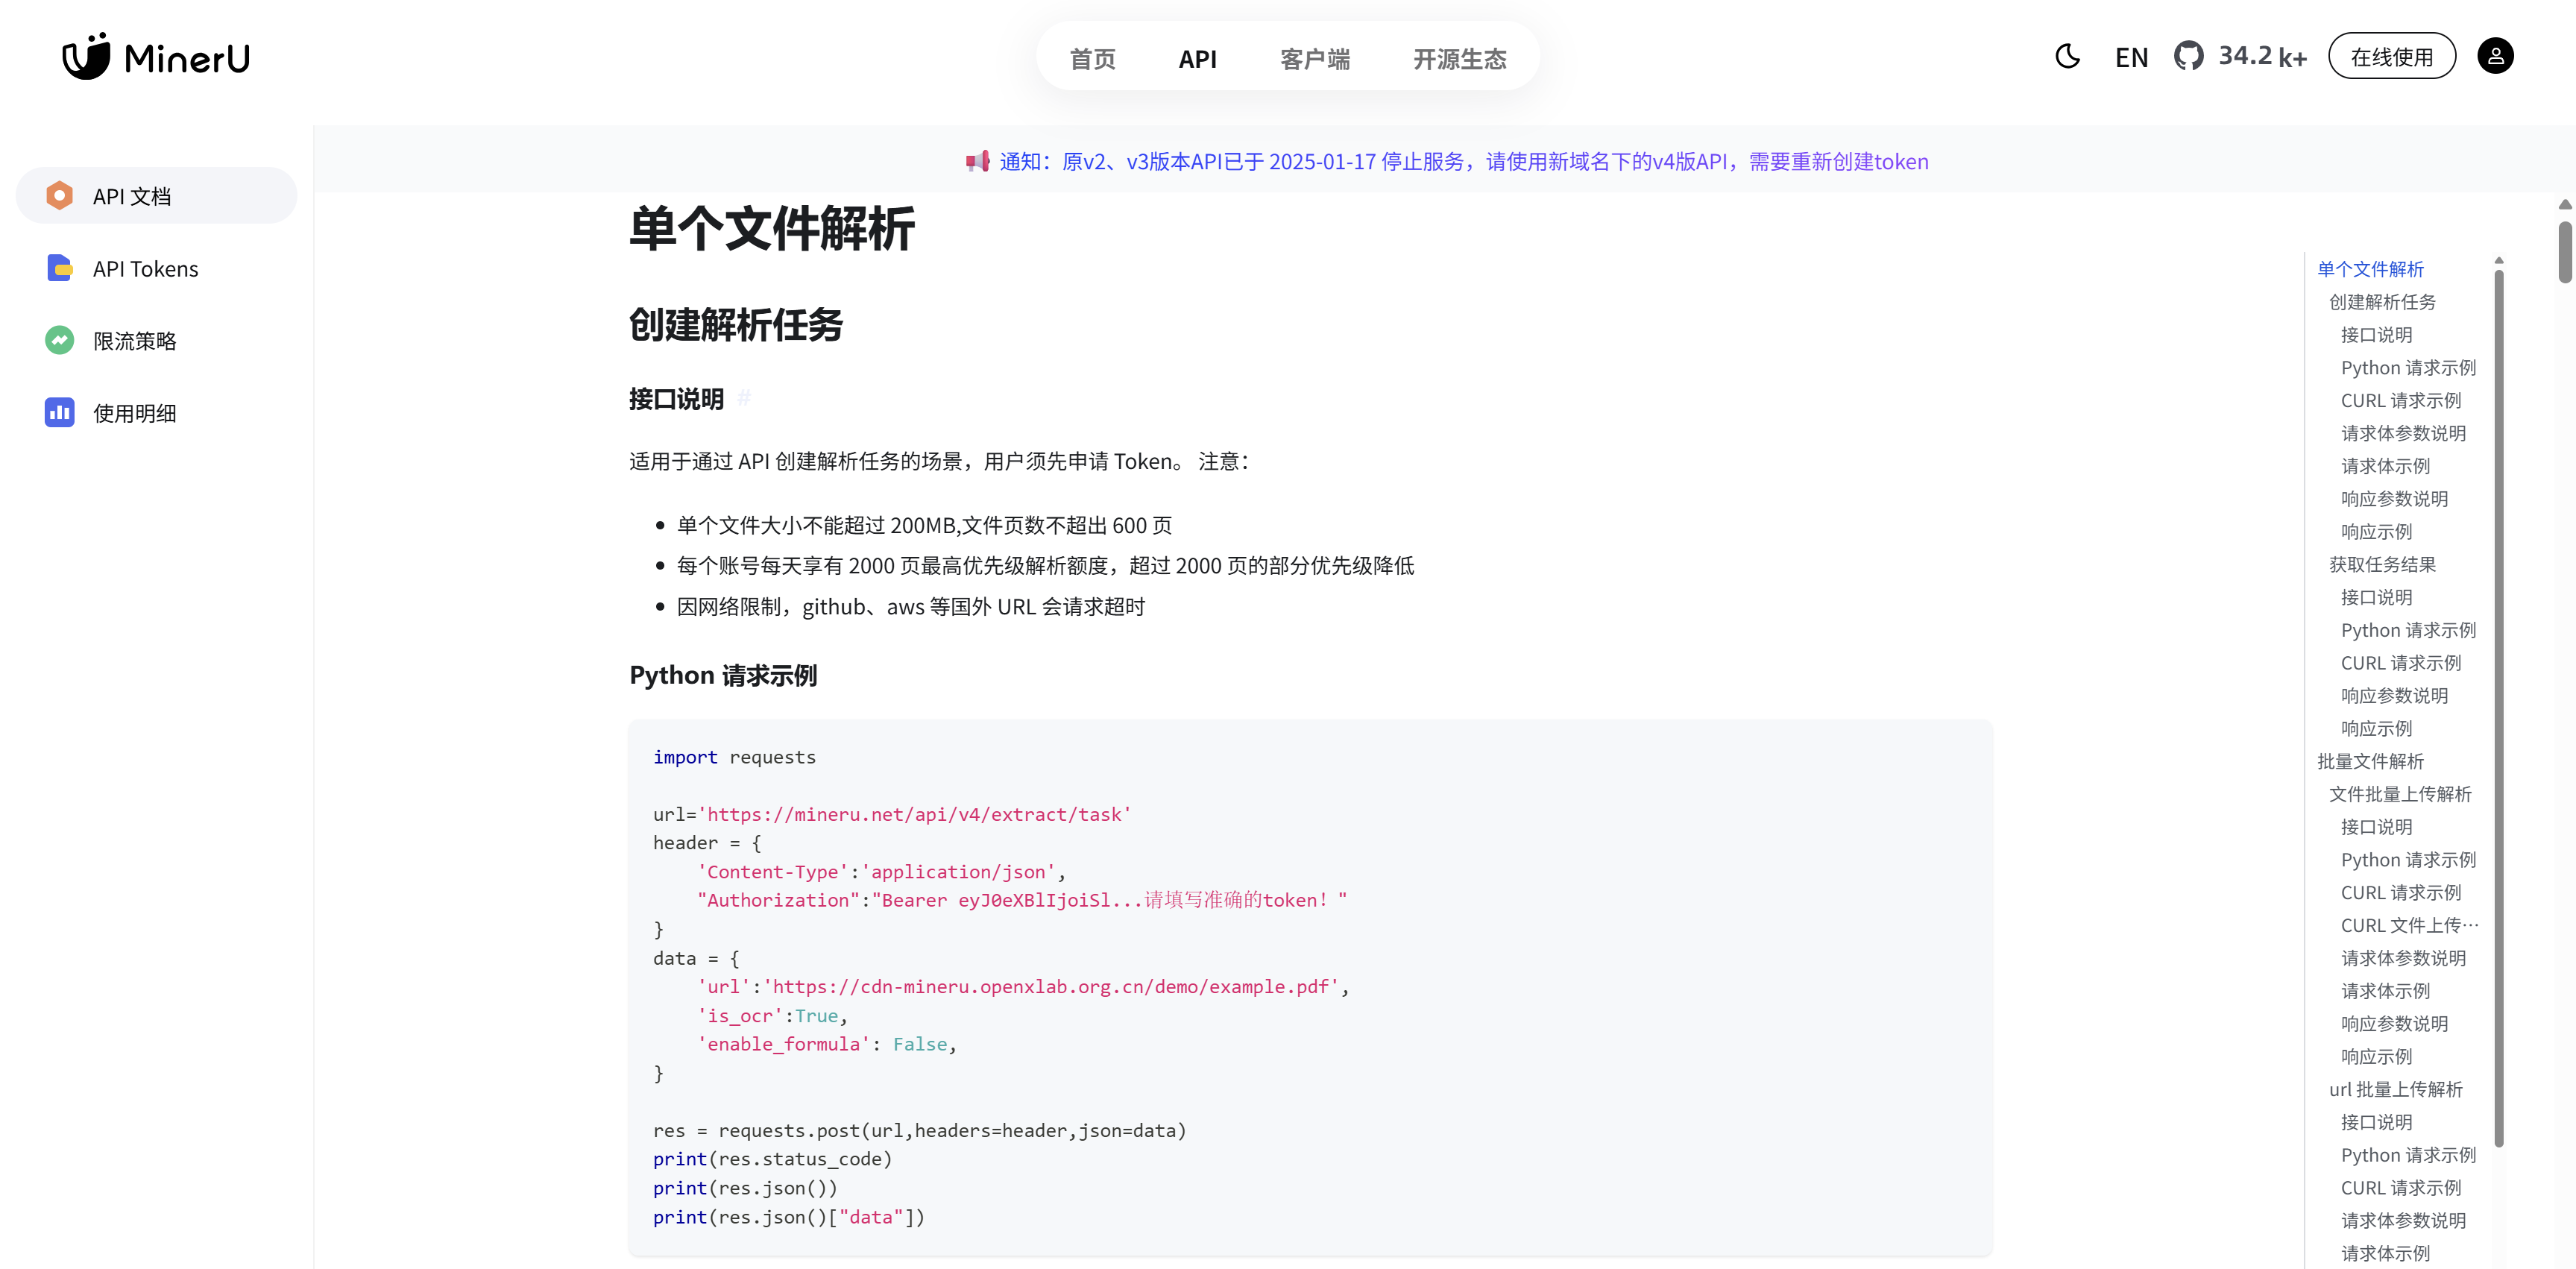
具体详细的调用方式以及参数详见官网:
MinerUMineru 智能数据提取https://mineru.net/apiManage/docs

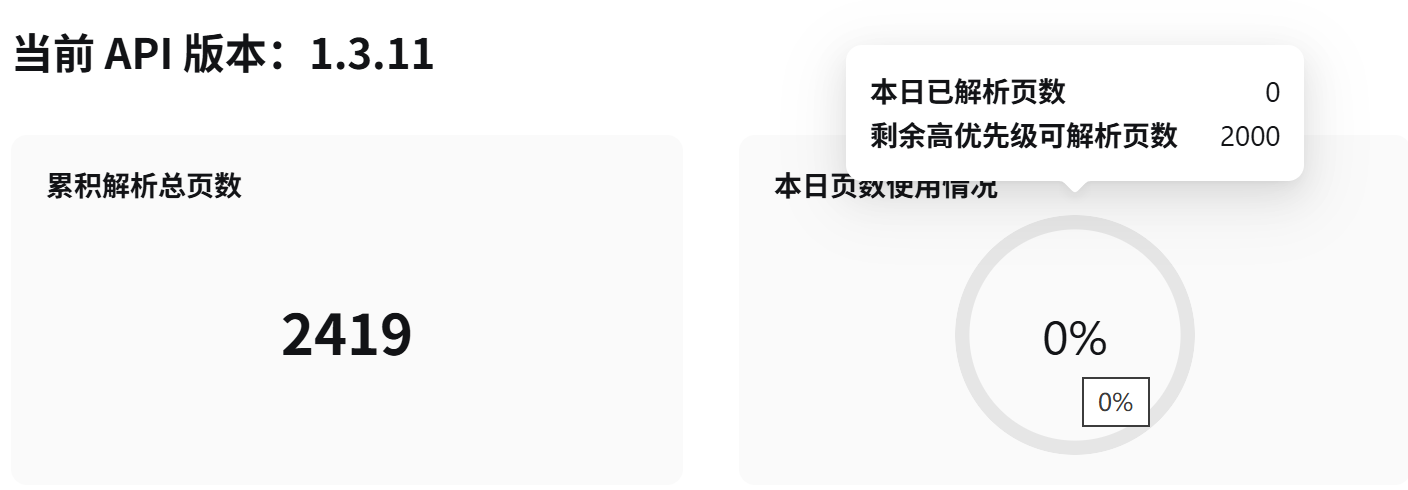
当前 MinerU API 处于内测运行阶段,为确保稳定服务体验,对用户执行以下限流策略:

  • 上传限制:单个文件大小不超过 200 MB,单个上传文件页数不超过 600 页
  • 解析页数限制:每个账号每天不限解析页数,但需要遵守我们的优先级策略。每个用户享有2000页最高优先级解析额度,超过2000页的部分优先级降低(自然日内统计)
由于MinerU官方给出的批量调用API示例不能匹配大规模调用(1000+)的使用场景,而且每次有限制最多一批上传200个pdf文件,这对于测试OCR benchmark带来不便,因此我在这里开源了我写的批量检测代码,每次调用只需要改动批次号i,因为目前API不支持连续多批次调用(当然也可以写脚本加时间间隔)。

import requests
import os
from glob import glob

# 配置参数

pdf_dir="/pdf" #输入你的pdf路径
max_files_per_batch = 200  # 每批最多200个文件 这是官网限制

# 获取所有PDF文件
pdf_files = glob(os.path.join(pdf_dir, "*.pdf"))
if not pdf_files:
    print(f"No PDF files found in {pdf_dir}")
    exit()

# API配置
url = 'https://mineru.net/api/v4/file-urls/batch'
header = {
    'Content-Type': 'application/json',
    "Authorization": "Bearer xxx" #输入你的API-key
}

# 
i=0
print(i)
batch_idx = max_files_per_batch * i  # 第二批次的起始索引(200)
batch_files = pdf_files[batch_idx : batch_idx + max_files_per_batch]

if not batch_files:
    print("第二批没有文件可处理")
    exit()

# 构建文件数据
files_data = [{
    "name": os.path.basename(pdf),
    "is_ocr": True,
    "data_id": f"{os.path.splitext(os.path.basename(pdf))[0]}_b2",
    "language": "ch",  # 批次号固定为2
} for pdf in batch_files]

# print(f"\n正在处理第"+i+"批次(共 {len(batch_files)} 个文件)")

try:
    # 获取上传URL
    response = requests.post(url, headers=header, json={
        "enable_formula": True,
        "language": "en",
        "layout_model": "doclayout_yolo",
        "enable_table": True,
        "files": files_data
    })

    if response.status_code != 200:
        print(f"请求失败,状态码:{response.status_code}")
        exit()

    result = response.json()
    if result["code"] != 0:
        print(f'申请失败,原因:{result.get("msg", "未知错误")}')
        exit()

    # 上传文件
    batch_id = result["data"]["batch_id"]
    urls = result["data"]["file_urls"]
    success_count = 0
    
    for idx, (url, pdf_path) in enumerate(zip(urls, batch_files)):
        with open(pdf_path, 'rb') as f:
            res = requests.put(url, data=f)
            if res.status_code in [200, 201]:
                success_count += 1
            else:
                print(f"失败文件:{os.path.basename(pdf_path)},状态码:{res.status_code}")
    
    print(f"第二批次完成 | 成功:{success_count}/{len(batch_files)} | 批次ID:{batch_id}")
#这个批次id一会会用到

except Exception as e:
    print(f"发生异常:{str(e)}")

由于MinerU在上传解析后仍然需要下载解析后pdf的压缩包,而手动下载非常麻烦,故我写了一个python代码自动获取某一批次id(如上面代码注释)的pdf解析结果md文件

import requests
import zipfile
import os
import shutil
from urllib.parse import urlparse

output_dir = "/result"  # 指定输出目录
os.makedirs(output_dir, exist_ok=True)  # 自动创建目录
idx='xxx-xxx-xxx' #之前代码的批次id

# 原始API请求
url = 'https://mineru.net/api/v4/extract-results/batch/'+idx
headers = {
    'Content-Type': 'application/json',
    "Authorization": "Bearer xxx" #你的api-key
}

response = requests.get(url, headers=headers)
batch_data = response.json()["data"]

# 正确访问数据路径
data_list = batch_data['extract_result']  # 从extract_result获取数据

for item in data_list:
    if item.get('state') == 'done' and 'full_zip_url' in item:
        zip_url = item['full_zip_url']
        original_name = item['file_name']
        
        # 生成最终路径
        base_name = os.path.splitext(original_name)[0]
        final_filename = f"{base_name}.md"
        output_path = os.path.join(output_dir, final_filename)
        
        try:
            # 创建临时目录
            temp_dir = os.path.join(output_dir, f"temp_{item['data_id']}")
            os.makedirs(temp_dir, exist_ok=True)
            
            # 下载ZIP文件
            zip_response = requests.get(zip_url, stream=True)
            zip_response.raise_for_status()
            
            # 保存临时ZIP
            zip_name = os.path.basename(urlparse(zip_url).path)
            zip_path = os.path.join(temp_dir, zip_name)
            with open(zip_path, 'wb') as f:
                for chunk in zip_response.iter_content(1024 * 1024):  # 1MB chunks
                    f.write(chunk)
            
            # 解压并处理文件
            with zipfile.ZipFile(zip_path, 'r') as zip_ref:
                # 搜索full.md文件
                target_file = None
                for file_info in zip_ref.infolist():
                    if os.path.basename(file_info.filename) == 'full.md':
                        target_file = file_info
                        break
                
                if target_file:
                    # 解压到临时目录
                    zip_ref.extract(target_file, temp_dir)
                    
                    # 构建完整路径
                    extracted_path = os.path.join(temp_dir, target_file.filename)
                    
                    # 移动并重命名
                    shutil.move(extracted_path, output_path)
                    print(f"成功处理:{original_name} -> {output_path}")
                else:
                    print(f"警告:{zip_name} 中未找到full.md文件")
            
        except requests.exceptions.RequestException as e:
            print(f"下载失败:{original_name} | 错误:{str(e)}")
        except zipfile.BadZipFile:
            print(f"损坏的ZIP文件:{original_name}")
        except Exception as e:
            print(f"处理异常:{original_name} | 错误类型:{type(e).__name__} | 详情:{str(e)}")
        finally:
            # 清理临时文件
            if os.path.exists(temp_dir):
                shutil.rmtree(temp_dir)

这样我们就可以愉快的转化pdf了(:

国产PDF智能提取神器:MinerU功能全解析 MinerU做为国产 PDF 智能提取工具,专注于文档数据的自动化处理和高效解析。它能够通过LayOut、OCR和表格识别等模型,对各类 PDF 文档进行精准的数据提取,支持表格、文本和字段等多种内容的识别与处理。无论是标准 PDF,还是扫描版、加密版文档,MinerU 都能够轻松应对,保持文档数据的完整性和结构化。提供API和客户端,帮助用户能快速上手,并根据业务需求拓展功能。 阅读详情

相关推荐

基于mineru与百度OCR的PDF转Word本地化工程方案

文档格式转换是数据处理中的常见需求,其核心在于从非结构化文档中准确提取并重建结构化信息。PDF作为一种跨平台的固定版式文档格式,其本质是打印描述文件,逆向转换为可编辑的Word文档涉及文本提取、版面分析和格式重建等关键技术环节。传统在线工具或商业软件常因格式错乱、识别精度低或隐私安全问题而难以满足高质量、批量化处理需求。通过结合开源文档解析工具mineru与百度Unlimited OCR的高精度识别能力,可以构建一套本地化、可编程的解决方案。该方案将转换流程透明化、工程化,允许开发者针对文本层与图像层进行精

weixin_34354173的博客 353

AI驱动的PDF文档智能解析:MinerU本地部署与API调用完全指南

MinerU是一个将复杂文档(如PDF)转换为LLM就绪的markdown/JSON格式的工具,用于Agentic工作流。相比传统PDF解析工具,MinerU在文档结构解析、多媒体提取、公式识别等方面有着显著优势。

Vantastic999的博客 4802

MinerU-3本地文档解析工具:OCR与文本提取一体化方案部署与评测

文档解析与OCR(光学字符识别)是信息数字化领域的核心技术,旨在将非结构化的文档(如PDF、图片)转换为可编辑、可搜索的结构化文本。其原理通常结合计算机视觉与自然语言处理技术,通过版面分析、文字检测与识别等步骤实现。这项技术的核心价值在于提升信息处理效率、实现知识资产数字化,并保障数据处理的本地化与隐私安全。在工程实践中,它广泛应用于学术文献整理、企业文档自动化、内容创作素材提取等场景。本文聚焦的MinerU-3工具,正是集成了OCR与文本提取能力,支持图文混排解析,并能同时兼容GPU加速与纯CPU运行的本

weixin_34318326的博客 557

实战指南:部署MinerU多模态文档解析API与Dify深度集成(实现解析PDF/JPG/PNG)

攻克多模态文档解析瓶颈! 本文手把手教你部署支持图片/公式/表格的MinerU解析服务,突破科学上网限制完成ModelScope模型下载,详解NVIDIA容器运行时配置。更实现与Dify平台的深度集成,通过插件授权+端口映射实战,构建从PDF下载→智能解析→Markdown转换的自动化工作流。

yumuing‘s blog 6504

MinerU私有化部署全攻略:从Docker到API调用的完整实践

本文提供了MinerU私有化部署的完整实践指南,涵盖从Docker环境配置到API调用的全流程。详细解析了三种Docker部署方案,包括快速体验、生产环境推荐及定制化调优,并重点介绍了如何通过API高效解析复杂PDF文档,确保数据安全与处理性能。

flower的专栏 714

MinerU是一款将PDF转化为机器可读格式的工具(如markdown、json),可以很方便地抽取为任意格式

MinerU是一款将PDF转化为机器可读格式的工具(如markdown、json),可以很方便地抽取为任意格式。

用命令行批量解析 PDF:mineru-open-api CLI 完整教程

MinerU CLI工具是上海人工智能实验室开源的文档解析利器,支持一键将PDF、Word等文件转换为结构化格式。最新2.5-Pro版本在OmniDocBench基准测试中取得95.69分,仅需1.2B参数即可实现高效解析。提供flash-extract(免登录)和extract(功能全面)两种模式,支持批量处理、多格式输出(Markdown/JSON等)及网页抓取功能。安装简单,Windows/macOS/Linux均可快速部署,是文档处理的高效解决方案。

lingxie2512的博客 862

细说VLAN之untag和tag

一、拓扑图 先给出上面拓扑图的结论,后面再详细讲解: 结论:只有PC1与PC4之间能相互通信,除此之外,所有PC之间均不能通信,比如PC1与PC3不能建立通信。 针对Ping命令的一个知识: 要想ping通某台主机,必须满足两个条件: 1,源主机的ICMP请求包必须能达到目的主机。 2,目的主机的ICMP应答包必须能回到源主机。 二、理论基础 端口的出...

NoobMaster的博客 3万+

开源VS商用OCR:MinerU性价比全面评测教程

本文介绍了如何在星图GPU平台上自动化部署OpenDataLab MinerU 智能文档理解镜像,高效实现扫描PDF、论文截图等非结构化文档的精准文字提取与图表理解。典型应用场景包括合同关键条款识别、学术图表数据解析及PPT多栏内容逻辑还原,显著提升知识工作者的文档处理效率与准确性。

weixin_42601702的博客 417

保姆级教程:用GROMACS的FEP方法计算小分子结合自由能(附完整mdp配置)

本文提供了一份详细的GROMACS自由能微扰(FEP)计算教程,涵盖从系统准备、参数配置到结果分析的全流程。通过具体案例演示如何计算小分子结合自由能,包括λ窗口设计、动力学参数优化及并行化执行技巧,帮助研究者克服FEP计算中的常见问题,获得可靠的自由能数据。

weixin_30598225的博客 353

从零构建高精度电子秤:HX711与STM32的时序通信陷阱与实战避坑指南

本文详细解析了使用STM32F103C8T6与HX711模块构建高精度电子秤的通信时序陷阱与实战解决方案。重点探讨了微秒级延迟实现、数据读取算法、校准方法和滤波优化,帮助开发者避开常见通信问题,提升电子秤的测量精度和稳定性。

data3的博客 782

MinerU API 接入实战:5 个端点跑通 PDF 批量转 Markdown

MinerU API 是一组 RESTful 文档解析接口:装好 mineru、启动 mineru-api 服务后,你用一次 HTTP 请求上传 PDF 或图片,响应里直接带回 Markdown、中间 JSON 和切图,不用自己搭解析管线。本文按"先跑通、再调参、后上生产"三步,带你把它接进自己的产品。 [![MinerU API 文档解析流水线:从 PDF 到 Markdown 的处理流程](

gitblog_00409的博客 795

S7-200SMART系列全套接线说明

SMART200接线方法,输入,输出,模拟量,面板,扩展糟等,并且详细说明接线原理。

文都龙哥 1万+

MinerU:免费开源文档解析神器,3分钟实现PDF转Markdown

你是否经常需要处理大量文档?PDF、Word、Excel、PPT等格式的文件转换是否让你头疼不已?MinerU是一款开源免费的高质量文档解析工具,能够将PDF、DOCX、PPTX、XLSX、图片等多种格式的文档智能转换为结构化的Markdown和JSON格式,为你的AI工作流提供强大的数据支持。 ## 为什么选择MinerU? 在文档处理领域,传统工具往往存在格式丢失、表格识别不准、公式转换困

gitblog_00804的博客 1075

Windows10内核逆向-2-KiSystemCall64的调用流程剖析

本文深入剖析了Windows 10 x64系统中KiSystemCall64函数的完整调用流程。从用户态触发syscall指令开始,详细讲解了如何通过swapgs切换内核栈、构建KTRAP_FRAME陷阱帧、进行SMAP/CFG等安全检查,到最终通过SSDT寻址并执行目标系统服务的全过程,揭示了系统调用从Ring 3到Ring 0切换的核心机制与安全设计。

weixin_29209805的博客 82

用易经智慧看懂人工智能:64卦中的科技密码--当古老智慧遇见未来科技

在人工智能狂飙突进的今天,我们总在追问:这些代码构建的智能究竟会带人类走向何方?或许答案早已藏在《周易》的六十四卦中——这本中华文明的“源代码”,正用一种跨越时空的语言,悄悄解释着最前沿的科技秘密。

weixin_38410320的博客 2084

MinerU API 实战指南:一条命令把 PDF 变成 Markdown,附批量解析避坑清单

MinerU 是一款开源文档解析工具,能把复杂的 PDF、扫描件和 Office 文档转成可直接喂给 LLM 的 Markdown 和结构化 JSON。它内置的 MinerU API 是一个 RESTful 文档解析接口:你用 HTTP 请求上传文件,它直接返回解析好的 Markdown、JSON 或压缩包,既适合批量 PDF 解析,也方便接进自己的后端服务。 ## 30 秒跑通 MinerU

gitblog_00840的博客 509

AI智能体丨使用Coze生成自媒体短视频分镜生成器(附保姆级教程)

【短视频分镜脚本生成器】是一款由Coze平台开发出来的智能体,可快速解析某音/某书视频或本地文件,自动生成专业分镜脚本。用户只需输入视频链接或上传文件,系统即会分析镜头节奏、叙事逻辑和画面内容,输出包含画面、模板和话术参考的标准化脚本(支持3分钟内视频)。该工具还能生成HTML网页和可下载图片,提供可视化呈现。工作流程包括视频解析、帧提取、AI画面理解、脚本生成和网页制作,大幅提升短视频创作效率。

李同学Lino的博客 1534

Mineru2.0基于华为昇腾 310 系列、910B系列本地化部署Mineru2.0开源项目

本文详细介绍了在华为昇腾NPU设备上部署Mineru项目的完整流程。首先需下载对应版本的华为镜像包,然后通过docker run命令运行容器并挂载必要的设备目录。部署过程中需注意安装指定版本的依赖库(如accelerate 0.25.0、torch-npu 2.1.0等),配置本地模型路径,并解决可能出现的依赖冲突问题。最后通过mineru-api命令启动服务,支持pipeline模式处理PDF文件解析。文章还提供了离线部署方案,可将配置好的容器打包为新镜像。测试时可通过curl发送PDF文件到指定端口进行

new_wugan的博客 4443

全新YOLO26有效涨点改进专栏目录 | 本专栏持续更新500+篇内容 | 包含各种卷积、主干网络、各种注意力机制、检测头、损失函数、小目标检测改进、二次创新模块、独家创新等几百种创新点改进

🔥《2026年YOLO26改进专栏》🔥 🚀持续更新500+最前沿创新改进点(顶会顶刊论文/独家创新策略),涵盖主干网络、各种卷积、注意力机制、检测头等模块,助力科研论文发表与模型性能提升,支持检测/分割/分类任务。订阅即获完整可运行项目,提供专业QQ答疑群,适合科研发论文(SCI/CCF/核心)及工业应用(PCB/医学/遥感检测)。专栏价格将逐步上涨,早订更优惠! ⭐特色:非计算机专业友好、模块可自由组合、全网独家创新;📌适用:研究生大论文和小论文创新、小目标检测、多领域科研应用,满足不同研究需求。

Ai缝合怪、助力小伙伴高效发论文 5129

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

MinerU API 实战指南:3 步启动、5 个场景把 PDF 批量解析搬进你的项目

MinerU 是一个把 PDF、图片、Office 文档转成 Markdown 与 JSON 的开源工具,配套的 MinerU API 让你用一条 curl 就能拿到解析结果。适合想把文档解析接进自己项目的开发者,本文只讲怎么跑起来、怎么配、怎么避坑。 ## 三步跑通服务 **第 1 步:安装。** 一条命令把 CLI 和 API 服务一起装上: ```bash pip install mi

gitblog_00614的博客 738

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

快速上手MinerU:一站式PDF转Markdown和JSON开源工具指南

MinerU是一款高质量的开源PDF转Markdown和JSON工具,专为文档解析和数据提取而设计。这个项目提供了完整的RESTful API接口,支持批量处理、多格式输出和灵活的配置选项,让文档处理变得更加简单高效。 ## 🚀 项目简介与核心价值 MinerU的核心优势在于其强大的文档解析能力和多格式输出支持。无论是学术论文、技术文档还是商业报告,MinerU都能准确提取文本、表格、公式和

gitblog_01180的博客 1144

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

MinerU开源模型落地指南:教育科技公司集成MinerU至在线阅卷系统OCR模块

本文介绍了如何在星图GPU平台上自动化部署MinerU智能文档理解服务镜像,实现教育阅卷系统中的高精度OCR识别。该镜像专精于文档场景,能高效处理手写文字、表格和数学公式的提取,显著提升在线阅卷的自动化水平和准确率。

weixin_35671843的博客 146

5款开源OCR工具对比:从学术文档到日常办公,哪款更适合你?

在数字化办公和学习中,快速将图片、PDF等文件中的文字提取为可编辑文本是高频需求。开源OCR工具凭借免费、灵活、可定制的优势,成为许多人的首选。今天为大家带来5款主流开源OCR工具的实测对比,他们是olmOCR、OCRmyPDF、MinerU、OmniAI/Zerox、Umi-OCR,总有一款帮你找到最趁手的“文字提取神器”!

zhulangfly的专栏 1万+

如何快速掌握MinerU API:PDF转Markdown的终极指南

在当今数字化时代,PDF转Markdown的需求日益增长,而MinerU作为一款高质量的开源工具,提供了强大的RESTful API接口,让文档转换变得简单高效。无论你是开发者、数据分析师还是内容创作者,掌握MinerU API都能大幅提升工作效率。 ## 为什么选择MinerU API? ### 传统文档转换的痛点 传统PDF转Markdown工具往往存在以下问题:格式错乱、表格识别不准确

gitblog_00801的博客 997

低成本实现智能OCR:MinerU开源模型部署实战指南

本文介绍了基于星图GPU平台自动化部署OpenDataLab MinerU 智能文档理解镜像的完整方案,实现无需编码的一键式本地化部署。该模型专精于学术论文解析、表格提取与图表理解,在CPU环境下即可完成高精度文档语义分析,适用于科研文献处理、财报识别等轻量级AI应用开发场景。

weixin_36122351的博客 958
下一篇: 本地部署Qwen2/2.5-VL和书生InternVL-2/3进行批量OCR
fdffsadf
博客等级 码龄6年 13粉丝 3原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值