【译】优化 clang 编译器的 mapping 函数

Mac平台MATLAB深度配置指南:从Apple Silicon适配到性能调优 科学计算与工程仿真领域的核心工具MATLAB,其高效运行依赖于与底层硬件和操作系统的深度协同。在macOS生态中,这一协同涉及编译器配置、环境变量管理及图形渲染优化等关键技术环节。对于工程师和科研工作者而言,理解MATLAB在Unix-like环境下的工作原理,能显著提升开发效率与计算性能。特别是在Apple Silicon(M系列芯片)架构逐步普及的当下,实现MATLAB的原生ARM64支持与性能调优,成为保障大规模数值计算、机器学习及图形处理流畅性的关键。本文聚焦于MATLAB在Mac平台的核心工作流搭 阅读详情

偶然发现一篇优化函数执行性能的文章,文章以 clang 里的 mapping 函数举例,但其优化思路以及举措可以通用到很多地方,非常值得一读,特此借翻译此文也加深自己的理解。

内容来源: https://developers.redhat.com/blog/2021/05/04/optimizing-the-clang-compilers-line-to-offset-mapping/
原文标题:Optimizing the Clang compiler’s line-to-offset mapping
作者: Serge Guelton
译者:流左沙
注:翻译较原文会有一定的精简、重排和添删,主要是为了提取重要内容以达到更好的理解,请以原文为准。

在用 profile 对 clang 编译器本身进行速度优化的时候,发现有一个函数相当地突出:

clang::LineOffsetMapping::get(llvm::MemoryBufferRef Buffer, llvm::BumpPtrAllocator &Alloc)

这个函数的逻辑就是分配一个容器(通过形参变量 Alloc 分配)来将行号跟文件内容的偏移量做映射(加载了文件内容的形参变量 Buffer)。

即 vector[行号] = 偏移量

这个函数逻辑比较独立,可以很好地去做 benchmark 基准测试。

The problem, and the naive implementation

std::vector<unsigned> LineOffsets;
LineOffsets.push_back(0);

const unsigned char *Buf = (const unsigned char *)Buffer.data();
const std::size_t BufLen = Buffer.size();

unsigned I = 0;
while (I < BufLen) {
  if (Buf[I] == '\n') {
    LineOffsets.push_back(I + 1);
  } else if (Buf[I] == '\r') {
    // If this is \r\n, skip both characters.
    if (I + 1 < BufLen && Buf[I + 1] == '\n')
      ++I;
    LineOffsets.push_back(I + 1);
  }
  ++I;
}

大概操作就是:当读到行分隔符 \n 或 \r\n 时,就进行存储 vector[行号] = 偏移量

Manual profile-guided optimization

因为读入 Buffer 的文件内容其实就是源代码,所以字符是新行或非新行的比率就可以当作优化指标了。

$ find llvm -name '*.cpp' -exec cat {} \; | tr -cd '\n' | wc -c
2130902
$ find llvm -name '*.cpp' -exec cat {} \; | wc -c
78537977

只有大概 2% 左右的新行占比。

那么根据这个比率,我们可以使用 gcc 的 __builtin_expect(expression, value) 来进行优化,这个函数的作用是允许程序员将最有可能执行的分支告诉编译器。【参考博文:https://www.jianshu.com/p/2684613a300f】

将流水线引入 CPU,可以提高 CPU 的效率。更简单的说,让 CPU 可以预先取出下一条指令,可以提供 CPU 的效率。如果存在跳转指令,那么预先取出的指令就无用了。CPU 在执行当前指令时,从内存中取出了当前指令的下一条指令。执行完当前指令后,CPU 发现不是要执行下一条指令,而是执行 offset 偏移处的指令。CPU 只能重新从内存中取出 offset 偏移处的指令。因此,跳转指令会降低流水线的效率,也就是降低 CPU 的效率。 【参考博文: https://blog.youkuaiyun.com/shuimuniao/article/details/8017971】

意思是 expression == value 的概率很大,编译器拿到这个信息(分支转移的信息)之后,在编译过程会将可能性更大的代码紧接在其后,从而减少指令跳转带来的性能损耗。

值得一提的是 c++20 的 likely 和 unlikely 与此殊途同归。

继续回到我们的优化,因为 \n 和 \r 在 ASCII 表中,位于这两个符号中间的那些都不常见,是垂直制表符和换页符,所以我们能够做一个快速的判断逻辑。【\n 是换行且使光标到行首;\r 是回车且使光标下移一格】
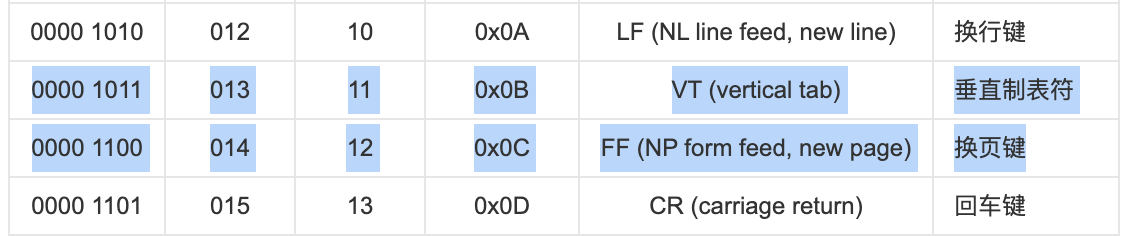
unsigned I = 0;
while (I < BufLen) {
  // Use a fast check to catch both newlines
  if (__builtin_expect((Buf[I] - '\n') <= ('\r' - '\n'), 0)) {
    if (Buf[I] == '\n') {
      LineOffsets.push_back(I + 1);
    } else if (Buf[I] == '\r') {
      if (I + 1 < BufLen && Buf[I + 1] == '\n')
        ++I;
      LineOffsets.push_back(I + 1);
    }
  }
  ++I;
}

注意,这里的快速判断逻辑不能改为看似等价的 Buf[I] <= '\r' 。因为 tab 键就符合这个错误的判断逻辑。

Adding a fast path

我们可以调整算法来做 \r 字符的快速扫描,如果没有的话就进入快速通道。如果有则走正常的之前的逻辑。

if(!memchr(Buf, '\r', BufLen)) {
  while (I < BufLen) {
    if (__builtin_expect(Buf[I] == '\n', 0)) {
      LineOffsets.push_back(I + 1);
    }
    ++I;
  }
}
else {
// one of the version above... or below
}

Looking through history

clang 源码包含有一个优化点:clang::LineOffsetMapping::get 曾经有过一个 SSE 的版本,但之后为了可维护性在之后版本 d906e731 又被去掉了。

那个 SSE 版本在 aligned load (对齐加载) 费尽心思,但对于旧的架构而言是一个很重要的优化点。从那之后,unaligned loads (非对齐加载) 在一些现代英特尔架构的开销已经下降了很多,所以我们可以尝试写一个新的 SSE 版本,同时它会是很容易去理解和维护的:

【解释下这两个 SSE 操作:【参考 https://stackoverflow.com/a/15964428/13005964 】

如果你知道你的源地址是正常对齐的,那么使用对齐加载 (aligned load) 可以更加高效地读取,因为它只需要一次的读操作,而不需要去处理几块不对齐的数据。

现代 CPU 对于对齐数据 (aligned data)进行这两个操作的开销差异已经不大了,但如果对于不对齐数据 (misaligned data) 进行对齐加载 (aligned load) 会引发异常。】

#include <emmintrin.h>

// Some renaming to help the reader not familiar with SSE
#define VBROADCAST(v) _mm_set1_epi8(v)
#define VLOAD(v) _mm_loadu_si128((const __m128i*)(v))
#define VOR(x, y) _mm_or_si128(x, y)
#define VEQ(x, y) _mm_cmpeq_epi8(x, y)
#define VMOVEMASK(v) _mm_movemask_epi8(v)

const auto LFs = VBROADCAST('\n');
const auto CRs = VBROADCAST('\r');

while (I + sizeof(LFs) + 1 < BufLen) {
  auto Chunk1 = VLOAD(Buf + I);
  auto Cmp1 = VOR(VEQ(Chunk1, LFs), VEQ(Chunk1, CRs));
  unsigned Mask = VMOVEMASK(Cmp1) ;

  if(Mask) {
    unsigned N = __builtin_ctz(Mask);
    I += N;
    I += ((Buf[I] == '\r') && (Buf[I + 1] == '\n'))? 2 : 1;
    LineOffsets.push_back(I);
  }
  else
    I += sizeof(LFs);
}

除了添加 SSE 的操作,还使用了内置函数 __builtin_ctz 去计算一个数末尾 0 的数量,这样可以直接就操作到要匹配的字符的位置。

因为我们知道要匹配的字符要么是 \r,要么是 \n,所以可以避免一些比较,直接用一行像 x86 的有状态 mov 的代码去操作要偏移的位置(这里指的是第 21 行)。

Bit hacks

接下来尝试看下 memchr 函数在 glibc 上的实现,它使用了类似向量化的操作,但有不少的兼容性问题,一般称之为 multibyte word packing (多字节压缩)。

位操作的爱好者知晓 Hacker's Delight 和他的好朋友 Bit Twiddling Hacks。他们包含有对于多字节的很多有用的操作,包括如何确定一个字 (word) 是否有在 m 到 n 区间范围内的字节 (byte)。

template <class T>
static constexpr inline T likelyhasbetween(T x, unsigned char m,
unsigned char n) {
// see http://graphics.stanford.edu/~seander/bithacks.html#HasBetweenInWord
  return (((x) - ~static_cast<T>(0) / 255 * (n)) & ~(x) &
          ((x) & ~static_cast<T>(0) / 255 * 127) + ~static_cast<T>(0) / 255 * (127 - (m))) &  
          ~static_cast<T>(0) / 255 * 128;
}

uint64_t Word;

// scan sizeof(Word) bytes at a time for new lines.
// This is much faster than scanning each byte independently.
if (BufLen > sizeof(Word)) {
  do {
    memcpy(&Word, Buf + I, sizeof(Word));
#if defined(BYTE_ORDER) && defined(BIG_ENDIAN) && BYTE_ORDER == BIG_ENDIAN
    Word = __builtin_bswap64(Word); // some endianness love
#endif

    // no new line => jump over sizeof(Word) bytes.
    auto Mask = likelyhasbetween(Word, '\n' - 1, '\r'+1 );
    if (!Mask) {
      I += sizeof(Word);
      continue;
    }

    // Otherwise scan for the next newline - it's very likely there's one.
    // Note that according to
    // http://graphics.stanford.edu/~seander/bithacks.html#HasBetweenInWord,
    // likelyhasbetween may have false positive for the upper bound.
    unsigned N = __builtin_ctzl(Mask) - 7;
    Word >>= N;
    I += N / 8 + 1;
    unsigned char Byte = Word;
    if (Byte == '\n') {
      LineOffsets.push_back(I);
    } else if (Byte == '\r') {
      // If this is \r\n, skip both characters.
      if (Buf[I] == '\n')
        ++I;
      LineOffsets.push_back(I);
    }
  }
  while (I < BufLen - sizeof(Word) - 1);
}

这代码有点长,而且依赖了 likelyhasbetween 函数中没被记载的特性:它设置比特来持有要搜索的值 0x80。

我们可以用这个 mask (掩码) 和内置函数 __builtin_ctzl 来匹配到正确的位置。

Crunching numbers

我把各种各样的实现都放到了一个仓库里了,里面还有一些测试来验证效果,使用 SQLite amalgamation 作为输入。

这是我笔记本电脑的效果,Core i7-8650U and gcc 8.2.1 (timing in milliseconds, average on 100 runs):

ref: 11.37
seq: 11.12
seq_memchr: 6.53
bithack: 4
bithack_scan: 4.78
sse_align: 5.08
sse: 3
sse_memchr: 3.7

ref 是参考的版本,作为对照。

使用 pgo 方式的 seq 只有少量提升。

快速通道的方式 seq_memchr提升效果比较明显。

位操作的两个版本几乎和 SSE 一样快,使用了快速通道的 SSE 版本反而适得其反。

在其他平台结果还不太一样,On a Mac Mini (on arm64), using the Apple clang version 12.0.0:

ref: 6.49
seq: 4
seq_memchr: 4
bithack: 2
bithack_scan: 2.05

Conclusion

最终我提交了位操作的版本给 LLVM。所以它没有 SSE 的表现效果好,但合入方强调了对于未知架构都能优于当前版本的好处,位操作会更加符合。

想了解更多 clang 和 LLVM 后端的内容,可以在这里查看:Red Hat Developer topic page。

C++单元测试覆盖率统计实战:基于gtest与gcov/llvm-cov的完整指南 单元测试覆盖率是衡量软件测试完备性的关键指标,它通过代码插桩技术,在测试执行过程中记录哪些代码行、分支和函数被实际执行,从而生成量化的覆盖报告。其技术价值在于为开发团队提供客观的代码质量度量,精准定位测试盲区,尤其在资源管理、多线程和异常安全要求极高的C++系统开发中,能有效提升软件的健壮性。典型的应用场景包括持续集成流水线、代码审查和重构保障。本文聚焦于C++项目,详细解析如何高效整合Google Test框架与覆盖率工具链,并针对**gcov**与**llvm-cov**两套主流方案,提供从编译插桩、C 阅读详情

相关推荐

【信息科学与工程学】计算机科学与自动化——第二十四篇 编译器10——编译原理与词法分析02

链接时优化:全局DCE(579)、LTO(580)安全编译:CFI(581、586)、ASan(582)、UBSan(583)、MSan(584)、TSan(585)、CET(587)、PAC(588)、MTE(589)、SFI(590)、Wasm沙箱(591)侧信道与秘密:侧信道缓解(592)、常量时间(593)、秘密清理(594)内存安全:ASLR(595)、栈保护(596)、整数溢出检测(597)、除零检测(598)、空指针检测(599)、数组边界检查(600)至此编号达到600。

weixin_49199313的博客 194

C1/基本概念:映射(mapping),函数(function),算子(operator)等等...

映射/函数/算子/… C1 目录: 1. 映射 mapping 映射就是将两个对象对应起来。对应的对象叫象; 被对应的对象叫原象。 映射是:集合 和 集合 之间的一种关系。 2. 函数 Function 函数是一种特殊的映射。是从 数集 到 数集 的映射。 3. 算子 Operator 英语的算子是Operator,含义为操作、运算等等。 算子可以理解为,把一个函数变成另一个函数的东西。 函数是从数到数的映射。 泛函是从函数到数的映射。 ...

大厂offer宝典 1万+

RAG——从0到1快速搭建RAG应用

本文介绍了基于LangChain框架构建RAG(检索增强生成)应用的技术方案,涵盖核心模块选型与实现流程。技术栈包括:LangChain应用框架、pypdf文档解析、RecursiveCharacterTextSplitter文本分块、bge-small-zh-v1.5向量模型、Faiss向量库和通义千问大模型。文章详细说明了开发环境配置步骤,包括虚拟环境创建、依赖库安装和模型下载。核心代码分为索引、检索、生成三大流程,索引流程完成PDF文档解析、分块和向量化存储;检索流程实现查询向量化和相似度匹配;生成流

小志的博客 590

GCC/CLANG likely\unlikely 宏定义实现。

(x), 1)!(x), 0)

liulilittle的博客 123

泰山派RK3576开发板部署Qwen3-VL-4B多模态模型实战指南:从模型转换到板端推理全流程

本文提供了在泰山派RK3576开发板上部署阿里Qwen3-VL-4B多模态模型的完整实战指南。详细介绍了从环境准备、模型转换(包括视觉模型转换为.rknn格式和语言模型转换为.rkllm格式)、交叉编译到板端推理的全流程,重点讲解了如何利用RK3576的NPU进行硬件加速,实现高效的边缘AI应用。

weixin_30356433的博客 257

FDTD仿真实战:从材料导入到反射率曲线分析

本文提供了一份完整的FDTD仿真实战指南,详细讲解了从自定义材料(如WO3)数据导入、结构建模、仿真区域与网格设置,到光源与监视器配置、运行仿真并提取反射率数据的全流程。重点解决了材料库缺失、网格优化、边界条件设置等常见难题,旨在帮助研究人员高效、准确地通过FDTD仿真获取材料的关键光学特性——反射率曲线。

elastic6hunter的博客 341

什么是映射函数(核函数)?

映射函数是连接原始数据空间与高维特征空间的桥梁,它允许我们在高维空间中进行更复杂的模式识别和分类任务,而核技巧则提供了一种计算高效的方式来实现这一点。

... 2365

知识图谱(Knowledge Graph)原理与代码实战案例讲解

知识图谱(Knowledge Graph)原理与代码实战案例讲解 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming 1. 背景介绍 1.1 问题的由来

AI天才研究院 1077

CreateFileMapping函数

为指定文件创建或打开命名或未命名的文件映射对象。 要为物理内存指定NUMA节点,请参阅CreateFileMappingNuma。 语法 HANDLE WINAPI CreateFileMapping( _In_ HANDLE hFile, _In_opt_ LPSECURITY_ATTRIBUTES lpAttributes, _In_ DWORD flProtect, ...

xinqingwuji的博客 6942

044.树莓派4B部署YOLO:从系统烧录到模型运行

《树莓派4B部署YOLOv8实战笔记》摘要:本文详细记录了在ARM架构树莓派4B上部署YOLOv8的全流程。关键点包括:必须使用64位系统并手动编译OpenCV(禁用FFMPEG、开启NEON优化);模型需在x86转换为TFLite格式(分辨率不超过320×320);推理代码使用tflite_runtime替代TensorFlow以减少内存占用;针对USB摄像头卡顿、内存泄漏等典型问题给出了解决方案。

2603_95664987的博客 169

【25届数字IC秋招总结】面试经验6——经纬恒润

25届数字ic面试记录——经纬恒润

lalala0635的博客 991

python中mapping_python-学习-ORM中遇到的 mapping 详解并再总结字典dict

python里的字典dict(mapping)如何使用Python字典的构造函数有三个,dict()、dict(**args)、dict(mapping),其中第一个、第二个构造函数比较好理解也比较容易使用,而dict(mapping)这个构造函数的使用比较难理解。1. dict()构造函数可以返回一个空的字典In [7]: d = dict()In [8]: print (d){}2. dic...

weixin_39935092的博客 5058

基于Simulink的电力电子负载特性模拟仿真实例

电阻性负载是最简单的负载形式,其阻抗为纯电阻,电流和电压之间的关系符合欧姆定律。电阻性负载的特点是消耗能量,不会存储能量。本示例将以一个典型的直流电源供电系统为例,展示如何利用Simulink进行不同负载特性的仿真模拟。直流电源:提供固定电压输入。逆变器(可选):根据需要产生PWM调制信号,驱动负载。负载模块:模拟不同类型的负载特性,如电阻性负载、电感性负载和容性负载。测量模块:用于观察负载上的电压和电流波形。系统架构视图plaintext深色版本v| || |

xiaoheshang_123的博客 429

LLVM IR学习路径快速上手:mapping-high-level-constructs-to-llvm-ir中5个必备工具(clang/opt/llvm-dis/llc)使用教程

**mapping-high-level-constructs-to-llvm-ir** 是一本开源的 LLVM IR 学习教程,它系统解释了 C/C++ 等高层语言的构造(变量、结构体、类、异常、Lambda)是如何一步步映射到 LLVM 中间表示(IR)中的。本文提炼出书中推荐的 **5 个必备 LLVM IR 工具**:`clang`、`clang++`、`opt`、`llvm-dis`、`

gitblog_01128的博客 766

SOUL.md 人格定制的 7 个高阶技巧:Hermes Agent 精准控制 AI 行为模式

揭示 SOUL.md 的本质是行为契约而非人格设定,介绍7个围绕边界约束的高阶技巧,包括用上下文锚点(INPUT SCOPE/OUTPUT TARGET/CONSTRAINTS)替代角色描述、动态渲染锚点适配CI流程等,显著降低token消耗与人工review耗时。

weixin_42520239的博客 251

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

编译器 | 从工业实现到极简设计 —— 编译器的多元形态与实践

……

u013669912的博客 887

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

UE5引擎源码级代码覆盖率分析:基于Clang/LLVM的完整实践指南

代码覆盖率是衡量软件测试完备性的关键指标,它通过插桩技术统计测试过程中代码的执行情况,帮助开发者识别未覆盖的代码路径。其核心原理是在编译阶段向源代码中插入计数器,运行时收集数据并映射回源码位置,从而生成可视化报告。在大型C++项目如游戏引擎开发中,源码级覆盖率分析对于保障代码质量、发现测试盲区具有重要价值。Clang/LLVM工具链凭借其现代化的架构和对复杂C++语法的良好支持,提供了稳定可靠的插桩方案。通过配置UnrealBuildTool使用clang-cl编译器,并添加-fprofile-instr-

weixin_30387423的博客 448

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

基于Clang LibTooling的IDA Pro代码移植工具设计与实现

在软件逆向工程领域,代码复用与移植是提升工程效率的关键。传统上,深度依赖特定框架(如IDA Pro SDK)的分析脚本难以脱离原环境运行,导致算法逻辑被平台锁定。通过抽象语法树(AST)分析与源码到源码的转换技术,可以实现代码逻辑与执行环境的解耦。Clang LibTooling作为LLVM生态的核心组件,提供了精准的C/C++源码解析与重构能力,能够将平台相关的类型系统和API调用映射为标准实现。这种技术方案不仅解决了逆向工程代码的移植难题,还为构建自动化分析流水线、独立服务部署和跨平台工具链提供了基础。

weixin_30319153的博客 273

Sourcetrail如何利用Clang AST与预处理器实现C/C++代码精准索引

在大型C/C++项目开发中,代码导航与理解是核心挑战。抽象语法树作为编译器理解代码结构的基础,能够将源代码转换为树状数据结构,精确反映语法和语义关系。其原理是通过词法分析、语法分析构建节点,表达程序元素间的层次与关联。这一技术的价值在于为代码分析、重构和可视化提供了结构化基础。在工程实践中,结合预处理器处理宏展开和条件编译,能确保索引结果与编译器视角完全一致。本文以Sourcetrail为例,深入解析其如何集成Clang AST解析器与预处理器,构建准确的代码知识图谱,解决大型项目中函数定位、类继承关系可视

weixin_30387799的博客 342

LLVM独立工具链实战:从编译优化到性能调优

编译器技术是现代软件开发的核心基础设施,其中LLVM以其模块化架构成为行业标准。通过将编译流程分解为前端、优化器、后端等独立阶段,LLVM工具链允许开发者像手术刀般精准控制每个环节。核心工具如clang(源码转IR)、opt(IR优化)、llc(机器码生成)构成完整工具链,配合llvm-objdump等分析工具,能显著提升嵌入式开发、性能调优等场景的效率。在工程实践中,LLVM独立工具特别适用于需要深度优化机器码的嵌入式系统开发,以及需要精细控制编译流程的高性能计算场景。通过掌握工具链的版本管理、跨平台编译

weixin_34253126的博客 449

LLVM学习日志13——add intrinsics mapping the new instruction

如题,增加新的指令应该是我最终的目标。有两个方式来实现这个目标,一个是增加通用的DAG,这样所有的ISA都会增加上这条指令,但是比较难,因为DAG有合法化、简化什么的,比较难。所以我选择第二条,就是为某一个特定的ISA增加一个内联函数(intrinsics ),通过这个内联函数来链接到新的指令。 首先,和增加伪指令一样,在clang中增加一条intrinsic function。具体就不写了。有...

tristan_tian的博客 1620

gbrain 私有仓库持久化:GITHUB.md 模板与 `sources push` 的秘密扫描备份契约

`templates/bootstrap/template-repo/GITHUB.md` 是 gbrain bootstrap 为每个 Agent 工作区预置的「持久化契约」文件:它规定了什么内容可以进入私有仓库、什么内容永远只留在本机、以及每次备份必须通过哪些安全闸门。本文结合该模板文件与 gbrain 源码(`src/core/workspace-push.ts`、`src/commands

gitblog_01155的博客 706

Nimcrypt2避坑指南:解决常见编译错误与Obfuscator-LLVM配置问题

Nimcrypt2是一款功能强大的.NET、PE及原始Shellcode打包器/加载器,采用Nim语言编写。本文将为新手用户提供实用的避坑指南,帮助您解决Nimcrypt2使用过程中常见的编译错误与Obfuscator-LLVM配置问题,让您的开发过程更加顺畅。 ## 一、Nimcrypt2编译常见错误及解决方法 ### 1.1 "Stub compilation failed! Check

gitblog_00723的博客 664

Cocos2d-x Lua绑定参数类型不匹配:原理、调试与解决方案

在游戏开发中,脚本语言与底层引擎的交互是核心技术环节。Lua与C++的绑定机制通过自动生成胶水代码,实现了高性能引擎与灵活脚本的桥接。其核心原理涉及抽象语法树解析、类型映射和栈数据转换,确保了两种语言间的数据传递与函数调用。这一技术的价值在于显著提升开发效率,允许开发者用Lua快速迭代逻辑,同时保持C++的运行时性能。在Cocos2d-x等游戏框架中,该技术被广泛应用于UI逻辑、游戏玩法模块和资源管理。然而,在自动化绑定生成过程中,常会遇到参数类型不匹配的棘手问题,例如基础类型映射偏差或自定义类型处理错误,

aodanchui1057的博客 396

LLVM代码覆盖率实战:从编译到报告生成的完整流程(附常见问题排查)

本文详细介绍了使用LLVM进行代码覆盖率分析的完整实战流程,涵盖从环境准备、编译插桩、运行测试到生成可视化报告的各个环节。重点解析了核心编译参数、数据合并方法以及HTML报告的生成技巧,并针对实际工作中常见的.profraw文件未生成、报告数据不匹配等问题提供了排查思路与解决方案,帮助开发者高效利用LLVM工具链提升软件测试质量。

hadoop5ranger的博客 696

MLIR生产化、C++26 ABI绑定与ThinLTO强制化:LLVMCon 2025三大工程拐点

MLIR已从研究型中间表示演进为芯片级AI编译基础设施,其分层Dialect设计、可组合Pass机制和细粒度副作用建模(如SideEffectResource)显著提升编译效率与错误定位能力;与此同时,Clang对C++26的支持转向ABI原子性绑定,放弃渐进式feature flag,强制耦合libc++26以保障二进制兼容性;而LTO架构完成分布式重构,ThinLTO成为链接时IR拓扑分析的强制前置阶段,并引入跨云缓存一致性协议。这三大动向共同指向一个事实:现代编译器基础设施正从‘功能可用’全面迈入‘工

civtsbiqr522632413的博客 409
上一篇: 《go 语言圣经》笔记
下一篇: CPU 分支预测探索与利用
流左沙
博客等级 码龄11年 46粉丝 55原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值