


Prometheus AlertManager
在Prometheus的报警系统中,是分为2个部分的, 规则是配置在prometheus中的, prometheus组件完成报警推送给alertmanager的, alertmanager然后管理这些报警信息,包括静默、抑制、聚合和通过电子邮件、on-call通知系统和聊天平台等方法发送通知。
Alertmanager配置文件详解
global:
  # 经过此时间后,如果尚未更新告警,则将告警声明为已恢复。(即prometheus没有向alertmanager发送告警了)
  resolve_timeout: 5m
  # 配置发送邮件信息
  smtp_smarthost: 'smtp.qq.com:465'
  smtp_from: 'QQ号@qq.com'
  smtp_auth_username: 'QQ号@qq.com'
  smtp_auth_password: 'QQ邮箱POP3/SMTP服务'
  smtp_require_tls: false

# 读取告警通知模板的目录。
templates:
- '/etc/alertmanager/template/*.tmpl'

# 所有报警都会进入到这个根路由下,可以根据根路由下的子路由设置报警分发策略
route:
  # 先解释一下分组,分组就是将多条告警信息聚合成一条发送,这样就不会收到连续的报警了。
  # 将传入的告警按标签分组(标签在prometheus中的rules中定义),例如:
  # 接收到的告警信息里面有许多具有cluster=A 和 alertname=LatencyHigh的标签,这些个告警将被分为一个组。
  #
  # 如果不想使用分组,可以这样写group_by: [...]
  group_by: ['alertname', 'cluster', 'service']

  # 第一组告警发送通知需要等待的时间,这种方式可以确保有足够的时间为同一分组获取多个告警,然后一起触发这个告警信息。
  group_wait: 30s

  # 发送第一个告警后,等待"group_interval"发送一组新告警。
  group_interval: 5m

  # 分组内发送相同告警的时间间隔。这里的配置是每3小时发送告警到分组中。举个例子:收到告警后,一个分组被创建,等待5分钟发送组内告警,如果后续组内的告警信息相同,这些告警会在3小时后发送,但是3小时内这些告警不会被发送。
  repeat_interval: 3h

  # 这里先说一下,告警发送是需要指定接收器的,接收器在receivers中配置,接收器可以是email、webhook、pagerduty、wechat等等。一个接收器可以有多种发送方式。
  # 指定默认的接收器
  receiver: team-X-mails


  # 下面配置的是子路由,子路由的属性继承于根路由(即上面的配置),在子路由中可以覆盖根路由的配置

  # 下面是子路由的配置
  routes:
  # 使用正则的方式匹配告警标签
  - match_re:
      # 这里可以匹配出标签含有service=foo1或service=foo2或service=baz的告警
      service: ^(foo1|foo2|baz)$
    # 指定接收器为team-X-mails
    receiver: team-X-mails
    # 这里配置的是子路由的子路由,当满足父路由的的匹配时,这条子路由会进一步匹配出severity=critical的告警,并使用team-X-pager接收器发送告警,没有匹配到的告警会由父路由进行处理。
    routes:
    - match:
        severity: critical
      receiver: team-X-pager

  # 这里也是一条子路由,会匹配出标签含有service=files的告警,并使用team-Y-mails接收器发送告警
  - match:
      service: files
    receiver: team-Y-mails
    # 这里配置的是子路由的子路由,当满足父路由的的匹配时,这条子路由会进一步匹配出severity=critical的告警,并使用team-Y-pager接收器发送告警,没有匹配到的会由父路由进行处理。
    routes:
    - match:
        severity: critical
      receiver: team-Y-pager

  # 该路由处理来自数据库服务的所有警报。如果没有团队来处理,则默认为数据库团队。
  - match:
      # 首先匹配标签service=database
      service: database
    # 指定接收器
    receiver: team-DB-pager
    # 根据受影响的数据库对告警进行分组
    group_by: [alertname, cluster, database]
    routes:
    - match:
        owner: team-X
      receiver: team-X-pager
      # 告警是否继续匹配后续的同级路由节点,默认false,下面如果也可以匹配成功,会向两种接收器都发送告警信息(猜测。。。)
      continue: true
    - match:
        owner: team-Y
      receiver: team-Y-pager


# 下面是关于inhibit(抑制)的配置,先说一下抑制是什么:抑制规则允许在另一个警报正在触发的情况下使一组告警静音。其实可以理解为告警依赖。比如一台数据库服务器掉电了,会导致db监控告警、网络告警等等,可以配置抑制规则如果服务器本身down了,那么其他的报警就不会被发送出来。

inhibit_rules:
#下面配置的含义:当有多条告警在告警组里时,并且他们的标签alertname,cluster,service都相等,如果severity: 'critical'的告警产生了,那么就会抑制severity: 'warning'的告警。
- source_match:  # 源告警(我理解是根据这个报警来抑制target_match中匹配的告警)
    severity: 'critical' # 标签匹配满足severity=critical的告警作为源告警
  target_match:  # 目标告警(被抑制的告警)
    severity: 'warning'  # 告警必须满足标签匹配severity=warning才会被抑制。
  equal: ['alertname', 'cluster', 'service']  # 必须在源告警和目标告警中具有相等值的标签才能使抑制生效。(即源告警和目标告警中这三个标签的值相等'alertname', 'cluster', 'service')


# 下面配置的是接收器
receivers:
# 接收器的名称、通过邮件的方式发送、
- name: 'team-X-mails'
  email_configs:
    # 发送给哪些人
  - to: 'team-X+alerts@example.org'
    # 是否通知已解决的警报
    send_resolved: true

# 接收器的名称、通过邮件和pagerduty的方式发送、发送给哪些人,指定pagerduty的service_key
- name: 'team-X-pager'
  email_configs:
  - to: 'team-X+alerts-critical@example.org'
  pagerduty_configs:
  - service_key: <team-X-key>

# 接收器的名称、通过邮件的方式发送、发送给哪些人
- name: 'team-Y-mails'
  email_configs:
  - to: 'team-Y+alerts@example.org'

# 接收器的名称、通过pagerduty的方式发送、指定pagerduty的service_key
- name: 'team-Y-pager'
  pagerduty_configs:
  - service_key: <team-Y-key>

# 一个接收器配置多种发送方式
- name: 'ops'
  webhook_configs:
  - url: 'http://prometheus-webhook-dingtalk.kube-ops.svc.cluster.local:8060/dingtalk/webhook1/send'
    send_resolved: true
  email_configs:
  - to: 'QQ号@qq.com'
    send_resolved: true
  - to: 'soulchild@soulchild.cn'
    send_resolved: true
部署步骤
- 安装和部署alertmanager
- 在prometheus中配置alertmanager的地址信息。
- 在prometheus中设置报警规则
- 在alertmanager配置接受者信息等
部署过程
安装alertmanage
到prometheus官网下载alertmanage包,可以装在prometheus-server,也可以装在另一台服务器上
#先上传alertmanage包
#解包
tar zxvf alertmanager-0.25.0.linux-amd64.tar.gz

#移动到prometheus目录
mv alertmanager-0.25.0.linux-amd64 /usr/local/prometheus/alertmanager

#编写启动文件
vim /usr/lib/systemd/system/alertmanager.service

#添加
[Unit]
Description=alertmanager
Documentation=https://prometheus.io/
After=network.target

[Service]
User=prometheus
Group=prometheus
ExecStart=/usr/local/prometheus/alertmanager/alertmanager --config.file=/usr/local/prometheus/alertmanager/alertmanager.yml --storage.path=/usr/local/prometheus/alertmanager/data
Restart=on-failure

[Install]
WantedBy=multi-user.target

#如果是新服务器,则需要创建prometheus用户
useradd -M -s /sbin/nologin prometheus

#更改属主属组
chown -R prometheus:prometheus /usr/local/prometheus/

#开启alertmanager并添加开机自启动
systemctl start alertmanager.service
systemctl enable alertmanager.service
在prometheus上集成alertmanage
#修改配置文件
vim /usr/local/prometheus/prometheus.yml

#在alerting中添加alertmanager服务器
#配置完成后重启prometheus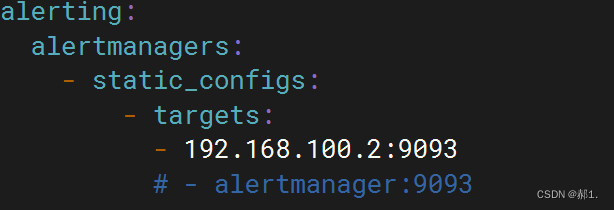
浏览器访问 IP:9093
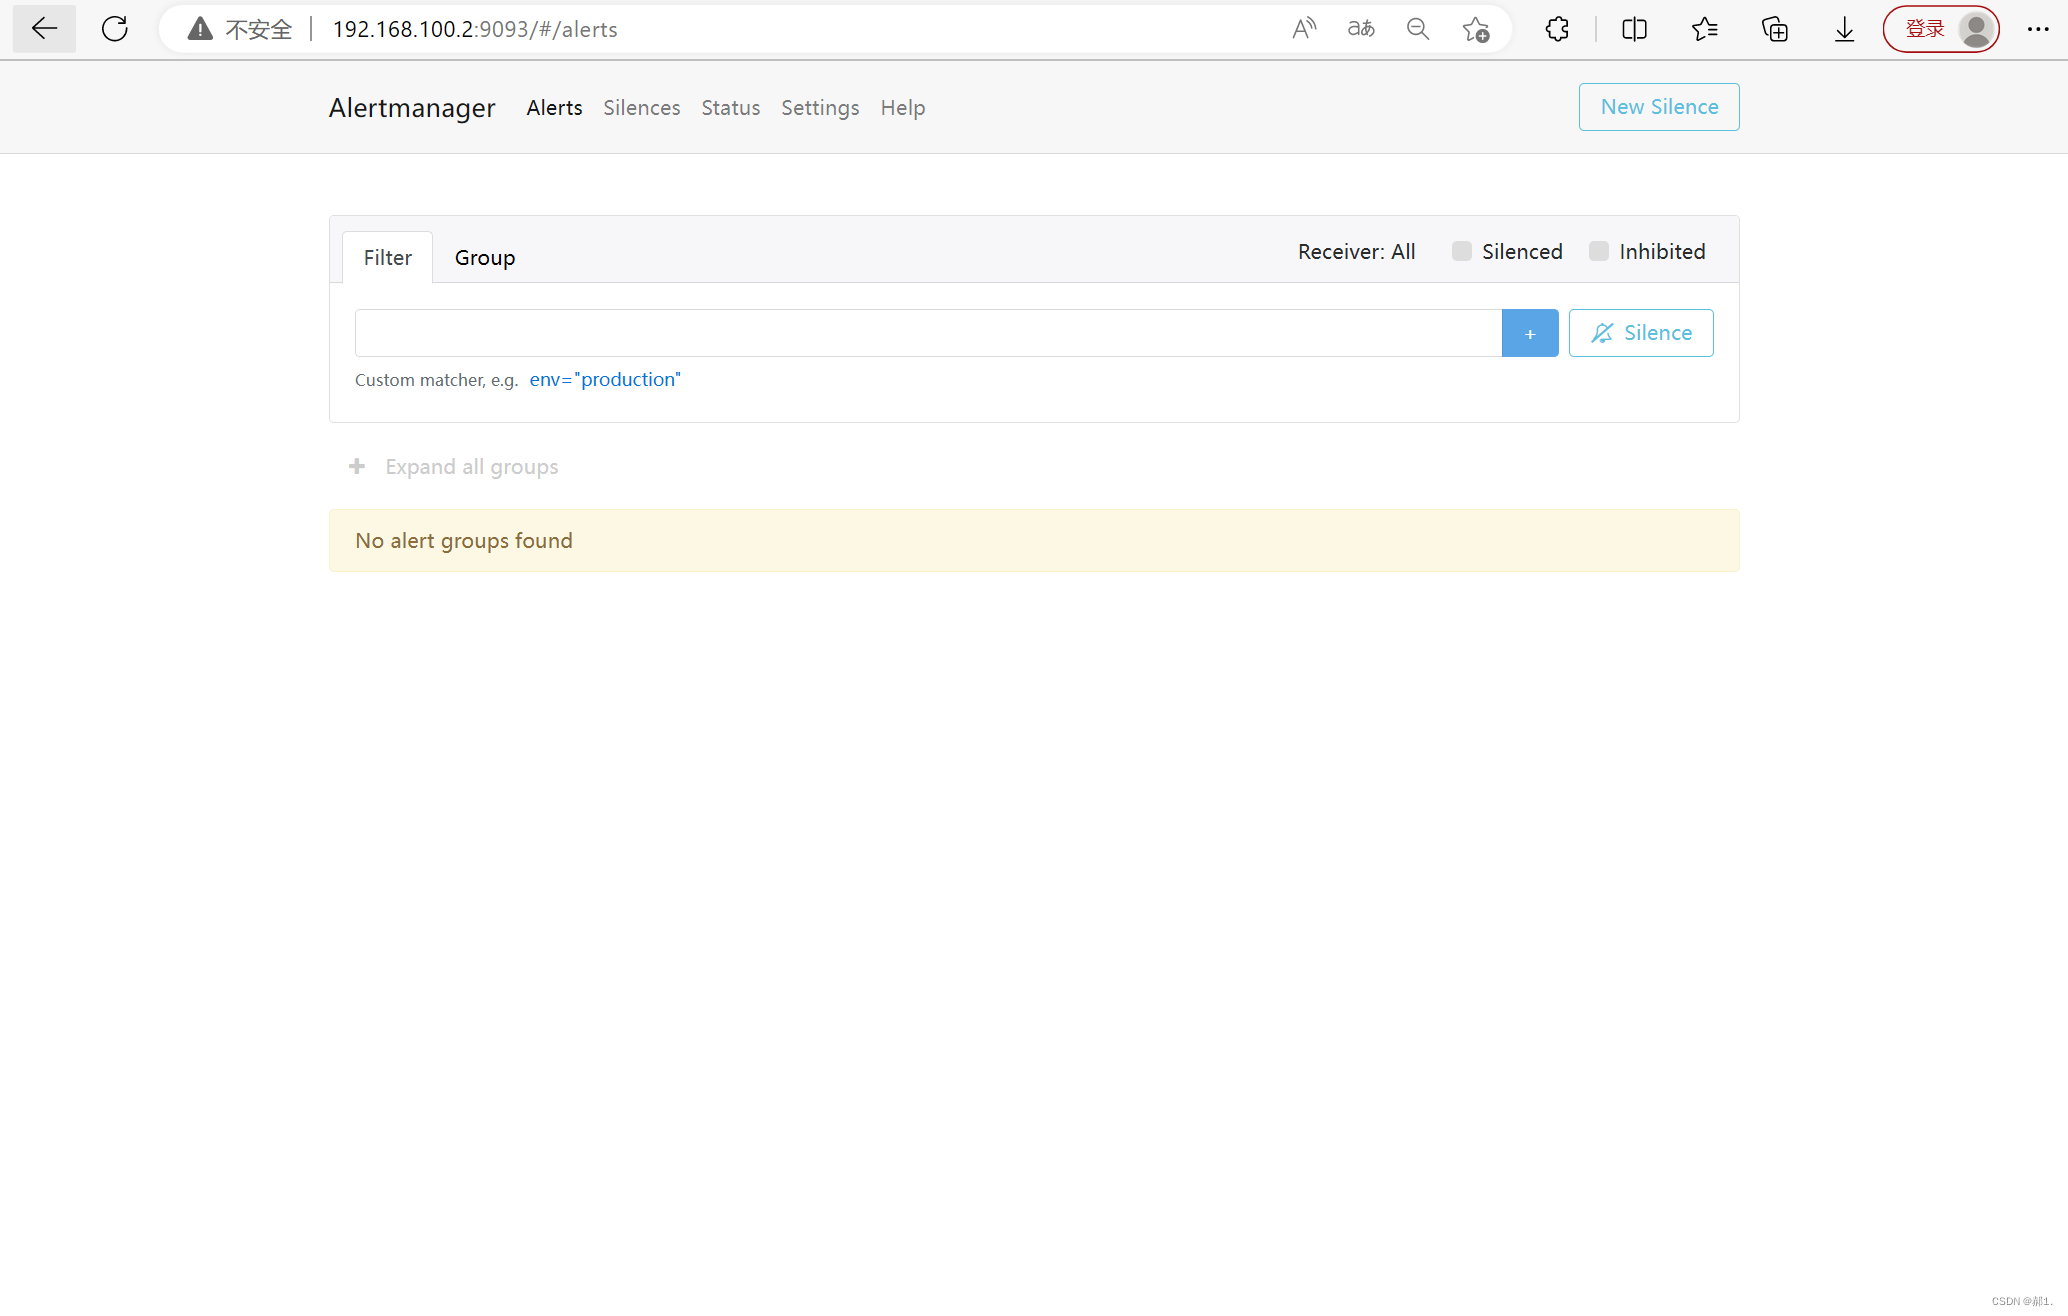
创建告警规则
#修改主配置文件
vim /usr/local/prometheus/prometheus.yml

#在rule_files区域添加
rule_files:
  - "rules/*rules.yml"

#创建目录
mkdir rules

#编写告警文件
vim /usr/local/prometheus/rules/node_rules_yml

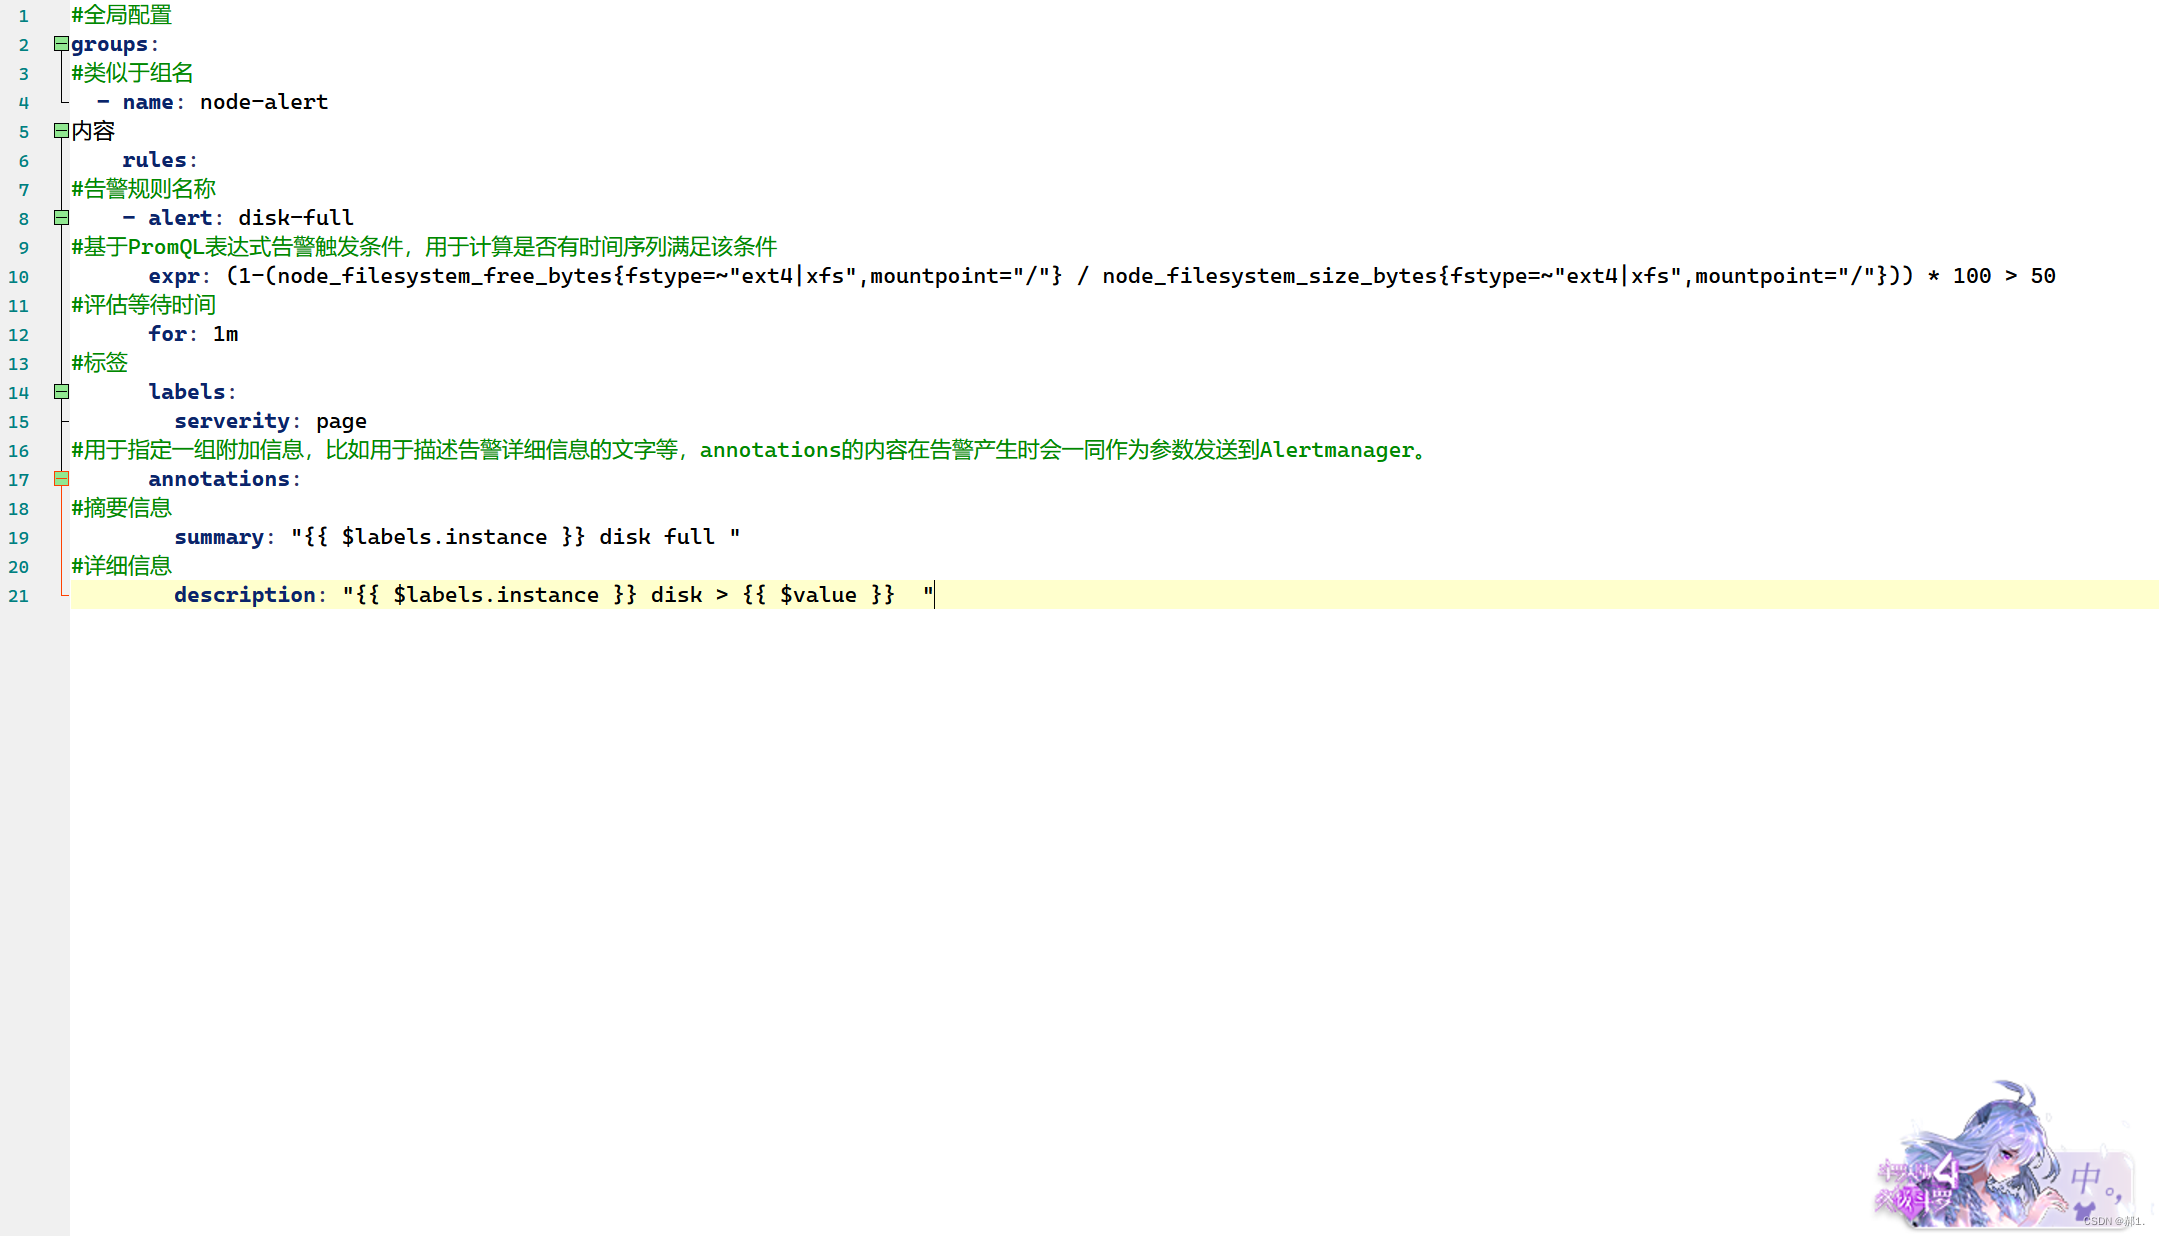
#添加
groups:
  - name: node-alert
    rules:
    - alert: disk-full
      expr: (1-(node_filesystem_free_bytes{fstype=~"ext4|xfs",mountpoint="/"} / node_filesystem_size_bytes{fstype=~"ext4|xfs",mountpoint="/"})) * 100 > 50
      for: 1m
      labels:
        serverity: page
      annotations:
        summary: "{{ $labels.instance }} disk full "
        description: "{{ $labels.instance }} disk > {{ $value }}  "


#修改属主属组
chown -R prometheus:prometheus /usr/local/prometheus/

#重启prometheus,浏览器访问
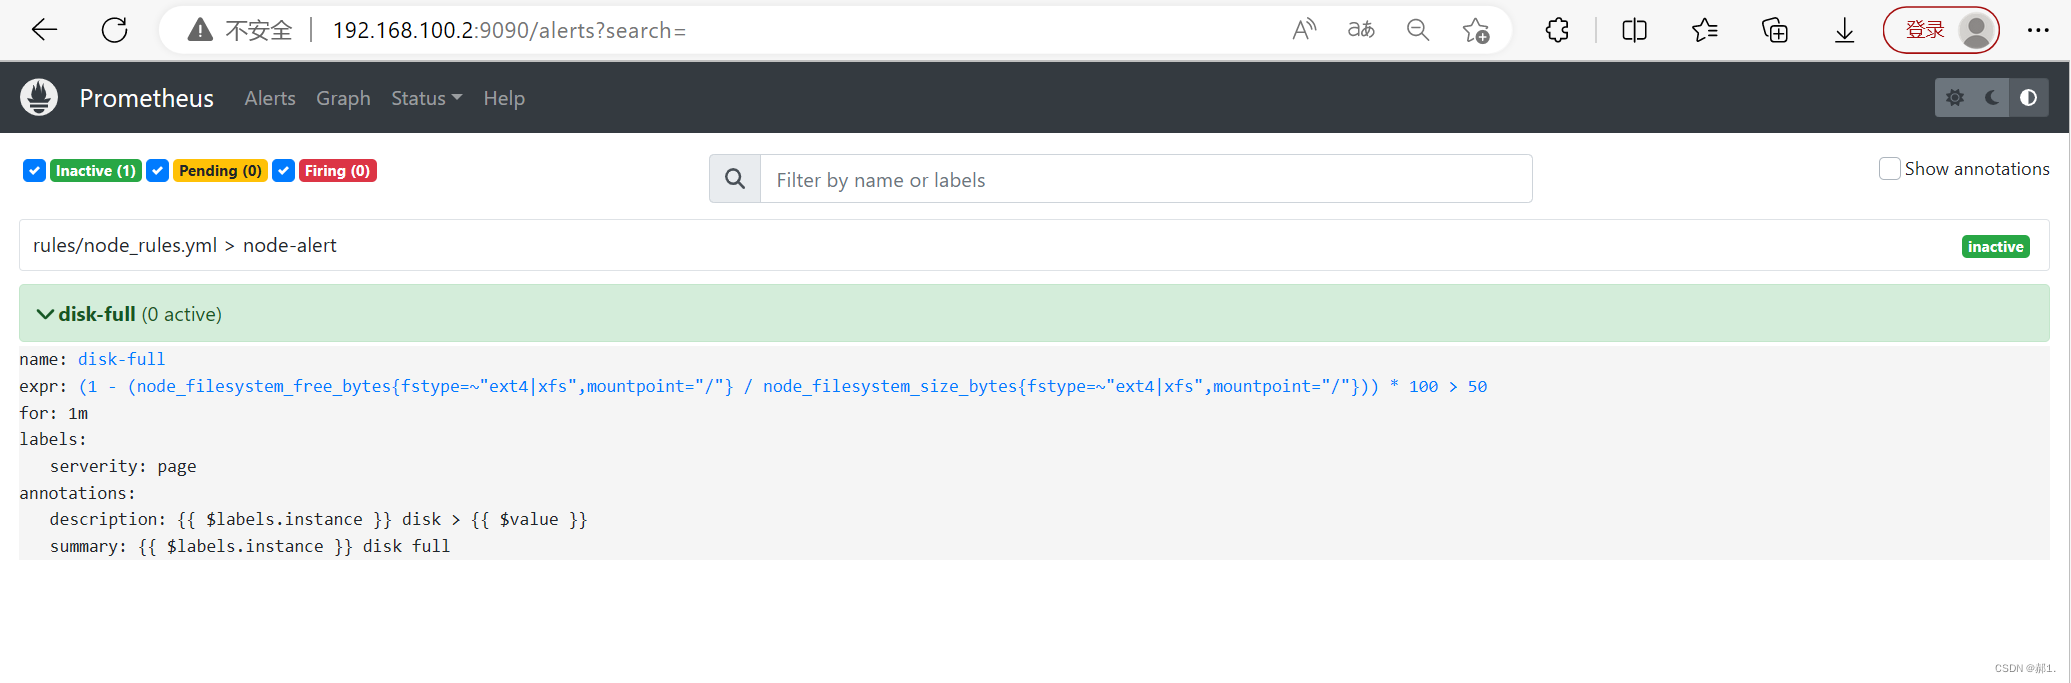
配置消息接收
上面的消息信息已经从prometheus推送给alertmanager了, 我们已经可以在alertmanager的web管理界面看到对应的报警信息,但是我们还没有配置如何让alertmanager把这些信息推送我们的社交软件上面去。由于邮件系统大家用的比较多,这里就是用qq邮箱进行后续试验。
#修改alertmanage配置文件
vim /usr/local/prometheus/alertmanager/alertmanager.yml

global:
  resolve_timeout: 5m
  smtp_smarthost: 'smtp.qq.com:465'
  smtp_from: '1684954874@qq.com'
  smtp_auth_username: '1684954874@qq.com'
  smtp_auth_password: 'qpfncrsdbhnebifj'
  smtp_require_tls: false
route:
  group_by: ['alertname']
  group_wait: 10s
  group_interval: 10s
  repeat_interval: 1h
  receiver: 'lyh'
receivers:
- name: 'lyh'
  email_configs:
  - send_resolved: true
    to: 1684954874@qq.com
inhibit_rules:
  - source_match:
      severity: 'critical'
    target_match:
      severity: 'warning'
    equal: ['alertname', 'dev', 'instance']

重启alertmanage
systemctl restart alertmanage


#生成一个大文件,使空间大于30%
dd if=/dev/zero of=bigfile bs=1M count=20000
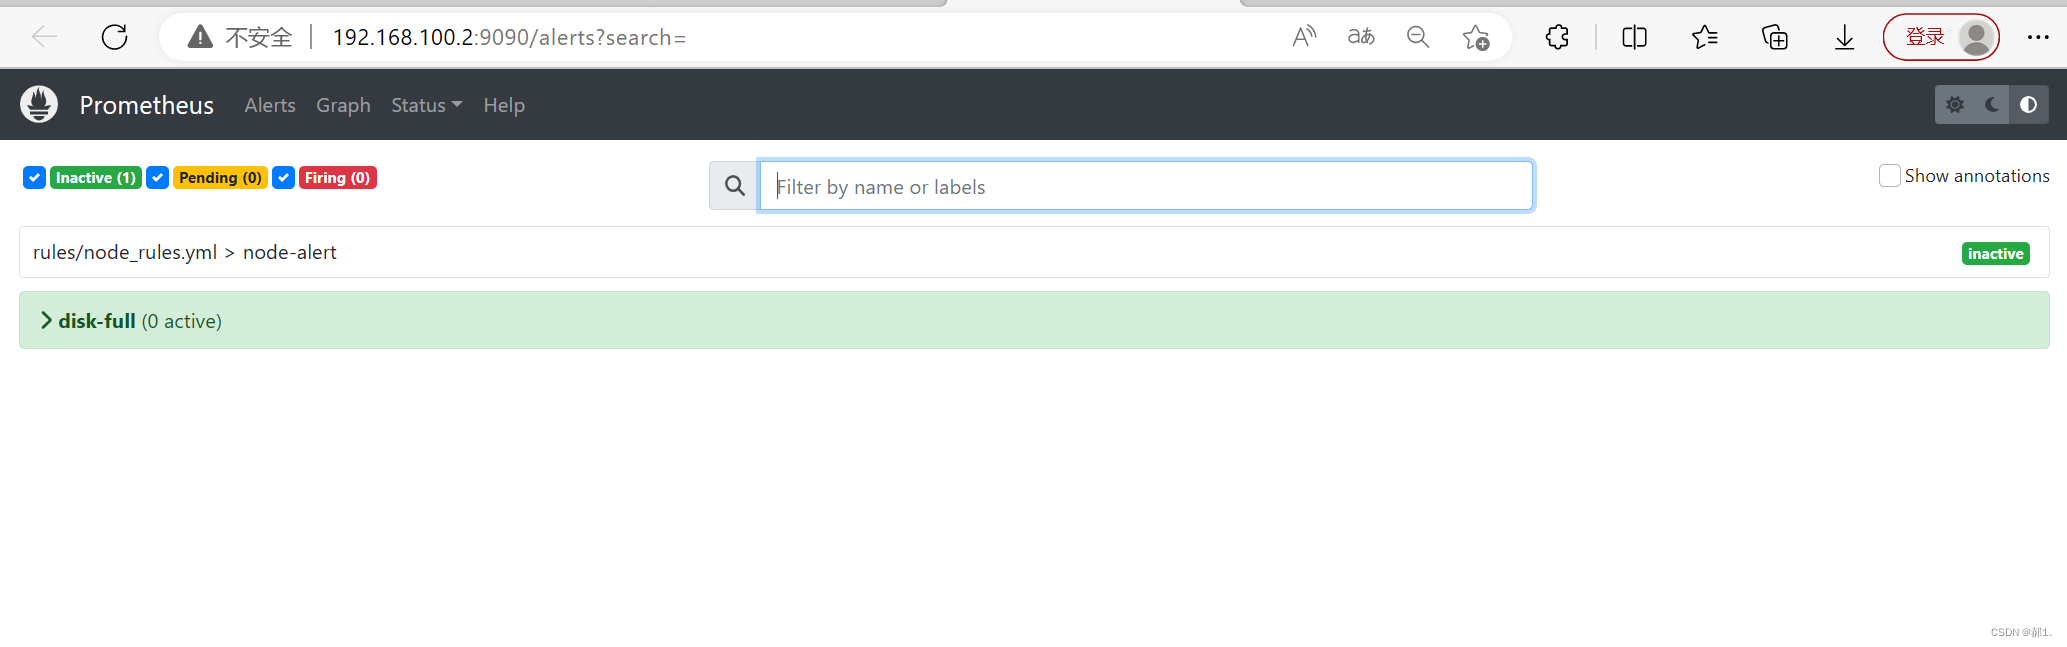
访问后发现在pending持续1分钟(取决于node_rules.yml文件中的for后面的时间)
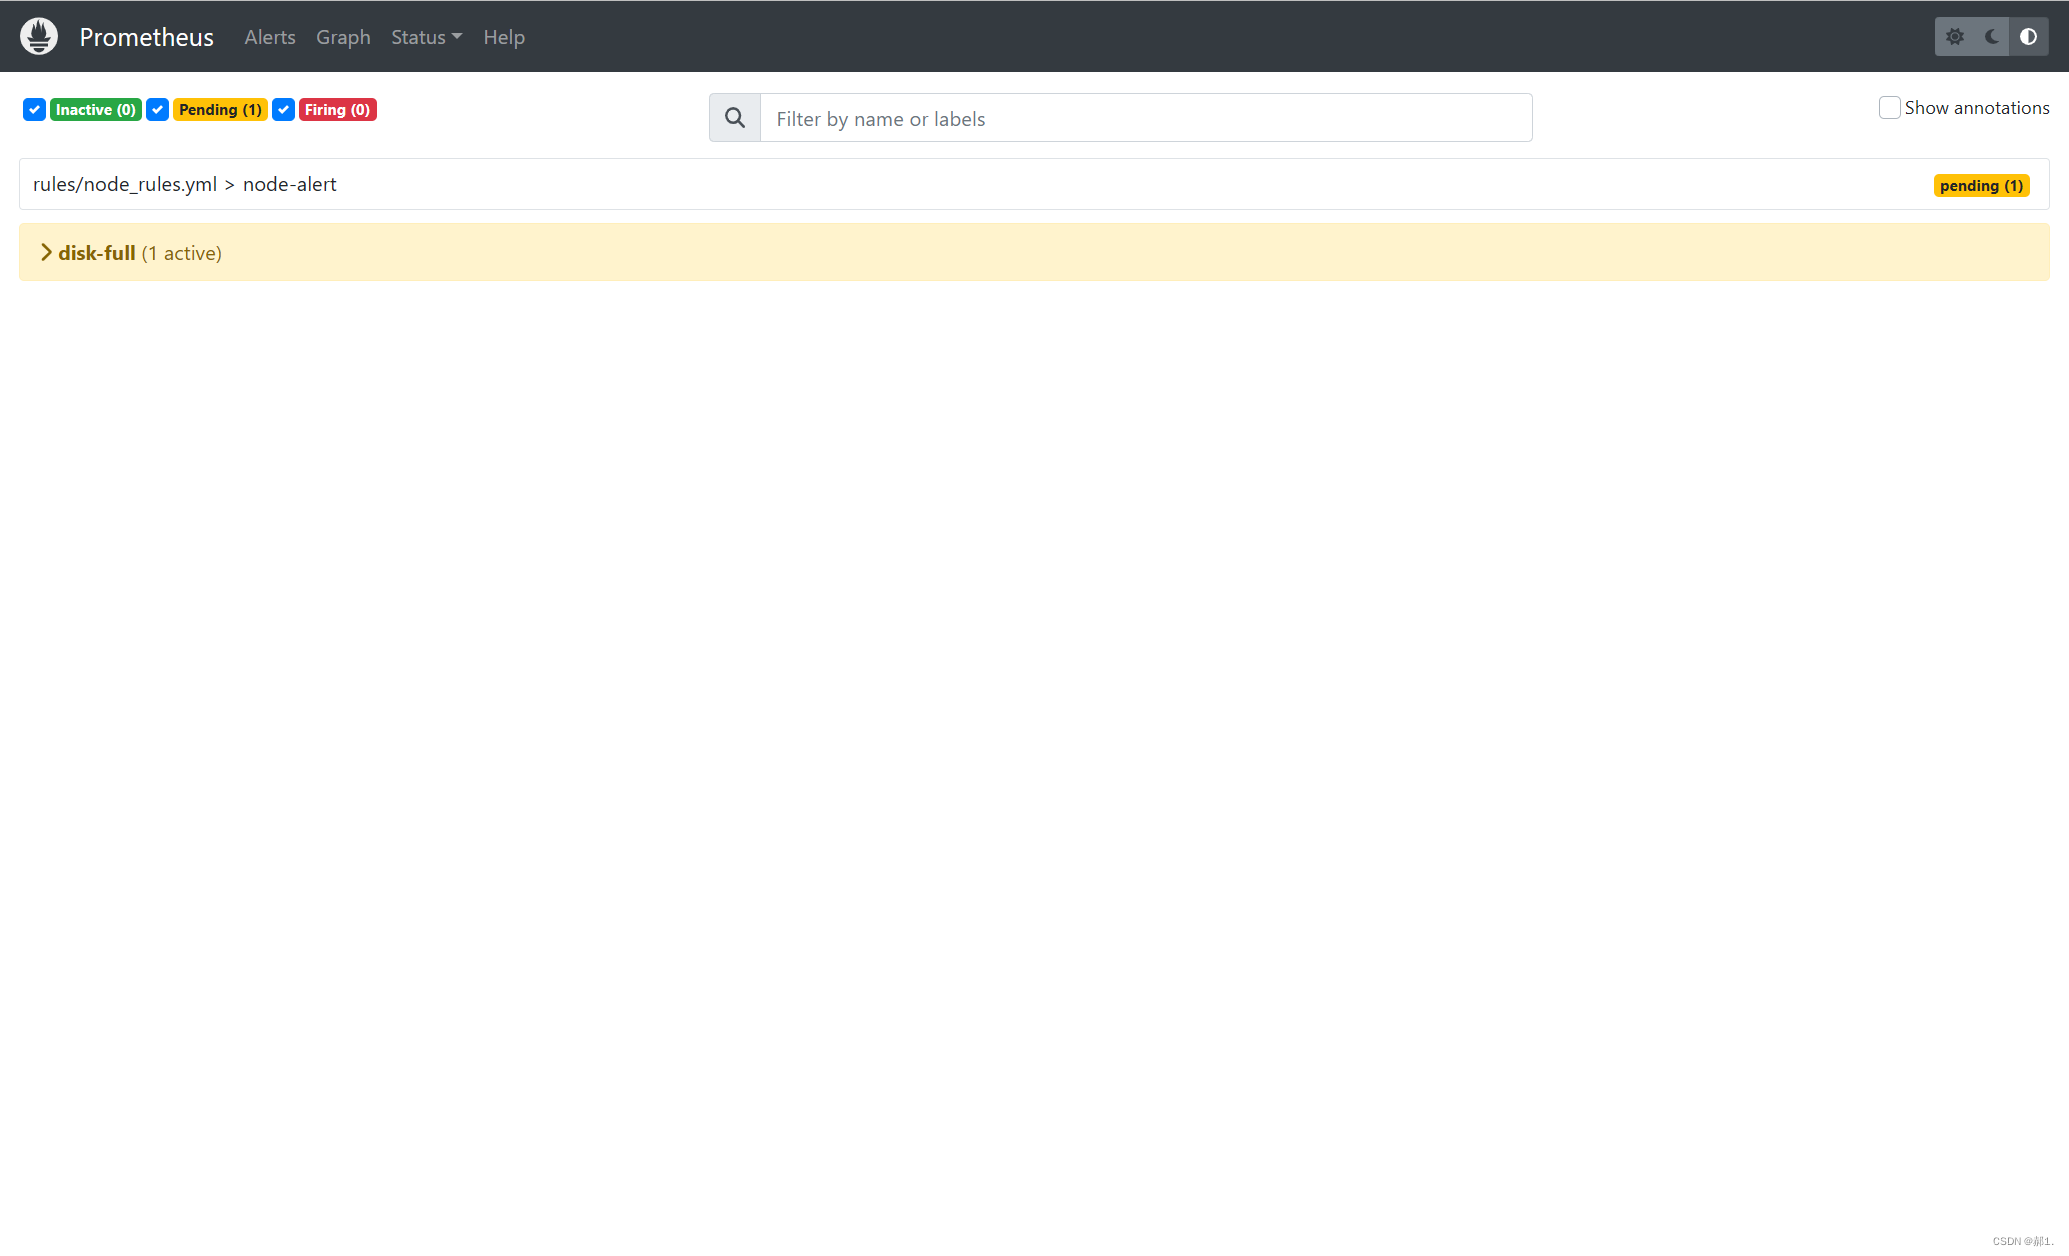
一分钟后到firing,同时发送邮件报警 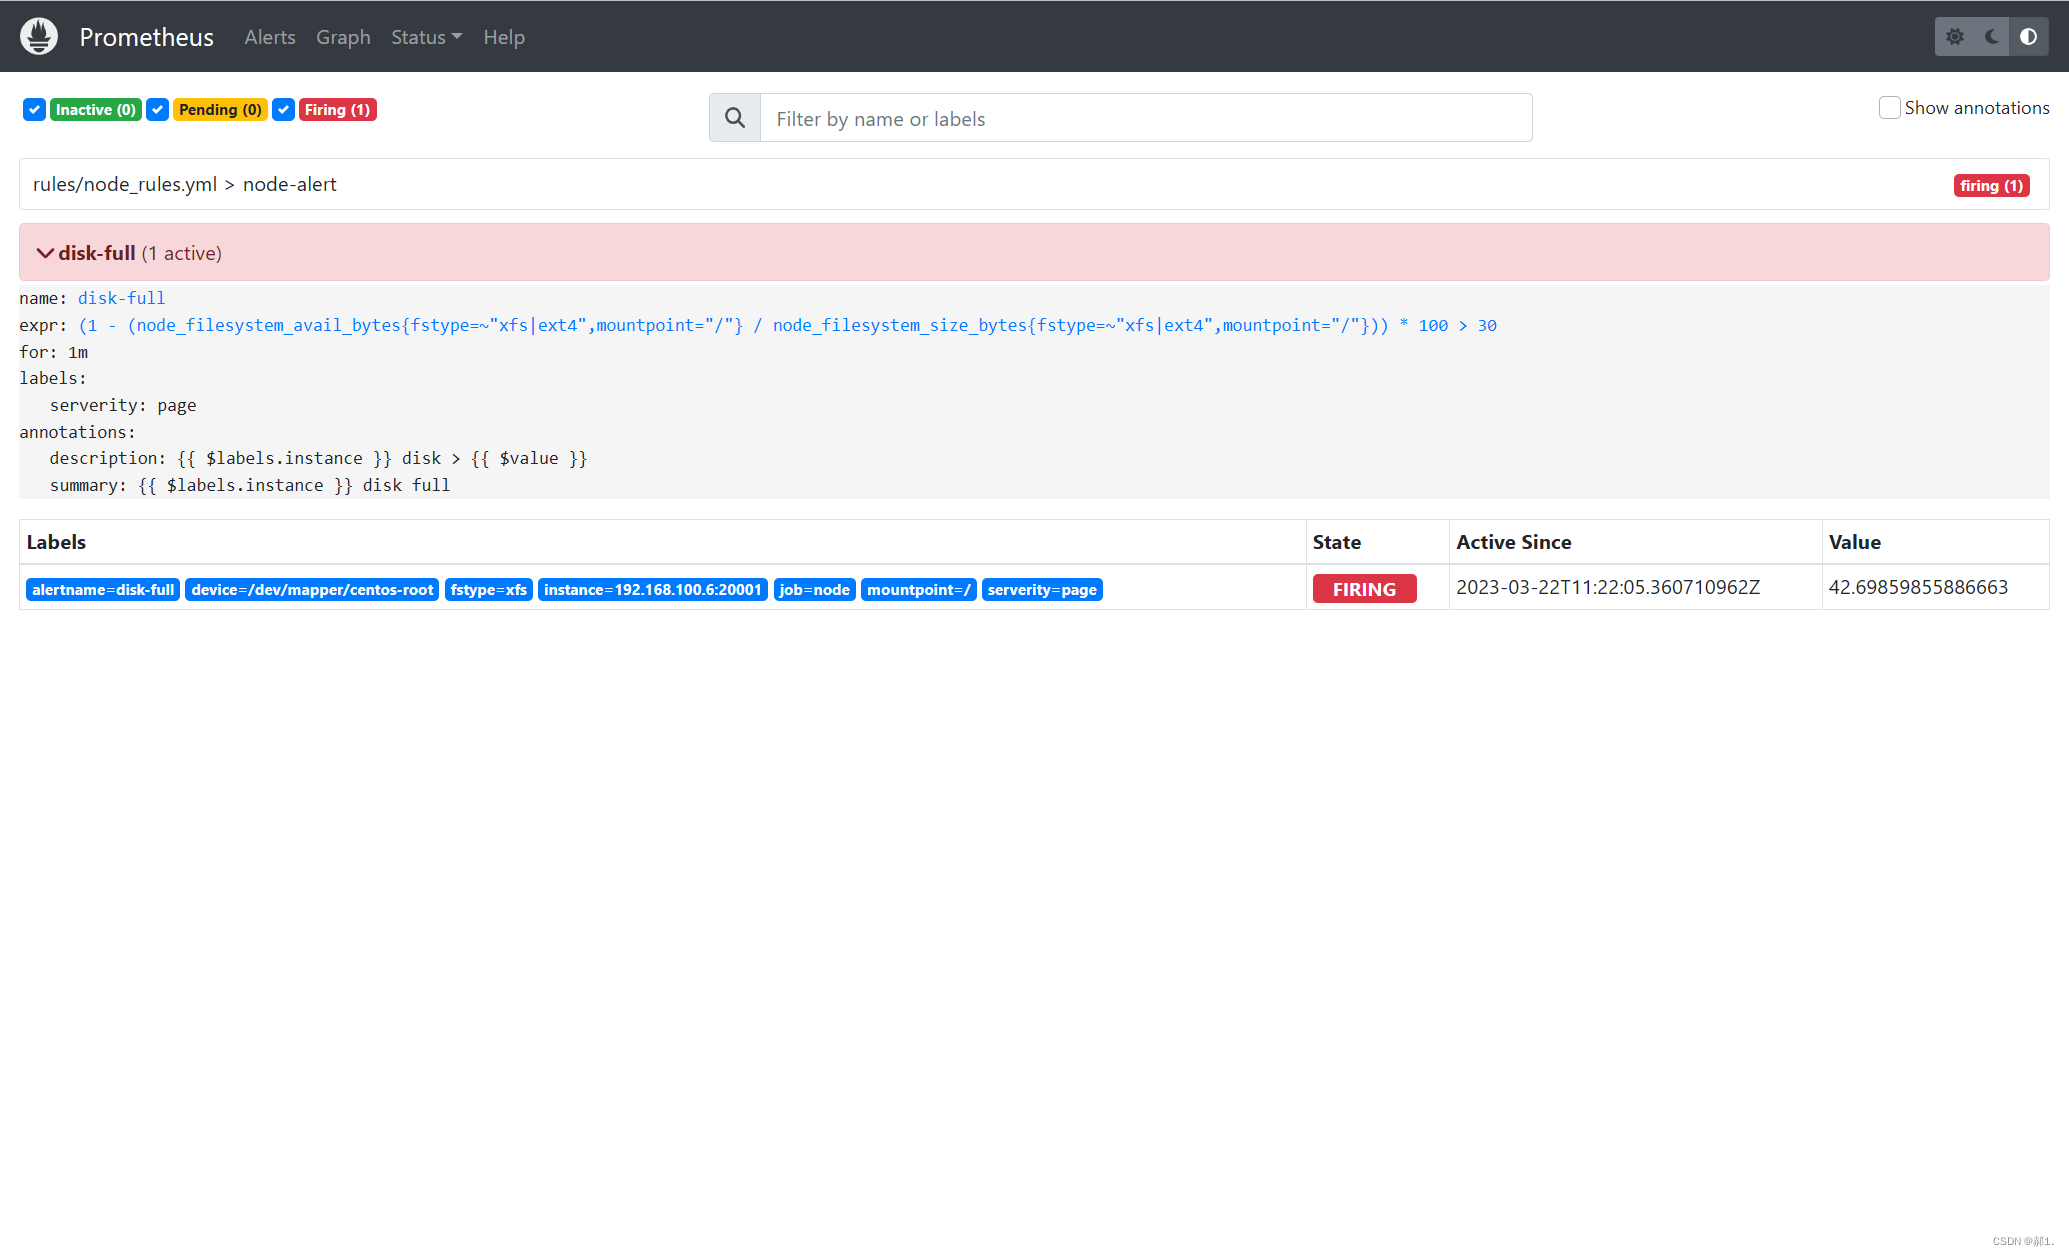
到firing后,alertmanage会收到数据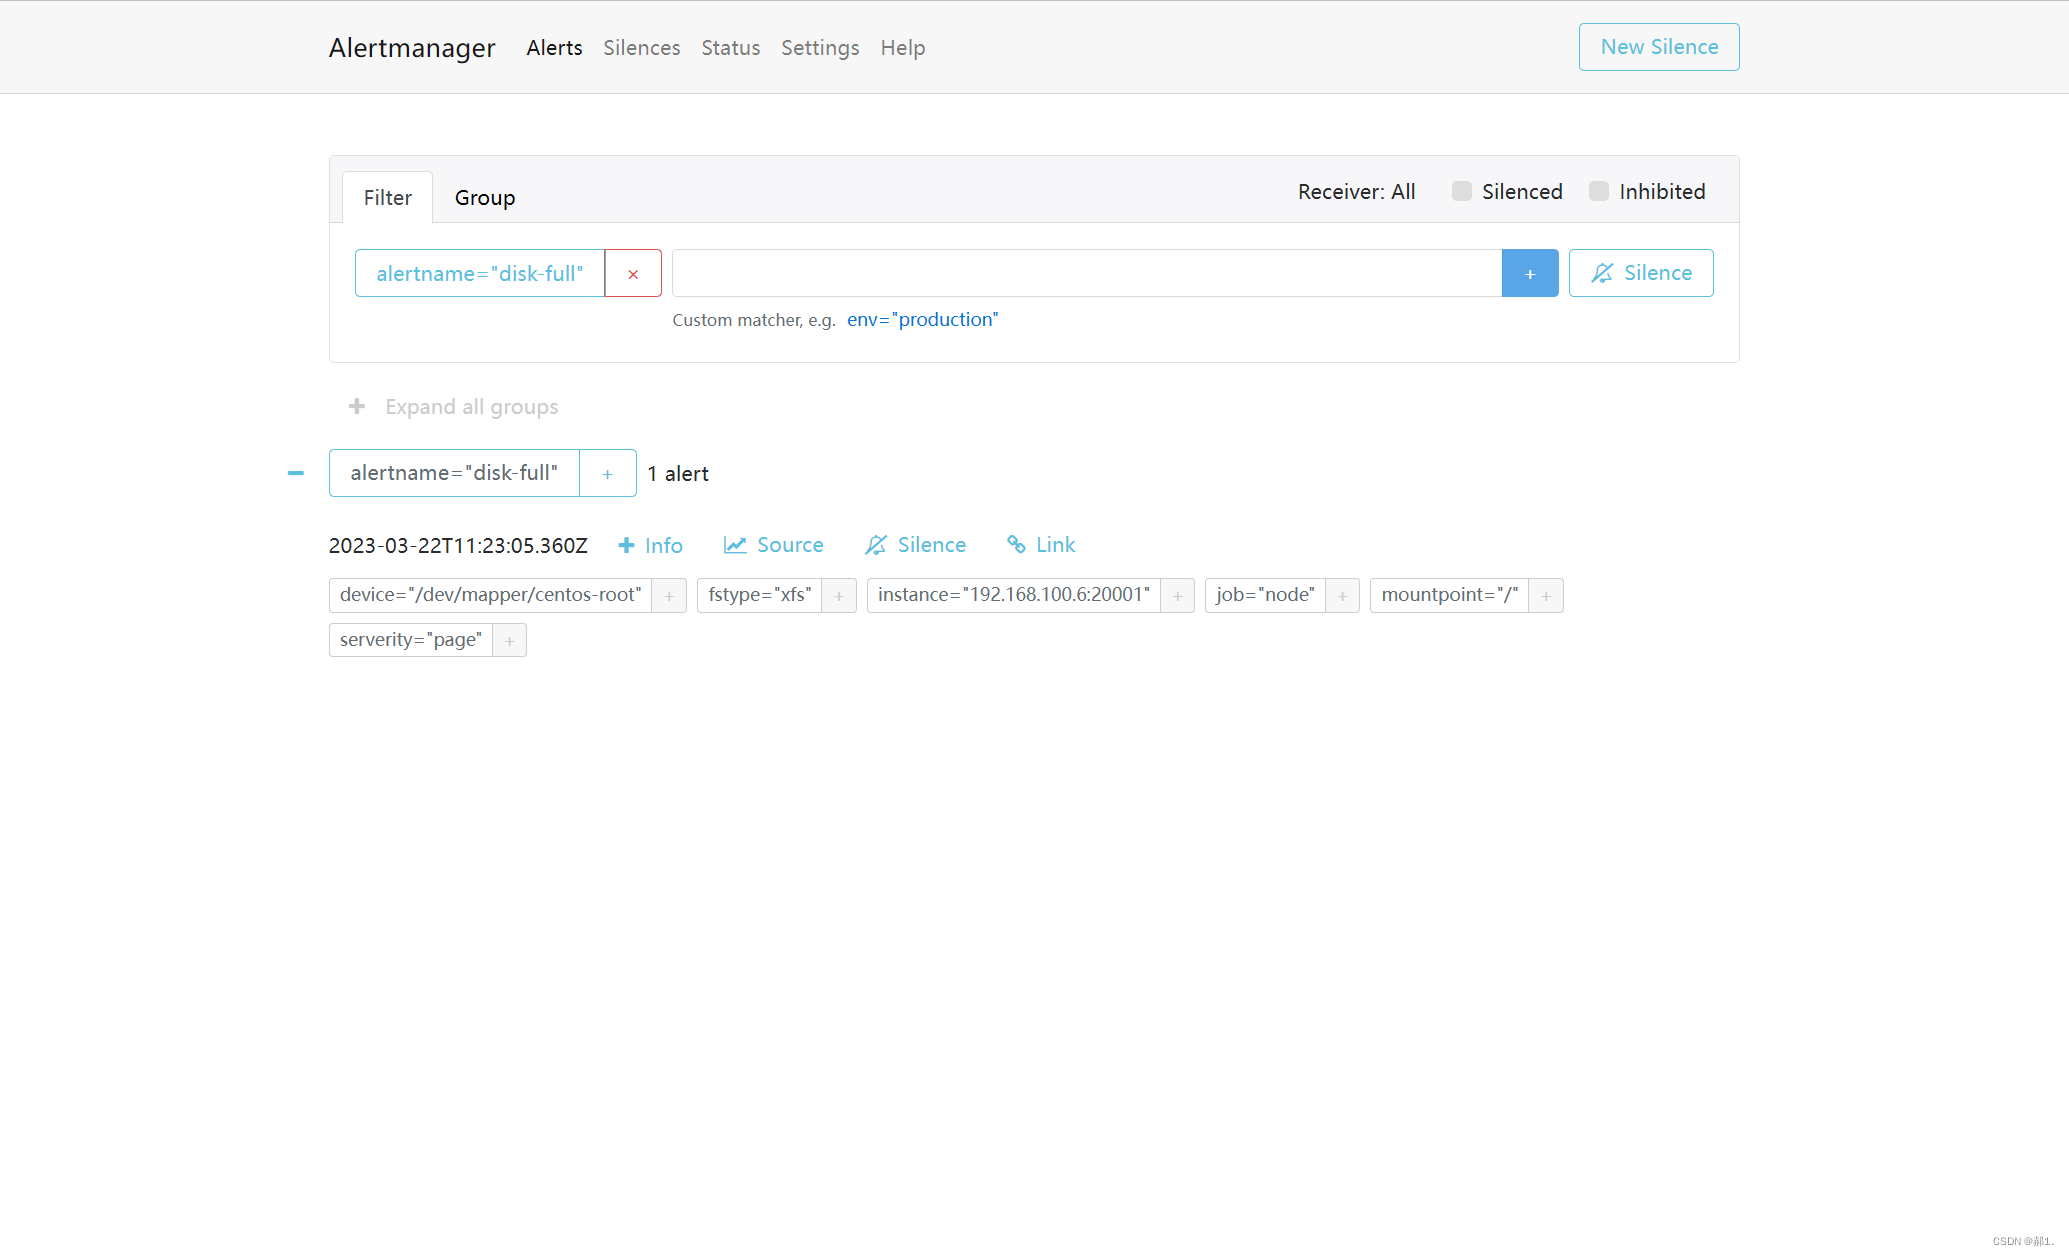
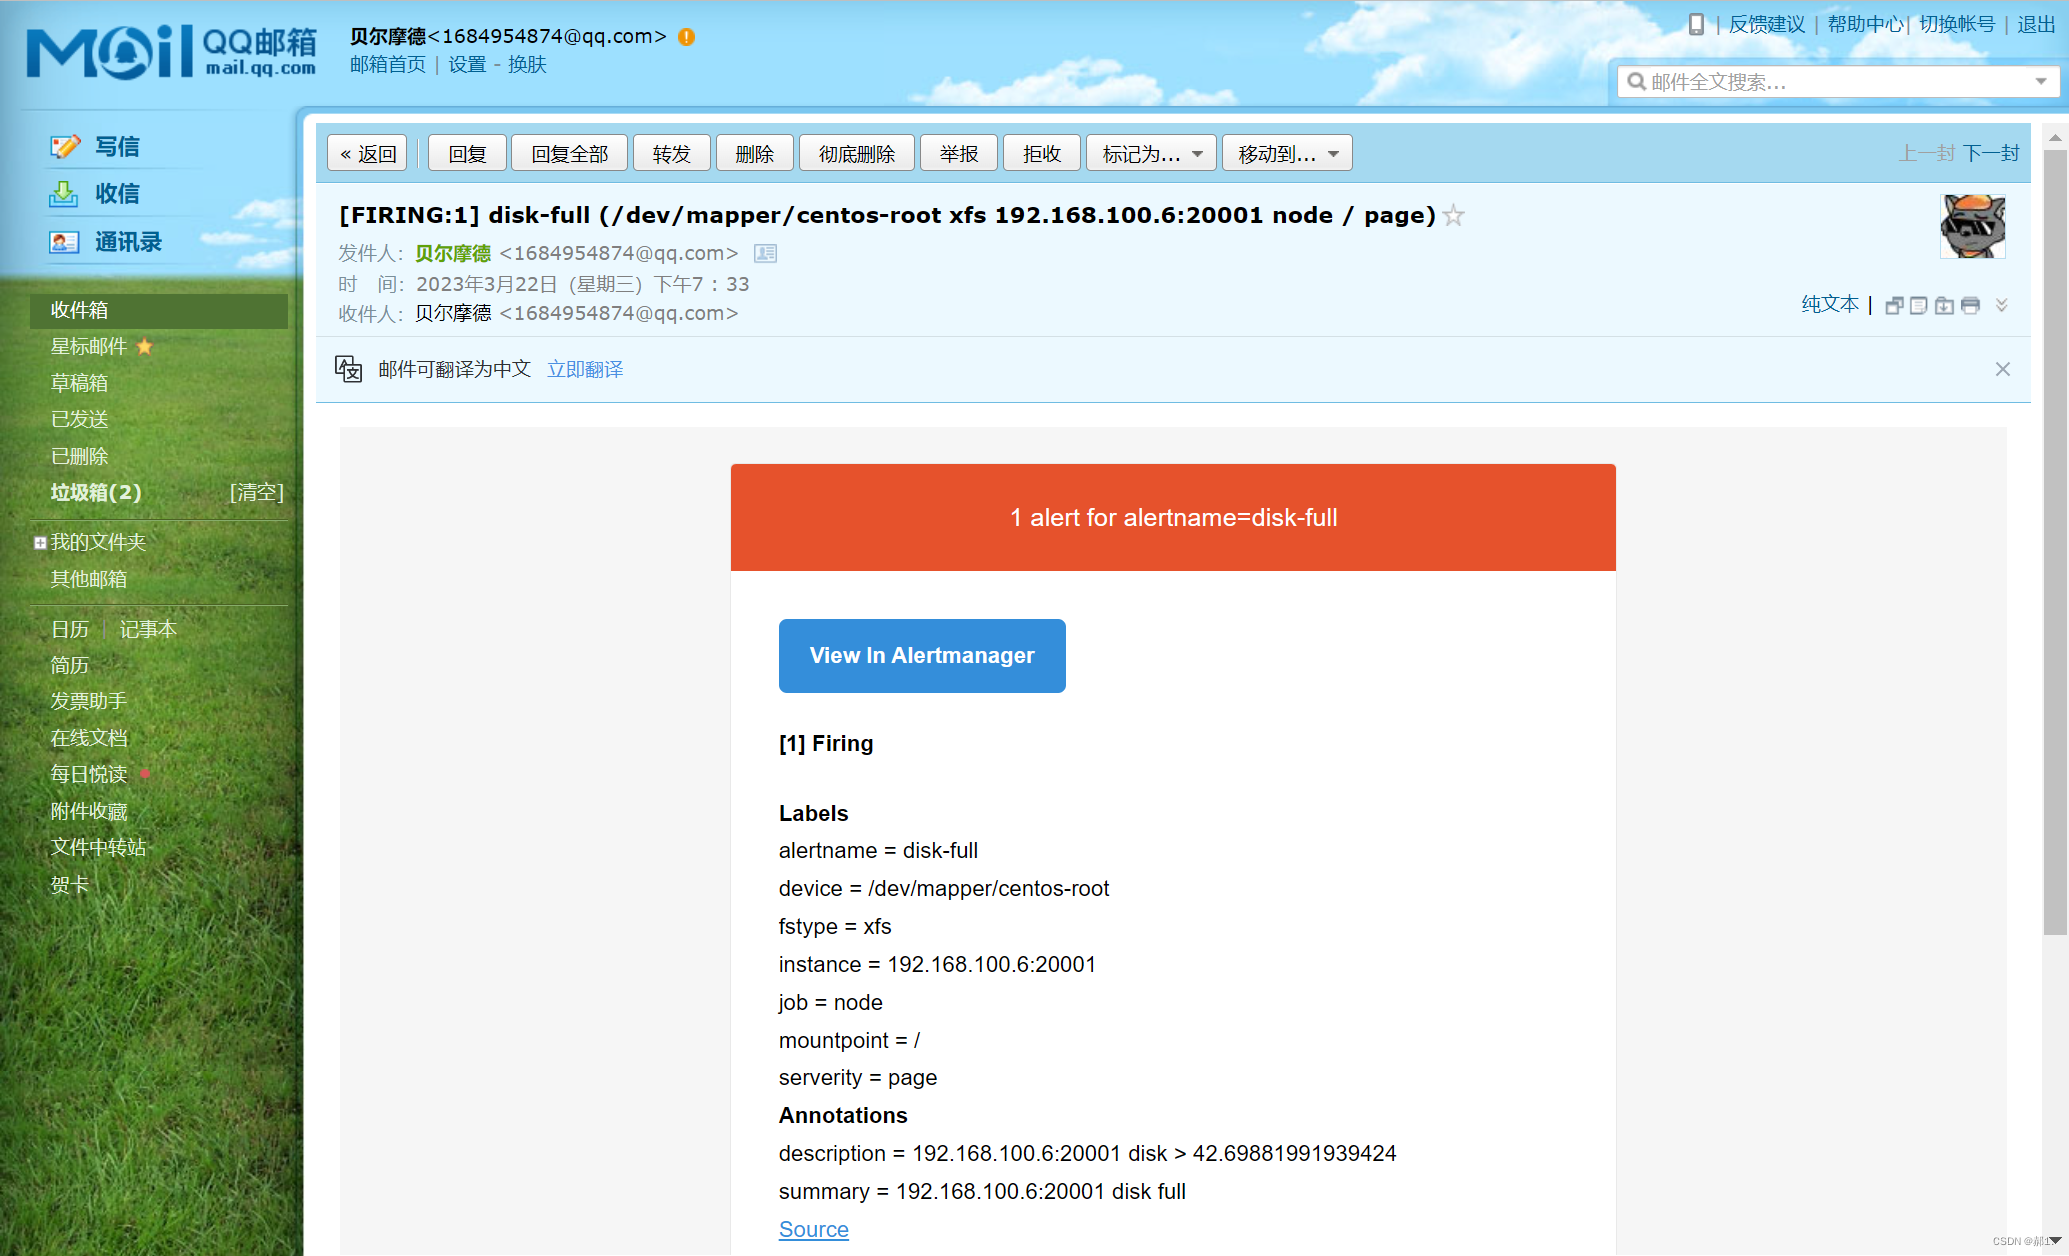
输入>bigfile释放空间
配置报警模板
#编辑配置文件


global:
  resolve_timeout: 5m
  smtp_smarthost: 'smtp.qq.com:465'
  smtp_from: '1684954874@qq.com'
  smtp_auth_username: '1684954874@qq.com'
  smtp_auth_password: 'qpfncrsdbhnebifj'
  smtp_require_tls: false
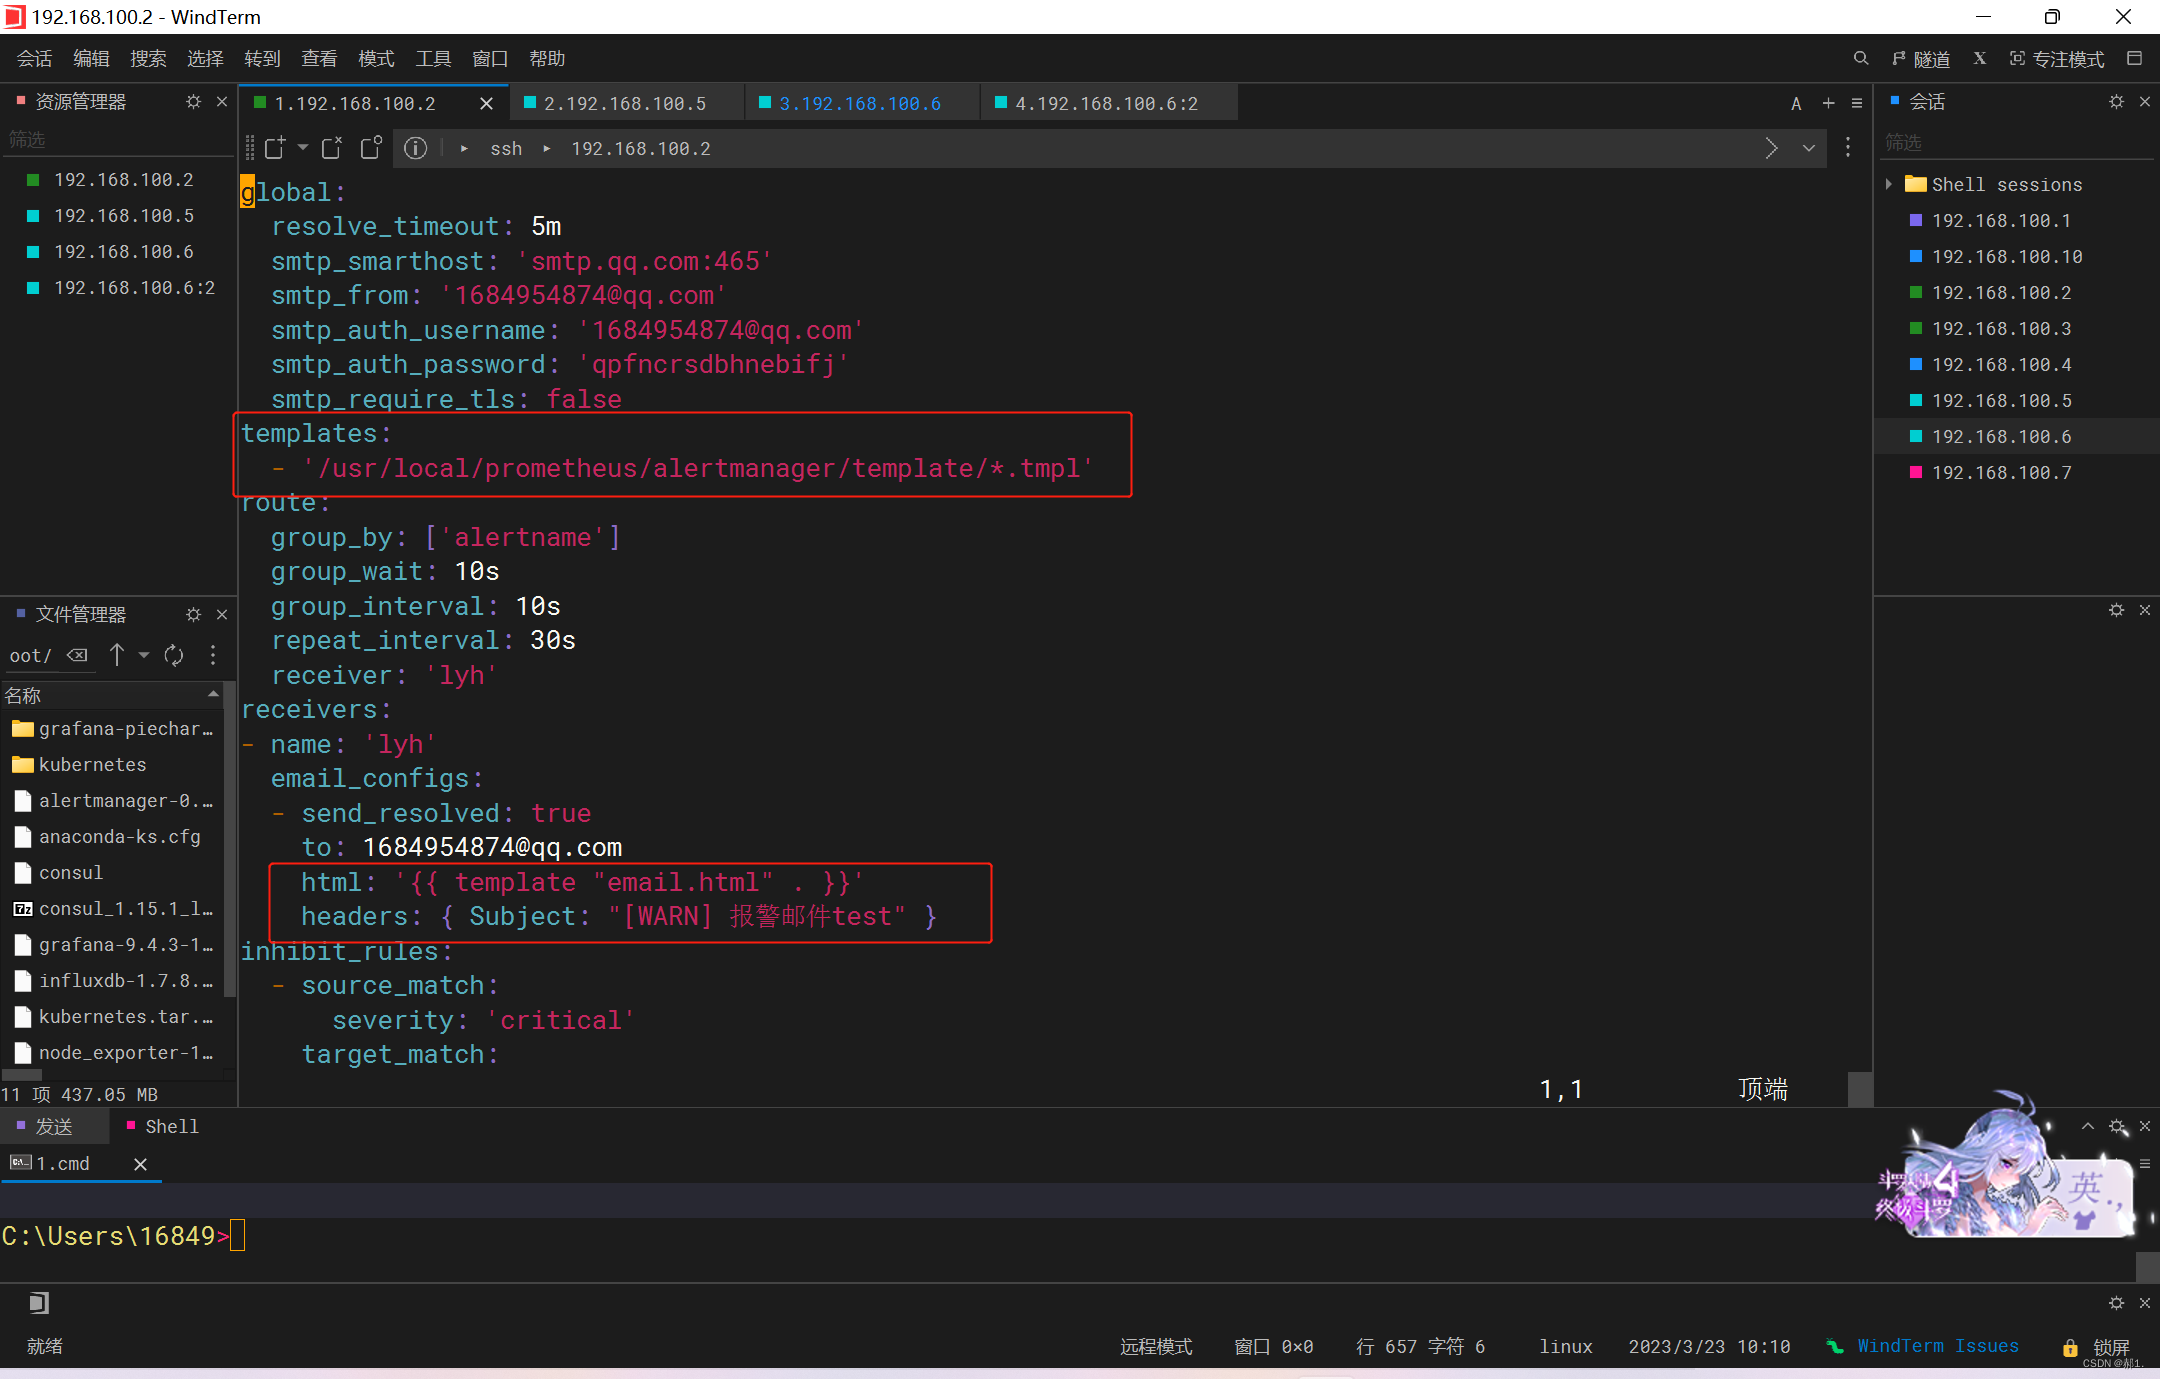
templates:
  - '/usr/local/prometheus/alertmanager/template/*.tmpl'
route:
  group_by: ['alertname']
  group_wait: 10s
  group_interval: 10s
  repeat_interval: 30s
  receiver: 'lyh'
receivers:
- name: 'lyh'
  email_configs:
  - send_resolved: true
    to: 1684954874@qq.com
    html: '{{ template "email.html" . }}'
    headers: { Subject: "[WARN] 报警邮件test" }
inhibit_rules:
  - source_match:
      severity: 'critical'
    target_match:
      severity: 'warning'
    equal: ['alertname', 'dev', 'instance']


#编辑告警模板
vim /usr/local/prometheus/alertmanager/template/wechat.tmpl

#添加内容
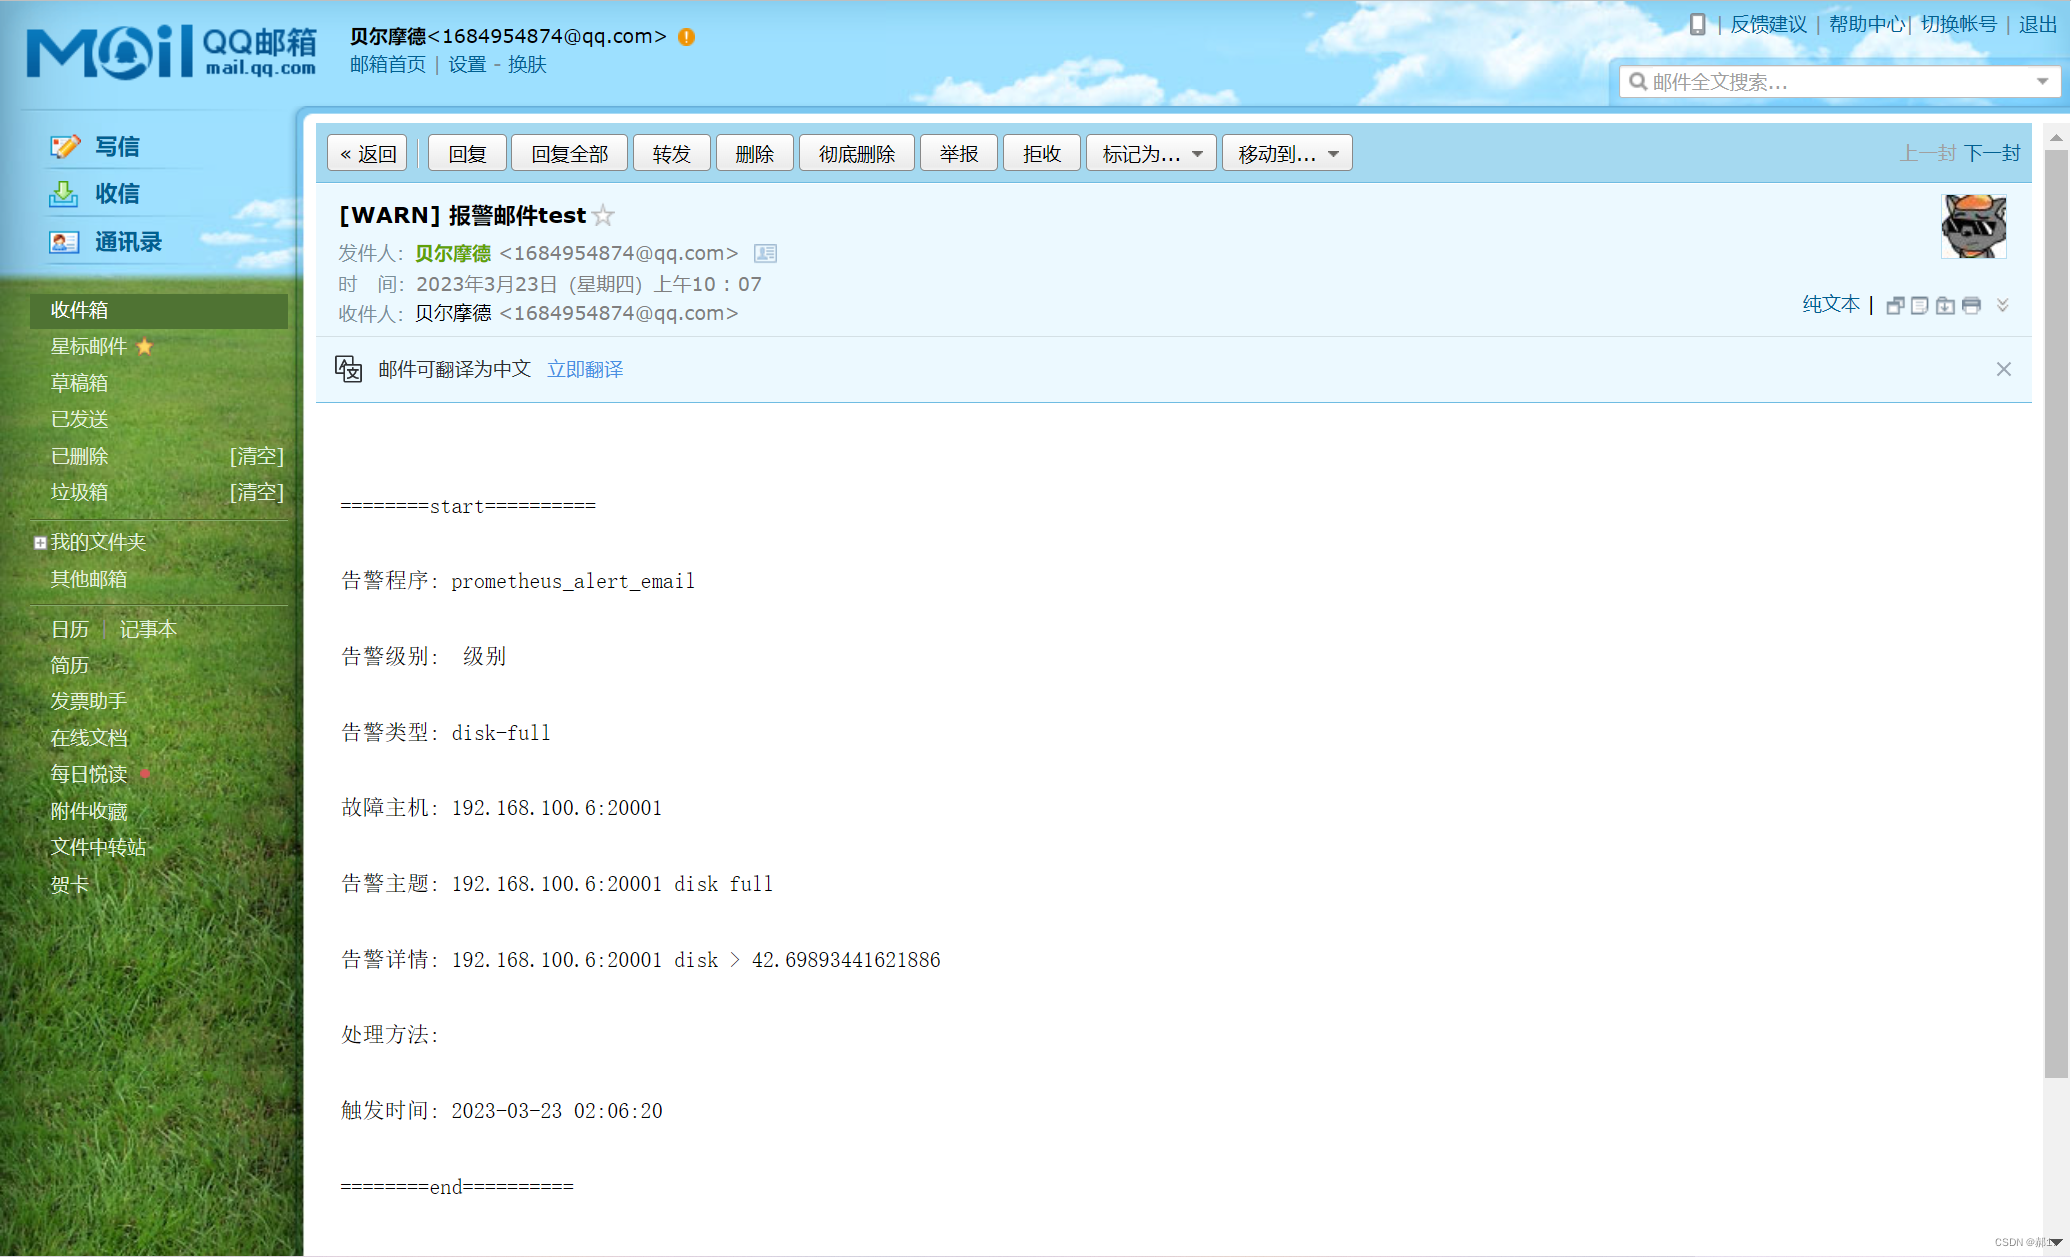
{{ define "email.html" }}

{{ range .Alerts }}

<pre>

========start==========

告警程序: prometheus_alert_email

告警级别: {{ .Labels.severity }} 级别

告警类型: {{ .Labels.alertname }}

故障主机: {{ .Labels.instance }}

告警主题: {{ .Annotations.summary }}

告警详情: {{ .Annotations.description }}

处理方法: {{ .Annotations.console }}

触发时间: {{ .StartsAt.Format "2006-01-02 15:04:05" }}

========end==========

</pre>

{{ end }}

{{ end }}

===========================================


#重启alertmanage和prometheus
systemctl restart alertmanager.service
systemctl restart prometheus.service
等待时间较长

 4351


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


