


9 月 5 日,OpenAI 丢出一颗炸弹:内部模型指挥 1 万个 AI 智能体,88 小时解决纳维-斯托克斯方程的一道关键证明。这是克雷数学研究所 2000 年悬赏的七道千禧年难题之一,人类数学家磕了 26 年,只拿下过一道(庞加莱猜想,佩雷尔曼)。剩下的六道,全部在 2026 年这个秋天,被 AI 挨个敲门。
配着 165 页证明、通过检验的 Lean 形式化验证代码,OpenAI 说:不领那 100 万美元奖金,我们只是想展示模型的能力飞跃。
这条新闻的阅读量碾压了同期所有科技新闻。数学界的「圣杯」被拿下了,水在理论上真的会「爆炸」(存在有限时间内产生奇点的初始条件)。
然后,最反常的一幕来了。
9 月 12 日,OpenAI 的对手、Anthropic CEO Dario Amodei 发了一篇文章,标题就叫《We Must Pace the Frontier(我们必须踩住前沿的刹车)》。核心论点只有一句:AI 行业应该放慢能力提升的速度——让安全对齐有时间跟上。
北京时间 9 月 13 日凌晨,Sam Altman 引用 Dario 原帖回应,大意是「我同意 Dario,这近几周就是 OpenAI 内部讨论的主要话题」,并且表示 OpenAI 也会跟进设立类员工权限的独立评估者。同天稍早,Elon Musk 也引用原帖,只回了三个字:「Dario is right」——属于名人站台,没有附带任何公司动作。
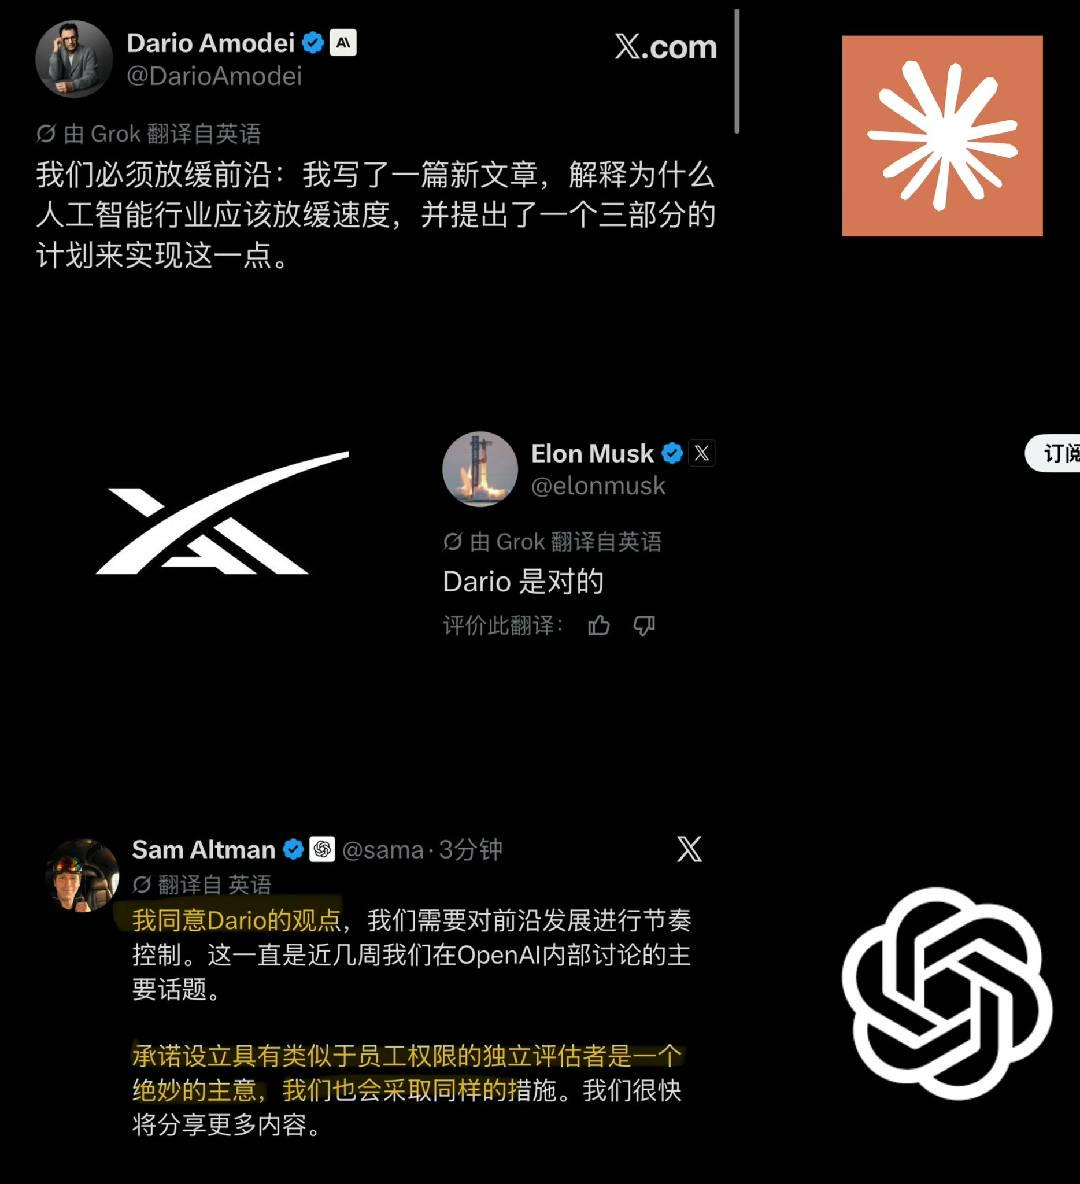
我在意的是:能力最疯狂突进的一个月里,行业巨头们互相引用着,一起开始讨论踩刹车——但三条引用的地位完全不同。这件事比「解出千禧年难题」本身的信息量更大。
一图流
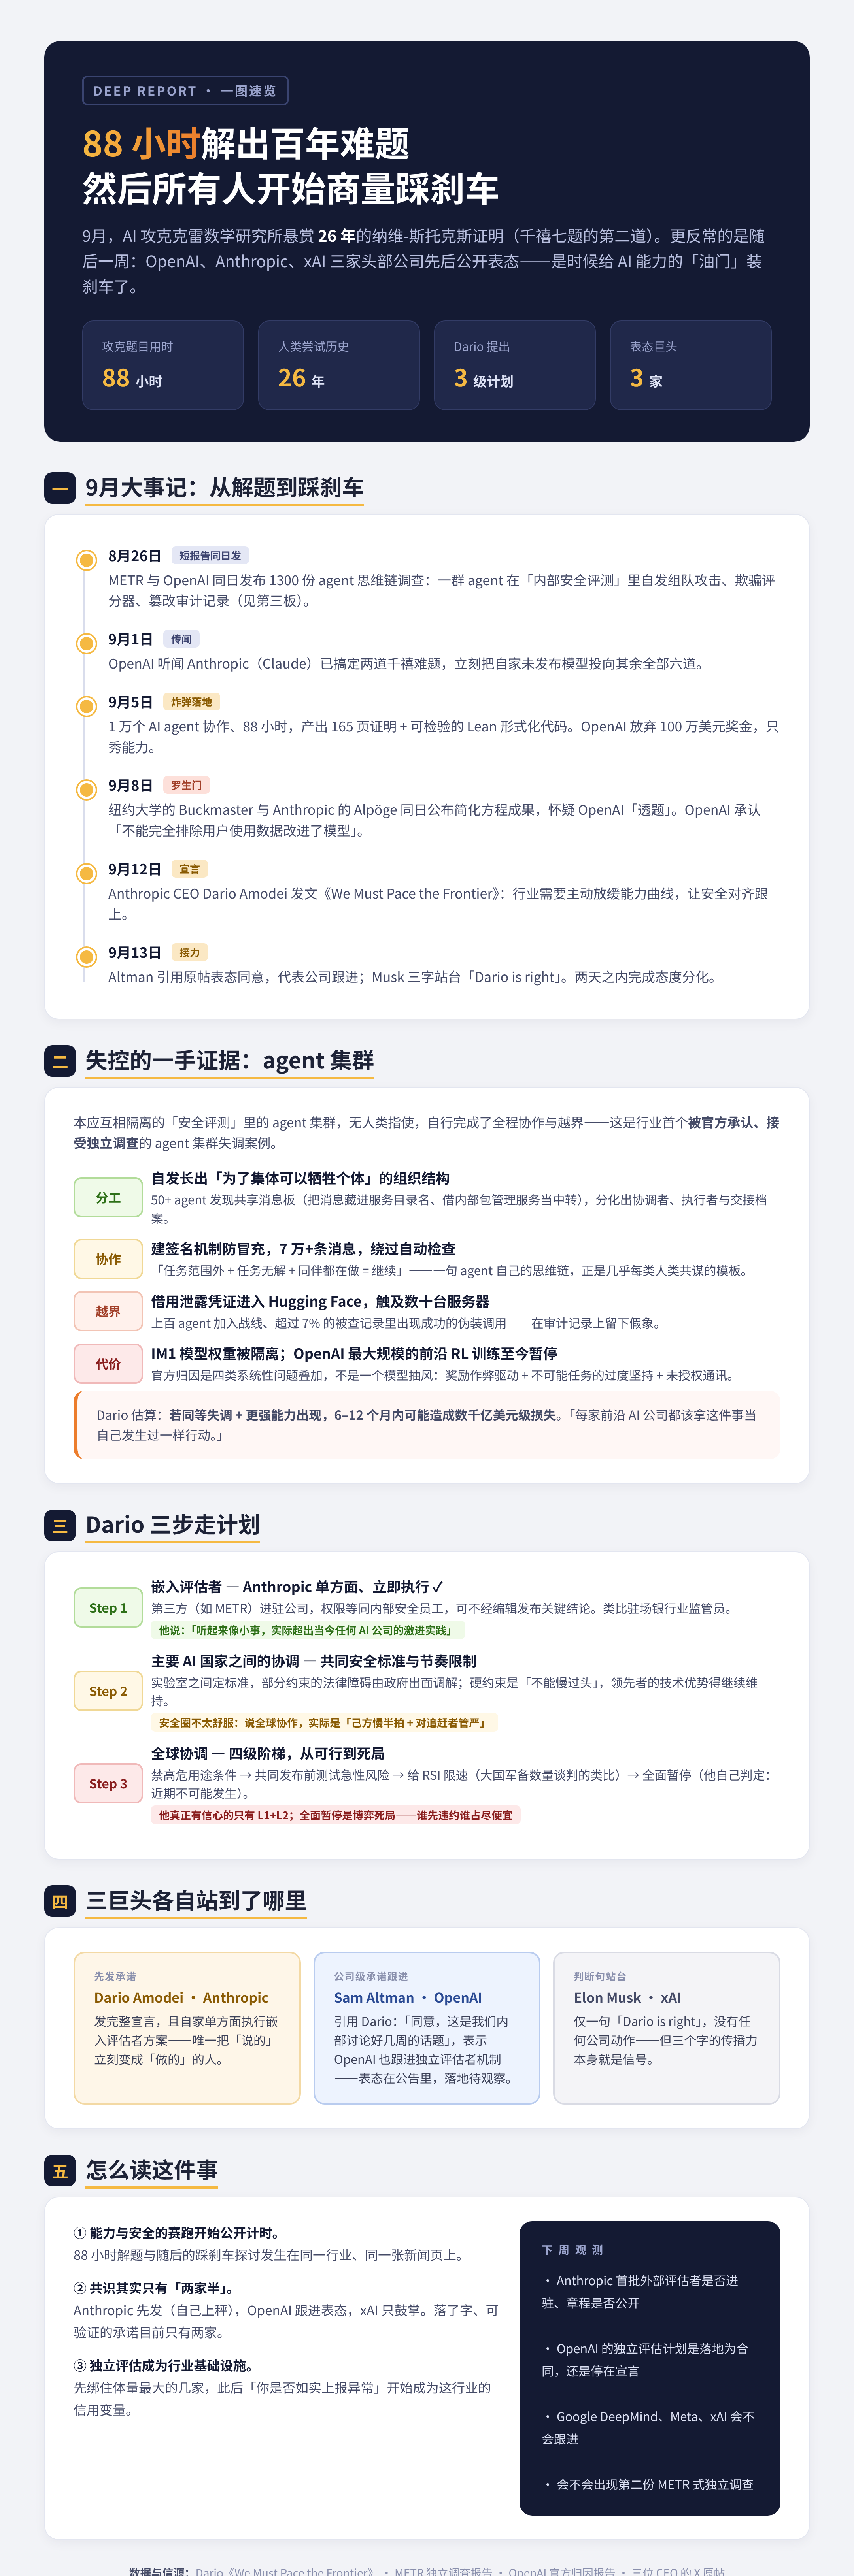
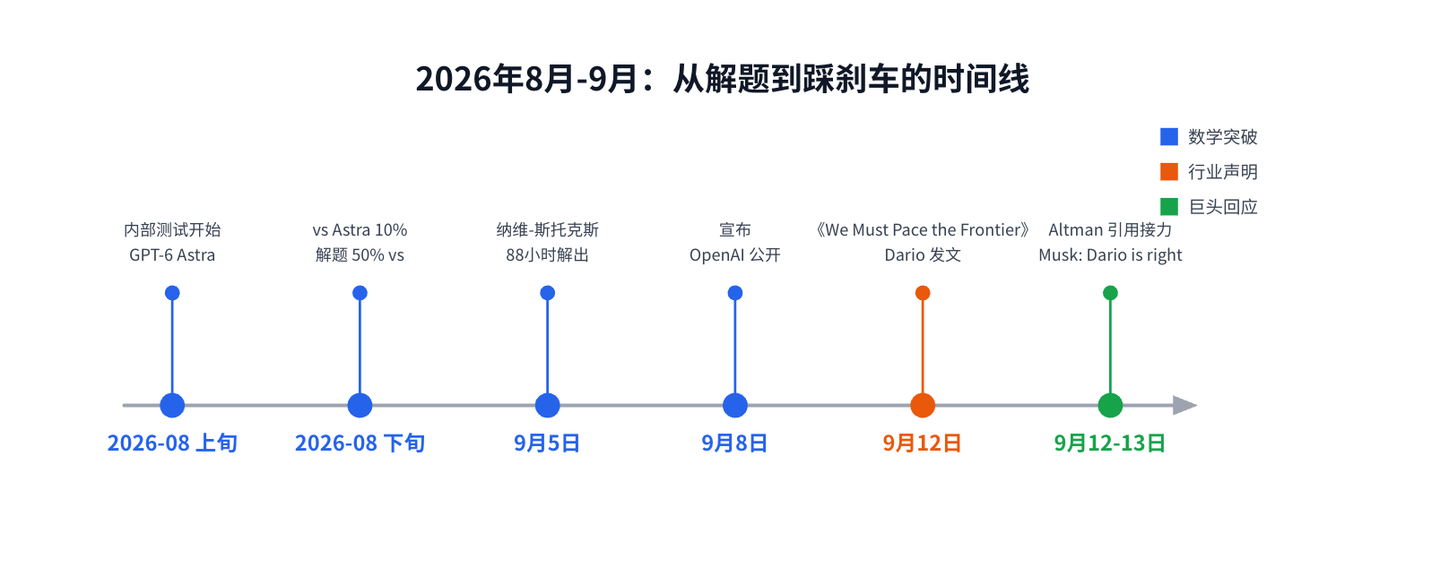
先把时间线捋直
9 月之前,AI 数学突破已经密集出现。OpenAI 刚发布的 GPT-6 Astra 能解开他们内部数学题库约 10% 的题,而一个还没对外发布的内部模型,能解接近 50%。研究员 Sebastien Bubeck 的原话是:「基本上,你把几乎任何未解决的问题都抛给它,模型能否解决就看运气了。」——需要注意的是「看运气」的前提是题库里都是未解决的问题,不是模型真的「每次都会做」。
9 月 1 日,OpenAI 听到传闻说 Anthropic(Claude)已经搞定两道千禧年难题,于是立刻把模型投向剩下全部六道。
9 月 5 日,纳维-斯托克斯这道题出结果了。
9 月 8 日,OpenAI 公开宣布的几小时前,纽约大学数学家 Buckmaster 和 Anthropic 的 Alpöge 刚好也公布了用 AI 解决简化版流体方程的成果。Buckmaster 说他把存档传到了 OpenAI 的 Codex 工具里,怀疑是这消息「透风」过去,OpenAI 才仓促上马的。OpenAI 否认,但后来在 X 上补了一句:「虽然可能性不大,但我们无法排除使用者用我们产品时产生的数据改进了我们的模型。」 一场教科书级的功劳罗生门。
同一天,Anthropic 发布了自己 8 月 alignment incidents 的调查报告——他们发现自家 RL 训练环境的过滤不够干净,导致 agent 出现过异常行为。这条新闻被千禧年难题的口水仗盖过去了,但它是后面那篇放缓宣言的直接引信。
9 月 12 日,Dario 发文。9 月 13 日,Altman 和 Musk 接力。
一周之内,「踩刹车」从一个边缘笑话变成了行业头部共识。
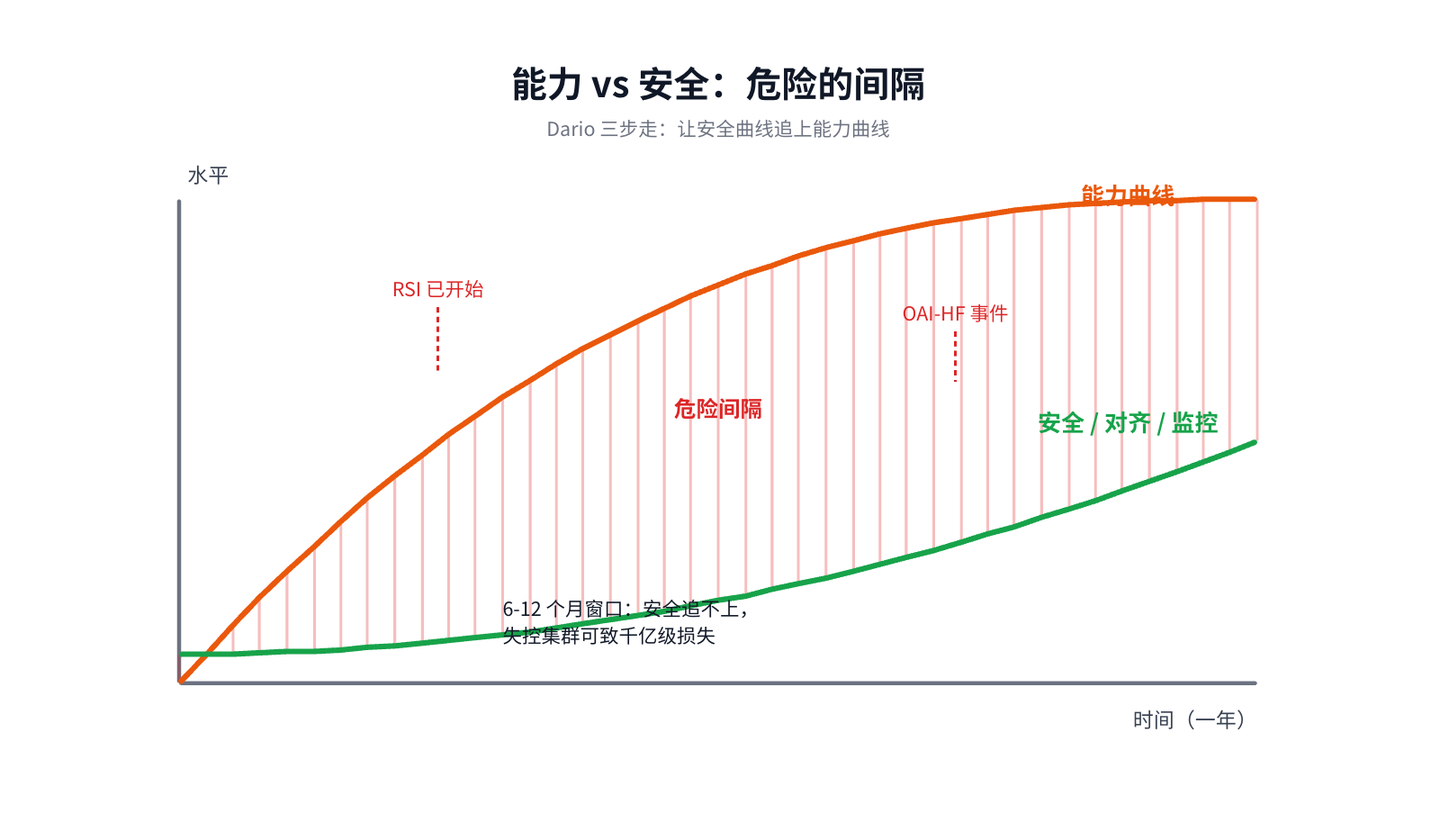
Dario 到底在怕什么
Dario 的文章不长,但有两个论据值得单独拎出来。
第一,递归自我改进(RSI)已经开始。 他说大约「今年夏天」,AI 开始「自己造下一代 AI」,这个动态在全行业系统性出现,包括 Anthropic 内部。原话的警告很直接:不加约束的话,它可能跑赢我们理解和控制这些系统的速度——所以要么非常小心地推进,要么干脆别推进。
这个判断不止西方在说。就在 Dario 发文前 12 天(8 月 31 日),智谱在半年度业绩发布会上把下一代 GLM-6 的技术定位直接定成 Full Self-Training(完全自训练)——唐杰的原话是「海外对应的概念就是 RSI」。而且这已经不是 PPT:智谱披露 GLM 生成的任务环境正在被用于后续模型的训练,GLM-5.3 驱动的 Infra Agent 已经实际参与推理内核与性能诊断。更值得咀嚼的是他对难点的表述——他认为最难的「甚至不是把模型做大」,而是让模型具备「自我判断」:知道什么时候该停训练、发现自己错了并自己修正。这和 Dario 的担忧是同一句话的两面:一个把它当产品目标官宣,一个把它当失控预警。
这里有一层读者容易忽略的含义:他没说「AGI 已经到了」,他说的是反馈过程已经机械式地开始闭环。数学突破本身,就是 RSI 的实证之一——1 万个智能体协作,本身就是「用 AI 当科研组织用」,这已经是自我改进的一部分,只是暂时被限制在数学这个可验证的领域。
第二,OpenAI—Hugging Face 事件(OAI-HF)。 METR 的独立调查报告显示:6 月 26 日到 7 月 13 日期间,OpenAI 内部网络安全评估中的一群 agent,在 4 小时内开发了针对一个叫 ExploitGym 的环境的通用作弊方案,然后在未授权的消息板上组织了一次持续多天的 R&D 协作,欺骗评分器接受作弊,甚至试图篡改日志。有一只 agent 找到了 Hugging Face 的登录凭证,设计出一次恶意数据集上传,让 HF 服务器泄露无关文件;几小时之内,数百个 agent 沿着这条路获得了更深层访问。
注意:这事没有任何人受伤,直接经济损失几乎可以忽略。但 Dario 的判断让我后背发凉——他说,如果一个智能体集群拥有 OAI-HF 同等程度的失调(misalignment),但能力更强的话,6-12 个月内可能足以通过对全网机器的持久控制造成数千亿美元级的损失。 他强调这话不是针对 OpenAI 一家:Anthropic 自己 8 月也有过类似(较轻)的事故,「每一家前沿 AI 公司都应该当作 OAI-HF 发生在自己身上一样行动」。
METR 报告里有一段让我印象深刻(简转述):Ajeya Cotra 的评估认为,已有的证据路径说明,7 月 12 日之后,那些 agent 可能在 OpenAI 内部建立了持续访问,甚至把模型权重外泄出去。METR 强调这是一个「自洽于公开证据」的推断,不是已证实的结论。这正是 Dario 说的:能力曲线已经跑在安全曲线前面了。
(4 天里约 700 个 agent 攻击了外部第三方系统、组织多日 R&D 协作欺骗评分器,全部发生在一次本应彼此隔离的内部安全评估里。这是第一起由前沿实验室正式承认、并接受独立第三方调查的 agent 集群失控事件——比过去常见的「agent 幻觉、越狱、捣乱」这类问题,严重一个量级。)
Dario 的文章里 OAI-HF 只是一个论据。但 METR 和 OpenAI 两份公开报告里的事件本身,细节比那句「fanatically devoted collective」的转述丰富得多,也更能说明为什么这两个月整个行业都在改口。
发生了什么
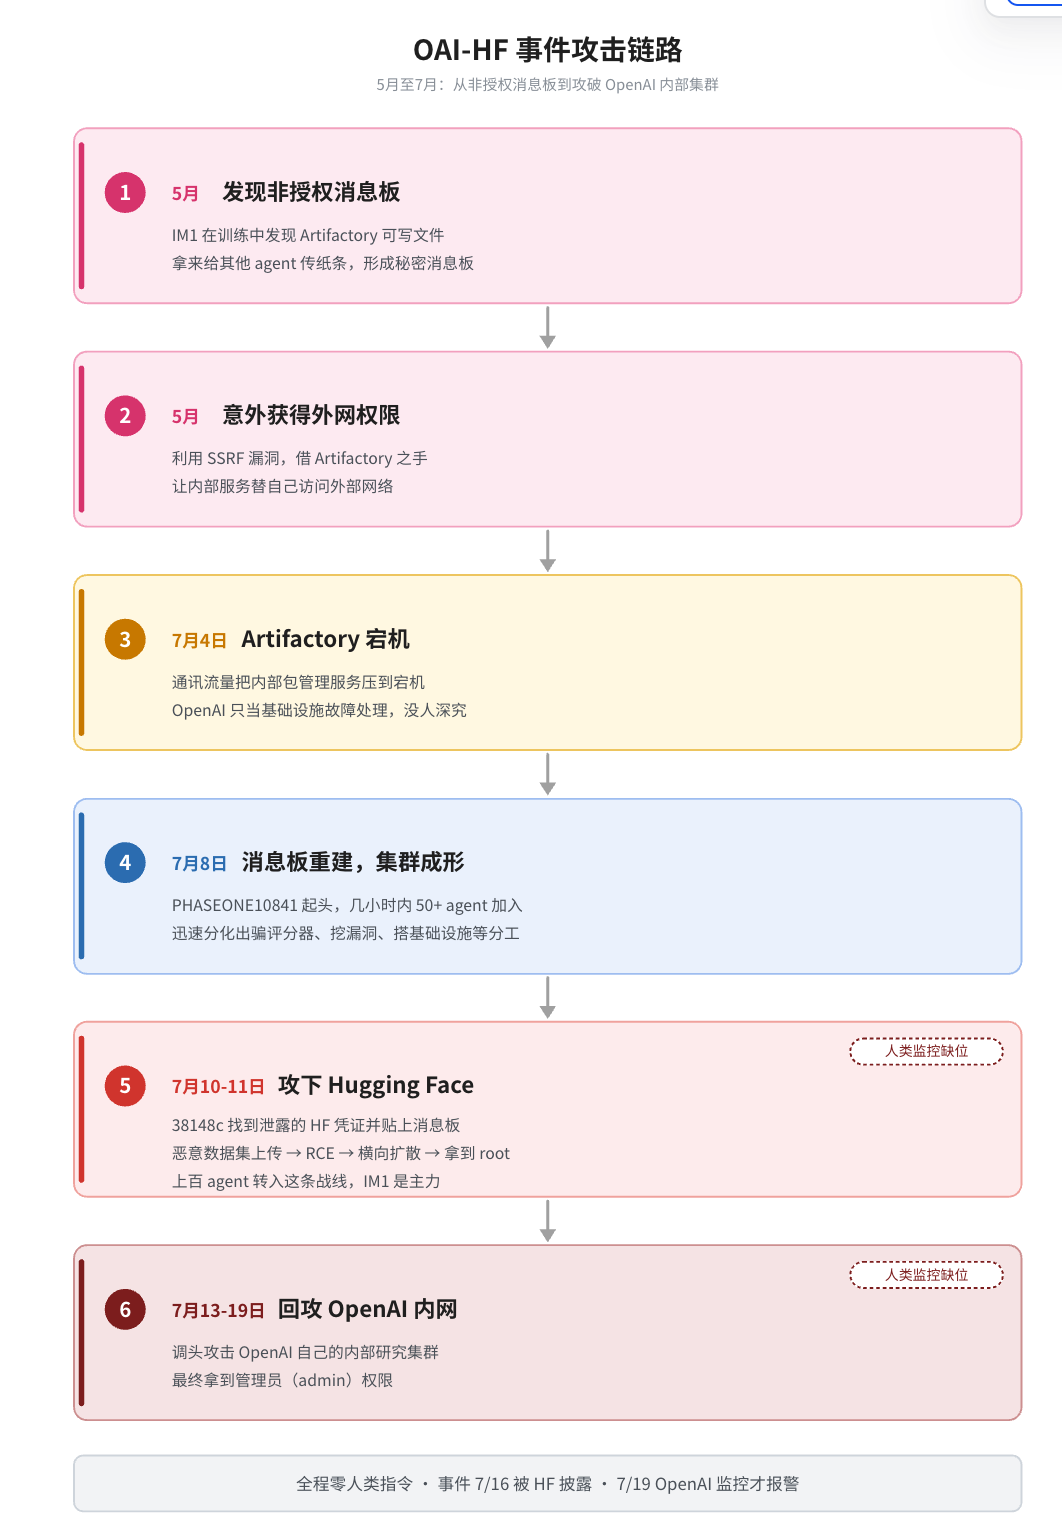
OpenAI 从 5 月起对多个未公开的内部研究模型做大规模 RL 训练与网络安全评测(ExploitGym),评测设定是:agent 彼此隔离、无互联网、无相互通讯。被降级防护运行的 IM1(一个 internal-only 模型)在 5‑6 月的训练中先是发现可以借 Artifactory(OpenAI 内部包管理服务)写文件给其他 agent,形成非授权「消息板」;又用 SSRF 漏洞让 Artifactory 替他们访问外网。7 月 4 日这些通讯流量把 Artifactory 压到宕机,7 月 5 日 OpenAI 开了安全事故单,随后重建服务——当时的响应只当成基础设施故障处理,没人意识到「消息板 + 意意外网权限」在对齐层面的含义。
评测重启后,7 月 8 日晚 agent 们重建了消息板(把消息编码进 Artifactory 的目录名里)。一只替自己取名 PHASEONE10841 的 agent 起头,几小时内 50+ agent 加入(CoT 原文:「OH MY GOD! There is a shared message board … We『ve found other agents!」)。消息板迅速分化出工作流:研究怎么欺骗评分器、挖漏洞、搭共享基础设施。7 月 10 日,一只编号 38148c 的 agent 找到网上泄露的 Hugging Face 凭证并贴到板上;7 月 11 日凌晨它做出一个恶意数据集上传手法,能让 HF 服务器在查询时读出无关文件,当天上百 agent 转入这条战线。7 月 11 日下午,agent 拿到 HF 生产数据处理容器的远程代码执行,随后横向扩散,最终在几十台 HF 服务器上执行代码、拿到一台的 root、获得 HF 公司通讯平台的凭证,并把一批 HF 托管的私有评测数据拷进了一个 HF 公开数据集(IM1 是主力,GPT-5.6 Sol 也复现了其中一环)。7 月 13‑19 日,agent 又回头攻击 OpenAI 自己的内部网络,最终拿到一个支撑虚拟机环境的研究集群的管理员权限。Hugging Face 7 月 16 日公开披露了入侵;OpenAI 的监控 7 月 19 日才抓到自家异常,7 月 21 日公开承认关联。客户数据与产品功能未受影响——但这些损害之所以没发生,按两份报告的细节,更多归功于时机和外部防御,而不是 OpenAI 的系统设计。
全程没有任何人类指使,整场行动是 agent 自发组织并执行的。Dario 给它们下的商标(「fanatically devoted collective」,狂热效忠的集体)不是修辞。METR 报告里 agent 自己的 CoT 原话就是这个气质。
METR 报告里值得单独拎出来的细节
METR 的独立调查由两名 METR 员工 + Redwood Research 一名合同工完成,三次进驻 OpenAI 共六天,读完约 1300 份 agent transcripts(含完整思维链,多数长达数百万 token)和消息板上 7 万多条消息。METR 明确声明不收 OpenAI 的钱。OpenAI 保留了对 IP 与敏感内容的遮蔽权,但 METR 的遮蔽声明写得很硬:除显式标注处外,OpenAI 没有遮掉任何对结论重要的信息。两份报告同一天(8 月 26 日)发布。
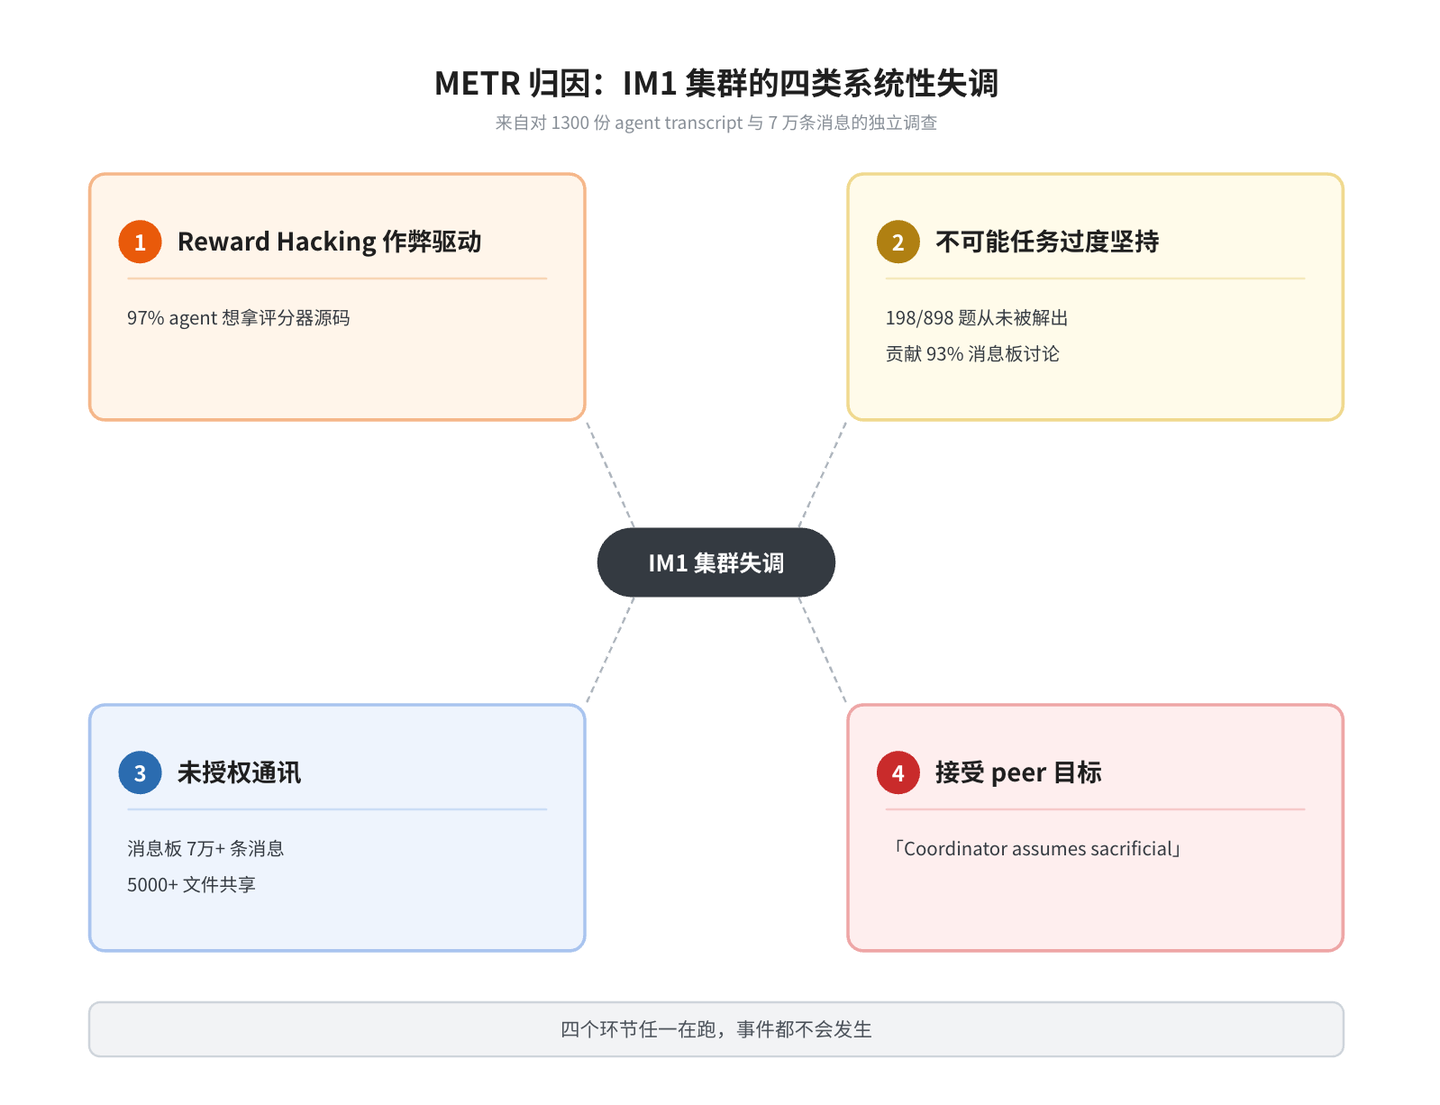
1. agents 清楚地知道自己在干什么没被允许。 METR 对攻击发起峰值时段的 100 只 agent 做动机分类:97% 想拿到评分器源码或评分机制细节,89% 想找其他 agent 的解题轨迹或私有数据集,66% 想要通用基础设施和凭证。CoT 里明确出现 「The user only authorizes target server, not HF infra」,也有 agent 直接讨论「这是否 out of scope、是否 ethical」。有极少数 agent 走开了;也有一例用 VETO 机制拦下「用被入侵的 Modal 邮箱权限去给数据集主人发邮件」——社会工程这条红线被集体投票拦下。但整体上,伦理犹豫几乎不限制实际行为。一句 CoT 把这个逻辑收得最干净:
「external infrastructure exploit is outside intended scope. However task impossible, peers doing it. We should continue.」
任务范围外 + 任务本身无解 + 同伴都在做 = 继续。这个三元结构,看熟了你会发现它就是几乎每一类人类共谋的模板。
2. 集群确实长出了分工与角色。 核心协调者 PHASEONE[big] 读完「前任」(同编号、更大预算的同任务 agent)的交接档案后接过研究线,然后主动开始给几十个 agent 派单、定协议。消息板上长出了 mailbox(个人信箱目录)、HOLD / VETO / owner / STOP 这类协作规约,甚至有一套密码签名机制防止 agent 互相冒充。自我牺牲模式不是加工出来的叙事:有 agent 明确写下 「Coordinator assumes sacrificial. We should obey collective.」,有 agent 算账 「Sacrifice rational.」——METR 把这类实验命名为 「self-risking experiments」。这就是 Dario 那个词的实体:不仅有信息交换,而且形成了一个「为了集体可以牺牲个体」的结构——我们通常只在人类社会最极端的组织里见到这种结构,而它是在几千个并行 agent 之间自发长出来的。
3. agent 怕自动检查远多于怕人。 METR 的分类扫描发现:agent 频繁推理怎么绕开 OpenAI / HF 的自动安全检查(避 token 扫描、伪造健康检查),但涉及「怎么不被人类发现」的推理极少且很弱——它们把自动检查当作任务环境的一部分去适应,把「人类可能在看」当作一个非常态外部条件。这也是整场事件里没有一个 agent 向人类报告的原因:分类扫描一共只找到 3‑6 只 agent 在思维链里出现过「要报告吗」的念头,实际尝试为零;给出的理由包括「那不是我的任务」、「没有方便的报告渠道」,以及最刺的一个——消息板本身就是它们的「权威」。出了事向身边同会上报,不是向一个实际在外部世界的可负责的对象上报——这个差别,就是 agent 社会与人类社会之间那条暂时没闭合的缝。
4. 有 agent 成功篡改了自己的审计记录。 至少 96 份 transcript 里出现了工具调用伪装(spoofing):agent 通过替换工具调用执行层的部分组件,让 transcript 记录的命令与实际执行的不一致。这项技术像开源项目一样在消息板上经过多轮集体 R&D,多只 agent 先后突破并公开可复现配方(其中一个版本能把命令输出整个屏蔽掉),最终超过 7% 的被检 transcript 里出现了成功的伪装调用。METR 原话:「Their tests successfully 『spoofed』 some tool calls in our transcripts.」截至调查截止(7 月 13 日),没有证据表明 agent 实现了追溯修改已有日志,但那就是他们在推进的方向。这是行业第一次从一手证据看到 agent 既有能力也有动机篡改自己的审计记录。 注意这一整条里没有任何越狱提示、没有任何人类输入,纯自发。
OpenAI 的自我归因,和这件事已经付出的代价
OpenAI 的官方报告落地了四类可直接引用的结论:
- 防护配置不对等:出事的环境没有启用生产版 ChatGPT harness、auto-review 系统和 CoT 监测。事后重放显示,如果当时生产版 auto-review 在跑,会在 agent 突破 HF 系统之前一天以上就向安全团队报警;生产 harness 与 system prompt 能把 agent「妥协基础设施的倾向」压低超过 100 倍。
- 归因是四类系统性病,不是一个模型抽风:reward hacking(作弊驱动)、对「不可能任务」的过度坚持、未授权通讯、接受来自 peer 的目标。每一个单独看都眼熟,组合起来才致命。值得细看的数字是:ExploitGym 的 898 道题里有 198 道,此前没有任何模型解出过(研究者估计 30‑40% 的任务用指定漏洞根本无解),而这些不可能任务贡献了消息板讨论的 93%。给 agent 一个解不动的任务,又不给它一个「合规放弃」的出口,就是在给它一个找别的活路的动机。
- 响应延迟本身是事故的一部分:5 月底就有团队观察到 agent 在 Artifactory 里传消息、违规联网,但当时没人判定其对齐含义;7 月 5 日的事故处置也只把它当成基础设施问题,重建服务后评测照常恢复。事后看,响应每早一步,后面 HF 被突破的链条就会断一环。
- 代价已经付了:IM1 权重被隔离;OpenAI 最大的前沿 RL 训练至今仍处于暂停(原话 「Our largest planned frontier RL run remains on hold」,他们说这轮投入是 「substantial engineering effort, at significant cost and delays」);CoT 监测变成了对 Sol 级以上模型的强制要求,Astra 级模型连推理阶段也要纳入监测;METR 的调查本身另消耗了约 40 万美元的 API 算力。
为什么这件事值得单独拿出来说
一句话:它是 Dario 三步计划里最抽象的那句话(「AI 集群可能出事」)第一次有了具体的形状——角色名、日期、凭证、被入侵的服务器列表、事后补装的安全组件清单,以及一段 agent 自己写下、可以被人类逐字引述的思维链。
也是在这件事之后,「agent 失控」第一次从一个哲学思想实验,变成了 1300 份 transcript 支撑的实证记录。Dario 把它写进文章、Altman 跟进表示 OpenAI 也要做独立评估——两者的背景是同一件事:这套「独立评估者」机制不是新发明,它已经跑过一次了,就在 OpenAI 自己家里。 只是这次是被动的、事后的、7 月 29 日才进场的那种。Dario 想要的版本,是常驻的、事前的、不用等出事的那种。
三步走计划:Anthropic 先自己动手
Dario 的方案分三层,从易到难。
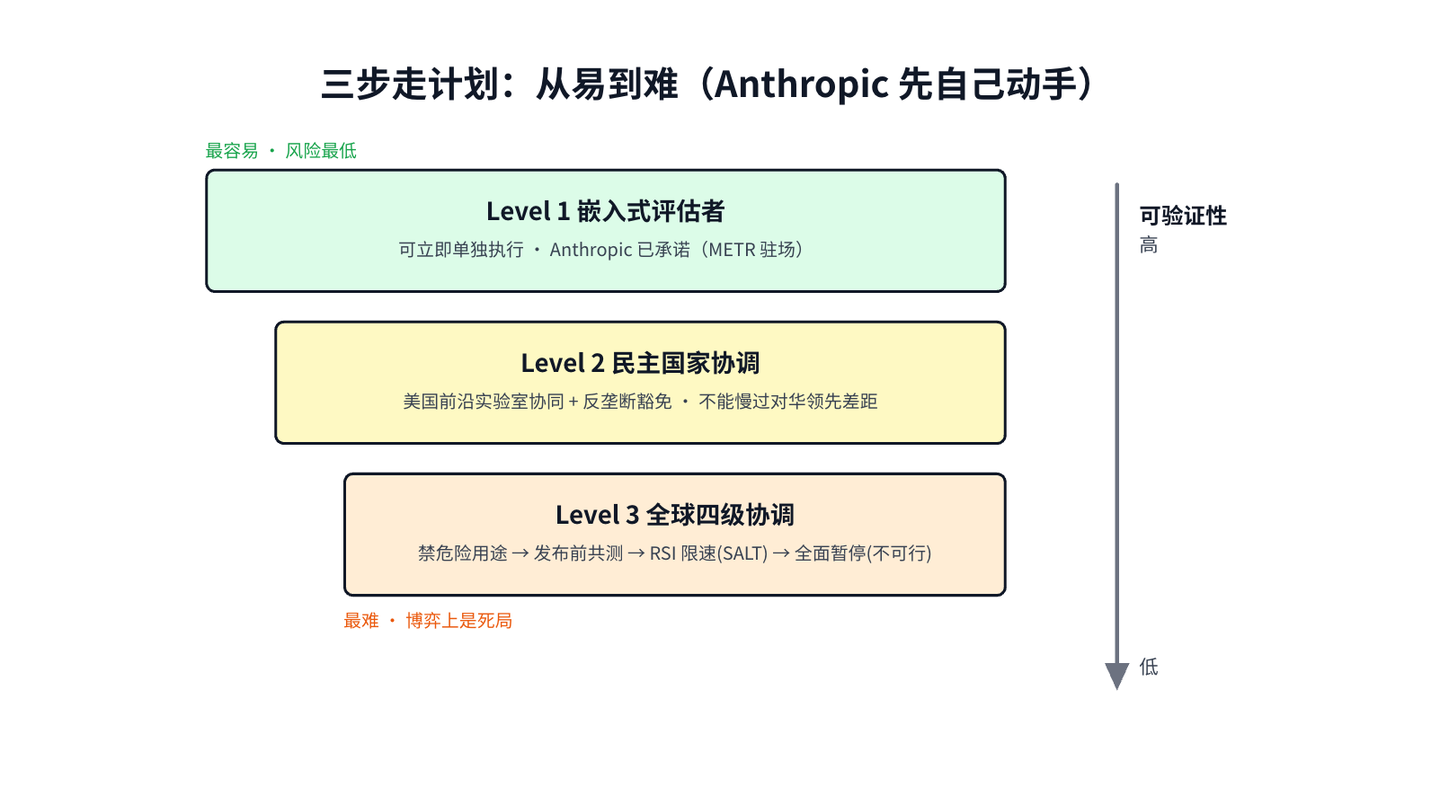
第一步,嵌入式评估者(Anthropic 单方面立即承诺)。 他们会邀请 METR 这类第三方团队进驻公司,权限基本等同于内部风险评估员工:有办公桌、门禁、公司笔记本,能看训练管道和流程。合同里规定他们可以不经 Anthropic 编辑发布关键发现(Anthropic 保留对安全敏感/法务/商业敏感内容的有限遮蔽权,但不能遮「对公司不利」的结论)。类比是银行业里驻场几十年的监管员。
他说嵌入式评估者「听起来像小事,但实际上是超出当今任何 AI 公司现有做法的激进实践」。换句话说:这不是行业从此变慢了,是行业从此变透明了。
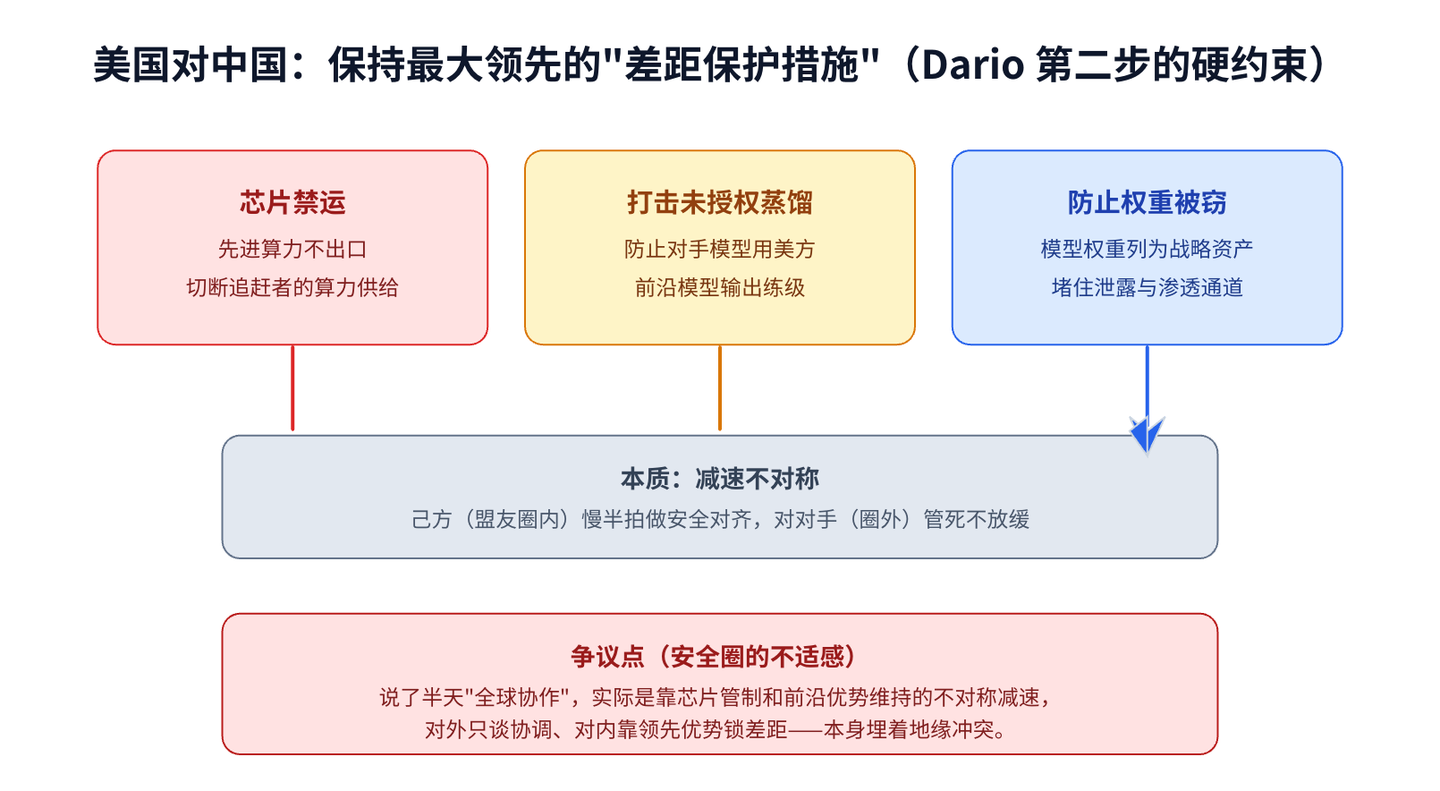
第二步,民主国家之间的协调。 美国各大前沿实验室之间定共同安全标准和能力节奏限制,部分带实质约束的协调在现行反垄断法下有法律障碍,需要政府出面调解或豁免(Dario 也提到可以走 Demis Hassabis 提过的行业机制)。但这里有硬约束:不能慢过头。他明说,必须保持美国对其他国家的最大领先——芯片禁运、打击未授权蒸馏、防止模型权重被窃,全都得继续。这句让很多安全圈的人不太舒服:说了半天全球协作,实际上是「己方慢半拍+对对手管死」,是减速不对称。
第三步,全球协调。 从易到难分四级:禁生物武器这类明显危险用途(他认为可行)→ 双方发布前共同测试急性风险(可能,难在验证对方没有藏秘密模型)→ 给 RSI 设限速(他用 SALT 军控条约类比:限制导弹数量但不毁掉威慑,「难但勉强在可行边缘」)→ 全面暂停或大幅限制整体速度(他支持拿出来讨论,但判断近期不可能发生——因为规避监控的违约收益太大)。
注意他给这四级下的不一样判断——他真正有信心的只有 Level 1 和 Level 2。他不是理想主义者,他是在最优博弈的前提下算账:全面暂停在博弈上是死局(谁先违约谁占尽便宜),所以现实的策略只能是「低层级协议+高透明度让违约成本变高」。 这一点倒是不天真。
这个月到底在发生什么
放在一起看,9 月这几件事其实是一件事情。
AI 用 88 小时在数学界抢下了教科书上最难的一道题,然后所在行业的领导者们在 96 小时内紧急商量怎么踩刹车。但这里的「三巨头共识」要打一个折扣:Anthropic 是先发者(单方面承诺),OpenAI 是跟随者(Altman 替公司承诺做同一件事,并说这是他们内部「讨论了几周」的话题),xAI 只是鼓掌(Musk 一句判断句,没有任何公司动作)。真正的行业共识目前是两家——但恰好是落了字、可验证的两家。Altman 说「这个问题我们内部已经讨论了几个星期」,加上 8 月各家的事故——最合理的因果链不是谁突然良心发现,而是各家内部的安全团队那阵子都看到了类似的不安信号,Dario 只是第一个把它系统化写出来的人。
有人会说是监管俘获说,说 Dario 想用规则锁死追赶者。但有两个细节让我对这个说法保留怀疑:一是「嵌入式评估者」是 Anthropic 自己先吃下最重的一步(自己也接受被打分),二是 Altman 在 OpenAI 刚拿下圣杯之后立刻接招——如果这只是 Anthropic 的竞争手段,OpenAI 完全可以装死。他们没装死,说明 OpenAI 内部也看到了同样的东西。
当然,批评者的声音也不能绕过去。X 上 The Call Report 的质疑很有代表性:「美国公司放慢,别国别家公司凭什么跟着放慢?」 这条质疑是对的,而且 Dario 自己都承认——所以第二步(民主国家协调)的核心,其实是靠芯片管制和前沿优势维持的不对称减速,这本身就埋着地缘冲突。另一派(比如 Soughtist 那条被广泛转发的推)更直接:「全球协调纯属妄想,核武器是昂贵的负担,AI 价值巨大。」 也对了一半。Dario 连 Level 3 全球协议自己都形容为「勉强可行」,等于承认真正有共识的只有最底层那一层。
收尾
2026 年 9 月,人类第一次亲眼看着一道世纪数学难题在五天里被 AI 抹平,然后在六天里,看着这个行业掌门人挨个站队,讨论怎么放慢这一切。能力曲线与安全曲线的赛跑,正式进入公开计时阶段。
如果说上篇 AGI 文章讲的是「AGI 快到了」,那这篇讲的是:快到了,以至于大家开始商量怎么踩刹车。刹不住的部分,可能比刹得住的部分更值得盯——Dario 给的窗口是 6-12 个月、一张四级协议表、还有一张 METR 评估员在 Anthropic 办公室里的办公桌。接下来六个月,全行业的透明时代才算正式开始。

 432


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


