爬虫杂记1

微信小程序获取用户手机号全流程实战(附完整代码) 本文详细介绍了微信小程序获取用户手机号的全流程实战,包括前端授权、后端解密及安全合规要点。通过传统授权按钮和新版手机号快速验证组件两种方案,帮助开发者高效实现功能,并附完整代码示例。重点解析了微信小程序接口的使用技巧和常见问题解决方案,确保数据安全与用户体验。 阅读详情

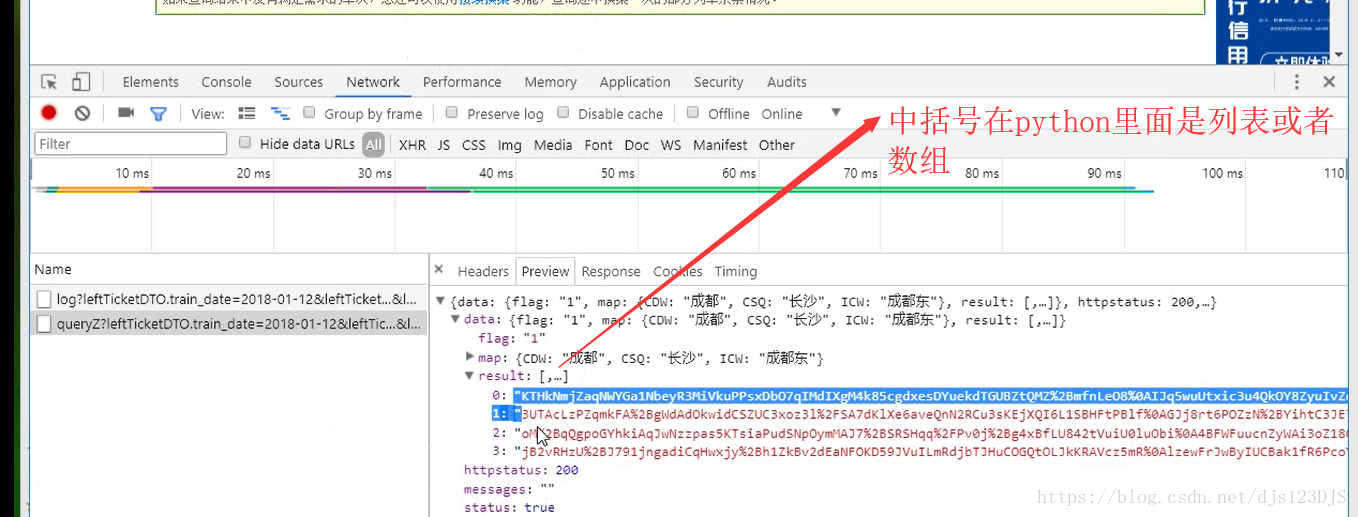
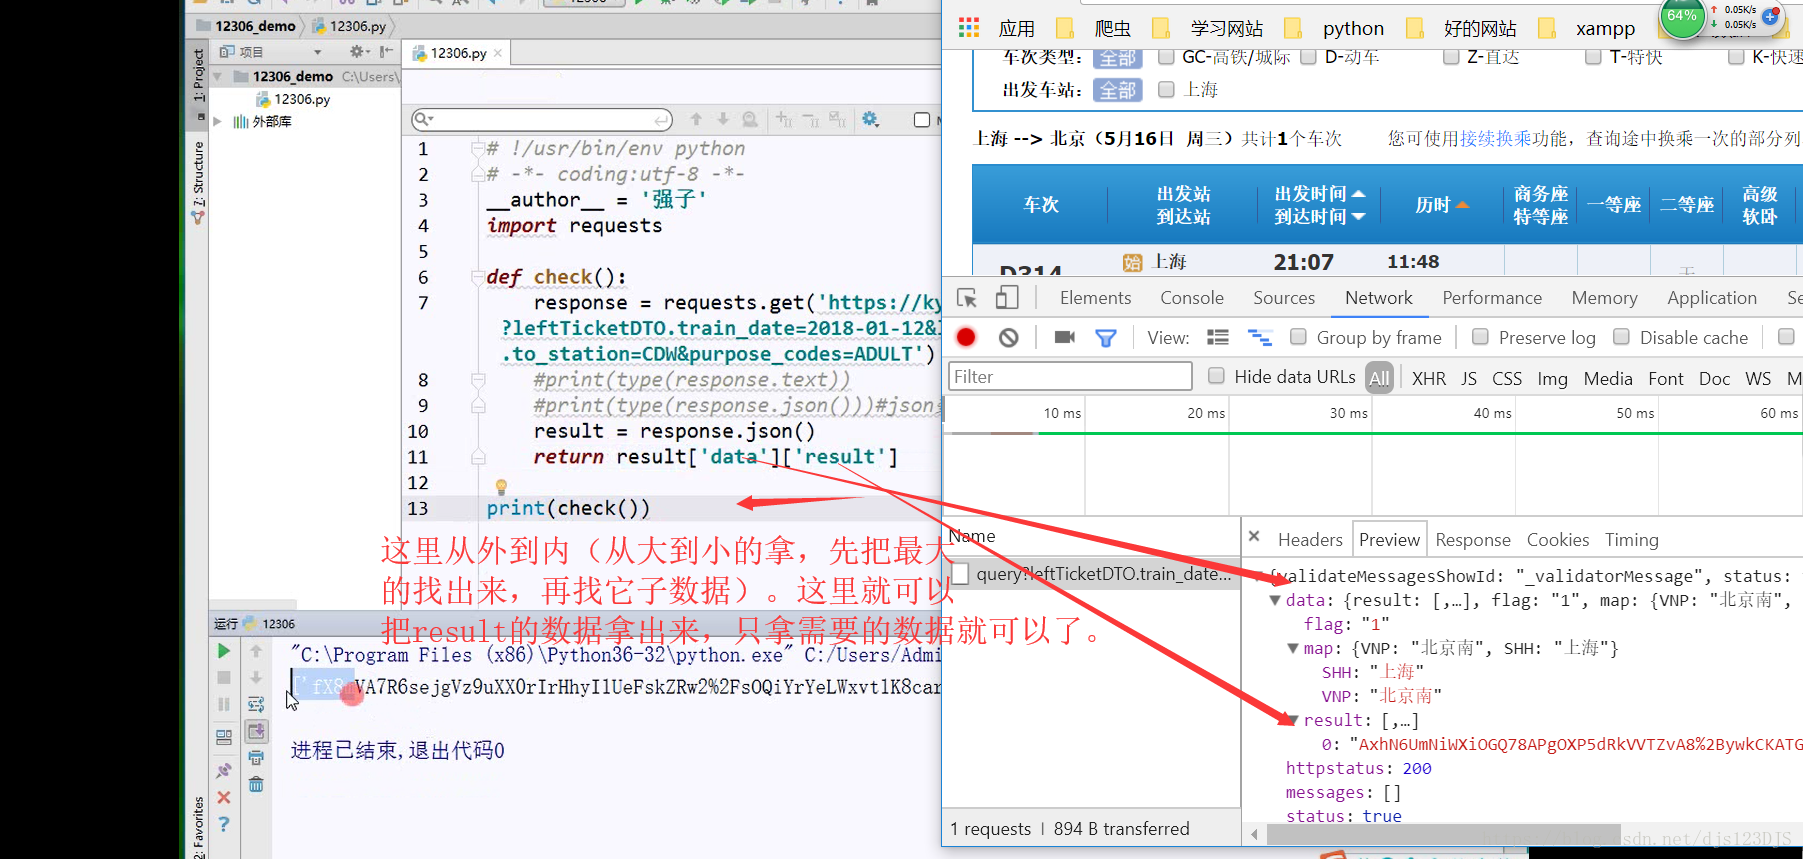
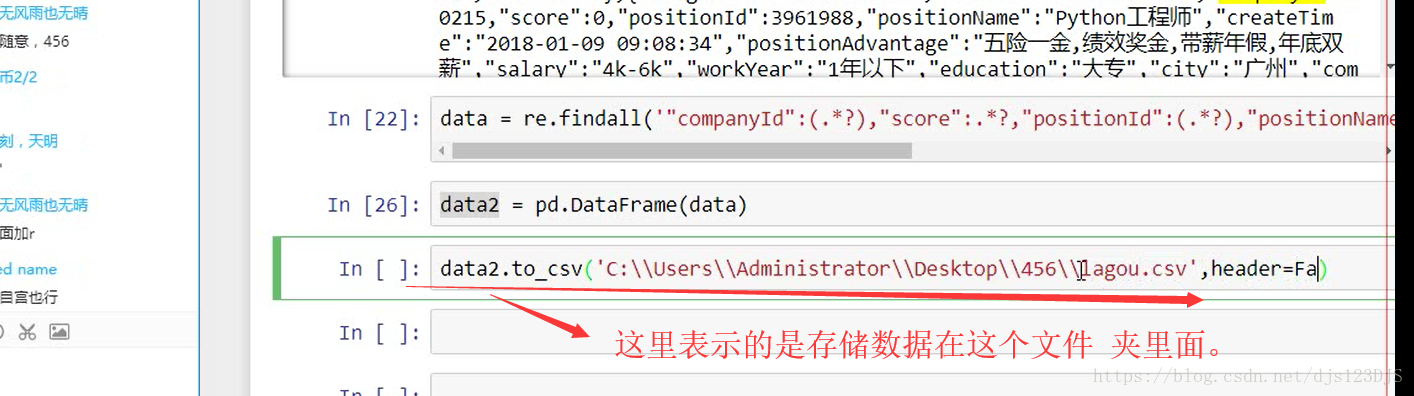
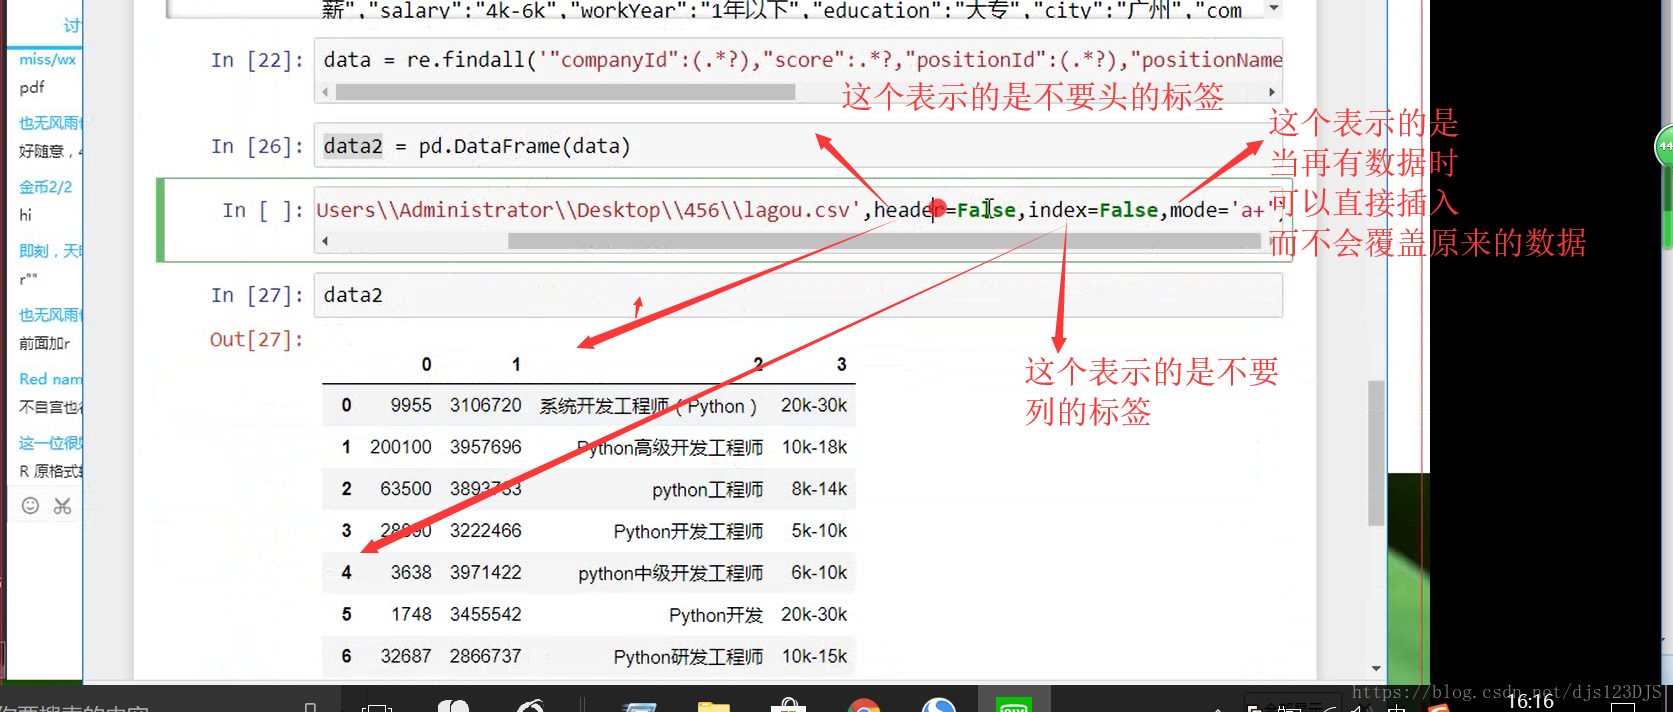
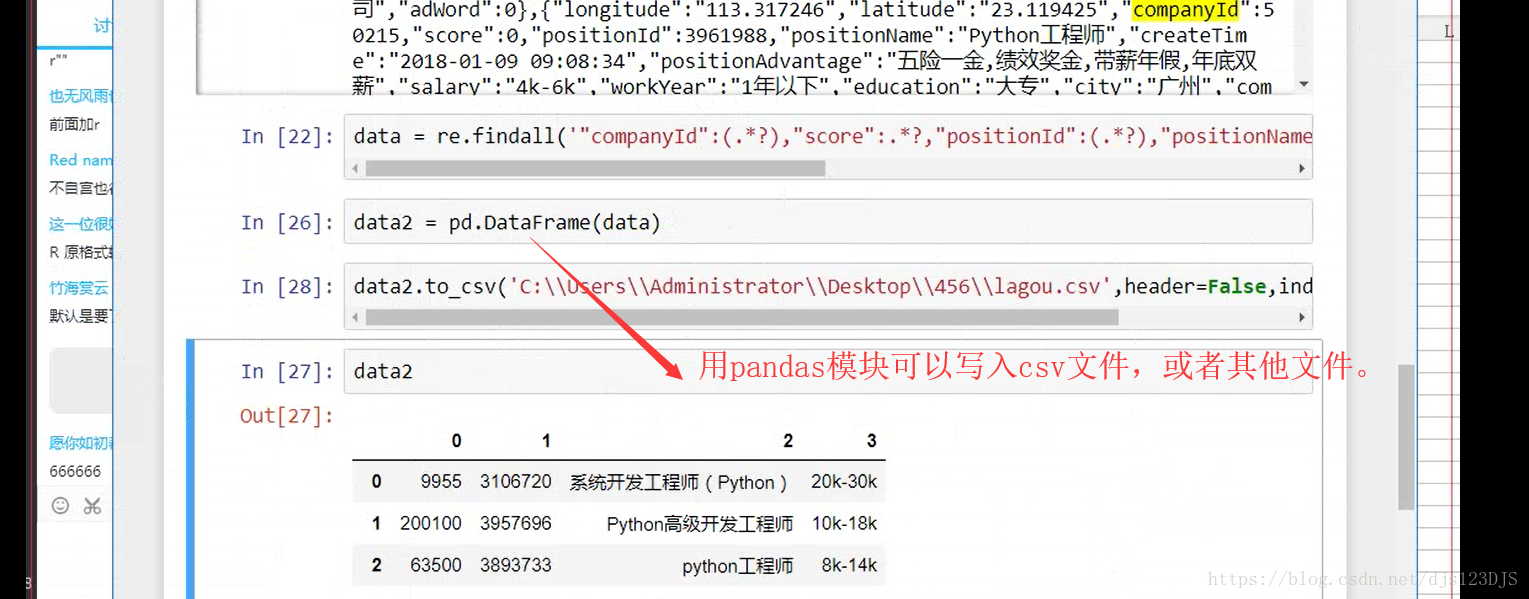
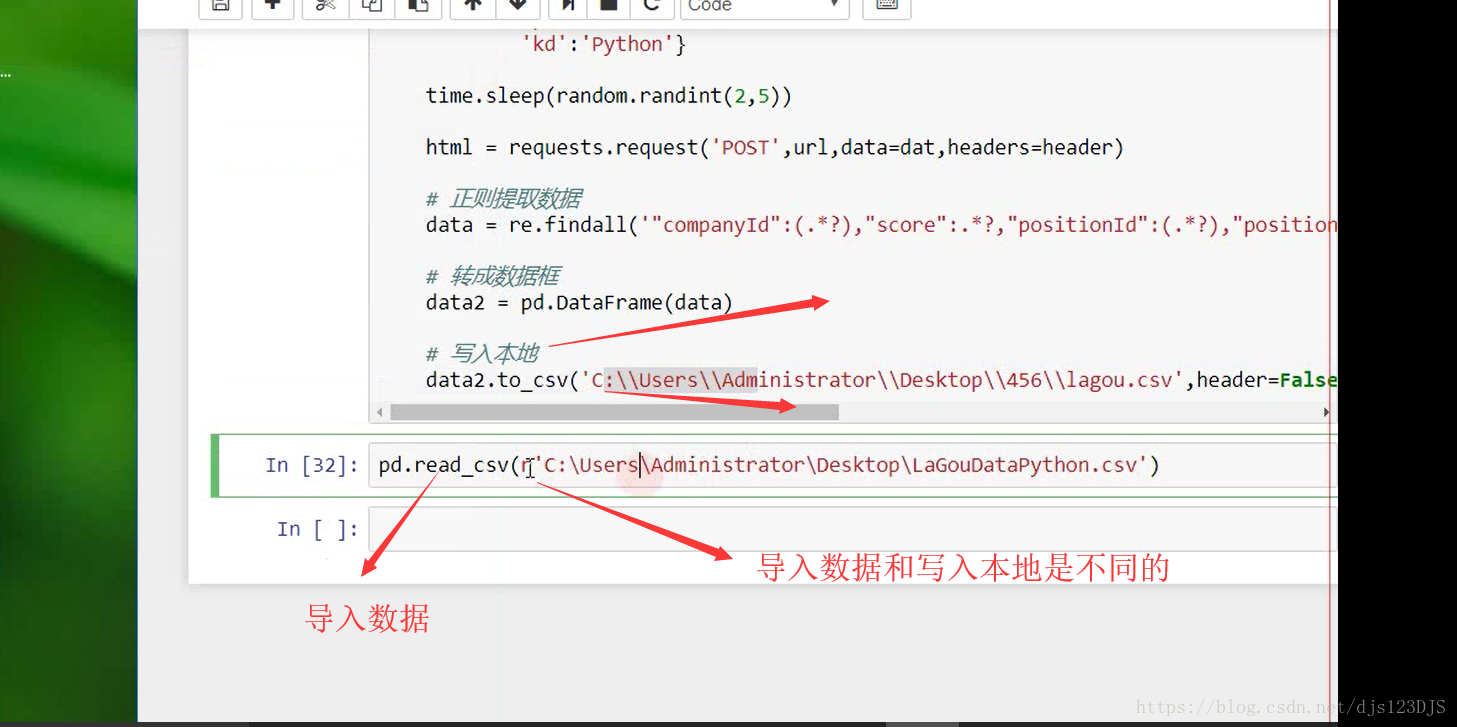
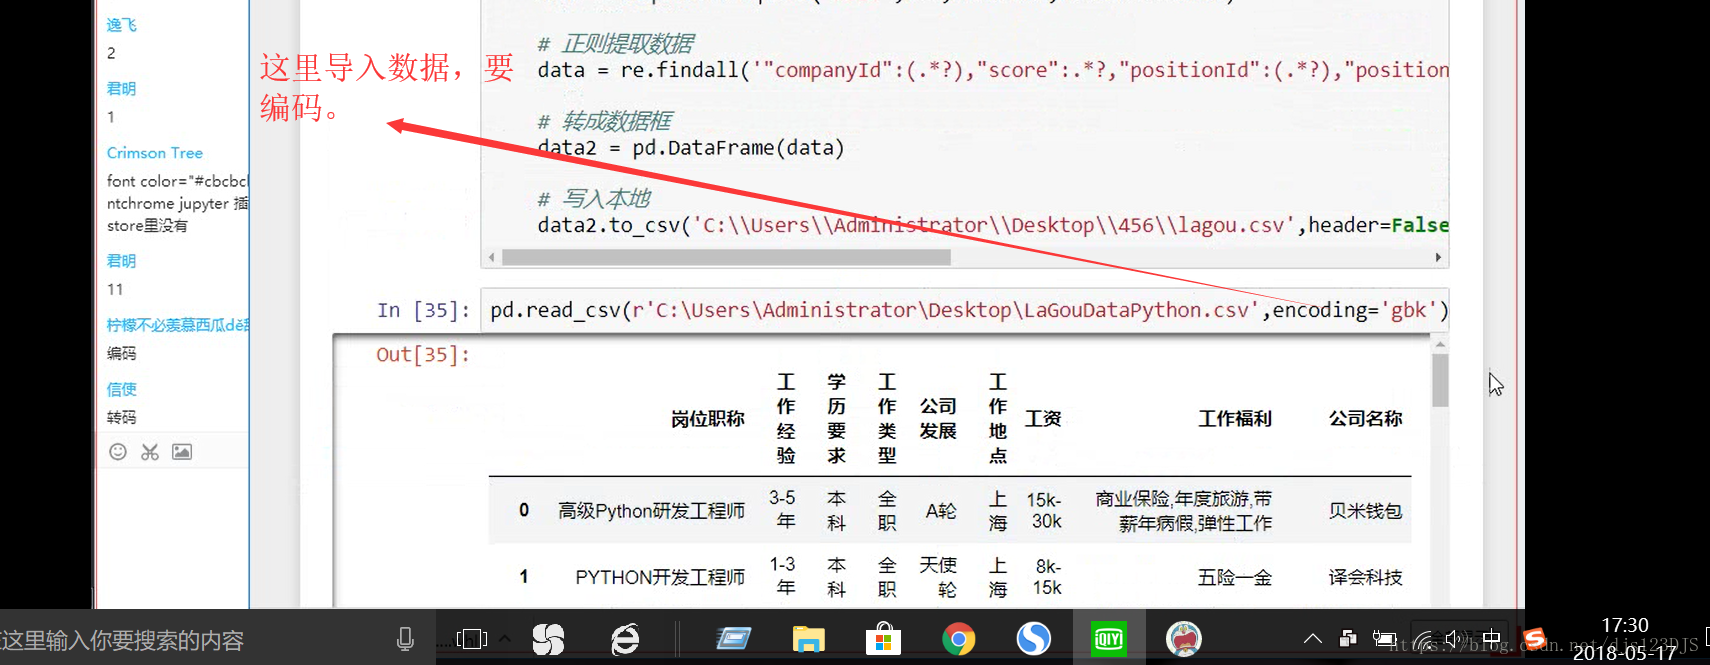
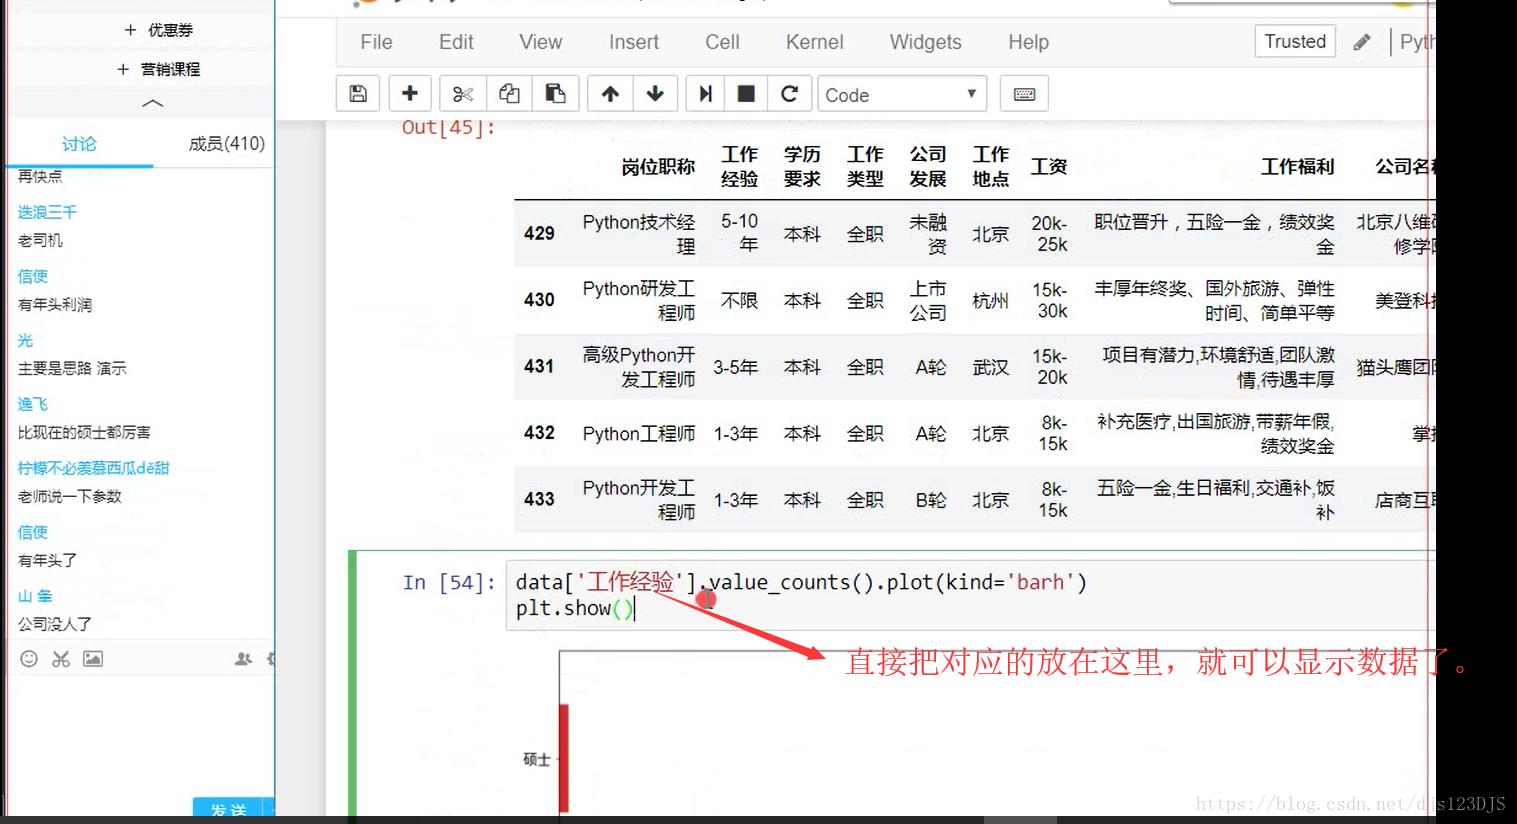
     计算机上面的东西如果你不把它放在硬盘里面,它都是在内存里面,只有这两个硬件可以存储东西,所以爬虫匹配出来的结果如果没有放在硬盘里的,都是在内存 里面。解释工具(匹配)有正则,xapth,bs4,json只能转换成类似字典的数据。免费的代理ip,可用性很差,100个可能也没有一个可以用,并且过期 时间很快。所以一般不用免费的代理。安卓系统和苹果系统都是基于unix或者linux开发的,所以都可以用命令行来操作,后来unix收费了,所以有了后来的Linux。

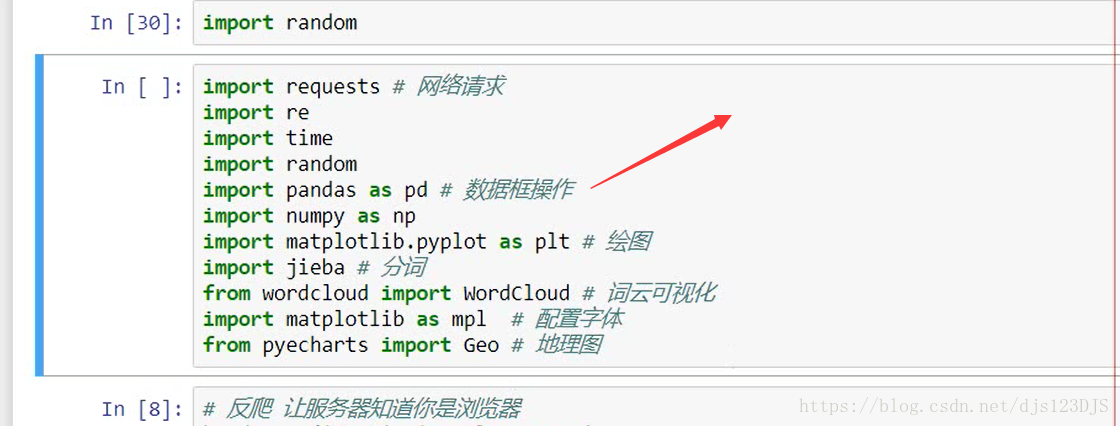
       python写系统命令就直接import os  

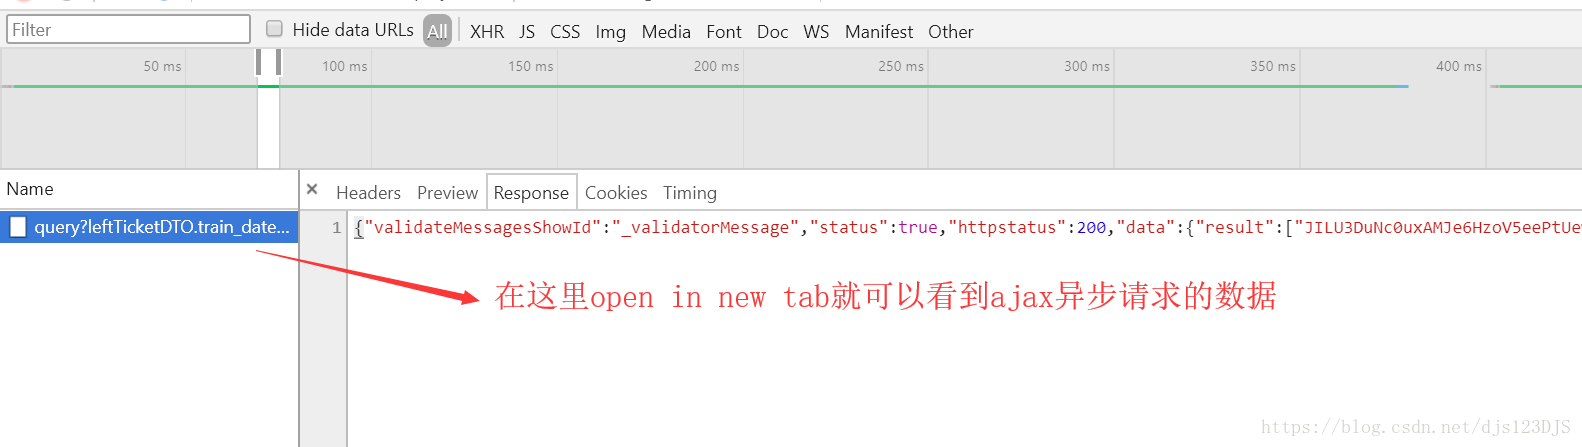
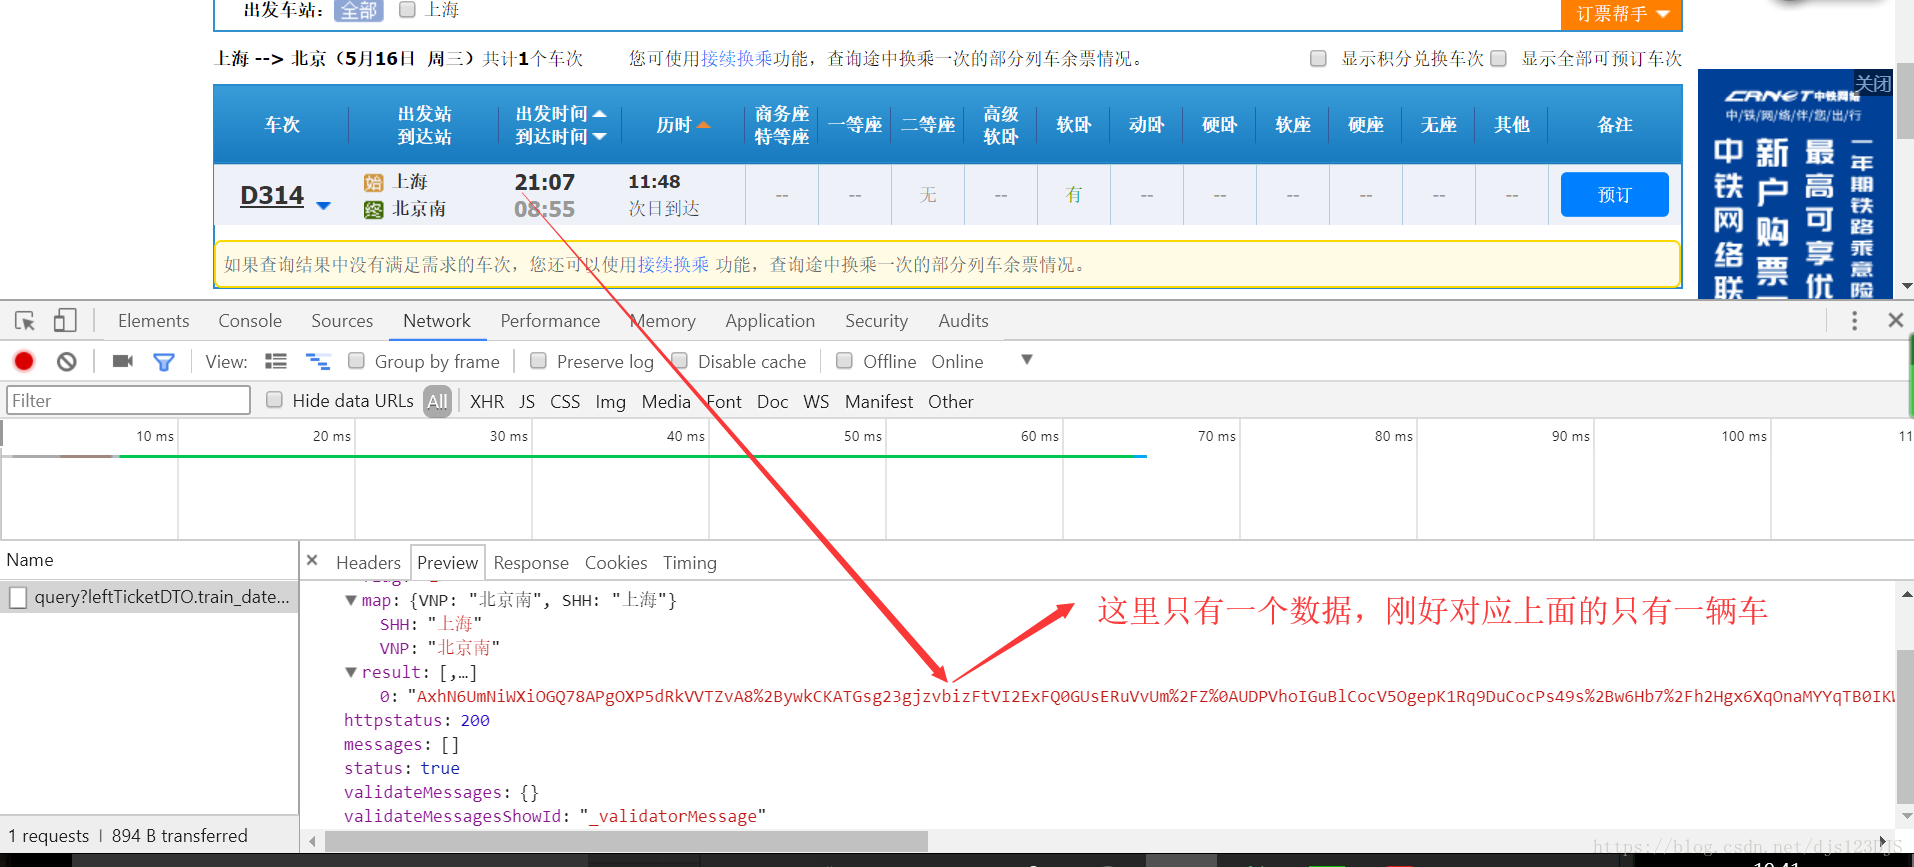
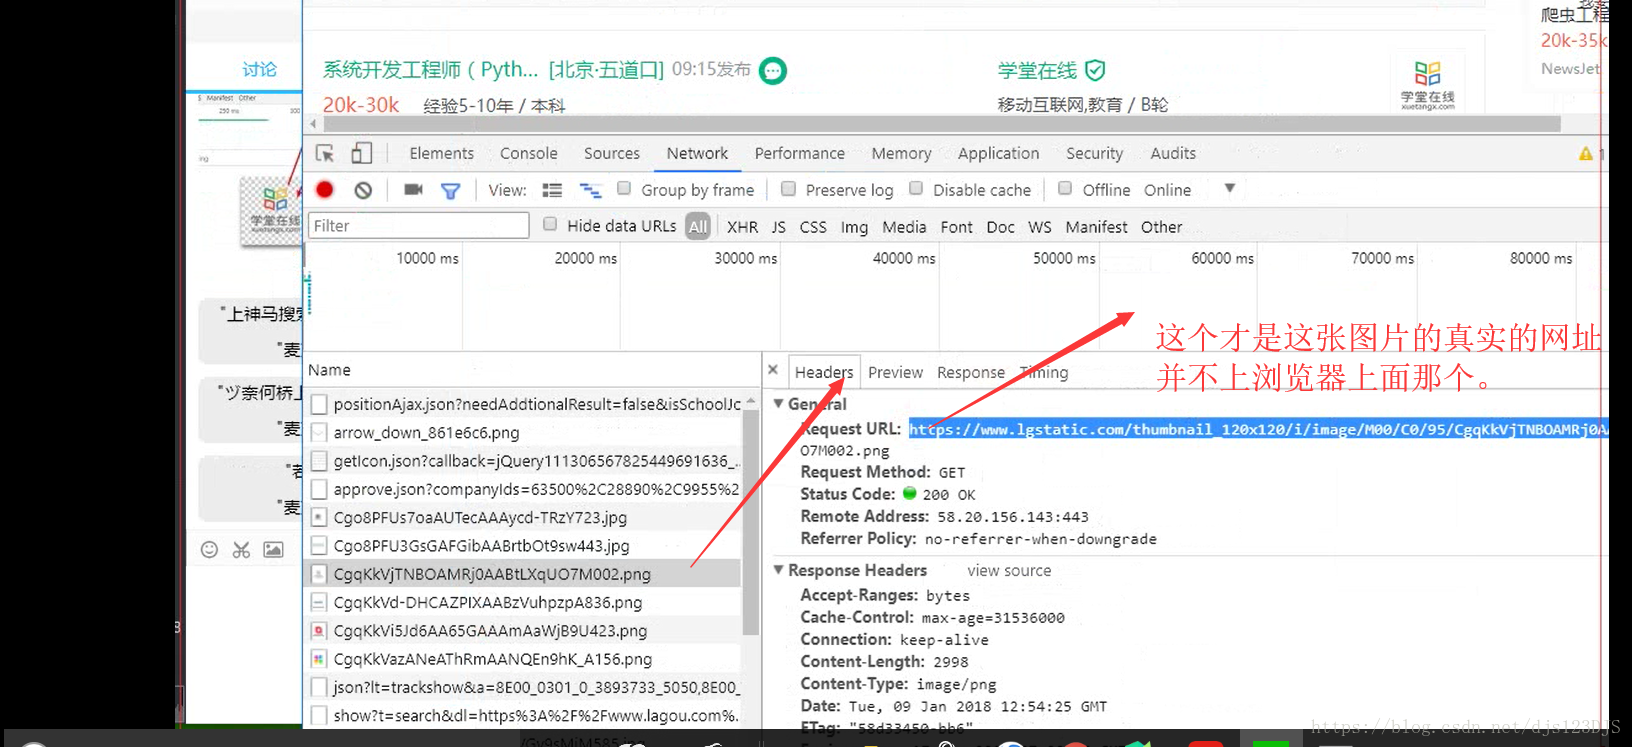
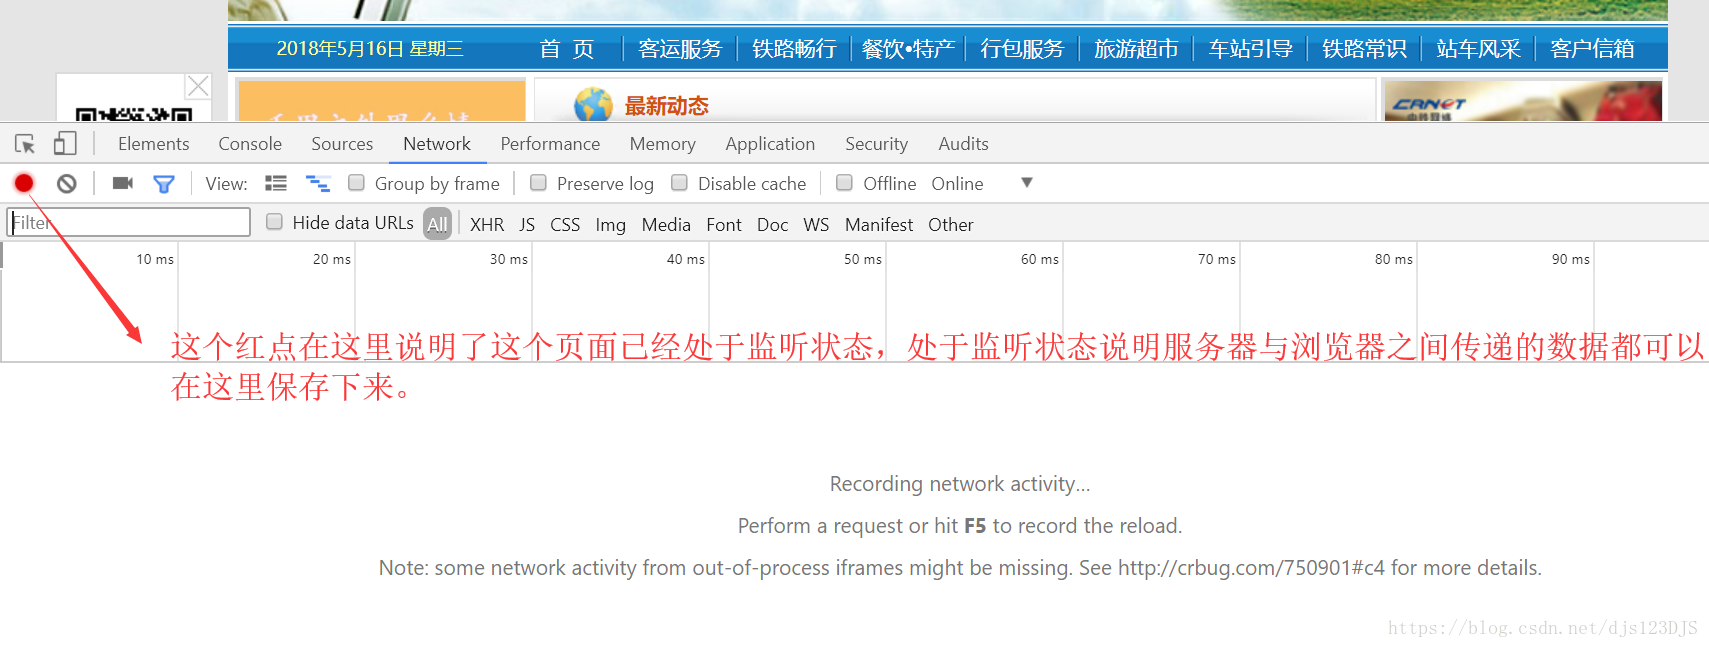
      爬虫的开发流程:分析网页结构---寻找目标数据有三种方法---1.直接通过源代码返回数据,即查看网页 的源代码然后在那里搜索(这种方式有时候是不行的)   2.ajax异步请求动态渲染(加载,显示的内容并没有在那个网页里面,而是在后台或者别的地方)    3.数据混淆(即js加密)

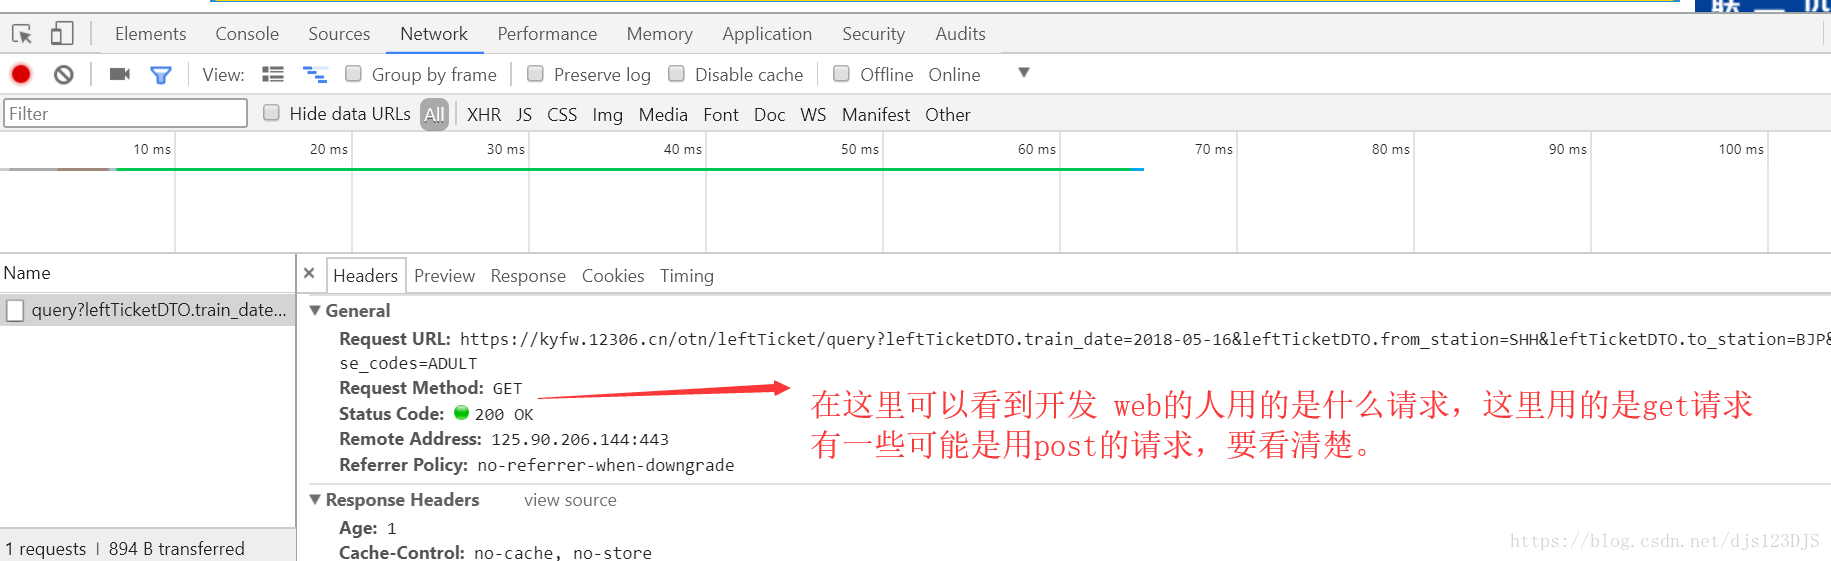
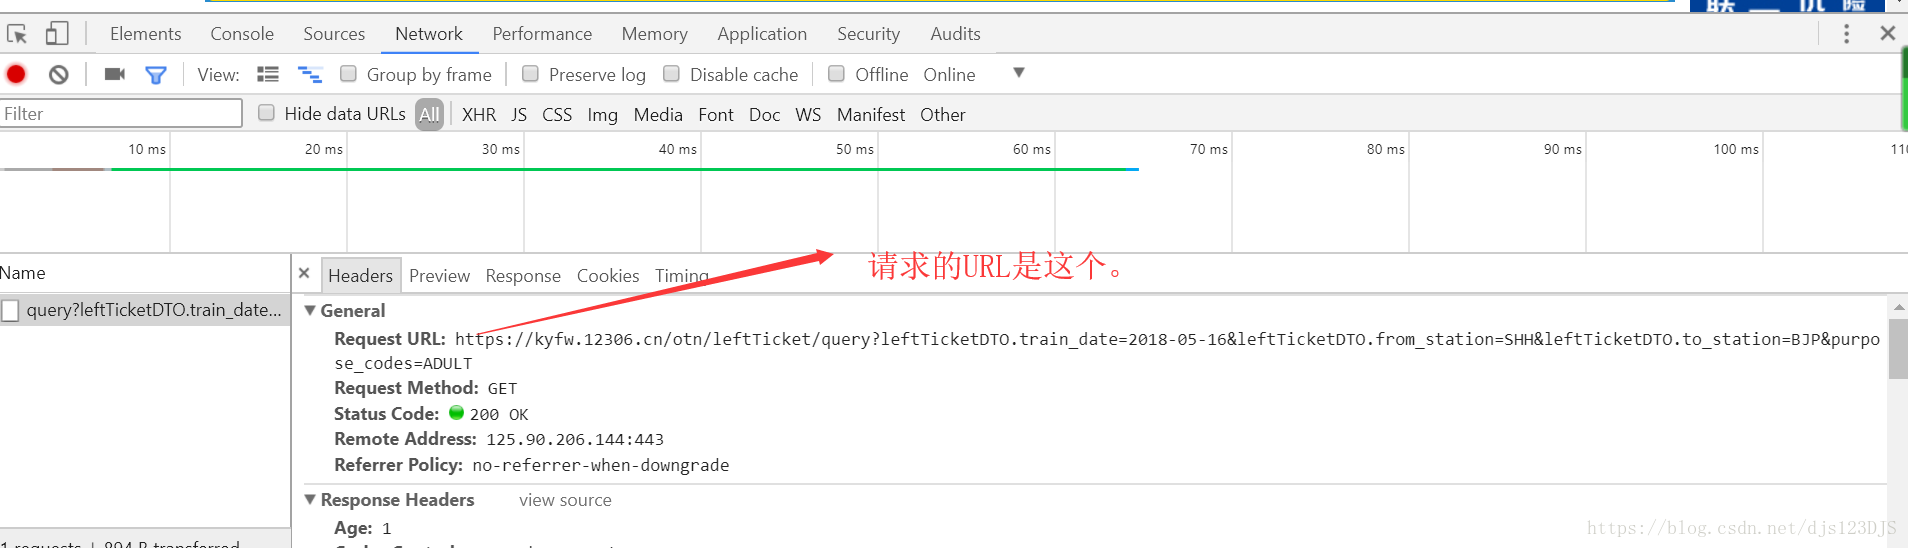
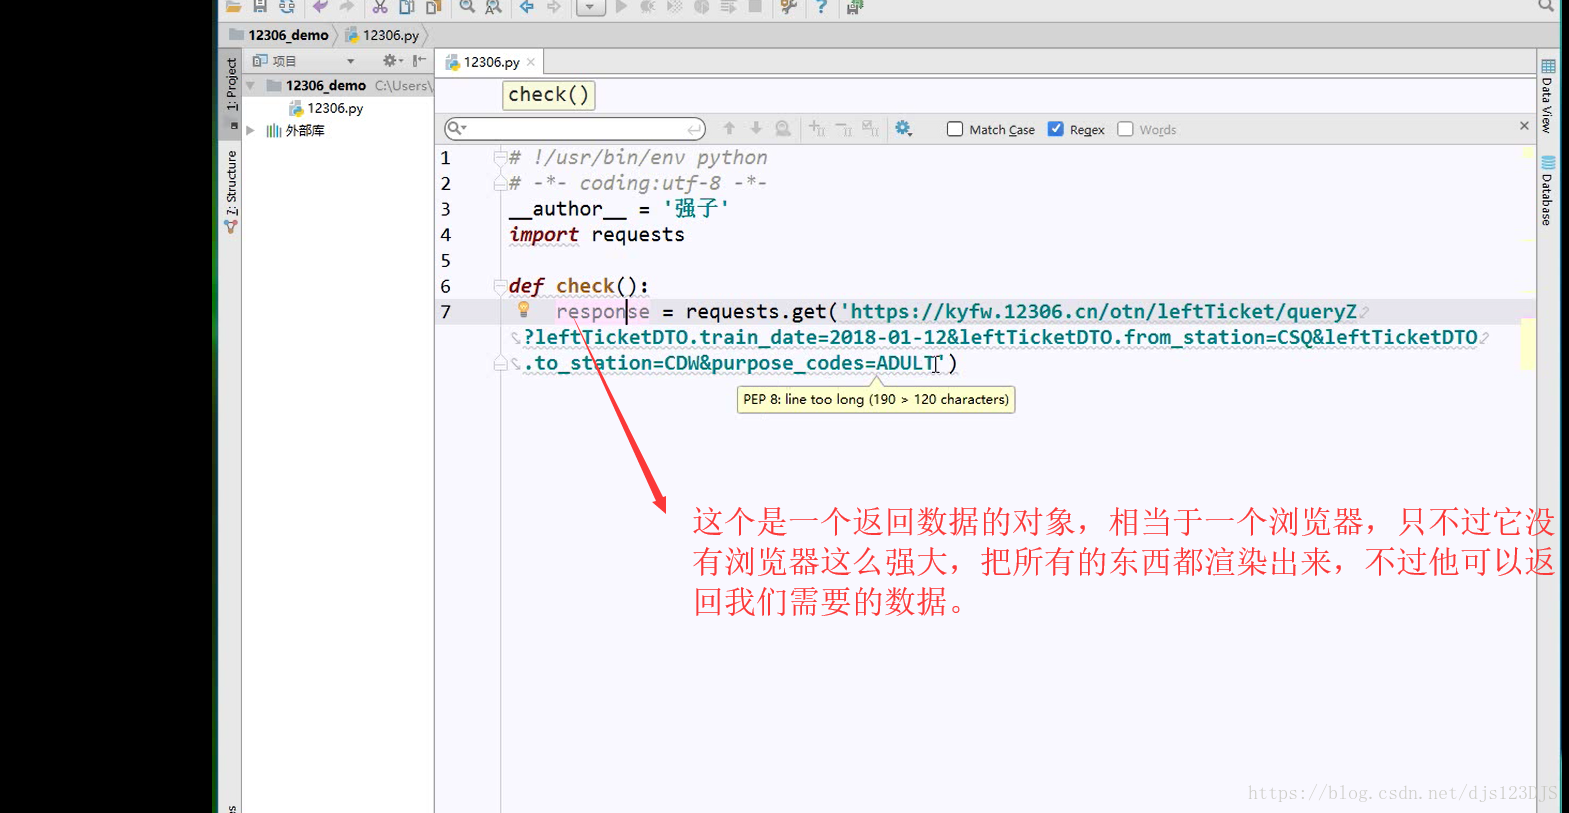
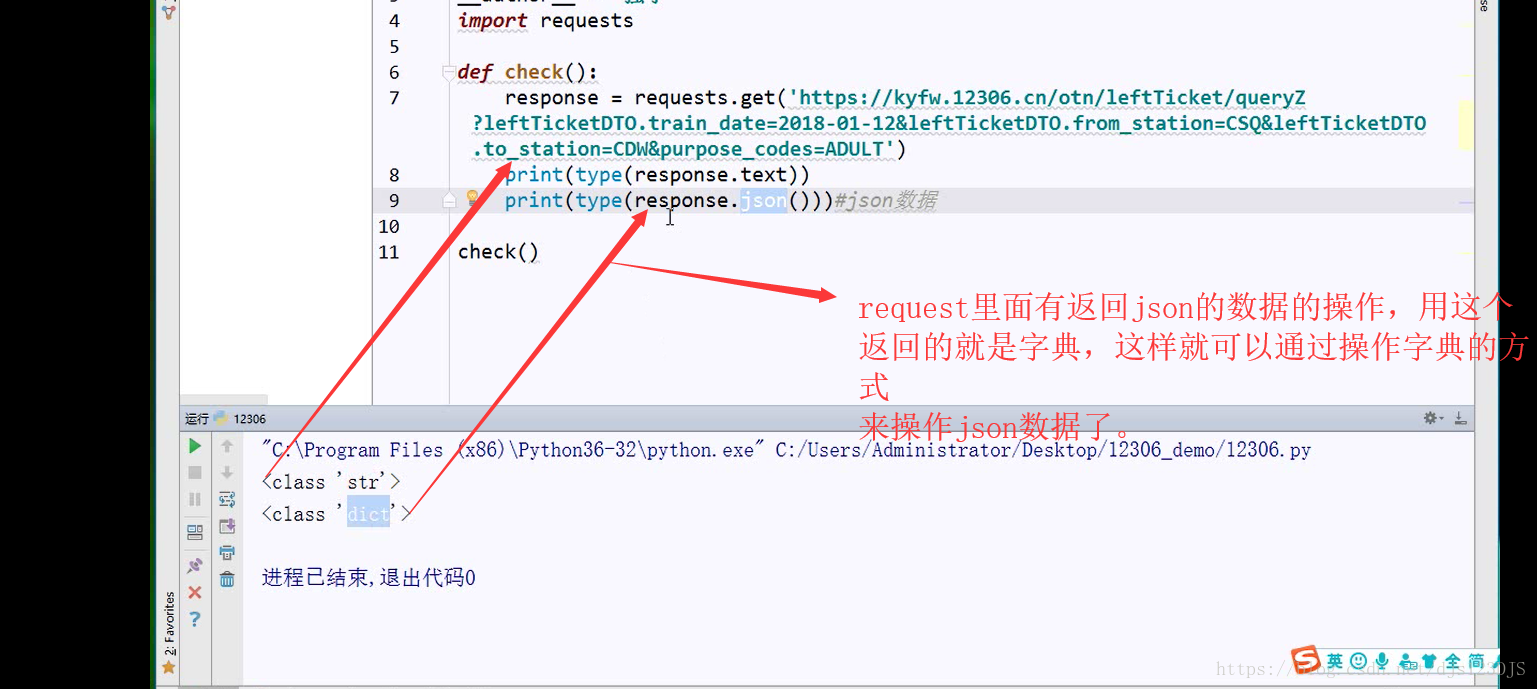
     request是爬虫的请求包,通过这个包几乎可以解决所有请求的功能。

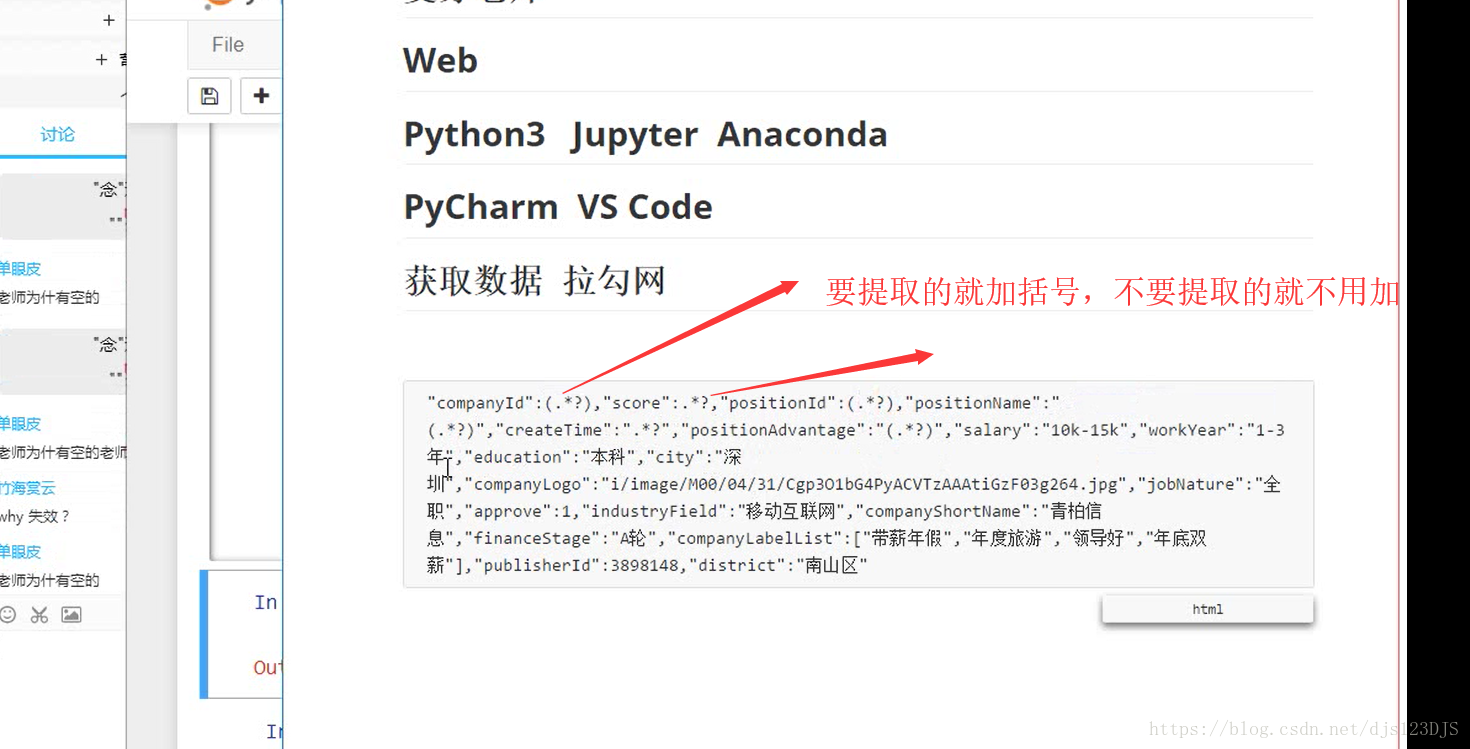
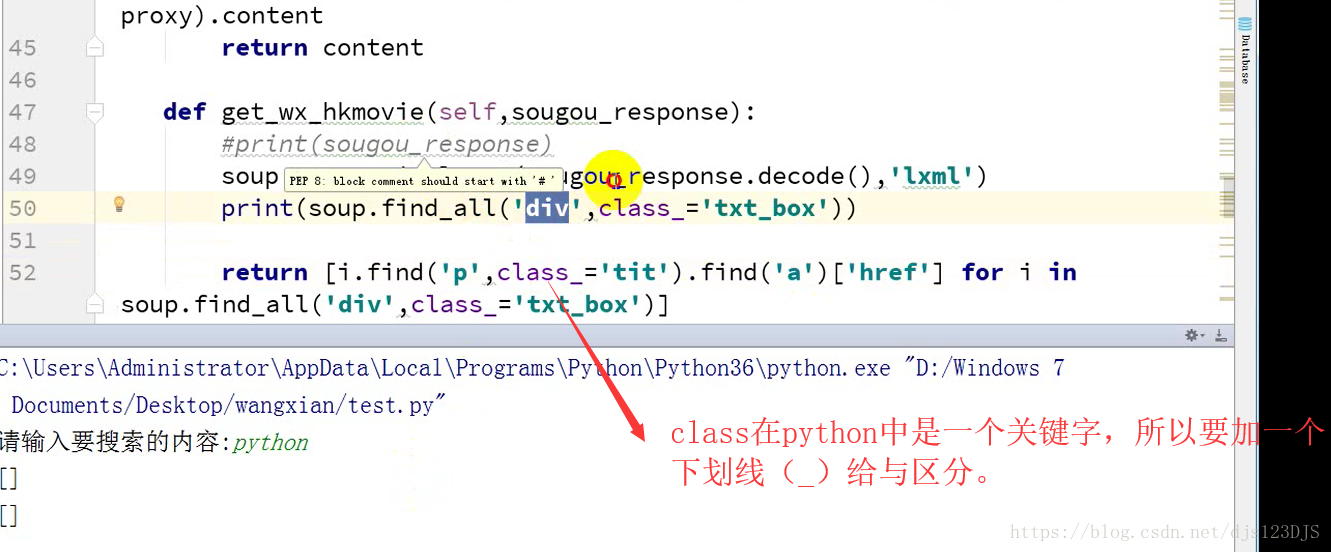
     正则表达式有时候可能会失效,失效的原因有很多,不过大多数是因为网页的结构发生了变化。


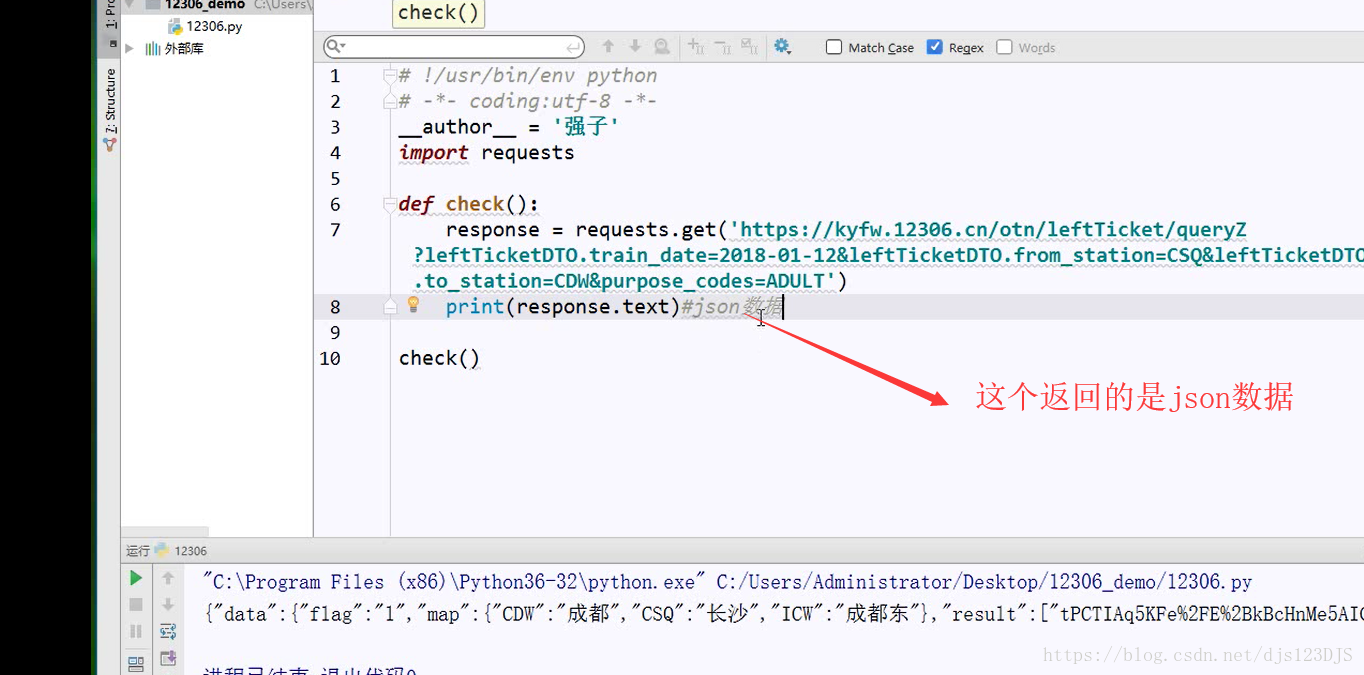
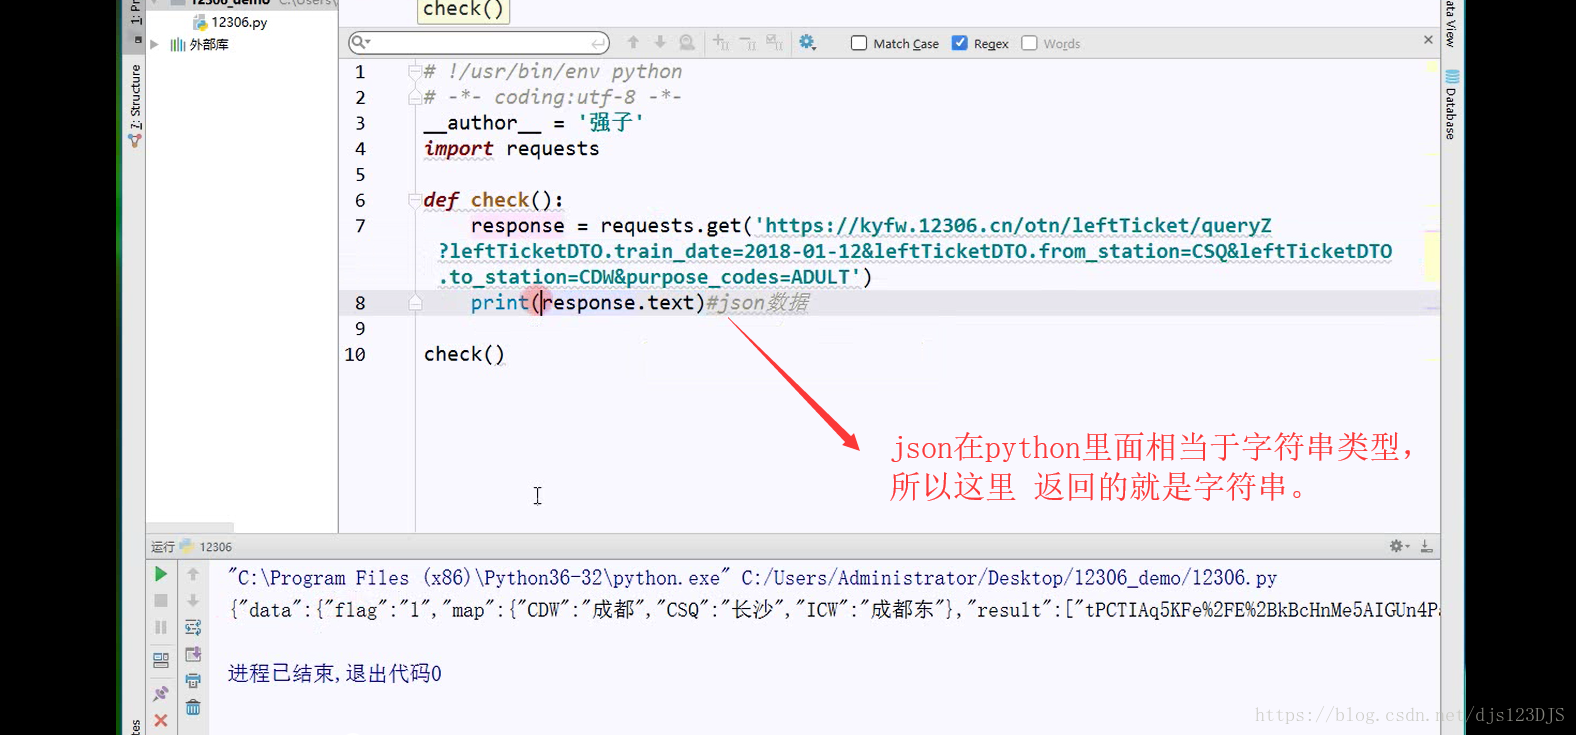
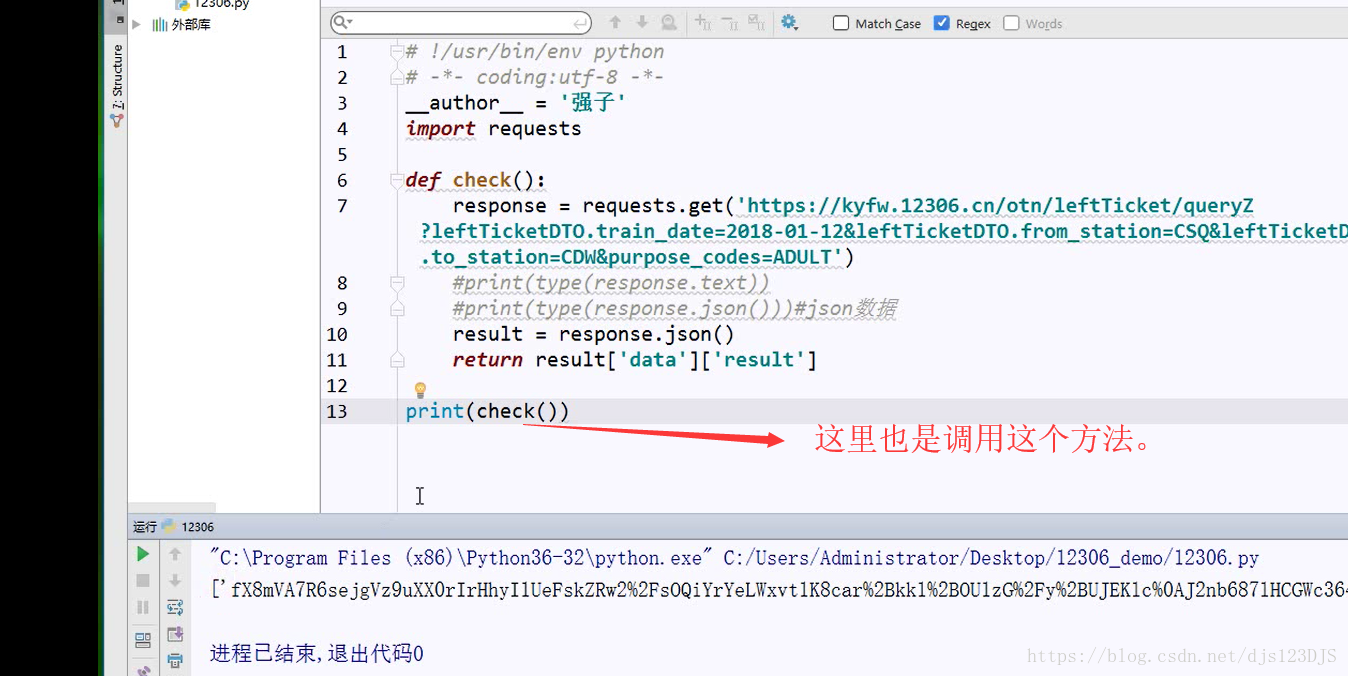
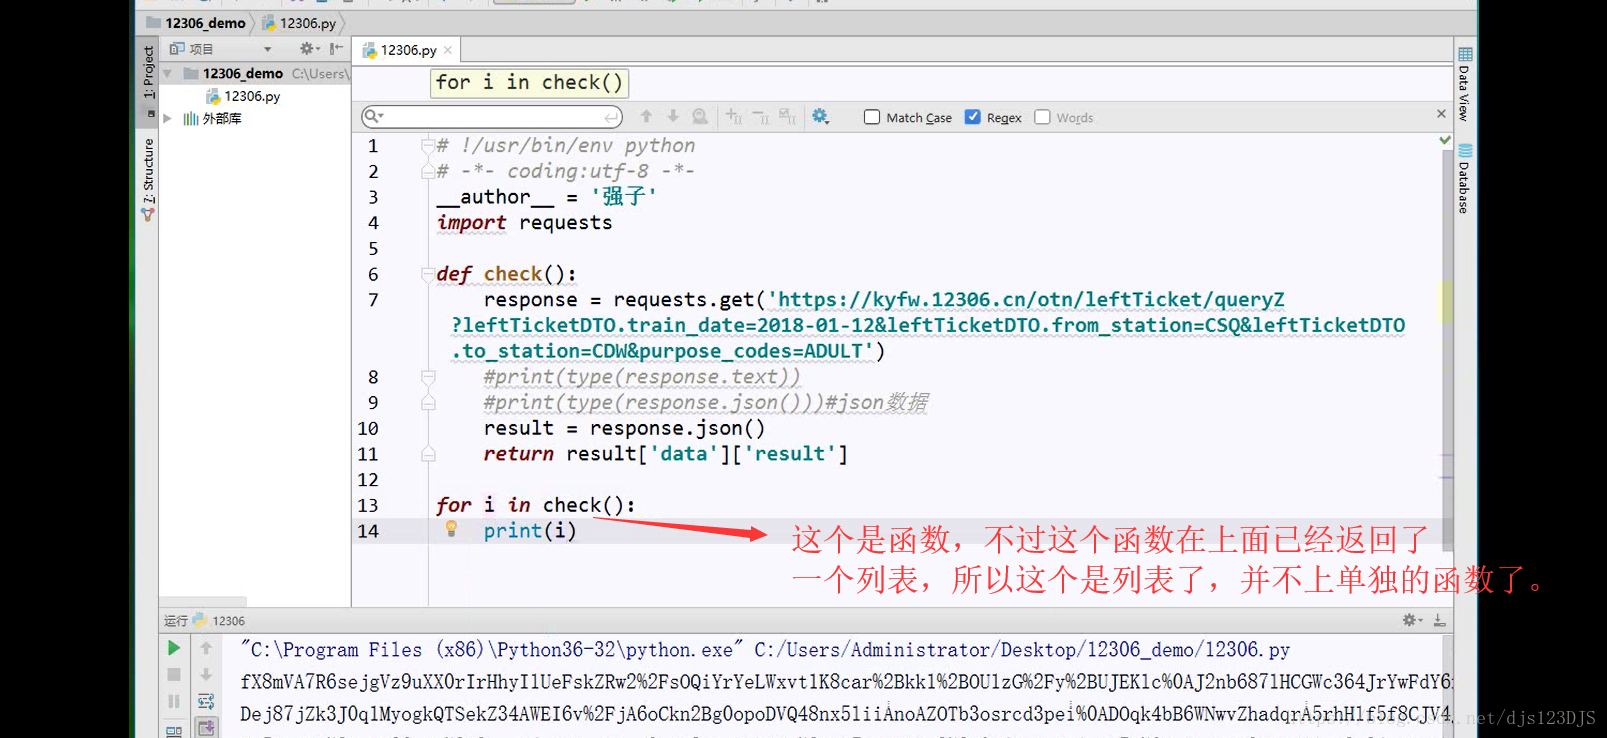
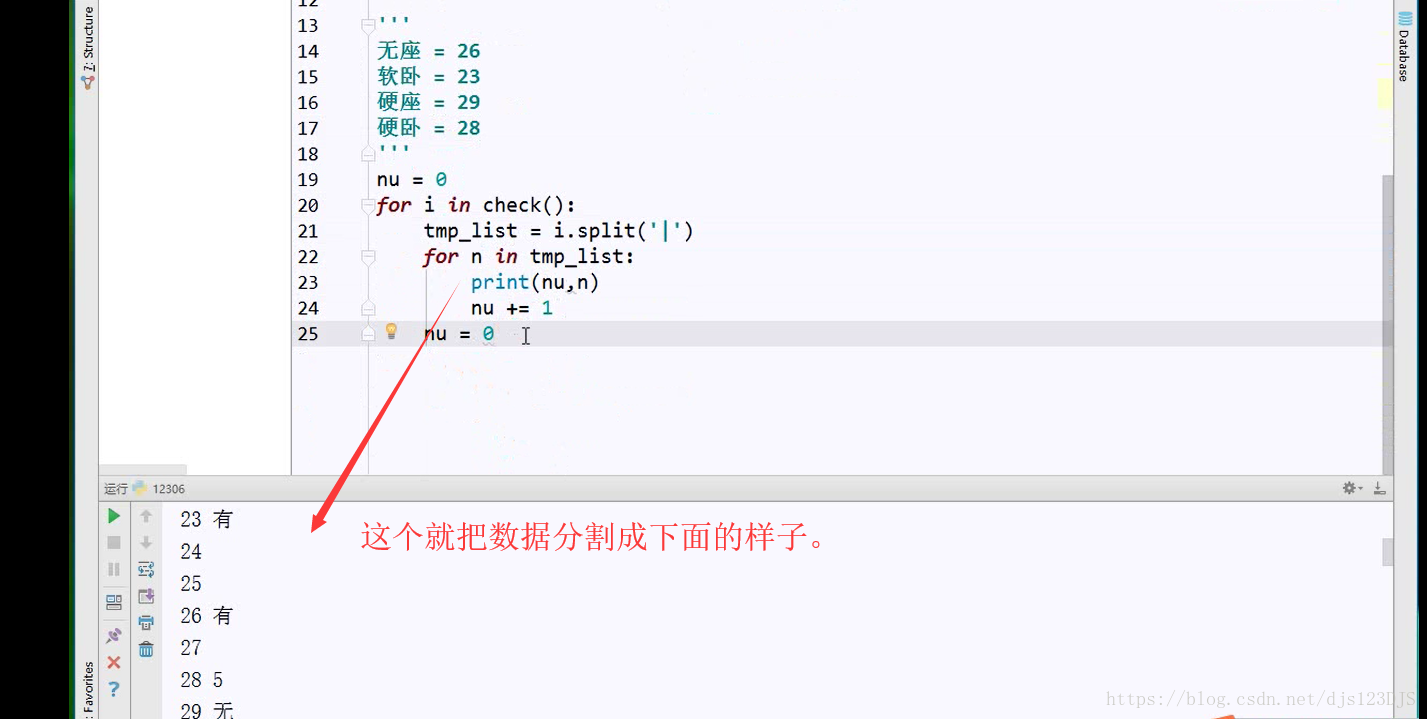
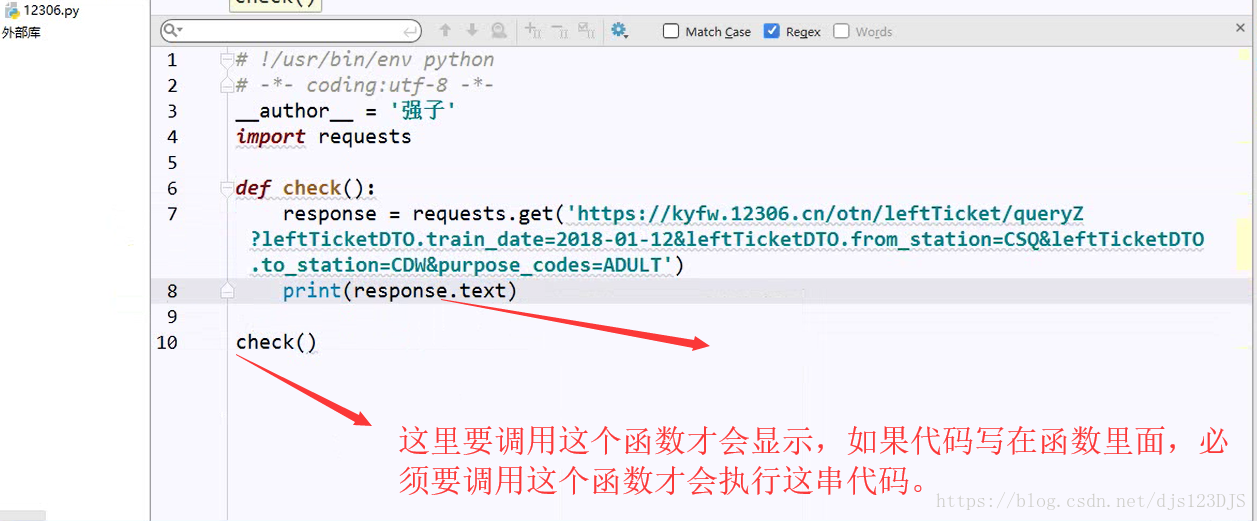
response 返回的其实URL的源代码。


48、基于头部电信号和触觉的人机交互技术研究 本文探讨了基于头部电信号控制决策和触觉感知的人机交互技术。通过EEG信号采集与ANN模型(TDNN/PRNN)分析,实现对用户意图的识别;同时利用触觉传感接口识别操作员有意接触,提升人机协作安全性。研究涵盖系统设计、数据处理流程、实验结果及技术拓展方向,并展望了两种技术在工业、医疗与智能家居等领域的融合应用前景。 阅读详情

相关推荐

《21天学通C++》阶段性成果测试题——hstring(手写string类)

总体考察了类的使用,缓冲区考察了指针和数组的使用、增删改查、考察编码思维、考察了类的重载。1.初始化子字符串的起始位置为-1,表示未找到,若buffer或findHstring为空,则返回-1。右边的字符串不为空,则分别获取母串和子串的长度(用循环),然后创建一个固定大小的数组。3.然后循环遍历寻找子串在母串中的起始位置,循环时可以通过两个长度相减,避免循环越界。2.如都不为空,则分别获取双方的字符串长度(用循环),然后。右边的字符串为空,则输出原来的字符串。是否为空,有一方为空则返回另一方。

立志成为炼丹师? 1265

【python杂记】网络爬虫-1/2 介绍

文章目录前言一、爬虫爬虫的目标爬虫步骤Robots排除协议二、函数库介绍1.requests函数库网页请求函数Response对象的属性通用代码框架2. beautifulsoup4函数库BeautifulSoup类解析内容BeautifulSoup类的基本元素 前言 本文记录下关于python爬虫的学习过程和个人见解。 一、爬虫 爬虫程序不一定非要python写,但是用python写肯定会更容易,python对于爬虫有很多比较友好的框架,框架一般适用于大型网站的爬虫需求,普通的网站随便请求下就行了。

m0_66978024的博客 701

【无标题】

可以看到这是一个带过滤的rce,并且还需要绕过空格,通过·查询资料得到了${IFS},$IFS$9,<,$IFS。然后f,l,a,g都被过滤了,可以用中括号[]来进行正则匹配,把GET传的参数改为?cmd=uniq /[e-h][k-n][^-b][e-h],就得到了flag。cmd={%0A"cmd":"/bin/cat /home/rceservice/flag"%0A}可以看到l被过滤了ls用不了了可以用dir用GET传参cmd=dir /,POST传参shell=system。

2501_94507425的博客 303

异步爬虫杂记1

      MVC设计模式可以说是前后端分离,现在的网站一般都是采用前后端分离的。前后端分离的话用爬虫就要通过抓包来爬取数据了。做爬虫的第一步是分析。     分析:1.数据是否在网页的源代码(html)里面      2.是否为ajax异步加载(用后台API开发)。ajax异步加载对于前端来说开发难度高(因为异步加载不仅要请求后端,还要JS把进行页面的渲染),对于后端来说开发难度低(异步加载后台...

代码改变世界 274

RM3100应用笔记驱动程序SPI接口

PNI磁传感器套件RM3100磁传感器套件由2个Sen-XY-f(pn13104)地磁传感器,1个Sen-Z-f(pn13101)地磁传感器和MagI2C(pn13156)控制芯片组成,能够实现三维空间的磁场大小测量。

AIoT技术栈的博客 4923

HWSD全球土壤数据下载处理

下载地址: http://www.fao.org/soils-portal/soil-survey/soil-maps-and-databases/harmonized-world-soil-database-v12/en/

江北20190411的博客 3万+

python爬虫scrapy从零开始学习杂记(1)

学习资料:https://doc.scrapy.org/en/latest/intro/tutorial.html(英文文档); https://scrapy-chs.readthedocs.io/zh_CN/0.24/intro/tutorial.html(中文文档) 1.创建一个scrapy项目 在命令行窗口中到你想要创建文件的目录下,打出这行命令: scrapy startproje

Arctring的专栏 898

【遥感数字图像处理(朱文泉)】各章博文链接汇总及思维导图

遥感数字图像处理(北京师范大学朱文泉教授)课程各章博文笔记汇总,及各章节思维导图

甜子yu的博客 2623

【python杂记】网络爬虫-2/2 实践

文章目录前言一、目标选取与分析选择目标网站分析使用步骤页面源码二、代码实现完整代码代码展望 前言 前半节把理论知识已经过了一遍,这节将具体实践一下。 一、目标选取与分析 该笔记记录纯学习使用。 选择目标 选择一个网站,将其内容爬取到本地进行保存或者展示。 网站:http://www.qisuwang.com/ 随便找的一个小说网站,这里建议大家经济没啥压力尽量多多支持正版啊。毕竟创作不易。 网站分析 该网站提供了网络小说txt格式电子书的下载服务。 使用步骤 主要操作步骤如下: 进入网站,选择一

m0_66978024的博客 413

Nvidia AGX Xavier刷机指北

因为工作的关系,要在AGX上安装CUDA。nvidia官网上没找到适合AGX版本的CUDA,只能走刷机的路子。刷机过程中,也遇到一些坑,做个记录。 需要有一台ubuntu系统的电脑作为主机Host。我的主机系统为Ubuntu18.04 整个刷机过程为: 在Host上安装sdkmanager,整个刷机过程主要通过sdkmanager来操作。 在Host自动下载一些系统组件,各种deb包 Host上制作OS系统镜像,烧录到AGX中 Host上之前下载好的deb包,安装到AGX中。 完结,撒花 ...

sinat_38685124的博客 6294

精通 Android NDK/JNI:从入门到精通实战与面试精粹

在Android开发中,

郑伟强dev的专栏 144

爬虫入门杂记

Sharry个人学习爬虫过程中的杂记。仅供参考

程序员Sharry的博客 624

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

爬虫杂记

1.你用过的爬虫框架或者模块有哪些?优缺点? Python自带:urllib,urllib2 第三方:requests 框架: Scrapy urllib 和urllib2模块都做与请求URL相关的操作,但他们提供不同的功能。 urllib2: urllib2.urlopen可以接受一个Request对象或者url,(在接受Request对象时,并以此可以来设置 一个URL的headers),urllib.urlopen只接收一个url。 urllib 有urlencode,urllib2没有,因此总是ur

cwtnice的博客 194

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

关于做爬虫项目的一些小杂记

关于做爬虫项目的一些小杂记–pyppeteer 1.清除特定参数(webdriver),达到绕过反爬检查,从而实现爬虫 await page.evaluateOnNewDocument(''' () => { const newProto = navigator.__proto__; delete newProto.webdriver; navigator.__proto__

weixin_42603578的博客 730

python爬虫运行_Python爬虫杂记 - python运行js

execjs 使用有了selenium+Chrome Headless 加载页面为什么还要用execjs来运行js?selenium+Chrome Headless 必然是爬虫的一大利器,可是缺点依然存在, 性能问题不可忽视。但这构不成舍弃它而不用的理由。我认为舍弃包括Chrome Headless、PhantomJS在内的无头浏览器的原因主要有以下几点:1. 页面结构改变、弹窗(一些网站的页面...

weixin_39727402的博客 210

学习杂记

学习杂记~~有些东西太小,不够一篇文章,都记到一块儿去!

在大海里翱翔的猪 505

杂记(python爬虫aiohttp模块模板

异步http请求爬虫模板,随便写的 看模板就行。

qq_40460136的博客 228

Python爬虫scrapy从零开始学习杂记(3))

这篇文章讲述的是我学习怎么防止scrapy爬虫被ban的过程~ 我所学习和参考的资料链接: https://www.jianshu.com/p/70d587e8baf2(写这篇杂记时已经使用过了,可行) http://www.360doc.com/content/17/1213/15/47241897_712718993.shtml 现先详细讲一下自己使用的方法,即轮换User_A

Arctring的专栏 488

爬虫杂记2(爬虫,数据,网站)

    爬虫开发的步骤:分析网站的结构---了解我们的需求---请求的分析    所有的爬虫都是模拟浏览器的请求。    爬虫:数据采集 互联网 工具获取我们想要的数据   加密,http  com控件 逆向 公开数据    - 数据清洗   - 数据挖掘  - 数据分析- 分析网站结构- 了解我们的需求- 请求分析  -1. 判断数据是否在当前请求的网页源代码当中(有三种可能性)  -2. 判断...

代码改变世界 280

工作杂记

工作杂记读写excel数据到数据库api编写就没什么说的了爬虫也只是用了xpath语法 读写excel数据到数据库 读数据时我学习到了两个库openpyxl和pandas 首先,openpyxl 、、、 from openpyxl import load_workbook def main(): data_from_excel = get_data_from_excel() def get_...

abc_soul的博客 308

Python 爬虫开发杂记之(八)pyspider框架将数据写入Mysql

一、不写入Mysql 根据  Python3 网络爬虫开发实战 (崔庆才著)这本书第十二章第二节的教程中去爬去哪儿网的攻略。 以下是完整的脚本: from pyspider.libs.base_handler import * class Handler(BaseHandler): crawl_config = { } @every(minutes=2...

jcpp9527的博客 2398

scrapy杂记

scrapy杂记 一、前言 了解到爬虫技术大概有18个月了,这期间自己写过几个爬虫,也fork过几个流行的爬虫repo,包括bilibili-user、iquery、WechatSogou等,但一直没系统的写过爬虫,上一次心血来潮(17年10月),想要爬下关于英雄联盟的数据,主要想获得皮肤原画数据。 当时决定的目标网站是英雄联盟中文官网,数据准确且更新快。LOL数据库,但苦于该网页全篇使...

Cloud_Strife0的博客 814

Python 爬虫开发杂记之(六)安装phantomjs爬的坑

一、前言 电脑环境基于前面几篇。anaconda3_5.2.0+python3.6 在这里学习 Python3 网络爬虫开发实战 这本书第十二章 pyspider框架的使用时,发现少安装了个phantomjs 二、错误安装 按照Python3 网络爬虫开发实战这书上第一章1.2.5节上的完全不行,pyspider启动时,phantomjs根本就起不来。 三、正确安装 不需要配置任何环境...

jcpp9527的博客 447

python模拟登陆杂记

从一个菜,开始练习要弄懂这些还真是费了很大的力气啊!        网上这种登陆的代码真的是一大堆了,所以代码就免了,也没什么意思!       就说说那些高手不会说的东西,就像课本里面只讲结论,而不讲这些贤人怎么思考的过程。我认为结论固然重要,但是思考的过程也很重要!       首先,有http协议和cookie的一些知识也很必要,没有也没有很大关系!       要模拟登陆,就需要懂

Jack_H的专栏 708

杂记

7月8号,距离刚开始学爬虫,已经近一个半月,6月8号买的爬虫书,这一个月算是努力了一下,自己也喜欢这种每天都有目标的 状态,感觉很好,很充实。回顾一下这一个月以来写的爬虫:头条街拍,淘宝,网易云相册,简书,微博(m.weibo.cn),豆瓣电影分类,其中头条、淘宝、微博都是书上的例子,但是我也尽量自己从头实现了一遍,其中的坑,只有踩过才懂。列几个感觉还需要深入的地方:1.微博验证码登陆,m.wei...

smh2208的博客 259

Python 爬虫杂记 - Chrome Headless

Chrome Headless使用 测试 Chrome 版本: 62.0.3202.89(正式版本)(64 位) Python环境:python2.7 注: Headless模式需要59版本及以上! Chrome的安装与配置不在此赘述, 不过需要注意的是: 版本号与驱动的映射关系! 版本号与驱动的映射关系!! 版本号与驱动的映射关系!!! Chrome与Chrom...

banlengcheng2628的博客 255
上一篇: python中函数调用的顺序
下一篇: github使用
djs123DJS
博客等级 码龄9年 49粉丝 137原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值