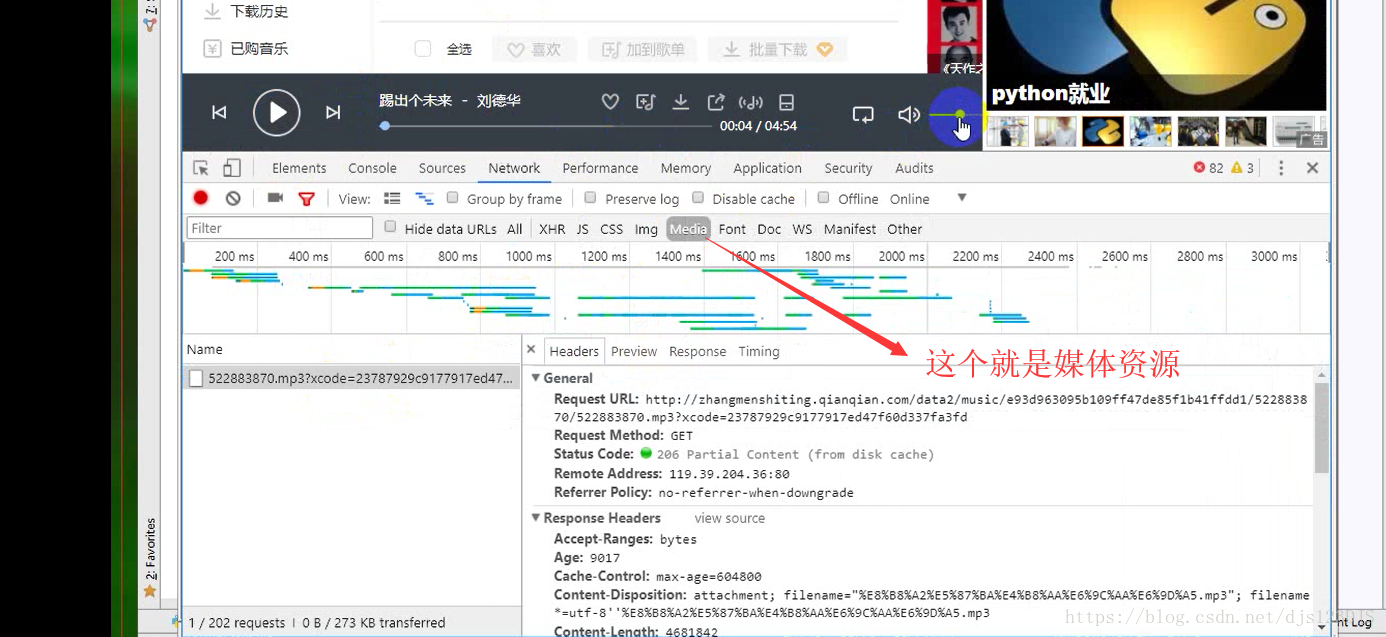
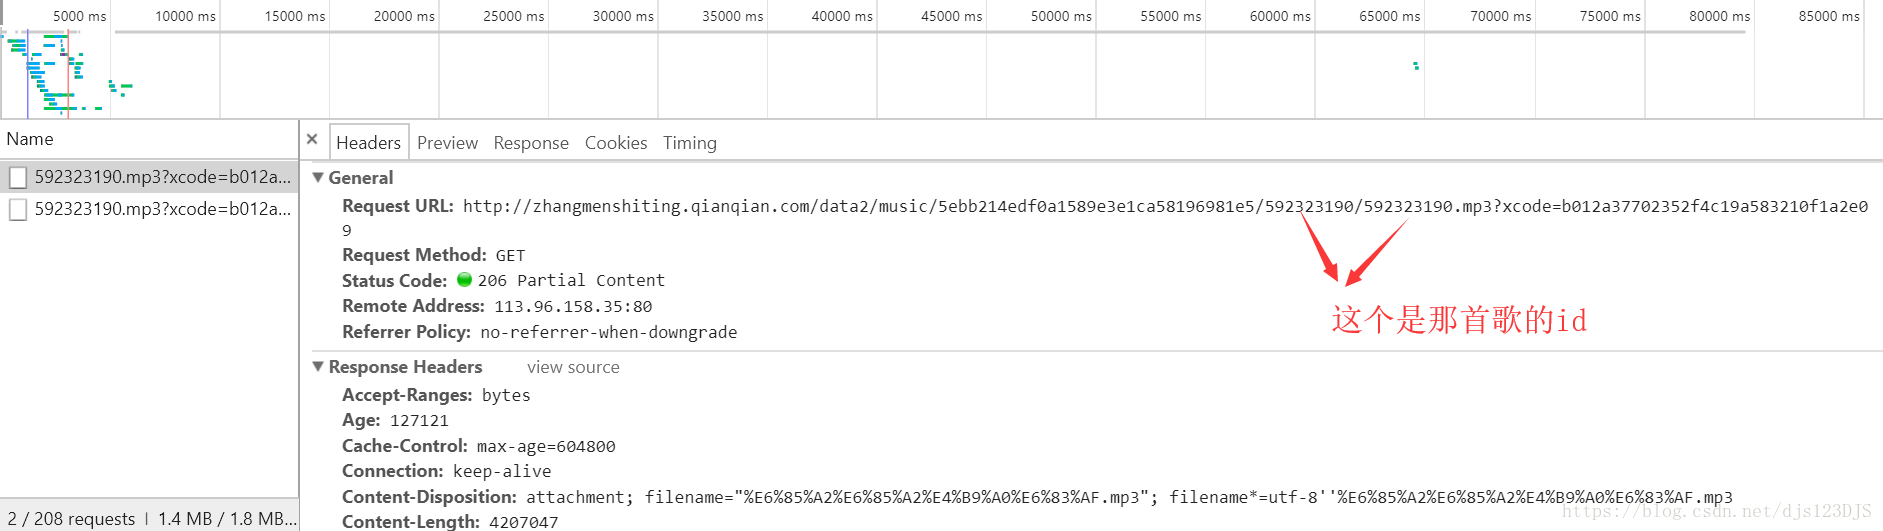
图片,网页,多媒体(网络资源),每一个网络资源都会有一个独一无二的url
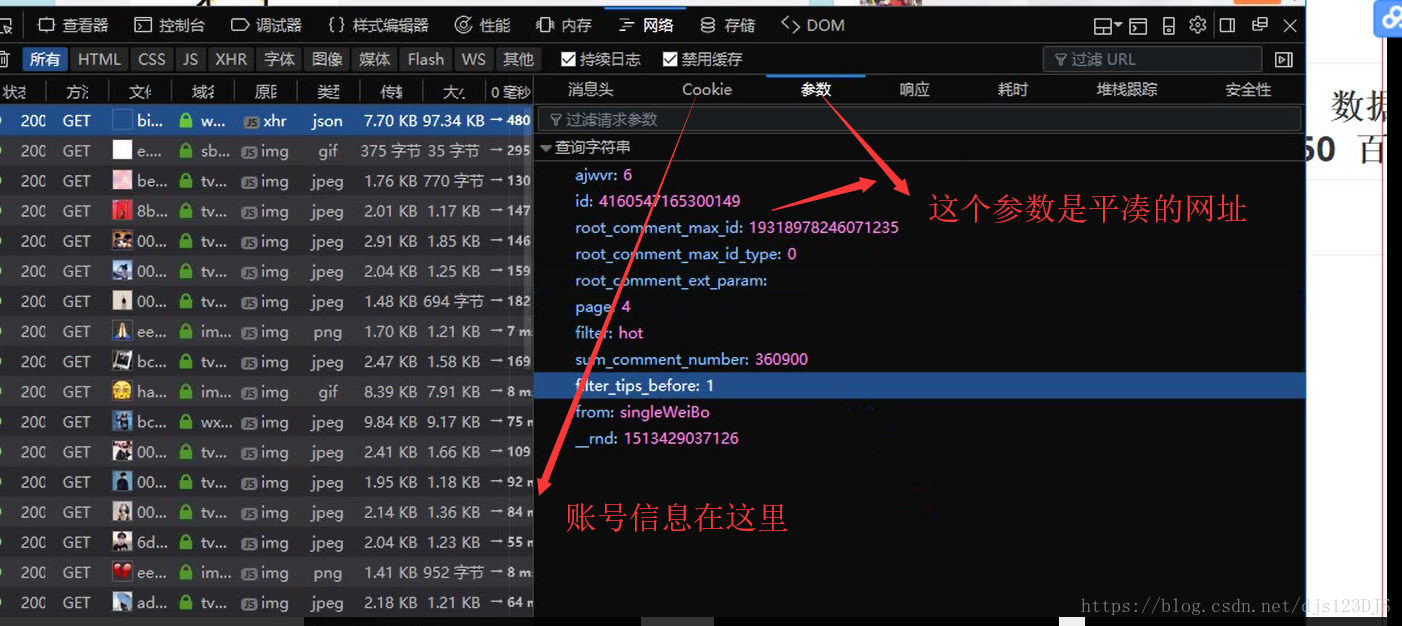
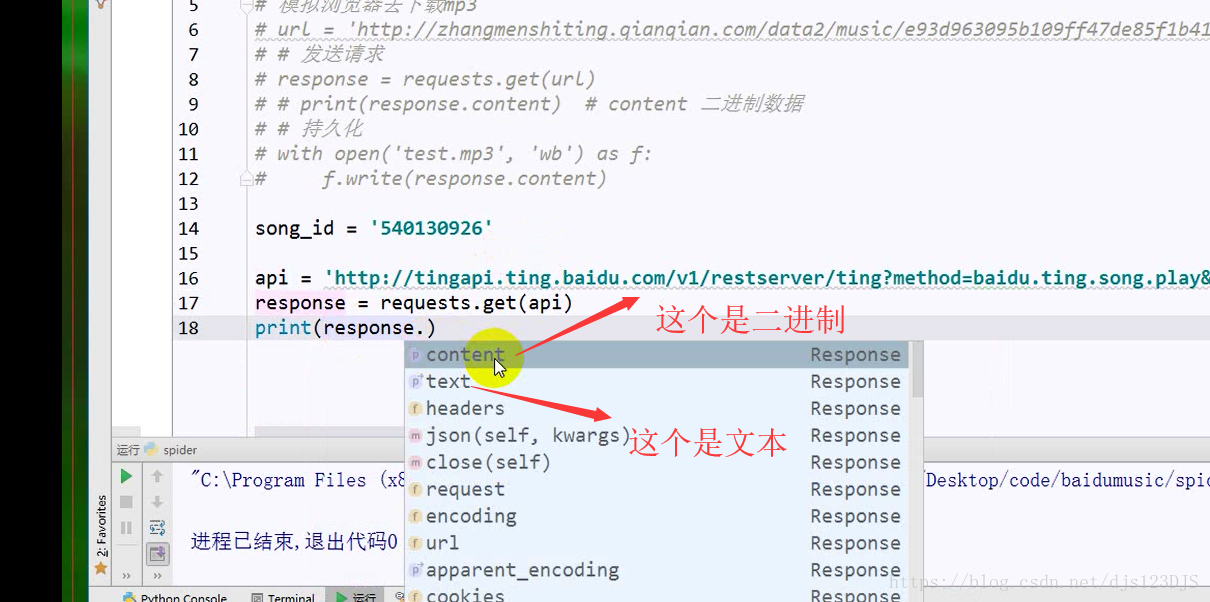
http请求 去对应的url请求数据,有get请求和post请求。
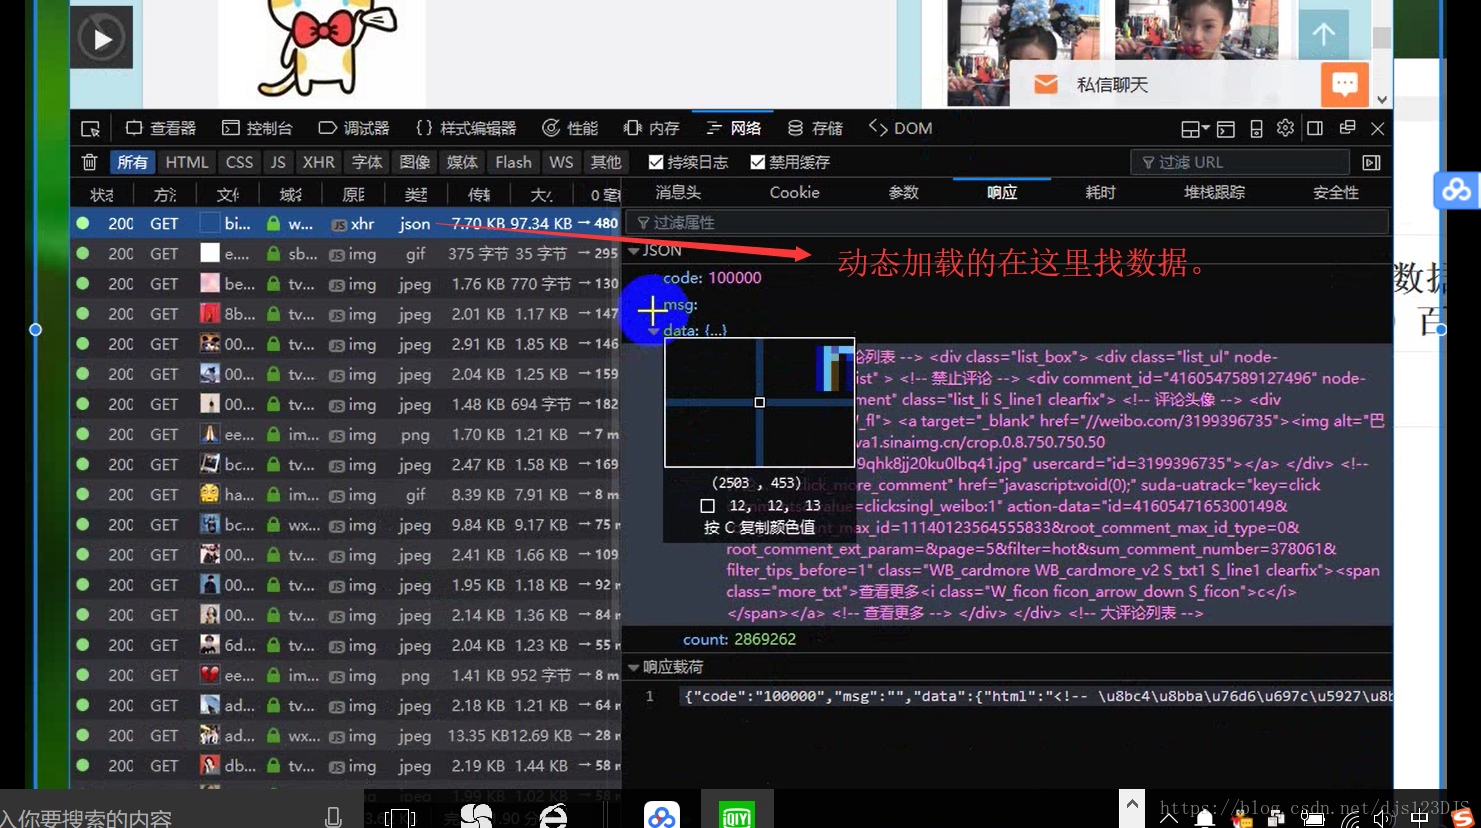
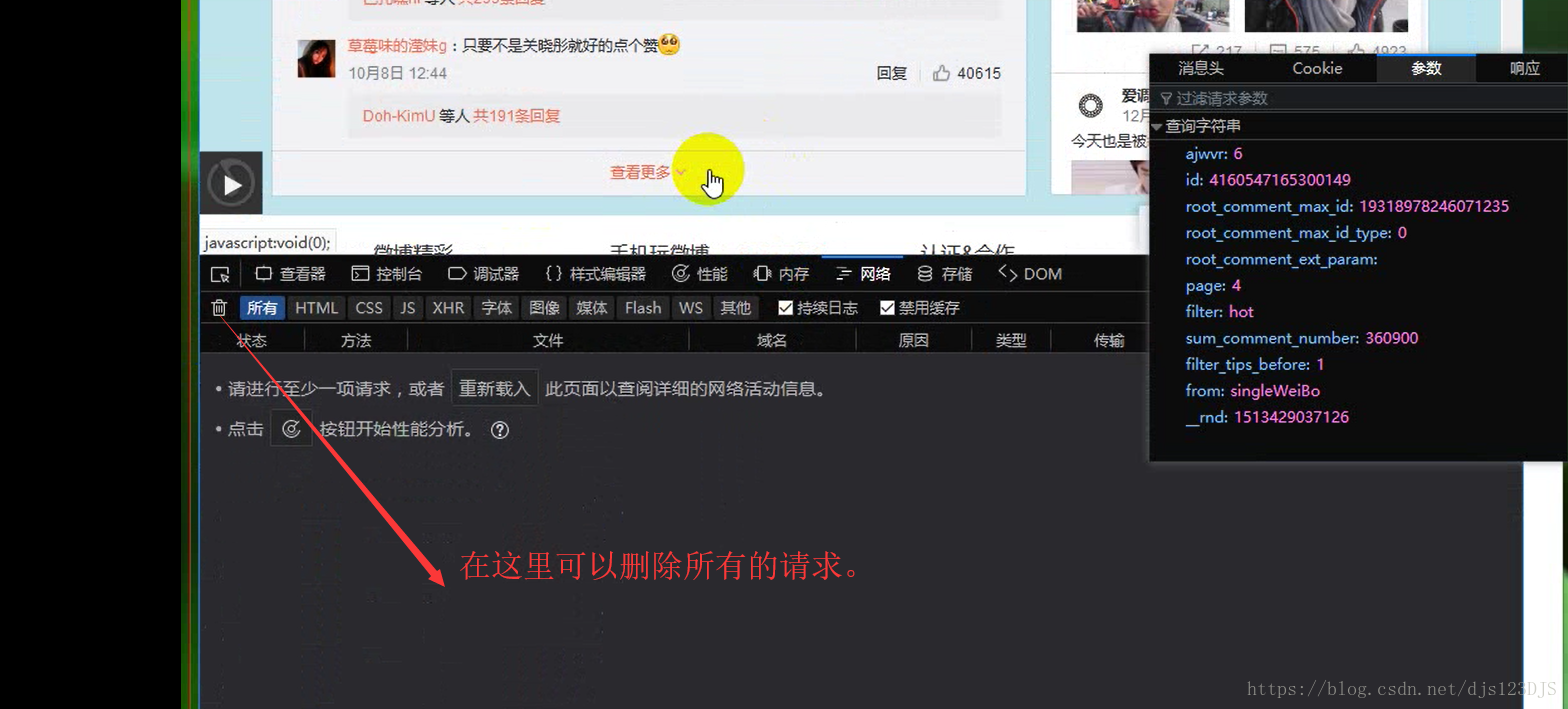
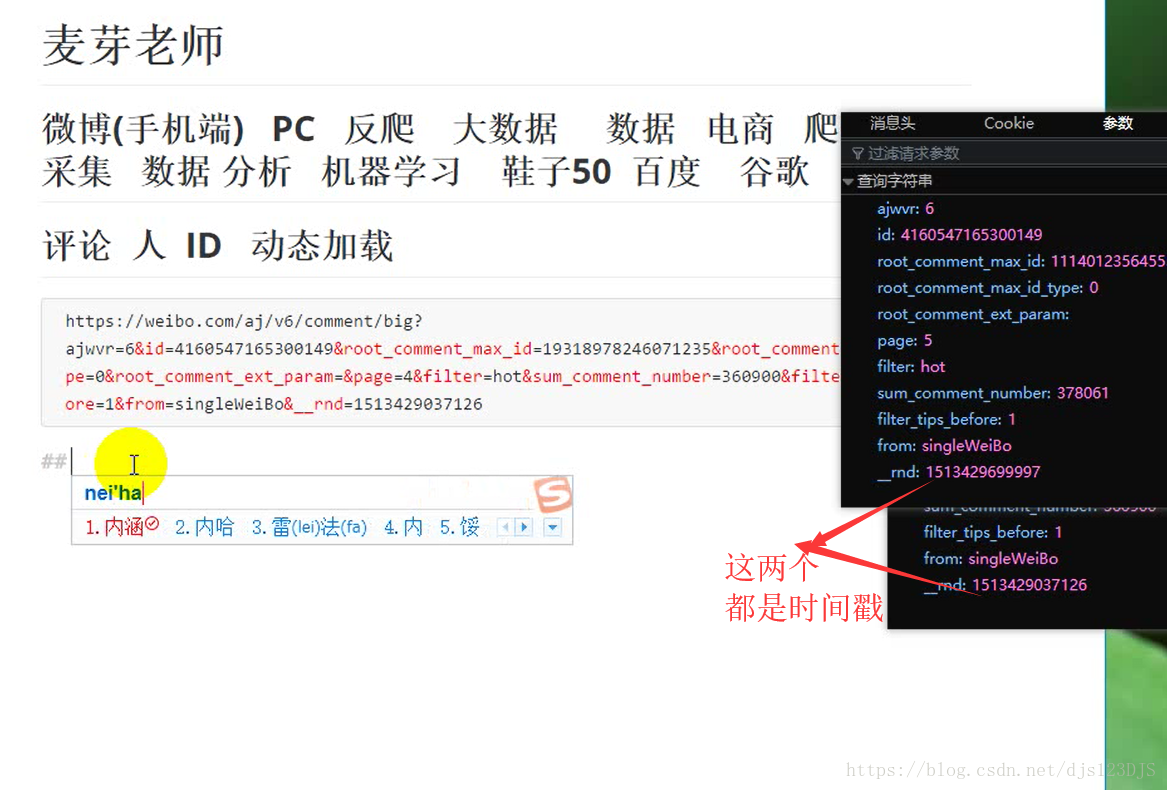
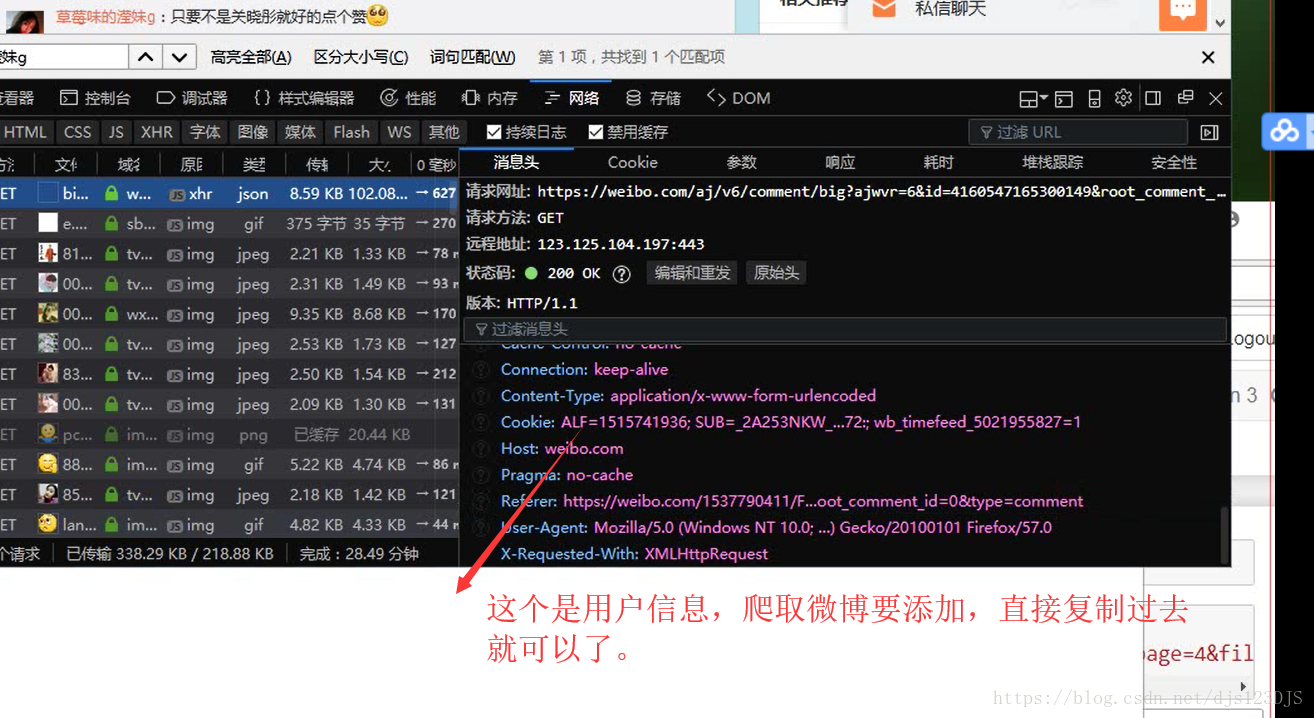
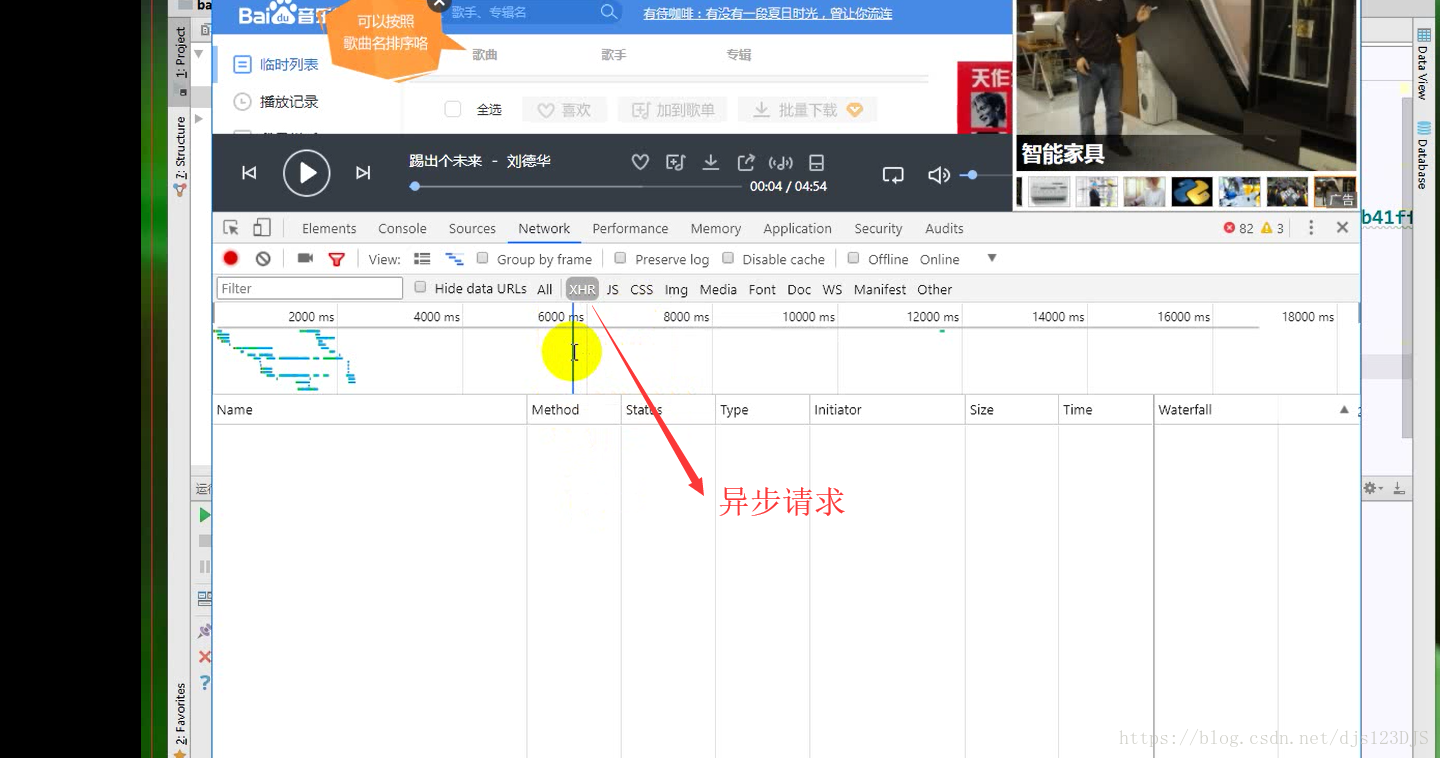
网页有静态加载和动态加载的,静态加载的可以在网页的源代码中看到网页中的信息,动态加载的就不可以。
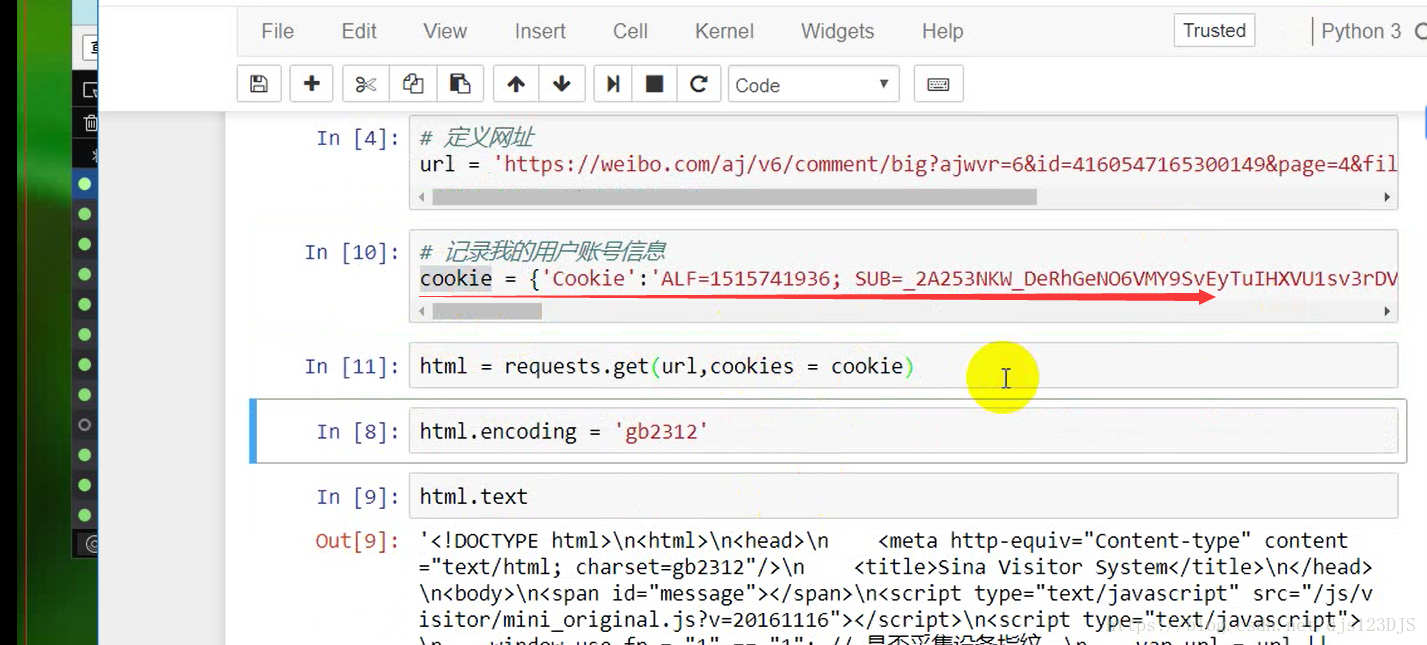
爬虫既可以cookie登录也可以模拟登录。json和字典类似


 墨衍会员
·
AI 创作全网分发
墨衍智能分发
本文由作者通过墨衍一键同步至各平台
1分发平台
200+累计阅读
215平均单平台
已同步平台
优快云
微信公众号
微博
知乎
掘金
百家号
博客园
抖音
小红书
你的文章也可以这样分发
墨衍会员 ¥399起/年,写一次发全网
我也要
图片,网页,多媒体(网络资源),每一个网络资源都会有一个独一无二的url
http请求 去对应的url请求数据,有get请求和post请求。
网页有静态加载和动态加载的,静态加载的可以在网页的源代码中看到网页中的信息,动态加载的就不可以。
爬虫既可以cookie登录也可以模拟登录。json和字典类似
单细胞空间转录组分析流程学习python版(三)
空转python版学习
【python杂记】网络爬虫-2/2 实践
文章目录前言一、目标选取与分析选择目标网站分析使用步骤页面源码二、代码实现完整代码代码展望 前言 前半节把理论知识已经过了一遍,这节将具体实践一下。 一、目标选取与分析 该笔记记录纯学习使用。 选择目标 选择一个网站,将其内容爬取到本地进行保存或者展示。 网站:http://www.qisuwang.com/ 随便找的一个小说网站,这里建议大家经济没啥压力尽量多多支持正版啊。毕竟创作不易。 网站分析 该网站提供了网络小说txt格式电子书的下载服务。 使用步骤 主要操作步骤如下: 进入网站,选择一
谷粒商城学习笔记-15-数据库初始化
这一节的主要内容是把创建对应的数据库和数据库表。
【python杂记】网络爬虫-1/2 介绍
文章目录前言一、爬虫爬虫的目标爬虫步骤Robots排除协议二、函数库介绍1.requests函数库网页请求函数Response对象的属性通用代码框架2. beautifulsoup4函数库BeautifulSoup类解析内容BeautifulSoup类的基本元素 前言 本文记录下关于python爬虫的学习过程和个人见解。 一、爬虫 爬虫程序不一定非要python写,但是用python写肯定会更容易,python对于爬虫有很多比较友好的框架,框架一般适用于大型网站的爬虫需求,普通的网站随便请求下就行了。
【Agent从入门到实践】40 容错优化:异常处理、重试机制、降级策略
各位小伙伴,咱们的多Agent框架一路优化到现在,决策快、执行效率高、资源用得省,看似啥都行,但只要一遇到网络波动、工具故障、数据异常调用web_search工具时网络超时,整个检索任务直接失败,写作Agent没数据可用向量库连接异常,向量检索直接崩掉,依赖检索结果的Agent全趴窝单个Agent执行出错,整个并行任务流程直接中断,前功尽弃高并发下部分工具调用失败,框架没有备用方案,只能返回任务失败说白了,咱们之前的框架只有正常执行逻辑,没有异常兜底逻辑。
GEE:关于遥感生态指数(RSEI)的若干疑问
本文记录了若干关于在 Google Earth Engine (GEE)平台上,计算基于主成分分析(PCA)的遥感生态指数(RSEI)的问题。并记录了解决这些问题的一些答案。问题包括,主成分分析的特征值的正负,主成分的占比,去云后空值像素的处理方法,异常值处理方法,如何看载荷等。
爬虫杂记2(爬虫,数据,网站)
爬虫开发的步骤:分析网站的结构---了解我们的需求---请求的分析 所有的爬虫都是模拟浏览器的请求。 爬虫:数据采集 互联网 工具获取我们想要的数据 加密,http com控件 逆向 公开数据 - 数据清洗 - 数据挖掘 - 数据分析- 分析网站结构- 了解我们的需求- 请求分析 -1. 判断数据是否在当前请求的网页源代码当中(有三种可能性) -2. 判断...
海康Visionmaster-全局脚本:VM 加载方案后自动执行 的方法,如何让VM在方案加载后自动执行流程?
海康Visionmaster-全局脚本:VM 加载方案后自动执行 的方法,如何让VM在方案加载后自动执行流程?
python爬虫scrapy从零开始学习杂记(2)
继续上一篇的例子,已经初步爬取到了整个网页源码,现在要抓取我们所需要的数据。 使用选择器selectors: 首先,在命令行界面打开shell:scrapy shell "http://quotes.toscrape.com/page/1/",回车 #Selector有四个基本的方法: 1.xpath():传入xpath表达式,返回该表达式对应的所有节点的selector list列表 2.
Vue + ECharts:从零构建智慧农业数据监控大屏(附完整源码)」 「超实用!一步步实现智慧农业大屏,完整代码+讲解」 「前端新手友好:Vue + ECharts 打造炫酷农业数据大屏」 「
Vue + ECharts:从零构建智慧农业数据监控大屏(附完整源码)」 「超实用!一步步实现智慧农业大屏,完整代码+讲解」 「前端新手友好:Vue + ECharts 打造炫酷农业数据大屏」 「前端可视化项目实战:智慧农业监控大屏开发详解」 「农作物可视化监控:用 Vue 和 ECharts 构建大屏应用」 「从零开始开发一个智慧农业数据大屏(代码+图表展示)」 「前端新手也能实现!智慧农业监控大屏开发教程」 「用 Vue 和 ECharts 搭建动态数据大屏:详细图文教程」 「学习前端大屏开发:
Arduino ESP32S3 基础入门教学大纲
ESP32环境、Arduino
爬虫入门杂记
Sharry个人学习爬虫过程中的杂记。仅供参考
CAN总线介绍及硬件设计
1. CAN是什么 CAN 是 Controller Area Network 的缩写(以下称为 CAN),是 ISO*1 国际标准化的串行通信协议。 在当前的汽车产业中,出于对安全性、舒适性、方便性、低公害、低成本的要求,各种各样的电子控制系统 被开发了出来。由于这些系统之间通信所用的数据类型及对可靠性的要求不尽相同,由多条总线构成的情况很 多,线束的数量也随之增加。为适应“减少线束的数量”、“......
爬虫杂记
1.你用过的爬虫框架或者模块有哪些?优缺点? Python自带:urllib,urllib2 第三方:requests 框架: Scrapy urllib 和urllib2模块都做与请求URL相关的操作,但他们提供不同的功能。 urllib2: urllib2.urlopen可以接受一个Request对象或者url,(在接受Request对象时,并以此可以来设置 一个URL的headers),urllib.urlopen只接收一个url。 urllib 有urlencode,urllib2没有,因此总是ur
visio安装包
Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。
VB摄像头监控
该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制
关于做爬虫项目的一些小杂记
关于做爬虫项目的一些小杂记–pyppeteer 1.清除特定参数(webdriver),达到绕过反爬检查,从而实现爬虫 await page.evaluateOnNewDocument(''' () => { const newProto = navigator.__proto__; delete newProto.webdriver; navigator.__proto__
数学建模模型总结
这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!
python爬虫运行_Python爬虫杂记 - python运行js
execjs 使用有了selenium+Chrome Headless 加载页面为什么还要用execjs来运行js?selenium+Chrome Headless 必然是爬虫的一大利器,可是缺点依然存在, 性能问题不可忽视。但这构不成舍弃它而不用的理由。我认为舍弃包括Chrome Headless、PhantomJS在内的无头浏览器的原因主要有以下几点:1. 页面结构改变、弹窗(一些网站的页面...
蓝牙模块HM-10手册
蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。
爬虫杂记1
计算机上面的东西如果你不把它放在硬盘里面,它都是在内存里面,只有这两个硬件可以存储东西,所以爬虫匹配出来的结果如果没有放在硬盘里的,都是在内存 里面。解释工具(匹配)有正则,xapth,bs4,json只能转换成类似字典的数据。免费的代理ip,可用性很差,100个可能也没有一个可以用,并且过期 时间很快。所以一般不用免费的代理。安卓系统和苹果系统都是基于unix或者linux开发的,所以...
学习杂记
学习杂记~~有些东西太小,不够一篇文章,都记到一块儿去!
异步爬虫杂记1
MVC设计模式可以说是前后端分离,现在的网站一般都是采用前后端分离的。前后端分离的话用爬虫就要通过抓包来爬取数据了。做爬虫的第一步是分析。 分析:1.数据是否在网页的源代码(html)里面 2.是否为ajax异步加载(用后台API开发)。ajax异步加载对于前端来说开发难度高(因为异步加载不仅要请求后端,还要JS把进行页面的渲染),对于后端来说开发难度低(异步加载后台...
杂记(python爬虫aiohttp模块模板
异步http请求爬虫模板,随便写的 看模板就行。
Python爬虫scrapy从零开始学习杂记(3))
这篇文章讲述的是我学习怎么防止scrapy爬虫被ban的过程~ 我所学习和参考的资料链接: https://www.jianshu.com/p/70d587e8baf2(写这篇杂记时已经使用过了,可行) http://www.360doc.com/content/17/1213/15/47241897_712718993.shtml 现先详细讲一下自己使用的方法,即轮换User_A
python爬虫scrapy从零开始学习杂记(1)
学习资料:https://doc.scrapy.org/en/latest/intro/tutorial.html(英文文档); https://scrapy-chs.readthedocs.io/zh_CN/0.24/intro/tutorial.html(中文文档) 1.创建一个scrapy项目 在命令行窗口中到你想要创建文件的目录下,打出这行命令: scrapy startproje
爬虫杂记4
验证码的有效期大概是2分钟。做爬虫一般都用utf-8(国际编码)http 与https 的区别:两者都是基于http协议,https有加密数据的功能,不过https要收钱。即https有一个加密 的证书,这个证书可以去购买也可以自己做。验证码的种类:字符串(早期的)字符生成图片坐标(极验,12306,点击)手机短信验证码语音验证码。 ...
Python 爬虫开发杂记之(八)pyspider框架将数据写入Mysql
一、不写入Mysql 根据 Python3 网络爬虫开发实战 (崔庆才著)这本书第十二章第二节的教程中去爬去哪儿网的攻略。 以下是完整的脚本: from pyspider.libs.base_handler import * class Handler(BaseHandler): crawl_config = { } @every(minutes=2...
scrapy框架杂记
一般爬虫的逻辑是:给定起始页面,发起访问,分析页面包含的所有其他链接,然后将这些链接放入队列,再逐次访问这些队列,直至边界条件结束。为了针对列表页+详情页这种模式,需要对链接抽取(link extractor)的逻辑进行限定。好在scrapy已经提供,关键是你知道这个接口,并灵活运用 scrapy框架爬取流程 爬取流程 Scrapy的整个数据处理流程由Scrapy引...
Selenium之学习杂记(一)
Selenium之学习杂记(一)Selenium一些概念页面导航启动浏览器打开页面浏览器基本操作拖动窗口cookie的调用使用多个窗口 Selenium一些概念 Selenium官方有一个很经典的回答:“自动化操作的浏览器,就是这样……做你想要做的事情,一切取决于你。” Selenium项目最早是为测试浏览器、网页而诞生的。在大数据时代,Selenium广泛应用于网络爬虫。需要注意的是,Selenium项目并不是单个特定的软件,而是由多个工具组成,每个工具具有特定的功能。 Selenium WebDriv

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言



 2084


 扫一扫


