


1. Kafka入门(消息写入磁盘)
topic有多个分区(分片),分配在多个broker中,分区之间有副本
不同消费者有不同的位移,每个分区最后读取的消息偏移量保存在Zookeeper 或Kafka上,读取状态不会丢失。
定义:点对点模型和发布订阅模型
作用: 削峰填谷,Kafka是消息引擎系统,也是分布式流处理平台
客户端服务端:生产者和消费者统称为客户端(Clients),Kafka 的服务器端由被称为 Broker 的服务进程构成,即一个 Kafka 集群由多个 Broker 组成
高可用(booker,副本),可伸缩(分区)

2. 客户端
分区(每个分区的消息是有顺序的)
- 作用(可伸缩,可放到多个机器上,高吞吐,负载均衡)
- 策略(轮询,随机,按消息键保序)
如何保证消息顺序(单个分区或基于某个值按照消息键保存,实现单个分区内的顺序)
2.1 压缩( Producer 端压缩、Broker 端保持、Consumer 端解压缩)
有时Broker 会解压缩解压缩(因为消息体格式不一样,主要是为了兼容老版本的消费者程序),
2.2 无消息丢失
生产者有副本(ISR,设置最大延时,重试,副本数等),发消息对回执做处理,producer的ack机制
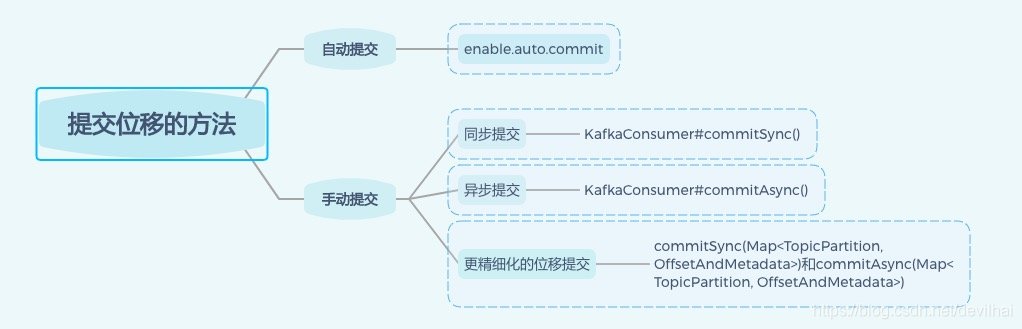
消费者不要自动提交位移
Kafka 只对“已提交”(当 Kafka 的若干个 Broker 成功地接收到一条消息并写入到日志文件后,且 Producer 接到 Broker 的应答)的消息做有限度(消息保存在 N 个 Kafka Broker 上,那么这个前提条件就是这 N 个 Broker 中至少有 1 个存活)的持久化保证。
- 不用producer.send(msg),而要使用 producer.send(msg, callback),要使用带有回调方法的API,我们可以根据回调函数得知消息是否发送成功,如果发送失败了我们要进行异常处理,比如存储到其他介质来保证消息不丢
- 维持先消费消息(阅读),再更新位移(书签)的顺序
- 如果是多线程异步处理消费消息,Consumer 程序不要开启自动提交位移,而是要应用程序手动提交位移
如果有些消息我们是可以容忍丢失的,我只希望kafka以最快的速度接收消息
- 0,producer不等待broker的ack,这一操作提供了一个最低的延迟,broker一接收到还没有写入磁盘就已经返回,当broker故障时有可能丢失数据。
- 1,producer等待broker的ack,partition的leader落盘成功后返回ack,如果在follower同步成功之前leader故障,那么将会丢失数据。
- -1,(all):producer等待broker的ack,partition的leader和follower全部落盘成功后才返回ack。但是如果在follower同步完成后,broker发送ack之前,leader发生故障,那么会造成数据重复。
retries=MAX(重试)
unclean.leader.election.enable = false(follower replica落后太多的不能竞选)
replication.factor (副本数)
min.insync.replicas(ISR副本数)
replica.lag.time.max.ms(ISR副本最大延时)
Apache Kafka 的所有通信都是基于 TCP 的,而不是基于 HTTP 或其他协议
为何采用 TCP?
- 利用 TCP 本身提供的一些高级功能,比如多路复用请求以及同时轮询多个连接的能力
- 目前已知的 HTTP 库在很多编程语言中都略显简陋
2.3 消息交付可靠性保障
- 最多一次(at most once):消息可能会丢失,但绝不会被重复发送。
- 至少一次(at leastonce):消息不会丢失,但有可能被重复发送。 (默认)
- 精确一次(exactly once):消息不会丢失,也不会被重复发送。
精准一次的实现
- 幂等性,At Least Once + 幂等性 = Exactly Once(幂等性producer,在 Broker 端多保存一些字段。当 Producer 发送了具有相同字段值的消息后,Broker 能够自动知晓这些消息已经重复了)
只能单分区、单会话(重启失效)上的消息幂等性 - 事务(保证将消息原子性地写入到多个分区中。这批消息要么全部写入成功,要么全部失败,性能差)
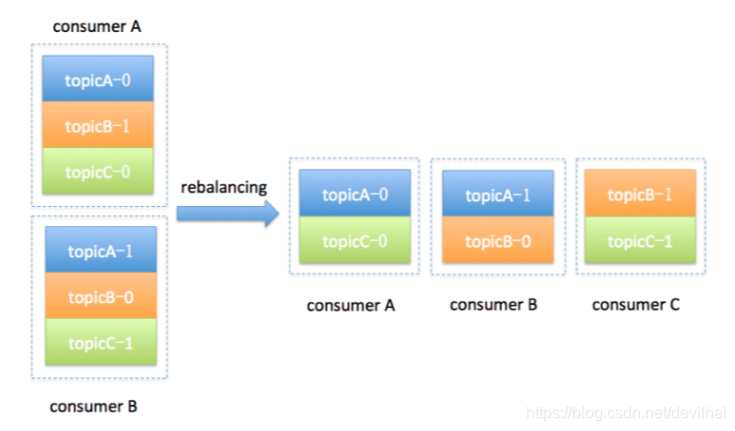
2.4 消费者组及重平衡(加入组和平衡组请求,通过心跳机制和协调者来平衡)
Consumer Group 是 Kafka 提供的可扩展且具有容错性的消费者机制
重平衡(Rebalance )此时会stop the world
触发时机:
- 组成员数量发生变化。
- 订阅主题数量发生变化。
- 订阅主题的分区数发生变化
通知机制(重平衡的通知机制正是通过心跳线程来完成的)
…
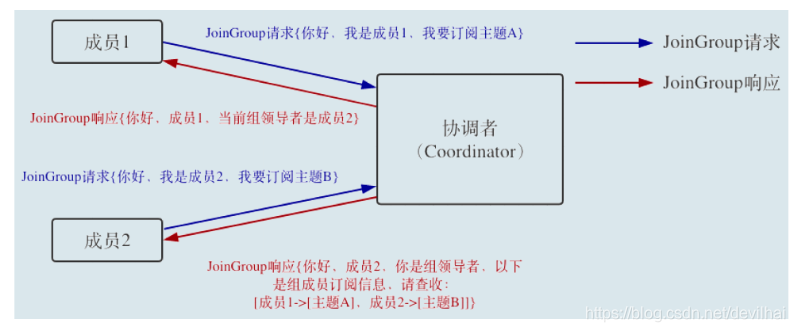
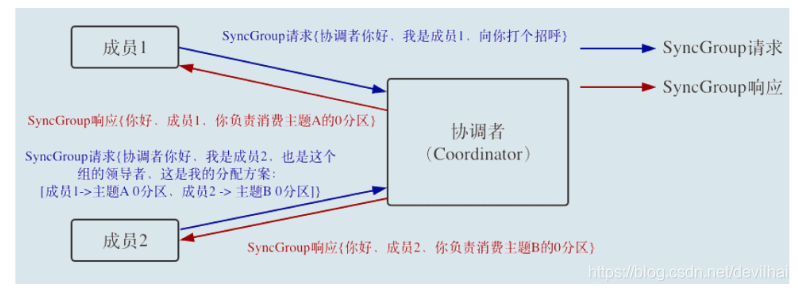
在消费者端,重平衡分为两个步骤:分别是加入组和等待领导者消费者(Leader Consumer)分配方案。这两个步骤分别对应两类特定的请求:JoinGroup 请求和 SyncGroup 请求
joinGroup请求 -》broker的协调者收集信息,分配领导者消费者,-> joinGroup响应,告诉领导者订阅信息
领导者分配
sync请求(领导者提交分配的请求) -》 sync响应,协调者返回分配的数据
Broker 端
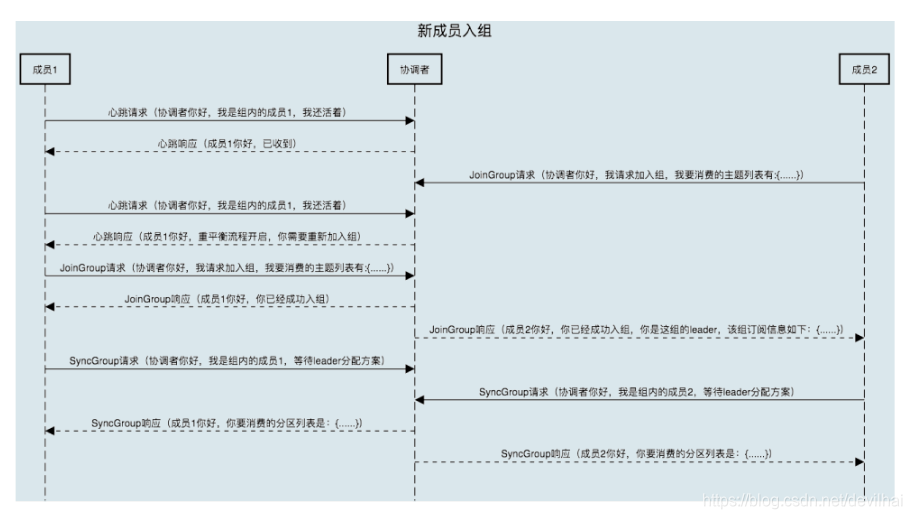
要避免重平衡,因为会stop the world,,增减成员的没法控制,主要通过控制参数(session.timeout.ms;heartbeat.interval.ms)来控制心跳的频率,超时时间来减少误判
2.5 位移主题(kafka内部主题,记录消费者位移,替换zookeeper保存位移方式)
Kafka 天然实现了高持久性和高吞吐量,那么任何有这两个需求的子服务自然也就不必求助于外部系统,用 Kafka 自己实现就好了,所以有了位移主题
将 Consumer 的位移数据作为一条条普通的 Kafka 消息,提交到 __consumer_offsets 中
位移主题的 Key 中应该保存 3 部分内容:<Group ID,主题名,分区号 >
创建方式:
- 当 Kafka 集群中的第一个 Consumer 程序启动时,Kafka 会自动创建位移主题(建议使用)
- 手动创建
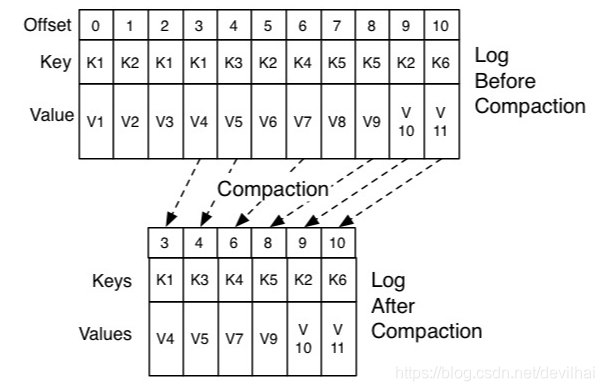
清理位移消息:
对于同一个 Key 的两条消息 M1 和 M2,如果 M1 的发送时间早于 M2,那么 M1 就是过期消息。Compact 的过程就是扫描日志的所有消息,剔除那些过期的消息
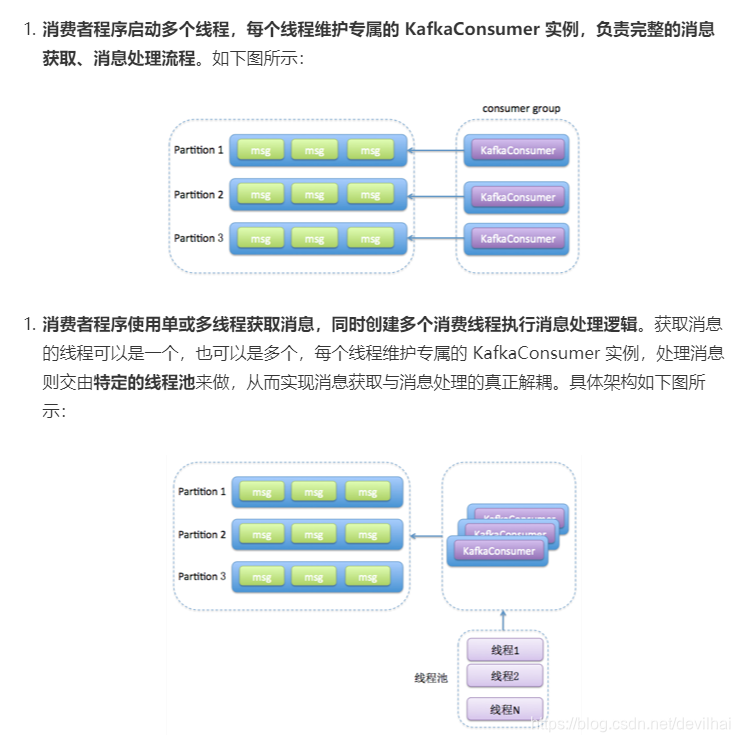
消费者多线程
看17 ,21 ,22
3. 深入内核
3.1 副本机制
Kafka 的 Broker 是不分主从的
追随者副本是不对外提供服务的(保证信息都是最新的)
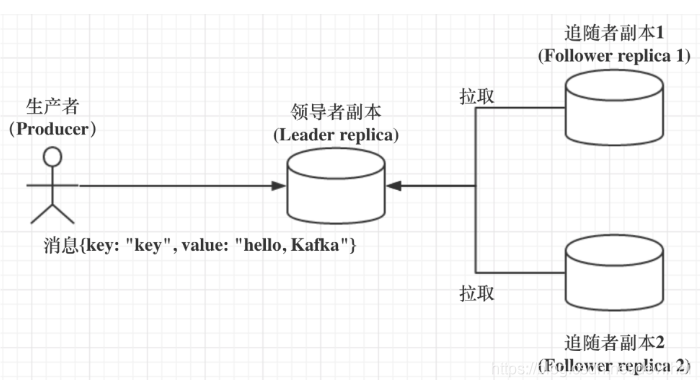
副本消息同步
借助hw(高水位)和LEO(log end offset,该副本日志中下一条消息的位移值),实现leader和flower之间这两个值的更新,从而实现副本同步
ISR( In-sync Replicas)
追随者副本到底在什么条件下才算与 Leader 同步。---- ISR
Kafka 判断 Follower 是否与 Leader 同步的标准,即在ISR中,不是看相差的消息数,而是另有“玄机”。
这个标准就是 Broker 端参数 replica.lag.time.max.ms (ISR副本最大延时)参数值
3.2 请求是怎么被处理的
Reactor 模式
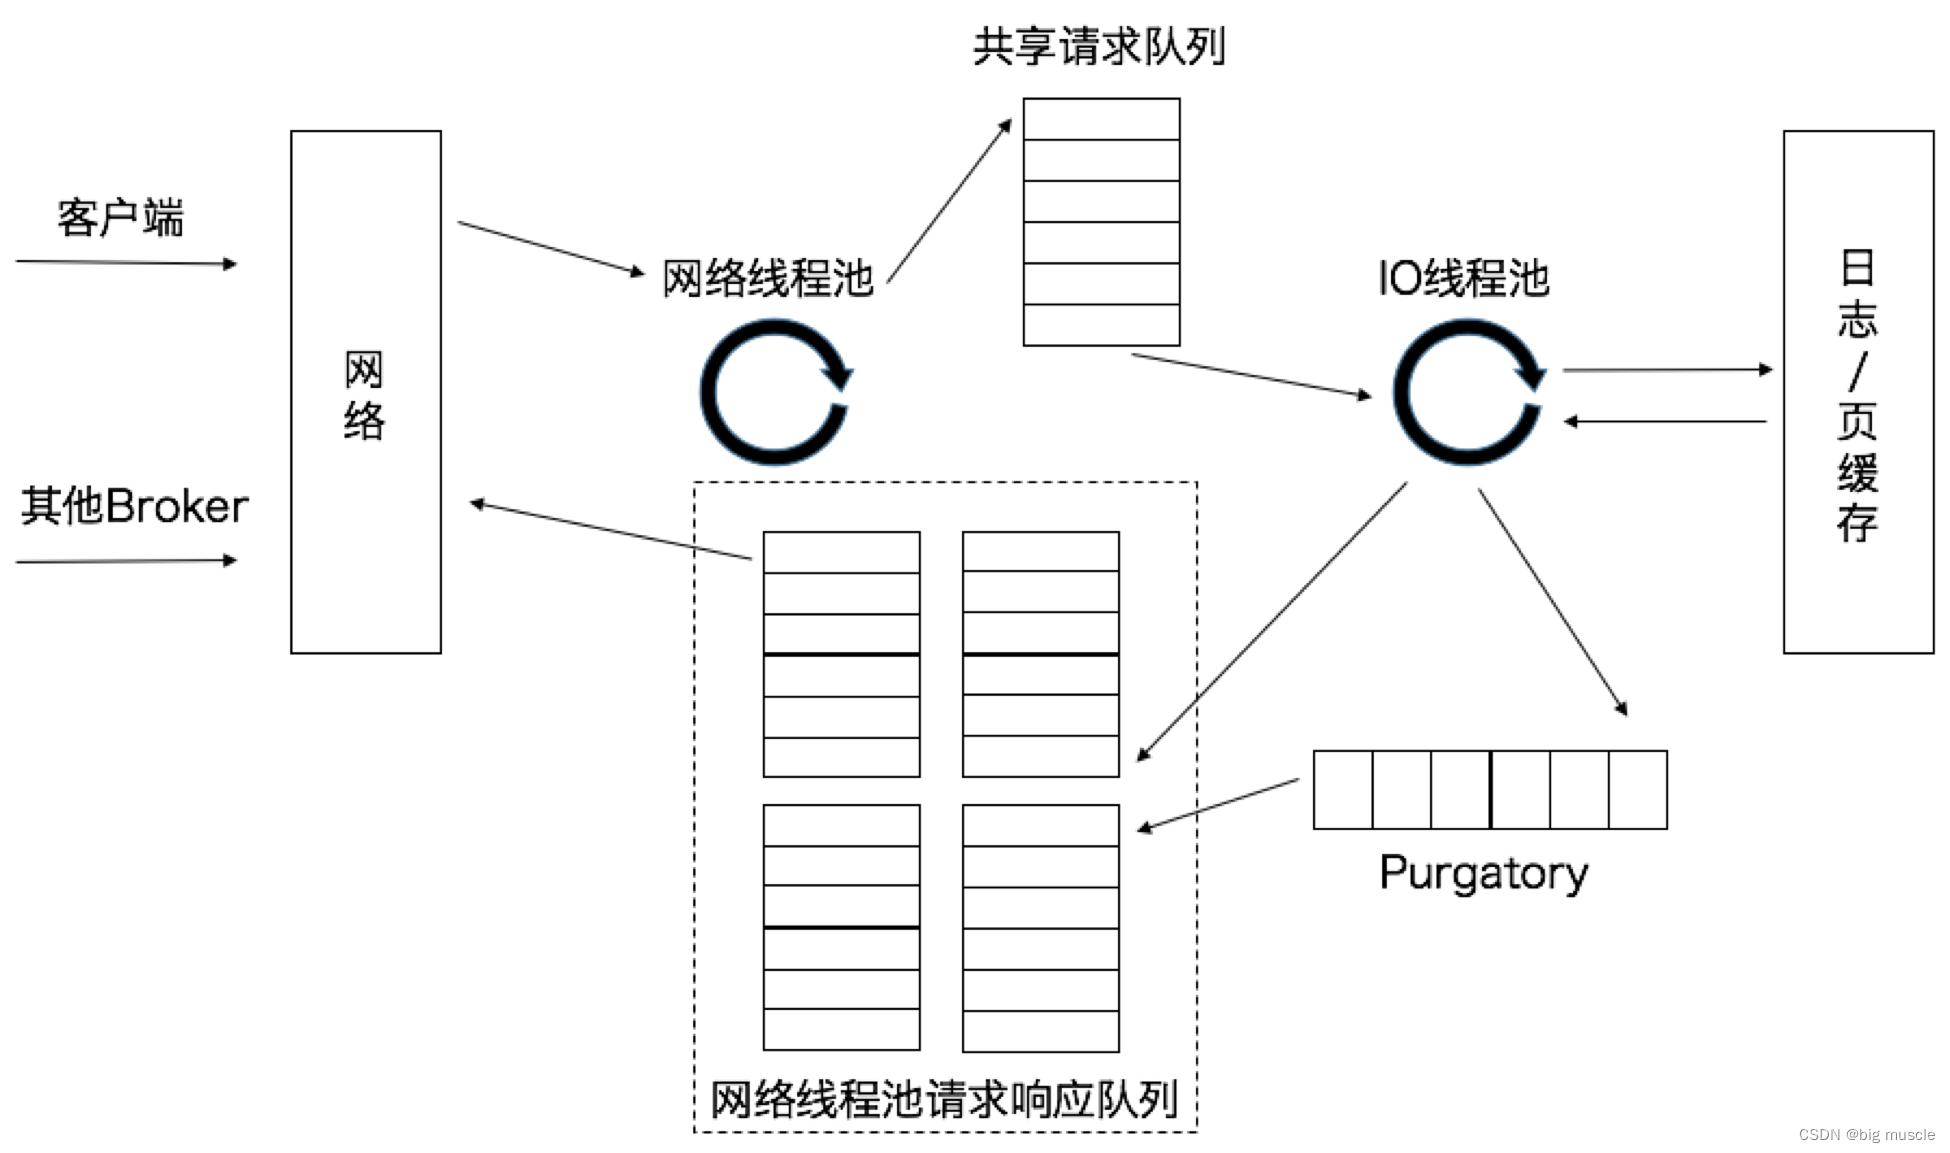
对于数据类请求和控制类请求优先级不同,将控制类请求直接丢到业务线程处理,提升优先级
3.3 控制器组件(Controller,某个broker)
它是 Apache Kafka 的核心组件。它的主要作用是在 Apache ZooKeeper 的帮助下管理和协调整个 Kafka 集群(broker集群),每个broker都能充当控制器,只能有一个控制器,Broker 在启动时,会尝试去 ZooKeeper 中创建 /controller 节点。Kafka 当前选举控制器的规则是:第一个成功创建 /controller 节点的 Broker 会被指定为控制器
控制器保存了什么数据
- 所有主题信息
- 所有broker信息
- 所有涉及运维任务的分区
数据服务,控制器上保存了最全的集群元数据信息;数据其实在 ZooKeeper 中也保存了一份。每当控制器初始化时,它都会从 ZooKeeper 上读取对应的元数据并填充到自己的缓存中。有了这些数据,控制器就能对外提供数据服务了。这里的对外主要是指对其他 Broker 而言,控制器通过向这些 Broker 发送请求的方式将这些数据同步到其他 Broker 上
3.4 高水位(生产者的位移)
作用
- 定义消息可见性,即用来标识分区下的哪些消息是可以被消费者消费的。
- 帮助 Leader 副本确定其高水位,也就是分区高水位。进而帮助 Kafka 完成副本同步。
HW值被用于衡量副本备份的成功与否以及在出现failture时作为日志截断的依据
consumer无法消费未提交消息。这句话如果用以上名词来解读的话,应该表述为:consumer无法消费分区下leader副本中位移值大于分区HW的任何消息。这里需要特别注意分区HW就是leader副本的HW值。
LEO:日志末端位移
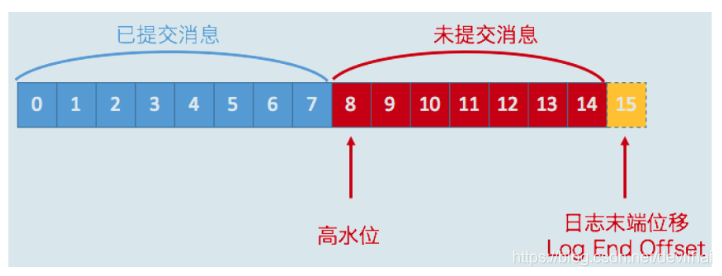
规则
leader根据自己和副本的leo确定同步情况
leader保留自己的hw和leo以及所有的follower副本的LEO,
follow保留自己的hw和leo
leo会在插入log时更新,leader的hw = min(自己及副本的leo),follow的hw=min(leader的hw和自己的leo)
机制
通过follower尚未发送FETCH请求及响应,来更新hw和leo,保持主从同步;但HW值的更新是异步延迟的,Follower 副本的高水位更新需要一轮额外的拉取请求才能实现,故这中间发生的任何崩溃都可能导致HW值的过期
Follower HW 在某一阶段内总是落后于 Leader HW,因此副本在根据 HW 值截取数据时将有可能发生数据的丢失或不一致。
后面有**leader epoch来标识leader broker的起始偏移值解决日志截断**的问题
原来通过hw做日志截断,现在向leader副本发送一个请求,来获取Follower自身所在 Epoch 的 Last Offset,避免截断;broker内存中为每个分区都缓存 Leader Epoch 数据,同时它还会定期地将这些信息持久化到一个 checkpoint 文件中
leader epoch前提是 leader的leo和follower的leo是同步的,需要版本是因为如果主节点切换多次,那么现在的leader不包含当前follower的leo信息;
日志截断
恢复时必须要放弃之前提交消息,如果不进行日志截断,那么新leaderB如果收到又一个producer的消息那么他这个位置和老leader这个位置就产生数据不一致了。所以将LEO恢复到HW位置,因为只有HW位置之前的数据都是所有副本已备份并且认同的,之后的数据并没有与所有副本(ISR集合)确认,需要抛弃这些数据然后重新和新的leader进行同步。
4. 管理与监控
配置
在config/server.properties改主要的配置信息
Topic 级别参数会覆盖全局 Broker 参数的值
Broker 端参数
- zookeeper.connect(zookeeper集群地址)
- auto.create.topics.enable(是否允许自动创建 Topic)
- log.retention.{hour|minutes|ms}(一条消息数据被保存多长时间。从优先级上来说 ms 设置最高、minutes 次之、hour 最低)
- log.retention.bytes(这是指定 Broker 为消息保存的总磁盘容量大小)
- message.max.bytes(控制 Broker 能够接收的最大消息大小)
Topic 级别参数
- retention.ms(规定了该 Topic 消息被保存的时长)
- retention.bytes:(规定了要为该 Topic 预留多大的磁盘空间)
- max.message.bytes( Kafka Broker 能够正常接收该 Topic 的最大消息大小)
Topic级别参数配置时机
- 创建 Topic 时进行设置
- 修改 Topic 时设置
主题管理
创建topic ./kafka-topics.sh --create --zookeeper 10.101.98.149:2181 --replication-factor 1 --partitions 1 --topic aaa
查看topic c ./kafka-topics.sh --zookeeper 10.101.98.149:2181 --list
查看某个topic的配置信息 ./kafka-topics.sh --zookeeper 10.101.98.149:2181 --describe --topic aaa
增加分区 ./kafka-topics.sh --zookeeper 10.101.98.149:2181 --alter --topic aaa --partitions 2
修改主题配置 ./kafka-configs.sh --zookeeper 10.101.98.149:2181 --entity-type topics --entity-name aaa --alter --add-config
max.message.bytes=10485760
动态broker参数(看)
修改之后无需重启broker即可生效
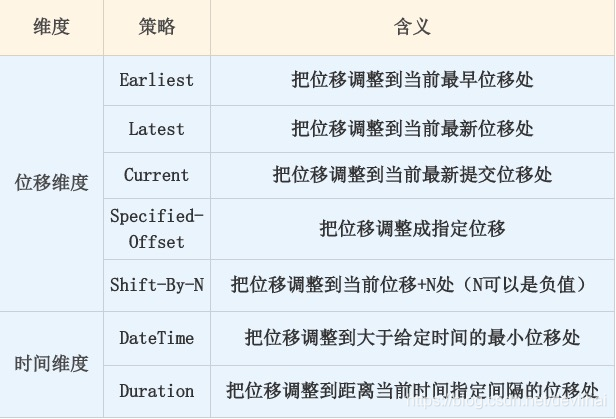
重置消费者位移
策略:
方式:
- 通过消费者 API 来实现。
- 通过 kafka-consumer-groups 命令行脚本来实现(11之后的版本)
常用工具脚本
- 创建生产者 ./kafka-console-producer.sh --broker-list localhost:9092 --topic aaa
- 创建消费者 ./kafka-console-consumer.sh --zookeeper 10.101.98.149:2181 --topic aaa --group test-group --from-beginning
- 启动 ./kafka-server-start.sh …/config/server.properties
- 后台启动: ./kafka-server-start.sh config/server.properties >/dev/null 2>&1 &
等等
看32,33,34
跨集群备份解决方案(看35)
通常我们把数据在单个集群下不同节点之间的拷贝称为备份,而把数据在集群间的拷贝称为镜像(Mirroring)
MirrorMaker
主机监控
top监控load和cpu使用率
集群监控
调优
面试
为什么不支持读写分离,仅leader可读写
自 Kafka 2.4 之后,Kafka 提供了有限度的读写分离。
场景不适用。读写分离适用于那种读负载很大,而写操作相对不频繁的场景。
延迟大:同步机制。Kafka 采用 PULL 方式实现 Follower 的同步,同时复制延迟较大。
Replica副本的作用
在 Leader 副本所在的 Broker 宕机后,随时准备应聘 Leader 副本
自 Kafka 2.4 版本开始,社区可以通过配置参数,允许 Follower 副本有限度地提供读服务
如何防止重复消费
幂等id
每次消费需提交offset
保证数据不丢
生产者生产消息可以通过comfirm配置ack=all解决
消费者丢失可以关闭自动提交offset功能,系统处理完成时提交offset
Broker同步过程中leader宕机可以通过配置ISR副本+重试解决
如何保证顺序消费
单个分区,单个消费者消费
如只需要单key有序,为每个key申请单独内存 queue

 2099


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


