使用python爬取微信公众号文章

爬取微信公众号发布的所有文章(包括阅读数,在看数,点赞数) 这次写爬虫。我爬取了某个微信公众号的全部文章的 文章链接 url 文章标题 title 发布时间 update_time 封面链接 cover 阅读数 read_num 在看数 like_num 若想直接拿代码来用,可以直接跳到最后。 首先要找到所有文章链接地址 一般来说,网上是搜不到某个公众号的全部文章的。但是我们利用 微信公众号平台 就能够一次性找到。 要用到它,肯定需要先注册登录一个微信公众号。当我们来到后台界面。 1,首先进入图文素材 2,创建新的图文 ... 阅读详情

一、背景


有时候看到某一个微信公众号中的文章,觉得写的非常不错,有种当时就想把该公众号所有的文章都看完的冲动,但是使用手机看不是特别方便,就想把文章全部下载下来到电脑上面看。

二、爬虫实现步骤

使用python爬取微信公众号文章,总共分为如下几步:

第一步:获取微信公众号的文章地址和入参规则;

第二步:将爬取的文章标题和url保存到数据库;

第三步:针对微信公众号连续爬取超过60次会提示访问太频繁而拒绝响应(记录当前爬取到的页码及异常情况处理)【{'base_resp': {'err_msg': 'freq control', 'ret': 200013}}】

三、爬虫实现过程

第一步:需要有一个个人微信公众号,订阅号也是可以的。

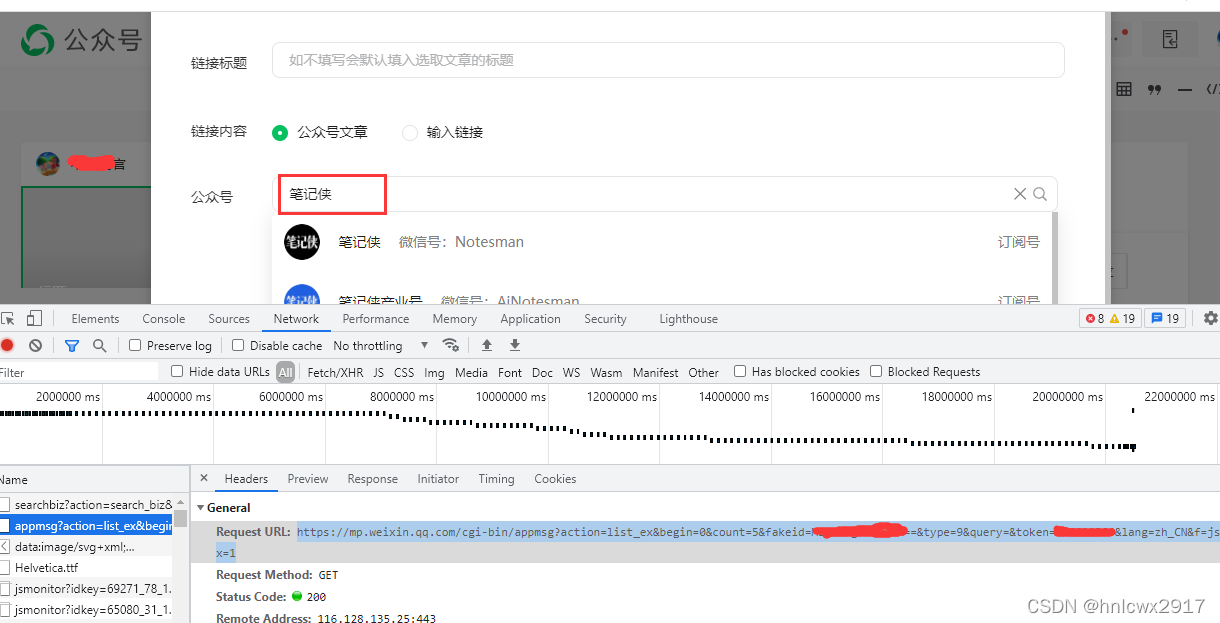
第二步:进入微信公众平台,新建图文素材,在界面上方有一个“超链接”的按钮,点击进入。

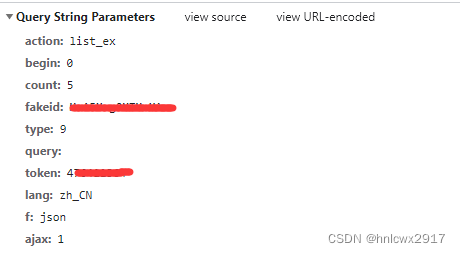
第三步:输入公众号名称进行检索,按F12,如下图显示公众号的文章请求地址、cookie、user-agent、请求参数。
# -*- coding: utf-8 -*-
import requests
import time
import csv
import pandas as pd
import traceback
import mymysql
import uuid

# 目标url
url = "https://mp.weixin.qq.com/cgi-bin/appmsg"

# 使用Cookie,跳过登陆操作
headers = {
  "Cookie": "appmsglist_action_3202723363=card; pgv_pvid=532343460; ua_id=OlRastLitDwq627TAAAAAJzUEREVZq7JaMyyQMxMEIw=; wxuin=42623452127; mm_lang=zh_CN; uuid=2702030d23431cc966563362; rand_info=CAESIKyltjg5bkliwmXupK/rdnCAEv5Nymy4o9rKsv12DRqR; slave_bizuin=3202723363; data_bizuin=3202723363; bizuin=3204433363; data_ticket=3JEz+aeGoOMeIRs/DjEPhZnKfqzismwik5LzOk6uXt+Z7CBkXJ+taoQJdCFeb8bJ; slave_sid=Zk5zbFBjODBTT3ZHVGR4ZzRWSTRMZnlPY2tTN2pjVnI5MFdyZzRxX2NNWTRNVV9aUHFjdlZ4Y0xrallmQ2c0WmcxWWFoaGZJVGlPVUJzOTBRNzhWSGpKT216a2lOS2c1VHF4YkVVa0drR2R0VlRqR01tMEoyM2dLMXhIb2M5TGZNOHNJQXRPaTl0SGpZMzd2; slave_user=gh_968271d6ce85; xid=81ded7b144cd53195323432e6e776",
  "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/92.0.4515.131 Safari/537.36",
}

data = {
    "token": "474544364",
    "lang": "zh_CN",
    "f": "json",
    "ajax": "1",
    "action": "list_ex",
    "begin": "0",
    "count": "5",
    "query": "",
    "fakeid": "MzA5MzMA==",
    "type": "9",
}

#时间转日期格式
def timetoDate(timeStamp):
    #timeStamp = 1643275175
    timeArray = time.localtime(timeStamp)
    otherStyleTime = time.strftime("%Y-%m-%d", timeArray)
    return otherStyleTime

#抓取公众号文章
def grapArtile():
    # 计数器
    counter = 0
    # 页数
    page = 0
    content_list = []
    # for i in range(20):
    content_json = []
    # 查询最新的页码
    mysqlConn = mymysql.MYMYSQL()
    mysqlConn.query()
    page = mysqlConn.page_no
    try:
        while 1:
            data["begin"] = page*5
            # 使用get方法进行提交
            content_json = requests.get(url, headers=headers, params=data).json()
            msglen = len(content_json["app_msg_list"]);
            #如果没有文章了,退出
            if msglen == 0:
                break
            items = []
            # 返回了一个json,里面是每一页的数据
            for item in content_json["app_msg_list"]:
                # 提取每页文章的标题及对应的url
                wzid = uuid.uuid1().hex
                yz = (wzid, item["title"], item["link"], timetoDate(item["create_time"]))
                items.append(yz)
                counter += 1
                print("爬取第" + str(page + 1) + "页,第" + str(counter) + "条")
            mysqlConn.batchInsert(items)
            page = page + 1
            time.sleep(3)
    except:
        print("出现【KeyError】异常,文件保存,原因")
        print(content_json)
        traceback.print_exc()
        mysqlConn.update(page)
        time.sleep(30*60)
        grapArtile()
    else:
        print("出现【KeyError】异常,文件保存")
        print(content_json)
        #saveFile(content_list)
        mysqlConn.update(page)
        time.sleep(30*60)
        grapArtile()

grapArtile()

第五步:将文章标题和url保存到数据库

import pymysql
import traceback
import uuid
class MYMYSQL():
    def __init__(self,):
        # 打开数据库连接
        conn = pymysql.connect("127.0.0.1", "user", "password", "python_pc", charset='utf8')
        self.conn = conn

    # 查询
    def query(self):
        self.conn.select_db('python_pc')
        # 获取游标
        cur = self.conn.cursor()
        cur.execute("select * from t_record where sno=1")
        while 1:
            res = cur.fetchone()
            if res is None:
                # 表示已经取完结果集
                break
            print(res[1])
            self.page_no = res[1]
        cur.close()

    #更新
    def update(self,cur_no):
        self.conn.select_db('python_pc')
        # 获取游标
        cur = self.conn.cursor()
        nums = cur.execute("update t_record set page_no="+str(cur_no)+",update_time=now() where sno=1")
        print("更新的数据条数:"+str(nums))
        cur.close()
        self.conn.commit()

    def batchInsert(self, list):
        self.conn.select_db('python_pc')
        # 获取游标
        cur = self.conn.cursor()

        # 另一种插入数据的方式,通过字符串传入值
        sql = "insert into t_article values(%s,%s,%s,%s)"
        insert = cur.executemany(sql, list)
        cur.close()
        self.conn.commit()


if __name__ == "__main__":
    try:
        me = MYMYSQL()
        # me.query()
        # me.update(3)
        # me.query()

        # list = []
        # for i in range(0,5):
        #     wzid = uuid.uuid1().hex
        #     yz = (wzid,'111','222')
        #     list.append(yz)
        # print(list)
        # me.batchInsert(list)


    except:
        traceback.print_exc()

 参考资料:
https://blog.youkuaiyun.com/jingyoushui/article/details/100109164
--python操作mysql数据库
https://blog.youkuaiyun.com/kongsuhongbaby/article/details/84948205

Python中的爬虫实战:微信公众号爬虫 如果你有兴趣使用Python爬虫来发掘更多有价值的信息,本例将是一个伟大的起点。在这个数字化时代,互联网上充满了大量的数据,爬虫已成为获取数据的重要手段,因此,python爬虫在数据分析和挖掘方面有着广泛的应用。微信公众号是一种流行的社交媒体平台,用于在线发布文章,是许多公司和自媒体推广和营销的重要工具。本例中,我将使用搜狗微信搜索提供的服务,它可以轻松地获取每个公众号在微信上的文章列表页面。首先我们需要找到这个公众号的名称或者ID,例如:“Python之禅”公众号的ID是“Zen-of-Python”。 阅读详情

相关推荐

Python | 爬取微信公众号推文 | 仅供测试

之前一直想偷懒写个脚本,方便后续整理推文,昨天测试了半天,后续因为太频繁结果被封了ip。今天重新修改了代码,终于算是可以了。以下是抓取的结果:非常简单,只有两部分内容, 标题和link简单调试了一个脚本方便自己的后续推文整理,当然,爬取的内容可能不仅仅是原创推文,以及一些图片的文字。可以再进行相应调整。该教程为个人学习记录,本人公开的代码以及爬取的文本为本人个人公众号,相关代码仅供测试与学习!参考方法:https://github.com/wnma3mz/wechat_articles_spider?

【更新于公众号 | 简谱学记】 3017

Python爬虫实战系列:微信公众号文章爬取的5种技术方案总结及代码示例!

本文只是基于近期搜索调研了一些内容后的抛砖引玉总结,具体一些方案详细技术实现大家可私下自己尝试。

2301_78217634的博客 3万+

如何使用python脚本爬取微信公众号文章

在座的各位可能经常听到一个词,叫“爬虫”,这是一种能够悄无声息地将网站数据下载至本地设备的程序。利用爬虫,您无需亲自访问特定网站,逐个点击并手动下载所需数据。相反,爬虫能够全自动地为您完成这项任务,从网站上获取您所需的信息,并将其下载到您的设备上,而整个过程无需您进行任何干预。

2201_76124692的博客 4032

python学习:爬虫爬取微信公众号数据

参考: https://blog.youkuaiyun.com/qq_45722494/article/details/120191233。上述第一步可以获取到cookie、fakeid、token、user_agent等,编辑成wechat.yaml文件,如下所示。1、使用fiddler或Charles抓包。1、登录微信公众平台。

nzbing的博客 1万+

如何使用python脚本爬取微信公众号文章?

在座的各位可能经常听到一个词,叫“爬虫”,这是一种能够悄无声息地将网站数据下载至本地设备的程序。利用爬虫,您无需亲自访问特定网站,逐个点击并手动下载所需数据。相反,爬虫能够全自动地为您完成这项任务,从网站上获取您所需的信息,并将其下载到您的设备上,而整个过程无需您进行任何干预。

R5463995的博客 3804

[Python3网络爬虫开发实战]使用代理爬取微信公众号文章

本节目标 我们的主要目标是利用代理爬取微信公众号的文章,提取正文、发表日期、公众号等内容,爬取来源是搜狗微信,其链接为 http://weixin.sogou.com/,然后把爬取结果保存到 MySQL 数据库。 准备工作 首先需要准备并正常运行前文中所介绍的代理池。这里需要用的 Python 库有 aiohttp、requests、redis-py、pyquery、Flask、PyMySQL...

python学习教程 1173

如何使用 Python 爬取微信公众号文章

我比较喜欢看公众号,有时遇到一个感兴趣的公众号时,都会感觉相逢恨晚,想一口气看完所有历史文章。但是微信的阅读体验挺不好的,看历史文章得一页页的往后翻,下一次再看时还得重复操作,很是麻烦。 于是便想着能不能把某个公众号所有的文章都保存下来,这样就很方便自己阅读历史文章了。 话不多说,下面我就介绍如何使用 Python 爬取微信公众号所有文章的。 主要有以下步骤: 1 使用 Fiddler 抓取公众号接口数据 2 使用 Python 脚本获取公众号所有历史文章数据 3 保存历史文章 Fiddler

hbqjzx的专栏 1785

使用Python爬虫技术爬取微信公众号文章及评论的详细教程

在互联网上,微信公众号不仅是个人和企业传播信息的平台,也是大量互动数据的来源。爬取微信公众号的文章内容及评论数据,对于学术研究、市场分析等方面具有重要意义。然而,微信的反爬虫机制复杂,常规的爬虫方法并不适用于微信公众号。为了爬取微信公众号文章,我们不仅需要处理静态页面,还需要应对JavaScript渲染、异步加载、验证码等问题。本文将以微信公众号的历史文章为例,介绍如何利用Python爬取文章及评论。

2201_76125261的博客 2275

如何用python爬取公众号文章_如何使用 Python 爬取微信公众号文章

我比较喜欢看公众号,有时遇到一个感兴趣的公众号时,都会感觉相逢恨晚,想一口气看完所有历史文章。但是微信的阅读体验挺不好的,看历史文章得一页页的往后翻,下一次再看时还得重复操作,很是麻烦。于是便想着能不能把某个公众号所有的文章都保存下来,这样就很方便自己阅读历史文章了。话不多说,下面我就介绍如何使用 Python 爬取微信公众号所有文章的。主要有以下步骤:1 使用 Fiddler 抓取公众号接口数据...

weixin_39524574的博客 1240

python-41-使用selenium爬取微信公众号下的所有文章列表

Selenium是一个用于Web应用程序测试的工具,Selenium测试直接运行在浏览器中,就像真正的用户在操作一样。

qq_20466211的博客 887

使用Python爬虫技术爬取微信公众号文章内容:从接口分析到抓包爬取

发送请求:通过requests或urllib等库发送HTTP请求获取网页内容。解析数据:通过lxml等库解析HTML,提取我们需要的数据。数据存储:将抓取到的数据存储到文件或数据库中。除了直接抓取HTML页面外,有时我们还需要分析API接口,尤其是在一些网站的数据通过API返回,通常以JSON或XML格式提供。在本篇博客中,我们介绍了如何使用Python爬取微信公众号的文章内容。我们通过分析HTML结构和API接口,结合抓包技术,详细讲解了如何抓取和解析文章数据。

2201_76125261的博客 2769

如何使用 Python 爬取微信公众号文章?

有时候我们遇到一个好的公众号,里面的每篇都是值得反复阅读的,这时就可以使用公众号爬虫将内容抓取保存下来慢慢赏析。安装 FiddlerFiddler 的下载地址为:https://www....

纯洁的微笑 1万+

全本地AI代理实战:零数据外泄的本地化Agent工作流搭建

全本地AI代理是一种将大语言模型推理、长期记忆与工具调用完全运行于用户本地设备的智能体架构,其核心原理在于通过进程隔离与标准化协议实现模型层、记忆层和工具层的解耦协同。相比依赖云端API的传统方案,它在数据主权、响应确定性与环境复现性上具备不可替代的技术价值。典型应用场景包括法务合规文档处理、离线工业现场辅助决策、以及高敏感度企业知识管理。本文聚焦Qwen2+Ollama+SurrealDB+Agno技术栈,详解如何构建可落地的全本地AI代理系统,覆盖从硬件适配、向量记忆建模到多模态插件协同的完整链路。

weixin_34194964的博客 650

python爬虫爬取微信_如何使用 Python 爬取微信公众号文章

我比较喜欢看公众号,有时遇到一个感兴趣的公众号时,都会感觉相逢恨晚,想一口气看完所有历史文章。但是微信的阅读体验挺不好的,看历史文章得一页页的往后翻,下一次再看时还得重复操作,很是麻烦。于是便想着能不能把某个公众号所有的文章都保存下来,这样就很方便自己阅读历史文章了。话不多说,下面我就介绍如何使用 Python 爬取微信公众号所有文章的。主要有以下步骤:1 使用 Fiddler 抓取公众号接口数据...

weixin_39840635的博客 562

#1机器学习(西瓜书)自学记录

《机器学习 》 Datawhale 组队学习, 吃瓜自学笔记。

qq_74168740的博客 1149

从零到一:用STM32 FOC算法驯服无刷电机的艺术

本文详细介绍了如何使用STM32和FOC算法实现无刷电机的高性能控制。从硬件搭建、参数识别到闭环调节,一步步解析FOC算法的核心原理与调优技巧,帮助开发者掌握电机控制的关键技术,实现从零到一的精准驯服。

kkk56的博客 918

python 微信公众号发文章_如何使用 Python 爬取微信公众号文章

我比较喜欢看公众号,有时遇到一个感兴趣的公众号时,都会感觉相逢恨晚,想一口气看完所有历史文章。但是微信的阅读体验挺不好的,看历史文章得一页页的往后翻,下一次再看时还得重复操作,很是麻烦。于是便想着能不能把某个公众号所有的文章都保存下来,这样就很方便自己阅读历史文章了。话不多说,下面我就介绍如何使用 Python 爬取微信公众号所有文章的。主要有以下步骤:1 使用 Fiddler 抓取公众号接口数据...

weixin_39866487的博客 508

【VAE学习笔记】全面通透地理解VAE(Variational Auto Encoder)

完整笔记:http://www.gwylab.com/note-vae.html 李宏毅老师的教程视频:https://www.bilibili.com/video/av15889450/?p=33 —————————————————————————————————   依据李宏毅老师的讲解,我整理了一番VAE的笔记。先简单介绍一下VAE,VAE作为一个生成模型,其基本思路是很容易理解的:把一堆真...

a312863063的博客 14万+

python爬取微信公众号怎么申请_如何使用 Python 爬取微信公众号文章

我比较喜欢看公众号,有时遇到一个感兴趣的公众号时,都会感受相逢恨晚,想一口气看完全部历史文章。可是微信的阅读体验挺很差的,看历史文章得一页页的日后翻,下一次再看时还得重复操做,非常麻烦。html因而便想着能不能把某个公众号全部的文章都保存下来,这样就很方便本身阅读历史文章了。python话很少说,下面我就介绍如何使用 Python 爬取微信公众号全部文章的。web主要有如下步骤:json1 使用 ...

weixin_39610722的博客 228

RabbitMQ的使用(JAVA)

Java快速上手的MQ上线!

.............. 1万+

MySQL 分库分表及其平滑扩容方案

MyCAT不仅仅可以用作读写分离,以及分表分库、容灾管理,而且可以用于多租户应用开发、云平台基础设施,让你的架构具备很强的适应性和灵活性。分表对于一张多行(记录)多列(字段)的二维数据表,又分两种情形(1)垂直分表竖向切分,不同分表存储不同的字段,可以把不常用或者大容量、或者不同业务的字段拆分出去;扩容前每个节点的数据,有一半要迁移至一个新增节点中,对应关系比较简单。此时,四个节点的数据都已完整,只是有冗余(多存了和自己配对的节点的那部分数据),择机清除即可(过后随时进行,不影响业务)。...

m0_71777195的博客 1929
上一篇: nginx日志的配置
下一篇: vmware虚拟机安装centos7及网络配置
hnlcwx2917
博客等级 码龄12年 42粉丝 55原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值