Kafka核心原理之消费端

Kafka(四)【Kafka 消费者】 Kafka 消费者 阅读详情

消费端消费流程

1)Consumer初始化

KafkaConsumer的构造方法中初始化了许多组件,重要组件如下:

  • metadata:ConsumerMetadata对象,负责存储Kafka集群的元数据信息。
  • client:ConsumerNetworkClient对象,上层的网络客户端,内部封装了一个NetworkClient对象,NetworkClient对象负责底层网络数据的读写。
  • assignors:消费者分区分配器列表,当前消费者如果被选举为消费者组的Leader,将使用该分配器进行分区分配。
  • coordinator:ConsumerCoordinator对象,消费者协调器组件,负责与服务端消费者组协调器交互。
  • fetcher:Fetcher对象,实际拉取服务端消息的组件。

其他组件:

  • 消费者拦截器链(可选)。
  • 消费者解码器。
  • 消费者数据统计器。

2)Consumer订阅主题

消费者拉取消息前,消费者需要先声明自己订阅的主题,通过KafkaConsumer#subscribe()方法实现。该方法中主要涉及一些属性的设置,大致分为以下几步:

  • 1)考虑到多次订阅主题不一致的情况,调用Fetcher#clearBufferedDataForUnassignedTopics()方法移除已经接收但不在本次订阅的Topic列表中的数据。
  • 2)调用SubscriptionState#subscribe()方法重置订阅的Topic列表。
  • 3)调用Metadata#requestUpdateForNewTopics()方法将更新元数据的标识为needPartialUpdate设置为true,后续消费者将会发送更新元数据请求。

3)Consumer拉取消息

消费者声明订阅的主题后,调用KafkaConsumer#poll()方法进入消息拉取流程,此处为消息消费的入口,关键步骤如下:

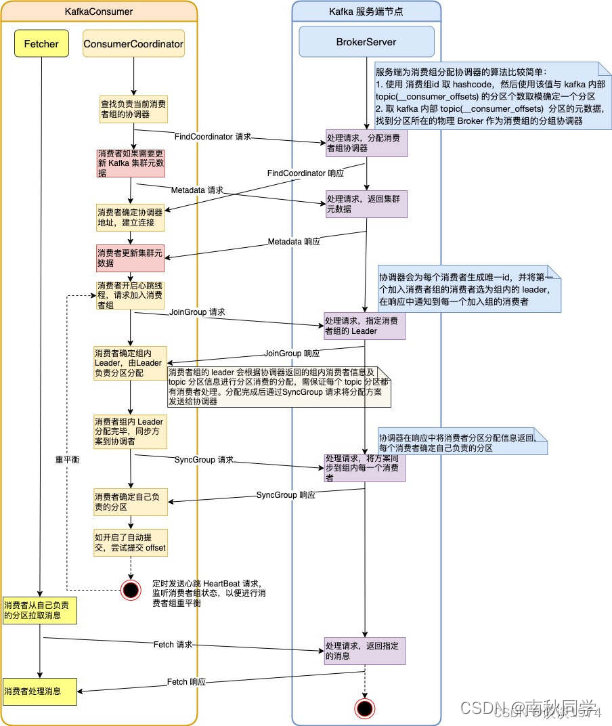
  • 1)确定消费者组中的协调器(Coordinator)并与其建立Socket连接。确定Coordinator的算法如下:
    • 计算Math.abs(groupID.hashCode) % offsets.topic.num.partitions参数值(默认为50) ,假设计算得到的结果为10。
    • 寻找__consumer_offsets中分区10的Leader副本所在的Broker ,该Broker即为该消费者组的Coordinator。
  • 2)消费者加入消费者组。消费者组中所有消费者向Coordinator发送JoinGroup请求。Coordinator收到消费者组中所有消费者发送的JoinGroup请求后,从中选择一个消费者作为消费者组的Leader,并将所有成员信息以及他们订阅的Topic信息发送给Leader。注意:Leader是消费者组中的一个消费者实例,而Coordinator是集群的一个Broker。是Leader(不是Coordinator)负责为整个消费者组成员制定分区分配方案。
  • 3)根据分区分配策略为消费者组指定分配方案。消费者加入消费者组后,由消费者组中的Leader开始制定分区分配方案,根据设定的分区分配策略,决定哪个消费者消费哪些Topic中的哪些分区,一旦分配完成,Leader会将分配方案封装成SyncGroup请求发送给Coordinator。注意:消费者组中所有消费者都会向Coordinator发送SyncGroup请求,不过只有Leader发送的请求中包含分配方案。Coordinator收到分配方案后将属于每个Consumer的分配方案单独抽取出来做作为SyncGroup请求的Response返回给各个Consumer。
  • 4)消费者根据分配的分区拉取消息进行消费。先从队列缓存中获取消息记录,存在则直接返回;否则通过消费者网络通信客户端(ConsumerNetworkClient)从Broker拉取消息存入队列缓存,再返回。
  • 5)消费者与协调器保持心跳连接。消费者会启动一个心跳线程与Coordinator保持连接,如果协调器返回消费者组状态变化,则进行重新加入消费者组的重平衡动作。注意:如果是消费者协调器失连,则调用AbstractCoordinator#lookupCoordinator()尝试重新连接。

整体流程如图所示:
消费者消费方式

当生产者将消息发送到Kafka集群后,会转发给消费者进行消费。消息的消费模型有两种:推送模式(push)和拉取模式(pull)。

推送模式

消息的推送模式需要记录消费者的消费状态。当把一条消息推送给消费者后,需要维护消息的状态(如:标记这条消息已经被消费),这种方式无法很好地保证消息被处理。如果要保证消息被处理,发送完消息后,需要将其状态设置为已发送。收到消费者的确认收到消息后,才将其状态更新为已消费,这就需要记录所有消息的消费状态。显然这种方式不可取。这种方式还存在一个明显的缺点,就是消息被标记为已消费后,其他消费者就不能再进行消费了。

另外,推送模式消息发送速率由Broker决定,肯能由于消费端处理消息不及时,造成网络拥塞。

拉取模式

由于推送模式存在一定的缺点,因此Kafka采用消费拉取的模式来消费消息。由每个消费者维护自己的消费状态,并且每个消费者互相独立地顺序拉取每个分区的消息。消费者通过偏移量的信息来控制从Kafka中消费的消息。

由消费者通过偏移量进行消费控制的优点在于,消费者可以按照任意的顺序消费消息。如:消费者可以通过重置偏移量信息,重新处理之前已经消费过的消息;或者直接跳转到某一个偏移量位置,并开始消费。

如果消费者已经将消息进行了消费,Kafka并不会立即将消息删除,而是会将所有消息进行保存(即:持久化保存到Kafka的消息日志中)。无论消息有没有被消费,用户可以通过设置保留时间来清理过期的消息数据。

推送模式与拉取模式的区别

在推送模式下,由于消息的发送速率由Broker决定,Broker的目标是尽可能以最快的速度传递消息。因此,很难适应消费速率不同的消费者,从而造成消费者来不及处理消息。消费者来不及处理消息就可能造成消息的阻塞,从而降低系统的处理能力。

在拉取模式下,用户可以根据消费者的处理能力调整消息消费的速率,但在这种模式下也存在一定的缺点。如果消息的生产者没有产生消息,就可能造成消费者陷入循环中,一直等待数据到达。为了避免这种情况出现,消费者在拉取消息时会传入一个时长参数(timeout),如果当前没有可拉取的消息,消费端会等待一段时间(timeout)后再进行拉取。

Kafka消费端采用拉取模式(长轮询机制)从Broker中读取数据。

消费者负载均衡机制(重平衡)

重平衡本质上是一组协议,它规定了一个消费者组是如何达成一致来分配订阅Topic的所有分区的。比如:消费者组A有3个消费者实例,它要消费一个拥有6个分区的Topic,每个消费者消费Topic中的2个分区,这就是重平衡。

重平衡是相对于消费者组而言的,每个消费者组会从集群的Broker中选出一个作为组协调者(Group Coordinator)。Group Coordinator负责对整个消费者组的状态进行管理,当有触发Rebalance的条件发生时,促使生成新的分区分配方案。

重平衡触发条件

重平衡触发条件:

  • 1)消费者组的成员发生变更。如:有新的消费者加入消费者组、有消费者离开消费者组、有消费者发生奔溃等。
  • 2)消费者组订阅的Topic分区数发生变更。
  • 3)消费者组订阅的Topic数量发生变更,这种情况主要发生在基于正则表达式订阅Topic时,当有新匹配的Topic创建时则会触发Rebalance。

其实无论哪种触发条件,根本原因是Topic中分区或者消费者实例发生了变更。

重平衡协议

重平衡本质上是一组协议,消费者组和协调器使用这组协议共同完成消费者组的重平衡。Kafka新版本提供了以下5种请求来处理重平衡:

  • JoinGroup请求:消费者请求加入组。
  • SyncGroup请求:消费者组的Leader将分配方案同步更新到组内所有成员中。
  • Heartbeat请求:消费者定期向协调器汇报心跳,表明自己依然存活。
  • LeaveGroup请求:消费者主动通知协调器自己将要离开消费者组。
  • DescribeGroup请求:查看组的所有信息,包括成员信息、协议信息、分配方案以及订阅信息等。该请求主要供管理员使用,协调器不使用该请求实现Rebalance。

重平衡过程中, 协调器要处理消费者发过来的JoinGroup和SyncGroup请求 ,当消费者主动离组时会发送LeaveGroup请求给协调器。

重平衡完成后,组内所有消费者都需要定期地向协调器发送心跳(Heartbeat)请求,而每个 消费者也是根据心跳请求的响应信息中是否包含REBALANCE_IN_PROGRESS判断当前消费者组开启了新一轮重平衡。

重平衡流程

消费者组在执行Rebalance之前必须先确认Coordinator在哪个Broker上,并创建与该Broker通信的Socket连接。

确定Coordinator的算法与确定Offset被提交到__consumer_offsets目标分区的算法相同:

  • 计算Math.abs(groupID.hashCode) % offsets.topic.num.partitions参数值(默认为50) ,假设计算得到的结果为10。
  • 寻找__consumer_offsets中分区10的Leader副本所在的Broker ,该Broker即为该消费者组的Coordinator。

成功连接Coordinator之后,便可以执行重平衡操作,重平衡主要分为两步:加入组和同步更新分配方案。

  • 加入组:消费者组中所有消费者向Coordinator发送JoinGroup请求。Coordinator收到消费者组中所有消费者发送的JoinGroup请求后,从中选择一个消费者作为消费者组的Leader,并将所有成员信息以及他们订阅的Topic信息发送给Leader。注意:Leader是消费者组中的一个消费者实例,而Coordinator是集群的一个Broker。是Leader(不是Coordinator)负责为整个消费者组成员制定分区分配方案。
  • 同步更新分配方案:消费者加入消费者组后,由消费者组中的Leader开始制定分区分配方案,根据设定的分区分配策略,决定哪个消费者消费哪些Topic中的哪些分区,一旦分配完成,Leader会将分配方案封装成SyncGroup请求发送给Coordinator。注意:消费者组中所有消费者都会向Coordinator发送SyncGroup请求,不过只有Leader发送的请求中包含分配方案。Coordinator收到分配方案后将属于每个Consumer的分配方案单独抽取出来做作为SyncGroup请求的Response返回给各个Consumer。

消费者分区分配策略

一个消费者组中存在多个消费者,一个Topic中存在多个分区,所以必然会涉及

到分区分配的问题,即:确定Topic中哪个分区由消费者组中的哪个消费者进行消费。

分区分配策略有:

  • Range(默认)
  • RoundRobin
  • Sticky

参数:

  • partition.assignment.strategy:配置分区分配策略,默认为:Range。Kafka可以同时使用多个分区分配策略。

Range(范围,默认分区分配策略,按主题划分)

Range是Kafka默认的消费者分区分配策略,它针对的是Topic维度,先对同一Topic中的分区按照序号进行排序,再对消费者组中消费者按照字母顺序进行排序,保证每个消费者按照顺序消费Topic的部分分区。

例如:一个Topic有七个分区:P0、P1……P6,消费者组中有C0、C1、C2三个消费者,分配策略为:

  • C0消费P0、P1、P2。
  • C1消费P3、P4。
  • C2消费P5、P6。

这种分配策略容易产生数据倾斜。

RoundRobin(轮询,按组划分)

RoundRoin分区分配策略是先将多个Topic中的所有分区经过hash后进行整体排序,然后以轮询的方式分配给消费者组中的消费者。如果消费者组中的所有消费者订阅了相同的主题,可以考虑这种分配策略。

Sticky(粘性)

Sticky是从Kafka0.11.x版本开始引入的分配策略,该分配策略可以理解为分配结果带有“粘性的”。即:在执行一次新的分配之前,考虑上一次分配的结果,尽量少的调整分配的变动,可以节省大量的开销。

首先会将同一Topic中的分区尽量均衡的分配给消费者,当同一消费组中的某个消费者异常退出进行重平衡时,尽量使原来分配的分区保持不变。

Sticky分区分配策略的目标有两点:

  • 1)分区的分配尽量的均衡。
  • 2)每一次重分配的结果尽量与上一次分配结果保持一致。

当以上两个目标发生冲突时,优先保证第一个目标。第一个目标是每个分配算法都尽量尝试去完成的,而第二个目标才真正体现出Sticky的特性。

示例:

有4个Topic:T0、T1、T2、T3,每个Topic有2个分区。

有3个Consumer:C0、C1、C2,所有Consumer都订阅了这4个分区。

如图所示:
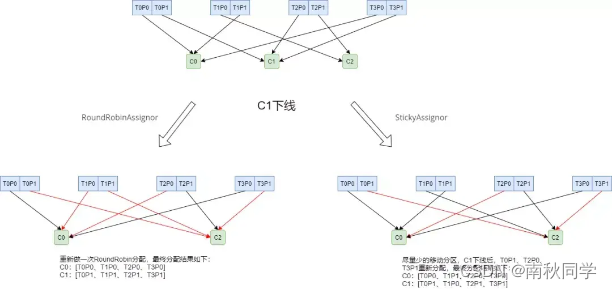
图中,红色箭头代表的是有变动的分区分配,可以看出,Sticky分配策略变动较小。

消费者线程安全问题

KafkaConsumer是非线程安全的。因为Kafka消费者使用内部状态(消费者的位置、消费者的偏移量、消费者的订阅主题和分区等)来跟踪消费进度和偏移量。如果多个线程同时访问同一个Kafka消费者实例,就会导致这些状态信息的不一致,从而导致消费进度出现错误。

KafkaConsumer非线程安全不意味着在消费消息时只能以单线程的方式执行,如果生产者发送消息的速度大于消费者处理消息的速度,就会有消息因此得不到及时处理而造成消费延迟。因此,可以采用多线程的方式来提高消费者的消费能力。

方案一:线程封闭

线程封闭指的是为每个线程实例化一个Consumer对象。使用该方式实现,一般所有的消费线程都属于同一个消费者组,一个消费线程可以消费一个或多个分区中的消息,因此并发数也受限于分区的实际个数(如果消费线程数大于分区数,就会有部分消费线程一直处于空闲状态)。

线程封闭方式的优点是每个线程可以按顺序消费各个分区中的消息;缺点是每个消费线程都要维护一个独立的TCP连接,造成额外的系统开销。

方案二:多线程处理消息

消费者吞吐量的瓶颈在处理消息的效率上,为了每个消费者维护一个单独线程会造成额外的系统开销,可以使用Reactor模型。即:消费者线程专门用来接收消息,接收到消息后采用多线程的方式(线程池)来处理消息。

这种方式解决了系统开销问题,缺点是无法对于消息按顺序进行处理,需要做额外的开发来保障。此外,如果需要手动提交,该种方式的实现也更加困难,存在数据丢失的风险。

(四)Kafka 消费者 不同于传统的消息系统,横向伸缩消费者和消费者群组并不会导致 Kafka 性能下降。除了通过增加消费者数量来横向伸缩单个应用程序,实际上,Kafka 的一个主要设计目标是。在这些应用场景中,我们希望。 阅读详情

相关推荐

字节架构师: Kafka 的消费者客户端详解

对于Kafka的分区来说,它的每条消息都有唯一的偏移量,用来展示消息在分区中对应的位置,它是一个单调递增的整数。在0.9版本之后Kafka的偏移量是存储在Kafka的_consumer_offsets主题中。消费者在消费完消息之后会向这个主题中进行消费位移的提交。消费者在重新启动的时候就会从新的消费位移处开始消费消息。因为,位移提交是在消费完所有拉取到的消息之后才执行的,如果不能正确提交偏移量,就可能发生数据丢失或重复消费。...

l688899886的博客 1164

Kafka消费者详解

Kafka消费者详解

日常分享数据分析开发、编程语言内容 4812

基于ESP32与JavaScript的Stack-chan桌面机器人:从硬件组装到AI交互的完整实践

嵌入式系统开发是连接物理世界与数字世界的核心技术,其核心原理在于通过微控制器直接操作硬件外设,实现感知、决策与执行。这项技术的核心价值在于为物联网、智能硬件和机器人等领域提供了低功耗、高可靠性的解决方案。在机器人应用场景中,嵌入式平台常作为主控大脑,驱动舵机、传感器并处理交互逻辑。本文聚焦的Stack-chan项目,正是这一理念的生动实践:它采用流行的ESP32微控制器,并创新性地通过Moddable运行时支持使用JavaScript进行嵌入式开发,极大地降低了机器人编程的门槛。开发者可以基于此平台,轻松实

weixin_28729173的博客 437

kafka消费的完整解决方案

无论是kafka,还是RocketMQ,rabbitMQ等,与springboot的结合得益于spring的强大,使得变的非常easy,但依然知识简单的使用变的非常容易,如果要达到理想的结果,不仅需要他们对原理熟悉一点,还要对spring提供的sdk熟悉,下面就看一下kafka的使用,以及需要解决的一些问题。 引入依赖             <!--kafka-->&nbs

felix 2856

别再只看K线了!聊聊“板块联动”和“热点轮动”的跟踪方法与工具(实战派分享)

本文深入解析了如何通过板块联动和热点轮动构建高效交易系统。从三维验证框架到主流工具配置,再到持续性热点的五大特征,实战派交易员分享了识别市场主线和预判轮动方向的高阶技巧,帮助投资者摆脱单纯依赖K线的局限,提升交易决策效率。

weixin_29281941的博客 760

USB2.0物理层实战:手把手教你用示波器抓取D+/D-信号(附波形分析)

本文是一份针对硬件工程师的USB2.0物理层信号调试实战指南。文章详细讲解了如何使用示波器捕获和分析D+/D-差分信号,从基础设置、核心信号状态解读,到信号完整性分析与常见问题排查,手把手教你定位USB通信故障。内容涵盖USB2.0协议物理层关键概念,并附有基础解码思路,旨在提升工程师的底层调试能力。

s8t9u0v1w的博客 451

Kafka面试精讲 Day 4:Consumer消费者模型与消费组

Kafka中的Consumer(消费者)是从Topic中读取消息的应用程序。多个消费者可以组成一个Consumer Group(消费组),共同消费一个或多个Topic的消息。| 概念 | 定义 || Consumer | 单个消费者实例,负责从Kafka拉取消息并处理 || Consumer Group | 一组具有相同group.id的消费者实例,共同消费Topic,实现消息的负载均衡与容错 || 消费位移(Offset) | 消费者在Partition中已消费消息的位置标识,用于记录消费进度 |

在未来等你的专栏 1230

模仿学习(Imitation Learning)概述

什么是模仿学习呢?简单来说,模仿学习(Imitation Learning),就是要训练机器能够复制人类的连续动作,进而达到模仿的目的。其实,Imitation Learning的实用性很高,假设今天有一个训练场景,你不知道该怎么定奖励值(reward),但是你可以收集到专家的示范数据(expert demonstration data),你就可以考虑用Imitation Learning这个方法。因此,模仿学习也被寄予很高的期待,成为下一代强人工智能的关键技术。......

qq_22749225的博客 2万+

如何快速全面掌握Kafka?5000字吐血整理

Kafka 是目前主流的分布式消息引擎及流处理平台,经常用做企业的消息总线、实时数据管道,本文挑选了 Kafka 的几个核心话题,帮助大家快速掌握 Kafka,包括:Kafka 体系架构...

过往记忆大数据 853

MIL-STD-1553B协议解析与工程实践指南

MIL-STD-1553B作为军用航空电子系统的核心通信协议,采用命令/响应式串行总线架构,通过双冗余设计实现高可靠性数据传输。该协议定义了三类终端设备(总线控制器、远程终端、总线监视器)和六种标准消息格式,典型应用包括飞行控制系统、导航设备等关键航电组件的实时数据交互。深入解析模式代码机制和状态字位域定义,其中传输向量字(10000)和同步命令(00001)等关键指令在分布式系统时间对齐、故障诊断等场景发挥重要作用。工程实践中需特别注意78Ω终端阻抗匹配、4-12μs响应时间窗口等硬性指标,结合变压器耦合

weixin_33431149的博客 435

【零基础入门unity游戏开发——unity3D篇】unity CharacterController 3D角色控制器最详细的使用介绍,并实现俯视角、第三人称角色控制(附项目源码)

【unity小技巧】unity最完美的CharacterController 3d角色控制器,实现移动、跳跃、下蹲、奔跑、上下坡、物理碰撞效果,复制粘贴即用但是我发现很多人还是不理解,都跑来私信问我,所以决定重新做一个更加详细且简单控制器,主要是实现俯视角和第三人称角色控制。添加一个胶囊体,添加Character Controller组件,记得删除Capsule Collider组件,因为Character Controller自带了碰撞,所以不需要Character Controller参数介绍。

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 5022

如何快速全面掌握Kafka

因为涉及内容较多,本文尽量做到深入浅出,全面的介绍 Kafka 原理及核心组件。 1. Kafka 快速入门 Kafka 是一个分布式消息引擎与流处理平台,经常用做企业的消息总线、实时数据管道,有的还把它当做存储系统来使用。早期 Kafka 的定位是一个高吞吐的分布式消息系统,目前则演变成了一个成熟的分布式消息引擎,以及流处理平台。 1.1 Kafka 体系架构 Kafka 的设计遵循生产者消费者模式,生产者发送消息到 broker 中某一个 topic 的具体分区里,消费者从一个或多个分区中拉取数

taoy86的博客 223

ardupilot 为什么要采样四元数姿态控制

本节主要说明清楚ardupilot姿态控制为什么要用到四元数,欢迎批评指正!!!

陌城烟雨 1118

源码系列第1弹 | 带你快速攻略Kafka源码之旅入门篇

Kafka 源码之旅入门

u011359591的专栏 1186

ZYNQ 使用AXI_BRAM实现PS与PL 数据交互数据交互

有时CPU需要与PL进行小批量的数据交换,可以通过Block RAM实现。通过Zynq 的GP Master 接口读写PL端的 BRAM,实现PS与PL的交互。加入自定义的 FPGA 程序,并利用 AXI4 总线进行配置,通知何时读写 BRAM。CPU通过 AXI BRAM Controller 读取 BRAM 数据,CPU 仅配置自定义的 PL BRAM Controller 的寄存器,不通过它读写数将BRAM与socket进行联合使用,将电脑的数据发到PS端,PS端放在PL端,PL端再发给PS端,P据。

wangjie36的博客 1万+

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

别再死记硬背!一文看懂 Kafka 核心组件及其协作原理

Kafka核心架构摘要 Kafka作为分布式消息系统,采用三层架构设计: 主题层:每个Topic划分为多个分区(Partition),分区可配置副本(Replication)实现高可用 分区层:每个分区包含Leader副本(处理读写)和Follower副本(仅同步数据) 消息层:分区内消息按顺序存储,通过Offset唯一标识 关键组件: Producer向Topic发布消息 Consumer通过Consumer Group实现负载均衡 Broker集群处理消息存储与转发 Coordinator管理消费者与分

JavaEdge全是干货的技术号 2818

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

kafka session.timeout.ms 是指消费一条数据的时间?_如何快速全面掌握Kafka?5000字吐血整理...

Kafka 是目前主流的分布式消息引擎及流处理平台,经常用做企业的消息总线、实时数据管道,本文挑选了 Kafka 的几个核心话题,帮助大家快速掌握 Kafka,包括:Kafka 体系架构Kafka 消息发送机制Kafka 副本机制Kafka 控制器Kafka Rebalance 机制因为涉及内容较多,本文尽量做到深入浅出,全面的介绍 Kafka 原理及核心组件,不怕你不懂 Kafka。1. Kaf...

weixin_39829501的博客 887

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

深入解析Kafka消费失败重试机制:从原理到Spring-Kafka实战配置

本文深入解析Kafka消费失败重试机制的核心原理,并结合Spring-Kafka实战配置,详细介绍了如何通过基础配置、代码级控制和高级调优来优化消息处理。文章还探讨了死信队列、批量消费和混合错误处理策略,帮助开发者在生产环境中实现高效可靠的消息消费。

weixin_30790841的博客 434

你说嘴巴嘟嘟,ok我是扣码,现在开始学kafka

包括你的Kafka集群的各种元数据,比如说每台机器上有哪些partition,谁是leader,谁是follower,是谁来管理的?生产者生产的消息按照一定的分区策略被发送到topic中partition中,partition在磁盘上就是一个目录,该目录名是topic的名称加上一个序号,在这个partition目录下,有两类文件,一类是以log为后缀的文件,一类是以index为后缀的文件,每一个log文件和一个index文件相对应,这一对文件就是一个segment file,也就是一个段。

m0_47443458的博客 274

Kafka消费者组重平衡终极指南:从原理到亿级流量优化实践

Kafka作为分布式消息系统的核心组件,其消费者组重平衡机制是保障高并发场景下消息可靠消费的关键。本文将系统解析Kafka消费者组重平衡的底层原理,提供从基础配置到亿级流量场景的全链路优化方案,帮助开发者彻底解决重平衡引发的性能瓶颈与数据一致性问题。 ## 一、揭开重平衡的神秘面纱:核心原理与执行流程 消费者组重平衡(Rebalance)是Kafka实现高可用和负载均衡的核心机制,当消费者组内

gitblog_00842的博客 942

Kafka面试题1

消息队列Message Queue,简称MQ。是一种应用间的通信方式,主要由三个部分组成。生产者:Producer消息的产生者与调用端主要负责消息所承载的业务信息的实例化是一个队列的发起方代理:Broker主要的处理单元负责消息的存储、投递、及各种队列附加功能的实现是消息队列最核心的组成部分消费者:Consumer一个消息队列的终端也是消息的调用端,具体是根据消息承载的信息,处理各种业务逻辑。消息队列的应用场景较多,常用的可以分为三种:应用解耦。

被拯救的威尼斯的博客 1013

限时发布!阿里内部爆款架构师培训Kafka源码笔记开源,权威性不言而喻!

在大数据、高并发的系统中,为了突破瓶颈,会将系统进行水平扩展和垂直拆分,形成独立的服务。每个独立的服务背后,可能是一个集群在对外提供服务。这就会碰到一个问题,整个系统是由多个服务(子系统)组成的,数据需要在各个服务中不停流转。如果数据在各个子系统中传输时,速度过慢,就会形成瓶颈,降低整个系统的性能。从而就形成了以Kafka为中心的解决方案! 因为阅读Kafka源码重要性就不言而喻,今天小编就分享一份拼多多Kafka的源码笔记,现已面向大众全面开源!(为了不影响大家的阅读体验,免费获取方式放在了文末!)

weixin_50205273的博客 2174

应用角度看kafka的术语和功能

kafka的术语(Terminology) Topic和Consumer Group Topic每条发布到 Kafka 集群的消息都有一个类别,这个类别被称为 Topic。(物理上不同 Topic 的消息分开存储,逻辑上一个 Topic 的消息虽然保存于一个或多个 broker 上但用户只需指定消息的 Topic 即可生产或消费数据而不必关心数据存于何处) 对应用来说,生产者...

weixin_30763397的博客 870

kafka源码学习

kafka

m0_49672766的博客 1127
上一篇: Kafka核心原理之Broker请求处理
下一篇: Kafka核心原理之精准一次性投递
南秋同学
博客等级 码龄7年 64粉丝 27原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值