


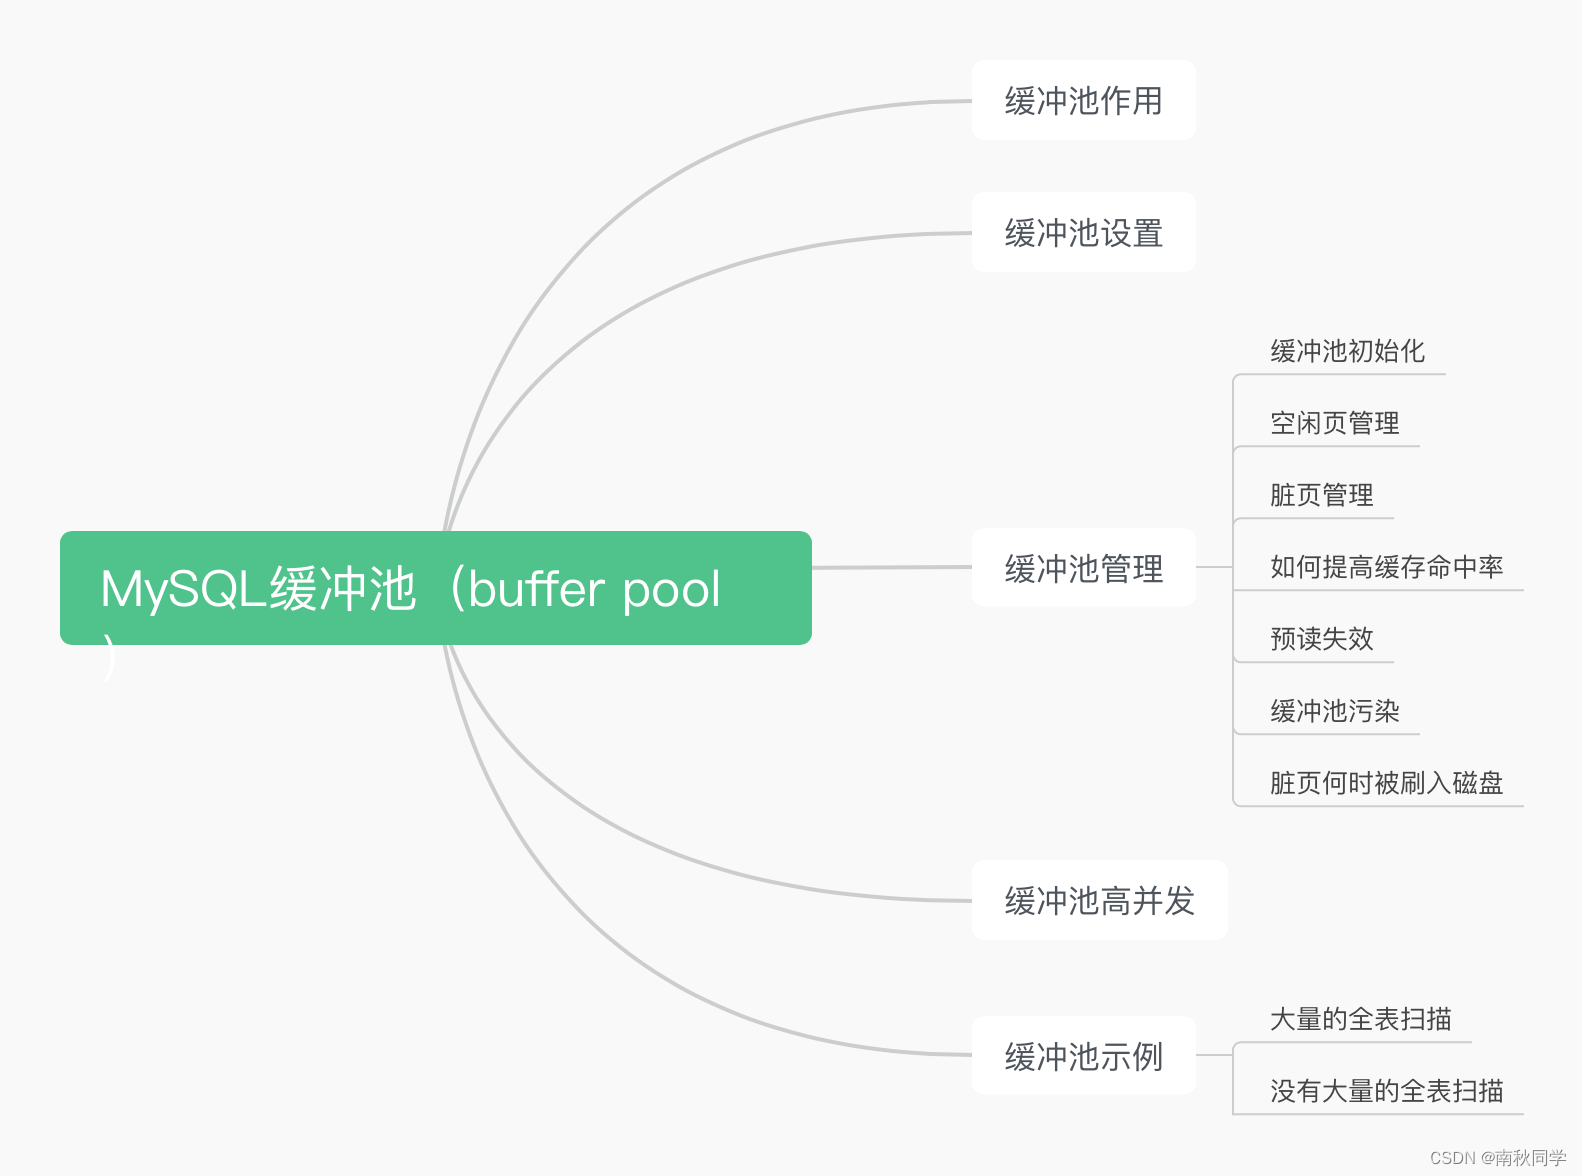
本章内容
缓冲池作用
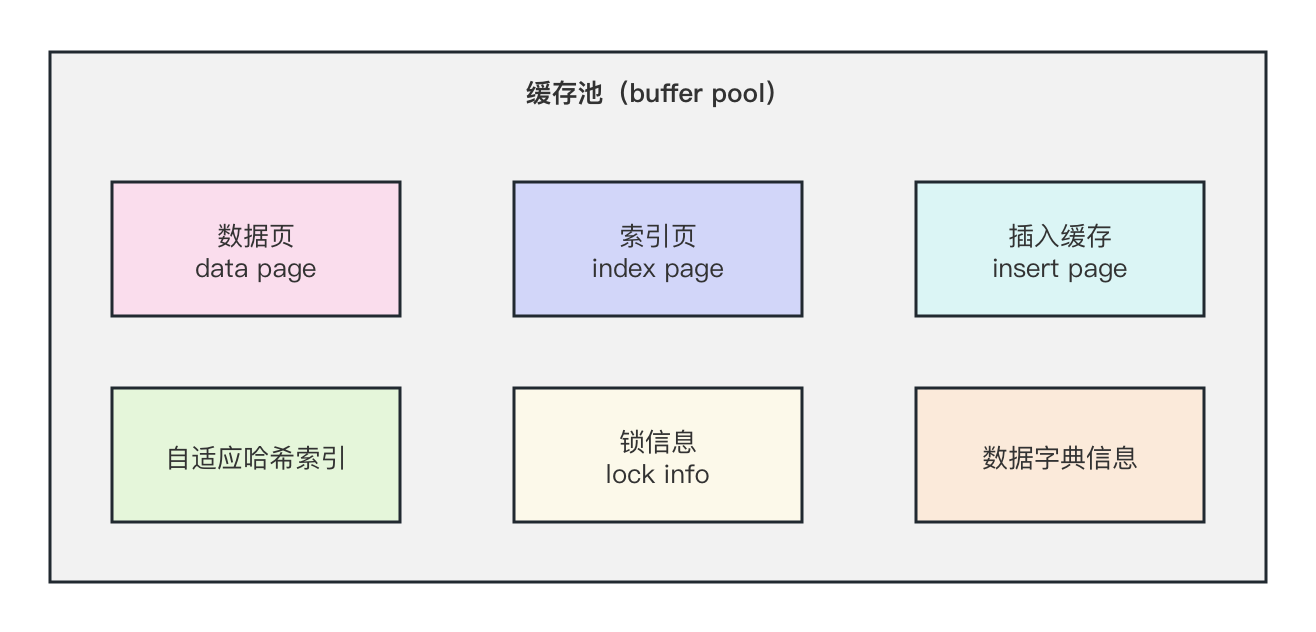
buffer pool是MySQL中最重要的内存组件,介于外部系统和存储引擎之间的一个缓存区,其中可以缓存磁盘上经常操作的真实数据,在执行增删改查操作时,先操作缓冲池中的数据(若缓冲池没有数据,则从磁盘加载并缓存),然后再以一定频率刷新到磁盘,从而减少磁盘 IO,加快处理速度。在缓冲池中不仅缓存了索引页和数据页,还包含了undo页、插入缓存(insert page)、自适应哈希索引以及InnoDB的锁信息等。
如图所示:
缓冲池设置
缓冲池的配置通过变量innodb_buffer_pool_size来设置,通常它的大小占用内存60%-80%,MySQL默认是134217728字节,即:128M。
-- 查看缓冲池大小
show variables like '%innodb_buffer_pool_size%';
-- 设置缓冲池大小
set persist innodb_buffer_pool_size=11274289152;
其中:11274289152 = 15(15G) * 0.7(70%) * 1024 * 1024 * 1024。
如何判断缓冲池的大小是否合理,可以通过:
- show engine innodb status:如果free buffers值为0,表示缓冲池设置过小。
- show status like '%buffer_pool_wait%':如果value值大于0,表示缓冲池设置过小。
缓冲池管理
缓冲池初始化
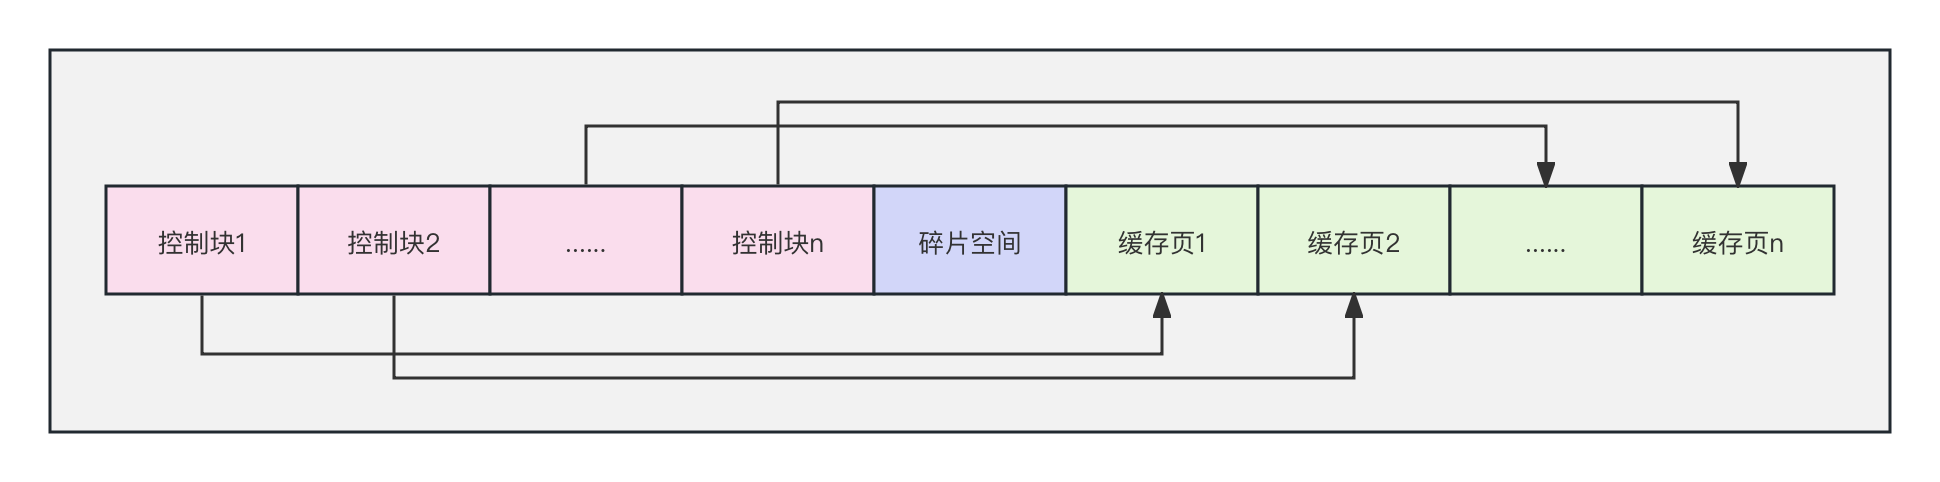
在MySQL启动时,InnoDB会为buffer pool申请一片连续的内存空间,然后按照默认的16KB的大小划分出一个个的页, buffer pool中的页就叫做缓存页。此时这些缓存页都是空闲的,之后执行增删改查操作时,才会加载磁盘中的数据页到buffer pool中。
为了更好的管理这些在buffer pool 中的缓存页,InnoDB为每一个缓存页的最前面都创建了一个内存大小一样的控制块,其中包括缓存页的表空间、页号、缓存页地址、链表节点等。
每一个控制块都对应一个缓存页,在分配控制块和缓存页后,剩余的空间不够一对控制块和缓存页的大小,就被称为碎片空间。
如图所示:
空闲页管理
buffer pool是一片连续的内存空间,当MySQL运行一段时间后,这片连续的内存空间中会同时存在空闲的缓存页和被使用的缓存页,为了能够快速找到空闲的缓存页,可以使用链表结构。MySQL将空闲缓存页的控制块作为链表的节点,这个链表称为Free链表(空闲链表)。
如图所示:
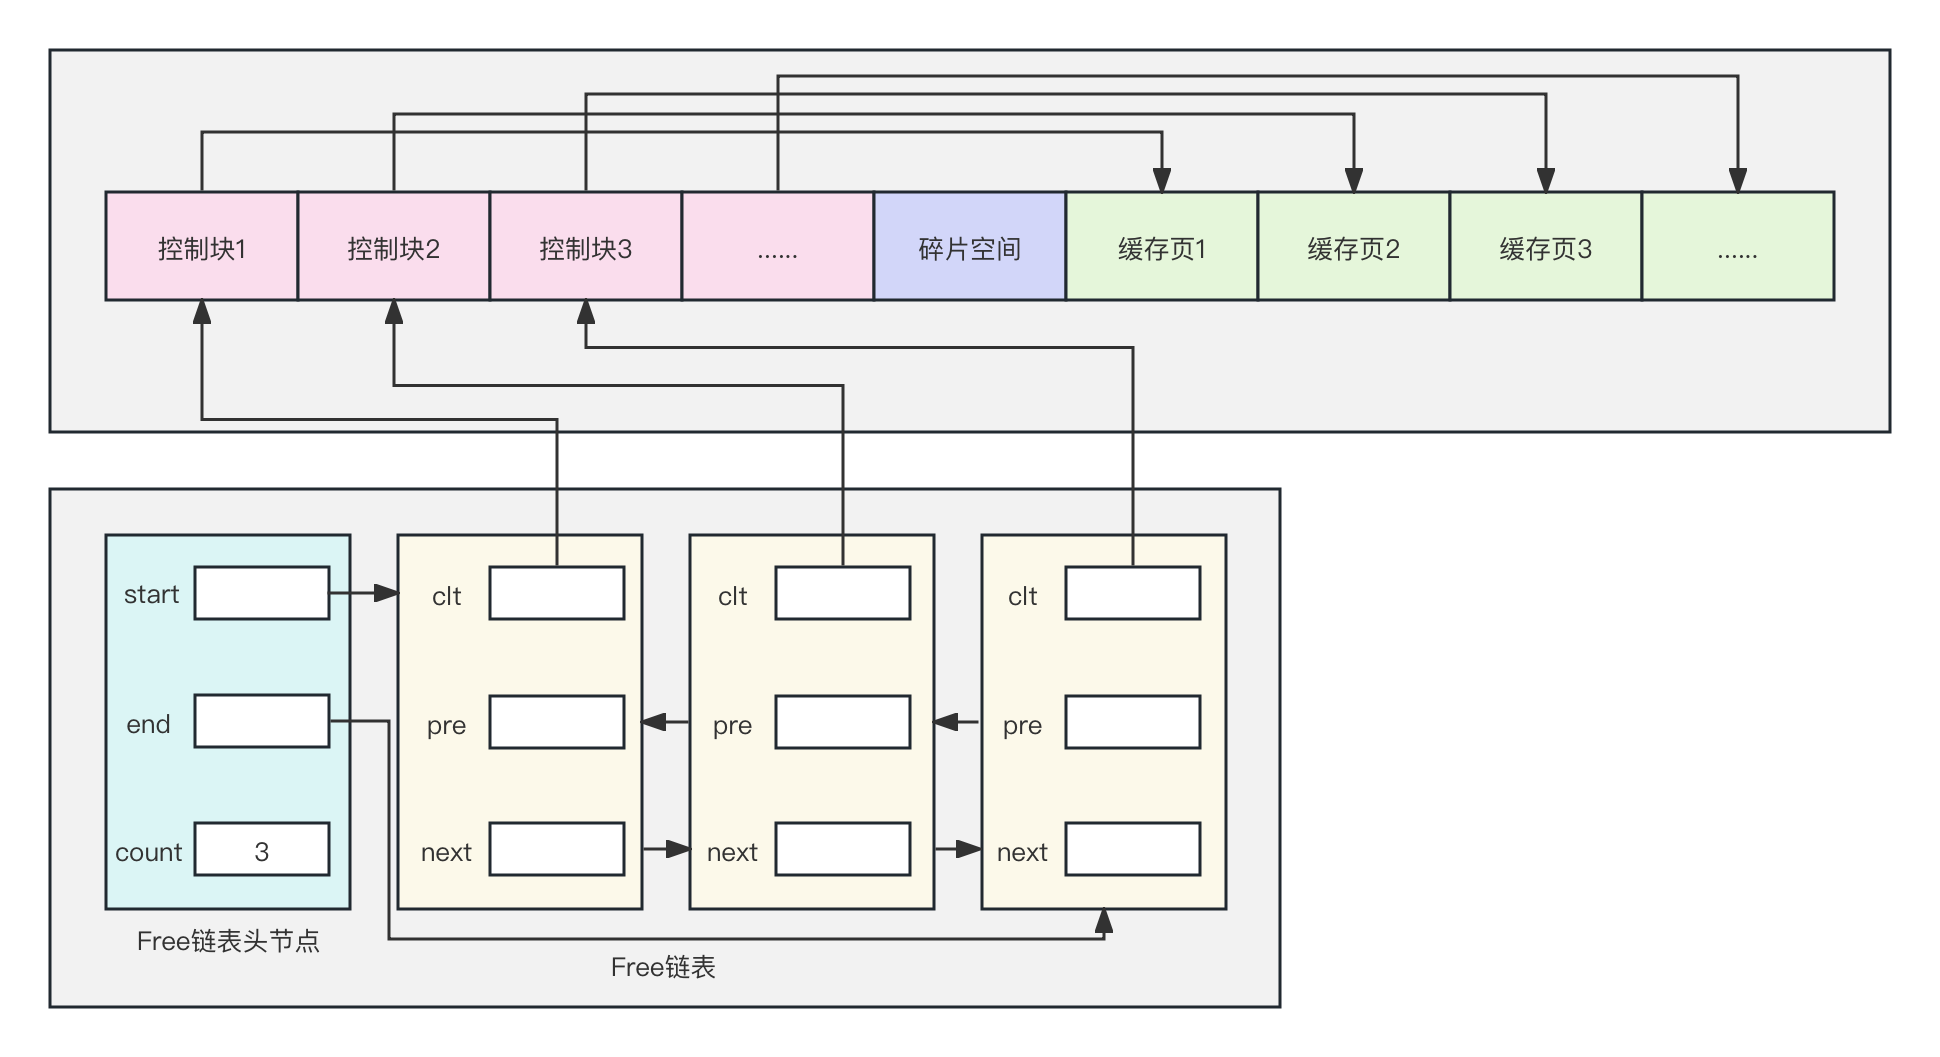
图中:
- Free链表中除了有控制块,还有一个头节点,该头节点包含链表的头节点地址、尾节点地址以及当前链表中节点数量等信息,头节点是一块单独申请的内存空间(约占40字节),并不在buffer pool的连续内存空间中。
- Free链表节点是一个一个的控制块,每个控制块包含着对应缓存页的地址,所以相当于 Free链表节点都对应一个空闲的缓存页。
- 每个控制块中都包含指向上一个节点的pre指针、指向下一个节点的next指针以及一个数据页地址clt。
每当buffer pool中有一页数据空闲出来时,直接把该数据页的地址追加到Free链表中。
每当需要从磁盘中加载一个页到buffer pool中时,就从Free链表中取一个空闲的缓存页,并且将该缓存页对应的控制块的信息填上,然后把该缓存页对应的控制块从Free链表中移除。
脏页管理
设计buffer pool除了能提高读性能,还能提高写性能,更新数据时,不需要每次都将更新后的数据写入磁盘,而是将buffer pool对应的缓存页标记为脏页,然后再由后台线程将脏页写入到磁盘中。
为了能快速知道哪些缓存页是脏页,于是就设计出了Flush链表,与Free链表类似,Flush链表节点也是控制块,区别在于Flush链表的元素都是脏页。
如图所示:
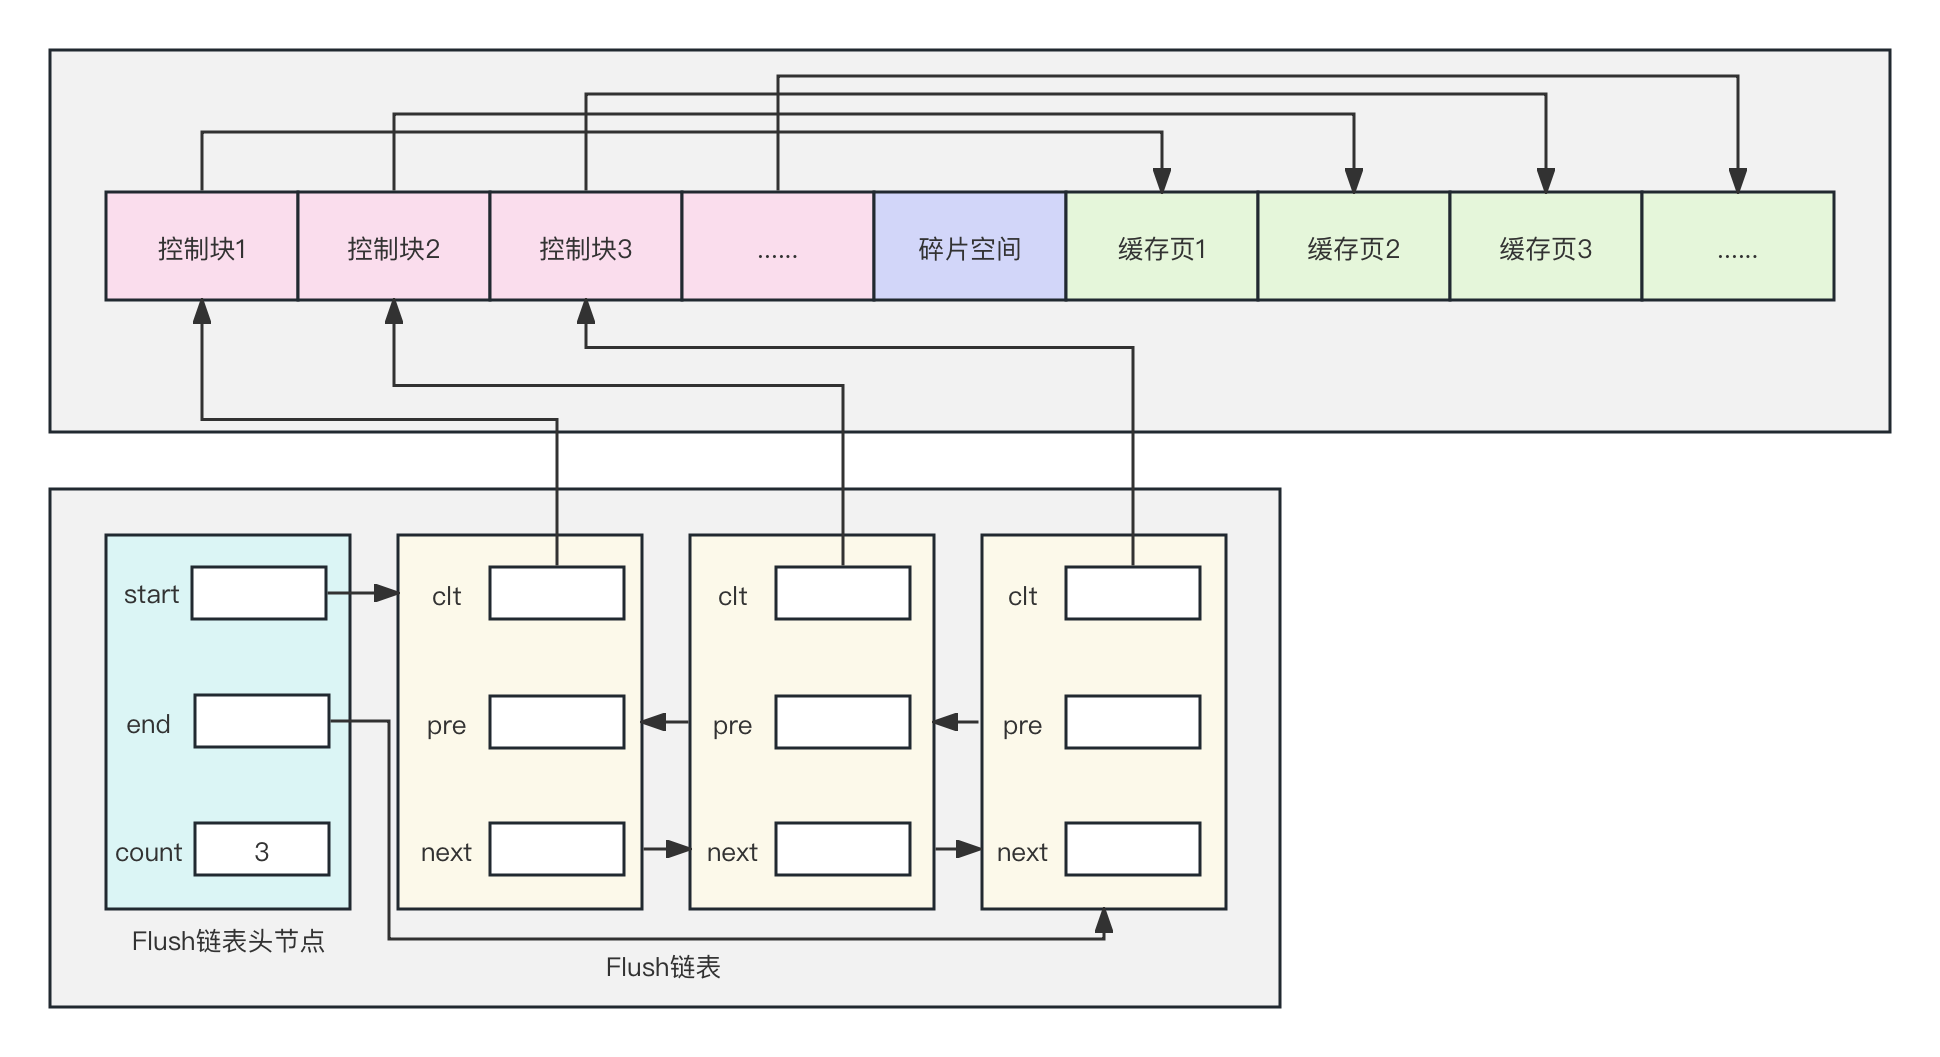
有了Flush链表后,后台线程就可以遍历Flush链表,将脏页写入到磁盘中。
如何提高缓存命中率
由于buffer pool的大小有限,对于一些频繁访问的数据希望可以一直留在buffer pool中,对于那些很少访问的数据希望可以在某个时机可以淘汰掉,从而保证buffer pool不会因为内存不足而导致无法再缓存新的数据,同时还能保证常用数据留在buffer pool中。要实现以上功能,最容易想到的就是使用LRU(Least Recently Used)算法。
LRU算法的思路是链表头节点是最近使用的数据,链表尾节点是最久没被使用的数据。当空间不够时,就淘汰最久没被使用的节点,从而腾出空间。
LRU算法的实现思路:
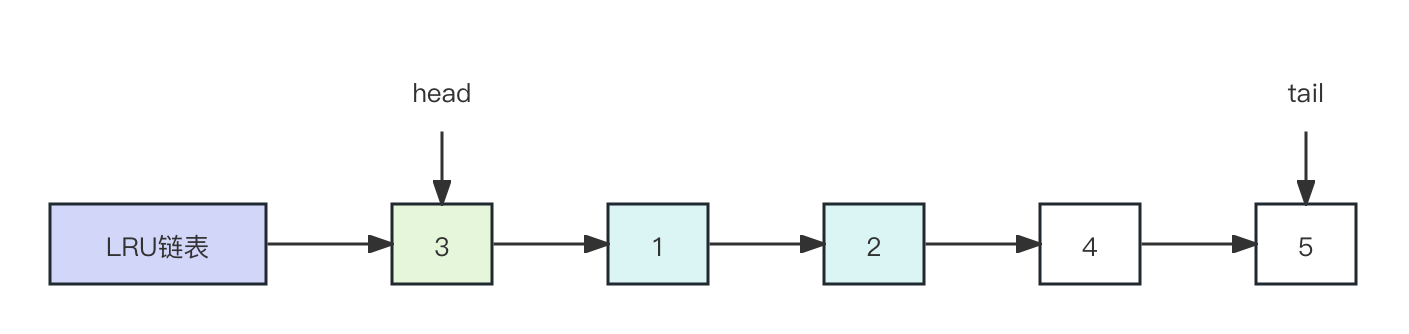
如果访问的页在buffer pool中,则直接将该页对应的LRU链表节点移动到链表的头部。
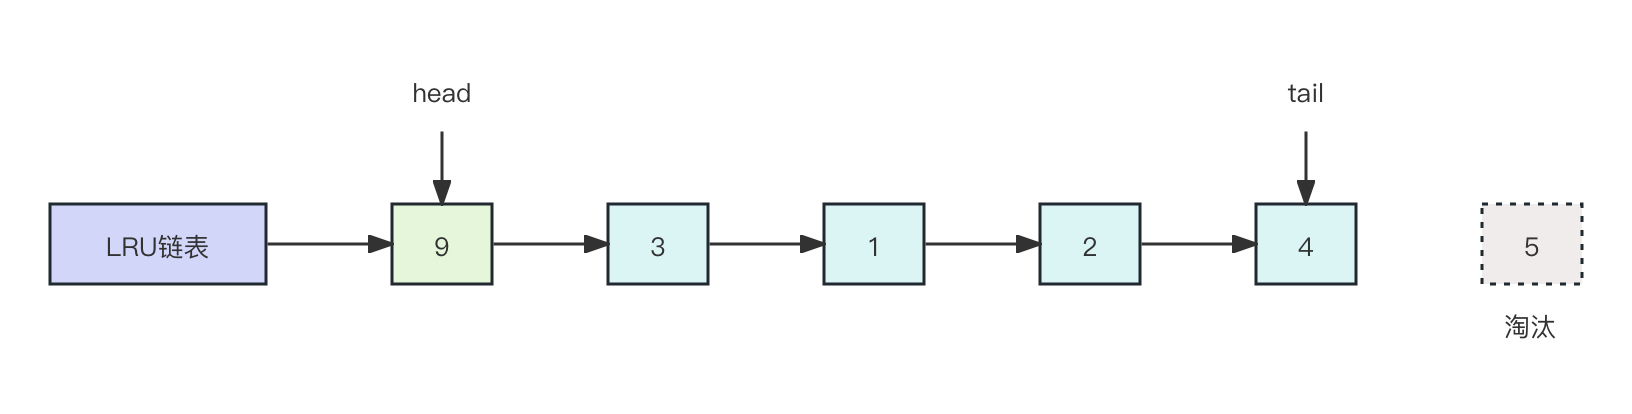
如果访问的页不在buffer pool中,则除了要将页放入到LRU链表的头部,还要淘汰LRU链表末尾的节点。
LRU结构如图所示:
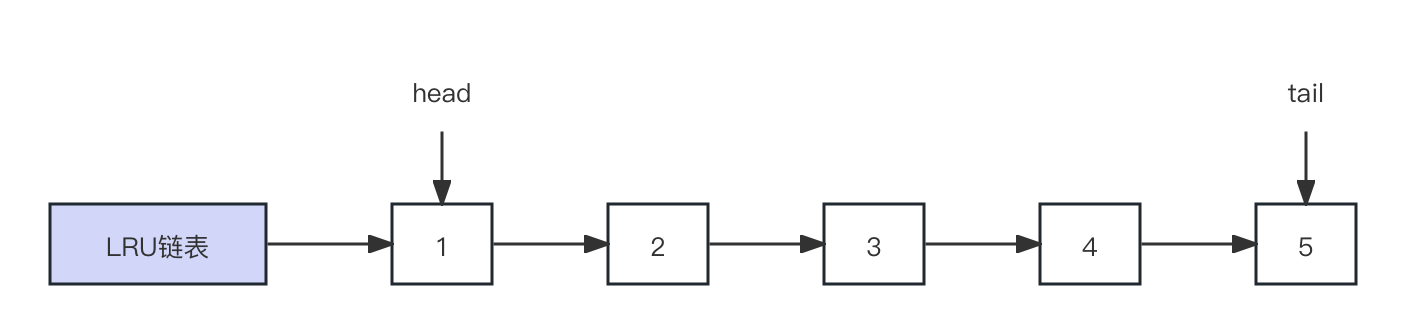
假如要访问3号页数据,因为3号页在buffer pool中,所以会把3号页移动到头部即可。
如图所示:
假如要访问9号页数据,但是9号页不在buffer pool中,所以需要淘汰5号页,然后在头部加入9号页数据。
如图所示:
至此,可以知道buffer pool中有三种页和链表来管理数据。

图中:
- Free Page(空闲页):表示此页未被使用,位于Free链表。
- Clean Page(干净页):表示此页已被使用,但是页面未发生修改,位于LRU链表。
- Dirty Page(脏页):表示此页「已被使用」且「已经被修改」,其数据和磁盘上的数据已经不一致。当脏页上的数据写入磁盘后,内存数据和磁盘数据一致,那么该页就变成了干净页。脏页同时存在于LRU链表和Flush链表。
简单的LRU算法并没有被MySQL使用,因为简单的LRU算法无法避免下面这两个问题:
- 预读失效。
- buffer pool污染。
预读失效
程序是有空间局部性的,一般靠近当前被访问数据的数据,在未来很大概率会被访问到。所以,MySQL在加载数据页时,会提前把它相邻的数据页一并加载进来,目的是为了减少磁盘 IO。但是可能这些被提前加载进来的数据页,并没有被访问,相当于这个预读是白做了,这个就是预读失效。
如果使用简单的LRU算法,就会把预读页放到LRU链表头部,而当buffer pool空间不够时,会淘汰末尾的数据页。如果这些预读页一直不会被访问到,就会出现一个很奇怪的问题,不会被访问的预读页占用了LRU链表前排的位置,而末尾淘汰的页可能是频繁访问的页,从而大大降低了缓存命中率。
如何避免预读失效带来影响?
要避免预读失效带来影响,最好的方式就是让预读的页停留在buffer pool中的时间要尽可能的短,让真正被访问的页才移动到LRU链表的头部,从而保证真正被读取的热数据留在buffer pool中的时间尽可能长。
MySQL改进了LRU算法,将LRU划分为2个区域:young区域和old区域。
young区域在LRU链表的前半部分,old区域则是在后半部分。
old区域占整个LRU链表长度的比例可以通过变量innodb_old_blocks_pct来设置,默认为37,代表整个LRU链表中young区域与old区域比例为63:37。
-- 查看innodb_old_blocks_pc变量值
show variables like '%innodb_old_blocks_pc%';
-- 设置innodb_old_blocks_pc变量值
set persist innodb_old_blocks_pct = 40;
划分这两个区域后,预读的页就只需要加入到old区域的头部,当页被真正访问时,才将页插入young区域的头部。如果预读的页一直没有被访问,就会从old区域移除,这样就不会影响young区域中的热点数据。
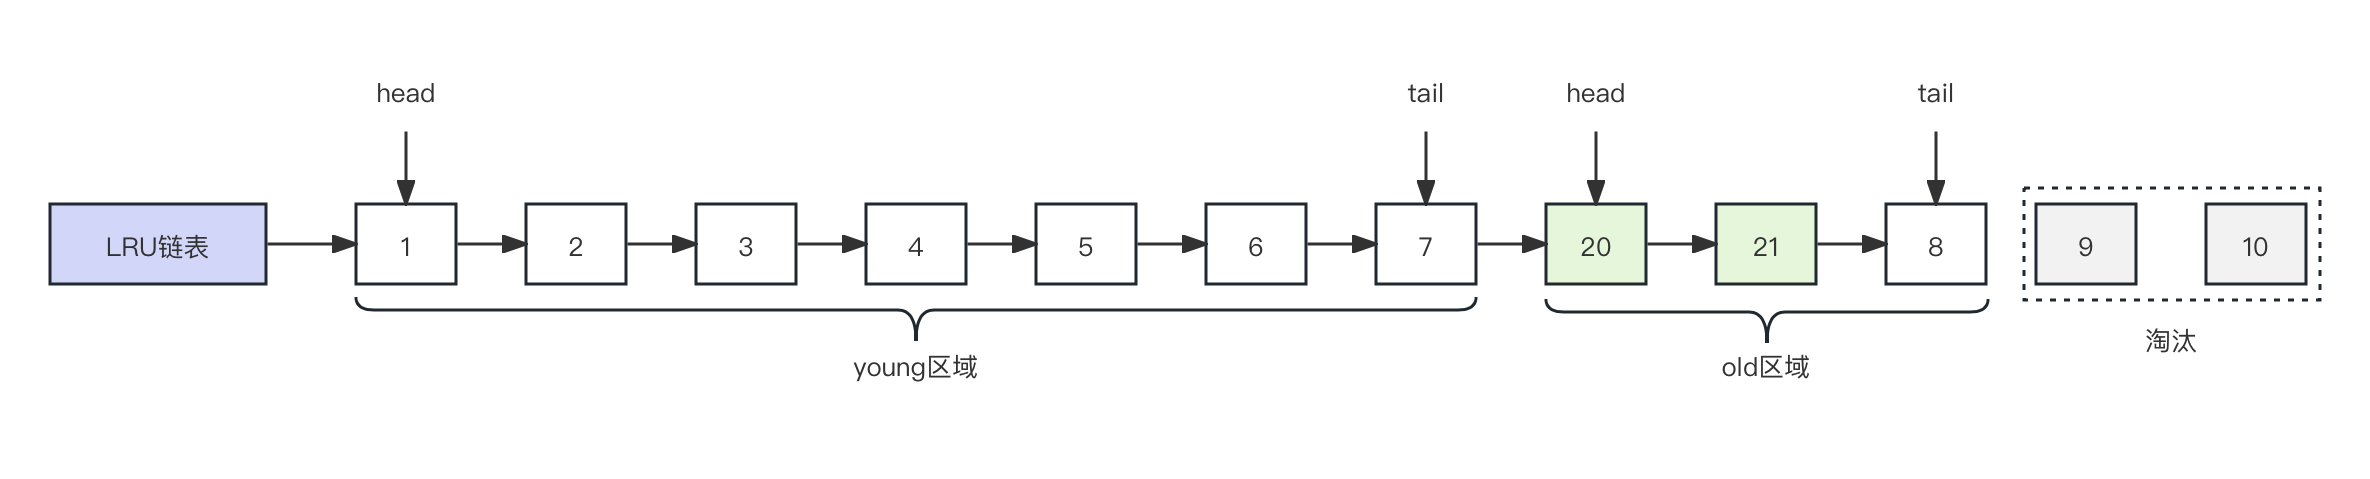
示例:假设有一个长度为10的LRU链表,其中young区域占比70%,old区域占比30%。
如图所示:

现在有两个编号为20和21的页被预读了,这个页只会被插入到old区域头部,而old区域末尾的9和10号页会被淘汰掉。如果20和21号页一直没有被访问到,那么就不会占用young区域的位置,而且会给young区域的数据更早被淘汰。
如图所示:
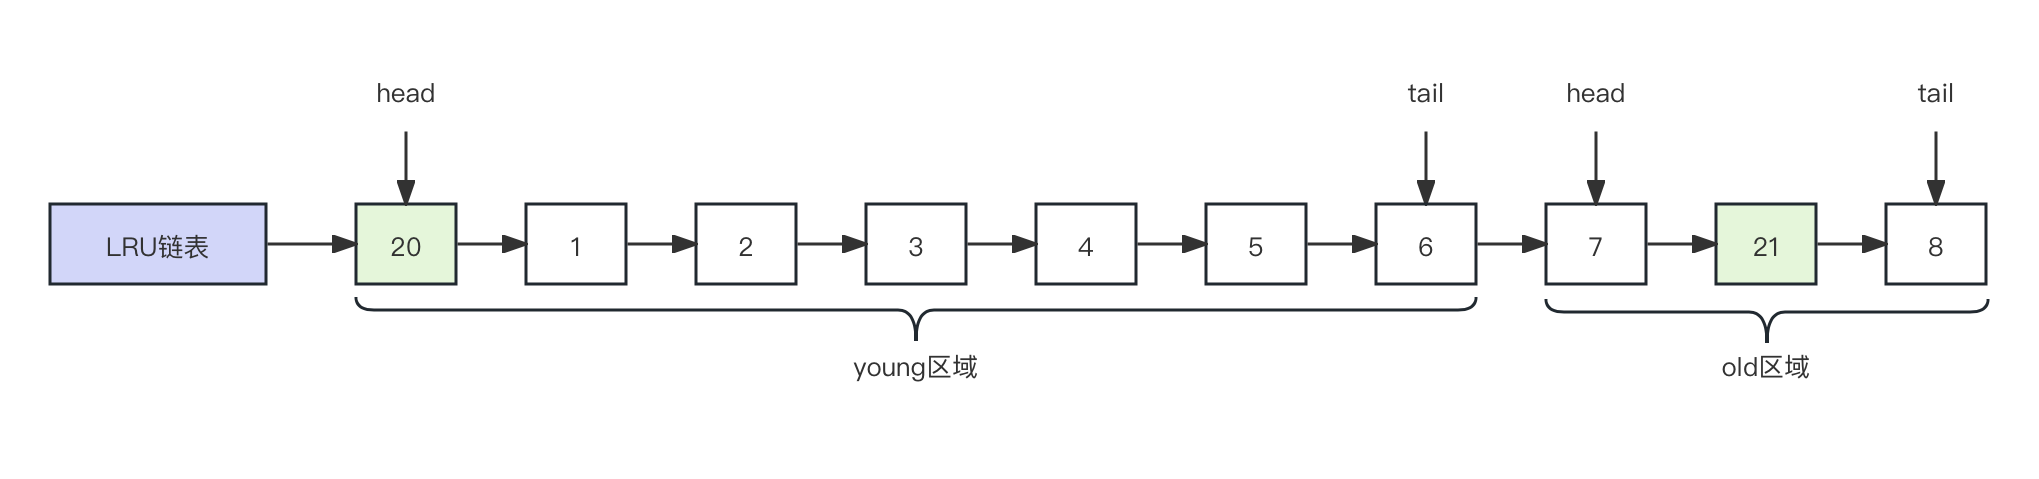
如果20号页被预读后立刻被访问了,那么就会将它插入到young区域的头部,young区域末尾的页(7号)会被挤到old区域,作为old区域的头部,这个过程并不会有页被淘汰。
如图所示:
缓冲池污染
当某一个SQL语句扫描了大量数据时,在buffer pool空间比较有限的情况下,可能会将buffer pool中的所有页都替换出去,导致大量热数据被淘汰了,等这些热数据又被再次访问时,由于缓存未命中,就会产生大量的磁盘IO,MySQL性能就会急剧下降,这个过程被称为buffer pool污染。
注意, buffer pool污染并不只是查询语句查询出了大量的数据才出现,即使查询出来的结果集很小,但扫需要扫描很多页(如:全表扫描),也会造成buffer pool污染。
select * from t_user where name like "%nanqiu%";
可能这个查询出来的结果就几条记录,但是由于这条语句会发生索引失效,所以这个查询过程会全表扫描,接着会发生如下的过程:
- 从磁盘读到的页加入到LRU链表的old区域头部。
- 当从页中读取行记录时(即:页被访问时),就要将该页放到young区域头部。
- 接下来拿行记录的name字段和字符串nanqiu进行模糊匹配,如果符合条件,就加入到结果集中。
- 如此往复,直到扫描完表中的所有记录。
如何解决出现buffer pool污染而导致缓存命中率下降的问题?
像前面这种全表扫描的查询,很多缓存页其实只会被访问一次,但是它却只因为被访问了一次而进入到young区域,从而导致热点数据被替换了。
LRU链表中young区域就是热点数据,只要提高进入到young区域的门槛,就能有效地保证young区域中的热点数据不会被替换掉。
在MySQL中,进入到young区域条件增加了一个停留在old区域的时间判断。在对某个处在old区域的缓存页进行第一次访问时,就在它对应的控制块中记录下来这个访问时间:
- 如果后续的访问时间与第一次访问的时间在某个时间间隔内,那么该缓存页就不会被从old区域移动到young区域的头部。
- 如果后续的访问时间与第一次访问的时间不在某个时间间隔内,那么该缓存页移动到young区域的头部。
这个间隔时间是由变量innodb_old_blocks_time控制,默认为1000ms。
-- 查看innodb_old_blocks_time变量值
show variables like '%innodb_old_blocks_time%';
-- 设置innodb_old_blocks_time变量值
set persist innodb_old_blocks_time  = 2000;
也就是说,只有同时满足「被访问」与「在old区域停留时间超过1秒」两个条件,才会被插入到young区域头部,这样就解决了buffer pool污染的问题 。
另外,MySQL针对young区域其实做了一个优化,为了防止young区域节点频繁移动到头部。young区域前面1/4被访问不会移动到链表头部,只有后面的3/4被访问了才会移动到链表头部。
脏页何时会被刷入磁盘
引入了buffer pool后,当修改数据时,首先是修改buffer pool中数据所在的页,然后将其页设置为脏页,但是磁盘中还是原数据。因此,脏页需要被刷入磁盘,保证缓存和磁盘数据一致,但是若每次修改数据都刷入磁盘,则性能会很差,因此一般都会在一定时机进行批量刷盘。
如果在脏页还没有来得及刷入到磁盘时,MySQL突然宕机,不会造成数据丢失,因为InnoDB的更新操作采用的是Write Ahead Log策略(即:先写日志,再写磁盘),通过redo log日志让MySQL拥有了崩溃恢复能力。
以下几种情况会触发脏页的刷新:
- 当redo log日志已满时,会主动触发脏页刷新到磁盘。
- 当buffer pool空间不足时,需要将一部分数据页淘汰掉,如果淘汰的是脏页,需要先将脏页同步到磁盘。
- MySQL认为空闲时,后台线程会定期将适量的脏页刷入到磁盘。
- MySQL正常关闭之前,会将所有的脏页刷入到磁盘。
在开启了慢SQL监控后,如果发现偶尔会出现一些用时稍长的SQL,这可能是因为脏页在刷新到磁盘时可能会给数据库带来性能开销,导致数据库操作抖动。如果间断出现这种现象,就需要调大buffer pool空间或redo log日志的大小。
缓冲池高并发
如果InnoDB存储引擎只有一个buffer pool,当多个请求同时进来时,为了保证数据的一致性(缓存页、Free链表、Flush 链表、LRU链表等多种操作),就必须给缓冲池加锁,保证同一时刻只有一个请求获得锁去操作buffer pool,其他请求只能排队等待锁释放,此时MySQL的性能就会变得非常低。
可以通过修改变量innodb_buffer_pool_instances给MySQL设置多个buffer pool来提升MySQL的并发能力。
innodb_buffer_pool_instances是一个持久化只读系统变量,需要授予persist_ro_variables_admin(启用持久化只读系统变量)和system_variables_admin(启用修改或保留全局系统变量)的权限。
-- 设置innodb_buffer_pool_instances变量值
set persist_only innodb_buffer_pool_instances=4;
修改完成后需要重启MySQL。
-- 查看innodb_buffer_pool_instances变量值
show variables like '%innodb_buffer_pool_instances%';
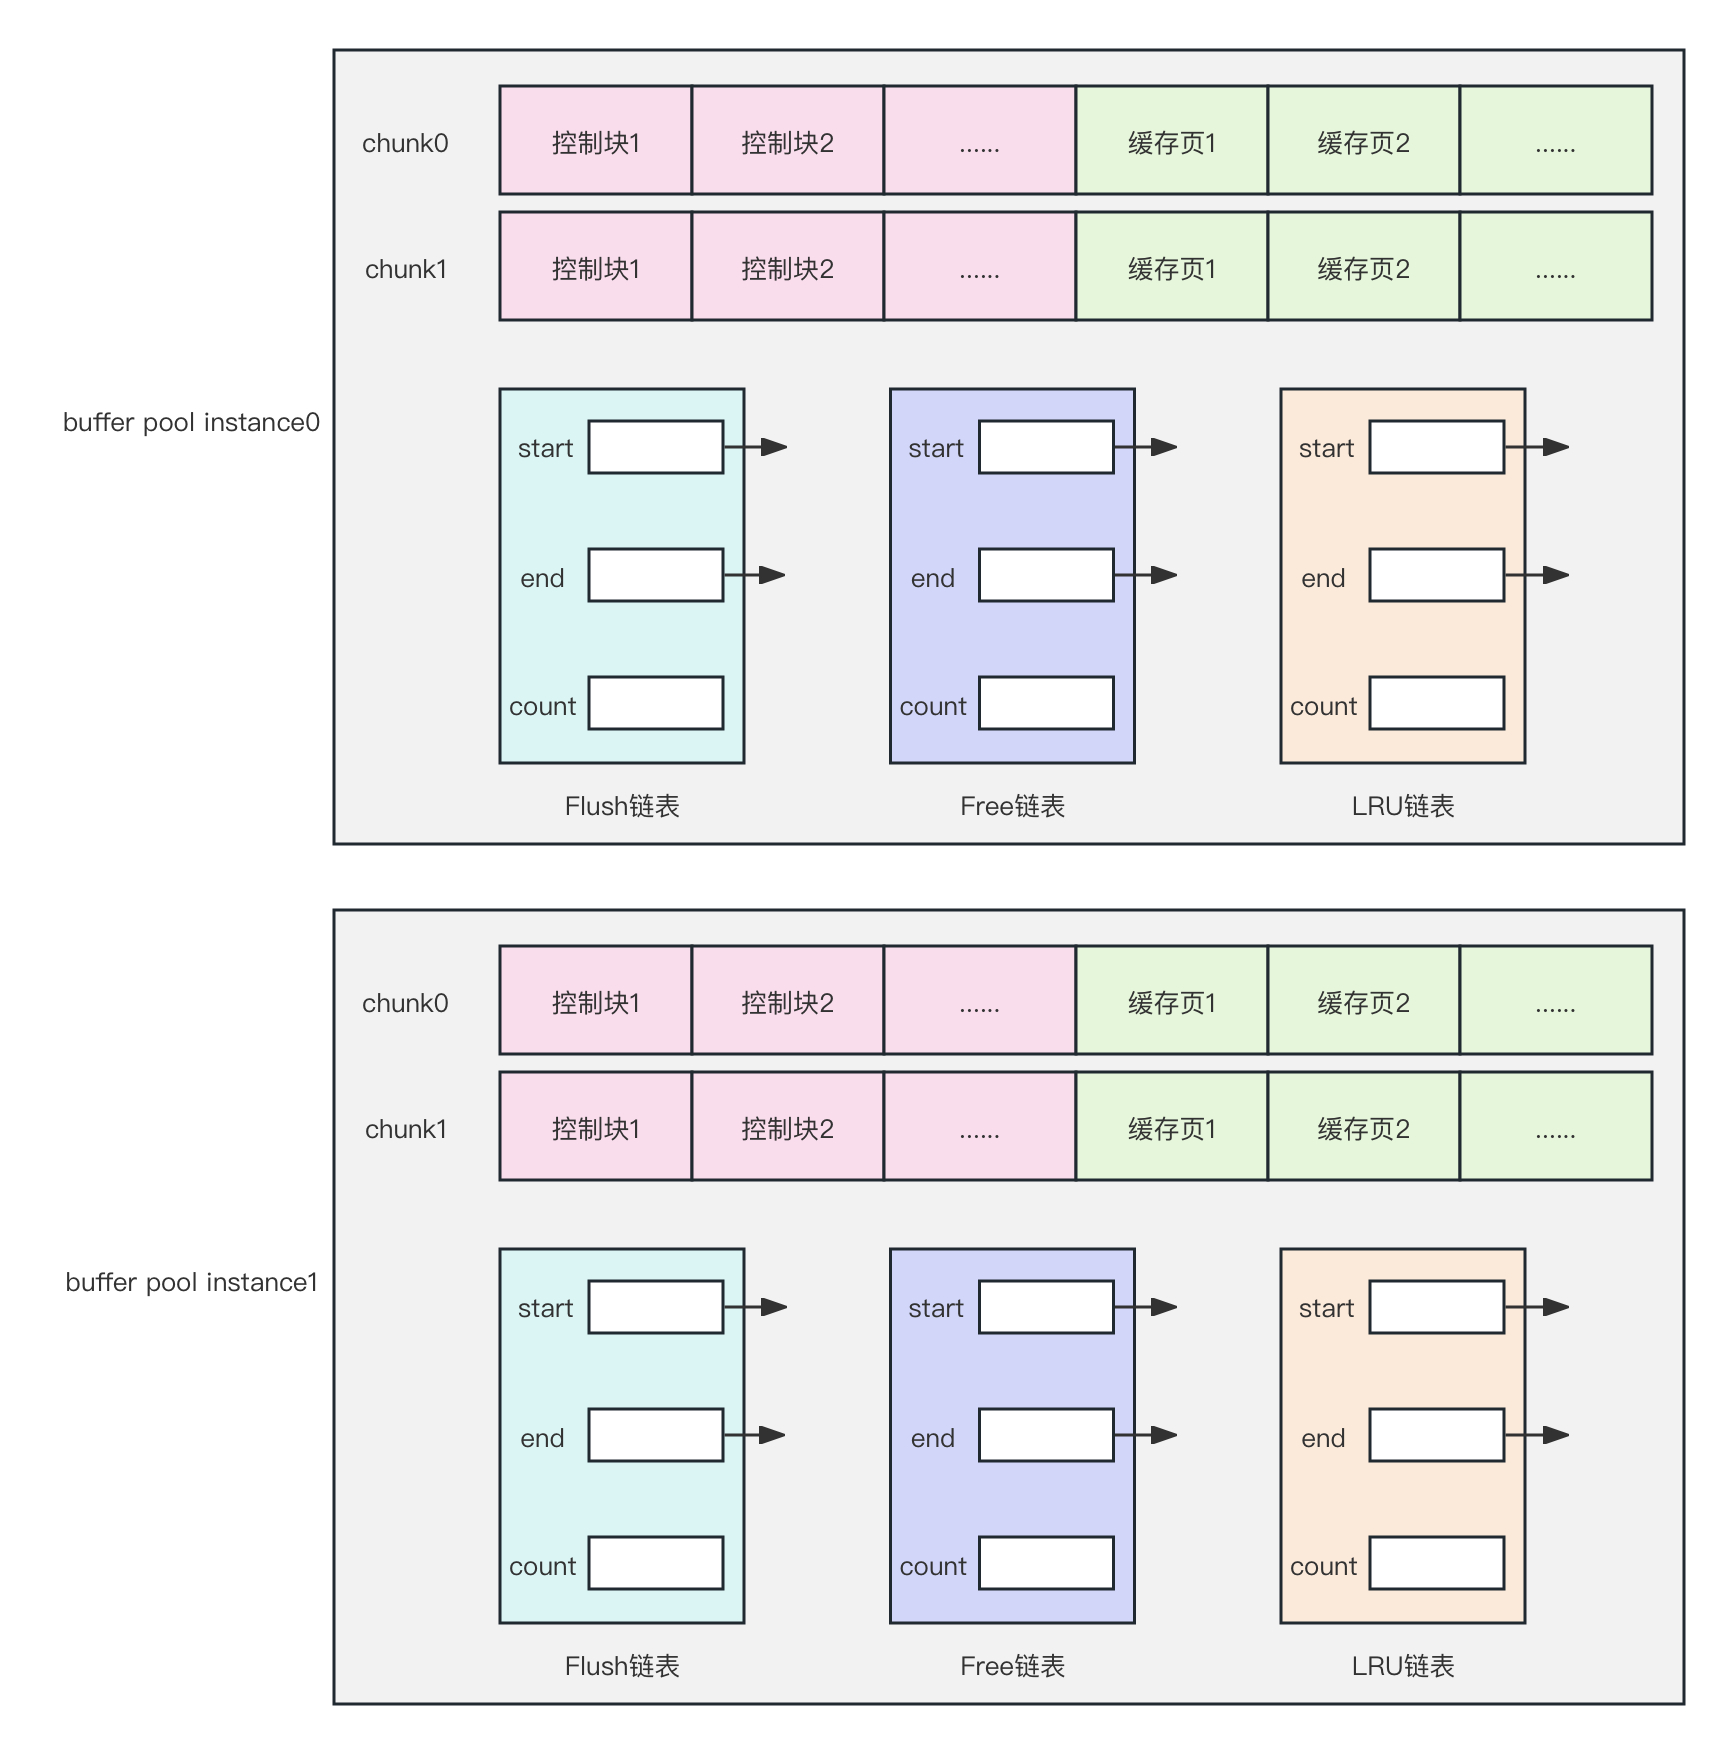
每个buffer pool负责管理自己的控制块和缓存页,有自己独立一套Free链表、Flush链表和LRU链表。
假设给buffer pool调整到16G(即:变量innodb_buffer_pool_size改为17179869184),此时,MySQL会为buffer pool申请一块大小为16G的连续内存,然后分成4块,接着将每一个 buffer pool的数据都复制到对应的内存块中,最后再清空之前的内存区域。这是相当耗费时间的操作。
为了解决以上问题,buffer pool引入chunk机制。每个buffer pool其实由多个chunk组成。每个chunk的大小由变量innodb_buffer_pool_chunk_size控制,默认值为128M。
-- 查看innodb_buffer_pool_chunk_size变量值
show variables like '%innodb_buffer_pool_chunk_size%';
-- 设置innodb_buffer_pool_chunk_size变量值
set persist_only innodb_buffer_pool_chunk_size  = 132417728;
变量innodb_buffer_pool_chunk_size和变量innodb_buffer_pool_instances一样,是一个持久化只读系统变量,修改完成后需要重启MySQL。
每个chunk就是一系列的描述数据块和对应的缓存页。
每个buffer pool中的所有chunk共享一套Free、Flush、LRU链表。
如图所示:
由于chunk机制的存在,通过增加buffer pool的chunk个数就能避免了上面说到的问题。当扩大buffer pool内存时,不再需要全部数据进行复制和粘贴,而是在原本的基础上进行增加内存。
chunk机制示例(chunk机制下,buffer pool如何动态调整大小):
调整前buffer pool的总大小为8G,调整后的buffer pool大小为16G。
由于buffer pool的实例数不可以变,因此,buffer pool从8G调整为16G是每个buffer pool增加2G的大小,此时只要给每个buffer pool申请(2048M/128M)个chunk就可以了,但是要注意的是,新增的每个chunk都是连续的128M内存。
缓冲池大小必须始终等于或者是innodb_buffer_pool_chunk_size * innodb_buffer_pool_instances的倍数。如果将缓冲池大小更改为不等于或等于innodb_buffer_pool_chunk_size * innodb_buffer_pool_instances的倍数的值,
则缓冲池大小将自动调整为等于或者是innodb_buffer_pool_chunk_size * innodb_buffer_pool_instances的倍数的值。
缓冲池示例
大量的全表扫描
如果在业务中做了大量的全表扫描,则可以将变量innodb_old_blocks_pct的设置减小,增大变量innodb_old_blocks_time的时长,不让这些无用的查询数据进入old区域,尽量不让缓存在young区域的有用的数据被立即刷掉。
-- 设置innodb_old_blocks_pct变量值
set persist innodb_old_blocks_pct=20;
-- 设置innodb_old_blocks_time变量值
set persist innodb_old_blocks_time=4000;
没有大量的全表扫描
如果在业务中没有做大量的全表扫描,则可以将innodb_old_blocks_pct增大,减小变量innodb_old_blocks_time的时长,让有用的查询缓存数据尽量缓存在innodb_buffer_pool_size中,减小磁盘IO,提高性能。
-- 设置innodb_old_blocks_pct变量值
set persist innodb_old_blocks_pct=37;
-- 设置innodb_old_blocks_time变量值
set persist innodb_old_blocks_time=1000;
【作者简介】
一枚热爱技术和生活的老贝比,专注于Java领域,关注【南秋同学】带你一起学习成长~
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


