一文讲清 Harness Engineering:为什么 Agent 的瓶颈不在模型

Harness Engineering实战:多Agent协同、沙箱隔离与Skill自进化 随着AI Agent从原型走向生产环境,单智能体已难以满足企业级应用对稳定性与安全性的要求。多Agent协同涉及任务分解、上下文隔离与权限控制,但若缺乏有效的运行框架,协作可能陷入无序。沙箱隔离技术为Agent执行提供安全边界,防止越权操作,而Skill机制则让经验沉淀为可复用的技能资产。Harness Engineering正是将模型调用、工具注册、沙箱执行、技能扩展及人工审批整合为一套“运行框架”,让Agent在可控、可审计的轨道上完成任务。该体系适用于企业知识库自动化、代码审查、文档流水线等场景,为A 阅读详情

在聊 Harness Engineering 之前,先看一个现象。

2025 年底到 2026 年初,各家 AI 公司密集发布了编程 Agent 产品——Claude Code、OpenAI Codex、Google Jules、Cursor。这些产品背后的基座模型各不相同,但它们的项目结构惊人地相似:

any-coding-agent/
├── cli/                    ← 入口和交互
├── agent/                  ← Agent 循环 + system prompt
├── tools/                  ← 工具定义(读文件、写文件、执行命令...)
├── context/                ← 上下文管理、会话持久化
├── permissions/            ← 权限控制、沙箱
└── config/                 ← 配置、用户偏好

这些代码里,真正调用 LLM 的只有一行——model.generate()。其余 95% 的代码,都在处理一个问题:怎么让这个 LLM 在真实环境中可靠地工作。

这 95% 的代码,就是 Harness。

而围绕"怎么设计好这 95%"的工程学科,就是 Harness Engineering。


Harness 是什么

直接看一个类比:

概念对应
CPU模型(原始推理能力)
RAM上下文窗口(有限的工作记忆)
操作系统Harness(管理资源、调度任务、提供驱动)
应用程序Agent(运行在 OS 之上的业务逻辑)

不会有人在裸 CPU 上跑应用程序——你需要操作系统来管理内存、调度进程、提供文件系统。同样,不应该在裸模型上直接跑 Agent——你需要 Harness 来管理上下文、调度工具、处理错误。

用一句话定义:

Harness = 把"一个大模型 + 一堆工具"变成"一个可持续运行、可观测、可控制的系统"的那层架构。


为什么现在需要给它起个名字

2026 年 3 月,一篇立场论文 Harness Engineering for Language Agents 正式提出了这个概念。同期 OpenAI、Anthropic、Martin Fowler 的博客也在密集讨论同一个词。

一个核心触发点是 LangChain 的一组数据:

他们的编程 Agent 在 Terminal Bench 2.0 上从 52.8% → 66.5%——只改了 Harness,没换模型。

如果不知道 Harness 变了,这个提升很容易被解读为"模型更强了"。但实际上模型完全没动。

这说明一个被长期忽视的事实:Agent 的能力 = 模型 × Harness,不是模型本身。

在 Agent 还只做单轮问答、调两三个工具的时候,Harness 的影响可以忽略不计。但当 Agent 开始做复杂工程任务(写一个完整项目、自主操作浏览器数小时、跨多个系统协作),Harness 的设计质量就变成了决定性因素:

  • API 超时了怎么办?
  • 上下文窗口满了怎么裁剪?
  • Agent 执行到一半用户断开了怎么处理?
  • 工具调用失败要重试还是跳过?

这些问题和模型无关,全部由 Harness 决定。

复杂度越过了一个阈值,让原来可以忽略的变量变成了决定性变量。 于是就需要给它一个名字,让大家能系统地讨论它。


CAR 框架:Harness 的三个维度

论文把 Harness 分解为三个维度——Control / Agency / Runtime,简称 CAR。

单独讲概念比较抽象,下面用 Claude Code(Anthropic 的终端编程 Agent)作为案例来拆解。选 Claude Code 是因为它是公开产品,读者可以直接安装体验,而且它的 Harness 设计在同类产品中最有代表性。

Control(控制):谁说了算

Control 解决的问题是:哪些事由代码规则决定,哪些事交给 LLM 自己判断。

来看 Claude Code 怎么做的。

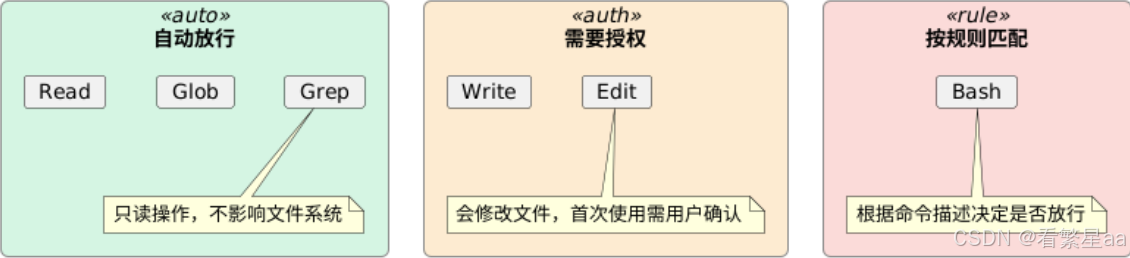
权限沙箱——Claude Code 把工具调用分成了三个等级:
在这里插入图片描述

注意,这里"能不能执行"的判断不是 LLM 做的,而是 Harness 的权限系统做的。LLM 只能看到"这个工具可以用"或"这个工具需要授权"——决策逻辑在 Harness 层。

这就是 Control 的核心:**不是信不信任 LLM,而是把不同类型的决策放在合适的层级。**确定性的安全规则用代码实现,模糊的语义判断交给 LLM。

执行预算——Agent 的 ReAct 循环不会无限跑下去,有最大步数和 token 上限。这是对"Agent 最多能跑多久"的显式约束,防止 LLM 陷入无限循环。

停止控制——用户可以随时中断 Agent 执行。中断信号通过 context 传递,Agent 循环检测到后立即退出。

Agency(代理/接口):Agent 能做什么

Agency 解决的问题是:Agent 的行动空间怎么设计。

一个常见的直觉是:工具越多,Agent 能力越强。但实践反复证明恰好相反——工具越多,LLM 越容易选错,上下文被工具描述占满后留给实际任务的空间就更少了。

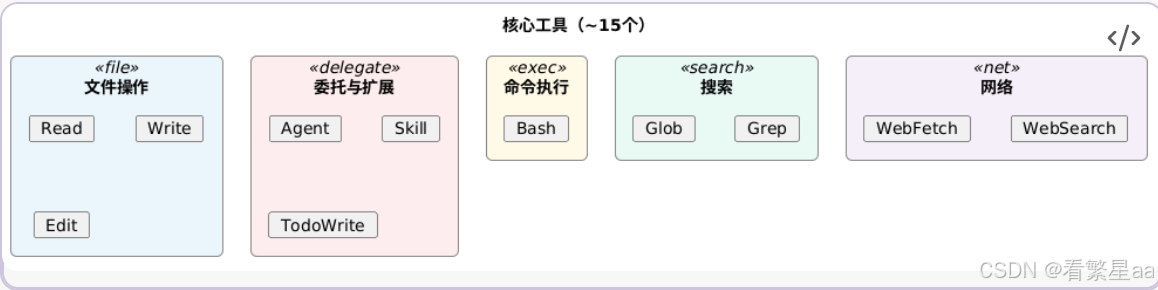
Claude Code 的工具设计就体现了"少而精"的原则:
在这里插入图片描述

覆盖了所有编程操作,但总数控制在 15 个以内。对比一些 Agent 框架动辄注册几十个细粒度工具,这种克制是有意的设计。

更值得注意的是工具描述的质量。每个工具不仅写了"该怎么用",还写了"不该怎么用":

Bash 工具描述(节选):
"避免使用 cat/head/tail 读文件,用 Read 工具代替。"
"避免使用 grep 命令搜索,用 Grep 工具代替。"

这种 反向约束(NOT for)比正向描述更重要——它大幅减少了 LLM 的选择困难。

子 Agent 机制也很巧妙:遇到复杂子任务时,主 Agent 不是给自己加工具,而是委托给子 Agent。子 Agent 有独立的上下文,完成后返回结果。主 Agent 的工具数量保持不变,复杂度通过委托而非堆工具来消化。

Skill 系统是 Agency 的动态扩展。用户可以编写 SKILL.md 文件注册新能力,Agent 按需加载。System Prompt 里只放 Skill 的名称和简短描述(几十个 token),完整说明在 Agent 需要时才加载到上下文(可能几千个 token)。

这就是所谓的渐进式展示(Progressive Disclosure)——不把所有信息一次性塞给 LLM,而是按需加载,节省上下文预算。

Runtime(运行时):系统怎么持续运行

Runtime 解决的问题是:Agent 在长时间运行中怎么不"失忆"、不"跑偏"、不"崩溃"。

上下文管理——随着对话推进,上下文会持续增长。Claude Code 在 token 数接近上限时自动压缩:保留最近的消息和关键信息,对早期历史做摘要。整个过程对 Agent 透明——Agent 不知道压缩发生了,只是"记忆"变成了摘要版本。

这里有一个重要概念:context rot(上下文腐烂)。在长对话中,随着信息累积和压缩,早期的关键细节可能被丢失或扭曲,导致 Agent 的行为逐渐偏离预期。上下文压缩策略的好坏直接影响 Agent 在长任务中的表现。

持久记忆——Claude Code 在每次会话启动时读取项目根目录的 CLAUDE.md 文件,将内容注入上下文。这个文件相当于跨会话的长期记忆——项目约定、代码规范、技术栈偏好写在这里,每次新对话都不用重复交代。

任务状态追踪——对于多步骤任务,Agent 用 TodoWrite 维护一个任务清单,标记每步的状态(pending / in_progress / completed)。这不只是给用户看进度——也是 Agent 自身的工作记忆,帮助它在长任务中不迷失。

检查点机制——Claude Code 深度集成 Git,有意义的修改后建议提交。这提供了隐式的检查点——后续操作出问题时可以回退。

这些 Runtime 机制单独看都不复杂,但它们的组合决定了系统能否持续可靠地运行。如果去掉上下文压缩让窗口溢出,或者去掉任务状态追踪让 Agent 在长任务中迷失方向——模型完全不变,系统行为会完全不同。


CAR 三个维度的联动

CAR 不是三个独立的维度,它们之间存在联动关系。

Agency 影响 Runtime:精简工具集(Agency 优化)→ 工具描述占用的 token 减少 → 上下文窗口留给对话历史的空间更大(Runtime 受益)。

Control 影响 Runtime:增加人工确认环节(Control 优化)→ 需要跨请求保存"等待确认"状态 → 需要会话持久化支持(Runtime 需跟进)。

Runtime 影响 Agency:上下文压缩策略改变(Runtime 调整)→ 早期的工具调用结果可能被摘要掉 → Agent 可能在后续步骤中重复调用同一个工具(Agency 受影响)。

CAR 框架的实用价值在于:当你要改一个维度时,可以快速检查另外两个维度是否需要联动调整,避免顾此失彼。


常见疑问:这不就是旧概念换了个名字吗

上下文管理、工具调用、权限控制、重试策略——这些概念确实存在已久。Harness Engineering 的组成部件并不新。

但有三件事是新的。

1. 统一命名

这些概念过去散布在不同的技术博客和框架文档中,分别叫 scaffolding、orchestration、context management、tool calling。没有统一的名字把它们框在一起。

类比 DevOps——CI/CD、部署脚本、监控、基础设施即代码,在 DevOps 这个词出现之前就存在。DevOps 没有发明新工具,但它创造了一个概念框架,让这些实践被系统化地讨论和传授。今天没人说"DevOps 只是换了个名字的运维"。

Harness Engineering 做的是同样的事:给一组已有实践一个名字和框架,使其成为一个可以被系统讨论的学科。

2. 归因模型的改变

以前的思维:Agent A 比 Agent B 效果好 → A 的模型更强。

现在的思维:Agent A 比 B 好 → 可能是模型更强,也可能是 Harness 更好,也可能两者都有。

这直接影响工程决策。效果不好时,应该换模型还是改 Harness?如果归因错了,可能花三个月等新模型发布,而实际上调整一下工具数量和上下文策略就够了。

论文还提出了 HARNESSCARD 的概念——一个类似 Model Card 的轻量级报告模板,要求 Agent 系统在报告性能时同时披露 Harness 设计。包含三个部分:

HARNESSCARD 示例:

Control:
  permission: 分级沙箱(读取自动/写入需授权)
  budget: 最大 50 步 / 60000 token

Agency:
  tool_count: 15 个核心工具
  loading: 按需加载(渐进式展示)
  constraints: 工具描述含反向约束(NOT for)

Runtime:
  compression: 自动摘要,阈值 60000 token
  memory: CLAUDE.md 跨会话持久
  checkpoint: Git 集成

3. 科学变量的要求

Harness Engineering 和"最佳实践合集"最不同的地方在于:论文要求 Harness 应该像模型超参数一样被记录和对照。

比如:把工具数量从 15 改成 30,其他不变,任务成功率怎么变?把上下文压缩阈值从 60000 降到 30000,长对话质量怎么变?

这些问题过去很少有人系统回答,因为 Harness 被默认为"实现细节"。但 LangChain 52.8% → 66.5% 的案例表明,Harness 的变化对结果的影响可能比模型本身还大。


Agent 项目的通用架构

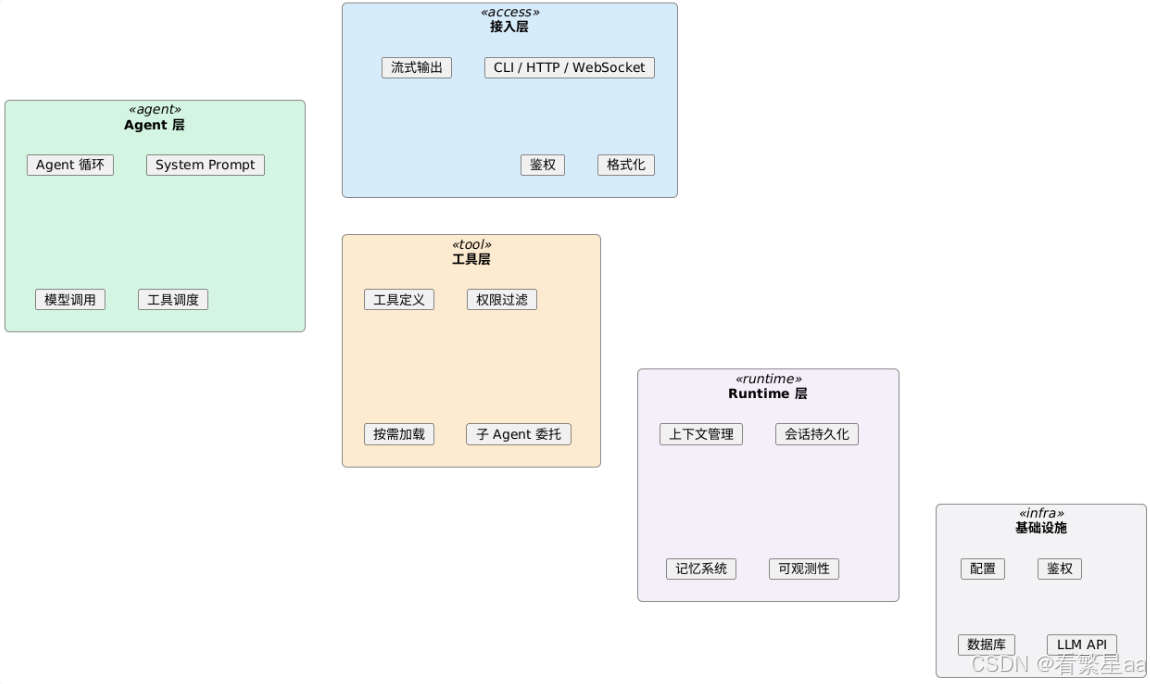
回到开头的观察——不同 Agent 产品的项目结构惊人地相似。这不是巧合,而是 Harness Engineering 实践自然收敛出的一套分层架构:
在这里插入图片描述

这四层各自对应 CAR 框架的不同维度:

  • 接入层偏 Control(权限、路由)
  • Agent 层是 Control(循环控制)+ Agency(工具调度)的交汇
  • 工具层是 Agency 的主体
  • Runtime 层是 Runtime 的主体

无论是 Claude Code、OpenAI Codex,还是企业内部的业务 Agent,基本都遵循这个分层。差异只在各层的具体实现选择上——用文件存储还是 Redis 做会话持久化,用 ReAct 还是 Plan-Execute 做 Agent 循环,用权限白名单还是分级沙箱做 Control。

如果你正在启动一个新的 Agent 项目,这四层分层可以作为起步的架构模板。


实用性判断

论文和相关工程报告提了很多建议,但不是每条都适合所有项目。

值得采纳的

建议价值
CAR 作为思维工具改架构时用三个维度过一遍,发现维度间的联动影响
工具做减法精简工具集 + 清晰的 Use when / NOT for 描述 + 按需加载,ROI 极高
归因意识效果不好先问"模型问题还是 Harness 问题",避免盲目换模型
四层分层模板接入层 / Agent 层 / 工具层 / Runtime 层,已是主流 Agent 项目的通用结构

视场景决定的

建议什么时候需要
人工确认门控涉及不可逆操作(支付、删库、群发邮件)时必须;纯分析生成类可选
自验证循环Agent 输出直接写入生产环境时需要;只输出文本给人审阅则不必
跨 Agent 状态传递多 Agent 系统且用户工作流涉及连续切换领域时需要

大多数项目不必要的

建议原因
HARNESSCARD 正式报告除非发论文或跨团队对照,内部设计文档就够
消融实验业务项目按需优化即可
Context rot 量化监测上下文压缩 + 会话 TTL 通常已足够

总结

Harness Engineering 不是一个需要额外去做的新东西。如果你在做 Agent 项目,你已经在做 Harness Engineering 了——接入层、工具系统、会话管理、上下文策略、可观测性,这些加起来就是 Harness。

一个 Agent 项目里 95% 的代码是 Harness,只有模型调用那一行不是。

这个概念的价值不在于发明了新技术,而在于三件事:

  1. 统一命名——让散落的工程实践有了一个系统讨论的名字
  2. 归因纠偏——Agent 能力 = 模型 × Harness,不再把所有功劳归给模型
  3. 框架化——CAR(Control / Agency / Runtime)提供了结构化视角来审视 Agent 架构

2026 年行业正在形成的共识是:模型已经够强了,瓶颈在 Harness。 竞争优势不在于谁有最强的模型,而在于谁能设计最有效的 Harness。

或者用论文的话说:

Reliable agency is designed, not inferred.
可靠的 Agent 行为是被设计出来的,而不是从模型中涌现出来的。

而设计这个行为的工程学科,现在有了自己的名字。

Harness Engineering 是 AI 工程领域继 Prompt Engineering、Context Engineering 之后的第三次重心迁移。从演进、构成、实践三个角度把它讲透 失败时能否定位到:哪次工具、哪次 handoff、哪条 guardrail?改动 prompt/模型版本后,能否用 trace + 数据集 证明没有回归?是否对权限、成本、超时、重试、人类审批有明确策略?是否把「完成定义」写进了可执行的检查(测试、schema、验收步骤),而不只是文案?OpenAI 用「五个月 Codex 实验」把结论写得很直白:竞争力来自束具与闭环;Anthropic 则用 Claude Code 与 safeguards 证明:高自主性必须配分层检测与运营治理。 阅读详情

相关推荐

Spring AI Agent 运行时实战:从 Prompt 模板到 Harness Engineering 的工程化落地

在 AI Agent 开发中,Prompt 模板仅解决指令表达,而 Harness Engineering 负责运行时可靠性。其原理是通过生命周期管理、工具注册、权限控制、错误恢复与状态隔离,确保模型在真实环境中稳定执行多步任务。技术价值在于提升并发安全与容错能力,应用场景覆盖订单查询、客服等 Java 后端服务。Spring AI 的 ChatClient、Advisor 链与 ToolCallback 机制为 Java 开发者提供了构建 Agent Harness 的基础设施,实现从能跑到跑稳的工程化演

weixin_32678995的博客 326

一文讲清楚 AI Agent 的核心概念:从 Token、Skill、RAG 到 MCP、SDD、Loop Engineering 和 Harness Engineering

你不是在告诉 Agent 每一步怎么做,你是在定义奖励函数——什么叫"对",什么叫"完成"——然后让 Agent 在你定义的环境里自己迭代。你定义目标(Goal),定义"完成"的可验证标准,定义预算上限,然后让 Loop 去运行——它自己找任务,分配给子 Agent,验证结果,记录状态,决定下一步,直到目标达成。" 这话乍听有点奇怪,但理解了 Vibe Coding 的失败模式,你就懂了——真正的 Prompt 不是你打在聊天框里那句话,而是那份精确定义了目标、约束、验收标准的 Spec 文件。

具身机器人和通用AI 677

【AI智能体】Harness Engineering 驾驭工程从使用到项目实战详解

Harness Engineering 驾驭工程从使用到项目实战详解

congge 2584

Loop Engineering又是啥?一文讲清企业Agent落地的四层工程进化论

Prompt Engineering 是一切的起点。在模型已经拿到所有信息的前提下,如何用最有效的措辞引导模型产出期望行为。同样的信息,换一种说法,模型表现会不会更好?具体技术手段包括:角色设定("你是一位资深财务分析师")、输出格式约束("以 JSON 格式返回")、Few-shot 示例(给 2-3 个输入输出样本)、Chain-of-Thought 引导("让我们一步步思考")、结构化 prompt 模板(使用 XML/Markdown 分区)。

2401_82819240的博客 462

总纲《从Harness engineering 到 Loop engineering》

2026 年中,AI 工程领域发生了一次静默但剧烈的范式跃迁。Addy Osmani 在博客中把"Loop Engineering"定义为:“把你(作为提示者)自己替换掉。你不再是那个提示代理的人,你设计一个系统来做这件事。这不是又一个新名词。它是一道分水岭:在此之前的工程师是"提问者",在此之后的工程师是"流程设计师"。

AI天才研究院 101

Origin软件XRD全峰拟合保姆级教程:从数据导入到弱峰处理技巧

本文提供了一份Origin软件进行XRD全峰拟合的深度实战指南。文章重点解析了从数据导入预处理、基线锚点视觉化设置,到弱峰拟合的锁定策略与手动干预等核心技巧,旨在帮助用户避开常见错误,获得可靠、精确的拟合结果,从而有效服务于材料结构分析。

rgv2345678的博客 706

强模型不代表可靠执行:learn-harness-engineering 第一课讲透 harness 工程为何决定 Agent 成败

本文围绕 learn-harness-engineering 课程第一讲《Les modèles forts ne garantissent pas une exécution fiable》(强模型不保证可靠执行),系统讲解"能力差距""验证差距""harness 诱导失败"等核心概念,并结合 Anthropic、OpenAI 的公开实验与本仓库 [项目一](https://link.gitco

gitblog_00332的博客 978

别再手动续期SSL证书了!用acme.sh配合阿里云DNS API,实现全自动HTTPS证书管理

本文详细介绍了如何使用acme.sh配合阿里云DNS API实现SSL/TLS证书的全自动管理,彻底解决手动续期带来的风险与不便。通过自动化部署流程,包括环境准备、API集成、多域名证书申请等关键步骤,帮助运维人员构建高效、可靠的HTTPS证书管理体系,显著提升安全性和运维效率。

weixin_29200485的博客 268

Learn Harness Engineering 第 14 讲:从单 Loop 到 Graph Engineering —— 当多个 Agent 需要协同时的系统设计

本篇教程围绕 Learn Harness Engineering 课程第 14 讲展开,解答一个在 2026 年中期被反复追问的问题:**为什么单个 Loop 最终一定会长成一个 Graph(图)?Graph 与传统的 Workflow 到底有什么区别?什么时候你真的需要一个 Graph,什么时候不需要?** 你将掌握图的四个基本构件(节点、边、共享状态、路由规则)、单个 Loop 在规模下失效的

gitblog_00291的博客 202

最近爆火的 Ontology 本体是什么?一文看懂基础概念 + 落地实操

1993 Tom Gruber原版定义:本体是对领域概念化模型的显式形式化规范。1998 Studer完善通用定义:本体是共享、明确、形式化的领域概念模型规范。大白话翻译:本体就是机器能看懂的行业词典+业务规则手册。数据库只管存数据,本体只管定规则,知识图谱是规则+数据结合体。区别于普通开源本体工具,这款国产商用本体平台核心优势:业务沙盘推演、可控业务数据写回、全链路字段级数据血缘审计,适配企业生产级业务落地。

驽马不舍 363

在ArcGIS Pro软件中进行滑坡的敏感性和易发性分析

滑坡的敏感性和易发性分析需要综合地形、水文、地质及环境等多维数据,本文罗列了基于ArcGIS Pro软件进行的一系列可执行分析。

weixin_49609713的博客 1731

Harness Engineering 是什么?AI Agent 越用越聪明的秘密

你看这六个问题,它们根本不是什么技术理论的包装,而是一个真实工程师在真实环境里做事情的时候,本能会问自己的那六件事。你的 PR Review Agent 今天跑了一遍,明天再跑的时候完全不记得「这个 PR 昨天已经审过了」,于是又审一遍再发一次消息,Slack 频道很快就会变成重复消息的坟场。这次会议的目标是啥。如果你不是简单地问一句「帮我总结这篇文章」,而是让大模型做一个更真实的任务,比如:「帮我分析这份需求文档,找出潜在风险,结合我们之前几次评审的意见,给出改进建议,最后生成一份发给产品经理的反馈稿」

knight_9___的博客 803

从零抓包分析AVDTP:用Wireshark解密蓝牙音频传输全流程

本文详细介绍了如何使用Wireshark抓包工具分析AVDTP协议,解密蓝牙音频传输的全流程。从实验环境搭建到信令交互解析,再到媒体流传输深度分析,逐步揭示蓝牙音频传输的技术本质,帮助开发者深入理解AVDTP协议的工作机制。

sun99的博客 202

Harness工程论文解读:Agentic Harness Engineering

一句话结论 **Agent(智能体)** 要变得更好用,瓶颈不在"再换一个更聪明的模型",而在把 **harness**(Agent 身边那一整套支撑系统——工具、规则、记忆、流程)做成 **observable**(看得见、能撤回、能讲清楚是谁起的作用)的工程对象。 2. 它在解决什么问题 **Agent**(智能体——比如帮你写代码、整理资料的那种 AI)表现好不好,越来越依赖它身边的 **harness**——也就是用什么工具、看什么规则、记得哪些经验、出错了怎么办这一整套外围设施。 但目前优化

xx_nm98的博客 326

179、瑞芯微RK3588在边缘盒子中的多摄同步架构——基于PLL的帧同步与曝光同步的实测调优

第一,RK3588的多摄同步,硬件上确实支持,但软件配置的坑比想象的多。第三,传感器的tPD差异是最大的不确定因素,选型时尽量选同一批次,而且要在量产前做全温测试——我遇到过低温下tPD变化超过3微秒的情况,直接导致同步失效。我遇到过一批IMX415,tPD差异达到±8微秒,直接超出SYNC控制器的补偿范围,最后只能挑芯片,把差异小的装到同一台设备里。别用100MHz,虽然分辨率更高,但高频信号在PCB走线上更容易引入EMI,边缘盒子的结构件往往没有很好的屏蔽,实测100MHz下同步信号边沿抖动明显增大。

zzfmlxs的博客 35

yolo 图像检测、关键点检测单摄像头测量物体尺寸长度大小

new_distance/real_size (待求物体像素距离与实际距离比值)= distance / metric_length (参照物像素距离与实际距离比值)然后运行size_demo进行要测量的物体进行关节点检测距离;metric_length是上面耳机选取的两个点的实际物理距离,大概6cm;这里用的windows。通过关键点检测识别物体关键点的像素距离,然后参考比例尺计算实际距离。2)关键点算法这里用的现有的进行测试,实际场景需要自己训练。这里拿这模型推理出的关键点坐标进行后续长度计算。

weixin_42357472的博客 2523

Harness Engineering:我的HomeSense Agent 架构演进

《从Prompt到Harness:AI工程的三阶演进与实践》摘要:本文系统阐述了AI工程从PromptEngineering到HarnessEngineering的演进历程。首先揭示核心问题:同样的模型和提示词,系统稳定性差异源于外部的"缰绳"(Harness)系统。随后解析三阶段演进路径:1)Prompt阶段聚焦任务表达;2)Context阶段优化信息供给;3)Harness阶段构建完整的执行控制系统。重点剖析成熟Harness的六层架构:上下文边界、工具系统、执行编排、记忆状态、评估

qq_36710118的博客 387

量子化学仿真软件:VASP_(7).表面与界面性质模拟

在量子化学仿真软件领域,表面与界面性质的模拟是研究多相催化、表面反应、材料科学等领域的关键工具。VASP(Vienna Ab Initio Simulation Package)作为一种广泛使用的密度泛函理论(DFT)计算软件,提供了强大的功能来模拟表面与界面的性质。本节将详细介绍如何使用VASP进行表面与界面性质的模拟,包括模型构建、输入文件准备、计算设置、结果分析等步骤。

kkchenjj的博客 948

300个智能体的关键不在模型,而在Harness工程

人工智能应用落地过程中,大模型能力与工程化机制缺一不可。模型的推理水平决定了智能体的智力上限,而真正决定其能否在生产环境中稳定运行、大规模扩展的,往往是模型之外的工程体系。这一体系被业界称为Harness,涵盖上下文组装、工具调用、状态编排、可观测性与安全治理等关键环节。Harness如同汽车的底盘与仪表盘,将模型的“发动机”动力转化为可控、可审计的业务价值。在金融等强监管领域,智能体能否达到300个量级,取决于是否构建了统一的Agent运行时与治理底座。本文通过信贷初审Agent的拆解,展示如何设计状态机

weixin_34267123的博客 404

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

YouTube 高赞视频分享:到底什么是Harness Engineering?一次讲清楚

任务是简单的单轮生成 → Prompt 是关键任务开始依赖外部知识、需要多步推理 → Context 变得关键模型进入长链路、低容错的真实执行场景 → Harness 几乎不可避免只要你的系统开始“跑流程”,Harness 就已经不可避免了。最后给你一个判断标准:成功率不稳定偶尔“抽风”很难 debug改一个地方,全局崩问题不在模型,而在 Harness。AI 落地的核心挑战,正在发生一个变化:从“让模型更聪明”→ 到“让模型稳定工作”同样的模型,不同产品表现差距巨大。

usstmiracle的博客 13

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

2026 年火遍 AI 圈的驾驭工程(Harness Engineering)是什么?从 AGENTS.md 到 TaoToken 配置骨架一次讲清

2026 年 AI Coding Agent 的瓶颈在 Harness Engineering。本文给出可落地骨架:AGENTS.md 约束任务边界与完成前校验,settings.json / config.toml 将 TaoToken 配为统一模型通道,再用 curl 与校验脚本验证 Agent 调用。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35751412的博客 10

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

图工程(Graph Engineering)实战指南:从单循环到多 Agent 协作图 —— Learn Harness Engineering 第十四讲深度解析

本篇技术指南源自 Learn Harness Engineering 教程的第十四讲《从单循环到图工程》([俄文原版](https://link.gitcode.com/i/c447f94c97ad41ecfddbf2ceb8cc2468),内容与[英文版](https://link.gitcode.com/i/f25158d1ef12f0baabc7d4c5b8e2e8f2)、[中文版](htt

gitblog_00065的博客 217

转:一文讲清楚 AI Agent 的核心概念

在你的问题域里,什么叫做好

Rolei的博客 59

什么是真正的 Harness:learn-harness-engineering 中的五子系统模型与代码级拆解

> 本篇文章以 [Lecture 02:What a Harness Actually Is](https://link.gitcode.com/i/bf349e0d2dd67f8d4a2f27a21aae530d) 为骨架,结合同一课程的 [code/ 示例目录](https://link.gitcode.com/i/96a93072cba83a687064d891c3e48557) 与仓库内

gitblog_00535的博客 270

Agent Harness Engineering 综述:用 TaoToken 统一 Key 打通 AI Agent 工程瓶颈的配置实战

用 TaoToken 统一 Key 与 Base URL,把 Cline、CC Switch、settings.json、config.toml 的接入配置收敛到一套凭据,是打通 AI Agent 工程瓶颈的第一步。本文给出四类工具的配置骨架与 curl 验证方法,帮你快速定位 401、404、模型不存在等常见报错。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42601134的博客 6
上一篇: 一文吃透 ReAct Agent:AI 任务规划与执行的闭环设计思路
下一篇: Skill:Agent 的可插拔能力单元
看繁星aa
博客等级 码龄4年 922粉丝 55原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值