Spark通信原理之Python与JVM的交互

给师弟师妹们学习数据挖掘的一些建议 看着刚进实验室的师弟师妹们的迷茫,虽然也与他们进行过一些零散的交谈,但是都不够系统。因此,根据自己的经历给出学习数据挖掘的一些建议,大家可以根据自身的情况,具体问题具体分析,作为参考。希望在上一届的基础上,走的更深,走的更远。 阅读详情

640?wx_fmt=jpeg

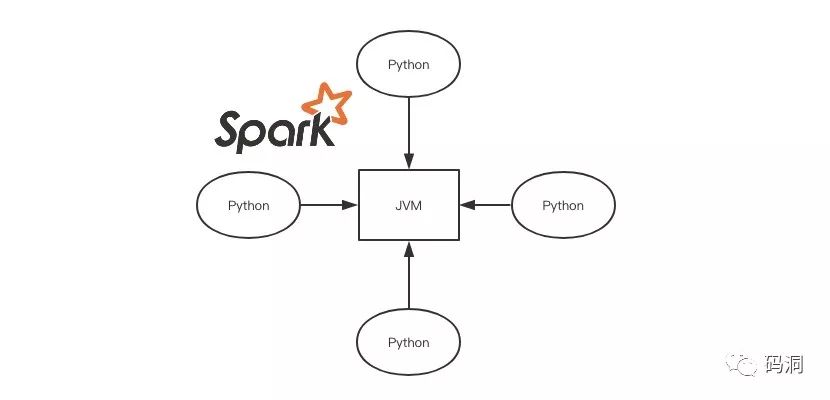
我们知道Spark平台是用Scala进行开发的,但是使用Spark的时候最流行的语言却不是Java和Scala,而是Python。原因当然是因为Python写代码效率更高,但是Scala是跑在JVM之上的,JVM和Python之间又是如何进行交互的呢?
640?wx_fmt=jpeg

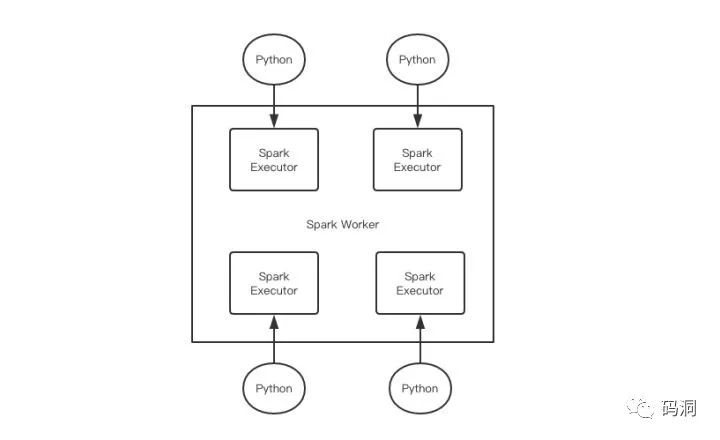
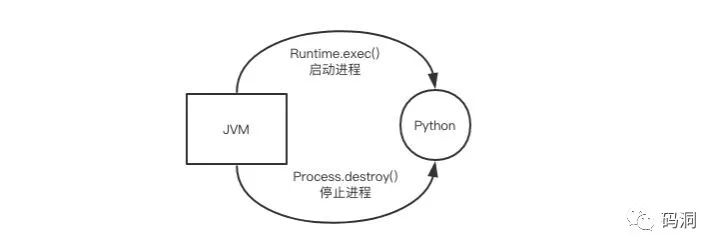
在实际运行过程中,JVM并不会直接和Python进行交互,JVM只负责启停Python脚本,而不会向Python发送任何特殊指令。启动脚本同执行外部任意进程的方法是一样的,就是调用Runtime.exec(command)生成python子进程。停止Python进行就是调用Process.destroy()和Process.destroyForcibly()杀死子进程,destroy方法使用SIGTERM信号通知Python进程主动退出,如果Python一段时间不响应,就会使用destroyForcibly方法发送SIGKIL信号强制杀死Python进程。
640?wx_fmt=jpeg

Pyspark玄妙的地方在于Python在运行的过程中需要调用Spark的API,这些API的实现在JVM虚拟机里面,也就是说python脚本运行的进程同Spark的API实现不在一个进程里,当我们在Python里面调用SparkAPI的时候,实际的动作执行确是在JVM里面,这是如何做到的?

答案就是远程过程调用,也就是我们经常听到的词汇RPC。

在Pyspark中,Python作为RPC的客户端,JVM作为RPC的服务端。JVM会开启一个Socket端口提供RPC服务,Python需要调用Spark API时,它会作为客户端将调用指令序列化成字节流发送到Socket服务端口,JVM接受字节流后解包成对应的指令,然后找到目标对象和代码进行执行,然后将执行结果序列化成字节流通过Socket返回给客户端,客户端收到字节流后再解包成Python对象,于是Python客户端就成功拿到了远程调用的结果。

客户端的这些序列化过程不是很复杂,当然也不会太简单,不管怎样,作为pyspark的使用者来说并不需要关心内部实现的细节,这一切pyspark库已经帮我们封装好了。对于JVM提供的所有RPC API,pyspark都已经包装成了一个python方法,对于使用者来说,他只需要调用相应的Python方法,就好像不存在远程过程调用一样,假装所有的这些过程都发生在python进程内部而没有任何感知。

640?wx_fmt=jpeg

仅仅在程序出现异常而在日志里面打印了复杂的堆栈信息的时候,我们才可以从中发现端倪。

pyspark的异常信息里面一般包含两部分堆栈信息,前一部分是Python堆栈,后一部分是JVM堆栈信息,原因是当JVM端执行代码出现异常的时候,会将错误信息包括堆栈信息通过RPC返回给客户端,Python客户端在输出错误日志时除了输出自己的堆栈信息之外还会将JVM返回回来的堆栈错误信息一同展现出来,方便开发者定位错误的发生原因。

Spark的开发者们并没有自己撸一个RPC库,他们使用了开源的Py4j库。Py4j是一个非常有趣的RPC库,我们接下来详细介绍这个库的使用和原理。

Py4j在JVM进程开辟一个ServerSocket监听客户端的链接,来一个链接开辟一个新线程处理这个链接上的消息,对于共享对象的状态,在JVM端实现API时需要考虑多线程并发问题。

Py4j在Python客户端会启动一个连接池连接到JVM,所有的远程调用都被封装成了消息指令,随机地从连接中挑选一个连接将消息指令序列化发送到JVM远程执行。

<dependency>
	<groupId>net.sf.py4j</groupId>
	<artifactId>py4j</artifactId>
	<version>0.10.6</version>
</dependency>

我们看一个简单的示例,首先导入相关依赖

import py4j.GatewayServer;

public class Py4jTest {

	public int fib(int n) {
		if (n < 2) {
			return 1;
		}
		return fib(n - 1) + fib(n - 2);
	}

	public static void main(String[] args) {
		Py4jTest app = new Py4jTest();
		GatewayServer server = new GatewayServer(app, 8000);
		server.start();
	}

}

上面是JVM Server端,GatewayServer需要提供一个entry_point入口点,入口点是服务对外暴露的直接引用,客户端通过这个引用来访问RPC服务。GatewayServer默认端口25333,可以通过参数进行修改。

# pip install py4j

from py4j.java_gateway import GatewayClient, JavaGateway

client = GatewayClient(address="127.0.0.1", port=8000)
gw = JavaGateway(client)
app = gw.entry_point
print app.fib(10)

这是Python客户端代码。我们首先指定远端地址构造一个GatewayClient,再拿到入口点引用,然后就可以直接调用RPC服务了。如果有多个JVM Server,我们就可以指定不同的地址构造多个GatewayClient分别进行调用,GatewayClient已经封装了连接池的逻辑。

除了使用entry_point属性暴露入口对象引用外,Gateway提供了默认的jvm对象引用,有了这个引用,你就可以远程导入任意的Java类,创建任意Java对象,自由地使用python语法操作Java的数据。

>>> from py4j.java_gateway import JavaGateway
>>> gateway = JavaGateway() # 使用默认地址
>>> random = gateway.jvm.java.util.Random()
>>> print random.nextInt(10)              

Py4j对JVM中常用的集合对象List、Set、Map做了快捷处理,使得Python常用的集合操作方法可以直接应用于JVM远程对象。

>>> m = gateway.jvm.java.util.HashMap()
>>> m["a"] = 0
>>> m.put("b",1)
>>> m{u'a': 0, u'b': 1}
>>> u"b" in m
True
>>> del(m["a"])
>>> m{u'b': 1}
>>> m["c"] = 2
>>> for key in m:
...     print("%s:%i" % (key,m[key]))

b:1
c:2

客户端表面上是在对本地一个字典对象进行操作,但是每一个操作背后都涉及到网络IO。Python使用操作符重载实现了这个转换。

Gateway Server创建的任意对象都会携带由服务端生成的唯一的对象id,服务端会将生成的所有对象装在一个Map结构里。当Python客户端需要操纵远程对象时,会将对象id和操纵指令以及参数一起传递到服务端,服务端根据对象id找到对应的对象,然后使用反射方法执行指令。

640?wx_fmt=jpeg

Py4j除了可以让Python自由操纵Java外,还可以通过Java直接操纵Python代码,实现了Python和JVM之间的双向交互。只不过逆向操作没有正向的自由,因为Java语言不是一个动态的语言,任何方法的调用都必须预先定义。所以对于Python服务的入口类,需要映射到Java端定义的一个相对应的接口类,Java通过接口函数来调用Python代码。

640?wx_fmt=jpeg

Py4j考虑了垃圾回收问题。通过Py4j客户端在JVM内部生成的对象都会集中统一放到一个map中,通过这个map来保持住对象的引用。python客户端这边会使用weakref跟踪对象的引用状态,当weakref挂接的对象被回收了说明对象变成了垃圾,Py4j就会向JVM发送一个携带对象的id的回收对象的指令,这样JVM就可以从map中移除掉这个对象,使得对象的引用技术变成零,于是就可以被JVM GC回收掉。

同样对于逆向调用,JVM会通过finalize方法来跟踪对象是否变成了垃圾。当finalize被执行时,说明指向Python对象的引用已经消失了,就会向Python VM发送一个回收对象的指令。于是Python VM也可以避免了内存泄露问题。

当你开发一个工具软件时,将需要性能和高并发的逻辑放进JVM中,而那些配置型的不需要高性能的部分逻辑使用Python来实现,再将两者使用Py4j连接到一起就可以做到一个既可以满足性能又可以满足易用性的软件来。

这同使用Golang内嵌Lua脚本语言来开发工具一样,虽然机制上差距极大,却可以达成相似的目标,即同时满足软件的性能和易用性。

640?wx_fmt=jpeg

阅读相关文章,请关注微信号【码洞】

PySpark 数据分析基础:PySpark 原理详解 总体而言,PySpark 是借助 Py4j 实现 Python 调用 Java,来驱动 Spark 应用程序,本质上主要还是 JVM runtime,Java 到 Python 的结果返回是通过本地 Socket 完成。 阅读详情

相关推荐

Spark与Python结合:PySpark初学者指南

Apache Spark开发人员每年的平均年薪为110,000美元。毫无疑问,Spark在这个行业中已经被广泛使用。由于其丰富的库集,Python今天被大多数数据科学家和分析专家使用。 将Python与Spark集成是开源社区的主要礼物。 Spark是用Scala语言开发的,与Java非常相似。它将程序代码编译为用于Spark大数据处理的JVM的字节码。为了支持Spark和Python,Apache Spark社区发布了PySpark。在本文中,我们将讨论以下主题: 1、Apache Spar

weixin_54707168的博客 2135

spark与pyspark教程(一)

大数据架构基础知识 HDFS,yarn,mapreduce,spark,hive spark 1.简介 spark是一种计算引擎,类似于hadoop架构下mapreduce,与mapreduce不同的是将计算的结果存入hdfs分布式文件系统。spark则是写入内存中,像mysql一样可以实现实时的计算,包括SQL查询。 spark不单单支持传统批量处理应用,更支持交互式查询、流式计算、机器学习、图计算等各种应用, spark是由scala语言开发,具备python的接口,pyspark。 2.spark组件

weixin_42010722的博客 1961

从 0 到 1,实战 Power BI 电商销售可视化看板全流程

本文详细介绍了从零开始使用Power BI构建电商销售可视化看板的全流程,涵盖数据准备、建模、可视化设计及高级功能应用。通过实战案例展示如何将复杂销售数据转化为直观图表,帮助电商从业者快速掌握销售趋势、热销产品和用户画像等关键信息,提升数据分析效率。

weixin_29061041的博客 487

学习Spark需要掌握的全部基础理论知识(穿插部分代码)——从Python角度看Spark

Spark 的 shell 作为一个强大的交互式数据分析工具,提供了一个简单的方式来学习 API,这里我选择使用Scala 环境学习这部分内容

Love And Program的博客 1733

68页|大型车企集团数字化转型汽车数字化信息系统平台规划方案

这份PPT文档提供了一个全面的汽车集团数字化转型规划方案,涵盖了项目目标、规划思路、实施关注点、解决方案建议以及合作优势等多个方面。

baidu_25525561的博客 1330

在STM32上运行小波变换及神经网络算法——(一)单片机中小波算法编写

在单片机上实现离散小波变换的C代码,通过确定信号长度、小波分解层数、小波基名称后进行编写,并改写成了方便调用的结构体格式。

weixin_45400202的博客 988

大数据时代Spark与Python的完美融合

假设你是奶茶店老板,开了100家分店。全市每个区域的销量Top3奶茶;每周五18点-20点的订单峰值;买过"芋泥波波"的用户,30天内复购率是多少。你用Excel打开数据——500万行,直接卡成"未响应"。数据存在不同地方:POS机的CSV、外卖平台的JSON、会员系统的MySQL;要算复购率,得关联3张表,Excel的VLOOKUP直接崩溃;想画个"销量随温度变化"的图,数据量太大,Matplotlib跑了1小时还没出结果。这就是大数据的3个痛点。

AI算力网络与通信的博客 774

QGIS编译(跨平台编译)001:Flex、Bison编译(安装)(Windows、Linux、MacOS环境下安装)

QGIS编译;Flex、Bison编译(安装)(Windows、Linux、MacOS环境下安装)

LuckyHanMo的博客 3082

Pandas基础学习与Spark Python初探

摘要:pandas是一个强大的Python数据分析工具包,pandas的两个主要数据结构Series(一维)和DataFrame(二维)处理了金融,统计,社会中的绝大多数典型用例科学,以及许多工程领域。在Spark中,python程序可以方便修改,省去java和scala等的打包环节,如果需要导出文件,可以将数据转为pandas再保存到csv,excel等。 1.Pandas是什么?    

shengjmm的博客 852

PyTorch深度学习实战(41)——循环神经网络与长短期记忆网络

循环神经网络 (Recurrent Neural Network, RNN) 通过将前一个时间步的隐藏状态作为当前时间步的输入,实现对序列数据的建模,由于循环连接的存在,RNN 能够捕获时间依赖关系,然而,RNN 在处理长期依赖性问题时会遇到困难。为了解决这个问题,提出了 LSTM,通过引入门控机制改进 RNN 来有效地处理长期依赖关系。在本节中,了解了 LSTM 和 RNN 的基本原理,并介绍了如何在 PyTorch 中实现 LSTM。

盼小辉丶的博客 1万+

2021-09-29 每天几个LCEDA小知识——如何交叉选择并阵列放置元器件

立创EDA专业版之交叉选择并阵列放置元器件????交叉选择????阵列放置 ????交叉选择 在原理图界面,先框选需要交叉选择的元器件对象,右键,选择交叉选择(如果熟练之后,直接选择元器件,快捷键Shift+X)。 完成上述操作之后,可以看到自动跳转到PCB绘图界面,并自动选定PCB中相关的元器件,接下来不要取消选择的状态,在相关元器件被选中的情况下,即可开展阵列放置,将这些元器件都放在一个区域,方便PCB画线前的布局工作。 ????阵列放置 在布局菜单栏中,选择分布,选择阵列分布, 在弹出的对话框

l64481000的博客 1465

PySpark是Apache Spark的Python库,它使得Python开发者能够利用Spark的分布式计算功能

15. **与其他技术的集成**:除了与其他大数据技术(如Hadoop、Hive等)集成外,PySpark还可以与机器学习库(如scikit-learn)、可视化库(如matplotlib、seaborn)等集成,从而提供更丰富的数据分析和可视化功能。22. **社区支持和生态系统**:PySpark拥有庞大的用户社区和丰富的生态系统,这意味着用户可以获得大量的支持、教程、示例代码和第三方库。20. **支持流式计算**:除了批处理外,PySpark还提供了对流式计算的支持。

博客域名:borter.blog.youkuaiyun.com 701

小麦病害检测系统开发

本项目旨在针对小麦病害小目标检测任务,在YOLOv11基础上进行三项改进: - 将主干网络替换为Swin Transformer,增强全局特征提取能力。 - 在检测头中引入DynamicHead,并增加检测头数量至四个,提升多尺度检测性能。 - 集成半监督FixMatch训练框架,利用无标签数据提升模型泛化能力。 我们定义五个模型进行对比实验: - Model 0: 原始YOLOv11 (有监督) - Model 1: YOLOv11 + Swin Transformer (有监督) ~~~~~~

AI的内部世界的博客 121

python通信原理_Spark通信原理之Python与JVM的交互

我们知道Spark平台是用Scala进行开发的,但是使用Spark的时候最流行的语言却不是Java和Scala,而是Python。原因当然是因为Python写代码效率更高,但是Scala是跑在JVM之上的,JVM和Python之间又是如何进行交互的呢?在实际运行过程中,JVM并不会直接和Python进行交互,JVM只负责启停Python脚本,而不会向Python发送任何特殊指令。启动脚本同执行外部...

weixin_39865061的博客 169

LeRobot 入门教程(七)数据集

LeRobot Dataset v3.0 是机器人学习数据的标准化格式,支持多模态时间序列数据和视频的统一访问。该版本通过基于文件的存储(Parquet/MP4)、关联元数据和Hub原生流式处理等新特性,显著提升了性能并降低了存储开销。文档详细介绍了格式设计、安装使用、数据记录与加载方法,以及从v2.1迁移到v3.0的步骤,特别针对大型数据集(如DROID 1.0.1)的处理提供了SLURM集群移植方案。v3.0通过优化文件组织和元数据管理,实现了更快的加载速度、更高的内存效率和更好的可扩展性。

2506_90492529的博客 2055

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

python与spark有联系吗_Spark通信原理之Python与JVM的交互

我们知道Spark平台是用Scala进行开发的,但是使用Spark的时候最流行的语言却不是Java和Scala,而是Python。原因当然是因为Python写代码效率更高,但是Scala是跑在JVM之上的,JVM和Python之间又是如何进行交互的呢?在实际运行过程中,JVM并不会直接和Python进行交互,JVM只负责启停Python脚本,而不会向Python发送任何特殊指令。启动脚本同执行外部...

weixin_39725594的博客 299

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

java和python数据交互_Spark通信原理之Python与JVM的交互

我们知道Spark平台是用Scala进行开发的,但是使用Spark的时候最流行的语言却不是Java和Scala,而是Python。原因当然是因为Python写代码效率更高,但是Scala是跑在JVM之上的,JVM和Python之间又是如何进行交互的呢?在实际运行过程中,JVM并不会直接和Python进行交互,JVM只负责启停Python脚本,而不会向Python发送任何特殊指令。启动脚本同执行外部...

weixin_39679468的博客 224

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Spark中Python与JVM的交互

原文链接:Spark通信原理之Python与JVM的交互 我们知道Spark平台是用Scala进行开发的,但是使用Spark的时候最流行的语言却不是Java和Scala,而是Python。原因当然是因为Python写代码效率更高,但是Scala是跑在JVM之上的,JVM和Python之间又是如何进行交互的呢? 在实际运行过程中,JVM并不会直接和Python进行交互,JVM只负责启停Pytho...

jia_7m的博客 648

Spark Schema、Hive和Python的数据类型关系,以及Pyspark数据类型详解

Spark Schema、Hive和Python的数据类型关系,以及Pyspark数据类型详解

qq_28658621的博客 6980

揭开PythonSpark框架的秘密

1.背景介绍 在大数据时代,处理和分析海量数据变得越来越重要。Apache Spark是一个开源的大数据处理框架,它可以处理批量数据和流式数据,并提供了一个易用的编程模型。PythonSpark是基于Python编程语言的Spark框架,它使得Spark更加易于使用和扩展。在本文中,我们将揭开PythonSpark框架的秘密,探讨其核心概念、算法原理、最佳实践、应用场景和未来发展趋势。 1. ...

AI天才研究院 424

Spark 学习-1 (python)

Spark学习-自用笔记

m0_55641196的博客 3303

java 调用python_皮皮调度(3)——Java和Python互相调用的方式

要实现皮皮调度,那么首先遇到的问题就是:Java和Python如何相互调用,并且Java部分能编译成原生程序。因为皮皮调度在设计之初就有了明确的目标: (参考皮皮调度(1)——从Airflow到DolphinScheduler,以及“皮皮调度”的来历​mp.weixin.qq.com)Java来实现平台核心框架Python用来实现各种自定义插件那让我们来首先列举一下Java和Python互相调用的...

weixin_39979245的博客 1014

pyspark运行加速方法思考(一)

pyspark运行优化pyspark工作原理工作中的联想案例借鉴总结 pyspark工作原理 如上图所示,pyspark并没有像dpark一样用python重新实现一个计算引擎,依旧是复用了scala的jvm计算底层,只是用py4j架设了一条python进程和jvm互相调用的桥梁。 driver: pyspark脚本和sparkContext的jvm使用py4j相互调用; executor: 由于driver帮忙把spark算子封装好了,执行计划也生成了字节码,一般情况下不需要python进程参与; 仅

qq_39290182的博客 2498

sparkpython多线程_pyspark与py4j线程模型简析

事由上周工作中遇到一个bug,现象是一个spark streaming的job会不定期地hang住,不退出也不继续运行。这个job经是用pyspark写的,以kafka为数据源,会在每个batch结束时将统计结果写入mysql。经过排查,我们在driver进程中发现有有若干线程都出于Sl状态(睡眠状态),进而使用gdb调试发现了一处死锁。这是MySQLdb库旧版本中的一处bug,在此不再赘述,有兴...

weixin_39775872的博客 908

java spark 运行原理_解读pyspark运行原理

python在近几年的势头很猛,在很多的编程语言排行榜中都能占据第一第二的位置。对初学者比较友好,优雅的编程风格,较高的开发效率,这些特点让python成为很多互联网行业从业者的选择。尤其是python在数据科学领域里面丰富的生态支持,让很多软件架构师在既要做系统架构,又要做数据算法的场景中为了统一编程语言,就进入了python的怀抱。在spark支持的开发语言中,python拥有比较高的使用比例...

weixin_26757925的博客 294
上一篇: GopherLua基础入门
下一篇: 迟来的HTTP2简明教程
codehole_
博客等级 码龄7年 34粉丝 132原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值