


===============================================================
MobileNetV1_demo
├─data
│ └─train
│ ├─Black-grass
│ ├─Charlock
│ ├─Cleavers
│ ├─Common Chickweed
│ ├─Common wheat
│ ├─Fat Hen
│ ├─Loose Silky-bent
│ ├─Maize
│ ├─Scentless Mayweed
│ ├─Shepherds Purse
│ ├─Small-flowered Cranesbill
│ └─Sugar beet
├─dataset
│ └─dataset.py
└─models
│ └─mobilenetV1.py
├─train.py
├─test1.py
└─test.py
===================================================================
import torch.optim as optim
import torch
import torch.nn as nn
import torch.nn.parallel
import torch.utils.data
import torch.utils.data.distributed
import torchvision.transforms as transforms
from dataset.dataset import SeedlingData
from torch.autograd import Variable
from Model.mobilenetv1 import MobileNetV1
from torchtoolbox.tools import mixup_data, mixup_criterion
from torchtoolbox.transform import Cutout
=================================================================
设置学习率、BatchSize、epoch等参数,判断环境中是否存在GPU,如果没有则使用CPU。建议使用GPU,CPU太慢了。
设置全局参数
modellr = 1e-4
BATCH_SIZE = 16
EPOCHS = 300
DEVICE = torch.device(‘cuda’ if torch.cuda.is_available() else ‘cpu’)
===================================================================
数据处理比较简单,加入了Cutout、做了Resize和归一化。
数据预处理
transform = transforms.Compose([
transforms.Resize((224, 224)),
Cutout(),
transforms.ToTensor(),
transforms.Normalize([0.5, 0.5, 0.5], [0.5, 0.5, 0.5])
])
transform_test = transforms.Compose([
transforms.Resize((224, 224)),
transforms.ToTensor(),
transforms.Normalize([0.5, 0.5, 0.5], [0.5, 0.5, 0.5])
])
===============================================================
将数据集解压后放到data文件夹下面,如图:

然后我们在dataset文件夹下面新建 init.py和dataset.py,在datasets.py文件夹写入下面的代码:
coding:utf8
import os
from PIL import Image
from torch.utils import data
from torchvision import transforms as T
from sklearn.model_selection import train_test_split
Labels = {‘Black-grass’: 0, ‘Charlock’: 1, ‘Cleavers’: 2, ‘Common Chickweed’: 3,
‘Common wheat’: 4, ‘Fat Hen’: 5, ‘Loose Silky-bent’: 6, ‘Maize’: 7, ‘Scentless Mayweed’: 8,
‘Shepherds Purse’: 9, ‘Small-flowered Cranesbill’: 10, ‘Sugar beet’: 11}
class SeedlingData (data.Dataset):
def init(self, root, transforms=None, train=True, test=False):
“”"
主要目标: 获取所有图片的地址,并根据训练,验证,测试划分数据
“”"
self.test = test
self.transforms = transforms
if self.test:
imgs = [os.path.join(root, img) for img in os.listdir(root)]
self.imgs = imgs
else:
imgs_labels = [os.path.join(root, img) for img in os.listdir(root)]
imgs = []
for imglable in imgs_labels:
for imgname in os.listdir(imglable):
imgpath = os.path.join(imglable, imgname)
imgs.append(imgpath)
trainval_files, val_files = train_test_split(imgs, test_size=0.3, random_state=42)
if train:
self.imgs = trainval_files
else:
self.imgs = val_files
def getitem(self, index):
“”"
一次返回一张图片的数据
“”"
img_path = self.imgs[index]
img_path=img_path.replace(“\”,‘/’)
if self.test:
label = -1
else:
labelname = img_path.split(‘/’)[-2]
label = Labels[labelname]
data = Image.open(img_path).convert(‘RGB’)
data = self.transforms(data)
return data, label
def len(self):
return len(self.imgs)
说一下代码的核心逻辑:
第一步 建立字典,定义类别对应的ID,用数字代替类别。
第二步 在__init__里面编写获取图片路径的方法。测试集只有一层路径直接读取,训练集在train文件夹下面是类别文件夹,先获取到类别,再获取到具体的图片路径。然后使用sklearn中切分数据集的方法,按照7:3的比例切分训练集和验证集。
第三步 在__getitem__方法中定义读取单个图片和类别的方法,由于图像中有位深度32位的,所以我在读取图像的时候做了转换。
然后我们在train.py调用SeedlingData读取数据 ,记着导入刚才写的dataset.py(from dataset.dataset import SeedlingData)
dataset_train = SeedlingData(‘data/train’, transforms=transform, train=True)
dataset_test = SeedlingData(“data/train”, transforms=transform_test, train=False)
读取数据
print(dataset_train.imgs)
导入数据
train_loader = torch.utils.data.DataLoader(dataset_train, batch_size=BATCH_SIZE, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset_test, batch_size=BATCH_SIZE, shuffle=False)
===============================================================
-
设置loss函数为nn.CrossEntropyLoss()。
-
设置模型为MobileNetV1,num_classes设置为12。
-
优化器设置为adam。
-
学习率调整策略选择为余弦退火。
实例化模型并且移动到GPU
criterion = nn.CrossEntropyLoss()
model_ft = MobileNetV1(num_classes=12)
model_ft.to(DEVICE)
选择简单暴力的Adam优化器,学习率调低
optimizer = optim.Adam(model_ft.parameters(), lr=modellr)
cosine_schedule = optim.lr_scheduler.CosineAnnealingLR(optimizer=optimizer,T_max=20,eta_min=1e-9)
====================================================================
定义训练过程
alpha=0.2
def train(model, device, train_loader, optimizer, epoch):
model.train()
sum_loss = 0
total_num = len(train_loader.dataset)
print(total_num, len(train_loader))
for batch_idx, (data, target) in enumerate(train_loader):
data, target = data.to(device, non_blocking=True), target.to(device, non_blocking=True)
data, labels_a, labels_b, lam = mixup_data(data, target, alpha)
optimizer.zero_grad()
output = model(data)
loss = mixup_criterion(criterion, output, labels_a, labels_b, lam)
loss.backward()
optimizer.step()
lr = optimizer.state_dict()[‘param_groups’][0][‘lr’]
print_loss = loss.data.item()
sum_loss += print_loss
if (batch_idx + 1) % 10 == 0:
print(‘Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}\tLR:{:.9f}’.format(
epoch, (batch_idx + 1) * len(data), len(train_loader.dataset),
-
- (batch_idx + 1) / len(train_loader), loss.item(),lr))
ave_loss = sum_loss / len(train_loader)
print(‘epoch:{},loss:{}’.format(epoch, ave_loss))
ACC=0
验证过程
def val(model, device, test_loader):
global ACC
model.eval()
test_loss = 0
correct = 0
total_num = len(test_loader.dataset)
print(total_num, len(test_loader))
with torch.no_grad():
for data, target in test_loader:
data, target = Variable(data).to(device), Variable(target).to(device)
output = model(data)
loss = criterion(output, target)
_, pred = torch.max(output.data, 1)
correct += torch.sum(pred == target)
print_loss = loss.data.item()
test_loss += print_loss
correct = correct.data.item()
acc = correct / total_num
avgloss = test_loss / len(test_loader)
print(‘\nVal set: Average loss: {:.4f}, Accuracy: {}/{} ({:.0f}%)\n’.format(
avgloss, correct, len(test_loader.dataset), 100 * acc))
if acc > ACC:
torch.save(model_ft, ‘model_’ + str(epoch) + ‘_’ + str(round(acc, 3)) + ‘.pth’)
ACC = acc
训练
for epoch in range(1, EPOCHS + 1):
train(model_ft, DEVICE, train_loader, optimizer, epoch)
cosine_schedule.step()
val(model_ft, DEVICE, test_loader)
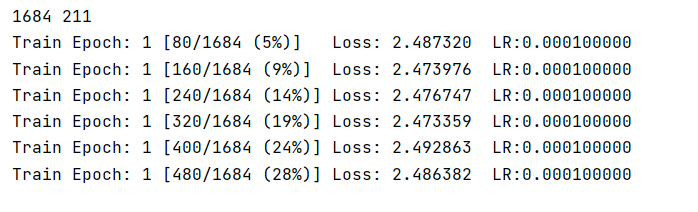
运行结果:
自我介绍一下,小编13年上海交大毕业,曾经在小公司待过,也去过华为、OPPO等大厂,18年进入阿里一直到现在。
深知大多数Python工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则几千的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!
因此收集整理了一份《2024年Python开发全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友,同时减轻大家的负担。


既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上Python开发知识点,真正体系化!
由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新
如果你觉得这些内容对你有帮助,可以添加V获取:vip1024c (备注Python)
一、Python所有方向的学习路线
Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。


二、Python必备开发工具
工具都帮大家整理好了,安装就可直接上手!
三、最新Python学习笔记
当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。

四、Python视频合集
观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

五、实战案例
纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
六、面试宝典


简历模板
一个人可以走的很快,但一群人才能走的更远。如果你从事以下工作或对以下感兴趣,欢迎戳这里加入程序员的圈子,让我们一起学习成长!
AI人工智能、Android移动开发、AIGC大模型、C C#、Go语言、Java、Linux运维、云计算、MySQL、PMP、网络安全、Python爬虫、UE5、UI设计、Unity3D、Web前端开发、产品经理、车载开发、大数据、鸿蒙、计算机网络、嵌入式物联网、软件测试、数据结构与算法、音视频开发、Flutter、IOS开发、PHP开发、.NET、安卓逆向、云计算
图片描述](https://i-blog.csdnimg.cn/blog_migrate/76297f91d14514672f4a1b141f32f260.png)
简历模板
一个人可以走的很快,但一群人才能走的更远。如果你从事以下工作或对以下感兴趣,欢迎戳这里加入程序员的圈子,让我们一起学习成长!
AI人工智能、Android移动开发、AIGC大模型、C C#、Go语言、Java、Linux运维、云计算、MySQL、PMP、网络安全、Python爬虫、UE5、UI设计、Unity3D、Web前端开发、产品经理、车载开发、大数据、鸿蒙、计算机网络、嵌入式物联网、软件测试、数据结构与算法、音视频开发、Flutter、IOS开发、PHP开发、.NET、安卓逆向、云计算

 1174


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


