hadoop 学习(六)分布式集群搭建

集群规划 

三台服务器   192.168.92.148 192.168.92.150 192.168.92.152

分别将hostname改为 hadoop148 hadoop150 hadoop152


hadoop148

hadoop150

hadoop152

HDFS


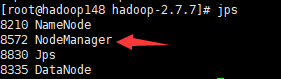
NameNode

DataNode


DataNode

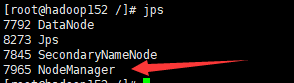
SecondaryNameNode

DataNode

YARN


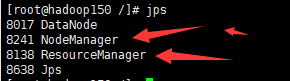
NodeManager

ResourceManager

NodeManager


NodeManager

首先配置ssh 

进入~/.ssh 目录

在三台机器上分别执行 ssh-keygen -t rsa 连续三个回车 生成公钥和私钥   

将秘钥分发到另外两台机器   ssh-copy-id 目标hostname   三台都要执行  

ssh成功后测试ssh登录不需要密码即成功


编写脚本封装rsynx  脚本内容如下   脚本需要依赖rsync  yum install rsync 安装

#!/bin/bash
#1 获取输入参数个数,如果没有参数,直接退出
pcount=$#
if((pcount==0)); then
echo no args;
exit;
fi

#2 获取文件名称
p1=$1
fname=`basename $p1`
echo fname=$fname

#3 获取上级目录到绝对路径
pdir=`cd -P $(dirname $p1); pwd`
echo pdir=$pdir

#4 获取当前用户名称
user=`whoami`

#5 循环  循环条件包含所需要分发的机器即可    
for((host=148; host<=152; host++)); do
        echo ------------------- hadoop$host --------------
        rsync -rvl $pdir/$fname $user@hadoop$host:$pdir
done

脚本放在 /usr/local/bin 下    脚本需要赋予执行权限  chmod 777 xsync    分发使用方式  xsync 文件夹路径  

hadoop 和 jdk 安装与环境变量配置见 hadoop 学习(一) 安装hadoop环境  

编辑hadoop配置文件  

hadoop-env.sh    yarn-env.sh   mapred-env.sh  三个配置文件中的java_home全都修改成绝对路径 

core-site.xml 

<configuration>
<property>
        <name>fs.defaultFS</name>
        <value>hadoop148:9000</value>
</property>
<!--  文件存储路径   -->
<property>
        <name>hadoop.tmp.dir</name>
        <value>/opt/module/hadoop-2.7.7/data/tmp</value>
</property>
</configuration>

hdfs-site.xml

<configuration>
<!-- 指定副本数  -->
<property>
    <name>dfs.replication</name>
    <value>3</value>
</property>

<!-- 指定Hadoop辅助名称节点主机配置 -->
<property>
      <name>dfs.namenode.secondary.http-address</name>
      <value>hadoop152:50090</value>
</property>

</configuration>

yarn-site.xml

<configuration>
<property>
  <name>yarn.nodemanager.aux-services</name>
  <value>mapreduce_shuffle</value>
</property>
<property>
  <name>yarn.resourcemanager.hostname</name>
  <value>hadoop150</value>
</property>
<!-- 开启日志聚集  -->
<property>
  <name>yarn.log-aggregation-enable</name>
  <value>true</value>
</property>

<!-- 日志保留时间设置7天 -->
<property>
  <name>yarn.log-aggregation.retain-seconds</name>
  <value>604800</value>
</property>
</configuration>

mapred-site.xml

<configuration>

<property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
</property>
<!-- 历史服务器端地址 -->
<property>
        <name>mapreduce.jobhistory.address</name>
        <value>hadoop148:10020</value>
</property>
<!-- 历史服务器web端地址 -->
<property>
        <name>mapreduce.jobhistory.webapp.address</name>
        <value>hadoop148:19888</value>
</property>

</configuration>

将配置好的hadoop分发到另外两台服务器上     xsync /opt/module/hadoop-2.7.7/


启动集群

编辑slaves文件  

vim  /opt/module/hadoop-2.7.7/etc/hadoop/slaves  

加入三台服务器的hostname   不允许有多余的空格和回车    

hadoop148
hadoop150
hadoop152

xsync  /opt/module/hadoop-2.7.7/etc/hadoop/slaves     将文件分发到其他服务器  

启动集群

       (1)如果集群是第一次启动,需要格式化NameNode(注意格式化之前,一定要先停止上次启动的所有namenode和datanode进程,然后再删除data和log数据)   

hadoop namenode -format

(2)启动HDFS


 [root@hadoop148 hadoop-2.7.7]# sbin/start-dfs.sh

 [root@hadoop148 hadoop-2.7.7]# jps

4166 NameNode

4482 Jps

4263 DataNode

[root@hadoop150 hadoop-2.7.7]# jps

3218 DataNode

3288 Jps


[root@hadoop152 hadoop-2.7.7]# jps

3221 DataNode

3283 SecondaryNameNode

3364 Jps

(3)启动YARN

[root@hadoop150 hadoop-2.7.7]# sbin/start-yarn.sh

注意:NameNode和ResourceManger如果不是同一台机器,不能在NameNode上启动 YARN,应该在ResouceManager所在的机器上启动YARN。

在yarn-site.xml指定了resourceManager的位置   

启动后查看各节点情况  
5d9c9e2c10ec30b5e96c6861888001714fa.jpg

f36dee8231f3f4d5e092f826ca8367452ec.jpg

cd0cd5839d8ca9903d7548c80cfc6a2b7e9.jpg

查看SecondaryNameNode的 web页面  192.168.92.152:50090   
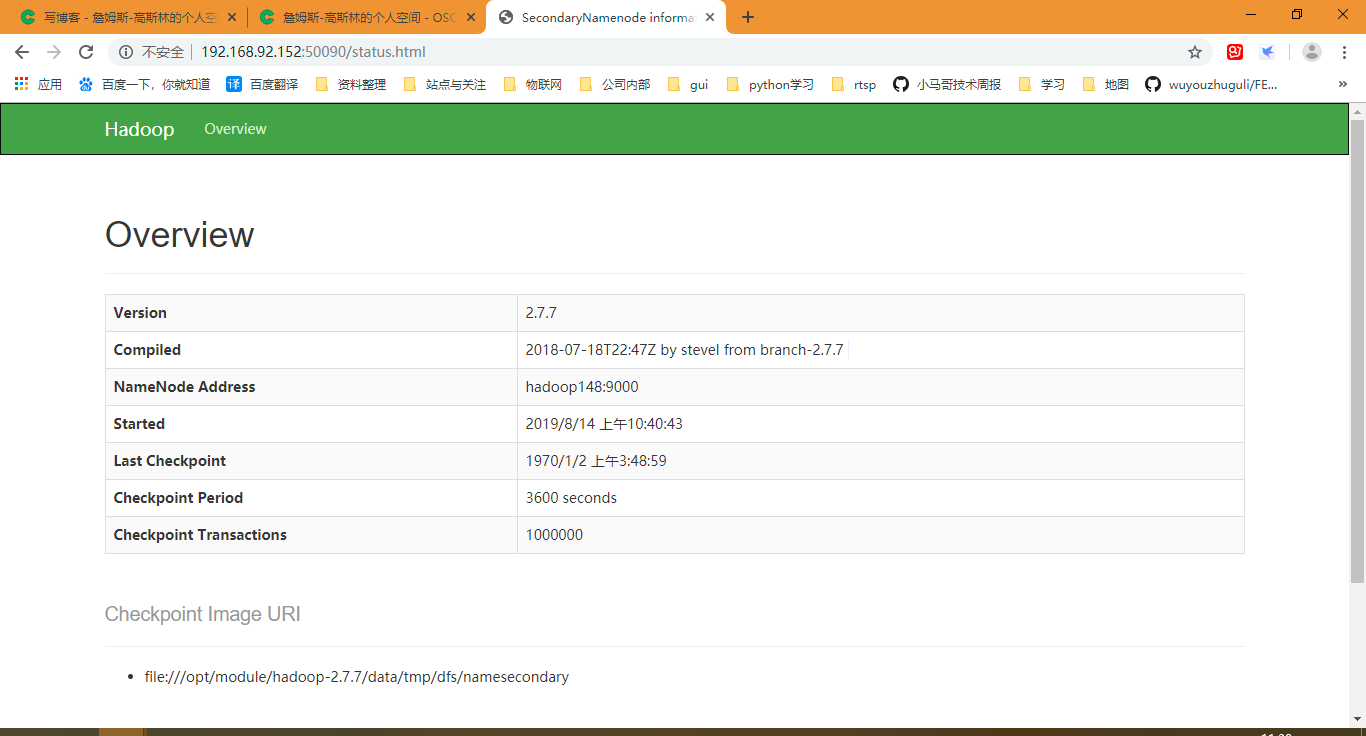
79e9adf8af940619ed97b7cbbfff57cb793.jpg

至此集群搭建完毕


各个模块分开启动/停止(配置ssh是前提)

       (1)整体启动/停止HDFS(namenode的机器上操作)

              start-dfs.sh   /  stop-dfs.sh

       (2)整体启动/停止YARN(resourceManager的机器上操作)

              start-yarn.sh  /  stop-yarn.sh


转载于:https://my.oschina.net/u/3618851/blog/3090044

Linux中Hadoop 集群搭建 零、下载Hadoop: http://archive.cloudera.com/cdh5/cdh/5/?tdsourcetag=s_pctim_aiomsg 一、集群规划: 搭建的 hadoop 集群由 3 台服务器组成,分别叫做 master,salve1 和 slave2。其中 master 作为主节点,slave1 和 slave2 作为从节点。 二、网络配置: 1.查看 3 个节点的主机名... 阅读详情

相关推荐

Hadoop分布式集群搭建以及案例运行-fs操作

Hadoop分布式集群搭建案例步骤(也可以叫分布式文件系统)一:创建分布式集群环境二:设置静态ip以及主机名与映射关系三:创建用户、配置SSH无密登录四:子机dn操作五:配置主机jdk、hadoop的环境以及hadoop文件六:打包、远程传输至子机七:启动hadoop集群以及运行案例基于hadoop的整体分布式模块交互 1)分布式系统的定义  把数据放到一个服务器集群上面,分为:主控服务器(Mas...

OnTheRoad的博客 1万+

Hadoop集群搭建与经验总结

最近要研发一款数据传输服务的产品需要用到Hadoop集群,之前搭建过后来长时间不用就给忘记了,这次搭好来记录一下搭建方法与经验总结 欢迎使用Markdown编辑器 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Markdown编辑器, 可以仔细阅读这篇文章,了解一下Markdown的基本语法知识。 新的改变 我们对Markdown编辑器进行了一些功能拓展与语...

一朝风月 6543

Hadoop分布式集群搭建完全教程

最近在学Hadoop,试着在自己机子上搭了个分布式环境,测试成功,现将搭建过程分享给大家。实验环境: 系统:win7 内存:8G(因要开虚拟机,内存建议不低于8G) 硬盘:建议固态 虚拟机:VMware 12 Linux:Centos 7 jdk1.7.0_67 hadoop-2.5.0.tar.gz 1.安装VMware虚拟机环境 2.安装Centos操作系统 3.修改主机名配置网络

小满麦渐黄 4837

搭建Hadoop分布式集群的详细教程

本文包括VMware创建配置虚拟机的基本方法,Centos的安装与配置,Hadoop集群安装与配置方法

程序员小木的博客 2万+

hadoop分布式集群之MySQL分布式集群搭建

分布式系统(distributed system)是建立在网络之上的软件系统。正是因为软件的特性,所以分布式系统具有高度的内聚性和透明性。因此,网络和分布式系统之间的区别更多的在于高层软件(特别是操作系统),而不是硬件。内聚性是指每一个数据库分布节点高度自治,有本地的数据库管理系统。透明性是指每一个数据库分布节点对用户的应用来说都是透明的,看不出是本地还是远程。在分布式数据库系统中,用户感觉不到数...

Java666999的博客 2360

(六)使用Ansible搭建分布式大数据基础环境-Hadoop高可用集群搭建

“使用Ansible搭建分布式大数据基础环境”系列文章完整包含了如何使用Ansible这一分布式运维利器,来帮我们快速搭建Hadoop2/Spark2/Hive2/ZooKeeper3/Flink1.7/ElasticSearch5等一整套大数据解决方案。本篇是系列文章的第六篇。更多后续文章敬请关注后续文章。

workwithwebis3w的专栏 2508

Ubuntu下搭建Hadoop分布式集群

应学校课程要求,这学期学习到了云计算与大数据,这次实验就是让我们在ubuntu中配置好hadoop分布式集群,这两天就从网上一边各种搜寻教程结合课本(课本上是使用的centos,而且版本较老,不太适用)一边自己动手做,顺便自己也写一篇教程记录一下,其中也包含一些遇到的问题及解决方法。因为第一次接触到这方面所以有很多不足的地方,见谅,我只能做到尽量详细 在搭建的过程中,发现几篇写得很详细且文章排版清晰的博客,可供参考一下: https://blog.youkuaiyun.com/zyw2002/article/detai

xk1835217729的博客 3万+

管道机器人手臂机械结构设计cad【8张】+三维图+设计说明书+绛重

履带式管道机器人适用于各种管道环境,包括直管道、弯曲管道、水平管道、垂直管道等,其灵活性和适应性使得它可以应对不同形状和尺寸的管道,完成全面的检测和维护工作。管道机器人研究具有重要的现实意义和深远的社会影响,通过提高工作效率、降低人员风险、提升服务质量、节约成本资源和促进科技创新等方面的作用,为现代工程技术领域的发展和进步做出了积极的贡献。管道机器人是一种能够在管道内部执行各种任务的智能机器人,而管道机器人的机械臂对于管道机器人在管道内执行任务的灵活性、稳定性和效率至关重要。

kejigongjiang的博客 943

Hadoop分布式集群搭建教程

本篇博客主要讲解如何在Linux虚拟机上搭建Hadoop的分布式集群

n04j04h06的博客 1855

Numpy快速入门(np)!看这一篇就够了

Numpy快速入门(np)!看这一篇就够了

weixin_74009895的博客 2679

ABAP FB05 清账实战:POSTING_INTERFACE_CLEARING 核心参数与业务场景解析

本文深入解析ABAP FB05清账操作中的核心函数POSTING_INTERFACE_CLEARING,详细讲解其关键参数与业务场景应用。通过实战案例展示收款清账(EINGZAHL)流程,提供常见错误排查方法,并分享批量清账优化与财务凭证集成的高级技巧,帮助开发者高效处理SAP财务模块清账需求。

weixin_33423874的博客 475

CDH大数据平台搭建之HADOOP分布式集群搭建

CHD大数据平台搭建之HADOOP安装一、什么是HADOOP?二、如何下载1.官网下载2.网盘下载三、搭建集群1.准备5台虚拟机2.安装JDK3.安装ZOOKEEPER4.集群规划5.安装HADOOP6.修改配置文件1、进入配置文件目录:2、修改env文件3、修改core-site.xml文件4、修改hdfs-site.xml文件5、配置mapred-site.xml文件6、修改yarn-site.xml文件7、修改slaves文件8、分发文件9、配置环境变量四、启动集群1.启动ZOOKEEPER集群2.启

qq_41924766的博客 4834

从亚稳态到稳定传输:深入解析CDC跨时钟域同步的核心技术与设计实践

本文深入解析了CDC(跨时钟域同步)技术的核心问题与解决方案,重点探讨了亚稳态现象及其危害,详细介绍了同步器设计、MTBF计算方法以及单bit和多bit信号同步的实战技巧。通过Verilog代码示例和工程实践案例,帮助读者掌握从亚稳态到稳定传输的关键技术,提升数字电路设计的可靠性。

weixin_32822843的博客 247

搭建Hadoop分布式集群

Hadoop框架是采用Java语言编写,需要java环境(jvm) JDK版本:JDK8版本 ,本次使用的是 Java: jdk-8u431-linux-x64.tar.gz三台Linux虚拟节点: CentOS-7-x86_64-DVD-2009.iso通过虚拟机设置共享文件夹将需要的安装包复制到linux虚拟机中。

不积跬步,无以至千里;不积小流,无以成江海。 1577

YOLO11涨点优化:小目标检测 | 多头检测器提升小目标检测精度

引入多头检测器助力YOLO11,添加一个微小物体的检测头暴力提升小目标检测性能

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 4742

WordPress插件depicter存在SQL注入漏洞(CVE-2025-2011)

Depicter 是一款功能强大的 WordPress 幻灯片插件,允许用户通过直观的拖放编辑器轻松创建响应式滑块、轮播和动态内容展示。该插件提供丰富的模板库、动画效果和图层控制,支持多媒体内容嵌入(如图片、视频、HTML),并优化了移动端显示和SEO性能。其无代码操作界面适合非技术用户,同时提供高级自定义选项,适用于产品展示、营销推广和视觉叙事等多种场景,是提升网站视觉吸引力的高效工具。

m0_50125527的博客 552

Hadoop 分布式集群搭建

Hadoop 分布式集群搭建

slb190623的博客 2494

【Unity小游戏】整整一个周末写一款《皇室战争 玩法》 的 即时战斗类 游戏Demo。两万多字游戏制作过程+解析

Unity游戏制作,本篇文章介绍了复刻皇室战争玩法的一个自制小游戏,共有该游戏的两万字教程加制作过程,欢迎品尝! 世界上没有绝对的公平,如果我们起点就比别人第一步,那就更需要比别人努力了。

努力前行,总会成为自己心中的那道光 12万+

Zookeeper和Hadoop分布式集群搭建

Zookeeper和Hadoop分布式集群搭建 用三台虚拟机搭建如上集群 Zookeeper下载地址: https://www.apache.org/dyn/closer.lua/zookeeper/zookeeper-3.5.8/apache-zookeeper-3.5.8-bin.tar.gz Hadoop下载地址: https://archive.apache.org/dist/hadoop/common/hadoop-3.1.3/ 环境配置:JDK1.8+Zookeeper3.5.8+hadoo

weixin_44468025的博客 1908

lammps教程:ovito免费输出高清图片方法

基本原理是调用ovito软件包中的TachyonRenderer模块,该模块可实现Tachyon渲染,达到和ovito 2.9 Tachyon完全相同的效果。这种方法在后来的ovito版本中已经不能使用,但是ovito 2.9版本在后处理方面功能较少,使用起来也不是特别方便。在之前的推文中,曾介绍过使用ovito 2.9版本更换Tachyon渲染器实现高清图片的输出。这个方法只需要配置ovito模块即可,完全免费,不需要购买ovito pro版。具体的配置参数可到ovito官网查询。大家好,我是小马老师。

lammps_jiayou的博客 2766

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

从零开始搭建Hadoop HDFS分布式集群

传统的数据存储方案,如关系型数据库和单机文件系统,在面对PB级别的非结构化数据时,早已力不从心。它将一个巨大的文件切分成若干个固定大小的数据块(Block,默认为128MB),并将这些数据块以多副本(默认为3份)的形式分布式地存储在整个集群的普通商用服务器上。通过将计算任务(如MapReduce)调度到数据所在的节点进行计算,极大地减少了网络传输开销,实现了数据本地化,从而提供了极高的数据吞吐率。

xiaolin030的博客 1910

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

hadoop和spark分布式集群搭建及运用

hadoop和spark分布式集群搭建及简单运用 hadoop和spark分布式集群搭建及简单运用 1Hadoop集群部署 1-1Hadoop简介 1-2 环境及软件说明 1-2-1 虚拟机软件 1-2-2 JDK 1-2-3 Xshell 1-2-4 hadoop安装包 1-3 配置基础环境 1-3-1固定IP地址 1-3-2 安装配置JAVA环境 1-3-3 修改Hostnam

qq_22583741的博客 3727

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

实验一:Hadoop集群搭建

Hadoop是一个由Apache基金会所开发的分布式系统基础架构。用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力进行高速运算和存储。Hadoop实现了一个分布式文件系统( Distributed File System),其中一个组件是HDFS。HDFS有高容错性的特点,并且设计用来部署在低廉的(low-cost)硬件上;而且它提供高吞吐量(high throughput)来访问应用程序的数据,适合那些有着超大数据集(large data set)的应用程序。

Linyer的博客 7285

搭建Hadoop集群

实验二搭建Hadoop集群 1实验目的 搭建Hadoop集群; 掌握Linux分发; 掌握Hadoop启动和关闭。 2实验内容 搭建Hadoop集群,配置etc/下的配置文件,设置主从节点,设置Hadoop环境变量,分发到其他电脑,运行hdfs和yarn,启动namenode、datanode。 3 实验知识点 Hadoop配置文件修改; 主从节点设置; 环境变量配置; 分发; 格式化namenode文件夹。 启动集群 4实验时长 8学时。 5实验环境 VMw...

m0_62670963的博客 4837

搭建hadoop分布式集群教程

注意:安装Hadoop分布式集群时,所克隆使用的虚拟机必须为单数台。过程中电脑插网线或者连接热点。一、快速克隆和配置虚拟机1、克隆出三台虚拟机bigdata112、113和114。2、配置虚拟机的IP地址,确保它们分别绑定到192.168.137.72、192.168.137.73和192.168.137.74,以避免IP冲突。3、将主机名分别更改为bigdata112、bigdata113和bigdata114,确保每个虚拟机能够根据其主机名进行识别。4、使用MobaXterm,连接到3台虚拟机。

m0_64006904的博客 974
上一篇: hadoop 学习(五) 配置历史服务器和日志聚集
下一篇: 封装rsynx脚本
cheqiang4607
博客等级 码龄10年 1粉丝 0原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值