


解决方案
数据集成(canal、kafka、filebeat) -数据处理(flink)-数据服务-离线处理-数据应用
flink(关联 hologress 维表)+maxcompute+hologres(代替 hbase)
maxcompute:
规模,安全,业务效能
发展:基于 hadoop-基于云服务器的 CDW-基于云原生 saas(slowflake、maxcompute、bigquery)
serverless 架构是最佳方案
大数据计算服务 naxcompute :开箱即用(云数据仓库)(计算引擎 mapreduce)
阿里云-控制台-maxcompute-region 设置-创建项目-test_001-一对一或一对二-创建 datawork s-创建 maxcompute-test0001-按量-2.0-创建
通过 dataworks-控制台-导航-dataworks-工作空间列表-region-创建工作空间-设置全区域唯一的名字-单环境-下一步-选择计算引擎 maxcompute-按量-名称-按量-创建
有编辑器-客户端-dataworks-idea 插件 maxcompute
安装odpscmd
安装java8
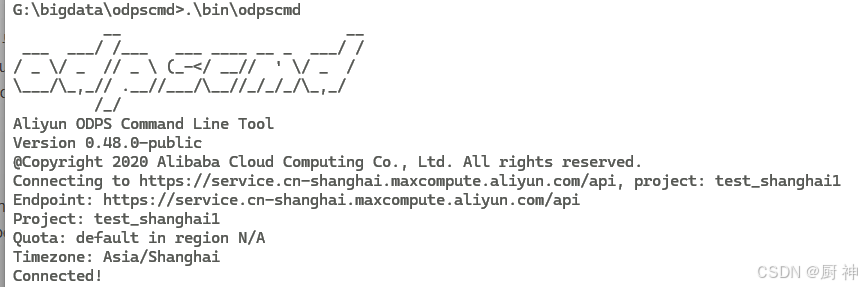
安装客户端-设置odps.conf.ini:access_id,access_key,end_point(maxcompute服务地址)-tunnel_endpoint=http://dt.odps.aliyu.com-log_view_host=http://logview.odps.ali.com-启动./bin/odpscmd
| 命令 | 作用 |
|---|---|
| show tables | 展示表 |
| create table a(name string) | 创建表 |
| odpscmd -e “show tables;” | 命令模式 |
| odpscmd -f test.txt | 文本运行 |
| odpscmd -s 脚本文件 | 脚本模式(代码嵌入式udf脚本 或 sql Function脚本) |
数据迁移
批量数据通道/流式数据通道/实时数据通道(dataHub)
tunnle客户端:批量+本地
maxCompute studio:批量+本地
dataWorks:批数据+阿里
MMA:hadoop集群到maxCompute
Java SDK:基于tunnle SDK,定制化数据迁移
流式:dataHub(FLUME、FLuentd、LogStash、OGG(oracle数据增量到datahub到maxcompute))
数据迁移
- tunnel命令上传下载
- tunnel SDK上传下载
- MMA迁移工具上传数据
- 其他
tunnle 命令
| 命令 | 作用 |
|---|---|
| tunnel help 【upload/download/upsert/resume/show/purge/help】 【path】 <[project.]table[/partition]> | 帮助 |
| tunnel upload 【acp自动创建表目录/dbr丢掉脏数据/fd指定列分隔符/c指定字符集】 | 上传 |
| tunnel help download 【cn指定下载列名称/limit下载记录数量/h是否包含列名信息(默认不包含)】 【project.table/partition】 【路径】 | 下载 |
tunnel SDK主要接口
- table tunnel
- uploadSession/downloadSession
- instanceTunnel
- TunnelBufferedWriter
流程:创建阿里账号 - 创建表通道- 创建上传会话- 读取文件 - 写入记录 - 上传会话提交
//阿里云账号
Account account=new AliyunAccount(accessID,accessKey)
Odps odps=new Odps(account);
odps.setEndpoint(odpsUrl)
odps.setDefaultProject(project)
try{


//表通道
TableTunnel tunnel=new TableTunnel(odps)
tunnel.setEndpoint(tunnelUrl);
PartitionSpec partitionSpec=new PartitionSpec(partition);
//上传会话
UploadSession uploadSession=tunnel.createUploadSession(project,table,partitionSpec);
TableSchema schema=uploadSession.getSchema();
//获取writer对象写入数据
RecordWriter recordWriter=uploadSession.openRecordWriter(0)
Record record=uploadSession.newRecord();
for(int i=0;i<schema.getColumns().size();i++){


	//设置record里每列的数据类型
}
//写入文件
for(int i=0;i<10;i++){


	recordWriter.write(record);
}
recordWriter.close();
//提交,开写
uploadSession.commit(new Long[]{

   }0L);
}
流程:创建阿里账号 - 创建表通道- 创建下载会话- 读取记录 - 写入文件
//阿里云账号
Account account=new AliyunAccount(accessID,accessKey)
Odps odps=new Odps(account);
odps.setEndpoint(odpsUrl)
odps.setDefaultProject(project)
try{


//表通道
TableTunnel tunnel=new TableTunnel(odps)
tunnel.setEndpoint(tunnelUrl);
PartitionSpec partitionSpec=new PartitionSpec(partition);
//下载会话
DownloadSession downloadSession=tunnel.createDownloadSession(project,table,partitionSpec);
long count=downloadSession.getRecordCount();
//获取数据
RecordReader recordReader=uploadSession.openRecordReader(0,count)
Record record;
while((record=recordReader.read()!=null)){


	consumeRecord(record,downloadSession.getSchema());
}
recordReader.close()
}
MMA迁移上传数据
MMA是一款MaxCompute数据迁移工具,支持Hive和OSS数据。
UDTF—MMAclient—MMAServer—Task Scheduler—Task Runner—ODPS SDK—MAxcompute–HiveSDK—HiveServer
1.确定hive版本hive -version下载mma-0.1.1 hive-1/2/3.x.zip
2.curl <Maxcompute endpoint>确认hive集群各个接电脑具备访问Maxcompute能力
3.hive开启hiveserver2和metasrote服务
4.确认maxcompute已配置2.0数据类型
| 命令 | 含义 |
|---|---|
| configure | 配置引导工具 |
| gen-job-conf | 生成任务配置工具 |
| mma-client | 客户端命令行工具 |
| mma-server | 服务端命令行工具 |
| sql-checker | SQL兼容性检查 |
-
hive配置
- metasroteURI
thrift://localhost:9083 - JDBC connection string
jdbc:hive2://localhost:10000 - JDBC用户名
xxx - JDBC连接密码
xxxx
- metasroteURI
-
hive安全配置(直接n即可,可选)
- jams-gss.conf 文件路径
- krbs.conf文件路径
- Kerberosprincipal属性
- kerberos keytab文件路径
-
maxcompute参数
- maxcompute endpoint
http://service.cn-shanghai.maxcompute.aliuyn.com/api - maxcompute项目名
- accesskey id
- accesskey secret
最后生成json格式配置文件
- maxcompute endpoint
创建Hive函数:
需要有对应jar包:MMAHOME/res/data−transfer−hive−udtf−{MMA_HOME}/res/data-transfer-hive-udtf-MMAHOME/res/data−transfer−hive−udtf−{}下有jar包
hdfs dfs -put <jar包> hdfs:///tmp/
使用beeline创建Hive函数
drop function if exists default.odps_data_dump_multi;
create function default.odps_data_dump_multi as 'com.aliyun.odps.mma.io.McDataTransmissionUDTF' using jar 'hdfs:///tmp/data-transfer-hive-${}'
启动MMA Server:
$MMA_HOME/bin/mma-server即可启动
生成任务配置:
- 表级别
-进入conf的table_mapping.txt文件:source_cata.source_table1:dest_pjt.dest_table1- 执行./gen-job-conf --objecttype TABLE --tablemapping …/conf/table_mapping.txt
- 可编辑上述文件,添加分区属性
- 库级别 -整库迁移
- ./gen-job-conf -objecttype CATALOG --sourcecatalog [sourcecatalog_name] --destcatalog [destcatalog_name]
提交迁移任务:
- 向mmaserver提交迁移任务
./mma-client --action SunmitJOb --conf [] - 查看状态
./mma-client --action GetJobInfo --jobid [id] - 查看任务列表 :ListJObs
- 删除 : DeleteJob --jobid [jobid]
- 重置:RestJob --jobid [jobid]
其他工具
MaxCompute Setdio数据导入
- 界面操作:选择表–import data into table
- tunnel 命令
Data Hub同步数据到MaxCompute
maxcompute建表–新建DataHub项目–新建Topic–向datahub topic写入数据–新建connector–确认同步结果
MaxComputeSQL
数据仓库工具,兼容大部分标准SQL,但不支持事务、主外键约束、索引等。作业准备提交耗时,实时性不高,适用于海量数据离线批量计算场景
- 数据类型:
- 基本数据类型
bigint、string、double、decimal、datetime、boolean(1,0)
int、smallint、varchar、float(2,0) - 复杂数据类型
array、map、sruct(2,0)
使用2.0新增数据类型:
- 基本数据类型
set odps.sql.type.system.odps2=true
set odps.sql.decimal.odps2=true
使用hive兼容版本数据类型:
set odps.sql.type.system.odps2=true;
set odps.sql.decimal.odps2.true;
set odps.sql.hive.compatible=true;
隐式转换:无需干预
显示转换:cast转换
运算符:
关系运算符:
> <>= <= = <> is null, is not null .like, rlike(% _),in, between and
关系运算符:+ - * / %
逻辑运算符 :and or not
位运算符:& | ||
DDL语句
创建删除表、生命周期管理、分区增删改合并、修改表属性、视图操作、其他
建表:
create [external] table [if not exists] <表名>
([字段名 字段类型 [not null] [default 默认值] [comment 注释]])
partitioned by (字段名 字段类型 [comment 注释],...) --分区表
clustered by |range clustered by (字段名,...)--分桶表
sorted by (字段名 [asc|desc],...) into [几个桶] buckets
[tblproperties("transactional"="true")] --指定为transactional(事务)表,设置表属性
[lifecycle 日期] --生命周期,默认永久
查看表信息
desc [extended更详细] 表名;
查看建表语句
show create table 表名;
删除表
drop table [if exists] 表名;
添加分区
alter table 表名 add 

 968


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


