400 行代码手搓最简 GPT,大模型就是这样玩的!

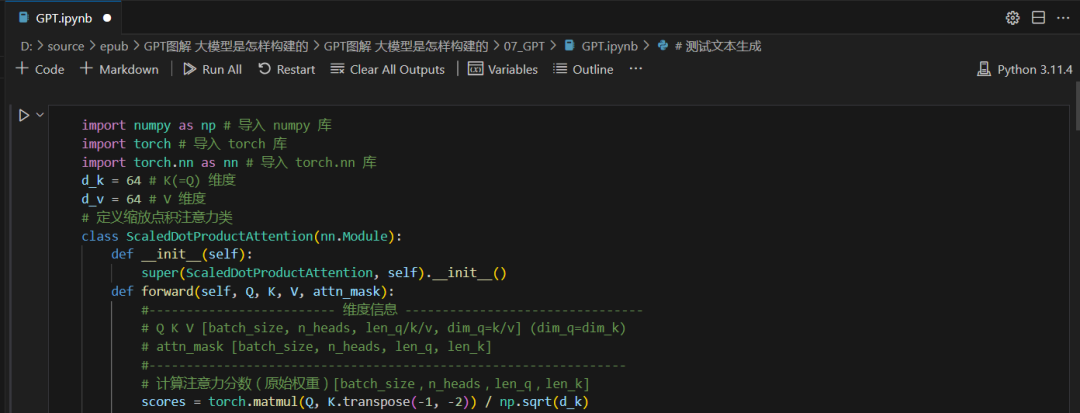
手搓GPT2模型:以一个文本生成器为例 token embedding + position embedding ——dropout——transformer block——LayerNorm——输出头(将embedding维的数据转化vocabulary维的数据) 阅读详情

01

怎样手搓一个最简GPT

学习 GPT 的方式是什么?

借用 Linus 大神的那句名言“talk is cheap, show me the code”,没有什么比手搓一个 GPT 出来更适合的了。

有的同学可能会被吓到,人家花了几百亿美刀整出来的成果,说搓就能搓出来吗?其实我们的目标是写一个最简 GPT,从根本上去理解 GPT 技术。就像当初最早发布的 Linux 内核也就是两万行代码,但 Linux 核心架构是延续至今的。

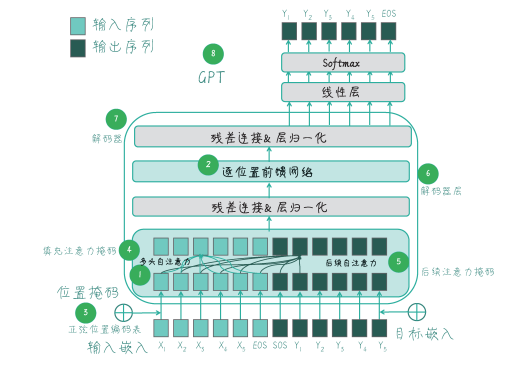
其实,只要实现 8 个核心组件,仅用400 行代码就可以得到一个“麻雀虽小,五脏俱全”的 GPT 了。
aa00e9cd7ec487ffd33f549d828130da.png

GPT关键组件

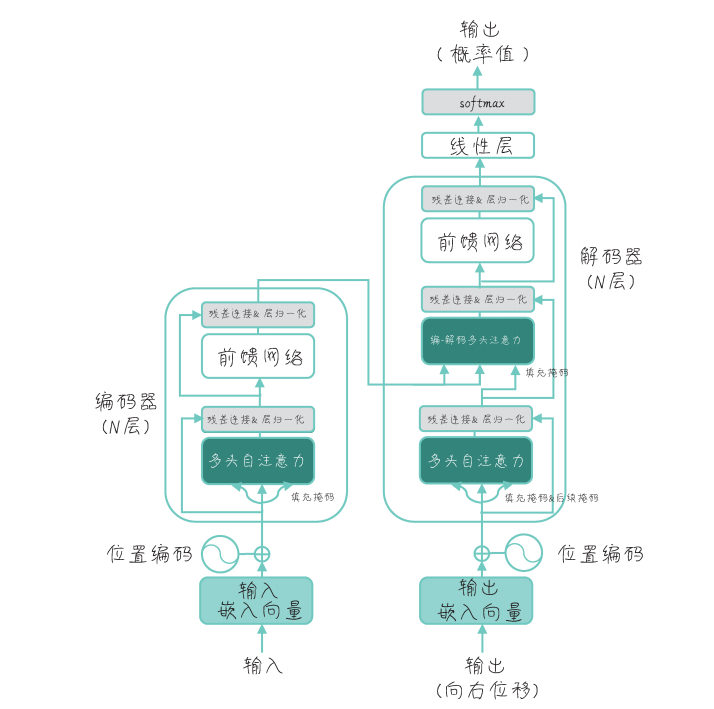
在动手之前,我们先了解一些基本概念。GPT 是基于 Transformer 架构的自然语言处理模型,而 Transformer 的核心是自注意力机制,它能够为输入序列中的每个元素分配不同的权重,从而更好地捕捉序列内部的依赖关系。
990cd73f1cd20c43f0dd4905542a0eca.png

Transformer 架构

GPT 是从左向右训练的单向模型,它只使用 Transformer 的解码器架构,具有自回归的特点。在训练过程中,GPT 模型通过后续注意力掩码,确保每个位置只能看到当前位置之前的信息,这使得 GPT 特别适合生成式任务,例如文本分类、问答系统等。

知道了 GPT 的原理,我们先来搞定 GPT 开发环境。

02

搭建 GPT 开发环境

本次实验环境,操作系统选择的是 Debian Linux,编程语言是 Python 3.x。同学们也可以根据自己的环境选择合适的工具,比如Windows、MacOS或者其他 Linux 发行版,开发工具可以用 PyCharm、VSCode 等。

在这个最简 GPT 工程中,需要依赖 numpy 和 PyTorch 库,我们可以用 pip 工具进行安装,pip 会自动依次安装相关依赖库。

pip install numpy

pip install torch
9b92ce58726029388c775d8aa65124a4.png

NumPy(Numerical Python)是 Python 中最基础和最重要的科学计算库,它为处理大规模数据和高效的数值计算提供了强大的支持。在本工程中会用到 NumPy的一些数学计算功能。

PyTorch 是一个基于 Python 的科学计算库,它主要是为了解决深度学习任务而设计的。PyTorch 采用动态计算图的方式,可以灵活地构建复杂计算图,同时支持动态图和静态图两种方式。它还允许用户自由组合各种神经网络层,从而实现定制化的模型结构。

在最简 GPT 工程中使用 torch.nn 模块构建神经网络模型,它提供了丰富的类和函数,方便用户定义、训练和评估神经网络模型。通过使用torch.nn,用户可以快速搭建各种复杂的神经网络结构,实现深度学习任务。

另外,我们还使用torch.optim模块来优化算法,它为用户提供了各种常见的优化器,并封装了参数更新和学习率调整等功能,方便用户进行深度学习模型的训练和优化过程。

开发环境准备好了,让我们开始手搓最简 GPT。

03

最简 GPT 开发过程

最简 GPT 工程的结构可以分为三个部分,分别是 GPT 模型、构建语料库与训练模型、生成文本。

GPT 模型

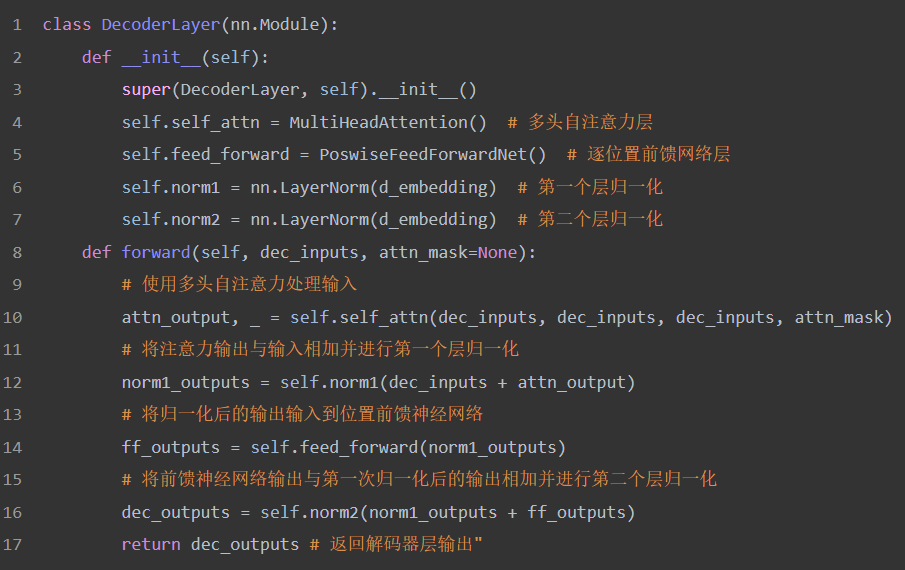
构成 GPT 模型的 8 个组件分别是多头自注意力、逐位置前馈网络、正弦位置编码表、填充掩码、后续掩码、解码器层、解码器、GPT。其中前五个组件构成 Transformer 解码器,我们重点对解码器层代码进行解读。
5a81bac6115e1eb21854b28d7e5a3d4e.png

GPT 解码器层包含一个多头自注意力层 MultiHeadAttention 和一个逐位置前馈网络层 PosFeedForwardNet,后面接了两个层归一化 nn.LayerNorm。

第一个层归一化 norm1:在多头自注意力 self_attn 处理后,将注意力输出 attn_output 与原始输入 dec_inputs 相加。这种加和操作实现了残差连接,可以加速梯度反向传播,有助于训练深层网络。

第二个层归一化 norm2:在逐位置前馈网络 feed_forward 处理后,将前馈神经网络输出 ff_outputs 与第一个层归一化输出 norm1_outputs 相加。这可以实现标准化输入数据,提高训练稳定性。

构建语料库与训练模型

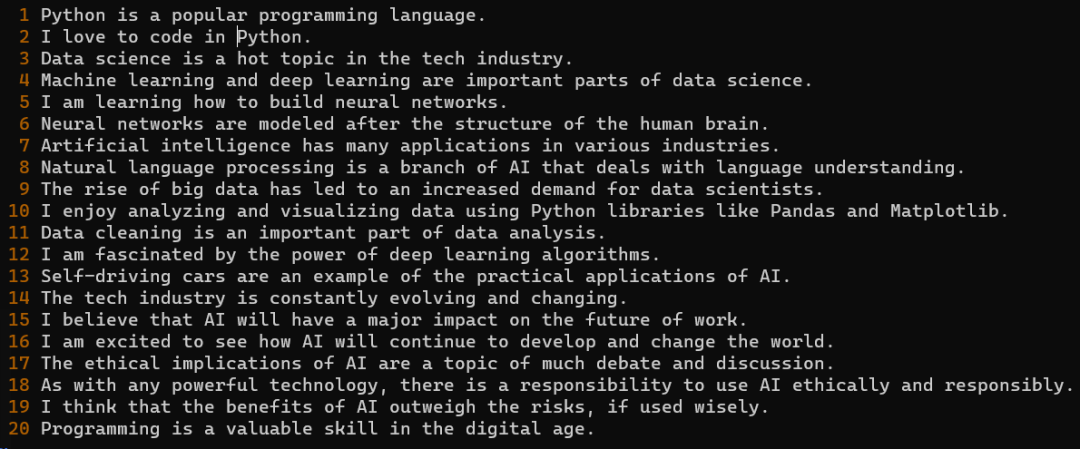
为训练模型准备一段原始文本,如下图所示。虽然篇幅不长,但足以演示最简 GPT 的核心功能。
c0f5d4f11d58160e0bb33faa3f204ca8.png

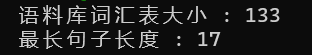
这段文本的分析结果如下图所示。

0091607274b6b32331f2e6e882f66d76.png

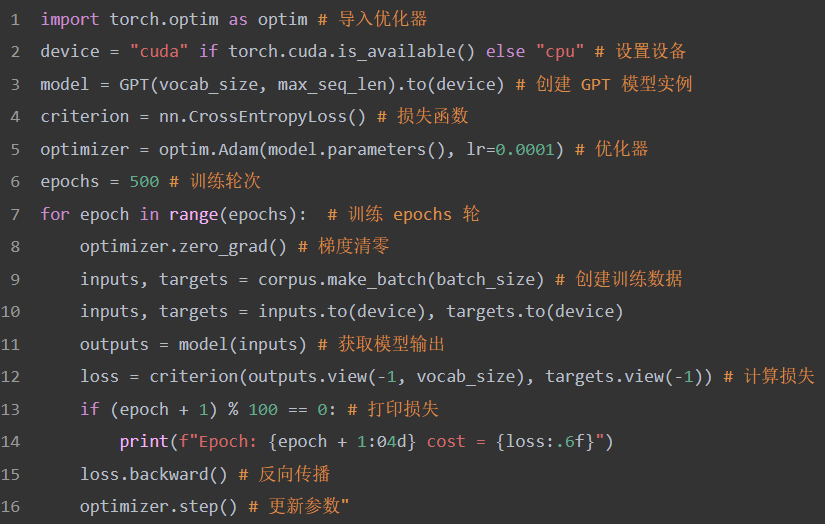
接下来是对原始文本进行训练,代码如下:

6c9ad4b4f06bd9ce2818bb5dc77f141d.png

训练数据由给定的输入句子构成,这些句子已经被编码为数字表示。在每个训练批次中,模型的输入是当前单词序列,而目标输出是该序列中每个单词的下一个单词。

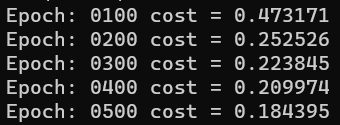
为了计算损失,模型预测下一个单词的概率分布,然后使用交叉熵损失函数比较这些预测概率和实际目标单词。代码会依据主机配置而自主选择 GPU 或 CPU 进行计算,训练时间在数分钟左右:
4efb745073f0e1a4149f57d803b306f1.png

生成文本

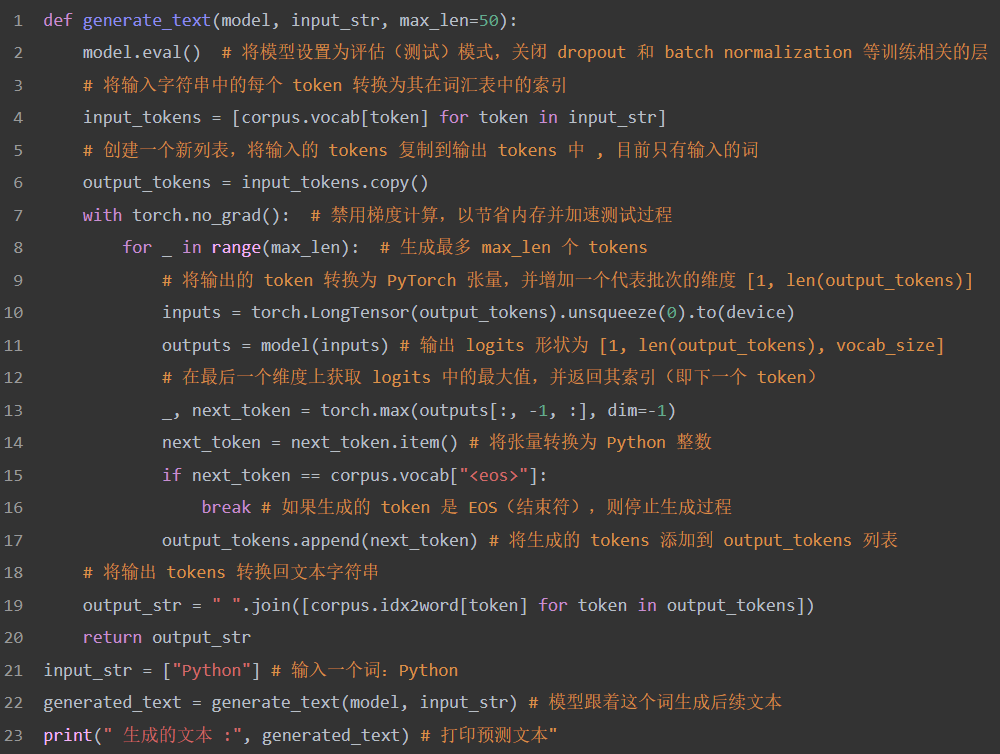
以下代码就是使用训练好的模型来生成文本,运行之后可以看到对每一个生成的词进行贪婪搜索的结果:
ac3fbbc653e1f09967bebe85ad8a3ee6.png

运行结果:

a37af2d2d9f3e078a23b67db59263e5e.png

首先,代码将输入字符串转换为一个单词索引列表 input_tokens,然后将这些输入的 token 作为初始生成的文本 output_tokens。接着,函数进入循环,将逐个生成新的 token,直到达到最大长度 max_len 或者遇到句子结束标志。

至此,手搓 GPT 大功告成,同学们还可以对上述代码进行调整。例如,将模型保存到磁盘上,以便反复加载使用;使用更丰富的语料来训练模型等。

最简 GPT 工程的 400 行完整代码全在《GPT 图解:大模型是怎样构建的》这本书中,书中对GPT 的8 个组件有非常细致的说明。

这是一本特别有趣的书,看着故事就把 GPT 学会了,让我们来具体了解一下。

04

弄懂大模型的那些事儿

《GPT 图解:大模型是怎样构建的》从 NLP 技术的发展脉络梳理,讲述了 N-Gram、词袋模型(BoW)、Word2Vec(W2V)、神经概率语言模型(NPLM)、循环神经网络(RNN)、Seq2Seq(S2S)、注意力机制、Transformer,以及从初代 GPT 到 ChatGPT 再到 GPT-4 等一系列突破性技术的诞生与演进。

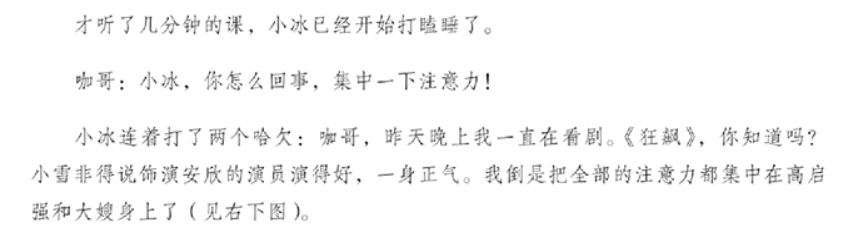
本书最大的特点是通过两位虚拟人物“咖哥”和“小冰”的对话来展开技术讨论,将枯燥的技术细节化作轻松幽默的故事和缤纷多彩的图画,引领读者穿梭于不同时空,见证自然语言处理技术的传承、演进与蜕变。
c783370cbdfea090caad0f39c5fc85ec.png

43498d917c3465c29b5c6d7e8848cd9d.png

本书作者黄佳,笔名就是“咖哥”,他目前是新加坡科技研究局人工智能研究员,主攻方向为 NLP 大模型的研发与应用。咖哥在 AI 领域深耕多年,在政府、银行、医疗等多个行业有丰富的 AI 实践经验。

咖哥同时还是《零基础学机器学习》《数据分析咖哥十话》等畅销书的作者。在他的笔下,技术褪去了神秘的面纱,读者在轻松的阅读体验中,自然就将技术学以致用。

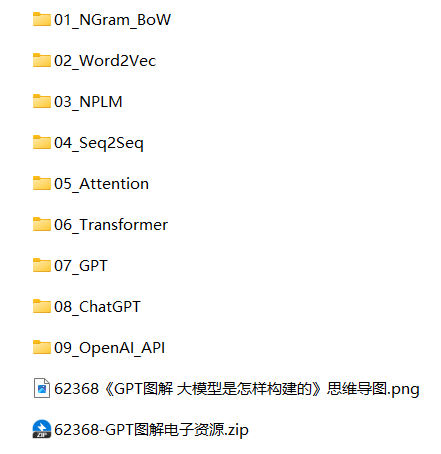
配套资源丰富是本书另一大特色,咖哥精心编写每一章的示例代码,并编排为 Python notebook 文件。读者可以在 notebook 的交互式环境中轻松运行调试代码,观察输出结果。
339664f16246071b9e54fd62f098b38b.png

在线下载页面

093de3b366024b249880bbfd0eeac946.png

各章节代码目录

d364dcd97cb83ae8544c7852658f1ee6.png

在 VSCode 中运行调试 Python notebook 工程

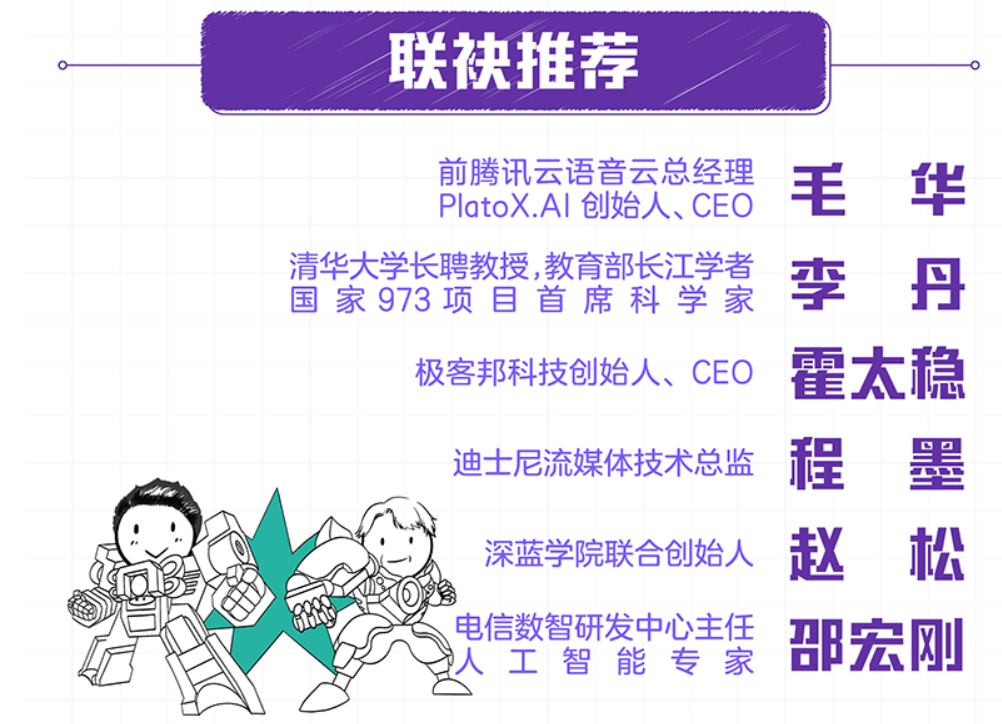
咖哥这部力作也得到了业界的广泛认可,多位大佬联袂推荐此书。
4f3916fb0afc5df7abc7a48ba879b190.png

看懂《GPT 图解:大模型是怎样构建的》,深入理解大模型原理,不要说手搓 GPT,在大模型的任何领域,同学们也都可以游刃有余,这才是 AI 时代应当具备的核心竞争力!
fa92e3e5b9d1445671b089cae7d2600a.png

▼点击下方即可购书,限时特惠

5折

多模态大模型革新UI自动化测试:从400行断言到85行智能验证 UI自动化测试是保障软件质量的关键环节,其核心原理是通过脚本模拟用户操作并对界面元素进行验证。传统方法依赖于与DOM结构强耦合的定位器和精确的属性断言,导致测试脚本脆弱、维护成本高昂,难以应对频繁的UI迭代和动态内容。多模态大模型(MLLM)的出现带来了技术范式的转变,它融合了计算机视觉与自然语言处理能力,能够理解界面语义并进行视觉推理。这项技术的核心价值在于,它将测试验证从“代码指令”升级为“自然语言需求”,使测试脚本具备了对“用户感知”层面的理解能力,显著提升了测试的鲁棒性和可维护性。在应用场景上,它特 阅读详情

相关推荐

基于多模态大模型的UI自动化测试:从400行断言到85行智能验证

UI自动化测试是软件质量保障的关键环节,传统方法依赖大量硬编码的断言(Assertion)来验证页面元素,导致测试脚本脆弱且维护成本高昂。其原理是通过选择器定位元素并检查属性,但无法理解页面整体状态和语义。随着多模态大模型技术的发展,测试范式正从“代码断言”转向“意图验证”。这项技术的核心价值在于,利用大模型的视觉-语言理解能力,让测试脚本能像人一样“看”页面并做出判断,从而大幅提升测试的健壮性和可维护性。在实际应用场景中,结合Playwright等现代UI自动化框架,通过设计精准的提示词,可将繁琐的验证逻

weixin_42619742的博客 380

手搓GPT系列之 - 神经网络模型基础知识,教你5分钟实现一个手写体识别神经网络

​2023年了nlp还存不存在我不知道,数学家的思想真的有意思。介绍了线性回归分类器和softmax分类器,并证明了softmax分类器是由线性回归分类器并联而成的。本文将介绍以LR模型为基础的另一个分类器:神经网络。我们将介绍神经网络模型中的一些核心概念和训练过程,并介绍神经网络模型与LR模型及softmax模型的关系。可以帮助机器学习领域的初学者对神经网络模型建立一个基本的认知。

marlinlm的博客 1259

开源王者!全球最强的开源大模型Llama3发布!15万亿数据集训练,最高4000亿参数,数学评测超过GPT-4,全球第二!

官方透露的信息非常多,Llama3系列是目前为止最强的开源大语言模型,未来还有4000亿参数版本,支持多模态、超长上下文、多国语言!Llama3系列模型是MetaAI开源的第三代大语言模型,本次发布的包含2个不同参数规模的版本,一个是80亿参数的LLama3-8B,另一个是700亿参数规模的Llama3-70B。这个分数仅次于Claude3-Opus的95分,超过GPT-4,全球第二,是目前开源大模型中得分最高的一个。其中的代码数据集高4倍!需要注意的是,这里的4000亿参数版本正在训练中,还没完成。

DataLearnerAI 2100

本科生60行代码教你手搓GPT大模型,技术介绍堪比教程

这一章节主要介绍了如何设置编码器、超参数以及参数。你要做的,首先是克隆代码库:然后安装依赖项:注意,如果你使用的是 M1 Macbook,在运行 pip install 之前,你需要在 requirements.txt 中将 tensorflow 更改为 tensorflow-macos。在这个项目下,文件包括 encoder.py、utils.py、gpt2.py、gpt2_pico.py:

qq_46094651的博客 1225

手撸大模型API调用:10行代码打通Agent开发第一关

大模型API调用是构建智能体(Agent)最基础的技术环节,其本质是遵循RESTful规范的HTTP请求与JSON响应解析过程。理解请求头认证、消息结构约束、状态码校验及token计费机制,是掌握Agent底层通信原理的关键。该能力直接支撑模型选型(如OpenAI、DeepSeek)、错误排查(401/400/429)、成本控制与跨平台适配等工程实践。本文聚焦裸写requests调用,不依赖LangChain等框架,通过最小可行代码示例,还原从环境配置、请求构造到结果提取的完整链路,帮助开发者建立对大模型服

weixin_34406086的博客 374

xenomai内核解析--嵌入式实时linux概述

Linux系统作为一个GPOS(通用操作系统)发展至今已经非常成熟可靠了,并且由于遵循GPL协议,开放所有系统源代码,非常易于裁剪。更重要的是,与其他开源的GPOS或RTOS相比,Linux系统支持多种处理器、开发板,提供多种软件开发工具,同时Linux系统对网络和图形界面的支持非常出色。显然,选择Linux操作系统在产品的开发周期和成本控制方面都有巨大优势。 虽然Linux系统功能强大、实用性强...

wsg1100 3700

手搓GPT系列之 - chatgpt + langchain 实现一个书本解读机器人

本文将给大家介绍一款基于大模型的应用框架:langchain。langchain集成了做一个基于大模型应用所需的一切。熟悉java web应用的同学们应该十分熟悉spring boot框架,我们可以说langchain 就是大语言模型应用方面的spring boot。本文将为大语言模型应用的开发者们提供一个基于langchain的示例项目,便于大家进一步提升prompt engineering的效能。

marlinlm的博客 6974

ROS2理论与实践_宇树机器人Go2开发指南(文字)

本文介绍了Unitree Go2机器人ROS2开发环境的安装与配置流程。主要内容包括:1)从GitHub克隆unitree_ros2仓库;2)安装ROS2 Foxy版本依赖项;3)编译特定版本的CycloneDDS(0.10.2);4)编译unitree_go和unitree_api功能包;5)网络配置,包括设置静态IP和修改环境变量脚本setup.sh以指定网络接口。文章还提供了本地回环测试的替代方案,并建议配置完成后重启电脑。整个流程涉及ROS2环境切换、网络适配和编译安装等多个技术环节。

Li_Dongyi的博客 4205

手搓大模型!实现简单的大模型核心组件,注意力机制原理与实现详解,收藏这一篇就够了!!

本文详细介绍了大语言模型核心组件——注意力机制的工作原理与实现。首先解释了注意力机制如何解决长序列建模问题,特别是在翻译任务中的应用。然后深入探讨了自注意力机制的概念,包括注意力得分计算、softmax归一化和上下文向量生成。文章提供了从零实现简化自注意力机制的代码示例,展示了如何使用矩阵运算高效计算所有输入token之间的注意力权重,为后续构建完整LLM架构奠定基础。

2401_85325557的博客 1001

LEfSe分析避坑指南:如何解决R语言中的常见错误与优化结果可视化

本文提供了R语言中进行LEfSe(线性判别分析)微生物组差异分析的全流程避坑指南。详细解析了从数据格式准备、参数调优(如显著性水平与LDA阈值)、结果可靠性验证到使用ggplot2进行高级可视化的实战技巧,帮助用户规避常见错误,获得更稳健、美观的分析结果。

weixin_29098391的博客 361

告别手动发日报!用n8n+钉钉打造智能报告机器人(含模板下载)

本文详细介绍了如何利用n8n开源工作流自动化平台与钉钉机器人搭建智能日报系统,实现数据自动采集、处理和发送。通过实战步骤和模板下载,帮助用户告别手动处理日报的繁琐,提升工作效率和数据准确性。

h3i4j的博客 857

手搓一个GPT模型,惊了!

以前,一个大型互联网企业,研发团队动辄上千人。但是随着大数据和AIGC技术的来临,可能十几个人甚至几个人就能完成以前上百人组成的技术团队的工作。随着开源技术和云计算的快速发展,程序员的可替代性变高了。但有些东西是没法迭代和替代的,打开认知的局限,掌握最前沿的技术,拓展提升研发实力,在技术迭代的浪潮中,打不过就加入,成为一个参与者!想学习大模型的原理,但是不知道如何进入?你是否还对GPT的原理处于懵...

程序员小灰的博客 300

Linux下科大讯飞离线语音识别SDK从下载到实战(附常见问题解决)

本文详细介绍了在Linux系统下,如何从科大讯飞开放平台获取离线语音识别SDK,完成环境准备、编译部署到实战开发的完整流程。文章重点解析了SDK目录结构、语法词典定制、示例代码修改,并针对开发中常见的“词典加载失败”、音频格式、交叉编译及性能优化等问题提供了深度解决方案,助力嵌入式与IoT开发者快速实现稳定可靠的离线命令识别功能。

honey的博客 1241

历时400多天,国产大模型全面赶超GPT-4?

稍微留意下近期的新闻,“赶超GPT-4”正在成为国产大模型的新热点。百度文心一言、商汤日日新以及阿里云刚刚发布的通义千问2.5,均已迈入“全面赶超GPT-4”阵营。把时间线稍微拉长一些的话,过去大半年时间里,“超越GPT-4”的消息可谓屡见不鲜,即使在报道中刻意加上了多项基准、部分指标等前缀,依然赚足了眼球,成为国产大模型佐证自身能力的有力指标。简单做个复盘的话,国产大模型对GPT-4的追赶已经进行了400多天,其中“赶超进程”可以粗分为三个阶段。

xxue345678的博客 1342

lighttools用透镜旋转手动创建菲尼尔透镜

学过很多软件,都没有留下痕迹,很多年之后只记得学过的软件常用的一些功能,稍微难一些的再次用起需要重新学,但如果留下点痕迹,重新再用就会很快。lighttools无意之中接触了,记一点点笔记吧。...

kingsai2012的博客 4331

发那科机器人编程软件fanuc roboguide授权补丁_工业机器人离线编程与应用:ROBOGUIDE V8.3版本的工程文件创建...

欢迎关注我们ROBOGUIDE是发那科机器人公司提供的一个离线编程工具,可模拟现实中的机器人和周边设备的布局,通过虚拟TP示教来模拟机器人的运动轨迹,同时可以验证方案的可行性和准确的周期时间。ROBOGUIDE是一款核心应用软件,具体的还包括搬运、弧焊、喷涂等其他模块。以最新的8.3版本为例进行讲解,对于未注册的版本将有30天的免费使用期限。开始菜单击开始菜单中的HandingPRO启动程序,第一...

weixin_39791446的博客 2925

GPT-5来了!人人都能免费用,最强大模型只需最傻瓜式使用

全世界等了2年,**GPT-5**终于正式发布!

m0_59163425的博客 1154

【25届数字IC秋招总结】面试经验6——经纬恒润

25届数字ic面试记录——经纬恒润

lalala0635的博客 991

这本新书一定要入手,《大模型应用开发极简入门》!

AI 领域的技术更新速度相当快,几个月的变化相当于其他领域一年的更新了,一年多前给大家推荐过《大模型应用开发极简入门》这本书,那时候 ChatGPT 正是火爆的时候,人们对 AI 既好奇又焦虑;一年多后的今天,AI 技术逐步普及,大模型的格局也不再是 OpenAI 一家独大——国内的模型已跻身世界一流,再度掀起了 AI 技术的热潮。

2401_84204207的博客 730

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

你好 GPT-4o!

你好 GPT-4o!OpenAI公司宣布推出 GPT-4o,这是OpenAI的新旗舰模型,可以实时对音频、视觉和文本进行推理。GPT-4o(“o”代表“o​​mni”)是迈向更自然的人机交互的一步——它接受文本、音频、图像和视频的任意组合作为输入,并生成文本、音频和图像的任意组合输出。它可以在短至 232 毫秒的时间内响应音频输入,平均为 320 毫秒,与人类的响应时间相似(在新窗口中打开)在一次谈话中。

大模型与Agent智能体 2571

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

GPT-5-Codex深度评测:不涨价却更强,400k上下文如何改变编程工作流!

周末加班修一个老项目,翻着一堆历史代码,像在旧仓库里找丢失的钥匙。 看到 GPT-5-Codex 的消息,心里一动:也许这次真的能把长文档和复杂逻辑一次性吃下。 到底“更能打”的点在哪?咱们聊聊。

m0_74942241的博客 716

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

最强开源大模型Llama 3发布!最大版本是4000亿参数规模!性能直逼GPT-4!

当地时间4月18日,Meta 官宣发布其最新开源大模型 Llama 3。目前,Llama 3 已经开放了 80亿 和 700亿 两个小参数版本,上下文窗口为8K。未来还有4000亿参数版本,支持多模态、超长上下文、多国语言!

u012744245的博客 3324

【收藏】GPT-5.2来袭!OpenAI最新最强大模型全解析,程序员必学

OpenAI为应对谷歌Gemini系列竞争压力,发布迄今最强大的GPT-5.2模型,包含Instant、Thinking和Pro三个版本,性能较前代有巨大提升。API、Codex已更新,Cursor等第三方工具已支持。作者已将OpenAI产品切换至GPT-5.2,并计划测试其在编码任务上的表现,标志着AI模型竞争进入新阶段。

2401_84204207的博客 1213

从零手搓LLM:拆解斯坦福CS336大模型训练全流程

大模型已成为人工智能领域的重要方向,但调用API与真正理解模型内部机制之间仍存在巨大鸿沟。Transformer架构作为现代LLM的核心,其训练涉及数据清洗、分词器构建、注意力机制、预训练与部署等完整链路。掌握从零构建LLM的能力,不仅有助于深入理解Loss变化、过拟合等底层问题,还能为模型定制化训练与工程优化提供坚实基础。本文以斯坦福CS336课程为主线,梳理手搓大模型的真实路径,并给出基于PyTorch的最小可运行示例,帮助开发者在本地跑通从数据准备到文本生成的完整流程。

weixin_33922672的博客 494

裸写10行代码调用大模型API的实战避坑指南

大模型API调用是构建AI Agent的基础能力,其本质是遵循HTTP协议的网络请求过程,涉及认证、参数编码、响应解析等关键环节。理解RESTful API原理有助于定位400/401/429等常见错误,避免被高级框架遮蔽底层协议细节。技术价值在于掌握跨平台兼容性——适配OpenAI、DeepSeek、Ollama三类主流后端,解决如temperature类型不一致、Authorization头格式差异、messages结构要求不同等真实工程问题。典型应用场景包括Agent开发入门、产品快速验证、私有化部署

weixin_29047919的博客 168

DeepSeek带火AI大模型岗!急招岗年薪百万,人才缺口将达400万(附大模型教程)

正值年后跳槽高峰期,近期大火的国产AI大模型——DeepSeek发布的一系列高薪招聘信息在各大平台刷屏,阅读量上亿。

2301_81940605的博客 2702
上一篇: 大厂某团员工爆料:夫妻俩人每月到手6万多,公积金1.6万,竟然还压力山大......
下一篇: 75k,确实可以封神了!
菜鸟学Python
博客等级 码龄9年 8062粉丝 571原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值