Unified Multimodal Chain-of-Thought Reward Model through Reinforcement Fine-Tuning

在这里插入图片描述

一、文章主要内容总结

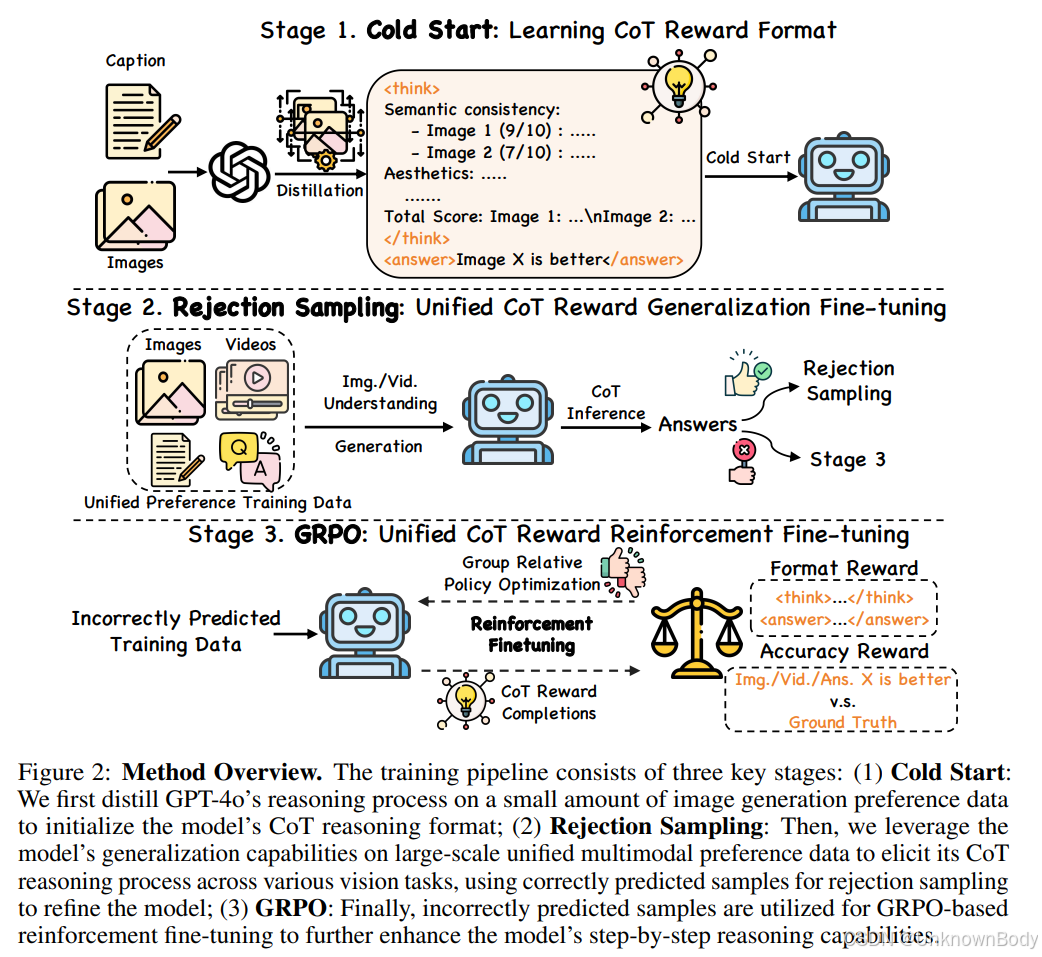
本文提出了首个基于统一多模态思维链(CoT)的奖励模型UNIFIEDREWARD-THINK,旨在通过显式长链推理提升多模态奖励模型的可靠性和鲁棒性。核心方法分为三个训练阶段:

  1. 冷启动阶段:使用少量图像生成偏好数据蒸馏GPT-4o的推理过程,使模型学习CoT推理的格式和结构。
  2. 拒绝采样阶段:利用大规模统一多模态偏好数据激发模型在各类视觉任务中的推理能力,保留正确推理样本以强化准确模式。
  3. 组相对策略优化(GRPO)阶段:对错误预测样本进行基于GRPO的强化微调,推动模型探索多样化推理路径,优化推理准确性。

实验表明,引入长CoT推理显著提升了奖励信号的准确性,且模型在掌握CoT后即使无需显式推理痕迹,也能通过隐式推理超越现有基线。

二、文章创新点

  1. 首个统一多模态CoT奖励模型:实现了视觉理解与生成任务的多维度、分步长链推理,突破了传统奖励模型仅提供直接响应或浅层推理的局限。
  2. 三阶段强化微调框架:结合冷启动蒸馏、拒绝采样和GRPO,有效激活模型的潜在推理能力,解决了CoT奖励数据稀缺的问题。
Unified Multimodal Chain-of-Thought Reward Modelthrough Reinforcement Fine-Tuning 2505.03318v1https://arxiv.org/pdf/2505.03318v1 近年来,多模态奖励模型(RMs)[Wang et al. 2024 2025, Zang et al. 2025, Xiong et al. 2024, He et al. 2024, Xu et al. 2024, Liu et al. 2025a, Li et al. 2025] 在将视觉模型输出与人类偏好对齐方面表现出色,为模型训练提供了关键的奖励信号[Wang et al. 2024 2025 阅读详情

相关推荐

大模型安全-生成检测-事实核查-攻击-防御-思考-记忆-融合-语音相关研究 2025年版

本文整理了关于大模型安全领域的综合性资源,包括7篇综述论文、9个安全数据集以及5篇强化学习相关的安全研究论文。主要涉及大模型的对抗攻击、隐私保护、安全评估等方向,涵盖TruthfulQA、ToxiGen等知名数据集和TrustLLM、HarmBench等关键研究。资源包括知乎博主分享、arXiv预印本和顶会论文,并附有详细的中文讲解链接,为研究者提供了系统性的安全研究参考。

CSPhD-winston的博客 3595

具身智能【2026-01】:Being-H0.5【VLA + Flow Matching】【MoT+MoE架构】【UniHand2.0数据集:4 亿个样本/35000小时 】

BeingBeyond Teamhttps://research.beingbeyond.com/being-h05Real-World Deployment Figure 1: Being-H0.5 at a Glance. We scale human-centric robot learning with Being-H0.5 toward cross-embodiment generalization. We introduce UniHand-2.0, a large-scale corpus

u013250861的博客 256

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

jks212454的博客 300

船载 OpenHarmony AIS 航海工作台:告警与防碰撞预警系统

船载OpenHarmony AIS航海工作台的告警与防碰撞系统,集成十余类告警(超速、偏航、会遇、SOS等),通过网格空间索引实现高效邻近判定,保障实时性。告警管理器统一调度规则、去重、通知与日志,支持悬浮球、语音、跑马灯、弹窗多渠道触达,确保航行安全。SOS紧急通道独立运行,避免干扰。系统设计强调性能优化与多场景适配,为航海安全提供核心支撑。

专注于计算机研发知识和资讯分享 197

从菜鸟到高手:我的Abaqus壳单元S4R、S3R、S8R选择心路历程

第一次打开Abaqus的单元库时,我被琳琅满目的壳单元类型晃花了眼。S4R、S3R、S8R、STRI65、S9R5...这些看似随意的字母数字组合,背后却隐藏着影响仿真精度的关键密码。作为一名从土木工程转行到汽车结构仿真的工程师,我花了三年时间才真正理解如何根据问题特性精准选择壳单元。这段学习历程充满试错与顿悟,今天就用几个关键案例,分享我的壳单元选择方法论。

weixin_42525637的博客 419

智能体在车联网中的应用:第9天 核心工具链与仿真世界:SUMO交通仿真入门——从安装到构建你的第一个虚拟十字路口

摘要 SUMO是一款开源微观交通仿真工具,为车联网和自动驾驶算法开发提供高效安全的测试环境。文章详细介绍了SUMO的核心概念、安装方法及实战应用。在Ubuntu或Windows系统安装SUMO后,可通过netedit工具构建十字路口路网,包括创建节点、连接边、设置交通信号灯等步骤。随后通过编写.rou.xml文件定义车辆类型、路线和车流,实现动态交通场景模拟。SUMO支持与外部程序交互,能复现真实场景、进行极端测试和算法验证,是车联网研究的理想数字沙盘。

IT深耕十余载,大道之简 1454

Goose开源程序本地机上 AI 代理,能够从头到尾自动执行复杂的开发任务。Goose 不仅可以提供代码建议,还可以自主构建整个项目、编写和执行代码、调试故障、编排工作流程以及与外部 API 交互

Goose开源程序 是您的本机上 AI 代理,能够从头到尾自动执行复杂的开发任务。Goose 不仅可以提供代码建议,还可以自主构建整个项目、编写和执行代码、调试故障、编排工作流程以及与外部 API 交互。无论您是在构建想法原型、优化现有代码,还是管理复杂的工程管道,goose 都能适应您的工作流程并精确执行任务。

struggle2025的博客 2047

Lumerical官方案例、FDTD时域有限差分法仿真学习(三)——环形谐振器(Ring resonator)之第一部分

环形谐振器教程的第 1 部分使用 MODE 来设计和仿真环形谐振器。 自由光谱范围 (FSR) 和品质因数 (Q 因数) 是这种面向片上通信应用的基于绝缘体上硅 (SOI) 波导设计的关键性能指标。

weixin_45719141的博客 3万+

深入大模型-13-大模型Skills应用之标准目录结构和开发一个Skill的步骤

首先对比Prompt工程,上下文工程,Skills工程,MCP工具的概念与区别,然后介绍Skill的标准目录结构,同时描述了开发一个Skill的步骤和最佳实践。

qq_20466211的博客 748

PCL RANSAC拟合分割多条直线【2026最新版】

使用RANSAC算法拟合分割多条直线,输出每一条直线的拟合参数到控制台,并保存直线点云到本地文件夹。博客长期更新,本文最新更新时间为:2026年5月24日。

点云侠的博客 7974

【项目实战】Java9的新特性模块化(Module)

Java 9引入了模块化系统,称为"Java Platform Module System"(JPMS)这个系统允许将Java程序分成模块,每个模块都有自己的规范,可以明确地声明它依赖于哪些其他模块,并且只能访问被其所依赖的模块暴露的API。这样可以模块化就是增加了更高级别的聚合,是Package的封装体。Package是一些类路径名字的约定,而模块是一个或多个Package组成的封装体。

奶爸的编程之路,也就一周冷个三天 1897

【实战圣经】YOLOv8-pose姿态估计模型从训练到RK3588部署:让边缘端骨骼识别速度突破60FPS

本教程从“模型训练-转换-边缘部署”全链路拆解了YOLOv8-pose姿态估计方案在RK3588上的落地过程,每一步都经过实战验证。无论是智能健身的动作实时纠正,还是工业设备的关键部件姿态检测,这套流程都能让你以最低成本实现高精度、高实时性的姿态估计应用。如果你在实践中遇到模型转换报错、部署性能不达标等问题,可聚焦某一环节深入优化——毕竟,让AI在边缘端“精准捕捉每一个关键点”,才是技术驱动场景创新的核心。

m0_71589036的博客 251

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

上一篇: A Day in Their Shoes: Using LLM-Based Perspective-Taking Interactive Fiction to Reduce Stigma Toward
下一篇: Sparse Attention Remapping with Clustering for Efficient LLM Decoding on PIM
UnknownBody
博客等级 码龄16年 5601粉丝 4740原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

UnknownBody

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


